
Facebook-scraping är fortfarande relevant 2026, men bara om du väljer rätt insamlingsmodell. Pew Research Center rapporterade den 20 november 2025 att 71% av amerikanska vuxna använder Facebook, och Meta sa den 29 april 2026 att dess Family of Apps nådde 3,56 miljarder dagliga aktiva personer i mars 2026. Den skalan gör Facebook fortsatt användbart för bevakning av Marketplace, research av offentliga sidor, leadgenerering och konkurrentbevakning. Det svåra är inte att hitta användningsfall. Det svåra är att få fram ren data utan att fastna i inloggningsväggar, dynamiska laddningar, tillfälliga spärrar eller sköra scraping-upplägg.
Den här årliga kortlistan är gjord för att du ska kunna fatta beslut snabbt. Jag gick igenom officiella produktsidor, dokumentation och prisindikationer på nytt i augusti 2026 och har därför bara valt verktyg som fortfarande är rimliga för faktiska företagsanvändare. Om du behöver infrastruktur på API-nivå hör Bright Data, Apify och Nimble by Nimbleway hemma i toppen av listan. Om ditt arbete även omfattar molnautomationer eller uppföljningsåtgärder efter insamling förtjänar PhantomBuster en närmare titt.
Snabba val efter uppgift
- Behöver du en officiell väg för en tillgång du själv administrerar? Börja med Metas hanteringsverktyg och godkända API:er.
- Behöver du ett specialist-API för offentliga data? Utvärdera Bright Data eller Apify mot exakt mål och tillåten användning.
- Behöver du ett generellt infrastruktur-lager för webbdata? Utvärdera Nimble eller ScrapingBot genom ett avgränsat proof of concept.
- Behöver du ett visuellt arbetsflöde för en tillåten källa utanför Meta? Octoparse kan passa ett processflöde som ägs av en analytiker.
Varför Facebook-scraping fortfarande är svårt 2026
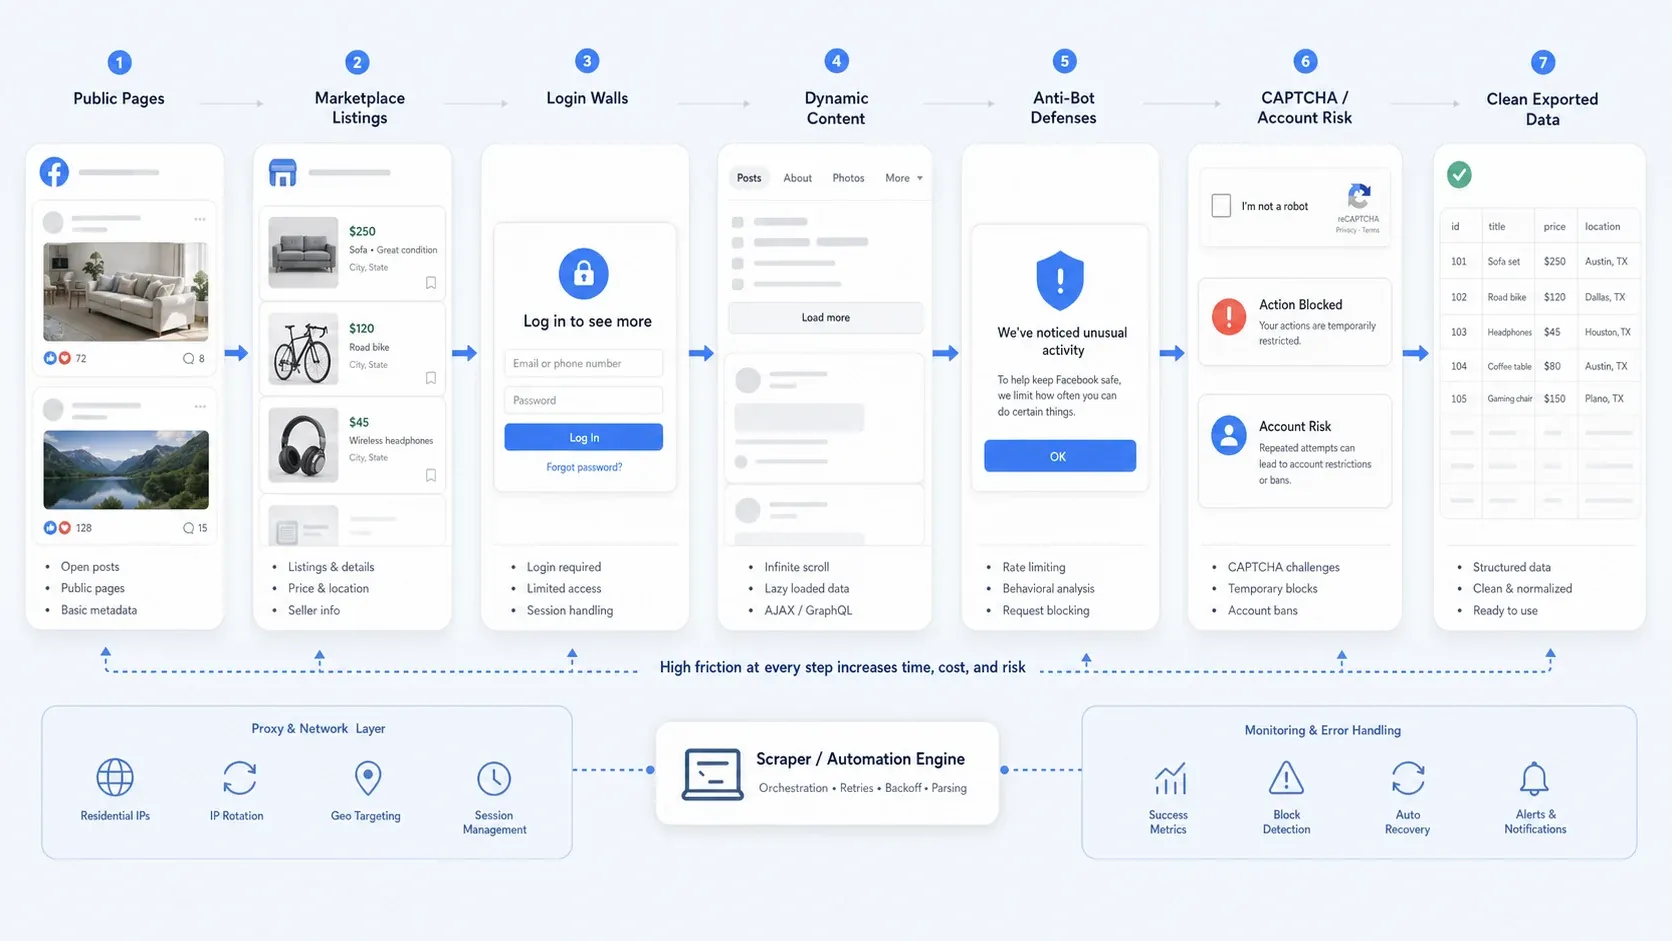
Insamling av Facebook-data handlar sällan bara om att välja rätt selektor längre. I praktiken stöter de flesta team på ett eller flera av dessa problem:
- Delvis offentlig åtkomst: Vissa sidor förblir öppna, medan andra flöden trycker dig mot inloggning för att se mer detaljer.
- Dynamiskt innehåll: Marketplace-vyer, långa kommentarsfält och sidinnehåll laddas ofta stegvis.
- Skydd mot bottar: Hastighetsbegränsningar, beteendekontroller, CAPTCHA och tillfälliga åtgärdsspärrar saboterar enkla automationer.
- Operativ risk: Insamling som kräver inloggning är betydligt riskablare än skrapning av offentliga sidor, särskilt om du bryr dig om kontosäkerhet och repeterbarhet.
Så här utvärderade jag verktygen
Jag optimerade den här sidan för att bygga en kortlista, inte för att fylla ut funktioner. Verktygen här jämfördes utifrån:
- Passar arbetsflödet: Matchar produkten faktiskt de Facebook- och Marketplace-jobb som riktiga team gör?
- Användarvänlighet: Kan icke-utvecklare eller små team få ut användbara resultat snabbt?
- Skalbarhet och tillförlitlighet: Håller verktyget fortfarande när du går från en engångsskrapning till återkommande användning?
- Hantering av skydd mot bottar och sessioner: Hur mycket infrastrukturproblem tar produkten bort?
- Utdatakvalitet: Kan du få strukturerad data till CSV, Sheets eller vidare system utan större städning?
- Prisbild: Är produkten praktisk att utvärdera, eller krävs ett tungt enterprise-upplägg?
- Efterlevnad och ansvar: Är verktyget tydligt inriktat på insamling av offentliga data och ansvarsfull användning?
Vilken typ av Facebook-scraper behöver du?
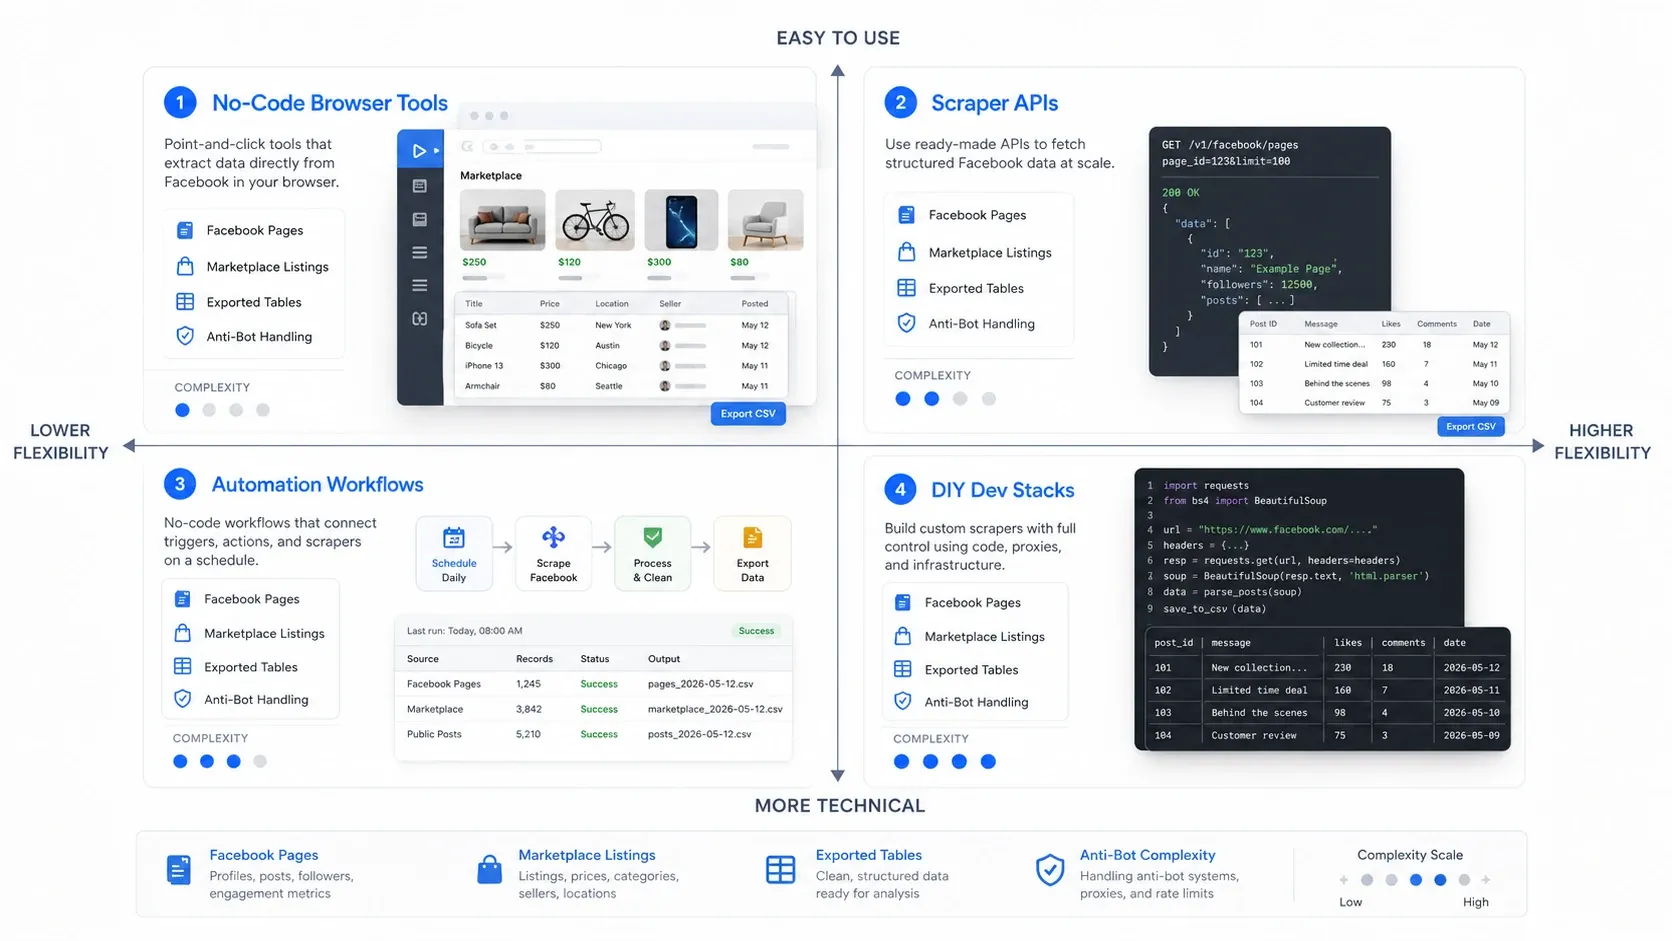
Det snabbaste sättet att välja rätt är att först välja rätt kategori. Verktyg för Facebook-scraping brukar falla inom fyra driftsmodeller:
- No-code-verktyg i webbläsaren: Bäst när du vill extrahera snabbt från sidan som redan är öppen framför dig.
- Scraper-API:er: Bäst när du behöver pålitlig, repeterbar insamling i högre volym.
- Automationsflöden: Bäst när scraping bara är ett steg i en bredare go-to-market-process.
- Egenutvecklade dev-stackar: Bäst när teamet vill ha maximal kontroll och är berett att ta underhållsbördan.
Jämförelsetabell
| Verktyg | Bäst för | Driftsmodell |
|---|---|---|
| Bright Data | Hanterat API-flöde för offentliga data | Specialist-API och leveranslager |
| Apify | Återkommande jobb för sidor eller profiler | Moln-actor och dataset-utmatning |
| Nimble | Utvärdering för tekniska team | Generellt API för offentliga webben |
| ScrapingBot | Test med renderingstöd | Generellt scraping-API |
| PhantomBuster | GTM-flöden med eget konto | Prospekteringsautomation |
| Octoparse | Visuellt uppbyggda uppgifter som ägs av analytiker | No-code visuellt arbetsflöde |
1. Bright Data
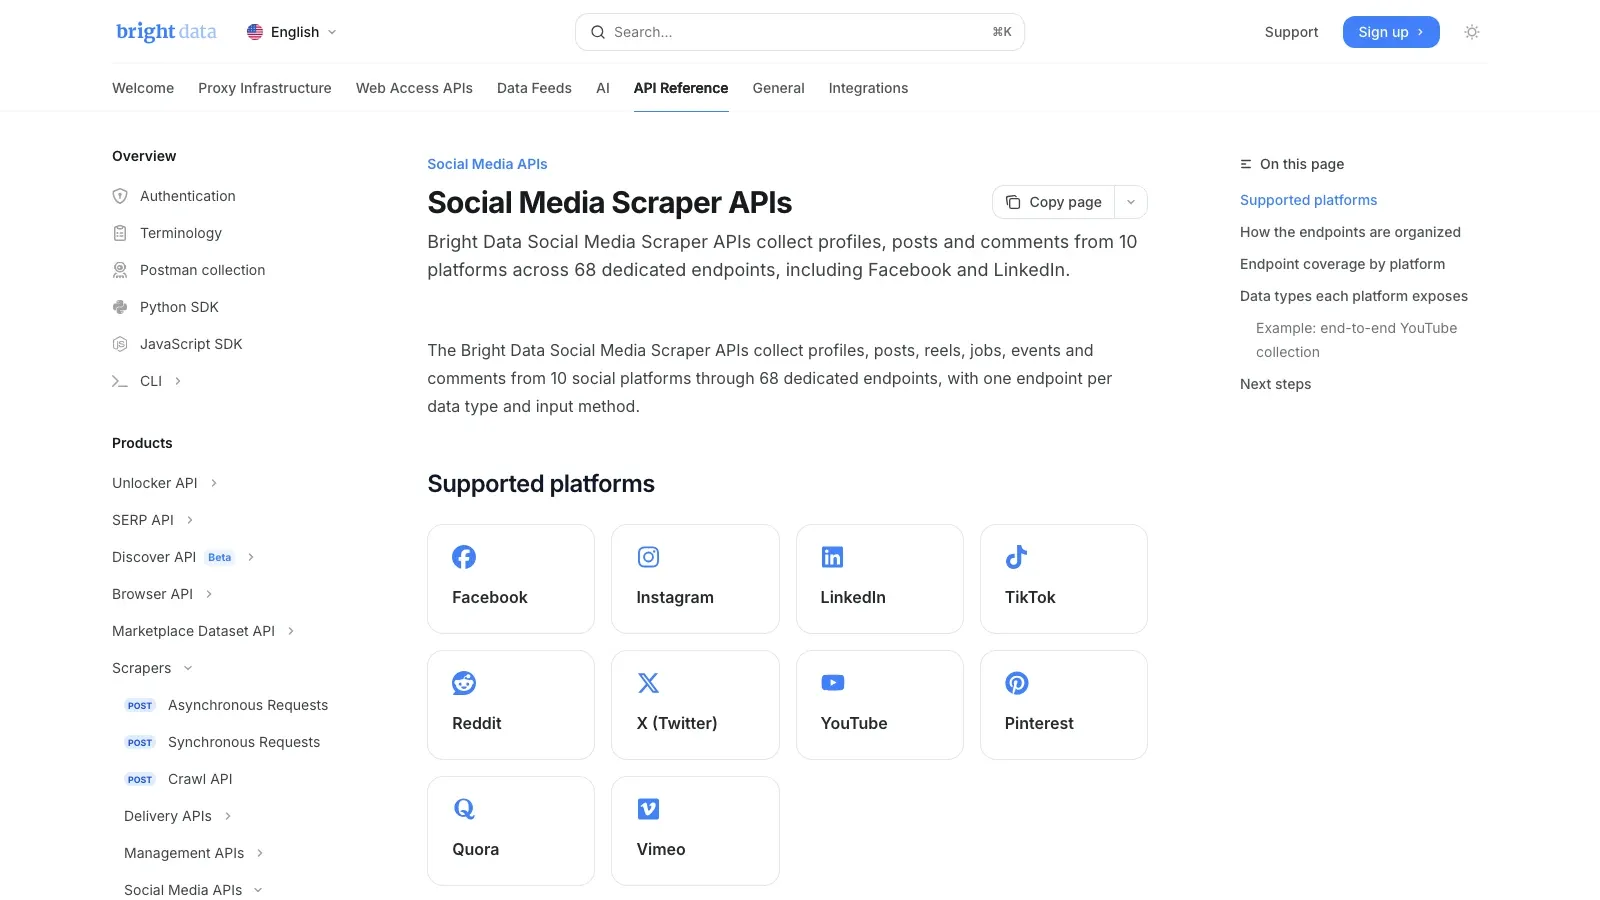
Bright Data är det infrastrukturförst-verktyg som sticker ut. Enligt Bright Datas egen dokumentation täcker dess Social Media Scraper APIs 10 plattformar och 68 dedikerade endpoints, inklusive Facebook. Om ditt jobb handlar om storskalig insamling av offentliga data är den här typen av hanterad API-stack ofta mer realistisk än att försöka skala upp ett webbläsartillägg eller en egenbyggd scraper.
Därför platsar det på kortlistan:
- Dedikerade endpoints för scraping av sociala medier
- Hanterad avblockering och extrahering
- Strukturerad leverans till datapipelines
- Bättre för övervakning och analys där tillförlitlighet är avgörande
Bäst för: analytiker, datateam, stora bevakningsprojekt och offentliga sociala dataset i stor skala.
Prisbild: Priset varierar beroende på produkt och volym. Kontrollera Bright Datas aktuella prissättning.
2. Apify
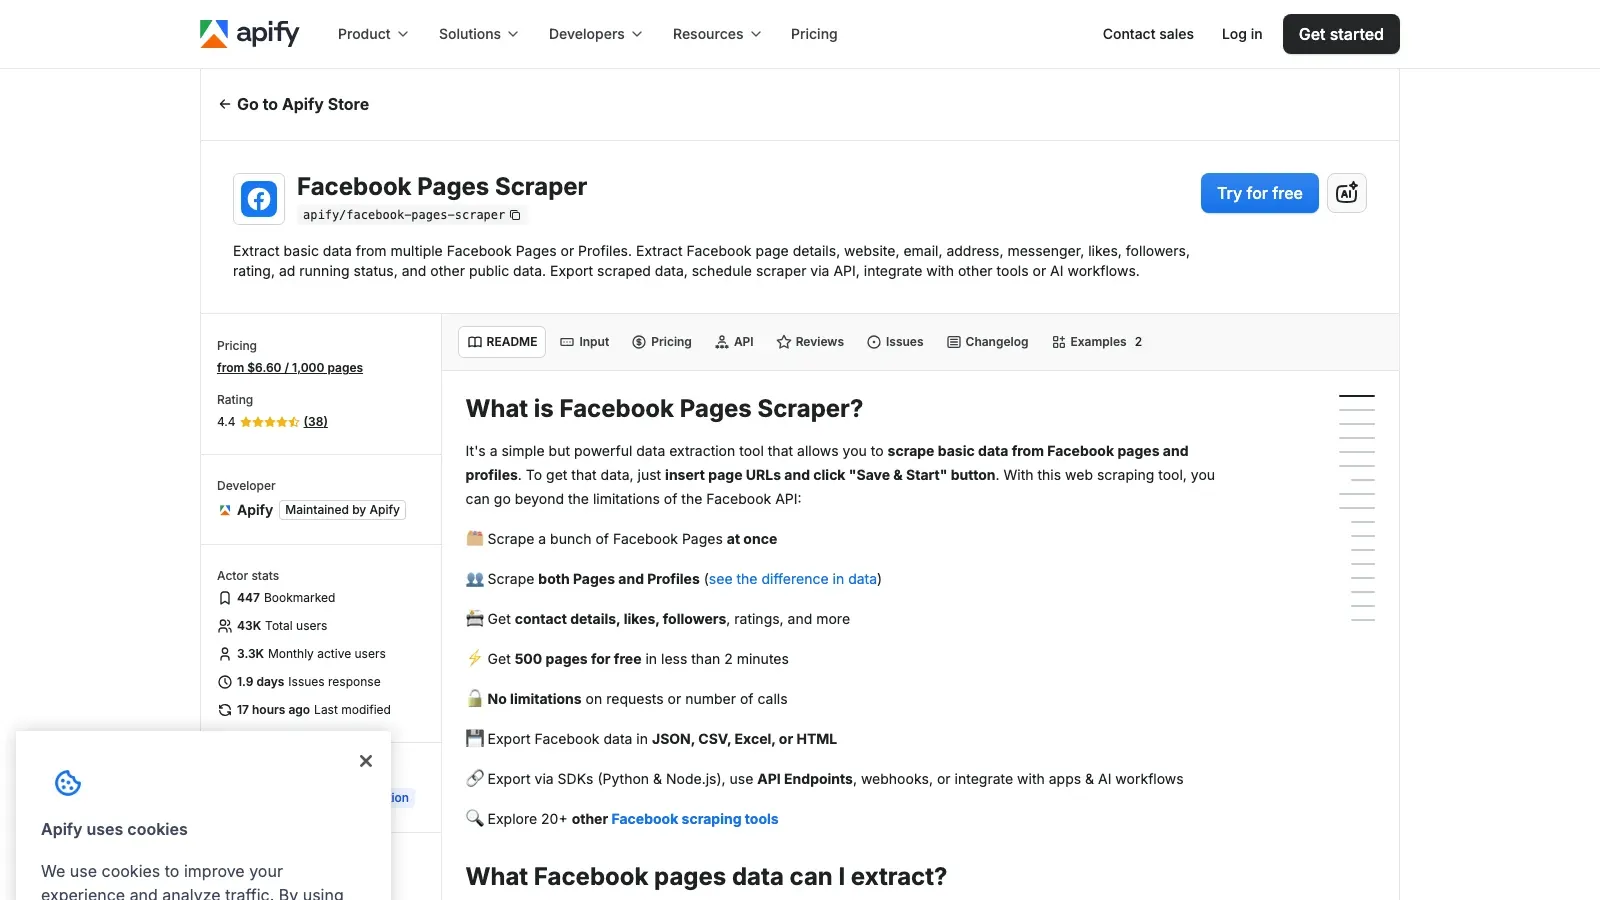
Apify är fortfarande relevant eftersom det ger en stark balans mellan färdiga mallar och full anpassning. Dess Facebook Pages Scraper-actor är en bra startpunkt, medan den bredare Apify-plattformen ger dig molnkörningar, schemaläggning, API:er och utrymme att bygga ut flödet när behoven blir mer komplexa.
Därför kom det med på listan:
- Färdiga Facebook-actors
- Molnkörning och återkommande scheman
- Flexibla exporter och API-åtkomst
- Lättare att bygga vidare på än ett rent no-code-flöde i webbläsaren
Bäst för: tekniska marknadsförare, byråer, ops-team och återkommande insamlingsjobb över flera webbplatser.
Prisbild: Plattformens planer är betalda och actor-användning debiteras separat. Se Apify prissättning.
3. Nimble by Nimbleway
Nimble by Nimbleway är API-först-alternativet för team som vill skicka in en URL och låta plattformen hantera åtkomst, rendering och leverans. Nimble positionerar sitt Web Scraper API som komplett insamling av data från öppna webben, vilket gör det användbart när Facebook-scraping bara är en del av en större datastack.
Därför är det värt att utvärdera:
- URL-först-API-flöde
- Mindre underhåll av scraperlogik för utvecklingsteam
- Bra för robust extrahering från öppna webben
- Användbart när skrapad data matar interna produkter eller dashboards
Bäst för: utvecklingsdrivna team, datapipelines för produkter och organisationer som vill ha infrastrukturabstraktion i stället för punktverktyg.
Prisbild: Nimble lyfter inte fram tydlig self-serve-prissättning på sina huvudsakliga API-sidor, så räkna med försäljningsledd prissättning och kontrollera direkt med Nimble by Nimbleway.
4. ScrapingBot
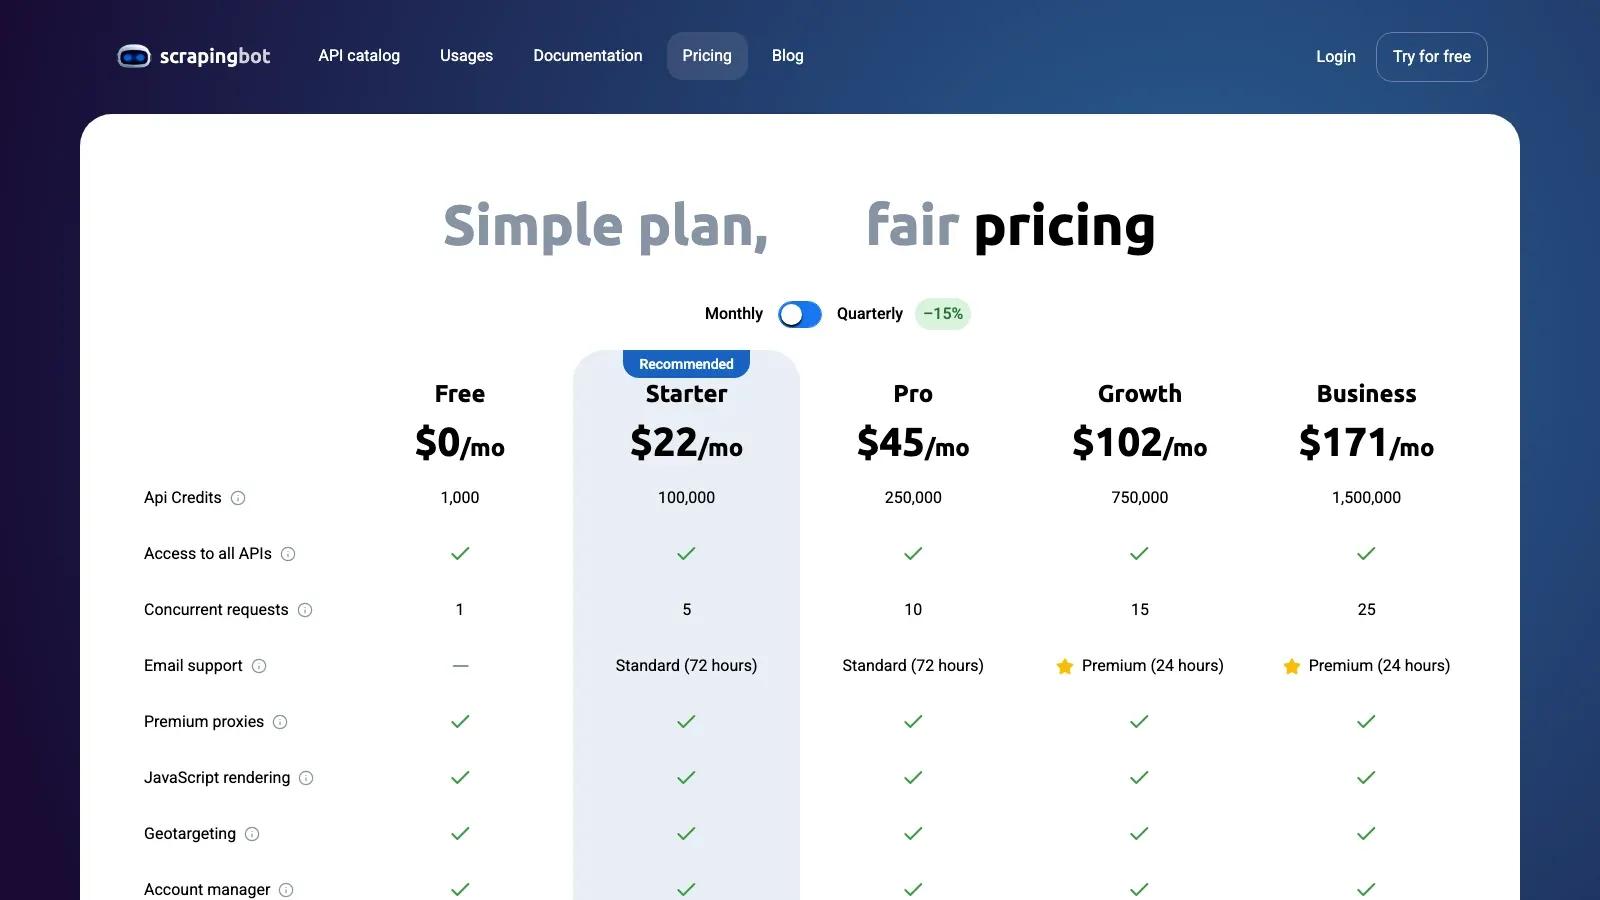
ScrapingBot är det kostnadsmedvetna API-alternativet i den här listan. Det är inte den mest Facebook-specialiserade plattformen här, men det är fortfarande ett rimligt val för mindre offentliga dataprojekt där du vill ha ett API, stöd för rendering och en lägre kostnadsnivå än enterprise-infrastruktur för scraping.
När det passar:
- Enkel API-baserad scraping av offentliga sidor
- Lägre startkostnad
- Rendering och proxihantering ingår
- Bättre för prototyper och lätta återkommande hämtningar än för stora analysprogram
Bäst för: startups, småföretag och utvecklare som testar lättare användningsfall för insamling från offentliga sidor.
Prisbild: Gratis nivå finns; den aktuella offentliga prissidan visar betalda planer från cirka $22/månad.
5. PhantomBuster
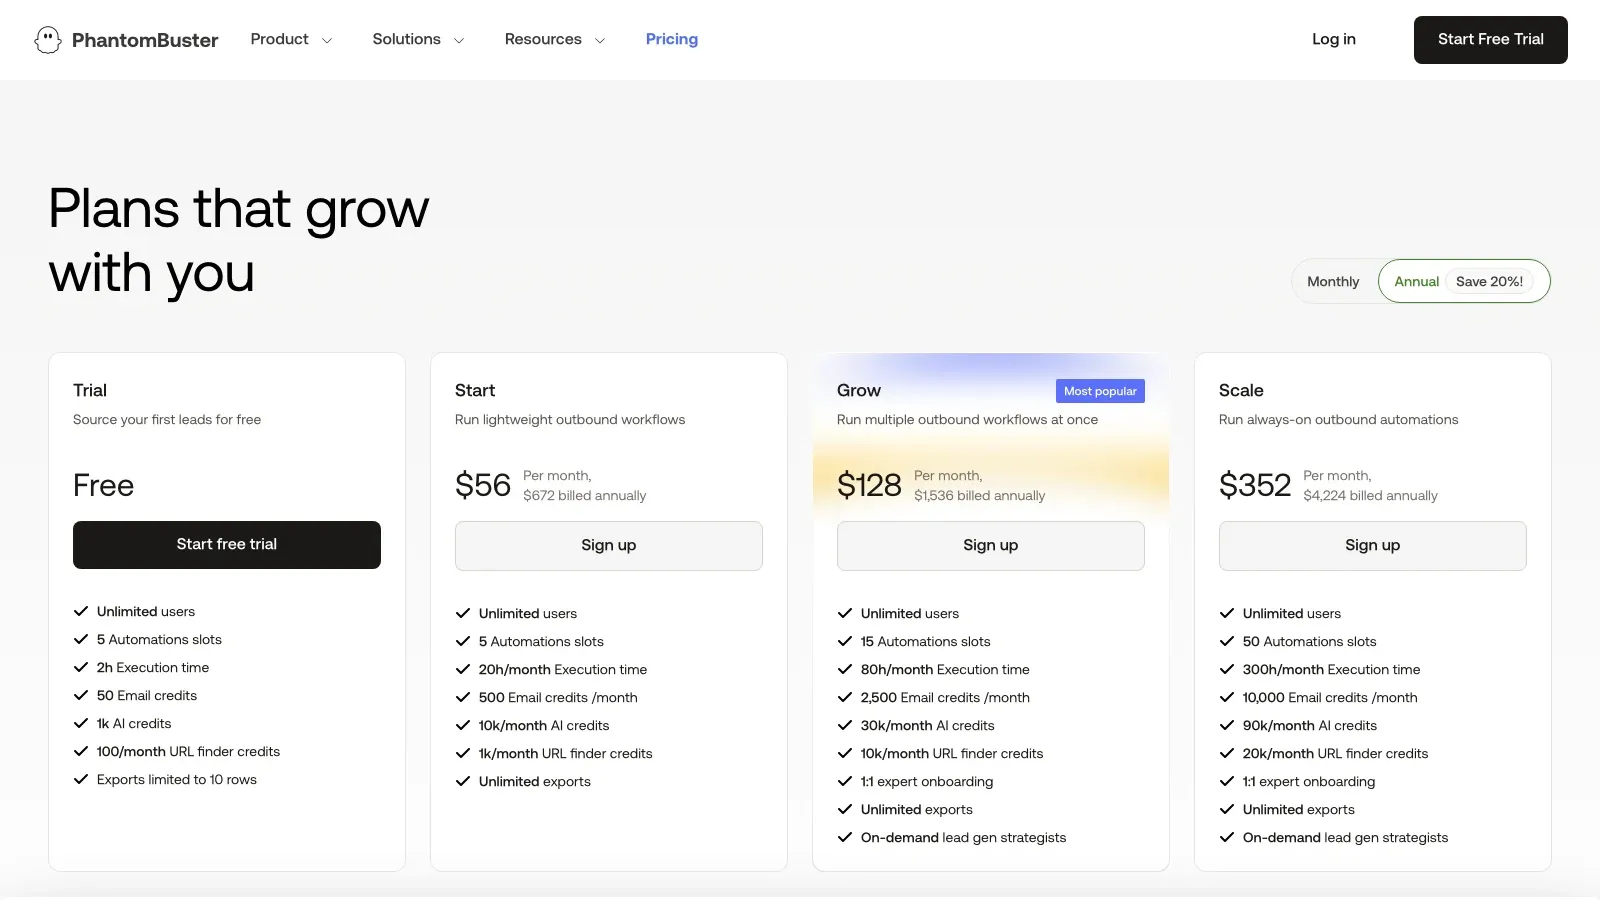
PhantomBuster handlar mindre om rå scraping-infrastruktur och mer om vad som händer efter insamlingen. Om ditt användningsfall är ”samla in datan, och trigga sedan outreach, enrichment eller uppföljningsåtgärder”, är PhantomBuster ofta mer användbart än en ren extraktor eftersom det är byggt kring molnautomationer och webbläsarstyrda arbetsflöden.
Därför fortsätter team att kortlista det:
- Molnbaserade automationsflöden
- Bra för leadgenerering och GTM-arbete
- Starkare passform när scraping bara är ett steg i en större process
- Praktiskt för operatörer som bryr sig om åtgärder, inte bara export
Bäst för: GTM-team, growth-team, rekryterare och operatörer som kedjar ihop insamling med vidare åtgärder.
Prisbild: Gratis provperiod finns; betalda planer på den aktuella prissidan börjar vid cirka $56/månad.
6. Octoparse
Octoparse är fortfarande ett av de bättre visuella no-code-verktygen för användare som vill ha återkommande arbetsflöden och schemalagda molnkörningar. Det ger icke-utvecklare mer tydlig kontroll över hur extraktionslogiken byggs och upprepas, men kräver mer initial inställning än ett lättviktigt engångsflöde.
Därför är det fortfarande relevant:
- Visuell arbetsflödesbyggare med klick och dra
- Molnextrahering och schemaläggning
- Bra för strukturerade, återkommande uppgifter
- Lämpligt för analytiker som vill ha repeterbarhet utan kod
Bäst för: icke-tekniska analytiker, SMB-ops-team och återkommande insamlingsuppgifter med mer tydlig logik i flödet.
Prisbild: Octoparses offentliga prissida visar betalda planer från cirka $69/månad för Standard-planen, fakturerad årligen.
Kortlista efter teamtyp
- API-drivet flöde: Bright Data eller Apify
- Teknisk utvärdering av offentliga webbdata, ägd av utvecklingsteam: Nimble eller ScrapingBot
- Prospekteringsflöde med eget konto: PhantomBuster
- Visuellt, redigerbart arbetsflöde: Octoparse
Innan du väljer något alternativ, testa exakt den sidtyp och de fält som ditt team får använda. Facebooks synlighet skiljer sig mellan Pages, Profiles, Marketplace, Groups, platser och kontostatus.
Slutsats
Rätt väg beror på datan, åtkomstmodellen och teamets ansvar för validering. För tillgångar du själv administrerar bör du börja med Metas officiella verktyg och godkända API:er. För research utanför det området bör du välja leverantör eller källa först efter att du har bekräftat sidtypen, tillåten användning, integritetskrav och det aktuella produktbeteendet.
Vanliga frågor
Vilken väg bör en icke-teknisk användare överväga först?
För en tillgång som din organisation administrerar, börja med Metas egna hanterings- och analysverktyg. För ett bredare researchbehov, identifiera en tillåten källa vars arbetsflöde och datarättigheter du kan bedöma.
Vilket alternativ är bäst för integration med mjukvara eller datapipeline?
Utvärdera ett Facebook-specifikt API som Bright Data, en actor-baserad plattform som Apify, eller ett generellt API för öppna webben genom ett avgränsat test av exakt mål.
Kan dessa verktyg kringgå Facebooks åtkomstbegränsningar?
Nej. Använd inte ett verktyg för att kringgå plattformsregler, inloggningsväggar eller integritetsskydd.




