
Min Amazon-recensionsskrapa fungerade klockrent i sex veckor — sedan, en morgon, fick den tillbaka 200 OK och en sida fylld av ingenting. Inget felmeddelande, ingen CAPTCHA, bara tom HTML där hundratals recensioner brukade ligga.
Om det låter bekant är du inte ensam. I slutet av 2025 började Amazon låsa in sina fullständiga recensionssidor bakom en inloggningsvägg, och mängder av Python-skript gick sönder över en natt. Jag har tillbringat de senaste månaderna på Thunderbit med att lösa problemet från båda håll — både genom att bygga vår AI web scraper och genom att underhålla mitt eget Python-flöde för recensioner — så jag tänkte att det var dags att skriva guiden jag själv hade önskat att jag haft när mitt skript först dog. Det här inlägget går igenom metoden som faktiskt fungerar: cookie-baserad autentisering, stabila selektorer som står emot Amazons CSS-obfuskering, lösningar för 10-sidorsgränsen i pagineringen, skydd mot botdetektering och ett extra avsnitt om sentimentanalys som omvandlar rå recensionstext till verkliga affärsinsikter. Och om du halvvägs tänker: "Jag vill helst slippa underhålla all den här koden", visar jag hur Thunderbit löser samma uppgift på ungefär två minuter utan någon Python alls.
Vad är Amazon-recensionsskrapning, och varför spelar det roll?
Amazon-recensionsskrapning är processen att programmatiskt extrahera kundrecensioner — stjärnbetyg, recensionstext, författarnamn, datum, märkning för verifierat köp — från Amazons produktsidor. Eftersom Amazon tog bort recensionsinnehåll från sitt Product Advertising API redan 2010 (och aldrig tog tillbaka det), är web scraping den enda programmässiga vägen till den här datan.
Siffrorna talar för sig själva. 95% av alla köpare läser recensioner innan de köper, och 94% anger Amazon som sin främsta källa för produktrecensioner. Att visa bara 5 recensioner på en produktsida kan öka konverteringen med 270%. Företag som systematiskt analyserar sentiments i recensioner ser upp till 15% högre kundlojalitet. Det här är inte abstrakt datavetenskap — det är konkurrensintelligens, signaler för produktförbättring och marknadsföringsspråk, allt ligger öppet som vanlig text på Amazons servrar.
Varför skrapa Amazon-recensioner med Python?
Python är fortfarande förstahandsvalet för den här typen av arbete. Det är det mest efterfrågade språket i Stack Overflows Developer Survey 2024, och ekosystemet — requests, BeautifulSoup, pandas, Scrapy — gör web scraping tillgängligt även för dem som inte jobbar som utvecklare på heltid.
Olika team använder den här datan på olika sätt:
| Team | Användningsområde | Vad de extraherar |
|---|---|---|
| Produkt / FoU | Hitta återkommande klagomål, prioritera förbättringar | 1–2-stjärniga recensioner, nyckelordsfrekvens |
| Försäljning | Bevaka konkurrenters produktomdömen | Betyg, trender i recensionsvolym |
| Marknadsföring | Hämta kundspråk till annonstexter | Positiva fraser från recensioner, omnämnanden av funktioner |
| E-handel / drift | Följa sentiment över tid för egna produkter | Fördelning av stjärnbetyg, andel verifierade köp |
| Marknadsanalys | Jämföra kategoriledare över funktioner | Recensionsdataset från flera ASIN |
Ett varumärke inom köksartiklar grävde i negativa recensioner och såg att 22% nämnde att "non-stick-beläggningen slits bort", gjorde om produkten och tog tillbaka sin plats som #1 Best Seller inom 60 dagar. Ett företag med fitness-trackers identifierade "irritation från bandet" i recensionstext, hittade ett problem med latexallergi, lanserade en hypoallergen version och minskade returerna med 40%. Det är den typen av ROI som gör utvecklingsinsatsen värd mödan.
Inloggningsväggen: varför din Amazon-recensionsskrapa slutade fungera
Den 14 november 2024 började Amazon kräva inloggning för att visa hela produktrecensionssidan. Förändringen bekräftades i både communityforum och bloggar från scraping-leverantörer. Om du besöker /product-reviews/{ASIN}/ i ett privat fönster skickas du till en inloggningssida i stället för att se recensionsdata.
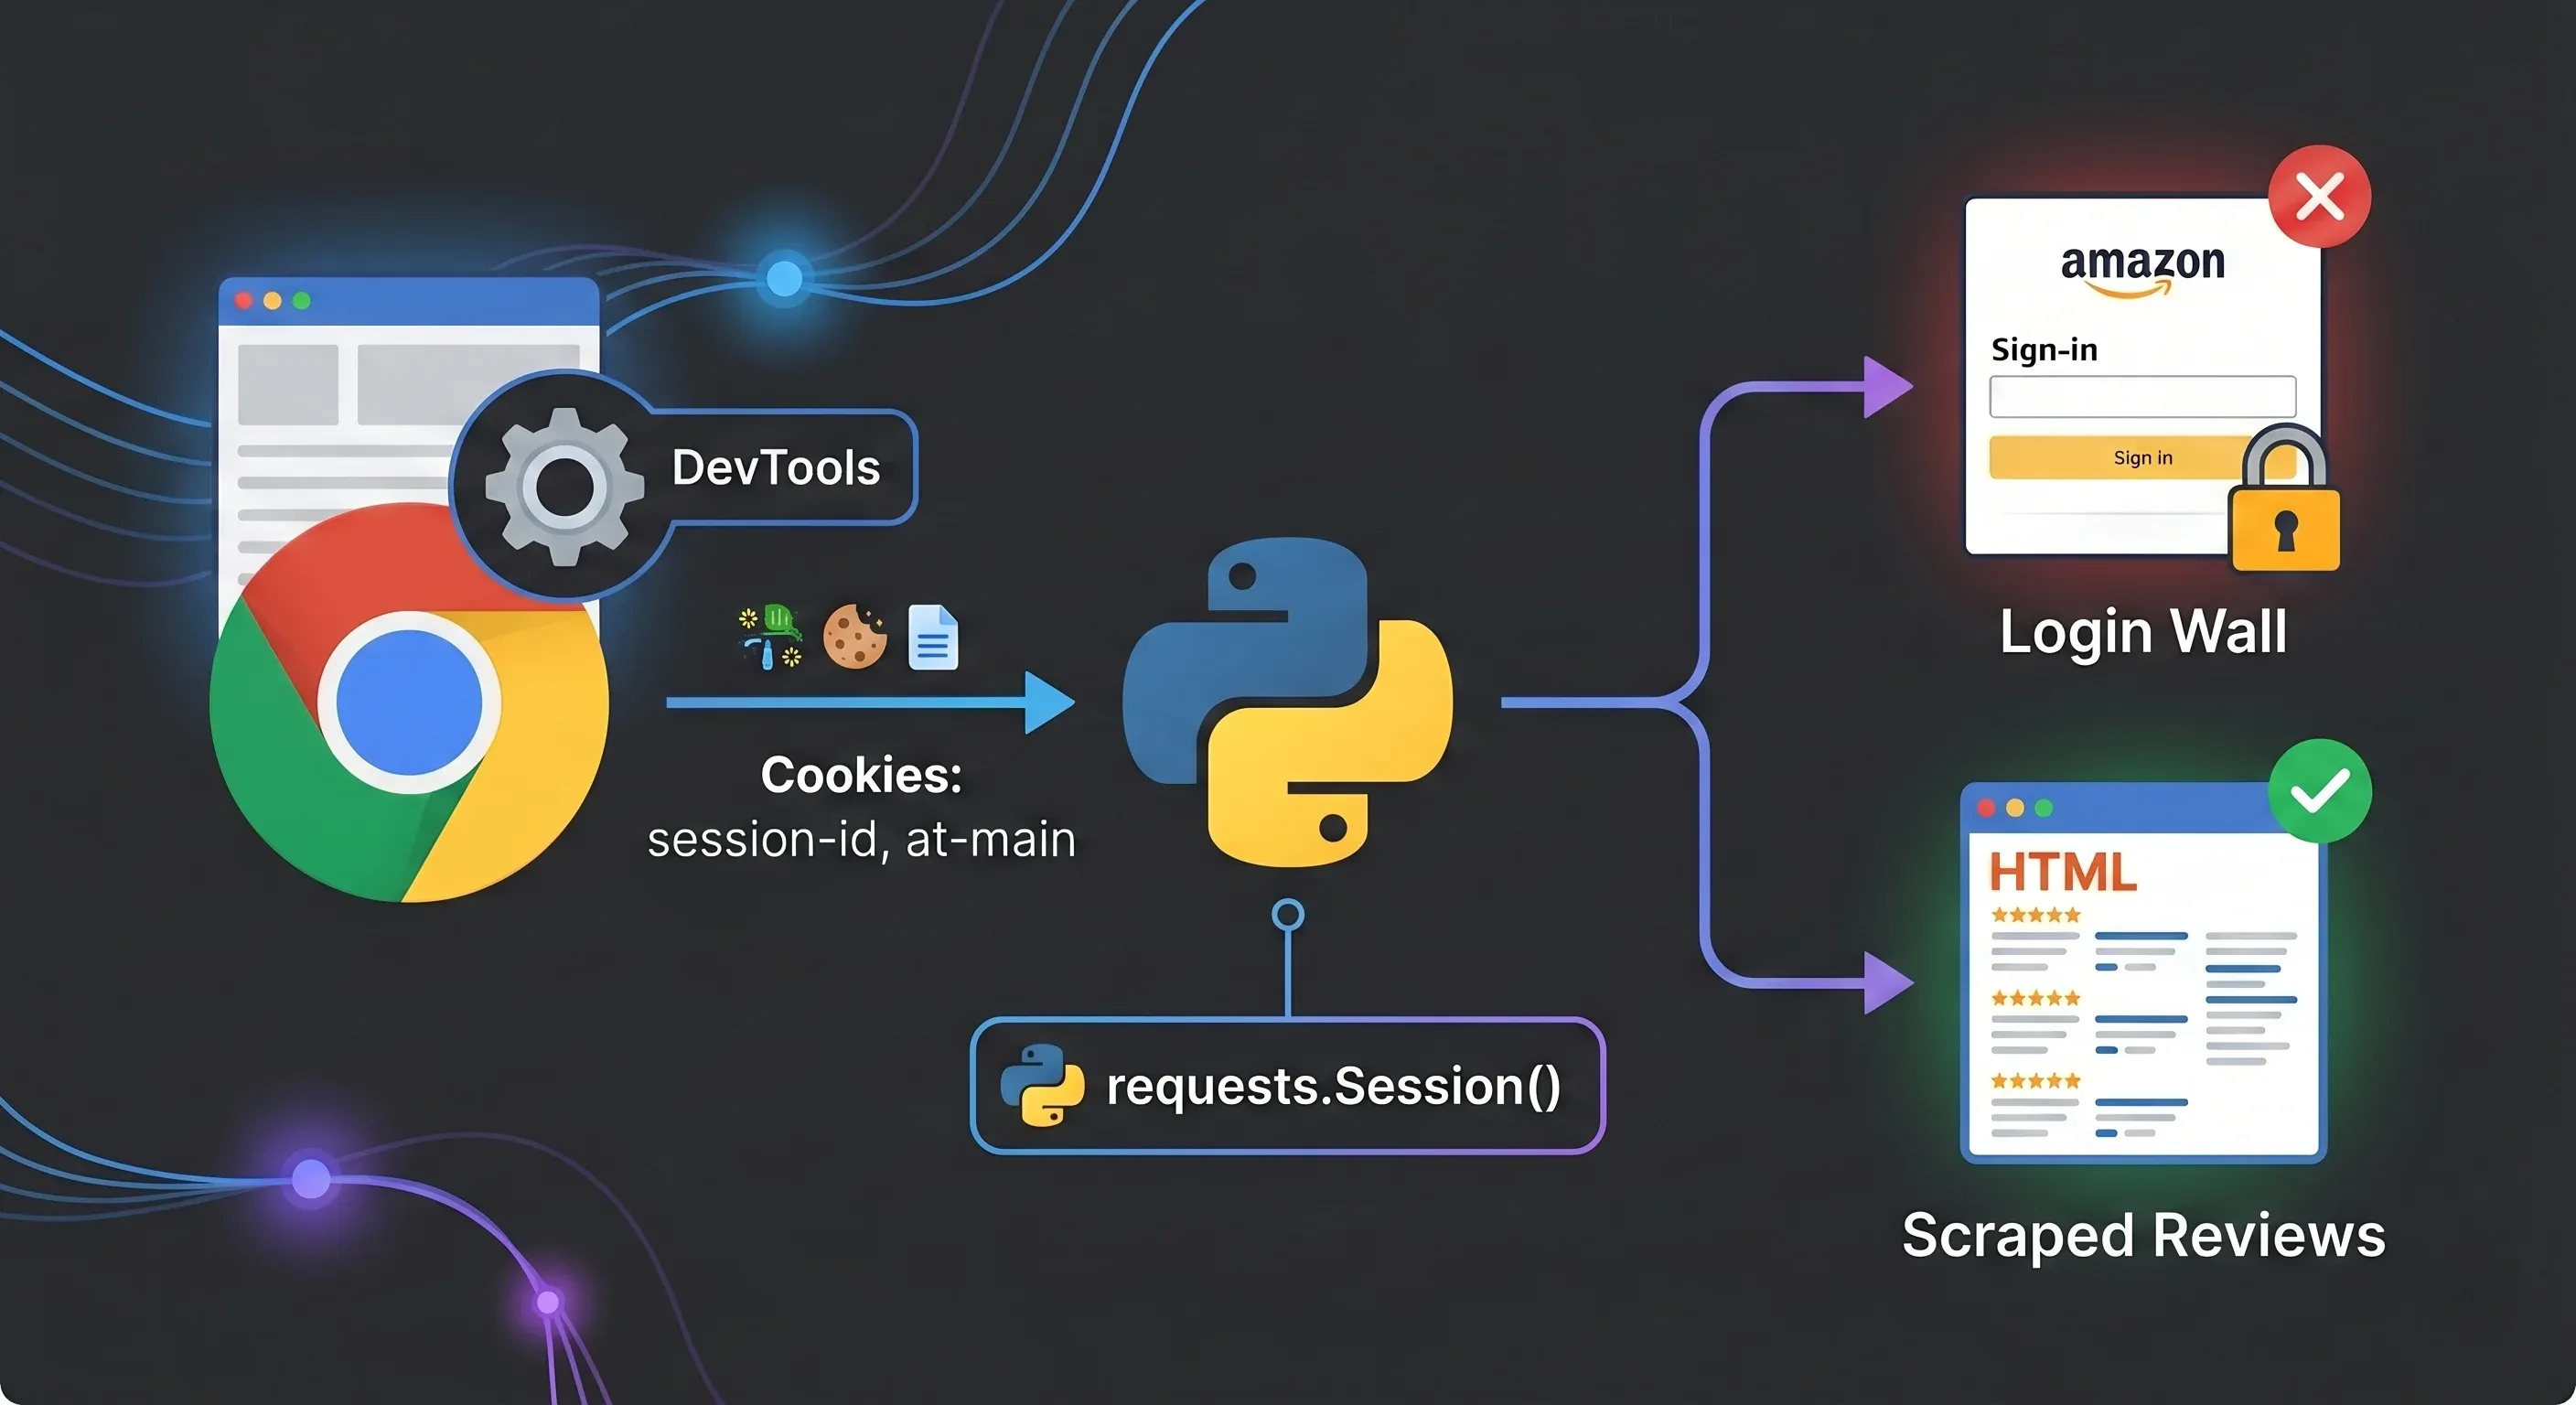
Symtomen är subtila: skriptet får ett svar med 200 OK, men HTML-kroppen innehåller ett inloggningsformulär (name="email", id="ap_password") i stället för recensioner. Ingen felkod. Ingen CAPTCHA. Bara... ingenting användbart.
Amazon gjorde detta av anti-bot-skäl och för regional efterlevnad. Verkställigheten är ojämn — ibland laddar ett nytt webbläsarfönster några recensioner innan väggen slår till, särskilt på första sidan — men för alla skrapor som körs i skala bör du utgå från att väggen alltid är aktiv.
Olika Amazon-domäner för olika länder (.de, .co.uk, .co.jp) hanterar väggen var för sig. Som en forumanvändare uttryckte det: "du behöver en inloggning för varje land." Dina .com-cookies fungerar inte på .co.uk.
Utvalda recensioner vs. fullständiga recensioner: vad du fortfarande kan komma åt utan inloggning
Amazons produktsidor (/dp/{ASIN}/) visar fortfarande ungefär 8 "utvalda recensioner" utan autentisering. Dessa är handplockade av Amazons algoritm och är bra för en snabb känslokoll, men de går inte att sortera, filtrera eller bläddra i.
De fullständiga recensionssidorna (/product-reviews/{ASIN}/) — med sortering på nyast, filter per stjärnbetyg och paginering över hundratals recensioner — kräver inloggning.
Om du bara behöver ett fåtal recensioner för en snabb avstämning, skrapa produktsidan. För hundratals eller tusentals behöver du hantera autentisering.
Det du behöver innan du börjar: Python-installation och bibliotek
Innan vi skriver kod, här är upplägget:
- Svårighetsgrad: Medel (du bör känna dig bekväm med Python och grundläggande HTML)
- Tidsåtgång: ~45 minuter för hela flödet; ~10 minuter för en enkel skrapning
- Det du behöver: Python 3.8+, Chrome-webbläsare, ett giltigt Amazon-konto
Installera kärnbiblioteken:
pip install requests beautifulsoup4 lxml pandas textblob
Valfritt (för avancerad sentimentanalys):
pip install transformers torch
Vad är ett ASIN? Det är Amazons produktidentifierare med 10 tecken. Du hittar det i varje produkt-URL — till exempel i amazon.com/dp/B0BCNKKZ91 är ASIN B0BCNKKZ91. Det är nyckeln du använder i recensions-URL:en.
Steg 1: Ta dig förbi inloggningsväggen med cookie-baserad autentisering
Det mest pålitliga sättet är att logga in på Amazon i webbläsaren, kopiera dina sessionscookies och mata in dem i din Python requests.Session(). Det här undviker de CAPTCHA och SMS-baserade 2FA-flöden som ofta ställer till det för Selenium-baserad inloggningsautomation.
Du behöver dessa sju cookies:
| Cookienamn | Syfte |
|---|---|
session-id | Roterande sessionsidentifierare |
session-id-time | Tidsstämpel för sessionen |
session-token | Roterande sessionstoken |
ubid-main | Identifierare för användarens webbläsning |
at-main | Primär autentiseringstoken |
sess-at-main | Autentisering knuten till sessionen |
x-main | Identifierare kopplad till användarens e-post |
Så extraherar du cookies från Chrome DevTools
- Logga in på amazon.com i Chrome
- Öppna DevTools (F12 eller högerklick → Inspektera)
- Gå till Application → Storage → Cookies →
https://www.amazon.com - Leta upp varje cookie i tabellen och kopiera dess värde
- Formatera dem som en sträng med semikolonseparerade värden för Python
Ställ in din session så här:
import requests

session = requests.Session()

# Klistra in dina cookie-värden här
cookies = {
    "session-id": "YOUR_SESSION_ID",
    "session-id-time": "YOUR_SESSION_ID_TIME",
    "session-token": "YOUR_SESSION_TOKEN",
    "ubid-main": "YOUR_UBID_MAIN",
    "at-main": "YOUR_AT_MAIN",
    "sess-at-main": "YOUR_SESS_AT_MAIN",
    "x-main": "YOUR_X_MAIN",
}

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.5",
}

session.cookies.update(cookies)
session.headers.update(headers)
Viktigt: Återanvänd samma session-objekt för alla förfrågningar. Det håller cookies konsekventa och efterliknar en riktig webbläsarsession. Cookies brukar hålla i dagar till veckor under skrapning, men om du börjar få inloggningsomdirigeringar igen är det bara att uppdatera dem från webbläsaren.
För marknadsplatser utanför .com ändras cookie-namnen lite — amazon.de använder at-acbde i stället för at-main, amazon.co.uk använder at-acbuk och så vidare. Varje marknadsplats behöver sin egen separata session.
Steg 2: Bygg förfrågan och tolka recensions-HTML med BeautifulSoup
Amazons recensions-URL följer det här mönstret:
https://www.amazon.com/product-reviews/{ASIN}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber=1
Kärnfunktionen:
from bs4 import BeautifulSoup
import time, random

def get_soup(session, url):
    time.sleep(random.uniform(2, 5))  # Hänsynsfull paus
    response = session.get(url, timeout=15)

    # Upptäck inloggningsväggen
    if "ap_email" in response.text or "Amazon Sign-In" in response.text:
        raise Exception("Inloggningsvägg upptäckt — uppdatera dina cookies")

    if response.status_code != 200:
        raise Exception(f"HTTP {response.status_code}")

    return BeautifulSoup(response.text, "lxml")
Ett litet knep som hjälper: innan du går till recensionssidan, besök produktsidan först. Det skapar ett mer naturligt surfmönster i din session.
# Besök produktsidan först (imiterar normalt surfande)
product_url = f"https://www.amazon.com/dp/{asin}"
session.get(product_url, timeout=15)
time.sleep(random.uniform(1, 3))

# Gå sedan till recensionssidan
reviews_url = f"https://www.amazon.com/product-reviews/{asin}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber=1"
soup = get_soup(session, reviews_url)
Steg 3: Använd stabila selektorer för att extrahera recensionsdata (sluta förlita dig på CSS-klasser)
Det är här de flesta guider från 2022–2023 faller isär. Amazon obfuskerar CSS-klassnamn — de ändras regelbundet, och som en frustrerad utvecklare skrev i en forumtråd: "ingen av dem hade något gemensamt mönster för namn på span-tagarnas klasser."
Lösningen: Amazon använder data-hook-attribut på recensionskomponenter, och de här är förvånansvärt stabila. De är semantiska identifierare som Amazons egen frontendkod bygger på, så de slumpas inte om.
| Recensionsfält | Stabil selektor (data-hook) | Skör selektor (klass) |
|---|---|---|
| Recensionstext | [data-hook="review-body"] | .review-text-content (ändras) |
| Stjärnbetyg | [data-hook="review-star-rating"] | .a-icon-alt (oklar) |
| Recensionstitel | [data-hook="review-title"] | .review-title (ibland) |
| Författarnamn | span.a-profile-name | Relativt stabil |
| Recensionsdatum | [data-hook="review-date"] | .review-date (regionsberoende) |
| Verifierat köp | [data-hook="avp-badge"] | span.a-size-mini |
Extraktionskoden med data-hook-selektorer:
import re

def extract_reviews(soup):
    reviews = []
    review_divs = soup.select('[data-hook="review"]')

    for div in review_divs:
        # Stjärnbetyg
        rating_el = div.select_one('[data-hook="review-star-rating"]')
        rating = None
        if rating_el:
            rating_text = rating_el.get_text(strip=True)
            match = re.search(r'(\d\.?\d?)', rating_text)
            if match:
                rating = float(match.group(1))

        # Titel
        title_el = div.select_one('[data-hook="review-title"]')
        title = title_el.get_text(strip=True) if title_el else ""

        # Brödtext
        body_el = div.select_one('[data-hook="review-body"]')
        body = body_el.get_text(strip=True) if body_el else ""

        # Författare
        author_el = div.select_one('span.a-profile-name')
        author = author_el.get_text(strip=True) if author_el else ""

        # Datum och land
        date_el = div.select_one('[data-hook="review-date"]')
        date_text = date_el.get_text(strip=True) if date_el else ""
        # Format: "Reviewed in the United States on January 15, 2025"
        country_match = re.search(r'Reviewed in (.+?) on', date_text)
        date_match = re.search(r'on (.+)$', date_text)
        country = country_match.group(1) if country_match else ""
        date = date_match.group(1) if date_match else ""

        # Verifierat köp
        verified_el = div.select_one('[data-hook="avp-badge"]')
        verified = bool(verified_el)

        reviews.append({
            "author": author,
            "rating": rating,
            "title": title,
            "content": body,
            "date": date,
            "country": country,
            "verified": verified,
        })

    return reviews
Jag har kört det här selektorset mot flera ASIN i månader nu, och data-hook-attributen har inte ändrats en enda gång. CSS-klasserna däremot har roterat minst två gånger under samma period.
Steg 4: Hantera paginering och Amazons 10-sidorsgräns
Amazon begränsar parametern pageNumber till 10 sidor med 10 recensioner per sida — ett hårt tak på ungefär 100 recensioner per filterkombination. Knappen "Nästa sida" försvinner helt efter sida 10.
Enkel pagineringsloop:
all_reviews = []

for page in range(1, 11):
    url = f"https://www.amazon.com/product-reviews/{asin}/ref=cm_cr_arp_d_viewopt_srt?sortBy=recent&pageNumber={page}"
    soup = get_soup(session, url)
    page_reviews = extract_reviews(soup)

    if not page_reviews:
        break  # Inga fler recensioner på den här sidan

    all_reviews.extend(page_reviews)
    print(f"Sida {page}: {len(page_reviews)} recensioner")
Hur du får fler än 10 sidor Amazon-recensioner
Workarounden är att dela upp hämtningen i filterbuckets. Varje kombination av filterByStar och sortBy får sitt eget oberoende 10-sidorsfönster.
Värden för stjärnfilter: one_star, two_star, three_star, four_star, five_star
Sorteringsvärden: recent, helpful (standard)
Genom att kombinera alla 5 stjärnfilter × 2 sorteringsordningar kan du nå upp till 100 sidor, alltså 1 000 recensioner per produkt — och för produkter med ojämn stjärnfördelning kommer du ofta nära hela recensionsmängden.
star_filters = ["one_star", "two_star", "three_star", "four_star", "five_star"]
sort_orders = ["recent", "helpful"]
all_reviews = []
seen_titles = set()  # Enkel dubblettkontroll

for star in star_filters:
    for sort in sort_orders:
        for page in range(1, 11):
            url = (
                f"https://www.amazon.com/product-reviews/{asin}"
                f"?filterByStar={star}&sortBy={sort}&pageNumber={page}"
            )
            soup = get_soup(session, url)
            page_reviews = extract_reviews(soup)

            if not page_reviews:
                break

            for review in page_reviews:
                # Ta bort dubbletter med kombinationen titel + författare
                key = (review["title"], review["author"])
                if key not in seen_titles:
                    seen_titles.add(key)
                    all_reviews.append(review)

            print(f"[{star}/{sort}] Sida {page}: {len(page_reviews)} recensioner")

print(f"Totalt antal unika recensioner: {len(all_reviews)}")
Det blir överlapp mellan bucketerna, så dubblettkontroll är avgörande. Jag använder kombinationen recensionstitel + författarnamn som en snabb nyckel — inte perfekt, men den fångar majoriteten av dubbletterna.
Steg 5: Undvik anti-bot-försvaret (rotera, stryp, försök igen)
Amazon använder AWS WAF Bot Control, och det har blivit betydligt mer aggressivt. Enskilda motåtgärder (bara rotera User-Agents, bara lägga in fördröjningar) räcker inte längre.
| Teknik | Implementering |
|---|---|
| Rotera User-Agents | Slumpmässigt val från 10+ verkliga webbläsarsträngar |
| Exponentiell backoff | Fördröjningar på 2s → 4s → 8s vid 503-svar |
| Begäransstrypning | random.uniform(2, 5) sekunder mellan sidor |
| Proxyrotation | Cykla genom residential proxies |
| Sessionsfingeravtryck | Konsekventa cookies + headers per session |
| TLS-impersonering | Använd curl_cffi i stället för standard requests i produktion |
En retry-wrapper redo för produktion:
import time, random

USER_AGENTS = [
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/147.0.0.0 Safari/537.36",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:149.0) Gecko/20100101 Firefox/149.0",
    "Mozilla/5.0 (Macintosh; Intel Mac OS X 15_7_5) AppleWebKit/605.1.15 (KHTML, like Gecko) Version/26.0 Safari/605.1.15",
    "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/146.0.0.0 Safari/537.36",
]

def scrape_with_retries(session, url, max_retries=3):
    for attempt in range(max_retries):
        try:
            session.headers["User-Agent"] = random.choice(USER_AGENTS)
            time.sleep(random.uniform(2, 5))

            response = session.get(url, timeout=15)

            # Upptäck blockeringar
            if "validateCaptcha" in response.url or "Robot Check" in response.text:
                wait = (2 ** attempt) * 5
                print(f"CAPTCHA upptäckt. Väntar {wait}s...")
                time.sleep(wait)
                continue

            if response.status_code in (429, 503):
                wait = (2 ** attempt) * 2
                print(f"Hastighetsbegränsad ({response.status_code}). Väntar {wait}s...")
                time.sleep(wait)
                continue

            if "ap_email" in response.text:
                raise Exception("Inloggningsvägg — cookies har gått ut")

            return BeautifulSoup(response.text, "lxml")

        except Exception as e:
            if attempt == max_retries - 1:
                raise
            print(f"Försök {attempt + 1} misslyckades: {e}")

    return None
En notis om proxies: Amazon blockerar kända datacenter-IP-intervall (AWS, GCP, Azure, DigitalOcean) på nätverksnivå. Om du skrapar fler än några hundra sidor är residential proxies i praktiken ett måste — räkna med 50–200+ USD/månad beroende på volym. För mindre projekt (under 100 förfrågningar/dag) fungerar ofta noggrann strypning från din hem-IP utan problem.
Amazon granskar också TLS-fingeravtryck. Pythons standardbibliotek requests har en välkänd JA3-hash som WAF-system ofta blockerar i förväg. För produktionsskrapor bör du överväga curl_cffi, som imiterar riktiga webbläsares TLS-stackar. För skrapning i tutorials-skala (några hundra sidor) brukar requests med bra headers ofta räcka.
Steg 6: Exportera dina skrapade Amazon-recensioner till CSV eller Excel
När du har samlat in recensionerna är det enkelt att få dem till ett användbart format med pandas:
import pandas as pd

df = pd.DataFrame(all_reviews)
df.to_csv("amazon_reviews.csv", index=False)
print(f"Exporterade {len(df)} recensioner till amazon_reviews.csv")
Exempeloutput:
| author | rating | title | content | date | country | verified |
|---|---|---|---|---|---|---|
| Sarah M. | 5.0 | Bästa köpet i år | Batteriet räcker hela dagen, skärmen är fantastisk... | January 15, 2025 | the United States | True |
| Mike T. | 2.0 | Besviken efter 2 veckor | Laddningsporten slutade fungera... | February 3, 2025 | the United States | True |
| Priya K. | 4.0 | Bra värde för pengarna | Gör allt jag behöver, bara lite lagg i tunga appar... | March 10, 2025 | the United States | False |
För Excel-export: df.to_excel("amazon_reviews.xlsx", index=False) (kräver openpyxl).
För Google Sheets fungerar biblioteket gspread, men det kräver 8+ steg i Google Cloud-konfiguration — skapa ett projekt, aktivera två API:er, generera servicekonto-uppgifter och dela kalkylbladet. Om det låter som mer uppsättning än själva skrapningen, har du inte fel. (Det här är ett sånt läge där ett verktyg som Thunderbit som exporterar till Google Sheets med ett klick börjar se väldigt lockande ut.)
Bonus: Lägg till sentimentanalys i dina skrapade recensioner på 5 rader Python
De flesta scraping-guider slutar vid CSV-export. Men att poängsätta sentiment är det som förvandlar rådata till affärsbeslut.
Det snabbaste basalternativet använder TextBlob:
from textblob import TextBlob

df["sentiment"] = df["content"].apply(lambda x: TextBlob(str(x)).sentiment.polarity)
Det ger dig en polaritetsscore från -1.0 (mycket negativ) till +1.0 (mycket positiv) för varje recension. Exempeloutput:
| content (förkortad) | rating | sentiment |
|---|---|---|
| "Battery lasts all day, screen is gorgeous..." | 5.0 | 0.65 |
| "The charging port stopped working after..." | 2.0 | -0.40 |
| "Does everything I need, minor lag on..." | 4.0 | 0.25 |
| "Absolute garbage. Returned immediately." | 1.0 | -0.75 |
| "It's okay. Nothing special but works." | 3.0 | 0.10 |
De intressanta raderna är avvikelserna — en 3-stjärnig recension med positiv text, eller en 5-stjärnig recension med negativt språk. De här skillnaderna avslöjar ofta nyanserade kundåsikter som stjärnbetyg ensamma missar.
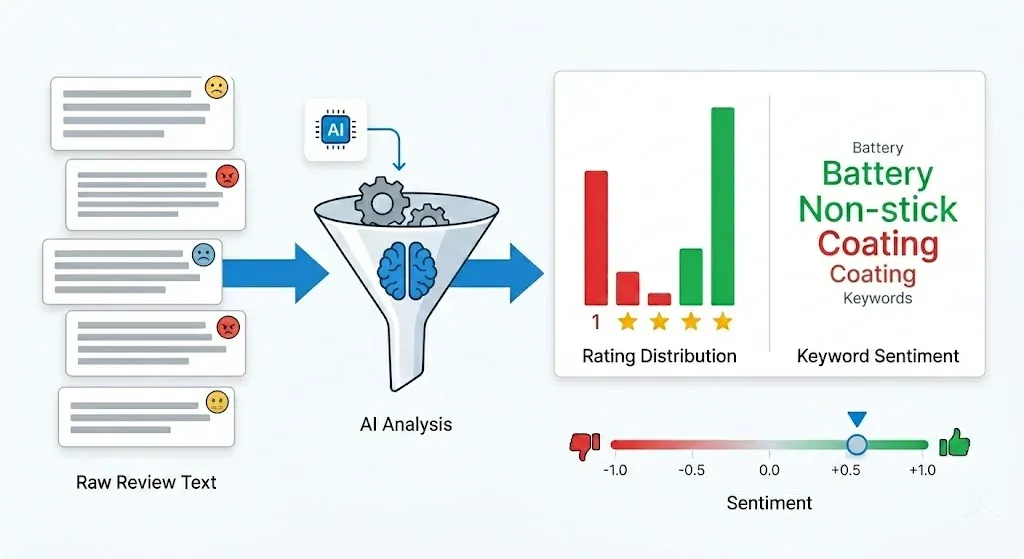
För mer produktionssäker träffsäkerhet rekommenderas Hugging Face Transformers. VADER tränades på tweets, inte produktrecensioner, och transformermodeller når över 98% noggrannhet på recensionsklassificering jämfört med lexikonverktyg. Modellen nlptown/bert-base-multilingual-uncased-sentiment kan till och med förutsäga 1–5 stjärnor direkt:
from transformers import pipeline

clf = pipeline("sentiment-analysis",
               model="nlptown/bert-base-multilingual-uncased-sentiment")
df["predicted_stars"] = df["content"].apply(
    lambda x: int(clf(str(x)[:512])[0]["label"][0])
)
Amazon-recensioner följer en J-formad fördelning — en stor topp vid 5 stjärnor, en mindre topp vid 1 stjärna och en dal i mitten. Det betyder att medelbetyget ofta är en dålig proxy för den faktiska produktkvaliteten. Segmentera klustret med 1-stjärniga recensioner och leta efter återkommande teman — det är ofta där en enda åtgärdbar brist gömmer sig.
Den ärliga avvägningen: egen Python-kod vs. betalda scraping-API:er vs. Thunderbit
Jag har underhållit Python-skrapor för Amazon, och jag ska vara ärlig: de går sönder. Selektorer ändras, cookies går ut, Amazon rullar ut ett nytt lager botdetektering, och plötsligt går din lördagsmorgon åt till att felsöka en skrapa i stället för att analysera data. Forumanvändare beskriver samma frustration — DIY-skript som "fungerade förra månaden" behöver nu ständig patchning.
Så här ser de tre vanligaste angreppssätten ut:
| Kriterium | Egen Python (BS4/Selenium) | Betalt scraping-API | Thunderbit (No-code) |
|---|---|---|---|
| Starttid | 1–3 timmar | 30 min (API-nyckel) | 2 minuter |
| Kostnad | Gratis (+ proxykostnader) | 50–200+ USD/mån | Gratis nivå finns |
| Hantering av inloggningsvägg | Manuellt cookie-hantering | Ofta inbyggt | Hanteras automatiskt |
| Underhåll | Högt (selektorer går sönder) | Lågt (leverantören underhåller) | Inget (AI anpassar sig) |
| Paginering | Kräver egen kod | Inbyggt | Inbyggt |
| Stöd för flera länder | Separata sessioner per domän | Vanligen stöd | Webbläsarbaserat = din lokala miljö |
| Sentimentanalys | Lägg till egen kod | Ibland inkluderat | Exportera till Sheets, analysera var du vill |
| Bäst för | Lärande, full kontroll | Skalbara produktionsflöden | Snabba datautdrag, team utan utvecklare |
Python ger dig full kontroll och är faktiskt det bästa sättet att förstå hur web scraping fungerar under huven. Betalda API:er (ScrapingBee, Oxylabs, Bright Data) är vettiga för produktionsflöden där drifttid är viktigare än kostnad. Och för team som behöver recensionsdata utan utvecklingsbördan — e-handelsdrift som bevakar konkurrentprodukter varje vecka, marknadsteam som hämtar kundspråk till annonser — finns en tredje väg.
Så skrapar du Amazon-recensioner med Thunderbit (ingen kod, inget underhåll)
Vi byggde Thunderbit för precis de här situationerna där det känns överdrivet att underhålla en Python-skrapa. Arbetsflödet ser ut så här:
- Installera Thunderbit Chrome Extension
- Gå till Amazon-sidans recensionsvy i webbläsaren (du är redan inloggad, så inloggningsväggen är inget problem)
- Klicka på "AI Suggest Fields" — Thunderbit läser sidan och föreslår kolumner som Author, Rating, Title, Review Text, Date, Verified Purchase
- Klicka på "Scrape" — datan extraheras direkt, med inbyggd paginering
- Exportera till Excel, Google Sheets, Airtable eller Notion
Den största fördelen är att Thunderbits AI läser sidstrukturen på nytt varje gång. Inga CSS-selektorer att underhålla, ingen cookiehantering, ingen anti-bot-kod. När Amazon ändrar sin HTML anpassar sig AI:n. För läsare som vill ha programmatisk åtkomst utan full DIY erbjuder Thunderbit också ett Extract API — strukturerad dataextraktion via API med AI-driven fältdetektering, utan selektorunderhåll.
För mer fördjupning i Amazon-data, se våra guider om hur man skrapar Amazon-produkter och recensioner och hur man extraherar och analyserar Amazons försäljningsdata.
Tips för att skrapa Amazon-recensioner i stor skala med Python
Om du skrapar recensioner för många ASIN finns det några arbetssätt som sparar dig huvudvärk:
- Batcha dina ASIN med pauser mellan produkterna, inte bara mellan sidorna. Jag använder 10–15 sekunders paus mellan ASIN.
- Ta bort dubbletter aggressivt. När du kombinerar flera stjärnfilter och sorteringslägen får du överlappande recensioner. Använd en uppsättning av
(title, author, date)som dedup-nyckel. - Logga fel. Spåra vilka ASIN + sida + filter-kombinationer som misslyckas så att du kan köra om dem utan att skrapa allt på nytt.
- Lagra i en databas för större projekt. En enkel SQLite-databas skalar mycket bättre än ständigt växande CSV-filer:
import sqlite3

conn = sqlite3.connect("reviews.db")
df.to_sql("reviews", conn, if_exists="append", index=False)
- Schemalägg återkommande skrapningar. För löpande bevakning kan du sätta upp ett cron-jobb eller använda Thunderbits Scheduled Scraper-funktion — beskriv URL och schema, så sköter den resten utan server.
För fler alternativ, se våra inlägg om bästa automatiserade web scraping-verktygen och hur man skrapar data från webbplatser till Excel.
En snabb notis om juridik och etik
Amazons Conditions of Use förbjuder uttryckligen "the use of any robot, spider, scraper, or other automated means to access Amazon Services." Samtidigt har senare amerikansk rättspraxis varit gynnsam för skrapning av offentligt tillgänglig data. I Meta Platforms v. Bright Data (januari 2024) slog en federal domstol fast att skrapning av offentligt tillgänglig data inte bryter mot användarvillkor när skrapan inte är en inloggad "användare".
Nyansen är viktig: skrapning bakom inloggning (vilket den här guiden handlar om) för dig in i kontraktsrättsligt territorium, eftersom du accepterade Amazons användarvillkor när du skapade kontot. Att skrapa offentligt synliga utvalda recensioner innebär lägre juridisk risk än att skrapa bakom inloggningsväggen.
Praktiska riktlinjer: återpublicera inte skrapad data kommersiellt, skrapa inte personuppgifter utöver det som är offentligt synligt, respektera robots.txt och rådfråga jurist vid storskalig eller kommersiell användning. Detta är inte juridisk rådgivning. För mer om det juridiska landskapet, se vår översikt över juridiska implikationer av web scraping.
Slutsats: skrapa Amazon-recensioner med Python eller hoppa över koden helt
Snabb sammanfattning av vad guiden gick igenom:
- Inloggningsväggen är verklig, men går att lösa med cookie-baserad autentisering — kopiera 7 cookies från webbläsaren och mata in dem i en
requests.Session() - Använd
data-hook-selektorer, inte CSS-klasser, för extrahering som inte går sönder varannan vecka - Kombinera stjärnfilter och sorteringsordningar för att kringgå 10-sidorsgränsen och nå 500+ recensioner per produkt
- Lägg till sentimentanalys med TextBlob för en snabb baslinje eller Hugging Face Transformers för produktionsmässig träffsäkerhet
- Underhåll skydd mot botdetektering: strypning, rotation av User-Agent, exponentiell backoff och residential proxies i skala
Python ger dig full kontroll och är det bästa sättet att förstå vad som händer under ytan. Men om ditt use case är "Jag behöver konkurrenters recensionsdata i ett kalkylblad före fredag" snarare än "Jag vill bygga ett produktionsflöde för data", kanske underhållskostnaden för en egen skrapa inte är värd det.
Thunderbit hanterar autentisering, selektorer, paginering och export med några klick — prova gratisnivån och se om den passar ditt arbetsflöde. I takt med att Amazon fortsätter skärpa sina anti-botåtgärder kommer AI-drivna verktyg som anpassar sig i realtid att gå från att vara en trevlig bonus till att bli en nödvändighet.
Du kan också utforska vår Thunderbit YouTube-kanal för videogenomgångar av arbetsflöden för scraping.
Vanliga frågor
1. Kan man skrapa Amazon-recensioner utan att logga in?
Ja, men bara de cirka 8 "utvalda recensioner" som visas på produktsidan (/dp/{ASIN}/). De fullständiga recensionssidorna med sortering, filter och paginering kräver autentisering från slutet av 2024. För de flesta affärsanvändningsfall behöver du hantera inloggningsväggen.
2. Är det lagligt att skrapa Amazon-recensioner?
Amazons användarvillkor förbjuder automatiserad scraping. Samtidigt stödjer nylig amerikansk rättspraxis (Meta v. Bright Data, 2024; hiQ v. LinkedIn) skrapning av offentligt tillgänglig data. Skrapning bakom inloggning innebär högre juridisk risk eftersom du har godkänt Amazons användarvillkor. Rådfråga jurist för kommersiell användning.
3. Hur många Amazon-recensioner kan jag skrapa per produkt?
Amazon begränsar recensionssidor till 10 per sorteringsordning och stjärnfilterkombination. Med alla 5 stjärnfilter × 2 sorteringsordningar kan du nå upp till 100 sidor (ungefär 1 000 recensioner) per produkt. Med nyckelordsfilter är det teoretiska taket mycket högre, men då med betydande dubbletter.
4. Vilket är det bästa Python-biblioteket för att skrapa Amazon-recensioner?
requests + BeautifulSoup för statisk HTML-parsning är den vanligaste och mest pålitliga kombinationen. Selenium är användbart när JavaScript-rendering krävs. För ett no-code-alternativ som hanterar inloggningsväggar och paginering automatiskt, prova Thunderbit.
5. Hur undviker jag att bli blockerad när jag skrapar Amazon?
Rotera User-Agent-strängar från en pool med 10+ riktiga webbläsarsträngar, lägg till slumpmässiga pauser på 2–5 sekunder mellan förfrågningar, implementera exponentiell backoff vid 503/429-fel, använd residential proxies i skala (datacenter-IP:er blockeras ofta i förväg) och håll konsekventa sessionscookies mellan förfrågningar. För en underhållsfri metod hanterar Thunderbit botförsvaret automatiskt via din webbläsarsession.
Läs mer



