
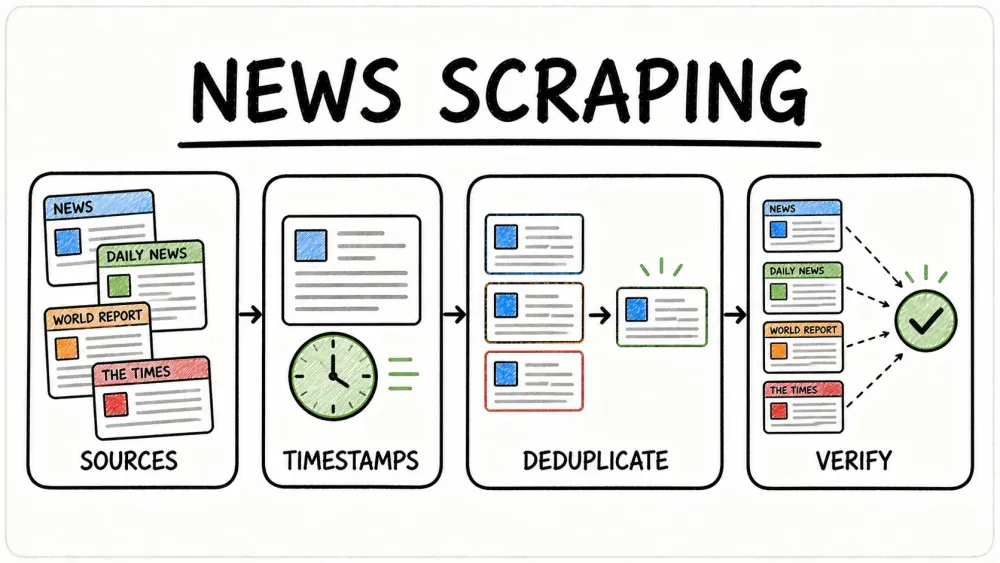
Takten i dagens digitala nyhetsflöde är nästan svindlande. Varje minut publiceras, uppdateras eller redigeras tusentals rubriker i det tysta — på stora nyhetssajter, nischade bloggar och i sociala flöden.
För att sätta det i perspektiv hämtar LexisNexis Newsdesk in över 4 miljoner nyhetsartiklar varje dag, medan GDELT Project bevakar nyheter på 100+ språk och uppdaterar sitt globala flöde var 15:e minut.
För alla som jobbar med media, forskning eller business intelligence är det ungefär som att försöka ösa vatten ur ett sjunkande skepp med en kaffemugg att försöka hänga med manuellt.
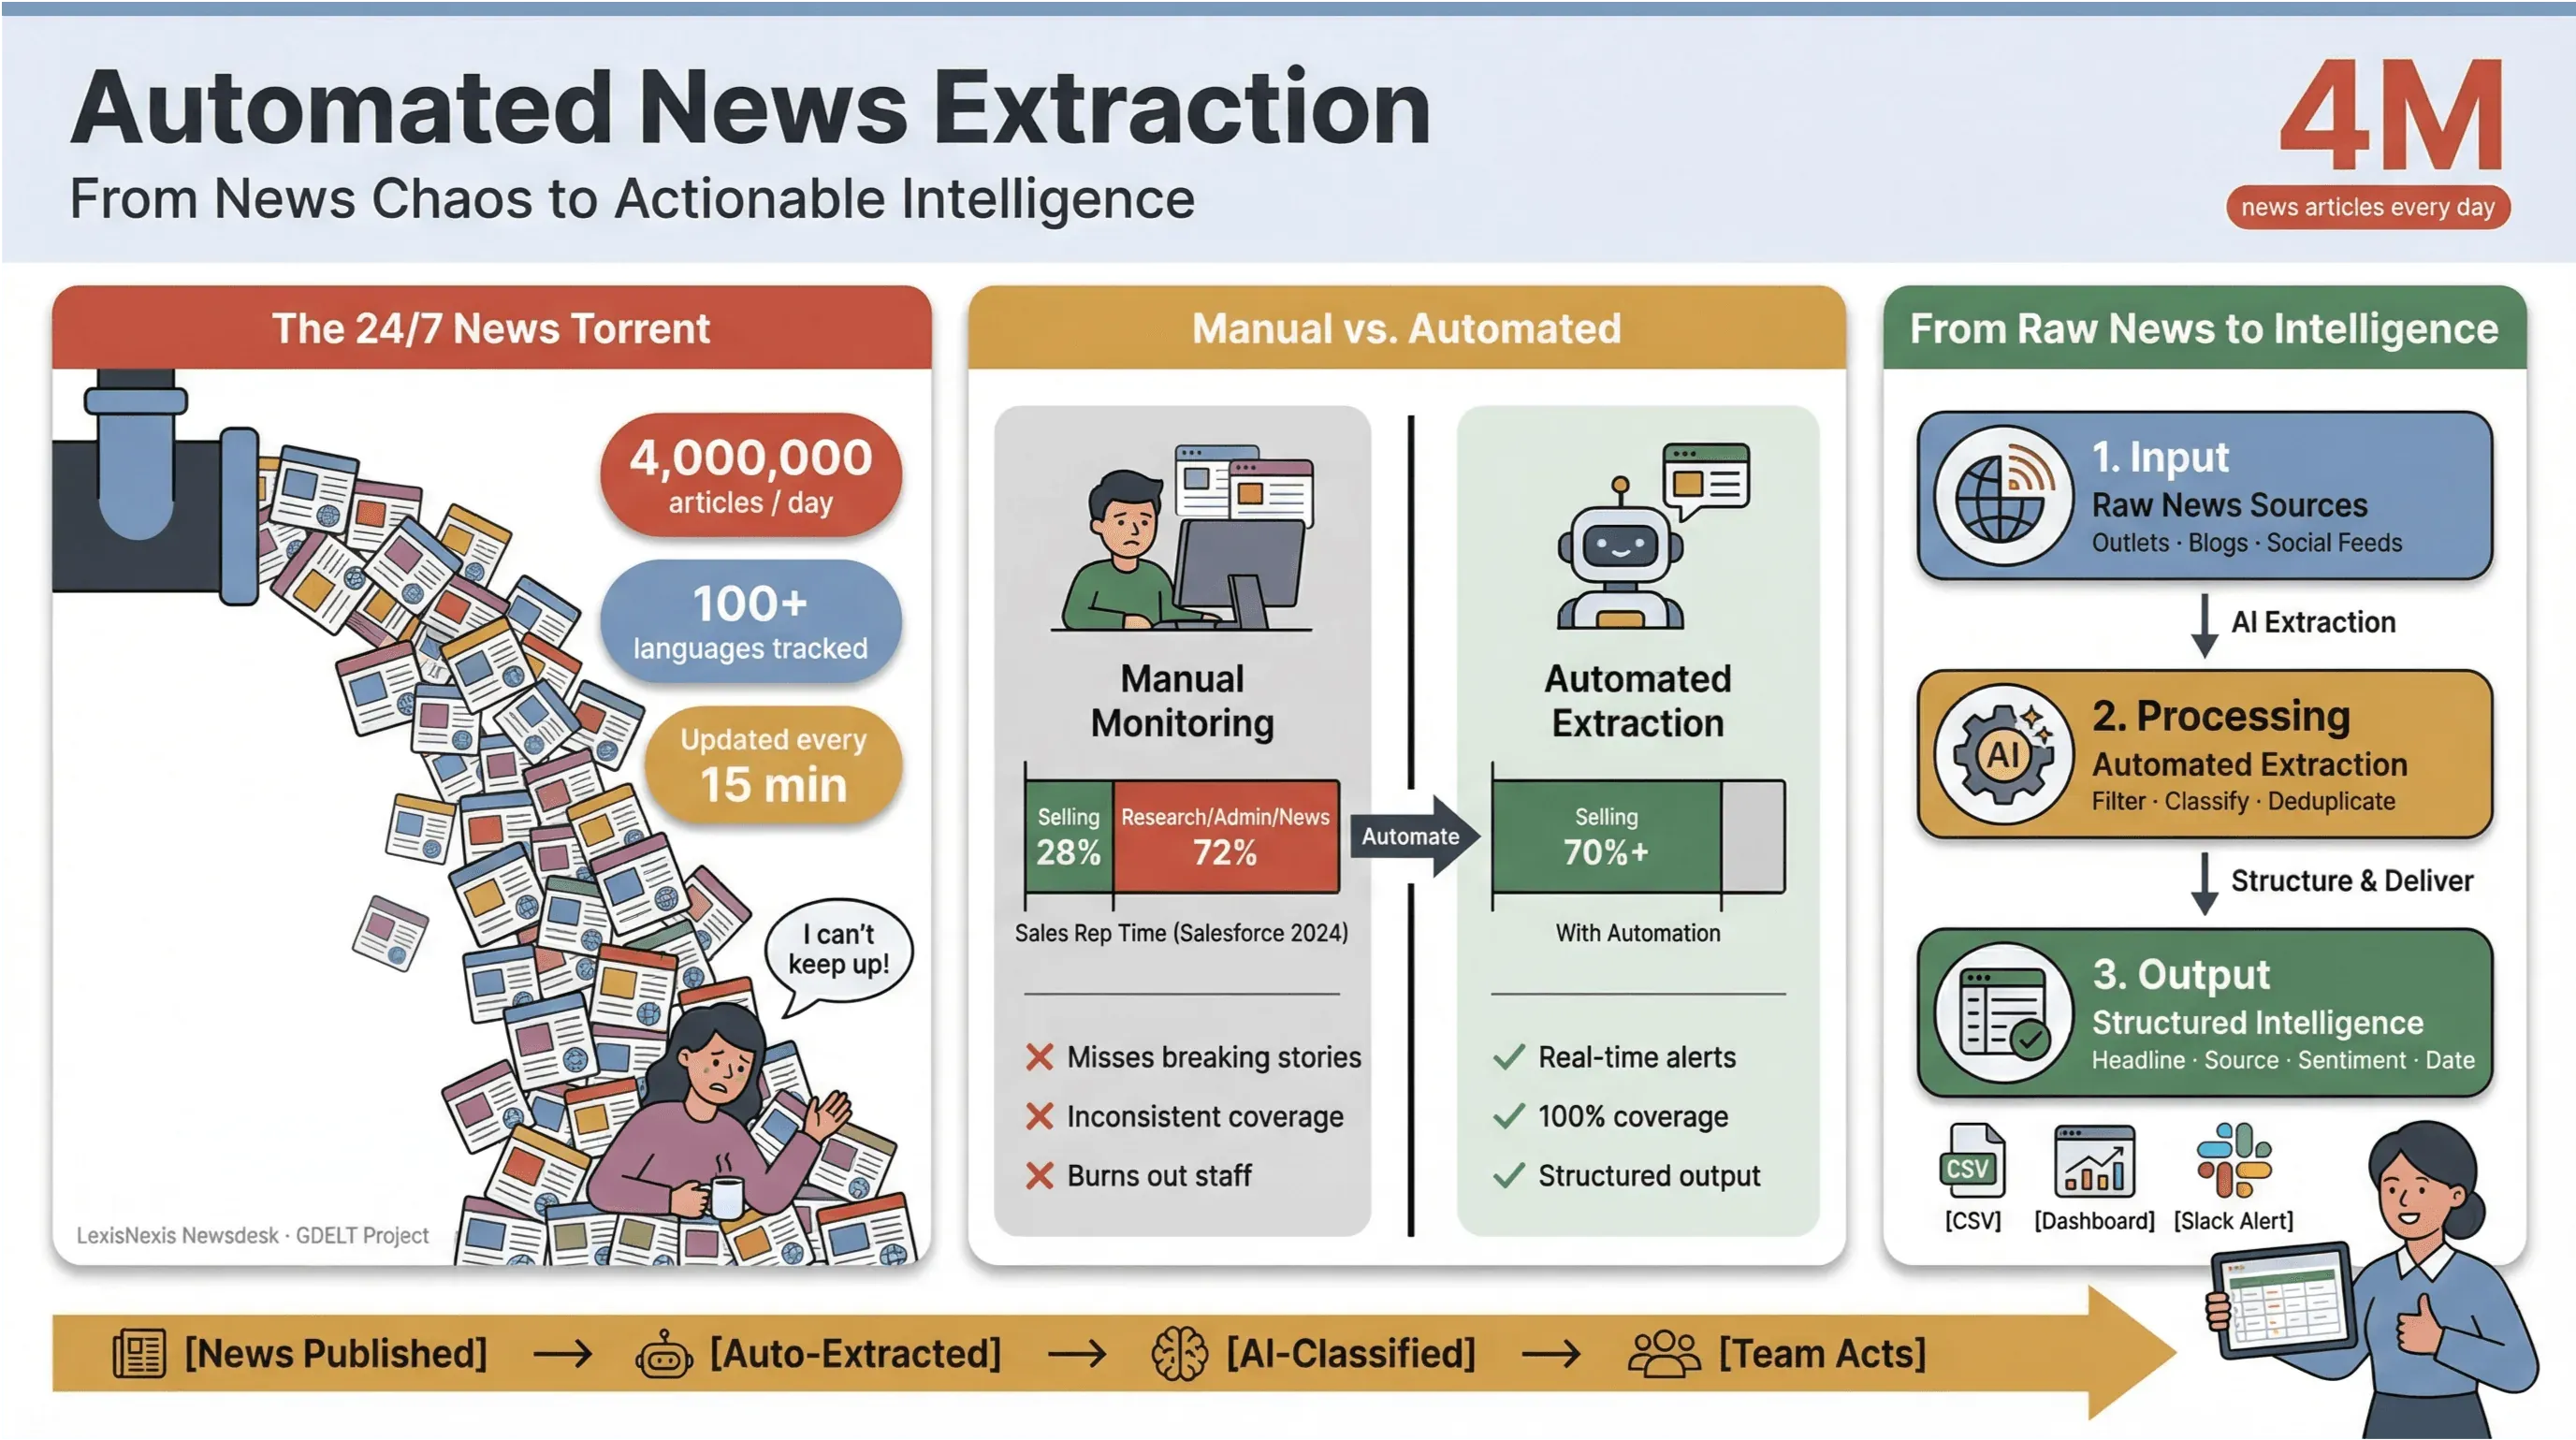
Jag har själv sett hur manuell nyhetsbevakning slukar både tid och resurser. Säljteam lägger mindre än en tredjedel av sin vecka på själva försäljningen — bara 28 % enligt Salesforce — medan resten försvinner i research, administration och, ja, ett oändligt växlande mellan nyhetsflikar.
Därför har automatiserad nyhetsextraktion blivit det moderna teamets hemliga vapen: det är i praktiken enda sättet att förvandla 24/7-nyhetscykelns kaos till strukturerad, handlingsbar intelligence — utan att köra slut på personalen eller missa de viktigaste nyheterna.
Låt oss gå igenom vad automatiserad nyhetsextraktion egentligen innebär, varför den är avgörande för alla som bryr sig om realtidsdata från nyheter, och hur du bygger ett robust och compliant arbetsflöde med de bästa verktygen (inklusive hur Thunderbit gör hela processen förvånansvärt enkel — även för icke-tekniska användare som min mamma).
Testa Thunderbit för automatiserad nyhetsextraktion Rubrik, tidsstämpel, författare och sammanfattning från vilken nyhetssida som helst — klicka en gång och schemalägg upprepning. Get Started Free
Automatiserad nyhetsextraktion: därför är den avgörande för moderna nyhetsredaktioner
Automatiserad nyhetsextraktion är precis vad det låter som: att använda programvara för att samla in nyhetsinnehåll automatiskt och göra om det till strukturerad, sökbar data — tänk rader och kolumner i stället för röriga webbsidor eller PDF-filer. I praktiken betyder det att du kan bevaka hundratals (eller tusentals) källor, plocka ut viktiga fält som rubrik, tidsstämpel, författare och brödtext, och mata in datan i dashboards, aviseringar eller vidare analys — utan att någonsin behöva använda Ctrl+C/Ctrl+V.
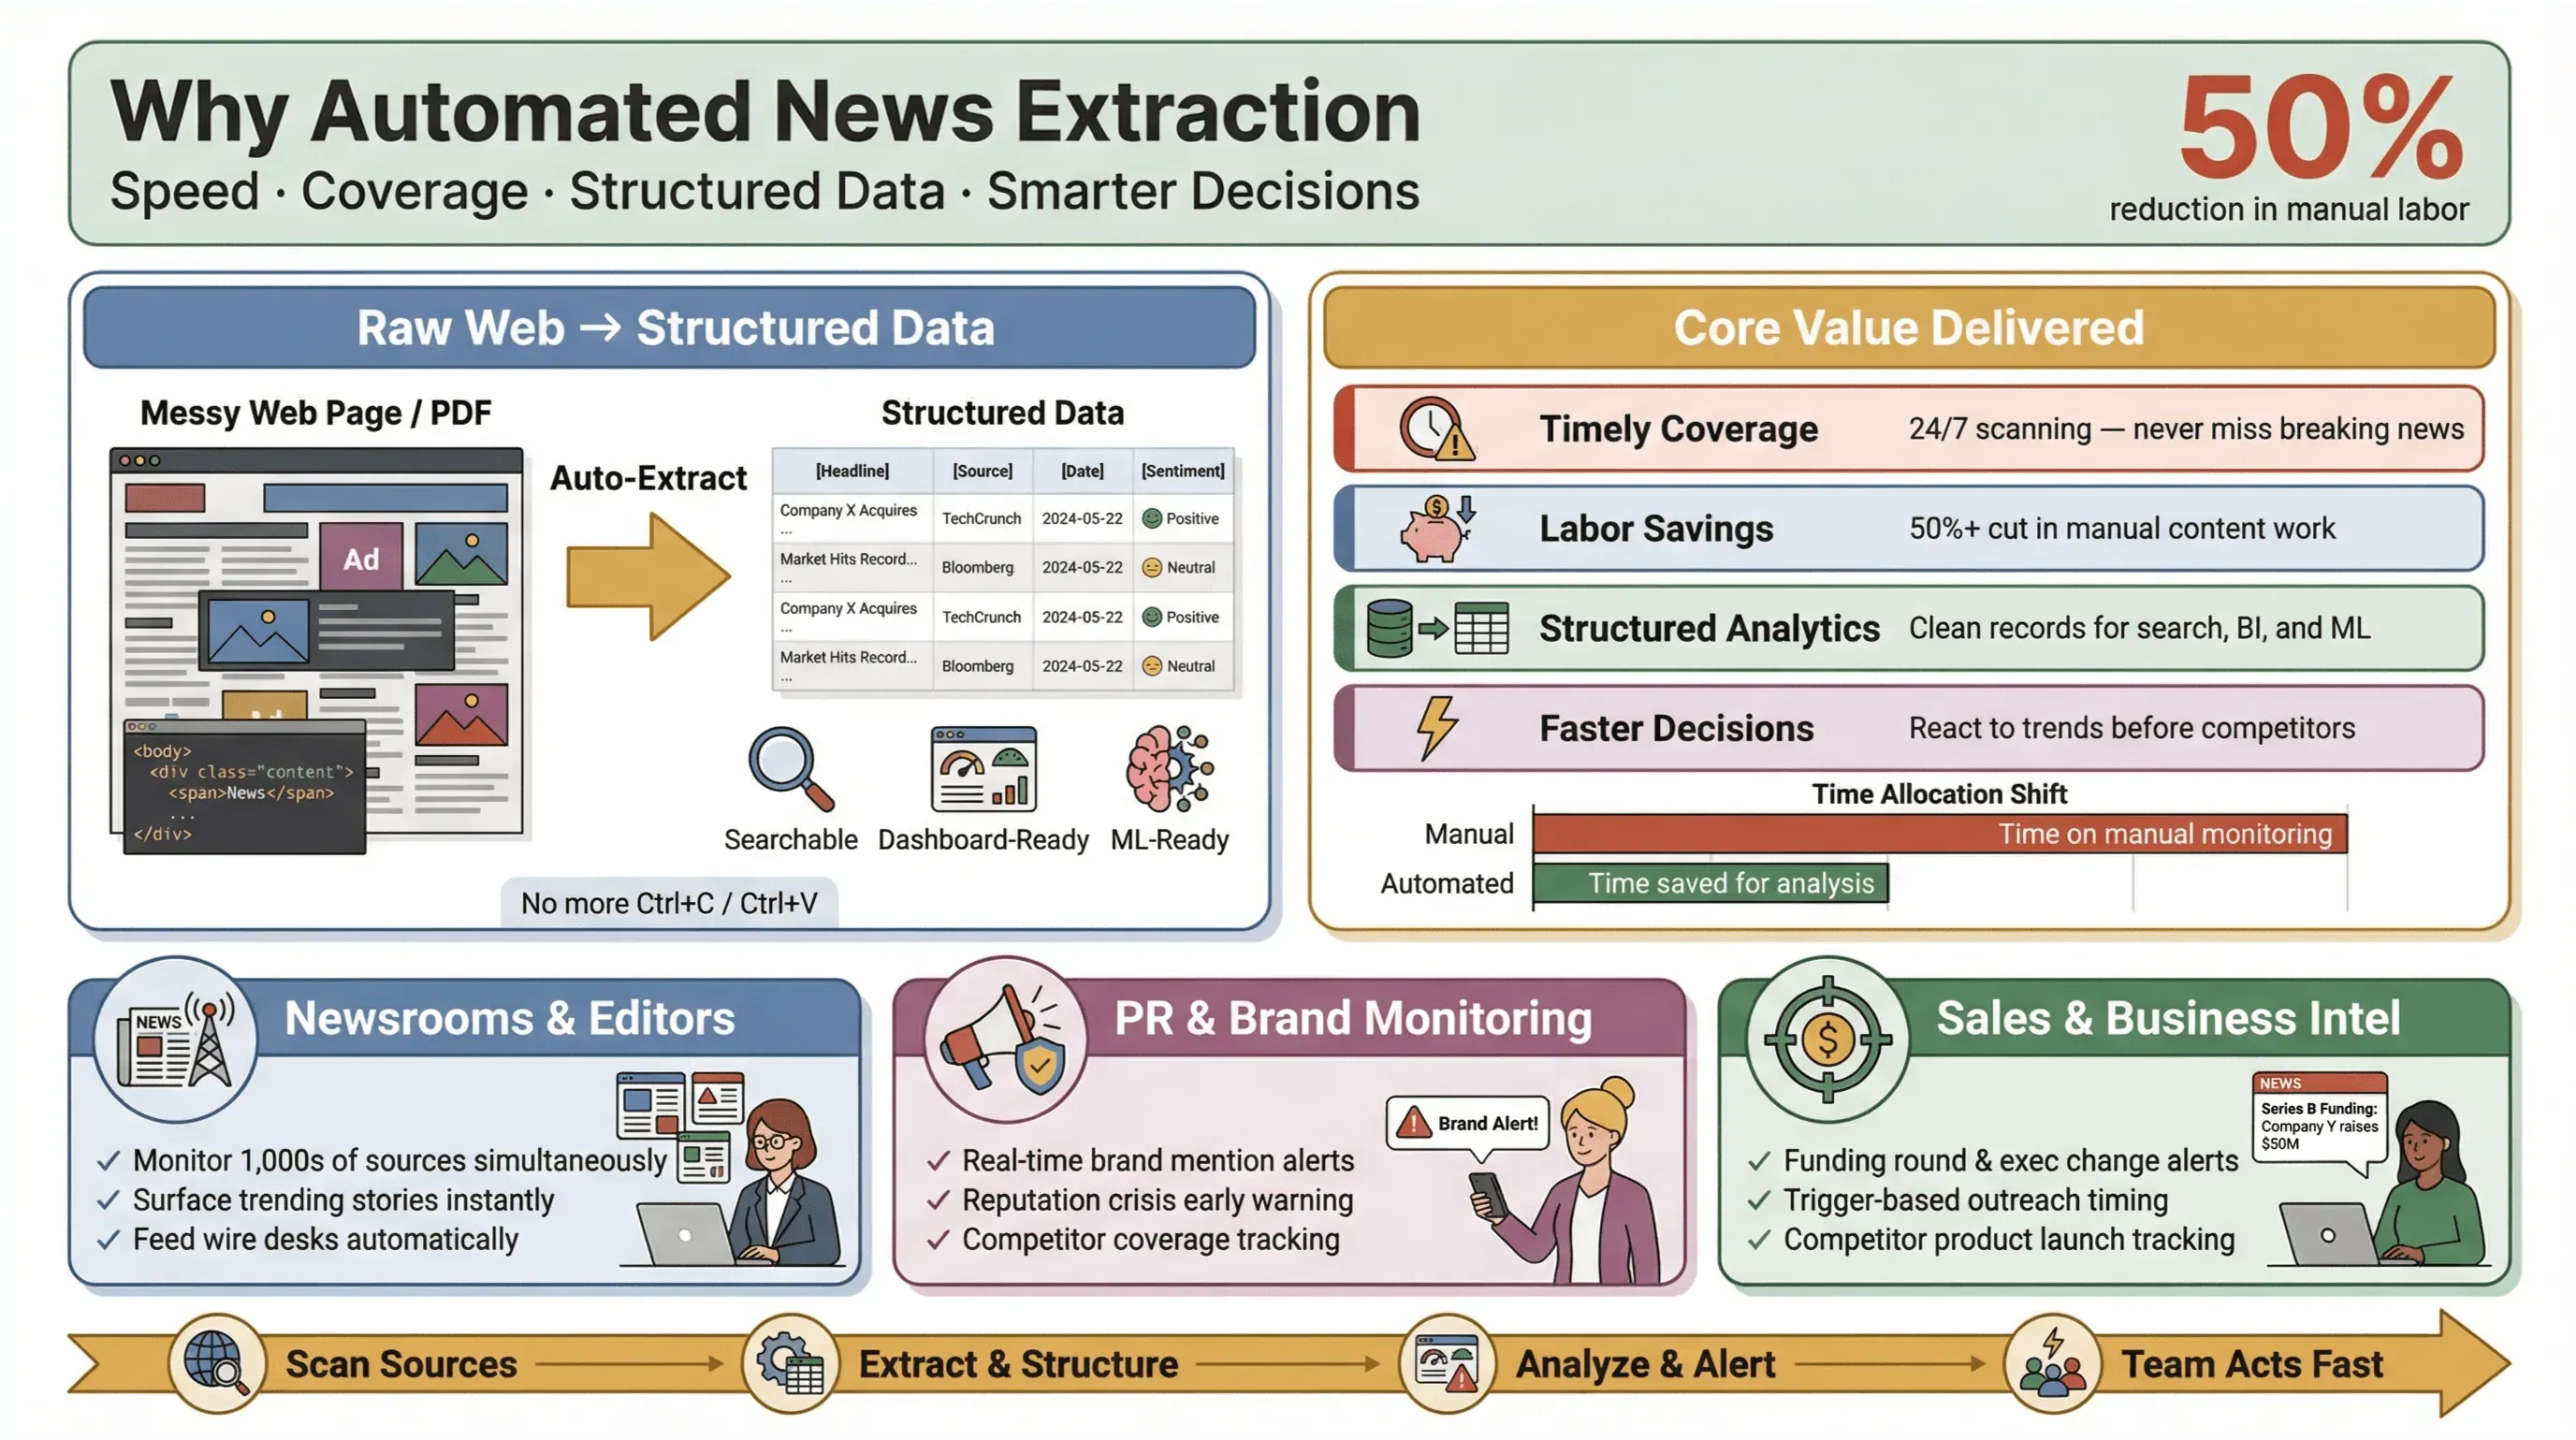 Varför spelar det här roll? För att snabbhet är allt i dagens nyhetslandskap. Oavsett om du är redaktör på en nyhetsredaktion, PR-ansvarig som bevakar varumärkesomnämnanden eller affärsanalytiker som följer konkurrenters drag, kan den som får reda på något först avgöra om du tar en möjlighet eller får jaga ikapp. Automatiserade verktyg för nyhetsextraktion gör att även små team kan jobba långt över sin viktklass — de samlar in nyhetsdata i realtid från hela webben, minskar manuellt arbete och lyfter fram de berättelser som faktiskt spelar roll.
Och effekten är tydlig: studier visar att automatisering kan minska manuellt arbete för innehållsuppdateringar med minst 50 %, vilket frigör tid för riktig analys och beslutsfattande.
Det centrala värdet av automatiserad nyhetsextraktion i nyhetsbranschen
Låt oss vara konkreta. Vad ger automatiserad nyhetsextraktion egentligen för nyhetsredaktioner och affärsteam?
- Snabb och heltäckande bevakning: Inga fler missade breaking news bara för att någon glömde kolla ett flöde. Automatiska verktyg skannar källor dygnet runt så att du inte missar något.
- Tids- och kostnadsbesparingar: Små och medelstora team kan bevaka lika många källor som de stora aktörerna — utan att behöva anställa en armé av praktikanter.
- Strukturerad data för analys: I stället för att tröska igenom ostrukturerade artiklar får du rena, strukturerade poster redo för sök, dashboards och maskininlärning.
- Snabbare och smartare beslut: Nyhetsdata i realtid gör att du kan reagera på marknadsskiften, PR-kriser eller nya trender innan konkurrenterna gör det.
Ta PR och kommunikation: plattformar som Cision och Meltwater lyfter realtidsbevakning av media som avgörande för att skydda varumärkets rykte och agera snabbt på negativ exponering. Inom försäljning blir nyhetslarm i realtid till ”context cards” för prospektering — tänk finansieringsrundor, chefsbyten eller produktlanseringar som triggar rätt uppföljning vid rätt tillfälle.
Så väljer du rätt verktyg för nyhetsscraping i olika scenarier
Alla verktyg för nyhetsscraping är inte skapade lika. Rätt val beror på dina mål, din tekniska komfort och vilka typer av nyheter du bryr dig om. Här är ett ramverk som hjälper dig att välja rätt:
- Utvärdera användarvänlighet och tillgänglighet
- Säkerhet och dataskydd
- Matcha verktyg med nyhetstyper och branschbehov
Utvärdera användarvänlighet och tillgänglighet
För de flesta affärsanvändare och journalister är enkel användning helt avgörande. Du vill ha ett verktyg som fungerar direkt, utan kod eller krånglig installation. No-code- och low-code-plattformar som Thunderbit, Octoparse och ParseHub låter dig bygga scrapers visuellt — peka, klicka och extrahera.
Thunderbit sticker särskilt ut med sitt ett-klicksflöde: klicka på One Click Extract så läser AI:n sidan, räknar ut vilka fält som behövs och hämtar dem. Även icke-tekniska användare kan sätta upp ett flöde för nyhetsdata på minuter, inte timmar.
Säkerhet och dataskydd
Med bra data följer ansvar. Verktyg för nyhetsscraping jobbar ofta mot känsligt innehåll, så säkerhet och efterlevnad måste ligga högt på listan. Leta efter:
- Datakryptering (under överföring och lagring)
- Tydliga integritetspolicyer (Thunderbit uppger till exempel att de inte säljer användardata och bara kommer åt det innehåll du själv väljer att extrahera)
- Detaljerade behörigheter (särskilt för webbläsartillägg — kontrollera alltid vilken data verktyget kan komma åt)
- Efterlevnad av lokala lagar (GDPR, CCPA och för EU-användare DSM Copyright Directive)
För extra trygghet: välj etablerade leverantörer, granska tilläggens behörigheter och begränsa åtkomsten till det som faktiskt behövs.
Matcha verktyg med nyhetstyper och branschbehov
Vissa verktyg är bättre på specifika nyhetsdomäner:
- Finans: API:er som News API och AYLIEN erbjuder klustring, sentimentanalys och händelsedetektering för finansnyheter.
- Tech och startups: Anpassad scraping med Thunderbit eller Octoparse låter dig rikta in dig på nischade bloggar, pressmeddelanden eller evenemangslistor.
- Politik och policy: Licensierade databaser som Factiva och LexisNexis ger tillgång till premiumkällor och arkiv.
Om du behöver bevaka en blandning av stora, nischade och internationella källor — även sådana utan API:er — är flexibla AI-drivna scrapers som Thunderbit det bästa valet.
Thunderbits unika fördelar för extraktion av nyhetsdata i realtid
Extrahera nyhetsdata i realtid med Thunderbit AI:n läser sidan och identifierar fälten — inget underhåll av selektorer när en publicist gör om designen. Get Started Free
Nu ska vi prata om vad som gör Thunderbit till ett utmärkt val för automatiserad nyhetsextraktion — särskilt om du vill ha nyhetsdata i realtid utan de tekniska huvudvärken.
Thunderbit är ett AI-drivet web scraper-tillägg för Chrome som är byggt för affärsanvändare, journalister och analytiker som behöver aktuell, strukturerad nyhetsdata från vilken webbplats som helst. Här är varför det har blivit mitt förstahandsval:
- One Click Extract: Thunderbit läser nyhetssidan och räknar ut de bästa kolumnerna att extrahera — rubrik, tidsstämpel, författare, sammanfattning och mer. Du slipper pilla med selektorer eller mallar.
- Extrahering av undersidor: Behöver du hela artikeln, inte bara rubriken? Thunderbit kan besöka varje nyhetslänk, extrahera brödtext, entiteter och taggar och slå ihop allt till en enda strukturerad tabell.
- Massexport och omedelbara uppdateringar: Exportera nyhetsdata direkt till Excel, Google Sheets, Airtable eller Notion med ett klick. Inga fler kopieringsmaraton eller CSV-strul.
- Schemalagd scraping: Ställ in återkommande körningar (timvis, dagligen eller i egna intervall) för att hålla nyhetsflödet färskt — perfekt för breaking news, marknadsbevakning eller löpande research.
- Anpassningsförmåga: Thunderbits AI anpassar sig till layoutändringar och nischade nyhetssajter, så du lägger mindre tid på att laga trasiga scrapers och mer tid på att analysera data.
Med 100 000+ användare i Chrome Web Store används det av PR-team, säljanalytiker och analytiker som behöver nyhetsdata utan att behöva passa en scraper hela dagarna.
AI-driven fältidentifiering och extrahering av undersidor
En av Thunderbits starkaste funktioner är dess AI-drivna fältidentifiering. Klicka bara på “One Click Extract” så skannar verktyget nyhetssidan — och identifierar viktiga fält som titel, datum, författare och sammanfattning. Du kan finjustera eller lägga till egna fält (till exempel “märk den här artikeln som ‘earnings’ om den nämner kvartalsresultat”), och sedan sköter Thunderbits AI resten.
Extrahering av undersidor är en riktig gamechanger för nyheter: skrapa en startsida eller en sektion med rubriker och låt sedan Thunderbit besöka varje artikel-URL för att extrahera hela texten, entiteter och till och med bilder. Det innebär att du får fullständiga, berikade nyhetsposter — redo för sök, dashboards eller vidare AI-analys.
Massexport och omedelbara uppdateringar
Thunderbit gör export av nyhetsdata smidig. Med ett klick kan du skicka ditt strukturerade nyhetsflöde till Google Sheets, Airtable eller Notion, eller ladda ner som CSV/Excel. För team som lever i kalkylblad eller BI-verktyg sparar det enormt mycket tid.
Och eftersom Thunderbit stöder schemalagd scraping kan du köra det varje timme, varje dag eller enligt ditt eget schema — så att nyhetsdatan alltid är uppdaterad. Inget mer väntande på att Google Alerts ska indexera artiklar dagar för sent.
Så övervinner du operativa utmaningar i lösningar för nyhetsdata i realtid
Även med de bästa verktygen kommer nyhetsextraktion i realtid med sina egna utmaningar. Så här hanterar du de vanligaste:
Hantera latens och färsk data
- Schemalägg scraping utifrån nyhetsflödets hastighet: För breaking news kan scrapers köras var 15–30 minut (i linje med GDELT Projects uppdateringscykel). För långsammare bevakningsområden räcker det ofta med dagligen eller varje timme.
- Övervaka fördröjningen mellan publicering och hämtning: Följ skillnaden mellan när en artikel publiceras och när ditt system hämtar den. Om fördröjningen ökar, kontrollera om något blockeras eller går långsamt.
- Skrapa om för “tysta redigeringar”: Nyhetsartiklar uppdateras ofta efter publicering. Schemalägg en andra scraping 24 timmar senare för att fånga rättelser eller dolda ändringar (GDELT gör detta medvetet).
Hantera API-gränser och variation mellan källor
- Respektera API-kvoter: Om du använder nyhets-API:er, håll koll på rate limits — sprid ut begäranden över tid och cacha resultat när det går (News API-dokumentationen).
- Ta bort dubbletter och normalisera: Nyhetsartiklar visas ofta på flera URL:er eller uppdateras. Spara kanoniska URL:er och använd hashvärden (t.ex. titel + datum) för att undvika dubbletter (Googles guide om kanonisering).
- Hantera dynamiskt innehåll: För sajter med oändlig scroll eller lazy loading bör du använda verktyg som stöder dynamisk rendering och bevaka layoutändringar (Octoparse guide).
Smart analys av nyhetsdata: AI och maskininlärning i praktiken
Att extrahera nyheter är bara första steget. Det verkliga värdet kommer när du analyserar och agerar på datan — och där glänser AI och maskininlärning.
- Entitetsutvinning: Använd NLP för att plocka ut personer, organisationer och platser som nämns i varje artikel (Google Clouds guide).
- Ämnesklassificering: Tagga automatiskt artiklar efter ämne, sentiment eller brådskande grad — vilket ger smartare dashboards och aviseringar (AYLIENs taxonomidokumentation).
- Händelseklustring: Gruppera dubbla eller relaterade nyheter från olika medier så att du ser helheten, inte bara ett flöde av nästan identiska rubriker.
- Personalisering och målgruppsanpassning: Använd nyhetsdata i realtid för att segmentera målgrupper, förbättra annonsering eller rekommendera innehåll — vilket ökar engagemang och ROI.
Till exempel använder PR-team realtidsanalys av nyheter för att upptäcka växande kriser innan de sprids viralt, medan säljteam berikar prospektlistor med ”trigger events” som finansieringsrundor eller nyanställningar på ledningsnivå.
Checklista med bästa praxis för automatiserad nyhetsextraktion
Här är en snabb checklista som hjälper dig hålla nyhetsflödet igång utan problem:
| Bästa praxis | Varför det är viktigt | Hur du gör |
|---|---|---|
| Schemalägg frekventa körningar | Minska datadröjsmål, fånga breaking news | Matcha uppdateringsfrekvensen med nyhetsflödets hastighet (t.ex. var 15:e minut för snabba områden) |
| Använd AI-driven extraktion | Anpassar sig till layoutändringar och minskar uppsättningstiden | Verktyg som Thunderbit, Diffbot, Zyte API |
| Ta bort dubbletter och normalisera | Undvik dubbla aviseringar och säkra ren data | Spara kanoniska URL:er, använd hash för deduplicering |
| Övervaka extraktionskvalitet | Upptäck saknade fält, avvikelser eller fel | Följ andelen kompletta poster, fördröjning och felfrekvens |
| Respektera juridik och compliance | Minska juridisk risk och behåll förtroendet | Föredra officiella API:er/flöden, granska villkor, minimera persondata |
| Exportera till strukturerade format | Möjliggör vidare analys | CSV, Excel, Sheets, Notion, Airtable |
| Schemalägg omkörningar för ändringar | Fånga uppdateringar efter publicering | Återbesök artiklar efter 24 h/1 vecka (GDELT-modellen) |
| Säkra ditt flöde | Skydda känslig data | Kryptering, åtkomstkontroller, pålitliga verktyg |
Bygg ett robust arbetsflöde för automatiserad nyhetsextraktion
Redo att bygga din egen ”svarta låda” för nyhetsdata? Här är ett steg-för-steg-flöde:
- Identifiera dina källor: Lista de nyhetssajter, bloggar eller API:er du vill bevaka.
- Sätt upp extraktionen: Använd Thunderbit eller ditt valda verktyg för att definiera fält (One Click Extract gör detta enkelt).
- Schemalägg scraping: Sätt frekvensen efter nyhetsflödets hastighet — varje timme för breaking news, dagligen för långsammare bevakning.
- Berika på undersidor: För varje rubrik, skrapa hela artikeln för brödtext, entiteter och taggar.
- Ta bort dubbletter och normalisera: Spara kanoniska URL:er, hasha poster och standardisera fält.
- Exportera och integrera: Skicka strukturerad data till Excel, Google Sheets, Airtable eller Notion för analys.
- Övervaka och anpassa: Följ extraktionskvalitet, bevaka layoutändringar och justera vid behov.
- Håll dig compliant: Granska villkor, respektera robots.txt och minimera persondata.
För att visualisera flödet, tänk: Källor → Extraktion (AI-fält) → Berikning av undersidor → Deduplicering → Export → Analys/Aviseringar → Övervakning
Slutsats och viktigaste lärdomar
Förvandla vilken nyhetssida som helst till en tabell Gratis att komma igång, inget kort behövs. Email Extractor, Phone Number Extractor och Image Extractor ingår i alla planer. Get Started Free
Automatiserad nyhetsextraktion är inte längre bara något “bra att ha” — det är ett måste för alla som behöver ligga steget före i en värld där nyheter bryter ut och ändras varje minut. Genom att följa bästa praxis och använda rätt verktyg kan du förvandla det digitala nyhetsflödet från en brandslang till en jämn ström av handlingsbar, strukturerad intelligence.
Viktigaste lärdomar:
- Online-nyheternas skala och tempo kräver automatisering — manuell bevakning hinner helt enkelt inte med.
- Automatiserade verktyg för nyhetsextraktion sparar tid, minskar kostnader och gör att små team kan matcha bevakningen hos betydligt större organisationer.
- Rätt verktyg handlar om en balans mellan användarvänlighet, säkerhet och anpassningsförmåga — Thunderbit sticker ut med sin AI-drivna enkelhet och sina exportmöjligheter i realtid.
- Bygg ditt arbetsflöde kring färskhet, deduplicering, compliance och kvalitetsövervakning för att säkerställa pålitlig, handlingsbar nyhetsdata.
- AI och maskininlärning öppnar för ännu större värde — smartare målgruppsanpassning, personalisering och beslutsfattande.
Om du fortfarande kopierar och klistrar in rubriker eller väntar på att Google Alerts ska visa nyheter ett dygn för sent, är det värt att testa ett automatiserat arbetsflöde. Installera det kostnadsfria Chrome-tillägget, peka det mot tre eller fyra källor du kollar varje morgon och se om den strukturerade exporten sparar så mycket tid som du tror. För fler tips, arbetsflöden och fördjupningar, kolla in Thunderbit Blog.
Extrahera nyhetssajter med Thunderbit Schemalägg det och låt det bevaka de källor som är viktiga för dig. Exporter går direkt till Sheets, Excel, Airtable eller Notion. Get Started Free
Vanliga frågor
1. Vad är automatiserad nyhetsextraktion och hur fungerar det?
Automatiserad nyhetsextraktion är processen att använda programvara för att samla in nyhetsartiklar och omvandla dem till strukturerad data (som tabeller eller JSON) för analys, sökning eller aviseringar. Verktyg som Thunderbit använder AI för att identifiera viktiga fält (rubrik, tidsstämpel, författare, brödtext) och extrahera dem automatiskt från webbsidor eller API:er.
2. Varför är nyhetsdata i realtid så viktigt för företag?
Nyhetsdata i realtid gör att företag snabbt kan reagera på marknadshändelser, PR-kriser eller konkurrenters drag. Oavsett om du jobbar med försäljning, PR eller research gör uppdaterade nyheter att du kan fatta smartare och snabbare beslut och ligga före konkurrenterna.
3. Hur gör Thunderbit nyhetsscraping enklare för icke-tekniska användare?
Thunderbit erbjuder ett enkelt ett-klicksflöde: klicka på One Click Extract så räknar AI:n ut vad som ska hämtas. Med funktioner som extrahering av undersidor och omedelbar export till Excel eller Google Sheets kan även icke-tekniska användare bygga robusta nyhetsdatapipelines på några minuter.
4. Vilka juridiska och compliance-relaterade aspekter bör man tänka på vid nyhetsscraping?
Granska alltid användarvillkoren för de sajter du vill bevaka, föredra officiella API:er eller flöden när det finns, och respektera robots.txt. Undvik att skrapa inloggningsskyddat eller betalväggat innehåll utan tillstånd, och minimera insamlingen av persondata för att följa integritetslagar.
5. Hur kan jag säkerställa att mitt arbetsflöde för nyhetsextraktion förblir pålitligt över tid?
Schemalägg regelbundna körningar, övervaka extraktionskvaliteten och använd verktyg som anpassar sig till layoutändringar (som Thunderbits AI-drivna extraktion). Ta bort dubbletter, följ fördröjningen mellan publicering och extraktion och sätt upp aviseringar för fel eller saknade fält så att flödet hålls friskt och uppdaterat.
Testa Thunderbit AI Web Scraper Get Started Free
Läs mer
- 10 automatiserade web scraping-verktyg som sparade mitt team timmar (2026)
- Topp 5 bästa program för web data scraping 2026
- 15 bästa verktygen för dataextraktion 2026: den ultimata kortlistan för varje team
- De bästa article scrapers 2026: en praktisk jämförelse
- Så bemästrar du automatiserad data scraping med Thunderbit




