MarkItDown hamnar ofta i samma fack som webbscrapare, men det är fel kategori. Den har ingen crawler, ingen JavaScript-motor och inget sätt att hämta en URL och rensa bort sidans boilerplate. Det den gör är att ta bytes du redan har — en PDF, ett Word-dokument, ett kalkylblad, en presentation — och omvandla allt till Markdown som en språkmodell kan läsa.
Jag ägnade ett par veckor åt att köra Microsofts MarkItDown genom en uppsättning verkliga dokument på en ensam Mac, där jag betygsatte varje tabell mot ett manifest jag skrivit före körningen och tajmade varje konvertering. Den korta versionen: på rena källor är det snabbt och träffsäkert, paketeringen döljer en 73 MB stor maskininlärningsruntime som du kanske inte bad om, och tabellerna går sönder på sätt som klarar ett ”överlevde texten?”-test men misslyckas med ”hamnade datan i rätt kolumn?”-testet. Här är hela bilden, med siffrorna.
Vad MarkItDown faktiskt är
MarkItDown är ett Python-verktyg från Microsoft som konverterar filer och Office-dokument till Markdown optimerat för LLM:er. Peka det mot en PDF, en .docx, en .xlsx, en .pptx, en bild, en HTML-fil eller några andra format, så får du tillbaka Markdown. Det finns tre sätt att använda det: via CLI (markitdown file.pdf -o out.md, eller med input via stdin), via Python API (MarkItDown().convert(...)) och som en valfri MCP-server för agentflöden.
Det viktigaste att förstå är vad det inte gör, eftersom README:n inte påstår det och jag bekräftade det i testerna: ingen crawling, ingen JS-rendering, ingen länkföljning, ingen paginering och ingen extraktion av huvudtext som i en readability-lösning. Det är en konverterare för hela dokument. Du tar med bytes; den standardiserar dem. Just den skillnaden avgör om verktyget hör hemma i din stack eller inte, så jag kommer att återkomma till den.
Själva repot är tungviktigt enligt GitHubs fåfängemått — 165 282 stjärnor och 11 790 forks i mitten av juli 2026, MIT-licensierat, med senaste releasen (v0.1.6) ute den 2026-05-26. Men stjärnantalet speglar mest att det är ett Microsoft-repo som rider på allmän entusiasm kring LLM-verktyg, inte att konverteringsdelen är mogen. Det finns också 833 öppna ärenden, och några av dem spelar faktiskt roll innan du installerar (mer om det nedan).
HTML till Markdown: snabbt och komplett, boilerplate och allt
Eftersom resten av min scraper-recensionsserie använder samma fyra webbfiksturer, matade jag MarkItDown med identiska lokala HTML-filer — inte för att bedöma det som en scraper, utan för att se hur bra dess HTML-till-Markdown-konvertering är. På välstrukturerade sidor är den faktiskt riktigt bra.
Alla fyra sidor konverterades med grundinstallationen utan extra tillägg, och varje kontrollpunkt i brödtexten överlevde. Wikipedia-artikeln ”Web scraping” (226 KB) kom ut med sitt rubrikträd speglat — en h1, sju h2 och tolv h3, i linje med artikelns verkliga sektionsstruktur — och 418 länkar bevarades som korrekta [text](url). Hockeystatistiktabellen med 25×9 celler på Scrape This Site forms-sidan blev en ren GFM-pipetabell med 27 rader (rubrik + separator + 26 datarader), inklusive tomma celler. Hastigheten var inget problem här: median 48 ms för quotes-sidan och upp till 352 ms för Wikipedia-sidan på 226 KB.
Men här kommer haken, och det är ett designval snarare än en bugg. MarkItDown tar inte bort boilerplate. Det konverterar hela <body>, så sidans chrome följer med — och resterna växer i takt med hur mycket chrome sidan har.
| Sida | Utdata-tecken | Rubriker (h1/h2/h3) | Länkar | Rader med sidchrome |
|---|---|---|---|---|
| Books to Scrape | 10,478 | 1 / 0 / 0 | 94 | 0.6% (1/159) |
| Quotes to Scrape | 2,973 | 1 / 1 / 0 | 55 | 1.2% (1/86) |
| ScrapeThisSite forms | 3,385 | 1 / 0 / 0 | 31 | 6.7% (5/75) |
| Wikipedia Web scraping | 60,159 | 1 / 7 / 12 | 418 | 12.4% (42/338) |
På Books-hemsidan, som nästan saknar chrome, är 0,6 % av utdata rader med sidchrome. På Wikipedia är det 12,4 % — 42 av 338 icke-tomma rader är saker som ”hoppa till innehåll”, ”visa/dölj innehållsförteckningen”, ”22 språk”, ”hämtad från”, cookies och licensfotnoter. Wikipedias underhållsbanderoller (”Den här artikeln behöver fler källor”) renderas dessutom troget som tvåkolumnstabeller, vilket förklarar varför nio tabellrader dyker upp på en sida som egentligen inte har någon riktig datatabell.
Det där är inte MarkItDown som gör något fel. Det är en konverterare för hela dokument, inte en readability-extraktor: trogen HTML-till-Markdown är en annan uppgift än att extrahera en ren artikeltext. Trafilatura och Firecrawl-liknande verktyg försöker returnera bara huvudinnehållet; MarkItDown returnerar sidan. Under huven tar _html_converter.py bort <script> och <style>, och skickar sedan hela body till biblioteket markdownify — det finns ingen heuristik för huvudinnehåll i kedjan. Om du bara vill ha artikeln är det här fel lager.
Hemmamarknaden: PDF, DOCX, XLSX, PPTX
Dokument är det MarkItDown är byggt för. Jag testade det mot verkliga publika filer — en arXiv-artikel med textlager, Bitcoin-whitepaper, en skannad PDF med enbart bild som jag renderade så att den helt saknade text, samt DOCX/XLSX/PPTX-filer från MarkItDowns egen testsvit (med UUID-seedning så att jag kunde upptäcka tyst innehållsförlust).
| Dokument | Input | Utdata-tecken | Kontroller | Median tid | Anteckningar |
|---|---|---|---|---|---|
| arXiv 1706.03762 (PDF med textlager) | 2.2 MB | 40,174 | 7/7 | 3.7 s (varm) | titel, ”Transformer”, ”BLEU”, ”References” alla närvarande |
| Bitcoin whitepaper (9 sidor PDF) | 184 KB | 22,485 | 6/6 | 1.4 s | ”Satoshi Nakamoto”, ”proof-of-work”, ”Conclusion” närvarande |
| Skannad PDF (inget textlager) | 89 KB | 0 | 0/4 | 15 ms | tom utdata, inget fel, ingen OCR |
| DOCX (test.docx) | 136 KB | 4,651 | — | 70 ms | rubriker + GFM-tabell; inbäddade UUID:er överlever |
| DOCX med ekvationer | 15 KB | 240 | — | 101 ms | Office Math bevaras som LaTeX |
| XLSX (test.xlsx) | 12 KB | 808 | — | 57 ms | varje blad → ## SheetName + GFM-tabell |
| PPTX (test.pptx) | 278 KB | 2,047 | — | 52 ms | markörer för bildnummer, tabeller, diagram → tabell |
Textåtergivningen i PDF-filer med textlager var utmärkt — 7 av 7 förregistrerade kontroller i arXiv-artikeln ”Attention Is All You Need”, 6 av 6 i Bitcoin-whitepaper — och ingen av Office-filerna tappade en enda UUID-sentinel, så det blev ingen tyst innehållsförlust i maintaindarnas egna regressionsfiler. En smal men viktig vinst: DOCX-vägen (via mammoth) bevarar Office Math-ekvationer som LaTeX och gör equations.docx till riktig $$...$$-matematik. Om du matar en LLM med Word-dokument fulla av formler är det här en verklig, om än ganska specifik, styrka som jag inte hittade tydligt beskriven någon annanstans.
Två resultat på det här området förtjänar extra uppmärksamhet, eftersom det är de som mest sannolikt ställer till problem för dig.
Den skannade PDF:en som försvinner
Mata MarkItDown med en bildbaserad PDF utan textlager, så får du tillbaka en tom sträng. Noll tecken, inget undantag, ingen varning — konverterat på ungefär 15 ms eftersom det inte finns något att extrahera. MarkItDowns PDF-väg är enbart textutvinning (pdfminer och pdfplumber under huven), och det följer ingen OCR med i grundinstallationen eller i några pip-extra.
Det spelar roll i batchkörningar. En utvecklare som matar in en mapp med PDF-filer där vissa är skanningar får tyst tomma resultat för just de filerna, utan någon signal om att något hoppades över. Jag kontrollerade att testfilen inte var trasig genom att köra pdfminers extract_text direkt mot den — noll borttagna tecken, inget textlager, bekräftat — så den tomma utdata är MarkItDowns faktiska beteende på en verklig skanning. Det här reproducerar ett länge öppet gap för OCR-fallback (#1268) som har följts upp upstream ett tag. Den dokumenterade vägen är den valfria Azure Document Intelligence-backenden eller ett plugin; inget av detta ingår i standardinstallationen.
PDF:er blir platt text, inte struktur
I båda PDF-filerna med textlager producerade MarkItDown noll Markdown-markörer för rubriker. En PDF innehåller inga semantiska rubriktaggar, och MarkItDown försöker inte gissa rubriknivåer från teckenstorlek, så varje rad hamnar på brödtextnivå. Textåtergivningen är hög; strukturen är platt.
Det här är inte bara mitt resultat. Publika tredjepartsbenchmarkar ger MarkItDown ungefär 0.0 i PDF-rubrikhierarki och cirka 0.27 i tabelltrohet, långt under Doclings 0.88 med TableFormer (se MarkItDown vs Docling vs Marker-jämförelsen och READoc-benchmarken). Mina tester återskapar deras siffror, vilket stärker evidensen — mina resultat stämmer med en extern källa. Samma benchmarkar rapporterar också att MarkItDown är ungefär 100 gånger snabbare än Docling, vilket stämmer med mina sekunder-i-stället-för-minuter-tider på dokument som ett layoutmodell-verktyg tuggar i flera minuter. Slutsatsen: MarkItDown ger dig ren och snabb PDF-text; det ger dig inte PDF:ens struktur. Om rubriker och tabeller måste överleva är ett layoutmodell-verktyg som Docling eller Marker rätt lager.
Tabeller: innehållet överlever alltid, strukturen gör inte alltid det
Tabeller är platsen där ”överlevde texten?” och ”går datan att använda?” skiljer sig åt, så jag byggde en matris med 13 fall — en <table> per fall, vardera poängsatt mot ett manifest skrivet före körningen — för att exakt kartlägga vilka former som håller och vilka som går sönder.
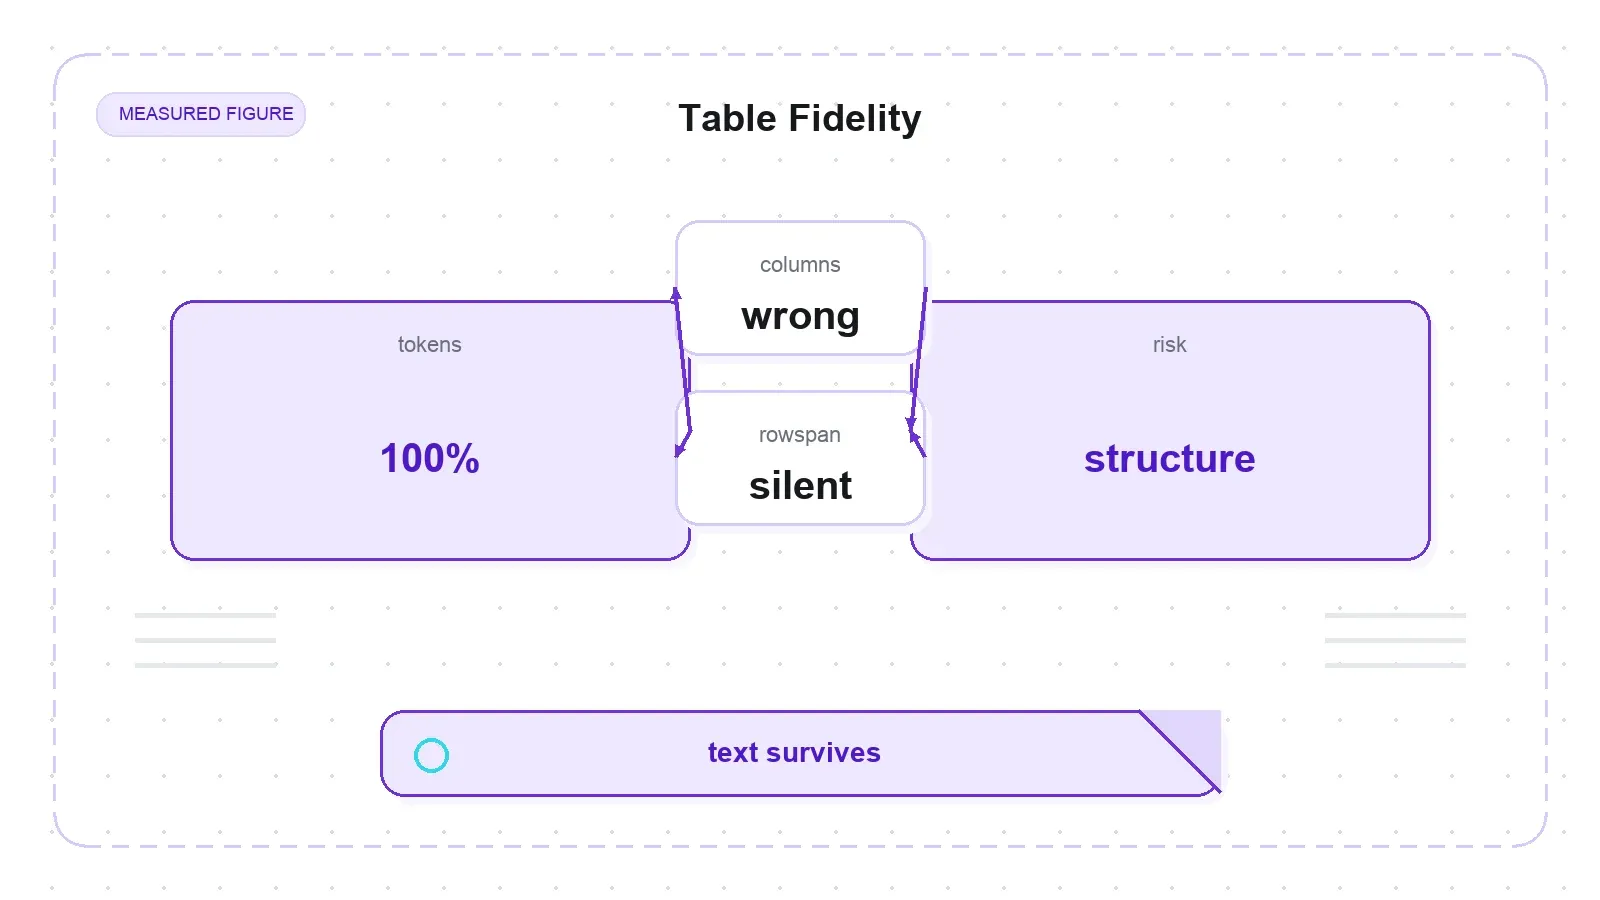
Huvudpoängen: MarkItDown tappade aldrig tabellinnehåll. Alla 13 fall behöll 100 % av sina förregistrerade token. Strukturell trohet delade däremot upp sig i tre lägen. Sju av tretton blev en välformad GFM-rutnäts-tabell (vanlig, header-colspan, 24 kolumner bred, utan header, tomma celler, block-i-cell och höger-till-vänster arabiska). Fyra blev skeva, eftersom Markdown inte har något begrepp för spända celler, så rowspan, colspan och felaktiga källor ger korta rader. Och två var helt trasiga.
De två trasiga fallen är värda att nämna. En nästlad tabell (en <table> inuti en <td>) plattas ut inline, så att dess egna pipes och separatorrad hamnar i föräldracellen och skapar en skräp-rad med 14 ”kolumner”. Och ett bokstavligt | inne i en cell escapes inte — celltexten a | b blir två kolumner, x || y blir tre — så en tabell med två kolumner kan plötsligt ge rader med två, tre och fyra kolumner, och alla downstream Markdown-parsers läser fel gränser. Märkligt nog escapes asterisker och backticks i celler, men inte pipes. Grundorsaken är att MarkItDowns HTML-väg använder markdownifys standardhantering av tabeller, och dess egna subclass överskuggar länkar, bilder och rubriker men inte tabellceller. Samma typ av pipe-escaping-bugg är ett öppet ärende för CSV-konverteraren (#2019), även om den fixen inte påverkar HTML-vägen jag testade.
Det subtila fallet — den upptäckt jag helst vill att en dataingenjör ska se — är rowspan. Fall t03 blir inte bara skevt; det förskjuter data tyst. En etikett med rowspan=2 (”Fruit”) skrivs ut en gång, och raden under blir en kort tvåkolumnsrad (| Banana | 8 |), så ”Banana” hamnar under kolumnen Group i stället för Item. Alla token finns där. En naiv konsument som ”läser andra kolumnen” får fel värde. Det är den sortens bugg som klarar ett textöverlevnadstest och i tysthet korrumperar ett dataset.
Begränsningen med spänn är i sig ett känt och uppföljt designval (#1211, #1248) — ett platt GFM-piprutnät kan verkligen inte representera spänningar eller nästling, så konverteraren byter struktur mot fullständig innehållstäckning. Det finns också bra beteenden i blandningen: tabeller utan header får en syntetisk tom header-rad (så att ingen data tyst blir en rubrik), tomma celler bevaras och <caption> överlever som en textrad ovanför tabellen.
Installation och uppstart: skatten som ett ”lättviktigt verktyg” inte varnar dig för
Inget här överraskade mig mer, och det är här som ”lättviktig Python-utility” lovar lite för mycket utan att säga det.
Först: kör inte pip install 'markitdown[all]'. På Python 3.14 backar den tyst till markitdown 0.0.2 — en två år gammal release — vilket jag reproducerade live i en ren venv. När man pinnat versionen blir orsaken tydlig: pip install 'markitdown[all]==0.1.6' ger fel eftersom extra-paketet [all] låser youtube-transcript-api~=1.0.0, och på dagens PyPI är varje bygg i det intervallet begränsad till Python <3.14, medan de enda bygg som fungerar med 3.14 ligger utanför den låsningen. Resolvern går därför hela vägen tillbaka till senaste versionen vars beroenden går att uppfylla. Det här matchar ett öppet ärende upstream (#2179). Lösningen är enkel — lås versionen och installera extrana var för sig: pip install 'markitdown==0.1.6', sedan pip install 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Var och en av dessa fungerar; det är bara den samlade [all]-bundlen som har den förgiftade låsningen. (Den här fallgropen beror på Python-versionen — på Python 3.13 eller tidigare kanske spärren inte träffar, så [all] kan lösas annorlunda.)
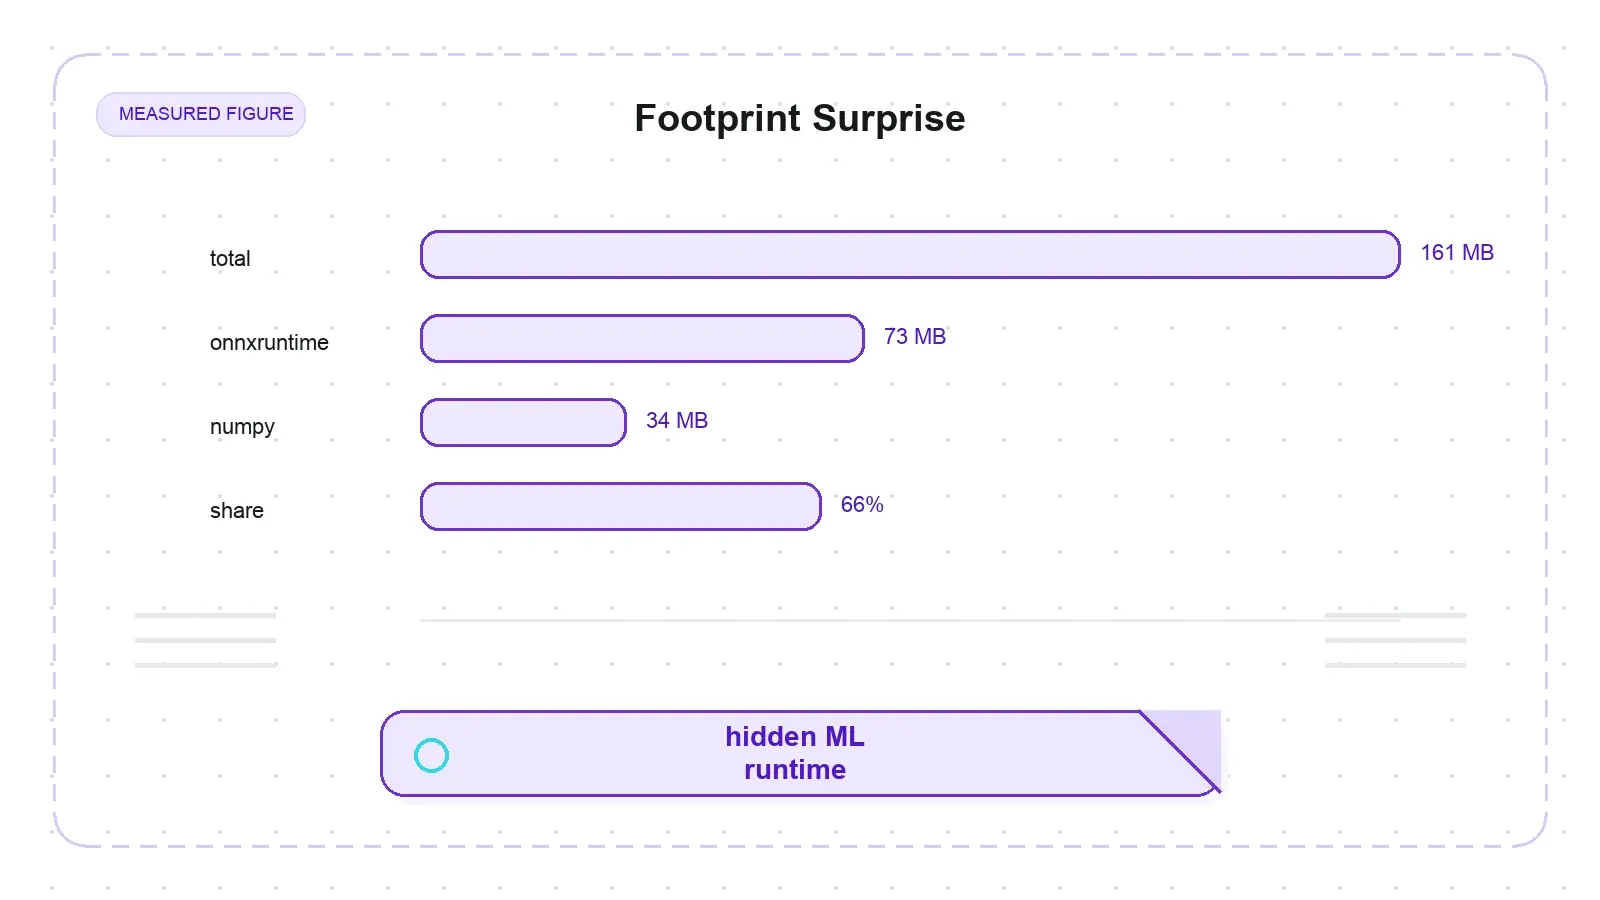
För det andra: fotavtrycket. Grundinstallationen är 161 MB (en tom venv på 13 MB plus 148 MB). Av detta står onnxruntime (73 MB) och numpy (34 MB) tillsammans för 107 MB — 66 % av hela kärninstallationen — och båda dras in av ett enda hårt beroende: magika, Googles ML-baserade filtypsdetektor. Så en textkonverterare shippar alltså en 73 MB stor ONNX-runtime i grundinstallationen innan du ens lägger till ett dokumenttillägg. Lägg till dokumentextrana, och venv:n når 310 MB. Det här är långt lättare än en headless-browser-stack, men om du väntade dig en mikroutil som bara är ”pip install och klart”, så ska du veta att en ONNX-runtime följer med.
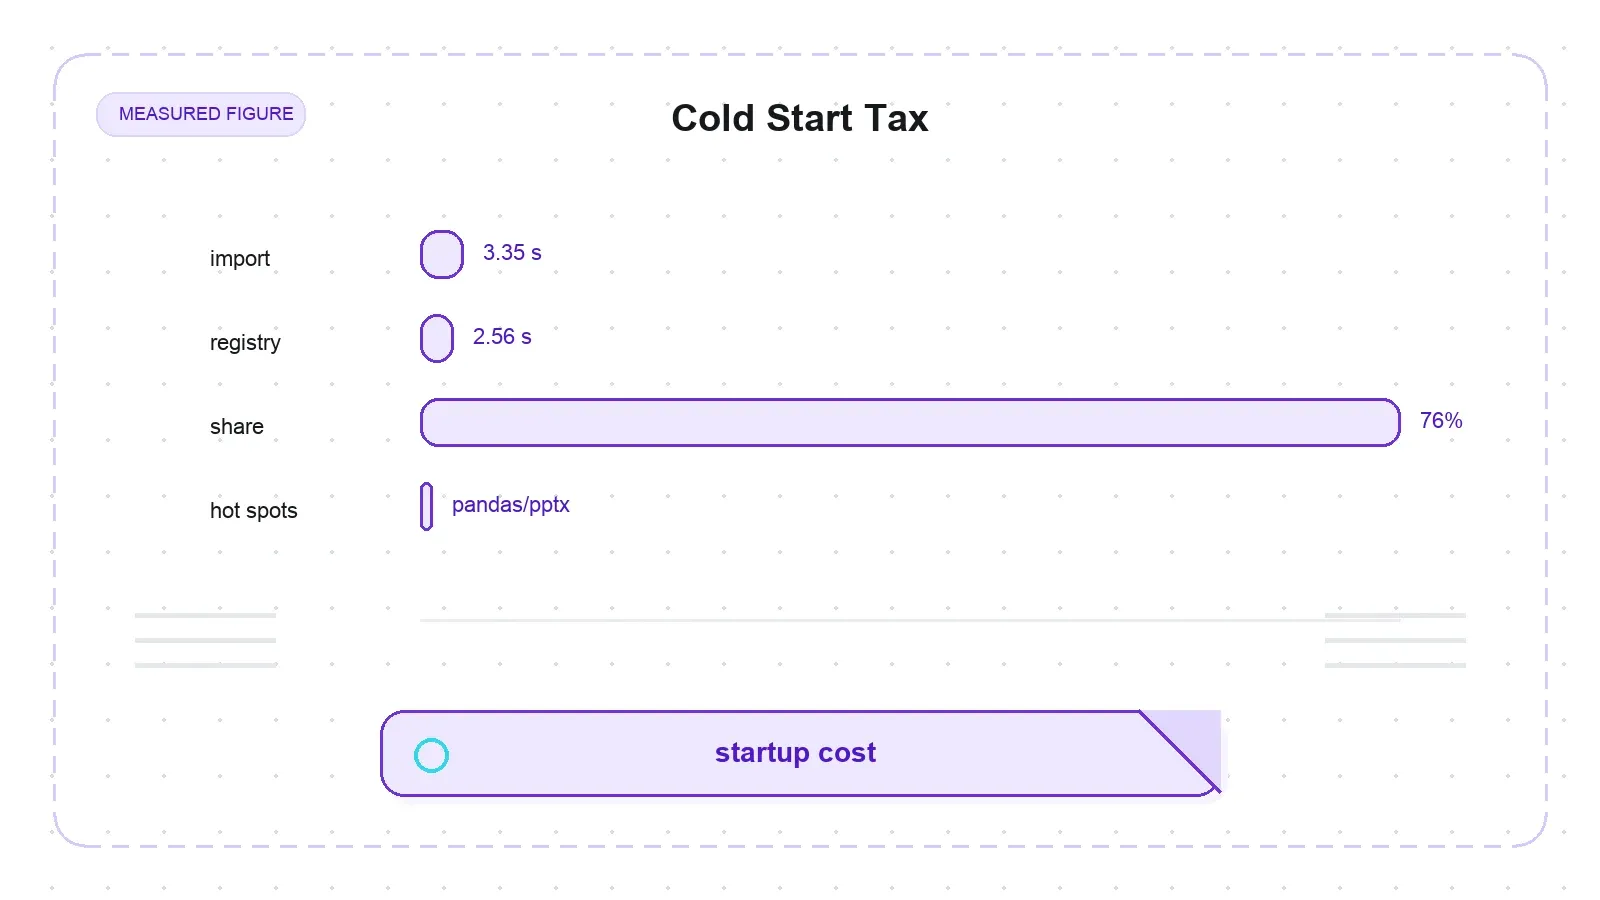
För det tredje — och det här är det enda resultatet i hela min uppsättning som klarar varje nyhetsfilter jag testade — även efter en ren installation kostar import markitdown ungefär 3,35 sekunder på den här maskinen. Kostnaden ligger nästan helt i importtiden: markitdown._markitdown importerar aggressivt hela konverteringsregistret (2,56 s kumulativt, 76 % av totalen), vilket i sin tur drar in pandas (1,21 s, via XLSX-konverteraren), python-pptx (427 ms), magika (354 ms) och requests (270 ms) — oavsett om du faktiskt konverterar något av dessa format. För en långkörande tjänst är det här amorterat och ointressant. För ett CLI-anrop eller en serverless cold start är det däremot en verklig per-process-skatt som etiketten ”lättviktig utility” inte får dig att förvänta dig. (Rättvis brasklapp: detta är en enda profilerad körning, behandlad som en observation, inte som en distribution över många körningar.)
Skala: det kraschar inte, men budgetera CPU för PDF:er och RAM för kalkylblad
Jag pressade fyra stora ämnen genom verktyget, var och en i en egen process så att peak-minnet inte skulle påverkas av en tidigare körning. Inget kraschade. Kostnadsprofilen är däremot ojämn.
| Ämne | Input | Utdata-tecken | Median tid | Peak RSS Δ |
|---|---|---|---|---|
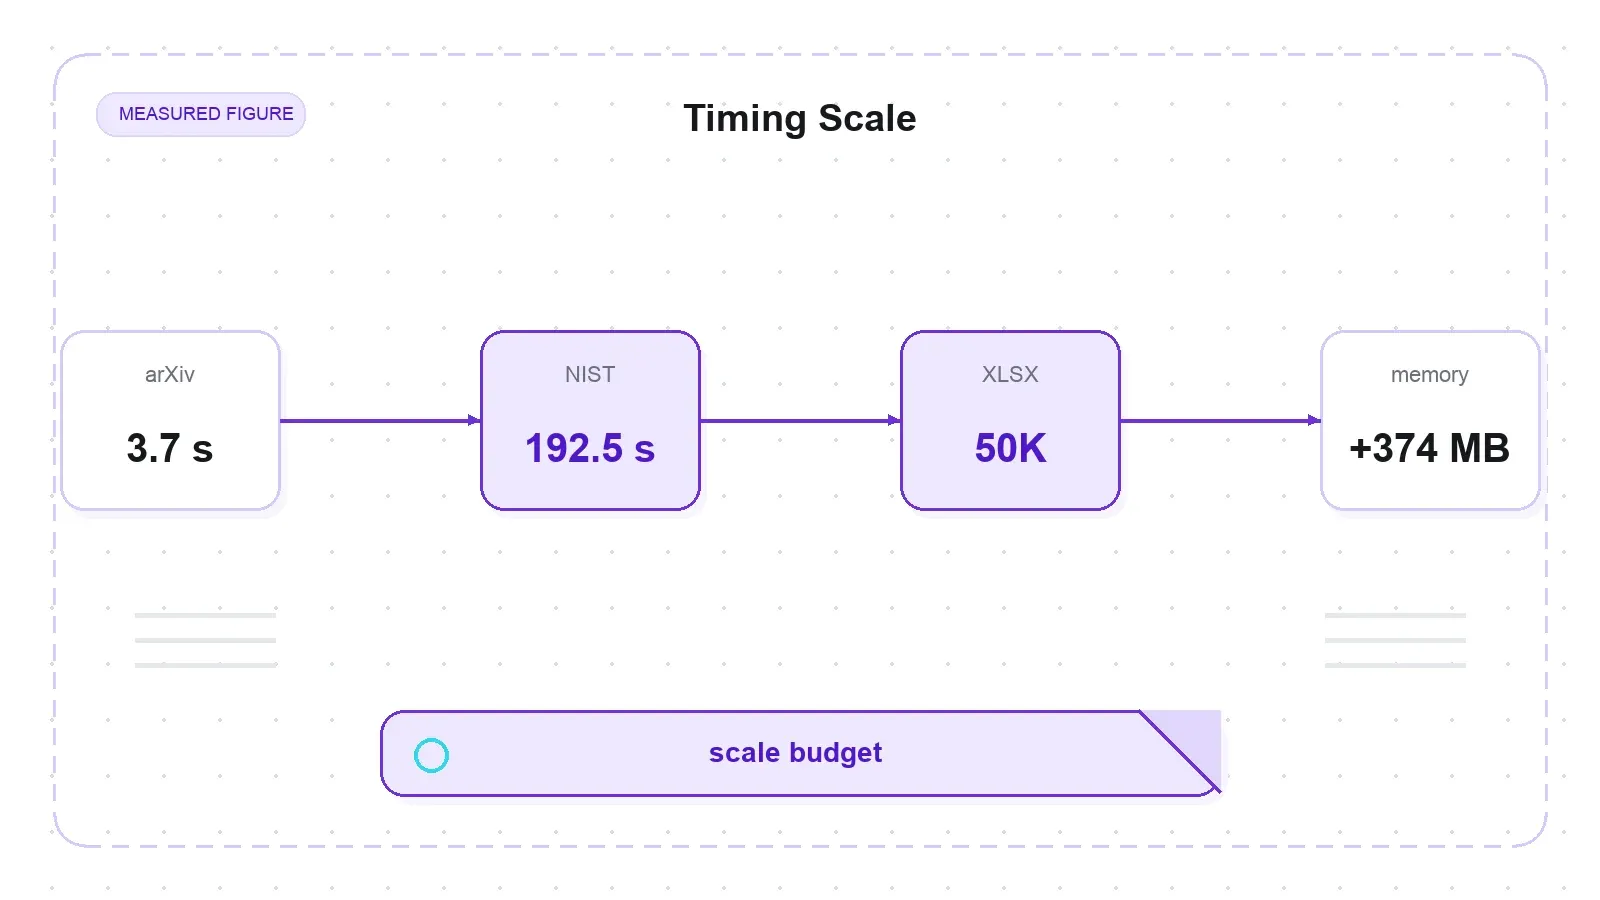
| NIST SP 800-53r5 (492-sidors PDF) | 6.07 MB | 1,625,365 | 192.5 s | +40 MB |
| XLSX 50,000 rader × 8 kolumner | 2.1 MB | 3,722,955 | 62.1 s | +374 MB |
| arXiv 1706.03762 (~15-sidors PDF) | 2.2 MB | 40,174 | 12.6 s | +25 MB |
| XLSX 200 rader × 64 kolumner | 46 KB | 120,129 | 2.9 s | +22 MB |
Den 492 sidor långa NIST-PDF:en tog en median på 192,5 sekunder — ungefär 3,2 minuter, eller 0,39 s/sida — eftersom pdfplumber kör formdetektering baserad på ordposition på varje sida. Peak RSS stannade på +40 MB, så det är CPU-bundet, inte minnesbundet. Till och med den 15 sidor långa arXiv-PDF:en tog 12,6 sekunder i sin egen isolerade process, ungefär 3,4 gånger längre än de 3,7 sekunder samma fil visade varm i min dokumentuppsättning. Det gapet är cold-process-kostnaden, och det bekräftar att arbetet per sida är det som driver tiden, inte rå filstorlek. Om du vill ha ett överförbart tal för just den PDF:en, använd de isolerade 12,6 sekunderna.
Kalkylbladsvägen vänder på flaskhalsen. En XLSX-fil på 2,1 MB med 50 000 rader växte till +374 MB peak RSS (och 3,7 miljoner tecken i utdata) eftersom konverteraren laddar hela arket och bygger en enda stor Markdown-sträng. Den praktiska rekommendationen är därför rätt rak: för stora PDF:er, budgetera minuter av CPU; för stora kalkylblad, budgetera hundratals MB RAM. Det här är siffror från en enda maskin på macOS arm64 och Python 3.14, och konstanterna per sida och per rad är plattformsberoende — men formen (PDF är långsam och CPU-bunden, XLSX är minnestungt, inget kraschar) är det som faktiskt går att generalisera.
Var Thunderbit passar — och var det inte gör det
Testa Thunderbit för webbdatanalys
Det här är den jämförelse där det vore lätt att överdriva, så jag drar gränsen noggrant. MarkItDown och Thunderbit löser angränsande problem, inte samma.
MarkItDown konverterar filer du redan har. Thunderbit hämtar sidan först. Thunderbits /distill-endpoint gör om en livewebbsida till ren Markdown redo för LLM:er — och hanterar JS-rendering, anti-bot och dynamiskt innehåll som MarkItDown inte har någon mekanik för — medan dess /extract-endpoint returnerar schema-matchad strukturerad JSON, inte bara rå Markdown. För utvecklare exponeras detta som ett API (POST /distill / POST /extract), en MCP-server och ett CLI (npx @thunderbit/thunderbit-cli) ovanpå en och samma AI-motor, samma som driver tillägget med 100 000+ användare.
Så de överlappar bara på en sak — båda kan mata ut ”LLM-redo Markdown” — men indata-domänen är olika: Thunderbits distill tar en URL på det öppna webben, MarkItDown tar en lokal fil. De är inte utbytbara, och jag tänker inte låtsas att de är det. Den realistiska stacken använder båda: hämta och crawla webben med Thunderbit (eller en Firecrawl-liknande tjänst), och normalisera sedan de blandade lokala dokument du också har — PDF:er, presentationsfiler och kalkylblad — med MarkItDown. Den ena hanterar nätverket; den andra hanterar filskåpet.
För- och nackdelar
Styrkor
- Fullständig återgivning av brödtext på ren HTML (4/4 sidor), med rubrikträd och länkar troget bevarade
- Hög textåtergivning i PDF/DOCX (arXiv 7/7 kontroller, Bitcoin 6/6) och ingen tyst innehållsförlust i maintaindarnas egna Office-fiksturer
- Office Math-ekvationer bevaras som LaTeX — en verklig nischstyrka
- Kraschade aldrig på något testobjekt, upp till en PDF på 492 sidor och en XLSX med 50k rader
- Enkel att använda: CLI,
convert(), stdin-piping och en valfri MCP-server - MIT-licensierad, aktivt underhållen av Microsoft, med responsiv ärendehantering
Svagheter
- Behåller boilerplate — upp till 12,4 % chrome-rader på Wikipedia; inte en artikel-extraktor
- Tabeller går sönder på spänn, nästling och pipes i celler (2/13 trasiga, 4/13 skeva), och rowspan kan tyst förskjuta data
- Skannade/bildbaserade PDF:er ger tom utdata utan OCR och utan felmeddelande
- PDF-utdata har ingen rubrikstruktur alls (i linje med publika benchmarkar)
- 161 MB grundinstallation med en 73 MB ONNX-runtime; cirka 3,35 s kall import
[all]-extra backar tyst till en två år gammal 0.0.2 på Python 3.14
Vem bör använda det — och vem bör låta bli
Välj MarkItDown om du standardiserar en hög blandade lokala dokument — Word, Excel, PowerPoint, PDF:er med textlager — till Markdown för en LLM-pipeline, och du bryr dig mer om fullständig text än om bevarad struktur. Som sista ledet i ett batchjobb, när du vill mata modellen med ren text, är det snabbt, troget och gratis.
Hoppa över det, eller kombinera det med något annat, om ditt jobb är något av detta: du behöver bara huvudartikeln från en webbsida (använd ett readability- eller Firecrawl-liknande verktyg); du behöver att en PDFs rubriker och tabeller överlever intakta (det är Docling- eller Marker-territorium); eller dina input innehåller skannade dokument som kräver OCR (då behöver du Azure-backenden eller ett helt annat verktyg). Och om du trodde att du köpte en scraper — något som hämtar och crawlar — så är det här inte det alls.
Den preliminära poäng jag satte, med ett scraper-liknande rubriceringsschema, landar MarkItDown på 60/100, och den låga totalsumman beror på att man bedömer en konverterare med en crawlers test. På dess egen hemmaplan är texttroheten hög; de svaga punkterna är strukturella (tabeller, PDF-rubriker) och handlar om paketering (fotavtryck, import, [all]-fällan), inte om textkvalitet. Bedöm det för vad det är — en fil-till-Markdown-konverterare — så är det ett stabilt, väl underhållet verktyg med några vassa kanter du bör känna till innan du kopplar in det i produktion.
Vanliga frågor
Är MarkItDown en webbscraper?
Nej. Det har ingen crawler, ingen JavaScript-rendering, ingen länkföljning och ingen paginering. Det konverterar filer och dokument du redan har — PDF, DOCX, XLSX, PPTX, bilder, HTML — till Markdown. Om du behöver hämta och crawla levande webbsidor vill du ha ett scraping-verktyg som Thunderbit eller Firecrawl; MarkItDown är steget efteråt, där hämtade eller lokala filer görs om till ren Markdown.
Varför installerar pip install markitdown[all] en gammal version?
På Python 3.14 låser [all]-extrat youtube-transcript-api~=1.0.0, och varje build i det intervallet är begränsad till Python-versioner under 3.14. Resolvern kan inte uppfylla låsningen, så den backar tyst till markitdown 0.0.2, en två år gammal release. Lösningen är att låsa versionen och installera extrana separat: pip install 'markitdown==0.1.6', och därefter lägga till 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Det här följs i ärende #2179.
Gör MarkItDown OCR på skannade PDF:er?
Inte i standardinstallationen. Dess PDF-väg är enbart för textutvinning, så en bildbaserad PDF utan textlager ger en tom sträng — inget fel, ingen varning. OCR kräver den valfria Azure Document Intelligence-backenden eller ett plugin, och inget av detta följer med som standard. Det här är ett länge känt glapp (ärende #1268).
Hur bra hanterar MarkItDown tabeller?
Innehållsmässigt mycket bra — i mitt test med 13 fall behöll den 100 % av tabellinnehållet i samtliga fall. Strukturellt beror det på formen: enkla, breda, headerlösa och tom-cellstabeller blir rena GFM-rutnät, men rowspan och colspan blir skeva (och rowspan kan tyst förskjuta data till fel kolumn), nästlade tabeller plattas ut till skräprader, och bokstavliga pipe-tecken i celler escapes inte. Markdowns platta tabellformat kan helt enkelt inte representera spänn eller nästling.
Är MarkItDown tillräckligt snabbt för stora dokument?
Det kraschar inte på stora filer, men budgetera resurser efter filtyp. En PDF på 492 sidor tog ungefär 3,2 minuter (cirka 0,39 s/sida) eftersom den gör formdetektering per sida, och är CPU-bunden. Ett kalkylblad med 50 000 rader blev klart på ungefär en minut men använde +374 MB RAM eftersom det bygger en enda stor Markdown-sträng i minnet. För stora PDF:er: planera för minuter av CPU-tid; för stora kalkylblad: planera för hundratals MB RAM.
Testa Thunderbit för webbdatanalys Get Started Free