
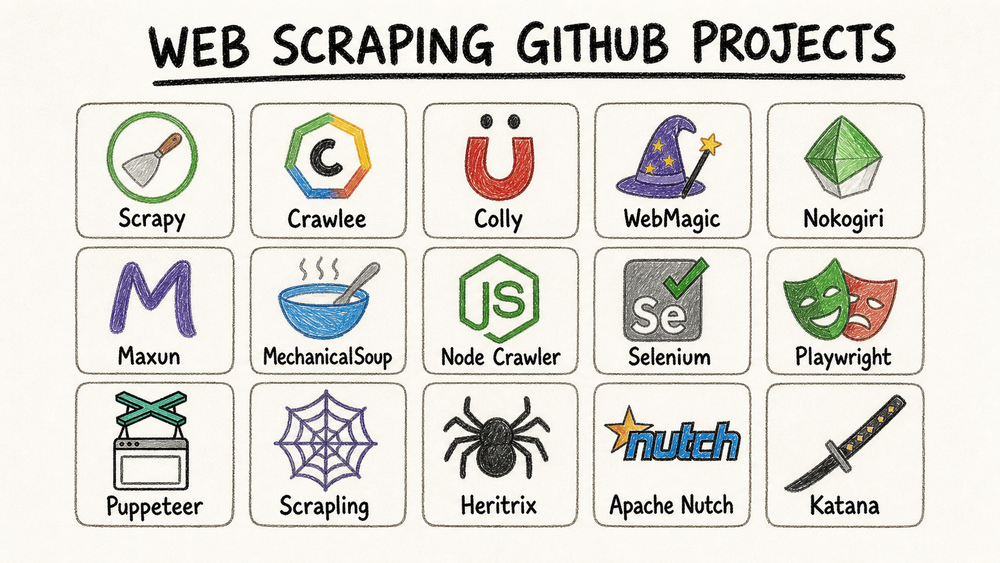
Webben är fortfarande full av värdefull data år 2026, men de flesta team behöver inte bara “en scraper” i allmän mening. De behöver ett praktiskt svar på en av tre frågor: vilket open source-projekt som fortfarande är värt att bygga vidare på, vilken stack som klarar moderna JavaScript-tunga sajter, och om någon utan utvecklarbakgrund bör hoppa över GitHub helt och i stället använda ett no-code-flöde.
Den här uppdateringen är byggd kring just det beslutet. Jag granskade offentliga GitHub-reposidor, stjärnbetyg och commit-aktivitet den 6 augusti 2026, och jämförde sedan projekten nedan utifrån installationssvårighet, stöd för JavaScript, tecken på aktiv underhållning, hur smidigt data exporteras och vilken målgrupp de passar bäst för.
Det korta svaret
- Välj Scrapy om du vill ha det mest mogna Python-ramverket för strukturerad scraping i stor skala.
- Välj Crawlee om ditt team jobbar i JavaScript eller TypeScript och vill ha en och samma stack för både HTTP-baserad och webbläsarbaserad scraping.
- Välj Playwright eller Puppeteer om sajten är tung på JavaScript och verklig webbläsarautomation är det som krävs.
- Välj Maxun om du vill ha ett öppet, visuellt och självhostat no-code-lager i stället för att skriva scrapingkod från grunden.
- Välj Heritrix, Apache Nutch eller Katana bara om uppgiften är specialiserad: arkiveringscrawling, distribuerad crawling eller säkerhetsrekognosering.
- Välj Thunderbit om du inte alls försöker bygga något på GitHub, utan bara vill få data snabbt till Sheets, Airtable, Notion, CSV eller JSON.
Testa en kodfri scraper innan du bestämmer dig för en kodstack
Jämförelse i korthet
GitHub-stjärnor och signaler från senaste commit har nedan kontrollerats mot offentliga reposidor och commit-flöden den 6 augusti 2026.
| Projekt | Språk / modell | Installation | JS-stöd | Bäst för | GitHub-stjärnor | Senaste commit-signal |
|---|---|---|---|---|---|---|
| Scrapy | Python-ramverk | Medel | Inget inbyggt JS-stöd | Storskaliga spiders, e-handel, nyheter | 63,7k | 6 augusti 2026 |
| Crawlee | Node.js / TypeScript-ramverk | Medel | Ja | Statisk + dynamisk scraping i en och samma stack | 25,2k | 6 augusti 2026 |
| Maxun | Öppen no-code-plattform | Medel att driftsätta, lätt för användare | Ja | Affärsanvändare som ändå vill ha kontroll via open source | 17,1k | 5 augusti 2026 |
| MechanicalSoup | Python-bibliotek | Enkel | Nej | Formulär, sessioner och enkla statiska sajter | 4,9k | 4 augusti 2026 |
| Node Crawler | Node.js-crawler | Medel | Nej | Snabb statisk crawling och feed-aggregering | 6,8k | 18 juni 2026 |
| Heritrix | Java-baserad arkiveringscrawler | Avancerad | Nej | Webbarkivering och insamling i domänskala | 3,3k | 5 augusti 2026 |
| Apache Nutch | Distribuerad Java-crawler | Avancerad | Nej | Sökliknande crawling och stordataflöden | 3,3k | 5 augusti 2026 |
| Selenium | Webbläsarautomation i flera språk | Medel | Ja | Flöden med mycket interaktion och hög webbläsartrohet | 34,3k | 6 augusti 2026 |
| Playwright | Webbläsarautomation i flera språk | Medel | Ja | Moderna dynamiska sajter och robust scripting | 94,1k | 6 augusti 2026 |
| Puppeteer | Node.js-webbläsarautomation | Medel | Ja | Chrome-först automation och scraping | 95,4k | 6 augusti 2026 |
| Scrapling | Python-verktyg för stealth scraping | Medel | Ja | Webbläsarscraping mot anti-bot-känsliga sajter | 72,8k | 30 juli 2026 |
| Katana | Go-crawler / CLI | Medel | Valfri headless | Säkerhetscrawling och URL-upptäckt | 17,3k | 5 augusti 2026 |
| Colly | Go-ramverk | Medel | Nej | Högpresterande statisk scraping | 25,4k | 18 juni 2026 |
| WebMagic | Java-ramverk | Medel | Inget inbyggt JS-stöd | Generella Java-baserade scraping-pipelines | 11,7k | 20 december 2025 |
| Nokogiri | Ruby-parser | Enkel | Nej | Ruby-appar och anpassade parse-flöden | 6,3k | 3 augusti 2026 |
| Thunderbit | AI-driven no-code Chrome-tillägg | Plug and play | Ja | Icke-tekniska team som snabbt vill få användbar data | N/A | Förvaltat produkt, uppdateras löpande |
Innan du väljer ett GitHub-projekt: fundera på om du ens vill ha ett kodflöde
Thunderbit är inte ett GitHub-projekt, och just därför hör det hemma i den här guiden. En stor andel av dem som söker efter “bästa GitHub-projekten för web scraping” vill egentligen inte underhålla en crawler-stack. De vill ha strukturerad data från en levande webbplats redan idag.
Thunderbit är den mest raka vägen från kodfokuserad scrapingresearch till affärsredo användning:
- Bäst för: prospektering inom försäljning, övervakning av e-handel, insamling av fastighetsdata, rekryteringsresearch och operativt arbete i webbläsaren.
- Därför sticker det ut: AI-förslag på fält, berikning av undersidor, hantering av dynamiska sidor och export till Sheets, Airtable, Notion, CSV och JSON utan att du behöver skriva scrapinglogik.
- Att tänka på: om du bygger en långsiktig intern crawl-plattform med egen infrastruktur ger ett open source-ramverk fortfarande mer kontroll.
Om du vill se no-code-spåret innan du bestämmer dig för att leva inne i GitHub, är den här aktuella genomgången av Thunderbit det snabbaste sättet att få verklighetskoll:
Testa Thunderbit AI Web Scraper gratis
Så här utvärderade jag dessa GitHub-projekt för scraping
Alla GitHub-projekt för scraping går inte att jämföra direkt. Vissa är fullskaliga ramverk. Vissa är bibliotek för webbläsarautomation. Vissa är parserverktyg. Vissa är nischade crawlers byggda för arkiv eller säkerhetsteam.
För att hålla listan användbar prioriterade jag projekt som fortfarande klarar fyra praktiska filter:
- De har fortfarande verklig marknadsrelevans.
Höga stjärnbetyg räcker inte i sig, men låg användning tillsammans med gammal underhållshistorik är nästan alltid ett dåligt tecken. - De visar fortfarande liv i projektet.
För den här uppdateringen kontrollerade jag offentlig commit-aktivitet den 6 augusti 2026 i stället för att lita på gamla sammanställningar. - De löser ett verkligt scrapingbehov.
Jag valde bort snygga men otydliga repos som inte passar särskilt bra i faktiska affärs- eller researchflöden. - De är tillräckligt olika för att vara värda en shortlist.
Målet är inte att dumpa 50 repos. Målet är att hjälpa dig välja mellan ramverk, browser stacks, öppna no-code-verktyg och specialiserade crawlers.
Jämförelsepunkterna är de som oftast avgör framgång eller misslyckande i praktiken:
- Installationssvårighet: hur snabbt en ny användare kan få fram en fungerande scrapingkörning.
- JavaScript-stöd: om projektet klarar moderna client-renderade sajter.
- Projektets hälsa: om repot fortfarande känns tillräckligt levande för att lita på.
- Hantering av data: om projektet levererar strukturerad output eller lämnar mer arbete åt dig.
- Målgrupp: om projektet verkligen är för nybörjare, dataingenjörer, säkerhetsteam eller icke-tekniska användare.
Installationssvårighet: hur snabbt kan du komma igång?
Den där uppdelningen håller fortfarande, men det nyttiga sättet att se på den år 2026 är enklare:
- Plug and play: Thunderbit för affärsanvändare; MechanicalSoup eller Nokogiri för lätta kodskript.
- Medel: Scrapy, Crawlee, Maxun, Selenium, Playwright, Puppeteer, Colly, Katana, Scrapling, WebMagic och Node Crawler kräver alla en viss mängd kod, CLI-arbete eller driftsättning.
- Avancerat: Heritrix och Apache Nutch är bara rimliga om du faktiskt behöver Java-baserad arkivering eller distribuerad crawling.
Maxun förtjänar ett särskilt omnämnande här eftersom det hamnar mittemellan. Själva plattformen behöver driftsättas, men användarflödet är betydligt lättare än att jobba direkt i Scrapy eller Playwright.
Stöd för dynamiskt innehåll: vilka projekt klarar den moderna webben?
Moderna webbplatser är fulla av React, Vue, oändlig scrollning, API-anrop i bakgrunden och login-tunga flöden. Det är här skillnaden mellan “jag fick HTML” och “jag fick den data jag faktiskt behövde” går.
Projekten på den här listan hamnar i tre grupper:
- Full webbläsarautomation: Selenium, Playwright och Puppeteer kör JavaScript fullt ut och är fortfarande de mest tillförlitliga valen för sajter med mycket interaktion.
- Hybrid- eller wrapper-stöd: Crawlee kan växla mellan lätt HTTP-crawling och browserbaserad scraping. Scrapling lägger till stealth-orienterade verktyg för tuffare mål. Maxun använder en browserbaserad metod bakom ett visuellt gränssnitt.
- Endast statisk HTML som standard: Scrapy, MechanicalSoup, Node Crawler, Colly, WebMagic, Nokogiri, Heritrix och Apache Nutch löser inte moderna renderingsproblem på egen hand.
Om din största fråga är “kan den här stacken hantera JavaScript-tunga sidor utan att jag måste bygga varje webbläsarsteg själv?”, är den här aktuella Playwright-guiden det bästa verklighetstestet mitt i texten:
Projektens hälsa: vilka repos ser fortfarande pålitliga ut 2026?
2025-versionen av den här artikeln byggde mycket på stjärnbetyg och några gamla uppdateringsnoteringar. Det räcker inte längre. Jag kontrollerade både aktuella stjärnbetyg och färska commit-signaler den 6 augusti 2026.
Den hälsosamma uppdelningen ser ut så här:
- Tydligt aktiva just nu: Scrapy, Crawlee, Maxun, MechanicalSoup, Heritrix, Apache Nutch, Selenium, Playwright, Puppeteer, Scrapling, Katana och Nokogiri hade alla offentliga commits inom de två veckorna före kontrollen.
- Levande men långsammare: Colly och Node Crawler hade båda senast commits den 18 juni 2026. De ser fortfarande användbara ut, men de uppdateras i sporadiska vågor snarare än i den veckotakt som Playwright eller Crawlee har.
- Mer försiktighet krävs: WebMagic är det enda tydliga undantaget på listan. Den senaste offentliga commit-signalen jag hittade var 20 december 2025, så jag skulle se det som stabilt snarare än aktivt vidareutvecklat.
Det spelar roll eftersom underhållsstilen bör påverka din shortlist:
- Om du vill ha ett säkert standardval för en ny utvecklingsinsats, välj de repos som tydligt är mest aktiva.
- Om verktyget är enkelt och användningsområdet smalt, kan långsammare tempo fungera bra.
- Om projektet är specialiserat, bedöm först hur väl det passar behovet — inte om det släpper nya versioner varje vecka.
De 15 bästa GitHub-projekten för web scraping 2026
Ramverk för storskalig eller allmän scraping
1. Scrapy
Scrapy är fortfarande det självklara Python-svaret när jobbet är större än ett snabbt script. Om du vill ha spiders, pipelines, middleware, throttling, retries och ett moget ekosystem är det fortfarande det tryggaste open source-ramverket på listan.
- Installation: Medel
- Bäst för: e-handelskataloger, katalogscraping, nyhetscrawling och långlivade interna scraping-system
- JS-stöd: Ingen inbyggd rendering; kombinera med Playwright eller Selenium vid behov
- Varför välja det: mogen arkitektur, stark dokumentation och en av de bästa balansförhållandena mellan kraft och community i open source-scraping
- Att tänka på: inlärningskurvan är verklig om du aldrig har arbetat i ett crawler-ramverk tidigare
Om du vill känna efter om Scrapy-spåret passar innan du bestämmer dig, är den här aktuella nybörjarguiden fortfarande användbar:
2. Crawlee
Crawlee har blivit det mest attraktiva valet för JavaScript- eller TypeScript-team som vill ha ett enda projekt som kan täcka både lätt crawling och browserbaserad scraping. Möjligheten att växla mellan HTTP-först och Playwright- eller Puppeteer-drivna arbetsflöden är den stora fördelen.
- Installation: Medel
- Bäst för: JS- och TS-team, hybrida statiska och dynamiska mål samt automationsintensiva interna verktyg
- JS-stöd: Ja
- Varför välja det: flexibelt körningsmodell, hjälp mot blockering och bättre ergonomi för webbläsarflöden än äldre crawler-only-stackar
- Att tänka på: det passar bäst om teamet redan är bekvämt i Node.js
3. Colly
Colly är fortfarande ett av de renaste och mest högpresterande valen för Go-team som inte behöver webbläsar-rendering som standard. Det är snabbt, elegant och praktiskt när flaskhalsen är volym snarare än gränssnittets komplexitet.
- Installation: Medel
- Bäst för: Go-utvecklare som bygger snabba statiska crawlers
- JS-stöd: Ingen inbyggd rendering
- Varför välja det: samtidighet, rate limiting och ett behagligt API för jobb med hög genomströmning
- Att tänka på: fel val när webbläsarautomation faktiskt är det som krävs
4. WebMagic
WebMagic är fortfarande Java-motsvarigheten för team som gillar Scrapy-modellen men vill stanna i JVM-ekosystemet. Det är fortfarande relevant för Java-miljöer, även om intresset runt det är mindre än för Python- eller Node-baserade alternativ.
- Installation: Medel
- Bäst för: Java-baserade scraping-pipelines
- JS-stöd: Ingen inbyggd rendering
- Varför välja det: schemaläggare, pipelines och en tydlig ramverksstruktur
- Att tänka på: ekosystemet är lugnare än de större alternativen i Python och Node, och den senaste offentliga commit-signalen jag hittade var 20 december 2025, så se det som stabilt snarare än aktivt föränderligt
5. Nokogiri
Nokogiri är inte ett crawler-ramverk. Det är parsern som Ruby-utvecklare fortfarande väljer när de vill ha ren HTML- eller XML-hantering i ett eget script eller i ett appflöde.
- Installation: Enkel
- Bäst för: Ruby- och Rails-appar som behöver parsing snarare än ett komplett crawler-ramverk
- JS-stöd: Nej
- Varför välja det: snabbt, stabilt och säkert parser-beteende som standard
- Att tänka på: du behöver fortfarande själv lägga till HTTP-, session- eller webbläsarlager
Lättare statiska och nybörjarvänliga projekt
6. Maxun
Maxun är open source-svaret för dig som gillar idén med no-code scraping men ändå vill kunna self-hosta och ha kontroll via GitHub. Det är mycket mer lättillgängligt för icke-utvecklare än ett rent ramverk, men det är fortfarande ett riktigt open source-projekt och inte en stängd SaaS-lösning.
- Installation: Medel att driftsätta, enklare för slutanvändare efter installation
- Bäst för: team som vill ha ett visuellt gränssnitt med open source-kontroll
- JS-stöd: Ja
- Varför välja det: klickbaserad extrahering, flerstegsflöden och bättre tillgänglighet än att skriva kod från grunden
- Att tänka på: driftsättningen är fortfarande tyngre än för ett helt förvalt webbläsartillägg
7. MechanicalSoup
MechanicalSoup förtjänar fortfarande en plats eftersom inte varje scrapinguppgift kräver en headless browser. Om det verkliga problemet är sessionhantering, formulärinskick eller att navigera ett statiskt flöde bakom inloggning, är det fortfarande litet, tydligt och lätt att förstå.
- Installation: Enkel
- Bäst för: enkla formulär, statiska sidor bakom inloggning och snabba Python-automationsskript
- JS-stöd: Nej
- Varför välja det: låg friktion, lättläst kod och en mjuk start för Python-användare
- Att tänka på: blir snabbt otillräckligt på JS-tunga sajter
8. Node Crawler
Node Crawler har fortfarande en plats om ditt mål är statisk HTML och du främst bryr dig om samtidighet, köhantering och Cheerio-lik parsing. Jag skulle inte välja det för ett nytt browser-tungt projekt, men det kan fortfarande vara ett bra val för feed-liknande insamling och statiska sajter.
- Installation: Medel
- Bäst för: snabb statisk crawling och aggregering
- JS-stöd: Nej
- Varför välja det: kontroll över samtidighet och ett välbekant jQuery-liknande parseflöde
- Att tänka på: den senaste offentliga commit-signalen jag hittade var 18 juni 2026, och glappen mellan uppdateringarna är långa, så det är inget jag hade valt som startpunkt för en ny långsiktig dynamisk stack
Projekt för dynamiska sajter och webbläsarautomation
9. Selenium
Selenium är äldre än Playwright, men det spelar fortfarande roll när exakt webbläsarbeteende och interaktionsnoggrannhet är viktigare än elegans. Det är särskilt relevant där scraping överlappar med QA, regressionstestning eller sajter som kräver väldigt bokstavstroget browserbeteende.
- Installation: Medel
- Bäst för: flöden med mycket interaktion, äldre webbläsarautomation och team som redan använder Selenium för testning
- JS-stöd: Ja
- Varför välja det: brett webbläsarstöd, enormt ekosystem och långvarig mognad
- Att tänka på: nyare automationsstackar känns ofta renare och snabbare för helt nya scrapingprojekt
10. Playwright
Playwright är min standardrekommendation i modern tid för utvecklingsteam som behöver scraping av dynamiska sidor. Kombinationen av stöd för flera webbläsare, stark väntelogik och rena API:er gör det till det lättaste browser-automationsprojektet här att rekommendera brett.
- Installation: Medel
- Bäst för: moderna webbappar, inloggade flöden och JavaScript-tunga mål
- JS-stöd: Ja
- Varför välja det: kontroll över flera webbläsare, robusta automation-primitiver och aktiv underhållning
- Att tänka på: du ansvarar fortfarande för selectors, browser-infrastruktur, retries och output-kvalitet
11. Puppeteer
Puppeteer är fortfarande den klassiska Chrome-först-lösningen. Om ditt team redan arbetar i Node.js och mest riktar sig mot Chromium-kompatibla flöden är det fortfarande ett praktiskt och välkänt alternativ.
- Installation: Medel
- Bäst för: Chrome-orienterad automation, skärmdumpar, PDF-filer och extrahering av dynamiskt innehåll
- JS-stöd: Ja
- Varför välja det: rik kontroll över webbläsaren och mängder av community-exempel
- Att tänka på: Playwright har blivit det starkare standardvalet om du vill ha bredare webbläsarstöd eller en modernare cross-browser-lösning
12. Scrapling
Scrapling är den mest specialiserade moderna nykomlingen i gruppen. Den är för personer som redan vet att webbläsar-rendering inte är det enda problemet. De behöver också stealth, proxy-medvetenhet och starkare anti-bot-förmåga.
- Installation: Medel
- Bäst för: stealth scraping, anti-bot-känsliga mål och Python-först-dynamiska sajter
- JS-stöd: Ja
- Varför välja det: aktiv utveckling och ett skarpare fokus på de friktioner som enklare ramverk ofta missar
- Att tänka på: överdrivet för vanliga statiska sajter och mindre nybörjarvänligt än MechanicalSoup eller Scrapy
Specialiserade crawlers för research, säkerhet och infrastruktur
13. Heritrix
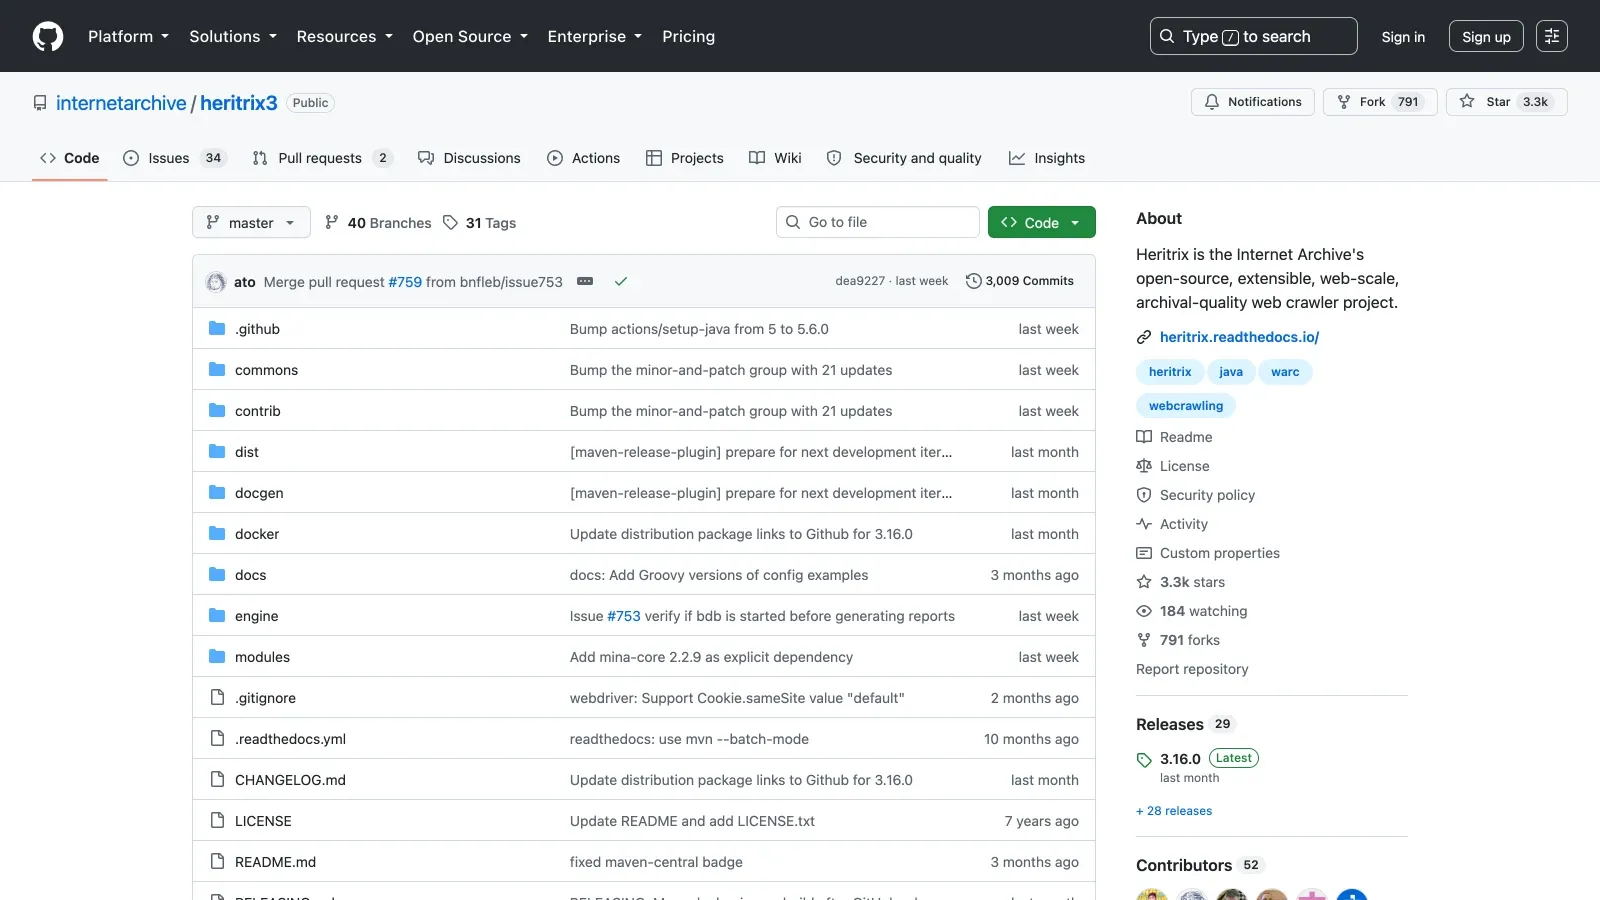
Heritrix är ingen scraper för produktjämförelser. Det är en arkiveringscrawler byggd för institutioner som bryr sig om att bevara hela webbplatser och samla in enligt standardiserade format.
- Installation: Avancerad
- Bäst för: arkiv, bibliotek och storskaliga bevarandeflöden
- JS-stöd: Nej
- Varför välja det: Internet Archive-arv och arkivflöden baserade på WARC
- Att tänka på: helt fel verktyg för riktad list- eller pris-scraping
14. Apache Nutch
Apache Nutch är fortfarande relevant för team som tänker i termer av distribuerad crawling, indexering eller sökliknande datainsamling snarare än enstaka scrapingjobb för affärsdata.
- Installation: Avancerad
- Bäst för: distribuerad crawling, forskningsdatamängder och sökmotorsliknande insamling
- JS-stöd: Nej
- Varför välja det: plugin-modell och Apache-lik företagsvana
- Att tänka på: alldeles för tungt för de flesta jobb som utgår från kalkylblad eller webbläsare
15. Katana
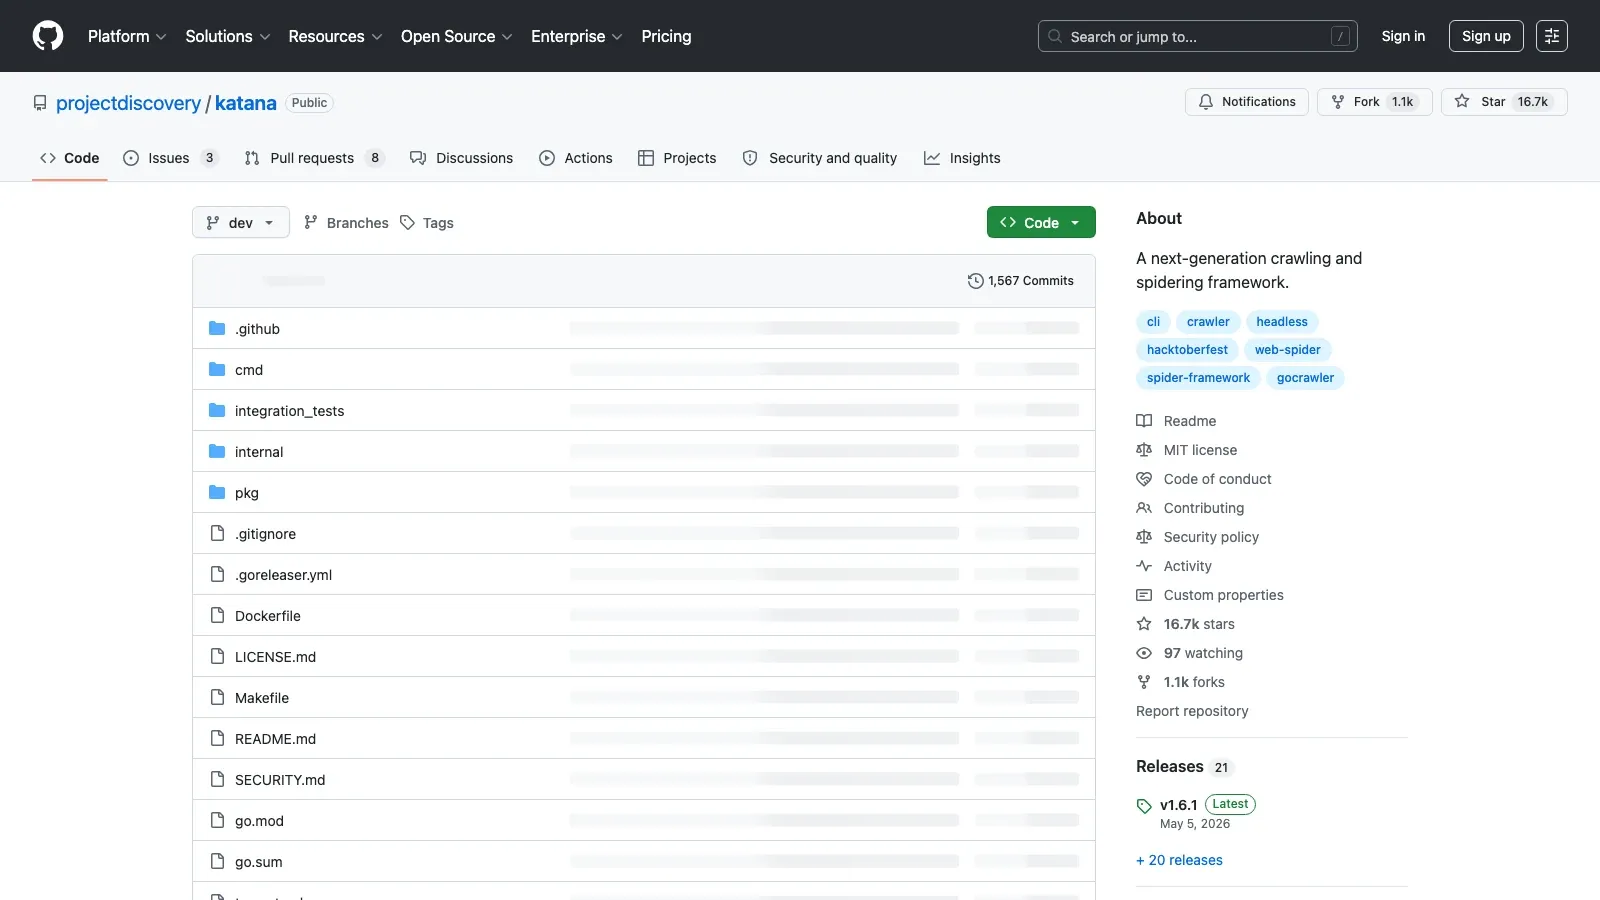
Katana hör hemma här eftersom säkerhetscrawling är ett eget användningsområde. Om uppgiften handlar om rekognosering, upptäckt av endpoints eller att snabbt kartlägga strukturen på ett mål, är Katana mycket bättre anpassat än ett generellt scraping-ramverk.
- Installation: Medel
- Bäst för: säkerhetsrekognosering, länkupptäckt och inventering av URL:er
- JS-stöd: Valfritt headless-läge
- Varför välja det: hastighet, samtidighet och en crawlingmodell byggd för säkerhet
- Att tänka på: det är inte byggt för att vara en välpolerad stack för affärsdataextraktion
Min shortlist efter teamtyp
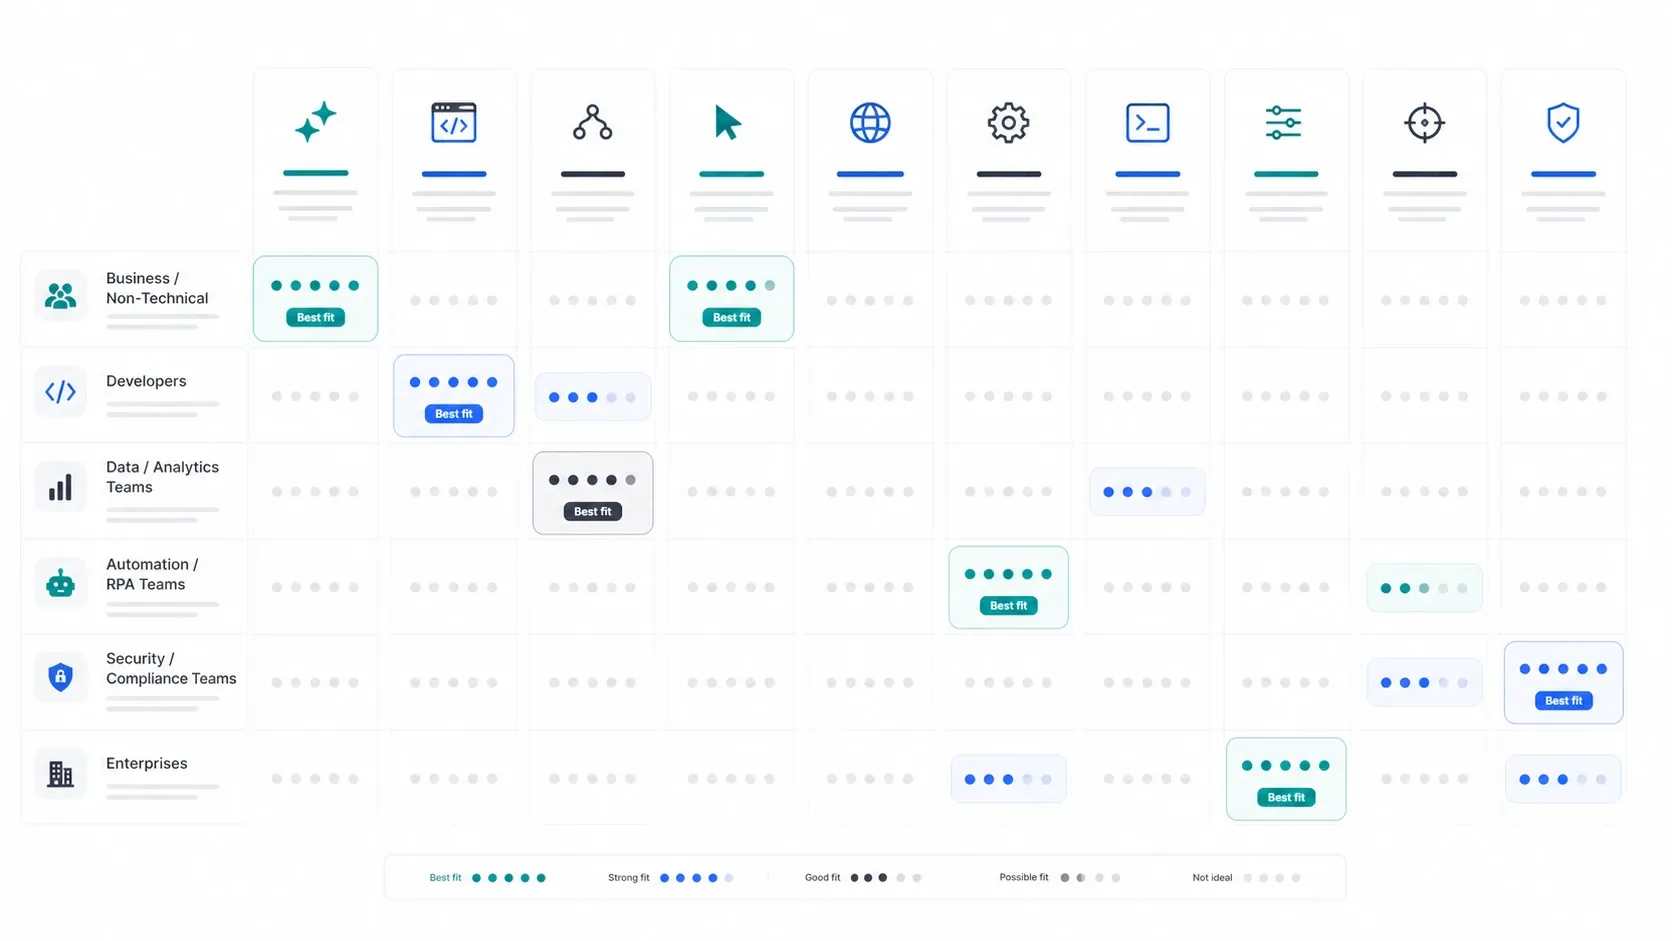
- Python-utvecklare: börja med Scrapy för ramverk, MechanicalSoup för mindre statiska flöden och Scrapling om stealth eller anti-bot-friktion redan är en del av problemet.
- JavaScript- eller TypeScript-team: börja med Crawlee som ramverk, Playwright för webbläsarautomation och Puppeteer om Chrome-först-flöden räcker.
- Go-team: Colly för scraping, Katana för discovery-tung säkerhetscrawling.
- Java-team: WebMagic för generell crawling, Heritrix för arkiveringsinsamling, Apache Nutch för distribuerad sök-lik crawling.
- Icke-tekniska användare: Maxun om du vill ha open source och egen drift, eller Thunderbit om du vill ha ett förvalt no-code-flöde som snabbare ger användbar output.
Vilket projekt bör de flesta faktiskt börja med?
Här är det pragmatiska svaret:
- Om du vill bygga och äga en scraper, börja med Scrapy eller Crawlee.
- Om du behöver styra en riktig webbläsare, börja med Playwright.
- Om du behöver ett visuellt open source-lager, börja med Maxun.
- Om du behöver specialiserad arkiv- eller säkerhetscrawling, välj Heritrix, Nutch eller Katana bara när ditt användningsfall tydligt kräver dem.
- Om du vill hoppa över kod och få datan nu, tvinga inte in dig själv i GitHub först. Använd Thunderbit.
Slutord
Det bästa GitHub-projektet för web scraping år 2026 beror mindre på råa stjärnbetyg och mer på vilket ansvar du faktiskt vill bära själv. Scrapy är fortfarande det säkraste standardvalet för Python. Crawlee är det bästa moderna JavaScript-ramverket. Playwright är den starkaste standarden för webbläsarautomation. Maxun är det mest intressanta open source-spåret för no-code. Heritrix, Apache Nutch och Katana är specialistverktyg som bara är riktigt rätt när uppgiften är specialiserad.
Det viktiga är att inte blanda ihop “mest kraftfullt” med “bäst passform”. Om ditt team bara behöver ren data i ett kalkylblad är GitHub kanske inte rätt startpunkt alls.
Hoppa över underhållsjobbet och börja scrapa snabbare Get Started Free



