
Mitt första scraping-projekt byggde på ett hemmasnickrat Python-script, en delad proxy och en bön. Det gick sönder var tredje dag.
År 2026 är det svåra inte längre att hämta en enskild sida. Det svåra är att välja ett arbetsflöde som kan rendera moderna webbplatser, leverera det format ditt system behöver, överleva layoutändringar och skala utan att varje redesign blir ett ärende till utvecklingsteamet.
Det arbetsflödet kan vara en no-code-app, ett scraping-API, egen kod eller en hanterad tjänst. Rätt val beror på vem som ska använda det, vart resultatet ska skickas och hur mycket kontroll eller löpande underhåll teamet vill ta ansvar för.
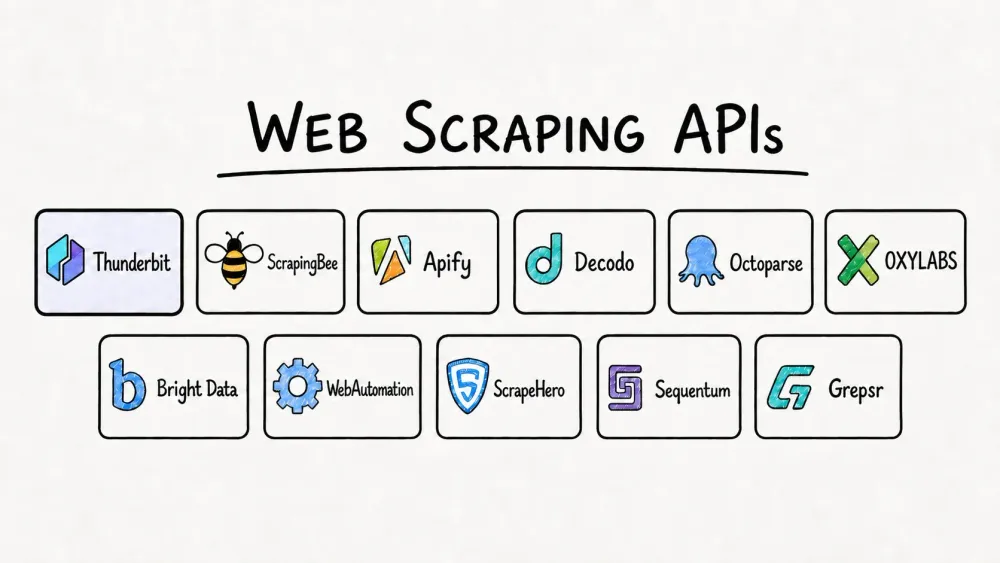
Här är 11 scraping-API:er och plattformar som jag har använt eller utvärderat — vad de gör bra, var de brister och vilken typ av team de passar för.
Scraping-beslutet 2026: gränssnitt, API, kod eller tjänst?
Innan du jämför leverantörer behöver du bestämma vilken modell du faktiskt behöver:
- No-code-app: Bäst när affärsanvändare ska kunna definiera fält visuellt, granska resultat och exportera data utan att underhålla kod.
- AI scraping-API: Bäst när en produkt, agent, RAG-pipeline eller intern tjänst behöver live-innehåll från webben eller JSON med tydlig struktur.
- Egen kod: Bäst när du behöver kontroll på webbläsarnivå, ovanliga interaktioner eller infrastrukturbeteende som ett hanterat API inte exponerar.
- Hanterad tjänst: Bäst när resultatet är viktigare än verktyget och du vill att en leverantör ansvarar för installation, övervakning och leverans.
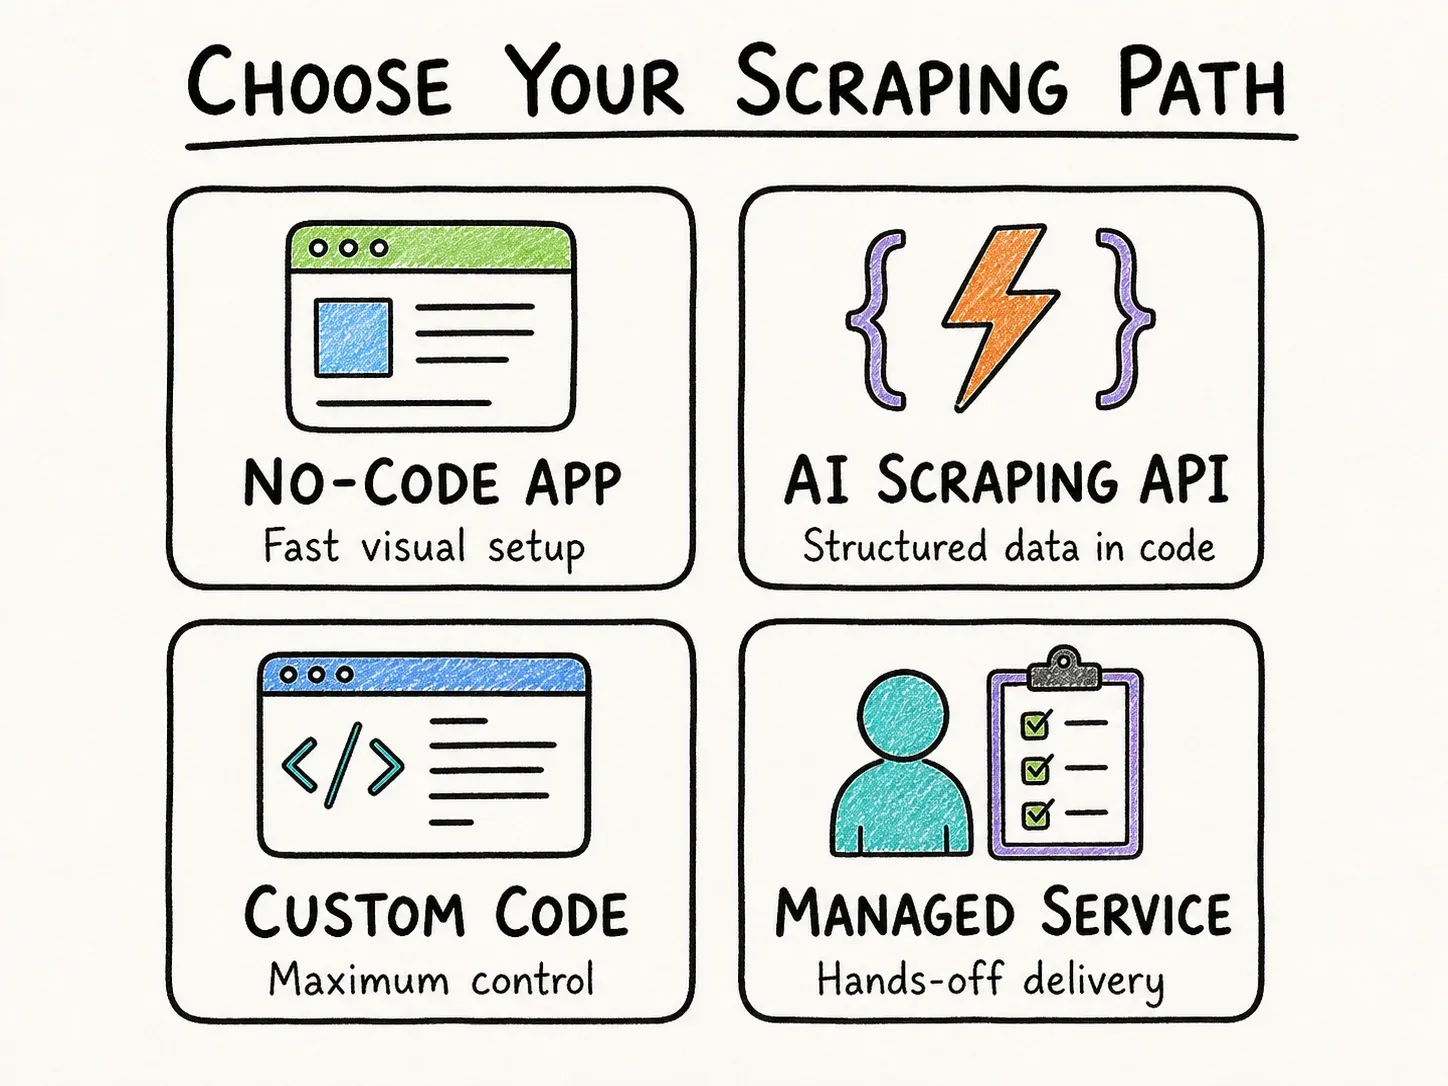
Dessa kategorier överlappar allt oftare. Vissa plattformar kombinerar ett visuellt gränssnitt med utvecklar-API:er, medan andra fokuserar på låg nivå-kontroll över proxyer eller helt hanterad leverans. Listan nedan jämför produkterna utifrån det arbetsflöde de stödjer i dag.
Vad är ett data scraping-API?
Låt oss backa bandet lite. Ett data scraping-API är ett verktyg som låter dig extrahera data från webbplatser programmatiskt — utan att du behöver bygga egna scrapers från grunden. Tänk på det som en robot du kan skicka ut för att hämta senaste priser, recensioner eller listningar, och som sedan kommer tillbaka med datan i ett snyggt strukturerat format (vanligtvis JSON eller CSV).
Hur fungerar de? De flesta scraping-API:er tar hand om de krångliga delarna — roterande proxies, CAPTCHA-lösning och JavaScript-rendering — så att du kan fokusera på det du faktiskt behöver: datan. Du skickar en begäran (oftast med en URL och några parametrar), och API:et returnerar innehållet redo för ditt affärsflöde.
Viktigaste fördelarna:
- Hastighet: API:er kan skrapa tusentals sidor per minut.
- Skalbarhet: Behöver du bevaka 10 000 produkter? Inga problem.
- Integration: Koppla in det i ditt CRM, BI-verktyg eller data warehouse med minimalt krångel.
Men som vi ska se är inte alla API:er skapade lika — och inte alla är så “ställ in och glöm” som de påstår.
Hur jag utvärderade dessa API:er
Jag har tillbringat mycket tid i skyttegravarna — testat, kraschat och ibland råkat DDoSa mina egna servrar (säg inget till mitt gamla IT-team). För den här listan fokuserade jag på:
- Tillförlitlighet: Fungerar det verkligen, även på svåra webbplatser?
- Hastighet: Hur snabbt kan det leverera resultat i stor skala?
- Pris: Är det rimligt för startups och skalbart för större företag?
- Skalbarhet: Klarar det miljontals anrop, eller kollapsar det vid 100?
- Utvecklarvänlighet: Är dokumentationen tydlig? Finns det SDK:er och kodexempel?
- Support: När det spårar ur (och det kommer det att göra), finns hjälp att få?
- Användaromdömen: Verkliga recensioner, inte bara marknadsföringssnack.
Jag lutade mig också tungt mot praktiska tester, analys av recensioner och feedback från Thunderbit-communityn (vi är rätt kräsna av oss).
De 11 API:er som är värda att överväga 2026
Redo för huvudnumret? Här är min aktuella kortlista över web scraping-API:er och plattformar för affärsanvändare och utvecklare 2026.
1. Thunderbit
Översikt:
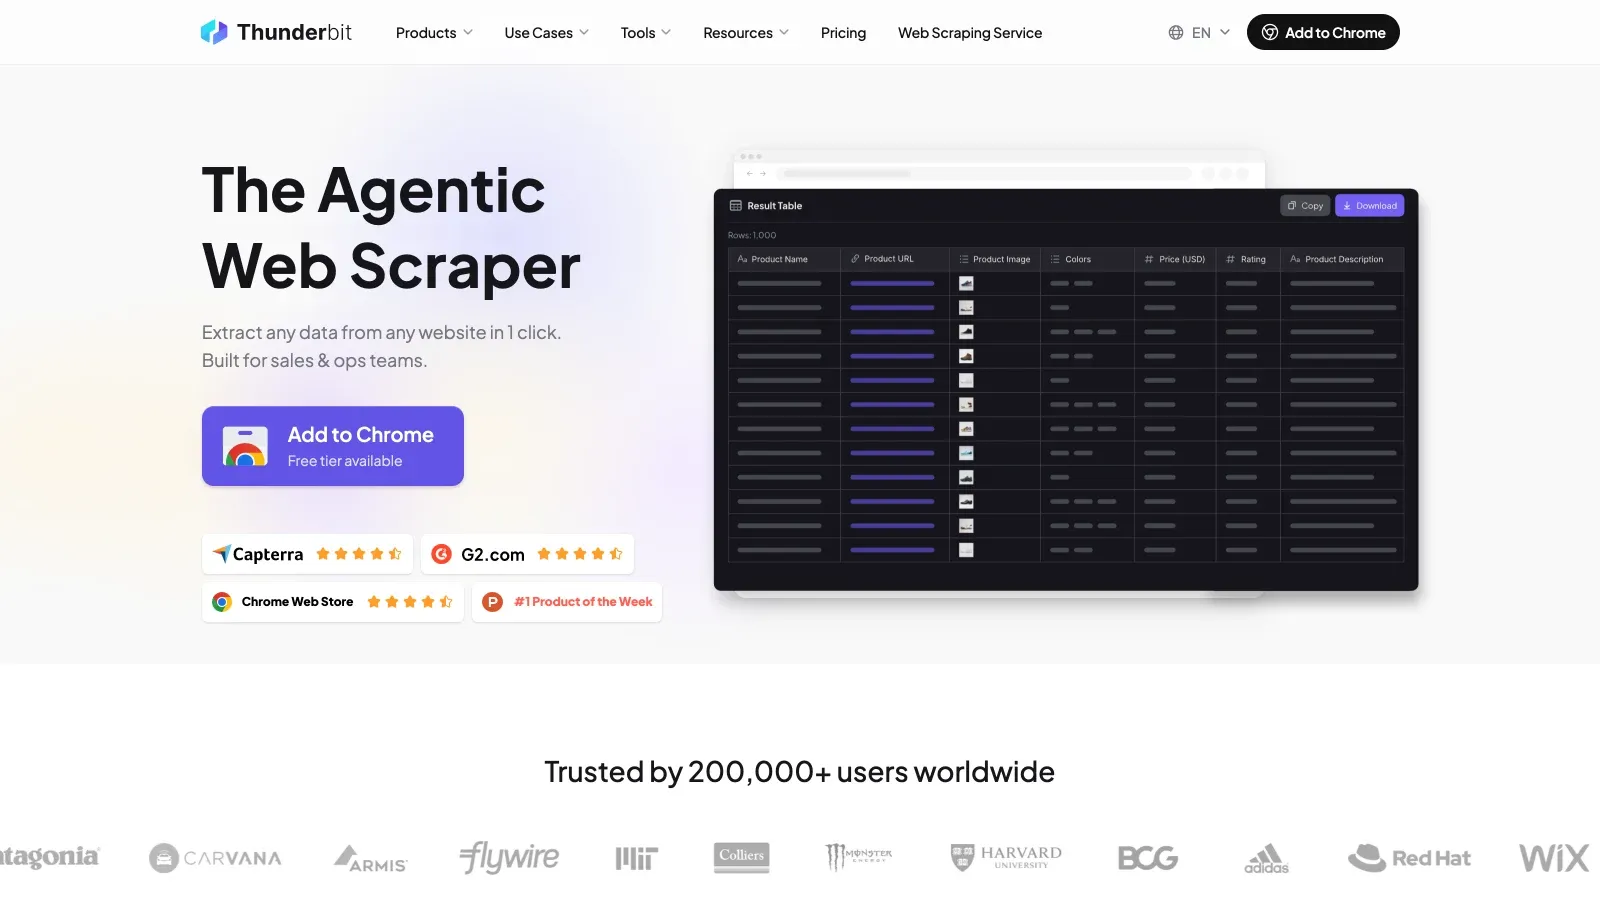
Thunderbit erbjuder nu både en no-code AI web scraper och ett Web Scraper API för utvecklare. För API-användare delar dess två kärnendpointar upp innehållshämtning från strukturerad extraktion: Distill omvandlar en URL till ren Markdown, medan Extract använder ett JSON Schema för att returnera validerad strukturerad data. Det gör verktyget användbart för RAG-ingestion, agentverktyg, berikning av databaser, prisövervakning och datamängder från flera källor.
Nyckelfunktioner:
- Distill för innehåll från URL till Markdown, med JavaScript-rendering och valfria länkar, bilder, metadata, sammanfattningar, svar och highlights
- Extract för schema-styrd JSON utan CSS-selektorer eller parsingsregler per webbplats
- Synkrona anrop för enstaka sidor samt asynkrona batchjobb; Batch Distill tar upp till 100 URL:er och Batch Extract upp till 50
- Bearer-token-autentisering, batchstatus per URL, felhantering med stöd för återförsök, polling och signerade webhooks
- CLI, SDK, MCP, automation och väldokumenterade integrationsvägar för tekniska arbetsflöden
Pris:
API:et har en engångsfria tilldelning på 600 enheter. Distill kostar 1 enhet per sida och Extract kostar 20 enheter per sida. Starter-planen kostar 16 USD/månad vid årsbetalning för 60 000 enheter per år och 30 samtidiga anrop; Pro börjar på 40 USD/månad vid årsbetalning för 600 000 enheter per år och 50 samtidiga anrop. Kontrollera Thunderbit API-priser innan publicering eftersom användningsgränser och planpriser kan ändras.
Passar bäst för:
Team som vill ha AI-baserad extraktion utan att underhålla selektorer, särskilt när samma organisation behöver ett visuellt arbetsflöde för operatörer och ett API för utvecklare.
Viktigaste avvägningen:
Thunderbit är optimerat för intention- och schema-driven extraktion snarare än låg nivå-kontroll över proxy eller webbläsare. Om ditt användningsfall kräver finjustering av enskilda proxy-sessioner eller skriptad hantering av ovanliga sidinteraktioner kan ett proxy-first-API eller en egen webbläsarautomationsstack passa bättre.
Utforska Thunderbit Web Scraper API
2. Oxylabs
 Översikt:
Oxylabs är tungviktsmästaren för web data-extraktion i företagsklass. Med en enorm proxypool och specialiserade API:er för allt från SERP:ar till e-handel är det förstahandsvalet för Fortune 500-bolag och alla som behöver tillförlitlighet i stor skala.
Nyckelfunktioner:
- Stort proxynätverk (residential, datacenter, mobile, ISP) i 195+ länder
- Scraper API:er med anti-bot-skydd, CAPTCHA-lösning och headless browser-rendering
- Geotargeting, sessionspersistens och hög datanoggrannhet (95%+ lyckandefrekvens)
- OxyCopilot: AI-assistent som automatiskt genererar parsingskod och API-förfrågningar
Pris:
Från cirka 49 USD/månad för ett enskilt API, 149 USD/månad för all-in-one-åtkomst. Inkluderar en gratis provperiod på 7 dagar med upp till 5 000 anrop.
Användaromdömen:
Får genomgående starka recensioner på G2 för tillförlitlighet och support. Den stora nackdelen? Det är dyrt — men man får vad man betalar för.
3. ScrapingBee
 Översikt:
ScrapingBee är utvecklarens bästa vän — enkelt, prisvärt och fokuserat. Du skickar en URL, så hanterar det headless Chrome, proxies och CAPTCHA:er och returnerar den renderade sidan eller bara den data du behöver.
Nyckelfunktioner:
- Headless browser-rendering med JavaScript-stöd
- Automatisk IP-rotation och CAPTCHA-lösning
- Stealth-proxypool för svåra webbplatser
- Minimal uppsättning — det räcker med ett API-anrop
Pris:
Gratisnivå med 1 000 API-krediter, inget kreditkort krävs. Betalda planer börjar på 49 USD/månad (Freelance-nivån, 250 000 krediter) enligt scrapingbee.com/pricing.
Användaromdömen:
Får genomgående bra omdömen på G2. Utvecklare gillar enkelheten; icke-kodare kan tycka att det är lite väl avskalat.
4. Apify
 Översikt:
Apify är schweizisk armékniv för web scraping. Du kan bygga egna scrapers (“Actors”) i JavaScript eller Python, eller använda deras stora bibliotek av färdigbyggda actors för populära webbplatser. Det är så flexibelt som du behöver att det ska vara.
Nyckelfunktioner:
- Egna och färdigbyggda scrapers (Actors) för nästan vilken webbplats som helst
- Molninfrastruktur, schemaläggning och proxyhantering ingår
- Dataexport till JSON, CSV, Excel, Google Sheets med mera
- Aktiv community och stöd via Discord
Pris:
Gratis plan med 5 USD i plattformskredit. Betalda planer börjar på 29 USD/månad (Starter) plus pay-as-you-go-användning enligt apify.com/pricing.
Användaromdömen:
Väl omdömt på G2 och Capterra. Utvecklare gillar flexibiliteten; nybörjare möter en brantare inlärningskurva.
Se hur Apify jämförs med Thunderbit
5. Decodo (tidigare Smartproxy)
 Översikt:
Decodo (Smartproxys nya varumärke, nu helt live på decodo.com) satsar på värde och enkel användning. Det kombinerar ett stort proxynätverk med scraping-API:er för allmän webb, SERP:ar, e-handel och sociala medier — allt under en enda prenumeration, och den nylanserade all-in-one Web Scraping API levereras med 100+ förbyggda mallar och en AI Parser.
Nyckelfunktioner:
- Enhetligt scraping-API för alla endpoints (inga separata tillägg längre)
- Specialiserade scrapers för Google, Amazon, TikTok med mera
- Användarvänlig dashboard med playground och kodgeneratorer
- 24/7 livechatt-support
Pris:
Från cirka 50 USD/månad för 25 000 anrop. Gratis provperiod i 7 dagar med 1 000 anrop.
Användaromdömen:
Prisad för “mycket för pengarna” och snabb support.
6. Octoparse
 Översikt:
Octoparse är no-code-mästaren. Om du avskyr kod men älskar data låter den här pek-och-klicka-datorappen, med molnfunktioner, dig bygga scrapers visuellt och köra dem lokalt eller i molnet.
Nyckelfunktioner:
- Visuell arbetsflödesbyggare — klicka bara för att välja datafält
- Molnextraktion, schemaläggning och automatisk IP-rotation
- Mallar för populära webbplatser och en marknadsplats för anpassade scrapers
- Octoparse AI: integrerar RPA och ChatGPT för datarensning och automatisering av arbetsflöden
Pris:
Gratis plan för upp till 10 lokala uppgifter. Betalda planer börjar på 83 USD/månad, eller 69 USD/månad vid årsbetalning (molnfunktioner, obegränsat antal uppgifter). 14 dagars gratis provperiod för premiumfunktioner.
Användaromdömen:
4.4/5 på G2. Älskas av icke-kodare, men avancerade användare kan stöta på begränsningar.
7. Bright Data
 Översikt:
Bright Data är den stora jätten — om du behöver skala, hastighet och alla funktioner du kan tänka dig är det här din plattform. Med världens största proxynätverk och en kraftfull scraping-IDE är den byggd för enterprise.
Nyckelfunktioner:
- 400M+ IP-adresser (residential, mobile, ISP, datacenter)
- Web Scraper IDE, färdigbyggda datainsamlare och färdiga dataset att köpa
- Avancerat anti-bot-skydd, CAPTCHA-lösning och stöd för headless browsers
- Fokus på compliance och juridik (Ethical Web Data-initiativet)
Pris:
Pay-as-you-go för Web Scraper API kostar 1,50 USD per 1 000 poster, med en Scale-plan för 499 USD/månad som inkluderar 384 000 poster och 1,30 USD per 1 000 poster därefter. Du betalar bara för lyckade leveranser. En gratisnivå med 5 000 poster per månad finns utan kreditkort. Proxyprodukter säljs separat per GB. Se brightdata.com/pricing/web-scraper för aktuella priser.
Användaromdömen:
Prisad för prestanda och funktioner, men priset och komplexiteten kan vara en tröskel för mindre team.
8. WebAutomation
 Översikt:
WebAutomation är en molnbaserad plattform som är byggd för icke-utvecklare. Med en marknadsplats av färdigbyggda extractors och en no-code-byggare passar den perfekt för affärsanvändare som vill ha data, inte kod.
Nyckelfunktioner:
- Färdigbyggda extractors för populära webbplatser (Amazon, Zillow med flera)
- No-code-byggare med point-and-click-gränssnitt
- Molnbaserad schemaläggning, dataleverans och underhåll ingår
- Radbaserad prissättning (du betalar för det du extraherar)
Pris:
Project-plan för 74 USD/månad (~400k rader/år), pay-as-you-go för 1 USD per 1 000 rader. 14 dagars gratis provperiod med 10 miljoner krediter.
Användaromdömen:
Användare gillar enkelheten och den transparenta prissättningen. Supporten är hjälpsam och underhållet sköts av teamet.
9. ScrapeHero
 Översikt:
ScrapeHero började som en konsultverksamhet för skräddarsydd scraping och erbjuder nu en molnplattform med självbetjäning. Du kan använda färdigbyggda scrapers för populära webbplatser eller beställa helt hanterade projekt.
Nyckelfunktioner:
- ScrapeHero Cloud: färdigbyggda scrapers för Amazon, Google Maps, LinkedIn med mera
- No-code-drift, schemaläggning och molnleverans
- Skräddarsydda lösningar för unika behov
- API-åtkomst för programmatisk integration
Pris:
Molnplaner börjar så lågt som 5 USD/månad. Skräddarsydda projekt från 550 USD per webbplats (engångskostnad).
Användaromdömen:
Prisad för tillförlitlighet, datakvalitet och support. Bra för att skala från gör-det-själv till hanterade lösningar.
10. Sequentum
 Översikt:
Sequentum är företagets schweiziska armékniv — byggt för compliance, spårbarhet och enorm skala. Om du behöver SOC-2-certifiering, granskningsloggar och samarbete i team är det här verktyget för dig.
Nyckelfunktioner:
- Low-code agent designer (point-and-click plus skriptning)
- Molnbaserad SaaS eller installation på plats
- Inbyggd proxyhantering, CAPTCHA-lösning och headless browsers
- Granskningsspår, rollbaserad åtkomst och SOC-2-efterlevnad
Pris:
Pay-as-you-go (6 USD/timme körning, 0,25 USD/GB export), Starter-plan från 199 USD/månad. 5 USD i gratis kredit vid registrering.
Användaromdömen:
Företag gillar compliance-funktionerna och skalbarheten. Det finns en inlärningskurva, men support och utbildning håller toppklass.
11. Grepsr
 Översikt:
Grepsr är en hanterad tjänst för dataextraktion — säg bara vad du behöver, så bygger, kör och underhåller de scrapers åt dig. Perfekt för företag som vill ha data utan det tekniska krånglet.
Nyckelfunktioner:
- Hanterad extraktion (“Grepsr Concierge”) — de sätter upp och underhåller allt
- Molndashboard för schemaläggning, övervakning och nedladdning av data
- Flera exportformat och integrationer (Dropbox, S3, Google Drive)
- Betala per datapost, inte per anrop
Pris:
Startpaket för 350 USD (engångsextraktion), återkommande abonnemang offereras individuellt.
Användaromdömen:
Kunder gillar den helt avlastade upplevelsen och den snabba supporten. Bra för icke-tekniska team och för dem som värdesätter tid framför pillande.
Snabb jämförelsetabell: de bästa web scraping-API:erna
Här är fusklappen för alla 11 plattformar:
| Plattform | Stödda datatyper | Startpris | Gratis provperiod | Användarvänlighet | Support | Utmärkande funktioner |
|---|---|---|---|---|---|---|
| Thunderbit | Webbsidor, Markdown, strukturerad JSON | Gratis / 16 USD/mån vid årsbetalning | 600 engångsenheter | API + no-code | Bas/priority beroende på plan | Distill, JSON Schema-extraktion, batchjobb, webhooks |
| Oxylabs | Webb, SERP, e-handel, fastigheter | 49 USD/mån | 7 dagar/5k anrop | Utvecklarfokuserad | 24/7, enterprise | OxyCopilot AI, enorm proxypool, geo-targeting |
| ScrapingBee | Allmän webb, JS, CAPTCHA | 49 USD/mån | 1k krediter | Enkel API | E-post, forum | Headless Chrome, stealth-proxyer |
| Apify | All webb, färdigbyggt/anpassat | Gratis/29 USD/mån + användning | Alltid gratis | Flexibel, komplex | Community, Discord | Actor-marknadsplats, molninfrastruktur, integrationer |
| Decodo | Webb, SERP, e-handel, socialt | 50 USD/mån | 7 dagar/1k anrop | Användarvänlig | 24/7 livechatt | Enhetligt API, kod-playground, bra värde |
| Octoparse | All webb, no-code | Gratis/69 USD/mån | 14 dagar | Visuell, no-code | E-post, forum | Point-and-click-gränssnitt, moln, Octoparse AI |
| Bright Data | All webb, dataset | 1,50 USD/1k poster | 5K poster/mån | Kraftfull, komplex | 24/7, enterprise | Största proxynätverket, IDE, färdiga dataset |
| WebAutomation | Strukturerat, e-handel, fastigheter | 74 USD/mån | 14 dagar/10M rader | No-code, mallar | E-post, chatt | Förbyggda extractors, radbaserad prissättning |
| ScrapeHero | E-handel, kartor, jobb, anpassat | 5 USD/mån | Ja | No-code, hanterat | E-post, ärenden | Molnscrapers, skräddarsydda projekt, Dropbox-leverans |
| Sequentum | All webb, enterprise | 0/199 USD/mån | 5 USD kredit | Low-code, visuellt | Hög beredskap | Granskningsspår, SOC-2, on-prem/moln |
| Grepsr | All strukturerad data, hanterad | 350 USD engångs | Exempelkörning | Helt hanterat | Dedikerad kontaktperson | Concierge-setup, betala per data, integrationer |
Så väljer du rätt web scraping-verktyg för ditt företag
Så, vilket verktyg ska du välja? Så här brukar jag dela upp det för team jag rådgiver:
-
Om du vill ha ingen kod, snabb uppstart och AI-driven fältextraktion:
Använd Thunderbit AI Web Scraper när operatörer behöver kunna definiera, granska och exportera data visuellt. Octoparse och WebAutomation är också värda att testa om du föredrar ett mer traditionellt visuellt arbetsflöde eller en marknadsplats med färdigbyggda extractors.
-
Om du behöver rent webbinnehåll eller strukturerad JSON i en produkt eller agent:
Börja med Thunderbit Web Scraper API när schema-driven extraktion och minimalt underhåll av selektorer är viktigt. ScrapingBee är ett rakt renderings-API; Apify erbjuder en bredare programmerbar plattform; Oxylabs och Bright Data ger djupare proxy- och enterprise-infrastruktur.
-
Om du behöver maximal kontroll över webbläsare eller proxyer:
Välj ett proxy-first-API eller en egen browser automation-stack. Du får ta större ansvar för uppsättning och underhåll, men du kan finjustera sessioner och interaktioner på en lägre nivå.
-
Om du behöver compliance, spårbarhet eller enterprise-funktioner:
Sequentum är byggt för dig. Det är dyrare, men värt det för reglerade branscher.
-
Om du bara vill att någon annan sköter allt:
Grepsr eller ScrapeHeros hanterade tjänster är rätt väg. Du betalar lite mer, men blodtrycket kommer tacka dig.
Och om du fortfarande är osäker erbjuder de flesta av dessa plattformar gratis provperioder — så testa dem!
Viktiga slutsatser
- Web scraping-API:er är nu avgörande för datadrivna företag — Mordor Intelligence:s rapport för 2026 satte marknaden till 1,03 miljarder USD under 2025 och förutspår att den ungefär fördubblas till 2030, med AI-träningsdata, e-handelsinsikter och SERP-övervakning som de främsta tillväxtdrivarna.
- Arbetsflödet är viktigare än etiketten. Använd en no-code-app för operatörsstyrda uppgifter, ett API för inbyggda eller agentdrivna flöden, egen kod för ovanlig browser-kontroll och en hanterad tjänst när du vill outsourca leveransen.
- Varje API/plattform har sina styrkor:
- Thunderbit för AI-baserad Distill och schema-driven Extract
- Oxylabs och Bright Data för skala och tillförlitlighet
- Apify för flexibilitet
- Decodo för värde
- WebAutomation för no-code
- Sequentum för compliance
- Grepsr för helt avlastad hanterad data
- Thunderbit hör nu hemma i både no-code- och API-kategorin. Dess visuella scraper hjälper operatörer, medan Distill, Extract, batchjobb och webhooks stödjer utvecklar- och agentflöden.
- Det bästa verktyget är det som passar ditt arbetsflöde, din budget och dina tekniska kunskaper. Var inte rädd för att testa dig fram!
Om du vill testa API-vägen, börja med Thunderbit Distill eller Extract. Om du föredrar ett visuellt arbetsflöde, använd Thunderbit AI Web Scraper. För fler guider om implementation, läs Thunderbit Blog.
Och kom ihåg: i världen av webbdata är det enda som förändras snabbare än själva webbplatserna tekniken vi använder för att skrapa dem. Var nyfiken, håll processen automatiserad och må dina proxies aldrig blockeras.




