
Din CRM är bara så bra som datan du matar in i den. Och den bästa datan hittar du på offentliga webbplatser — inte i dyra tredjepartsdatabaser.
Web extractors förvandlar stökig webbdata till rena kalkylblad. De bra verktygen fixar det på några minuter, utan kod.
Jag har använt de här verktygen i riktiga projekt — för att bygga leadlistor, hålla koll på konkurrenters priser och skrapa produktkataloger. Här är 12 verktyg som höll måttet, rankade efter hur bra de fungerade för faktiska affärsuppgifter.
Varför web extractors är en affärsnödvändighet
Låt oss vara ärliga: webben är världens största (och rörigaste) databas. Och 2026 är det företagen som kan omvandla det här kaoset till insikter som drar ifrån. Datadrivna företag presterar konsekvent bättre än sina konkurrenter, både när det gäller produktivitet och lönsamhet. Fördelen är på riktigt — om du faktiskt lyckas få tag på datan.
Web extractor-verktyg (ibland kallade web page extractors eller web extracting-lösningar) är det hemliga vapnet här. De låter säljteam skrapa offentliga kataloger, sociala medier och företagswebbplatser för att bygga riktade prospektlistor — så du slipper köpa gamla leadlistor eller hoppas att praktikanten inte säger upp sig mitt i copy-paste-maratonet (Thunderbit Blog). Marknadsförings- och e-handels-team använder web extractors för att följa konkurrenters prissättning, bevaka lagersaldon och benchmarka produkter i realtid — John Lewis, till exempel, tillskriver web scraping en försäljningsökning på 4 % enbart tack vare smartare prissättning (Thunderbit Blog).
Men det handlar inte bara om siffror. Web extractors sparar enormt mycket tid (en användare rapporterade att de sparade ”hundratals timmar” genom att automatisera datainsamling) och minskar mänskliga fel (Thunderbit Blog). Driftteam sätter nu upp scrapers för att kontinuerligt samla in data som tidigare hade tagit praktikanter veckor — och frigör timmar som annars gått åt till trist copy-paste (Thunderbit Blog). Och med AI-drivna extractors kan även icke-tekniska användare förvandla webbplatser till strukturerad data för analys (Box Piper).
Kort sagt? Om du inte använder en web extractor 2026, lämnar du sannolikt insikter — och pengar — på bordet.
Hur vi valde de 12 bästa web extractors
Med så många web extracting-verktyg där ute, hur väljer man rätt? Jag tittade på dussintals alternativ, men bara 12 tog sig in på listan. Här är vad jag fokuserade på:
- Enkel användning: Kan en icke-teknisk användare komma igång snabbt utan att skriva kod? Jag prioriterade no-code- eller low-code-verktyg med intuitiva gränssnitt (Thunderbit Blog).
- AI-funktioner: Nästa generations verktyg som använder AI för att förenkla scraping — till exempel genom att automatiskt känna igen datafält, hantera navigering på sajten eller låta dig beskriva vad du behöver med vanligt språk (Thunderbit Blog).
- Automatisering och schemaläggning: De bästa web extractors körs på autopilot. Jag valde verktyg som stöder schemalagda extraheringar eller bevakning av webbplatser (Thunderbit Blog).
- Dataexport och integration: Kan du enkelt exportera till Excel, Google Sheets, Airtable eller Notion? Pluspoäng för arbetsflödesintegrationer (Thunderbit Blog).
- Skalbarhet och tillförlitlighet: Oavsett om du skrapar en sida eller tusentals ska verktygen klara jobbet. Jag tog också hänsyn till användaromdömen om stabilitet.
- Affärsorienterade användningsfall: Jag lade vikt vid verktyg som är populära bland sälj-, marknadsförings-, e-handels- och driftteam — inte bara bland utvecklare.
Vissa verktyg här är AI-drivna nykomlingar, andra är klassiker i branschen. Alla är byggda för att hjälpa dig förvandla webben till din egen affärsdatabas — utan huvudvärk.
Snabb jämförelse: web extractor-verktyg i korthet
Här är en överblick av de 12 web extractor-verktyg jag går igenom, så att du kan se hur de står sig:
| Verktyg | AI-automatisering | Enkel användning | Bästa användningsfall |
|---|---|---|---|
| Thunderbit | Ja – AI föreslår fält och hanterar sidor automatiskt | Väldigt enkelt (Chrome-tillägg, ingen kod) | Snabb scraping av leads, priser med mera för icke-tekniska användare som vill ha resultat på några minuter. |
| Octoparse | Begränsad (mallbaserad, ingen AI) | Enkelt för de flesta (visuellt dra-och-släpp-gränssnitt) | Anpassade scraping-flöden (med inloggning, paginering) för analytiker som vill ha kontroll utan kod. |
| Browse AI | Delvis – punkt-och-klicka ”robots” | Enkelt (no-code, molnbaserat) | Automatiserad bevakning av data (priser, listningar etc.) enligt schema, med aviseringar och integrationer. |
| WebScraper.io | Nej (manuell konfiguration) | Medel (webbläsartillägg med sitemap-setup) | Visuell scraping av webbplatser i flera nivåer för användare som vill konfigurera stegen själva. |
| ScraperAPI | N/A (API-tjänst, hanterar proxies via API) | Kräver kodning (API-integration) | Webbdataextrahering i hög volym för teknikteam — proxies och CAPTCHAs hanteras för storskalig scraping. |
| Data Miner | Nej | Väldigt enkelt (webbläsartillägg med mallar med ett klick) | Snabb engångsextrahering från sidor (särskilt tabeller eller listor) direkt till CSV/Excel. |
| Simplescraper | Nej (vissa AI-assisterade funktioner) | Enkelt (receptbyggare med punkt-och-klick) | No-code scraping med integrationer — bra för att skicka webbdata till Google Sheets, Airtable eller API. |
| Instant Data Scraper | Ja – känner automatiskt igen datatabeller | Väldigt enkelt (bara klicka, ingen setup) | Direkt gratis scraping av HTML-tabeller och listor av vem som helst (perfekt för snabba datauttag). |
| ScrapeStorm | Ja – AI identifierar sidans element | Enkelt (visuellt gränssnitt; plattformsoberoende app) | Stora eller komplexa scrapingprojekt utan kod, inklusive schemalagda crawls. |
| Apify | Viss – färdiga ”actor”-bots finns tillgängliga | Medel (webbgränssnitt; kodning valfritt) | Skalbar molnscraping och automatisering via färdiga eller egna skript. |
| ParseHub | Nej (utan script men med manuell setup) | Enkelt för grundläggande användning (visuell editor; desktop-app) | Scraping av dynamiska eller komplexa sajter (AJAX-innehåll) genom ett no-code-gränssnitt. |
| OutWit Hub | Nej | Enkelt (desktop-GUI-applikation) | Enkel, offline-baserad dataextrahering och innehållsarkivering för mindre projekt. |
De flesta verktyg erbjuder gratisplan eller testperiod samt nivåindelade abonnemang. Fokus här ligger på funktioner och användningsfall snarare än pris.
Thunderbit: den AI-drivna web extractorn för alla

Skrapa data från vilken webbplats som helst med AI Inga selektorer, ingen setup — AI läser sidan och ger dig en strukturerad tabell med 1 klick. Get Started Free
Vi börjar med Thunderbit — ja, det är min egen grej, men häng med. Web extracting-branschen håller på att skifta från ”konfigurera din egen scraper” till ”berätta bara för AI:n vad du vill ha”. Thunderbit är det första verktyg jag sett (och hjälpt till att bygga) som verkligen känns som en AI-datassistent snarare än ännu en ”crawler”.
Med Thunderbit behöver du inte pilla med XPath, CSS-selektorer eller reguljära uttryck. Du beskriver bara datan du vill ha med vanligt språk — till exempel ”hämta titel, författare och datum från den här sidan” — och Thunderbits AI sköter resten (Thunderbit Blog). Klicka på ”AI Suggest Fields”, så läser Thunderbit sidan, föreslår kolumner och hanterar till och med undersidor och paginering automatiskt (Thunderbit Blog).
Men det handlar inte bara om att hämta data. Thunderbit kan rensa, omvandla, kategorisera och till och med översätta fält medan det skrapar. Behöver du standardisera telefonnummer, sammanfatta beskrivningar eller översätta produktnamn? Lägg bara till en snabb instruktion, så fixar AI:n det. Och när du är klar kan du exportera direkt till Excel, Google Sheets, Airtable eller Notion (Thunderbit Blog).
Det som verkligen skiljer Thunderbit åt är ingen setup, ingen inlärningskurva. Det är ett Chrome-tillägg, så du är igång på några sekunder. Inga plugins, ingen konfiguration, inget tekniskt jargongsnack. Därför har det blivit en favorit för sälj-, marknadsförings- och driftteam som behöver resultat snabbt (Thunderbit Blog). Gratisplanen låter dig testa hela flödet, och betalplanerna är prisvärda (tänk ”mindre än din månatliga kaffebudget” för de flesta team).
Om du vill känna hur AI-web extracting fungerar, ladda ner Thunderbit Chrome Extension och testa. Dina copy-paste-dagar kan mycket väl vara över.
Octoparse: visuell web extractor för anpassade arbetsflöden
Octoparse är en klassiker inom visuell web scraping. Det är en desktop-app med ett punkt-och-klick-gränssnitt — du interagerar med webbplatsen, markerar datan du vill ha och Octoparse bygger ett arbetsflöde i bakgrunden (Thunderbit Blog). Du kan hantera inloggningar, ställa in paginering och till och med automatisera formulärinlämningar, allt utan att skriva kod.
En av Octoparses styrkor är dess bibliotek med 500+ färdiga mallar för populära sajter (Amazon, Twitter, LinkedIn osv.), så du kan ofta bara ladda en mall och börja extrahera (Thunderbit Blog). För mer komplexa sajter kan du växla till manuellt läge och konfigurera varje steg visuellt. Octoparse stöder innehåll som laddas efter klick eller scrollning, och kan arbeta med proxies och lösa CAPTCHAs för tuffare jobb. Det finns också ett molnbaserat alternativ för att schemalägga och köra scraping i stor skala.
Nackdelen? Det finns lite av en inlärningskurva, särskilt om du vill hantera avancerade scenarier. Men för icke-programmerare och dataanalytiker som vill ha ett anpassat scraping-flöde utan kod är Octoparse ett starkt val (Dev.to).
Browse AI: automatiserat web extracting med färdiga robots
Browse AI har en smart och smidig approach: du tränar en ”robot” genom att peka och klicka på datan du vill ha, och den lär sig att extrahera den datan på liknande sidor (Thunderbit Blog). Allt är molnbaserat och no-code, så du slipper tänka på skript eller servrar.
Det som gör Browse AI extra intressant är dess automatisering och bevakning. Du kan schemalägga dina robots att köras regelbundet och få aviseringar när data ändras (till exempel när en konkurrent sänker sitt pris eller en ny jobbannons dyker upp). De erbjuder också ett bibliotek med färdiga robots för vanliga uppgifter — så du kan ofta börja med en färdig lösning och justera den vid behov (ToolsForHumans).
Browse AI integreras med tusentals appar via Zapier och Make, och kan exportera data direkt till Google Sheets eller via API/webhooks (Thunderbit Blog). Det passar perfekt för kontinuerlig övervakning och återkommande datainsamling, särskilt om du vill ha aviseringar och integrationer som sköter sig själva.
WebScraper.io: webbaserad web page extractor
WebScraper.io (ofta bara kallat ”Web Scraper”) är ett webbläsartillägg som låter dig bygga ”sitemaps” — visuella planer för hur en webbplats ska navigeras och vilka element som ska extraheras (Thunderbit Blog). Du definierar selektorer för datan du behöver och länkarna du ska följa (till exempel ”klicka på nästa-knappen för att paginera” eller ”besök varje produktlänk för detaljer”).
Det finns lite av en inlärningskurva, men du skriver ingen kod — du väljer bara sidans element och ställer in extraheringsåtgärder. Web Scraper stöder navigering på flera nivåer, paginering och till och med oändlig scroll (även om du måste ange dessa steg manuellt). Det är flexibelt och körs i din webbläsare, så du kan skrapa sidor bakom inloggning genom att själv logga in.
WebScraper.io passar perfekt för ”medborgardataanalytiker” som är bekväma med webbside-strukturer och vill ha ett gratis, flexibelt verktyg. Det är en pålitlig arbetshäst om du är beredd att sätta upp egna sitemaps.
ScraperAPI: API-först web extractor för utvecklare och team
Alla team vill inte ha ett punkt-och-klick-gränssnitt — ibland behöver du en backend-lösning som skickar webbdata direkt in i dina appar eller databaser. ScraperAPI är en API-först web extractor: du ger den en URL och den returnerar rå HTML eller extraherad data, och hanterar allt det knepiga som proxies, geografisk IP-rotation, headless browsers och CAPTCHAs åt dig (ScraperAPI Pricing).
ScraperAPI har en pool av 40 miljoner proxies i 50 länder och uppger att de hanterar miljarder förfrågningar för mer än 10 000 företag. Det är bäst för storskalig, automatiserad scraping där tillförlitlighet och anti-blockering är avgörande. Du behöver viss kodkunskap för att använda det, men om du bygger datapipelines eller integrerar scraping i din produkt är ScraperAPI ett toppval.
Data Miner: Chrome-tillägg för snabb web page extracting
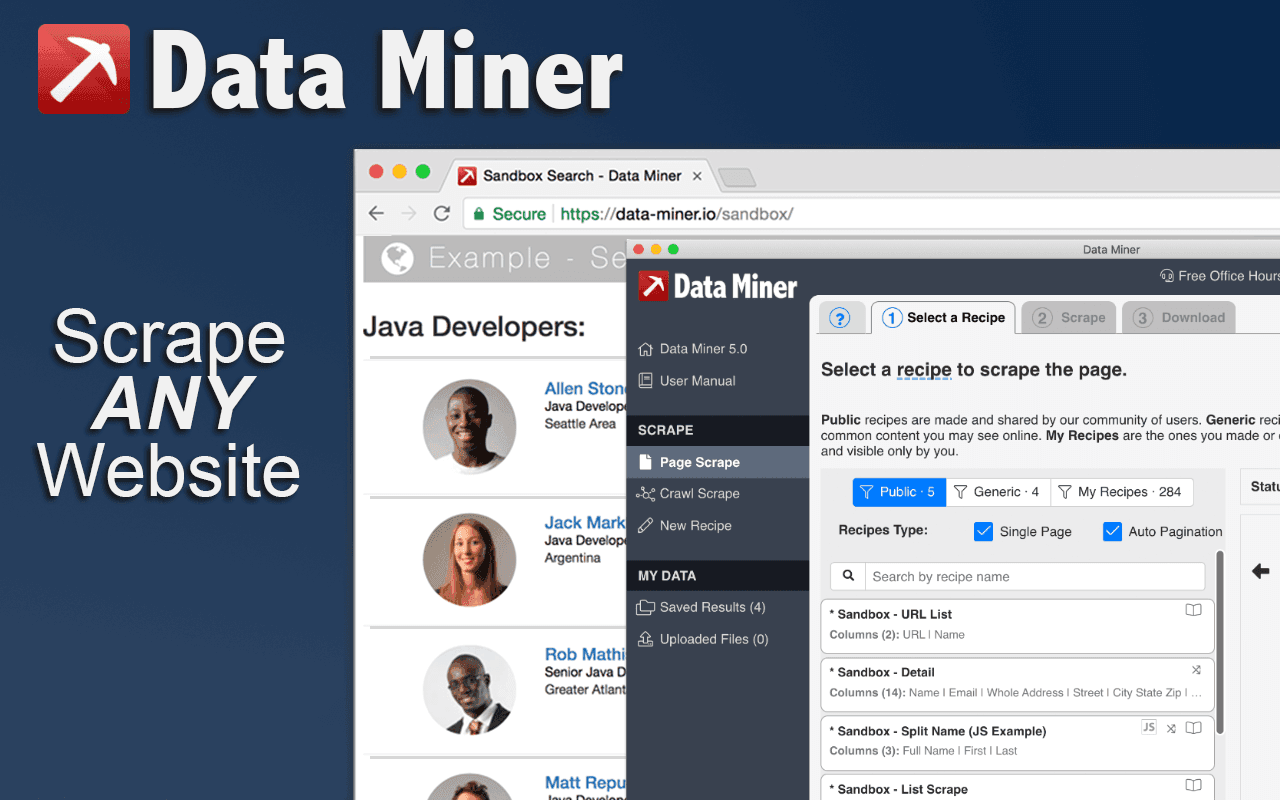
Data Miner är ett Chrome-tillägg byggt för affärsanvändare och forskare som snabbt behöver få ut data. Det erbjuder en punkt-och-klick-scraping-upplevelse och ett bibliotek med färdiga scraping-”recept” för vanliga mönster som tabeller, listor eller specifika sajter (Dev.to).
Installera bara tillägget, gå till din målsida och klicka på Data Miner-ikonen. Välj ett recept eller skapa ditt eget genom att markera element på sidan. Det är utmärkt för engångsuppgifter eller snabba databehov — tänk säljare som hämtar en lista över leads från en onlinekatalog, eller en e-handelschef som kopierar konkurrentpriser.
Data Miner är enkelt, integrerat i webbläsaren och perfekt för interaktiv scraping på begäran.
Simplescraper: no-code web extractor för snabba resultat
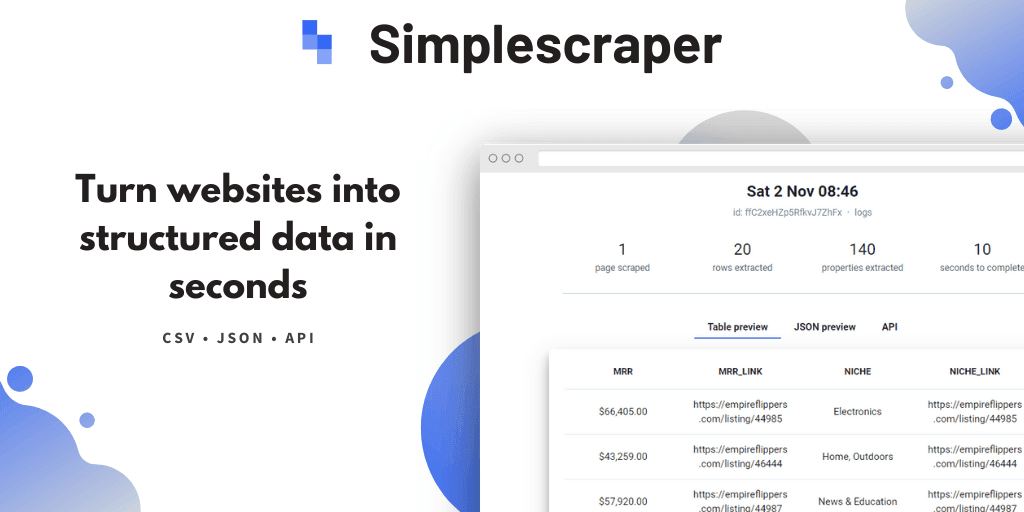
Simplescraper lever upp till sitt namn. Det är ett no-code Chrome-tillägg (och en webbapp) som låter dig visuellt välja data på en sida för att skapa ett ”recept” för extrahering (Thunderbit Blog). Du kan följa länkar för att skrapa undersidor, hantera paginering och till och med förvandla din scraping till en API-endpoint med ett klick.
Det som gör Simplescraper starkt är dess integrationsmöjligheter — du kan skicka data direkt till Google Sheets, Airtable eller verktyg som Zapier (Thunderbit Blog). Det finns också molnscraping och schemaläggning för återkommande jobb, samt funktionen ”AI Enhance” för att rensa eller analysera din data med GPT.
Om du vill ha snabba resultat och enkla integrationer är Simplescraper som en schweizisk armékniv för lättviktig web scraping.
Instant Data Scraper: snabb web extracting för tabeller och listor
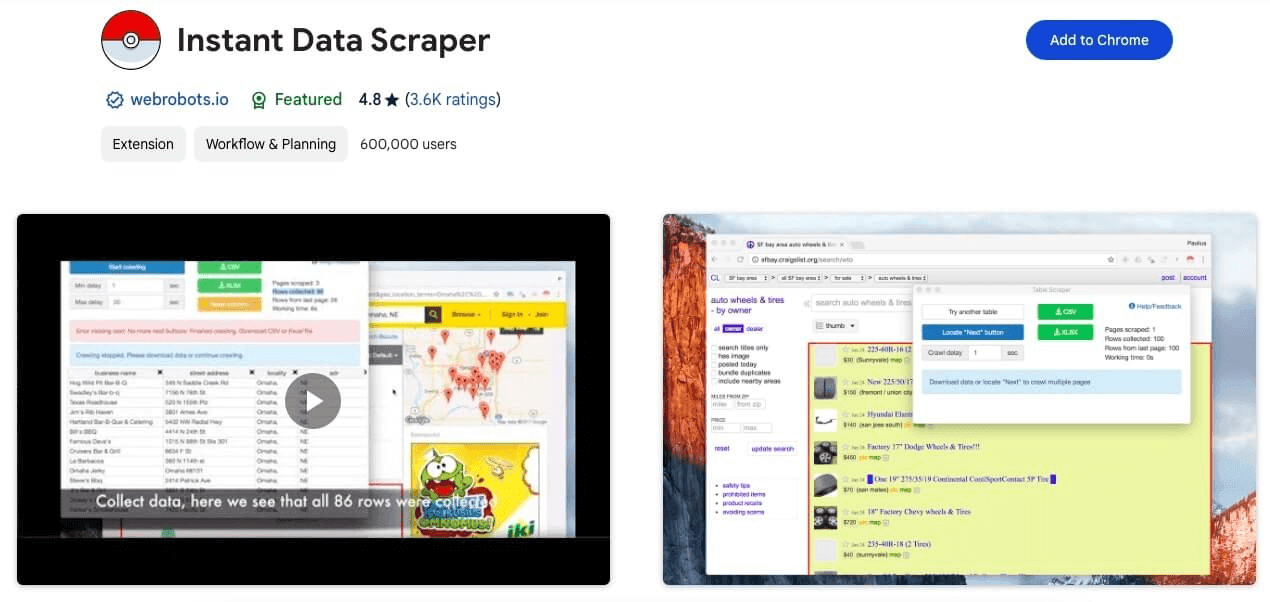
Ibland vill du bara ha datan nu, utan någon setup alls. Det är där Instant Data Scraper (IDS) kommer in. Det är ett gratis Chrome-tillägg som är känt för sin scraping av tabulär data med ett klick (Thunderbit Blog). Aktivera tillägget, så känner IDS automatiskt av tabeller eller listor på sidan. Det hanterar till och med paginering och oändlig scroll genom att automatiskt klicka sig igenom alla sidor.
IDS är 100 % gratis, ingen registrering, ingen kod, ingen väntan. Det är perfekt för avslappnade eller akuta scraping-behov — som när en säljare snabbt behöver en leadlista, eller en student plockar data från Wikipedia-tabeller. Hittar den din data, har du den på några sekunder.
ScrapeStorm: molnbaserad web extractor med AI-stöd
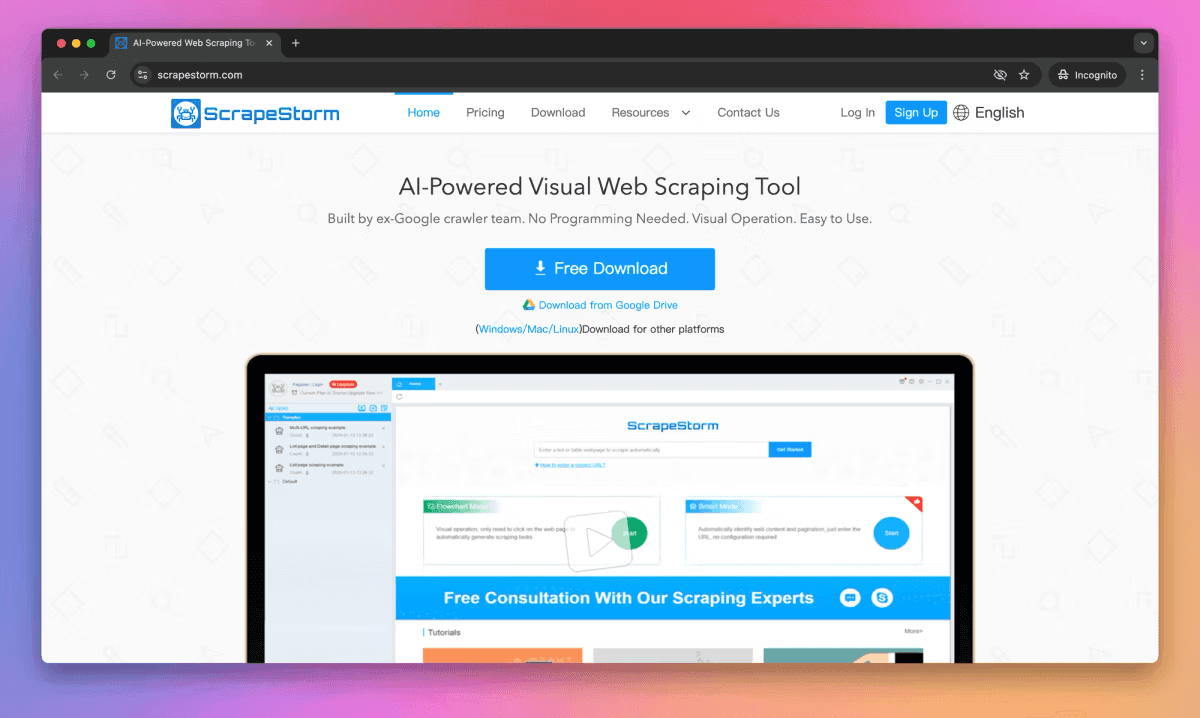
ScrapeStorm är ett AI-drivet web scraping-verktyg som kombinerar ett visuellt gränssnitt med kraftfulla AI-algoritmer (AI Tools Inc.). Du anger en URL, och dess AI identifierar automatiskt datafält — listor, tabeller, knappar för nästa sida och mer.
ScrapeStorm stöder användning på flera plattformar (Windows, Mac, Linux) och erbjuder både desktop- och molnbaserad scraping. Du kan schemalägga uppgifter, köra flera jobb parallellt och exportera data i Excel, CSV, JSON eller till och med ladda upp till en databas (AI Tools Inc.). Det är särskilt populärt för e-handel och marknadsundersökningar, och kan till och med tolka data från bilder eller PDF-filer med hjälp av AI.
Om du behöver en smart assistent för stora eller komplexa scrapingprojekt är ScrapeStorm värt att titta närmare på.
Apify: marknadsplats och automationsplattform för web extractors
Apify är inte bara en scraper — det är en plattform för web scraping och automatisering. Du kan köra ”actors”, alltså skript för scraping eller webbläsarautomatisering. Det verkliga värdet ligger i Apifys marknadsplats med färdiga actors för vanliga uppgifter (Dev.to). Behöver du skrapa alla recensioner från en e-handelssajt? Det finns sannolikt en actor för det.
För utvecklare gör Apify det möjligt att skriva egna scrapers i Node.js eller Python och köra dem i molnet. Det är skalbart, automatiserbart och integreras via API. Apify passar bäst för power users och organisationer som ser webbdata som en strategisk resurs — till exempel kontinuerlig, storskalig scraping eller integration av scraping i datapipelinen.
ParseHub: visuell web page extractor för komplexa sajter
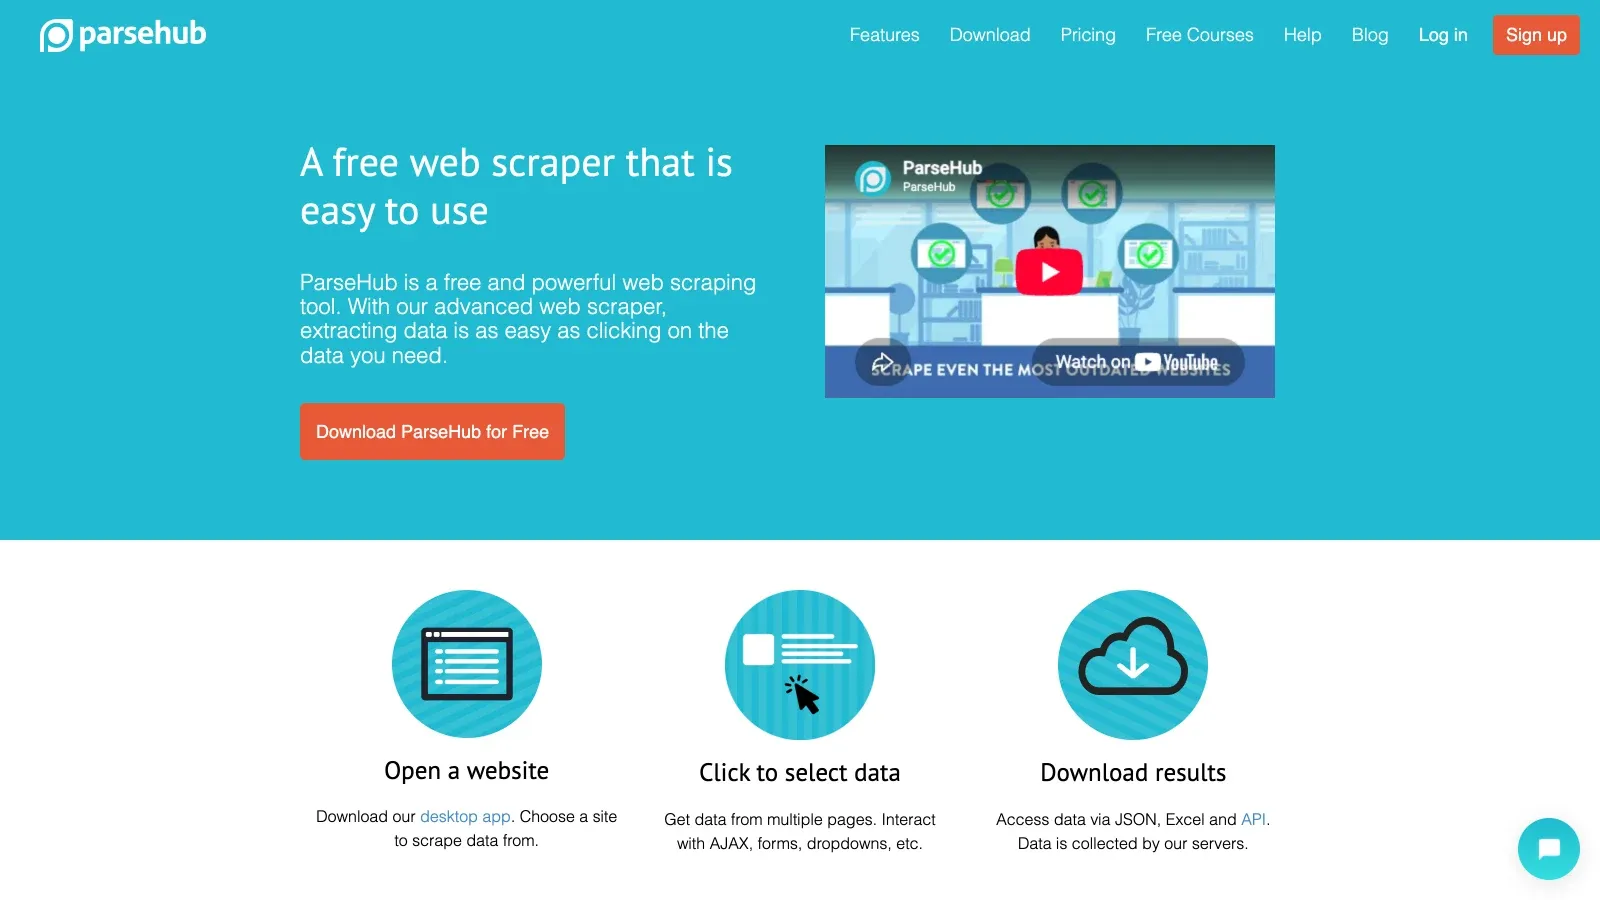
ParseHub är en desktop-app (med molnalternativ) som är känd för att klara komplexa, dynamiska webbplatser. Du navigerar på sajten i ett webbläsarliknande gränssnitt, klickar på datapunkter och ParseHub bygger din scraper (Dev.to). Det stöder villkorslogik, nästlad scraping, AJAX-innehåll och mer.
ParseHub är ofta förstahandsvalet när andra verktyg misslyckas med att skrapa en sajt korrekt. Det används av forskare, analytiker och småföretagare som behöver ta sig an knepiga webbplatser. Det finns en inlärningskurva, men om du har en komplex sajt att skrapa och inte vill koda är ParseHub ett av de bästa alternativen.
OutWit Hub: desktop web extractor för innehållsarkivering
OutWit Hub är lite old school, men det är en desktop-applikation som är bra för att hämta många olika typer av innehåll (länkar, bilder, e-postadresser osv.) och organisera det (Scrapeless). Det fungerar som en blandning av webbläsare och kalkylblad — gå till en sida, och OutWit Hub kan extrahera tabeller, listor, bilder och mer.
Det är särskilt användbart för innehållsarkivering eller research — till exempel att skrapa alla inlägg från ett forum eller ladda ner en samling filer. Det är ett desktopverktyg, så du kör det lokalt och behåller din data privat. OutWit Hub är bäst för små till medelstora scrapinguppgifter där du vill ha ett enkelt desktopgränssnitt.
Vilken web extractor passar bäst för dina behov?
Tolv verktyg, tusen användningsfall. Så vilket web extractor ska du välja? Här är min fusklapp:
-
För totala nybörjare eller snabba engångsuppgifter:
Testa Instant Data Scraper för enkla tabeller och listor (det är gratis och direkt). Data Miner är ett annat användarvänligt alternativ med fler mallar om du ofta skrapar liknande sidor.
-
För icke-tekniska användare som behöver återkommande scraping eller integrationer:
Thunderbit erbjuder det smidigaste arbetsflödet med sin AI-drivna approach — perfekt för affärsanvändare som vill ha resultat snabbt och ofta. Browse AI är idealiskt för kontinuerlig övervakning och aviseringar. Simplescraper är bra om du vill att den insamlade datan ska flöda in i Google Sheets eller en intern app via API.
-
För komplexa webbplatser eller anpassade arbetsflöden utan kod:
Välj en visuell scraper som Octoparse eller ParseHub. Octoparse är användarvänligt och har mängder av mallar. ParseHub klarar mycket komplexa dynamiska sajter och ger fin kontroll. WebScraper.io är också starkt om du är beredd att konfigurera dina egna sitemaps.
-
För utvecklare eller data engineers som behöver skala:
ScraperAPI är skräddarsytt för att bädda in web scraping i din programvara eller köra stora projekt. Apify är perfekt när du behöver en skalbar plattform med en marknadsplats för färdiga eller egna skript.
-
För innehållstung extrahering eller offline-användning:
OutWit Hub är ett stabilt val för att systematiskt samla in och arkivera innehåll, särskilt om du föredrar ett desktopverktyg för integritet eller kontroll.
Se vad AI:n hittar på din egen sida Öppna en sida du faktiskt bryr dig om och låt Thunderbit läsa kolumnerna själv — strukturerad tabell med 1 klick, gratisplan ingår. Get Started Free
Ärligt talat använder många team flera verktyg beroende på uppgiften. Du kanske börjar med Instant Data Scraper för något enkelt, går vidare till Thunderbit eller Octoparse för ett mer omfattande projekt, och använder ScraperAPI eller Apify när du behöver industrialisera processen. Den goda nyheten? De flesta av de här verktygen har gratisplan eller testperiod, så du kan prova dig fram och se vad som passar.
Slutsats: framtiden för web extracting för affärsteam
Web extractor-verktyg har kommit långt. 2026 är de helt mainstream. Den stora trenden? Web scraping blir enklare, mer automatiserat och mer integrerat i det dagliga arbetsflödet (HubSpot Blog). AI-drivna scrapers gör att även komplexa, dynamiska webbplatser kan hanteras utan specialistkunskaper. Som en dataingenjör uttryckte det: ”När AI web scraping-verktyg kom ut på marknaden kunde jag slutföra uppgifter mycket snabbare och i större skala... med AI inkluderas [datarensning] automatiskt i mitt arbetsflöde.”
En annan stor förändring är att gränserna mellan scraping, bevakning och automatisering suddas ut. Verktyg som Browse AI och Thunderbit extraherar inte bara data utan håller den också uppdaterad och kan till och med utföra handlingar (som att fylla i formulär eller trigga aviseringar). Ökningen i användning är tydlig — en större plattform såg månatliga aktiva användare öka med över 140 % på ett år (Apify Blog). Företag i alla storlekar inser att tillgång till offentlig webbdata, på ett etiskt och lagligt sätt, är nyckeln till att förbli konkurrenskraftiga.
För affärsteam är lärdomen att makten ligger i egna händer. Du behöver inte vänta i veckor på en utvecklare eller nöja dig med beslut på magkänsla. Verktygen i den här listan ger dig webbdata direkt i händerna, med gränssnitt och funktioner anpassade för verkliga användningsfall inom sälj, marknadsföring, drift och mer. Och med hur snabbt utvecklingen går förväntar jag mig ännu mer användarvänliga gränssnitt, smartare AI och djupare integration med BI- och analysplattformar inom en snar framtid.
Kom bara ihåg: respektera webbplatsers användarvillkor och robots.txt-regler, och se till att du följer dataskyddslagar. Etisk scraping är viktigt för att den här typen av arbetssätt ska vara hållbar över tid.
Så oavsett om du börjar med ett gratis tillägg eller rullar ut en enterprise-nivå scraping-flotta, har det aldrig varit en bättre tid att förvandla webbens information till användbara insikter. Revolutionen kring web extractor är här — välj ett verktyg, prova det och lås upp värdet som gömmer sig mitt framför ögonen. Din datadrivna framtid är bara ett klick bort.
Vanliga frågor
1. Vad är en web extractor och varför är det viktigt för företag?
En web extractor är ett verktyg som automatiskt samlar in strukturerad data från webbplatser. Det är viktigt eftersom det hjälper företag att förvandla rörig onlineinformation till användbara insikter — vilket ökar produktiviteten, driver lönsamhet och eliminerar manuell datainsamling.
2. Vem kan använda web extractors — behöver jag tekniska kunskaper?
Nej, många moderna web extractors kräver inga tekniska färdigheter. Verktyg som Thunderbit, Browse AI och Instant Data Scraper är byggda för icke-tekniska användare med intuitiva gränssnitt, AI-driven automatisering och no-code-flöden.
3. Hur kan sälj-, marknadsförings- och driftteam dra nytta av web extractors?
Säljteam kan bygga leadlistor från onlinekataloger, marknadsteam kan övervaka konkurrenters priser och driftteam kan automatisera datainsamlingsprocesser. De här verktygen sparar tid, minskar fel och ger färska, tillförlitliga insikter för strategiska beslut.
4. Vad ska jag titta efter när jag väljer ett web extractor-verktyg?
Viktiga faktorer är användarvänlighet, AI-funktioner, automatisering/schemaläggning, integration med verktyg som Google Sheets eller Airtable, skalbarhet och hur väl verktyget passar ditt affärsfall (till exempel leads, prisbevakning eller innehållsarkivering).
5. Finns det gratis eller billiga web extractor-verktyg?
Ja, många web extractors erbjuder gratisplaner eller prisvärda abonnemang. Instant Data Scraper är helt gratis för grundläggande behov, medan verktyg som Thunderbit, Simplescraper och Data Miner erbjuder generösa gratisplaner med uppgraderingsmöjligheter vid behov.
Vill du lära dig mer om web extracting, AI scraping eller hur du förvandlar webbplatser till ditt teams nästa stora fördel? Kolla in Thunderbit Blog för fler guider, tips och verkliga berättelser från dataautomatiseringens frontlinje.
Prova Thunderbit AI Web Extractor Get Started Free



