
Webben svämmar över av data, och 2026 är kampen om att omvandla kaoset till affärsvärde tuffare än någonsin. Jag har sett sälj-, e-handels- och driftteam förändra sina arbetsflöden genom att automatisera sådant som tidigare tog timmar av monotont copy-paste-arbete. I dag, om du inte använder programvara för webbdataskrapning, halkar du inte bara efter — du sitter sannolikt fortfarande fast i kalkylbladens skärseld medan konkurrenterna redan hunnit ta sin andra kopp kaffe.
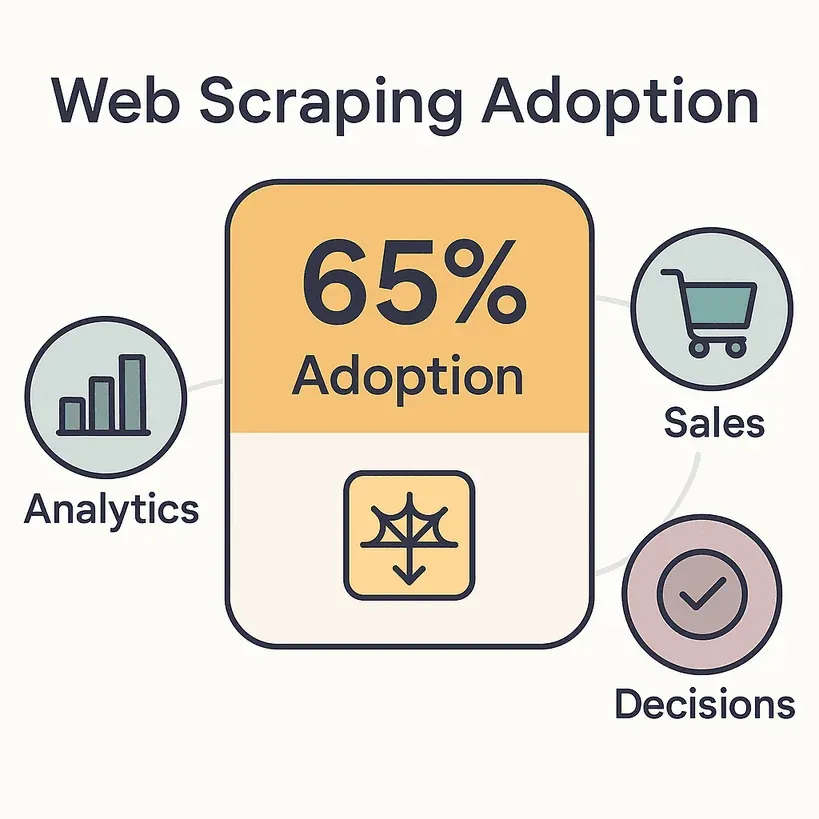
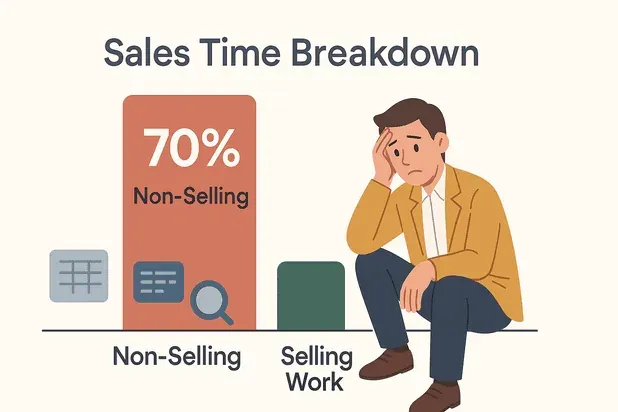
Så här ser verkligheten ut: 65 % av företagen använder nu verktyg för web scraping för att driva analys, försäljning och beslutsfattande. Den globala marknaden för extraktion av webbdata är redan värd över 1 miljard dollar, och den förväntas fördubblas till 2030. Säljare lägger en stor del av veckan på uppgifter som inte leder till försäljning, som datainmatning och research. Det är mycket tid som i stället hade kunnat gå till att faktiskt stänga affärer — eller åtminstone till en ordentlig lunchrast.
Så, vilken är den bästa programvaran för webbdataskrapning 2026? Jag har grävt djupt i de fem främsta verktygen som förändrar spelet för team av alla storlekar och tekniska nivåer. Oavsett om du är en icke-kodare som bara vill klicka igång allt, eller en utvecklare som vill ha maximal flexibilitet, finns det något här för dig.
Vad kännetecknar den bästa programvaran för webbdataskrapning?
Vad är dataskrapning och hur gör man det 2025 Get Started Free
Låt oss vara ärliga: alla webbskrapor är inte skapade lika. Den bästa programvaran för webbdataskrapning 2026 utmärker sig genom att göra datainsamling snabb, pålitlig och tillgänglig för alla — inte bara för dem som drömmer i Python.
Här är de viktigaste kriterierna jag tittar på (och det som affärsanvändare bryr sig mest om):
- Enkel användning: Kan icke-tekniska användare sätta upp en skrapning på några minuter? No-code och AI-drivna gränssnitt är ett måste för de flesta team.
- Flexibilitet i datakällor: Klarar verktyget webbsidor, PDF-filer, bilder och dynamiskt innehåll (som infinite scroll eller AJAX)? Ju fler källor, desto bättre.
- Automatisering och schemaläggning: Kan du köra återkommande skrapningar, hantera paginering och automatisera navigering mellan undersidor? Automatisering är skillnaden mellan “ställ in och glöm” och “ställ in och övervaka hela tiden”.
- Integration och export: Kan det exportera direkt till Excel, Google Sheets, Notion, Airtable eller via API? Ju mindre manuellt arbete, desto nöjdare team.
- Teknisk nivå som krävs: Är det verkligen no-code, eller måste du damma av dina regex-kunskaper? De bästa verktygen passar både icke-kodare och avancerade användare.
- Skalbarhet: Klarar det att skrapa hundratals eller tusentals sidor utan att tappa tempo?
- Support och community: Finns det bra dokumentation, snabb support och en aktiv användarbas?
De här kriterierna är inte bara trevliga att ha — de skiljer verktyg som sparar dig timmar från sådana som kostar dig dagar. 2026, med nästan hälften av all internettrafik som kommer från botar, är rätt skrapverktyg en tydlig konkurrensfördel.
Nu kör vi igenom topp fem.
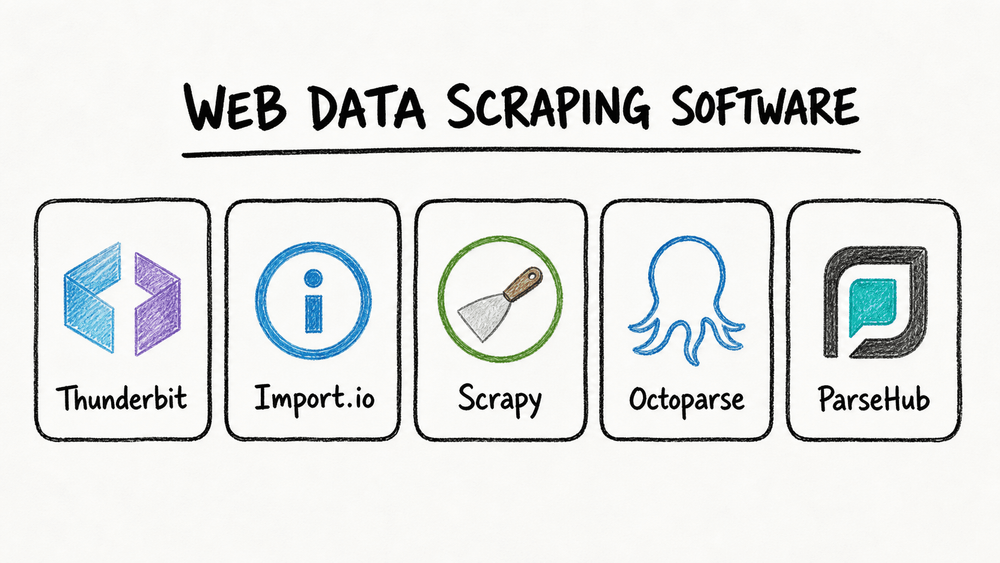
Topp 5 bästa programvaror för webbdataskrapning 2026
- Thunderbit för no-code, AI-driven skrapning från flera källor
- Import.io för företagsnivå, integrerade datapipelines
- Scrapy för öppen källkod och utvecklarstyrd flexibilitet
- Octoparse för visuell no-code-skrapning med schemaläggning
- ParseHub för lättanvänd dataextraktion med klickgränssnitt
1. Thunderbit: Den enklaste AI-drivna programvaran för webbdataskrapning
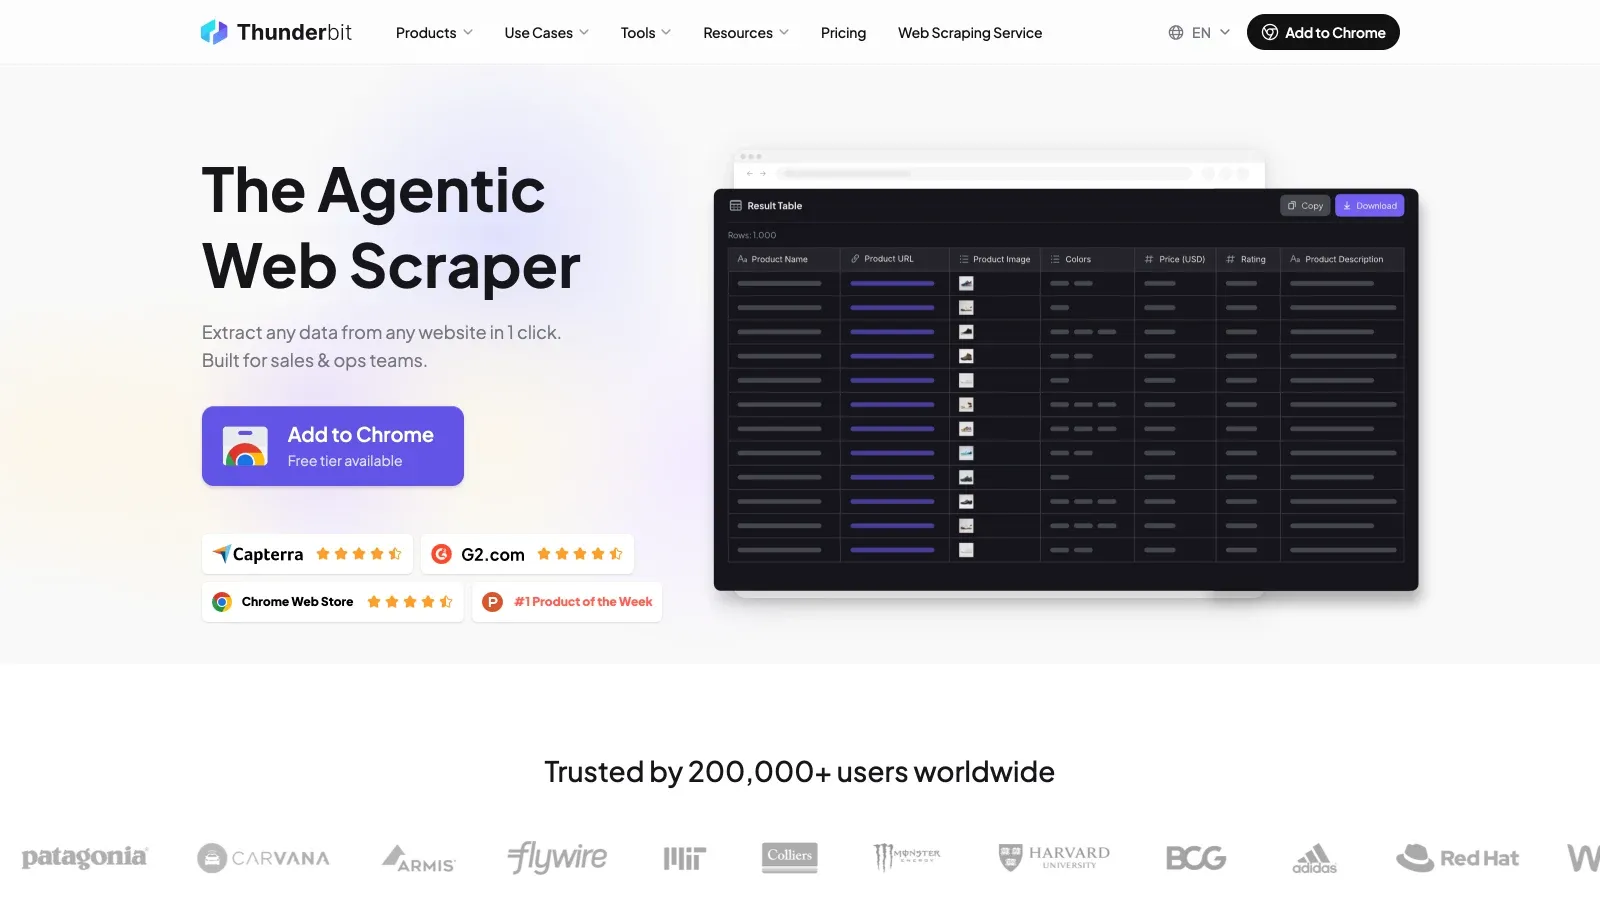
Skrapa data från vilken webbplats som helst med AI Get Started Free
Thunderbit är mitt förstahandsval för alla som vill skrapa webbdata utan att skriva en enda rad kod. Och ja, jag är lite partisk — jag har varit med och byggt det. Men hör mig: Thunderbit är skapat för affärsanvändare som vill ha resultat, inte huvudvärk.
Det här gör Thunderbit särskilt starkt:
- AI-föreslagna fält: Klicka bara på “AI Suggest Fields” så läser Thunderbits AI av sidan, föreslår vad som ska extraheras och sätter upp skrapan åt dig. Inga selectors, inga mallar, inget krångel.
- Skrapning från flera källor: Skrapa inte bara webbsidor, utan även PDF-filer och bilder. Thunderbit kan hämta text, länkar, e-postadresser, telefonnummer och bilder — allt på två klick.
- Automatisering av undersidor och paginering: Behöver du samla in detaljer från varje produkt- eller profilsida? Thunderbits skrapning av undersidor följer länkar, hämtar extra information och sammanfogar det i din tabell. Den hanterar också infinite scroll och paginering utan problem.
- Batch- och schemalagd skrapning: Klistra in en lista med URL:er, schemalägg återkommande körningar och låt Thunderbit göra det tunga jobbet — oavsett om det gäller daglig prisbevakning eller veckovisa lead-uppdateringar.
- Direkt export: Exportera direkt till Excel, Google Sheets, Airtable, Notion, CSV eller JSON. Inga fler copy-paste-maraton.
- Egna AI-prompter: Vill du kategorisera, översätta eller tagga data medan du skrapar? Lägg till en egen instruktion så tar Thunderbits AI hand om resten.
- Molnläge eller webblägesläge: Kör skrapningar i molnet för snabbhet (50 sidor åt gången) eller lokalt för webbplatser som kräver inloggning.
Thunderbit används av över 200 000 användare världen över, från säljteam till fastighetsmäklare och små e-handelsföretag. Gratisnivån låter dig skrapa upp till 6 sidor per månad, och du betalar bara för det du använder — ett kreditpoäng per outputrad.
Varför jag gillar det: Thunderbit är det enda verktyg jag sett där en icke-teknisk användare kan gå från “jag behöver den här datan” till “här är mitt kalkylblad” på under fem minuter. Gränssnittet är genuint lätt att använda (vi var extremt noga med det), och AI:n anpassar sig efter ändringar på webbplatsen så att du slipper fixa trasiga skrapor hela tiden.
Bäst för: Försäljning, e-handel, drift och alla som vill ha no-code, AI-driven skrapning utan löpande underhåll.
Prova Thunderbit Chrome-tillägg
Kolla in Thunderbit Blog för fler guider.
2. Import.io: Webbdataskrapning och integration i enterprise-klass
Import.io är tungviktsmästaren för företag som behöver webbdata i stor skala — och vill få in den direkt i affärssystem.
Det här skiljer Import.io från mängden:
- Enterprise-redo pipelines: Import.io är inte bara en skrapare; det är en komplett plattform för integration av webbdata. Tänk “data som tjänst” med kontinuerliga, automatiserade flöden.
- Självläkande AI: Om en webbplats ändras försöker Import.io:s AI mappa om fälten automatiskt, så att dina pipelines inte kraschar över en natt.
- Robust automatisering: Schemalägg skrapningar per timme, dagligen eller med egna intervall. Få aviseringar om något går fel eller om datan ser konstig ut.
- Interaktiva arbetsflöden: Hantera webbplatser med inloggning, formulär eller flerstegsnavigering. Import.io kan spela in och upprepa komplexa sekvenser.
- Efterlevnad och styrning: Automatisk identifiering av PII, maskering och granskningsloggar — avgörande för reglerade branscher.
- API och integration: Strömma data direkt till Google Sheets, Excel, Tableau, Power BI, databaser eller dina egna appar via API.
Import.io används av varumärken som Unilever, Volvo och RedHat. Det är ett vanligt val för användningsfall som prisbevakning över tusentals e-handelswebbplatser, marknadsinsikter eller att mata AI/ML-modeller med färsk webbdata.
Prissättning: Import.io är en premiumlösning som börjar runt 199 dollar per månad för self-service-planer. Det finns en gratis provperiod, men ingen långsiktig gratisnivå. Om webbdata är affärskritisk finns det god avkastning.
Bäst för: Företag och datadrivna organisationer som behöver tillförlitlighet, skala, efterlevnad och djup integration.
3. Scrapy: Open source-ramverk för webbskrapning för utvecklare
Scrapy är open source-kraftpaketet för utvecklare som vill ha maximal flexibilitet och kontroll. Om du — eller ditt team — kan koda i Python, är Scrapy webbscrapingens schweiziska armékniv.
Därför gillar utvecklare Scrapy:
- Full anpassning: Skriv spiders (skript) för att crawla, tolka och bearbeta data exakt som du vill. Hantera flersidiga flöden, egen logik och avancerad datarensning.
- Asynkront och snabbt: Scrapys arkitektur är byggd för fart och skala — skrapa hundratals sidor per minut, eller miljontals med distribuerade crawlers.
- Utbyggbart: Ett stort ekosystem av plugins och middleware för proxies, headless browsers (Splash/Playwright) och integrationer.
- Gratis och open source: Inga licensavgifter. Kör det på egen hårdvara eller i molnet och skala så mycket du behöver.
- Community-support: Över 55 000 GitHub-stjärnor och en enorm användarbas. Om du stöter på problem är chansen stor att någon redan löst det.
Att tänka på: Scrapy kräver Python-kunskaper och att du är bekväm med kommandoraden. Det finns inget klickgränssnitt — här är det kod först som gäller. Men för skräddarsydda projekt, AI-träningsdata eller riktigt stora crawls finns det knappast något bättre.
Bäst för: Organisationer med egna utvecklare, anpassade datapipelines eller stora och komplexa skrapbehov.
4. Octoparse: Visuell webbdataskrapning gjord enkel
Octoparse är en favorit bland icke-kodare som vill ha kraftfull skrapning med ett visuellt gränssnitt där du klickar och väljer.
Varför Octoparse är populärt:
- Visuell arbetsflödesbyggare: Klicka på element i en inbyggd webbläsare så känner Octoparse automatiskt igen mönster. Ingen kod — bara klicka och extrahera.
- Hantera dynamiskt innehåll: Skrapa AJAX, infinite scroll och webbplatser med inloggning. Simulera klick, scrollningar och formulärinlämningar.
- Molnskrapning och schemaläggning: Kör uppgifter i molnet (snabbare, parallellt) och schemalägg återkommande jobb för data som alltid är aktuell.
- Förbyggda mallar: Hundratals mallar för populära sajter (Amazon, Twitter, Zillow med flera) gör att du kan börja skrapa direkt.
- Export och API: Ladda ner resultat som CSV, Excel, JSON eller hämta data via API. Integrera med Google Sheets eller databaser.
Octoparse beskrivs ofta som “superenkelt att använda, även för nybörjare”. Gratisnivån är begränsad, men betalplaner (från cirka 69 dollar per månad) låser upp molnkörningar, schemaläggning och mer hastighet.
Bäst för: Icke-tekniska användare, marknadsförare, forskare och små team som behöver regelbunden, automatiserad datainsamling utan kodning.
5. ParseHub: Användarvänlig dataextraktion för vardagliga uppgifter
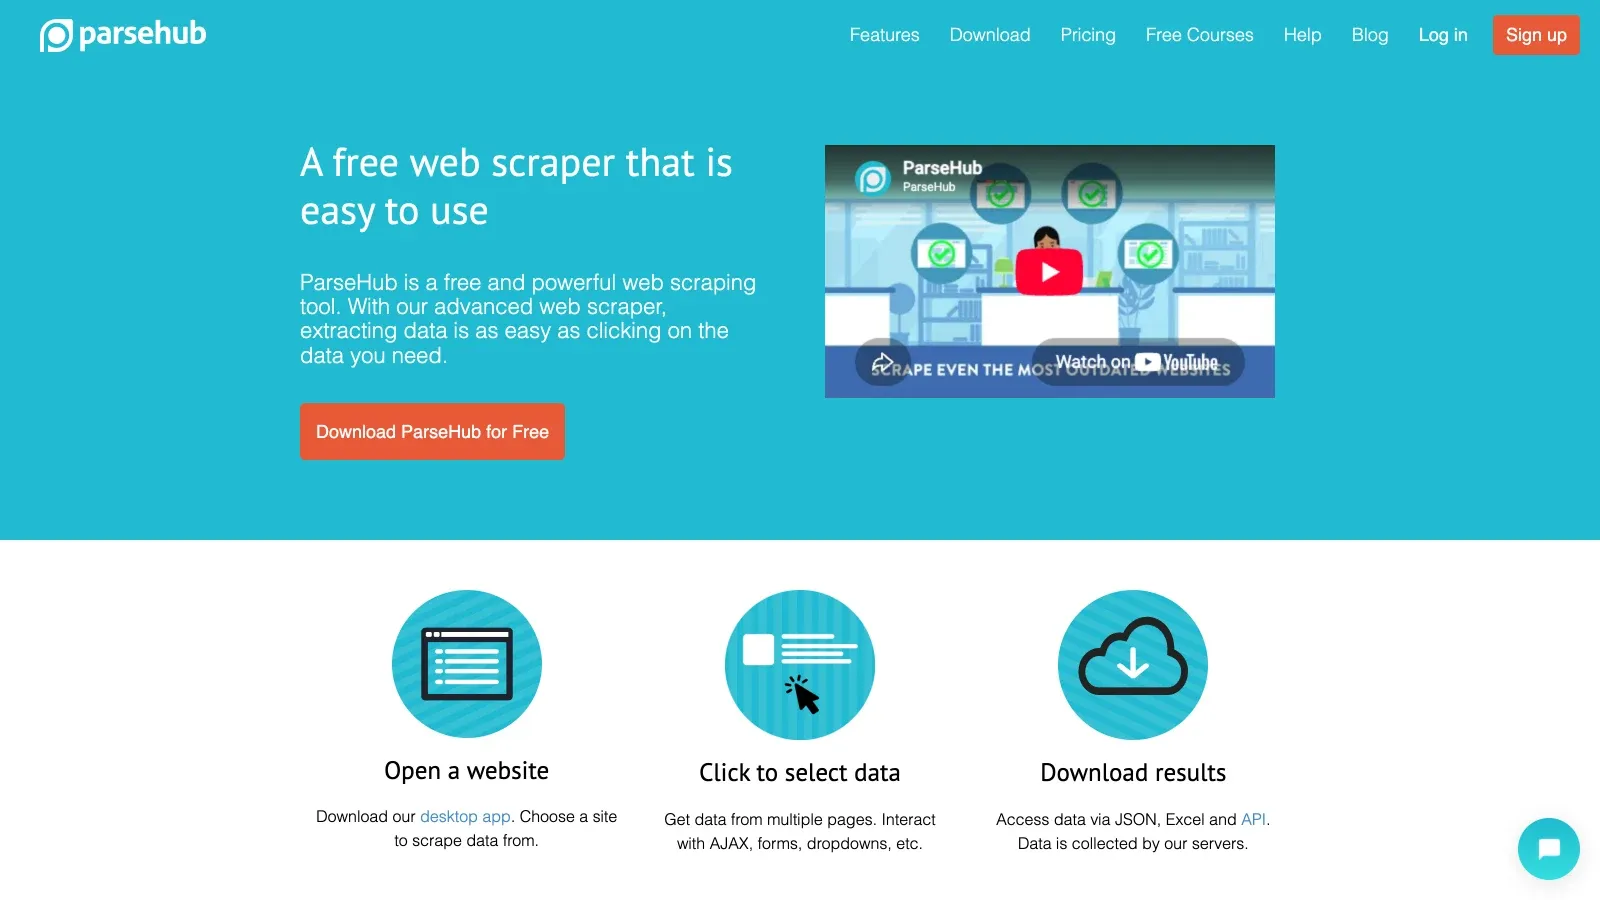
ParseHub är ännu en no-code-favorit, särskilt för småföretag och frilansare som vill automatisera vardagliga datauppgifter.
Det här gör ParseHub starkt:
- Enkelt klickgränssnitt: Välj data genom att klicka på element i webbläsarvyn. Bygg arbetsflöden visuellt — ingen kod behövs.
- Klarar JS och dynamiska webbplatser: Skrapa sidor med mycket JavaScript, infinite scroll och flerstegsnavigering.
- Moln- och lokala körningar: Kör skrapningar på din dator eller i molnet. Schemalägg återkommande jobb och få åtkomst till resultat via API (på högre abonnemang).
- Exportalternativ: Ladda ner data som CSV, Excel eller JSON. API-åtkomst för automatisering.
- Plattformsoberoende: Finns för Windows, Mac och Linux.
ParseHubs gratisplan är begränsad (200 sidor per körning), men betalplaner (från cirka 189 dollar per månad) låser upp mer kraft, snabbhet och API-åtkomst.
Bäst för: Småföretag, frilansare och team med enkla skrapbehov som vill ha ett pålitligt, visuellt verktyg.
Jämförelsetabell: Bästa programvaran för webbdataskrapning i överblick
| Verktyg | Enkel användning | Datakällor | Automatisering och schemaläggning | Integration och export | Teknisk nivå | Pris |
|---|---|---|---|---|---|---|
| Thunderbit | No-code, AI-driven | Webb, PDF, bilder | Undersidor, paginering, schemalagt, batch | Excel, Sheets, Notion, Airtable, CSV, JSON | Ingen | Freemium (betala per rad) |
| Import.io | Klickgränssnitt | Webb (statisk/dynamisk, inloggning) | Självläkande, schemalagt, aviseringar | API, BI-verktyg, Sheets, Excel, DB | Låg–medel | Från 199 dollar/månad |
| Scrapy | Kod krävs | Webb, API:er, (JS via tillägg) | Full automatisering via kod | Allt (via kod) | Python-utvecklare | Gratis (open source) |
| Octoparse | Visuellt, no-code | Webb (dynamisk, inloggning) | Molnschemaläggning, mallar | CSV, Excel, JSON, API | Ingen | Från 69 dollar/månad |
| ParseHub | Visuellt, no-code | Webb (JS, dynamisk) | Moln/lokalt, schemalagt | CSV, Excel, JSON, API | Ingen | Från 189 dollar/månad |
Så väljer du den bästa programvaran för webbdataskrapning för ditt företag
Osäker på vilket verktyg som passar dig? Här är min fusklapp:
- Icke-tekniska användare, snabba resultat: Välj Thunderbit eller Octoparse. Thunderbit är oslagbart för omedelbar, AI-driven skrapning och stöd för flera källor (webb, PDF, bilder). Octoparse är utmärkt för visuella, schemalagda skrapningar.
- Företagsintegration, efterlevnad och skala: Import.io är ditt bästa val. Det är byggt för kontinuerliga, pålitliga datapipelines och djup integration.
- Utvecklare, skräddarsydda projekt eller enorma crawls: Scrapy är rätt väg. Du behöver Python-kunskaper, men får obegränsad flexibilitet.
- Småföretag, frilansare eller vardagliga uppgifter: ParseHub är ett stabilt och användarvänligt val för klickbaserad skrapning och måttlig automatisering.
Tips för att välja rätt verktyg:
- Matcha verktyget med teamets tekniska nivå och databehov.
- Tänk igenom hur komplicerade webbplatserna du ska skrapa är (dynamiskt innehåll? inloggning?).
- Fundera på hur du ska använda datan — behöver du direkt export till Sheets eller djup API-integration?
- Börja med en gratis provperiod eller freemium-plan för att testa verkliga arbetsuppgifter.
- Underskatta inte värdet av bra support och tydlig dokumentation.
Slutsats: Lås upp affärsvärde med den bästa programvaran för webbdataskrapning
Webbdata är bränslet för smartare affärsbeslut 2026. Rätt programvara för webbdataskrapning kan spara dig timmar, minska fel och ge teamet ett verkligt försprång — oavsett om du bygger leadlistor, bevakar konkurrenter eller matar din analysmotor.
Kort sammanfattat:
- Thunderbit är den enklaste AI-drivna no-code-skrapan för affärsanvändare.
- Import.io är enterprise-lösningen för kontinuerliga, integrerade datapipelines.
- Scrapy är open source-verktyget för utvecklare som vill ha full kontroll.
- Octoparse och ParseHub gör visuell, no-code-skrapning tillgänglig för alla.
De flesta av de här verktygen erbjuder gratis provperioder eller freemium-planer — så testa dem. Automatisera det tråkiga, lås upp nya insikter och låt teamet fokusera på det som verkligen spelar roll.
Lycka till med skrapandet — och må din data alltid vara färsk, strukturerad och redo att användas.
FAQ
1. Vad används programvara för webbdataskrapning till?
Programvara för webbdataskrapning automatiserar processen att hämta information från webbplatser, PDF-filer och bilder. Den används för leadgenerering, prisbevakning, marknadsresearch, innehållsinsamling med mera.
2. Är webbdataskrapning lagligt?
Web scraping är lagligt när du samlar in offentligt tillgänglig data och följer webbplatsens användarvillkor samt integritetslagstiftning. Granska alltid sajtens policy och använd data ansvarsfullt.
3. Behöver jag kunna koda för att använda programvara för webbdataskrapning?
Inte nödvändigtvis! Verktyg som Thunderbit, Octoparse och ParseHub är gjorda för icke-kodare. För mer komplexa eller skräddarsydda projekt kan utvecklarverktyg som Scrapy behövas.
4. Hur exporterar jag skrapad data till Excel eller Google Sheets?
De flesta moderna skrapverktyg (Thunderbit, Octoparse, ParseHub) erbjuder export med ett klick till Excel, Google Sheets, CSV eller till och med direkt integration med Notion och Airtable.
5. Kan programvara för webbdataskrapning hantera dynamiska webbplatser eller inloggningar?
Ja — toppverktyg som Import.io, Octoparse och ParseHub kan hantera dynamiskt innehåll (AJAX, infinite scroll) och webbplatser med inloggning. Thunderbit stöder också skrapning från dynamiska sidor och undersidor.
Vill du se hur modern web scraping ser ut? Ladda ner Thunderbits Chrome-tillägg eller utforska Thunderbit Blog för fler tips, guider och djupdykningar i världen av AI-driven datainsamling.
Prova AI Web Scraper Get Started Free




