
Automatiserad trafik står nu för 53 % av webben, alltså mer än människorna, och anti-bot-systemen slår tillbaka hårdare än någonsin.
Jag har själv sett hur ett enda snedsteg — som att använda fel user agent — kan förvandla ett dataprojekt till en vägg av 403-fel. För sälj-, e-handels- och driftteam betyder blockeringar förlorade leads, felaktiga priser eller tappade intäkter.
Här är det jag har lärt mig om user agents för scraping — de viktigaste arbetssätten, vanliga misstagen och hur verktyg som Thunderbit hanterar allt detta automatiskt.

Varför valet av bästa user agent för scraping spelar roll
Vi börjar med grunderna: vad är en user agent? Tänk på den som webbläsarens ”ID-kort”. Varje gång du besöker en webbplats — oavsett om du är människa eller bot — skickar webbläsaren en User-Agent-sträng i request-headern. Det är en liten presentation som säger: ”Hej, jag är Chrome på Windows” eller ”Jag är Safari på iPhone” (ScraperAPI). Så här kan en vanlig Chrome user agent se ut:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
Webbplatser använder den här informationen av två huvudskäl:
- För att visa rätt innehåll (till exempel mobil- eller desktopvy).
- För att upptäcka bottar och scrapers.
Om din user agent säger ”python-requests/2.28.1” eller ”Scrapy/2.9.0” kan du lika gärna bära en namnskylt där det står ”Hej, jag är en bot!”. Sajter har blocklistor med sådana uppenbara identifierare och stänger dörren snabbare än du hinner säga ”403 Forbidden”. Om du i stället använder en vanlig, uppdaterad browser user agent smälter du lättare in i mängden.
Kort sagt: din user agent är din förklädnad. Ju bättre förklädnad, desto större chans att få tag i datan du behöver.
User agentens roll för lyckad web scraping
Varför påverkar valet av user agent så mycket? För att det är första försvarslinjen för de flesta anti-bot-system. Det här kan gå fel om du väljer fel:
- Direkta blockeringar (403/429-fel): Använder du en standard-UA från ett scrapingbibliotek blir du blockerad innan du ens hunnit se startsidan (Webmasters StackExchange).
- Tom eller falsk data: Vissa sajter skickar tomma eller ”dummy”-sidor till misstänkta user agents.
- CAPTCHA eller omdirigeringar: En bot-liknande UA triggar ”Är du människa?”-tester eller eviga inloggningsslingor.
- Throttling och avstängning: Om du träffar samma webbplats om och om igen med samma UA kan du få begränsad hastighet eller bli IP-bannad.
Så här slår olika user agents ut:
| User Agent-sträng | Resultat på de flesta sajter (2026) |
|---|---|
python-requests/2.28.1 | Blockeras direkt, flaggas som bot |
Scrapy/2.9.0 (+https://scrapy.org) | Blockeras eller får fejkat innehåll |
Mozilla/5.0 (Windows NT 10.0; Win64; x64)... | Behandlas som en riktig användare, åtkomst tillåts |
AhrefsBot/7.0 (+http://ahrefs.com/robot/) | Blockeras, känd crawler |
| Tom eller obegriplig UA | Ibland tillåten, men ofta misstänkt |
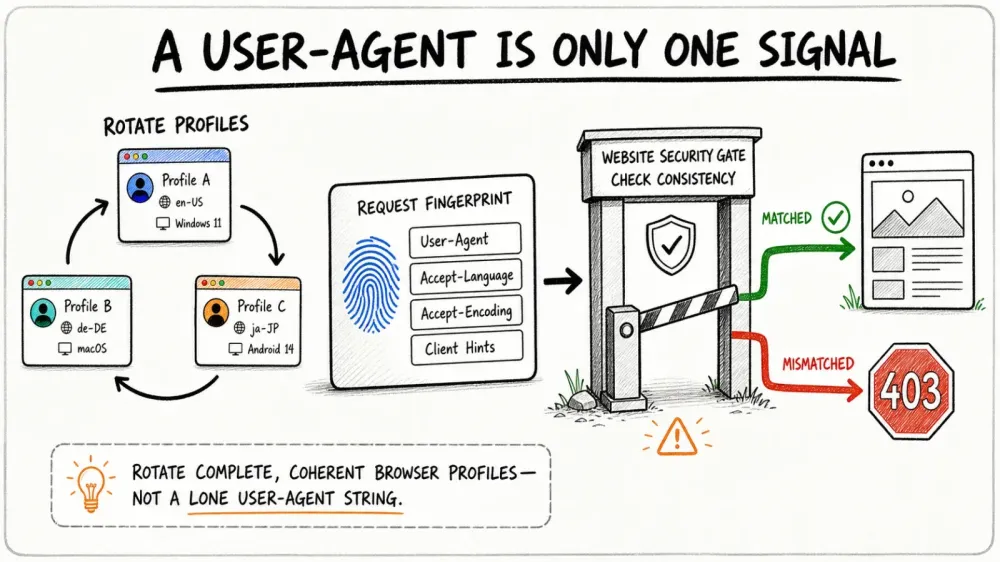
Lärdomen? Välj din förklädnad med omsorg. Och glöm inte att moderna anti-bot-system inte bara tittar på din user agent. De kontrollerar också om andra request-headerar, som Accept-Language eller Referer, stämmer överens. Om du påstår att du är Chrome men inte skickar rätt headerar kommer du ändå att avslöjas (ScraperAPI).
Skrapa data från vilken webbplats som helst med AI Thunderbits agentiska web scraper hanterar rendering och sidstruktur själv, så du slipper sköta user agents manuellt. Get Started Free
Det är här Thunderbit kommer in. Jag har pratat med så många företagsanvändare — säljare, e-handelsansvariga, fastighetsmäklare — som bara vill ha datan, inte en crash course i HTTP-headerar. Därför byggde vi Thunderbit så att hanteringen av user agents blir osynlig och automatisk.
Thunderbit: gör hanteringen av user agents enkel för alla
Med Thunderbits one-click scraping behöver du inte välja någon user agent alls. Vår AI-motor gör det åt dig och väljer den mest realistiska och uppdaterade webbläsarsignaturen för varje webbplats. Oavsett om du använder Thunderbit Chrome Extension (som bokstavligen använder Chromes riktiga UA) eller moln-scraping (där vår AI roterar mellan en pool av aktuella webbläsar-UAs) smälter du alltid in bland normal trafik.
Och det handlar inte bara om user agenten. Thunderbit skickar en komplett och konsekvent uppsättning headerar — Accept-Language, Accept-Encoding, Client Hints, vad du vill — så att dina requests både ser ut och beter sig som en riktig webbläsare. Inga fler osammanhängande headerar, inga fler ”bot”-varningsflaggor.
Det bästa av allt? Du behöver inte konfigurera någonting. Thunderbits AI sköter alla tekniska detaljer i bakgrunden, så att du kan fokusera på det som faktiskt spelar roll: att få tillförlitlig data av hög kvalitet.
Testa Thunderbits agentiska web scraper gratis Installera det kostnadsfria Chrome-tillägget och extrahera strukturerad data från vilken sida som helst med ett klick, utan att behöva fejka headerar. Get Started Free
Varför dynamisk rotation av user agents är ett måste
Säg att du hittar den perfekta user agenten. Ska du då använda samma för varje request? Inte riktigt. 2026 är det en tydlig varningssignal att köra samma UA om och om igen. Riktiga användare har olika webbläsare, versioner och enheter. Om din scraper träffar en sajt 500 gånger i rad med exakt samma UA är det som att skicka in en parad av identiska tvillingar — ingen går på det.
Därför är dynamisk rotation av user agents nu branschstandard. Tanken är enkel: rotera mellan en lista av realistiska, uppdaterade user agents för varje request eller session. Det får din scraper att se ut som en mångsidig grupp riktiga besökare, inte ett enda automationsskript (Capsolver).
Thunderbits AI-drivna rotation tar detta ett steg längre. För flersidescrawls eller schemalagda jobb roterar Thunderbit automatiskt user agents och parar dem till och med med olika proxy-IP:er. Om en sajt börjar bete sig misstänksamt anpassar Thunderbit sig i realtid — byter UA, justerar headerar eller saktar ner requesten vid behov. Allt detta sker i bakgrunden, så att din scraping förblir oupptäckt och datan fortsätter att flöda.
User agent och request-headerar: kraften i konsekvens
Här är ett proffstips: user agenten är bara en del av din requests ”fingeravtryck”. Moderna anti-bot-system kontrollerar om din UA matchar andra headerar som Accept-Language, Accept-Encoding och Referer. Om du säger att du är Chrome på Windows men skickar en fransk Accept-Language från en IP i New York, då lyser varningslamporna (ScraperAPI).
Bästa praxis:
- Skicka alltid en komplett uppsättning headerar som matchar din user agent.
- Håll Accept-Language och Accept-Encoding konsekventa med din UA och, om möjligt, med din IP-geolokalisering.
- Använd webbläsarens utvecklarverktyg för att inspektera riktiga requests och kopiera hela headeruppsättningen för din valda UA.
Thunderbit sköter allt detta åt dig. Vår AI ser till att varje request blir en perfekt match — user agent, headerar och till och med browser fingerprinting. Du får en mänsklig requestprofil utan att lyfta ett finger.
Undvik vanliga fallgropar: vad du INTE ska göra med user agents
Jag har sett många scrapingprojekt gå omkull av samma skäl. Här är de största misstagen att undvika:
- Använda standard-UA från scrapingbibliotek: Strängar som
python-requests/2.x,Scrapy/2.9.0ellerJava/1.8triggar blockering direkt. - Gamla webbläsarversioner: Att påstå att du kör Chrome 120 år 2026? Misstänkt — den versionen är mer än två år gammal. Använd alltid en UA från den aktuella stabila kanalen (Chrome 147 när detta skrivs); en lista som är tolv månader gammal är redan ett bot-spår.
- Omatchade headerar: Skicka inte en Chrome-UA med saknad eller felmatchad Accept-Language, Accept-Encoding eller Client Hints.
- Kända crawler-UAs: Allt med ”bot”, ”crawler”, ”spider” eller verktygsnamn (som AhrefsBot) är en tydlig varningssignal.
- Tomma eller obegripliga UAs: Ibland tillåtet, men ofta misstänkt och opålitligt.
Snabb checklista för säkra user agents:
- Använd riktiga, uppdaterade webbläsar-UAs (Chrome, Firefox, Safari).
- Rotera mellan flera user agents.
- Håll headerarna konsekventa med din UA.
- Uppdatera din UA-lista varje månad (webbläsare uppdateras snabbt).
- Undvik allt som skriker ”automation”.
Thunderbit i praktiken: verkliga scenarier för sälj och drift
Låt oss bli konkreta. Så här hjälper Thunderbits hantering av user agents riktiga team:
| Användningsfall | Gamla sättet: manuell scraping | Med Thunderbit | Resultat |
|---|---|---|---|
| Säljleadgenerering | Frekventa blockeringar, saknad data | AI väljer bästa UA, roterar och efterliknar verklig surfning | Fler leads, högre kvalitet, färre studs |
| Bevakning av e-handel | Skript går sönder, IP-bans | Moln-scraping med dynamisk UA- och proxyrotation | Tillförlitlig pris- och lageruppföljning |
| Bostadsannonser | Tråkiga justeringar, blockeringar | AI anpassar UA/headerar, hanterar undersidor automatiskt | Kompletta, uppdaterade fastighetslistor |

Ett säljteam som använde Thunderbit skrapade tusentals webbplatser för leads och såg bara cirka 8 % bounce rate för e-post — jämfört med 15–20 % från inköpta listor (Reddit). Det är kraften i färsk, mänskligt lik scraping.
Steg för steg: så skrapar du med bästa user agent med Thunderbit
Så här enkelt kommer du igång med Thunderbit — inga tekniska kunskaper krävs:
- Installera Thunderbit Chrome Extension.
- Gå till webbplatsen du vill samla data från. Logga in om det behövs — Thunderbit fungerar även på sidor bakom inloggning.
- Klicka på “One Click Extract”. Thunderbits AI analyserar sidan och föreslår de bästa kolumnerna att skrapa.
- Granska och justera fälten om du vill. Byt namn på, lägg till eller ta bort kolumner efter behov.
- Klicka på “Scrape”. Thunderbit extraherar datan och roterar user agents och headerar i bakgrunden.
- Exportera din data. Skicka den direkt till Excel, Google Sheets, Airtable, Notion eller ladda ner som CSV/JSON.
Du behöver inte välja eller uppdatera user agents själv — Thunderbits AI gör allt och anpassar sig efter varje sajt för maximal träffsäkerhet.
Skrapa med AI-driven rotation av user agents Thunderbit kör scrapingjobb via sin egen infrastruktur, så ett enda klick ersätter manuella skript för rotation av user agents. Get Started Free
Jämförelse: Thunderbit kontra traditionell hantering av user agents
Så här står sig Thunderbit mot det gamla manuella arbetssättet:
| Funktion/uppgift | Manuellt scrapingupplägg | Thunderbits upplägg |
|---|---|---|
| Inställning av user agent | Forska fram och hårdkoda | Automatiskt, AI-väljs per sajt |
| Hålla UAs uppdaterade | Manuellt, lätt att glömma | AI uppdaterar automatiskt i takt med webbläsartrender |
| UA-rotation | Bygg egen rotationslogik | Inbyggd, intelligent rotation |
| Konsekventa headerar | Matcha headerar mot UA manuellt | AI säkerställer komplett och konsekvent headeruppsättning |
| Hantering av blockeringar/CAPTCHAs | Manuella byten, mycket underhåll | AI anpassar sig, försöker igen och roterar vid behov |
| Tekniskt kunnande som krävs | Högt (kodning, HTTP-kunskap) | Inget — byggt för företagsanvändare |
| Tidsåtgång för felsökning | Ofta, frustrerande | Minimal — fokusera på data, inte på scrapingstrul |
Thunderbit är byggt för alla som vill ha pålitlig och skalbar scraping — utan den tekniska bördan.
Se hur agentisk web scraping fungerar Thunderbits AI läser en sida som en människa skulle göra och extraherar data med ett klick, utan att du behöver finjustera scrapers manuellt. Get Started Free
Viktiga insikter: bygg en framtidssäker strategi för user agents
Det här har jag lärt mig (ibland den hårda vägen) om hantering av user agents 2026:
- Använd aldrig standard- eller utdaterade user agents. De är orsak nummer ett till att scrapers blockeras.
- Rotera user agents dynamiskt. Variation är din vän — låt inte din scraper se ut som en robotparad.
- Håll headerarna konsekventa och realistiska. Din user agent är bara så bra som sällskapet den har.
- Håll dig uppdaterad. Webbläsarversioner ändras snabbt; det bör även din UA-lista göra.
- Låt AI sköta det svåra. Verktyg som Thunderbit bygger in bästa praxis direkt, så att du kan fokusera på resultat i stället för requests.
Om du är trött på att bli blockerad, felsöka skript eller bara vill skrapa som ett proffs utan krångel, testa Thunderbit. Vår agentiska web scraper används av tusentals användare världen över och är byggd för att göra webdata tillgänglig för alla — utan tekniskt huvudbry.
För fler tips, guider och fördjupningar om web scraping, kolla in Thunderbit Blog.
Vanliga frågor
1. Vad är en user agent och varför spelar den roll för web scraping?
En user agent är en sträng som skickas med varje web request och som identifierar din webbläsare och ditt operativsystem. Webbplatser använder den för att visa rätt innehåll och upptäcka bottar. Rätt user agent hjälper din scraper att smälta in och undvika blockeringar.
2. Varför ska jag inte använda standard-user agent från mitt scrapingbibliotek?
Standard-user agents som python-requests/2.x är välkända bot-signaturer och blockeras ofta direkt. Använd alltid realistiska, uppdaterade browser user agents.
3. Hur hanterar Thunderbit rotation av user agents?
Thunderbits AI roterar automatiskt mellan en pool av aktuella, realistiska webbläsar-user agents för varje request eller session. Det gör att din scraping ser ut som riktig och varierad användartrafik.
4. Måste jag ställa in headerar som Accept-Language eller Referer manuellt med Thunderbit?
Nej! Thunderbits AI ser till att alla headerar är konsekventa och matchar din user agent, så att dina requests ser ut och beter sig som en riktig webbläsare.
5. Vad händer om en sajt ändå börjar blockera mina requests?
Thunderbit upptäcker blockeringar eller CAPTCHAs och anpassar sig i realtid — genom att byta user agent, justera headerar eller försöka igen vid behov. Du får pålitlig data utan manuell felsökning.
Redo att skrapa smartare? Ladda ner Thunderbit och låt vår AI hantera katt-och-råtta-spelet med user agents åt dig. Trevlig scraping!
Läs mer
- Vad är AI-agenter? Hur det fungerar och hur du använder det
- Vad är Manus AI Agent? Hur det fungerar och hur du använder det
- Nybörjarguide: Så bygger du en AI-agent steg för steg
- Guide till vertikala AI-agenter: koncept och verkliga användningsfall
- Förstå statistik för AI-agenter: från träffsäkerhet till skalbarhet
Testa agentisk web scraper Get Started Free



