
Temu har nu över 416 miljoner aktiva användare varje månad i mer än 50 marknader. Produktutbudet sträcker sig från köksprylar till tillbehör för husdjur och LED-lister. Om du jobbar med e-handel, dropshipping eller konkurrensanalys har du säkert velat få ut Temu-data i ett kalkylblad — och sedan märkt att Temu verkligen, verkligen inte vill att du gör det.
Jag har lagt mycket tid på att undersöka och testa scrapers för skyddade e-handelssajter. Temu är ett av de tuffaste målen som finns. De flesta guider på nätet ger dig antingen en Python-tutorial som slutar fungera inom en vecka eller pekar dig mot företags-API:er som kostar mer än din månadsbudget för annonser.
I praktiken vill de flesta affärsanvändare — dropshippare, ensamföretagare och marknadsteam — bara ha ett snyggt kalkylblad med produktnamn, priser, bilder, betyg och säljarinformation. De vill inte felsöka Playwright-skript klockan två på natten.
Den här guiden är byggd kring just det glappet: en praktisk genomgång, uppdelad efter kunskapsnivå, av de bästa Temu-scrapers som faktiskt fungerar 2026, plus bästa arbetssätt för att förvandla enkel scraping till löpande konkurrensintelligens. Oavsett om du är nybörjare eller utvecklare som bygger en datapipeline finns det något för dig här.
Testa Thunderbit för Temu-scraping
Varför scrapa Temu? Viktiga användningsområden för affärsteam
Temu-data är inte bara intressant — den är strategiskt värdefull.
Plattformen har blivit en prissättande kraft i produktkategorier med lägre och medelhögt prisintervall. Även om du inte säljer på Temu jämför dina kunder ändå dina priser med det de ser där. Så här använder olika team Temu-data:
| Användningsområde | Data som behövs | Varför det spelar roll |
|---|---|---|
| Produktresearch för dropshipping | Titel, pris, bild, betyg, antal recensioner, antal sålda, varianter | Hittar lågprisprodukter med efterfrågesignaler för jämförelse mot Amazon, Shopify, AliExpress, TikTok Shop |
| Konkurrensprissättning | Aktuellt pris, originalpris, rabatt %, valuta, frakt, tidsstämpel | Ger en bas för prissättning och kampanjplanering |
| Produktinköp och sourcing | Specifikationer, bilder, varianter, säljare/butik, artikel-ID, kategori | Identifierar produkttyper och leverantörsliknande listningar som kräver vidare kontroll |
| Marknadstrendanalys | Sökord, kategori, antal sålda, antal recensioner, betyg | Visar vilka produkter som ökar i popularitet inom olika kategorier |
| Marknadsföring och kreativa insikter | Titel, bild, antal recensioner, betyg, beskrivningar, kategorietiketter | Avslöjar budskap, visuella krokar, paketlösningar och påståenden som används av listningar med hög volym |
| Lager- och tillgänglighetsövervakning | Produkt-URL, tillgänglighet, leveransestimat, pris, tidsstämpel | Fångar slutsåldhet, förändringar i lokallager och prisrörelser över tid |
De som söker efter "bästa Temu-scrapers" brukar delas in i tre grupper. Icke-tekniska användare vill ha en Chrome-tilläggslösning som exporterar till kalkylblad. Halvtekniska användare vill ha ett visuellt verktyg med mallar och schemaläggning. Utvecklare vill ha ett API, ett Playwright-skript och en proxylösning.
Den här artikeln täcker alla tre — men den börjar med den största gruppen: personer som behöver data, inte kod.
Vad som gör de bästa Temu-scrapers särskilt bra 2026
En scraper som fungerar för Amazon eller Shopify överlever inte nödvändigtvis Temu. Bedömningskriterierna för den här artikeln är:
- Tillförlitlighet på Temu — Får den faktiskt ut ren data, eller blockeras den, returnerar tomma rader eller går sönder vid en layoutändring?
- Användarvänlighet — Kan en affärsanvändare utan teknisk bakgrund komma igång utan att skriva kod?
- Datakompletthet — Stöder den berikning via undersidor (att besöka varje produkts detaljsida för specifikationer, varianter och säljarinfo)?
- Underhållsbehov — Anpassar den sig när Temu ändrar sin sidstruktur?
- Schemaläggning och övervakning — Kan den köra återkommande scraping och exportera till en levande datamottagare?
- Exportmål — CSV, Excel, Google Sheets, Airtable, Notion, JSON?
- Kostnadstransparens — Vad kostar ett realistiskt Temu-flöde per månad i praktiken?
Rapporter från communityn på Reddit's r/webscraping beskriver konsekvent Temu som en av de svåraste e-handelssajterna att scrapa. En användare skrev att de "inte ens kan få fram ett pris som köpare", medan en annan påpekade att Temu och Shopee har team som kontinuerligt stärker anti-bot-mekanismerna. Det finns ingen offentlig benchmark för Temu-specifika felprocenter, men Impervas Bad Bot Report 2025 visade att automatiserad trafik passerade mänsklig trafik, med bottar som stod för 51% av all internettrafik. Det är den miljö Temu försvarar sig mot.
Temus anti-bot-försvar: varför de flesta scrapers misslyckas
De flesta artiklar om Temu-scraping nämner anti-bot-skydd i en enda mening: "Temu använder anti-bot." Det hjälper inte mycket.
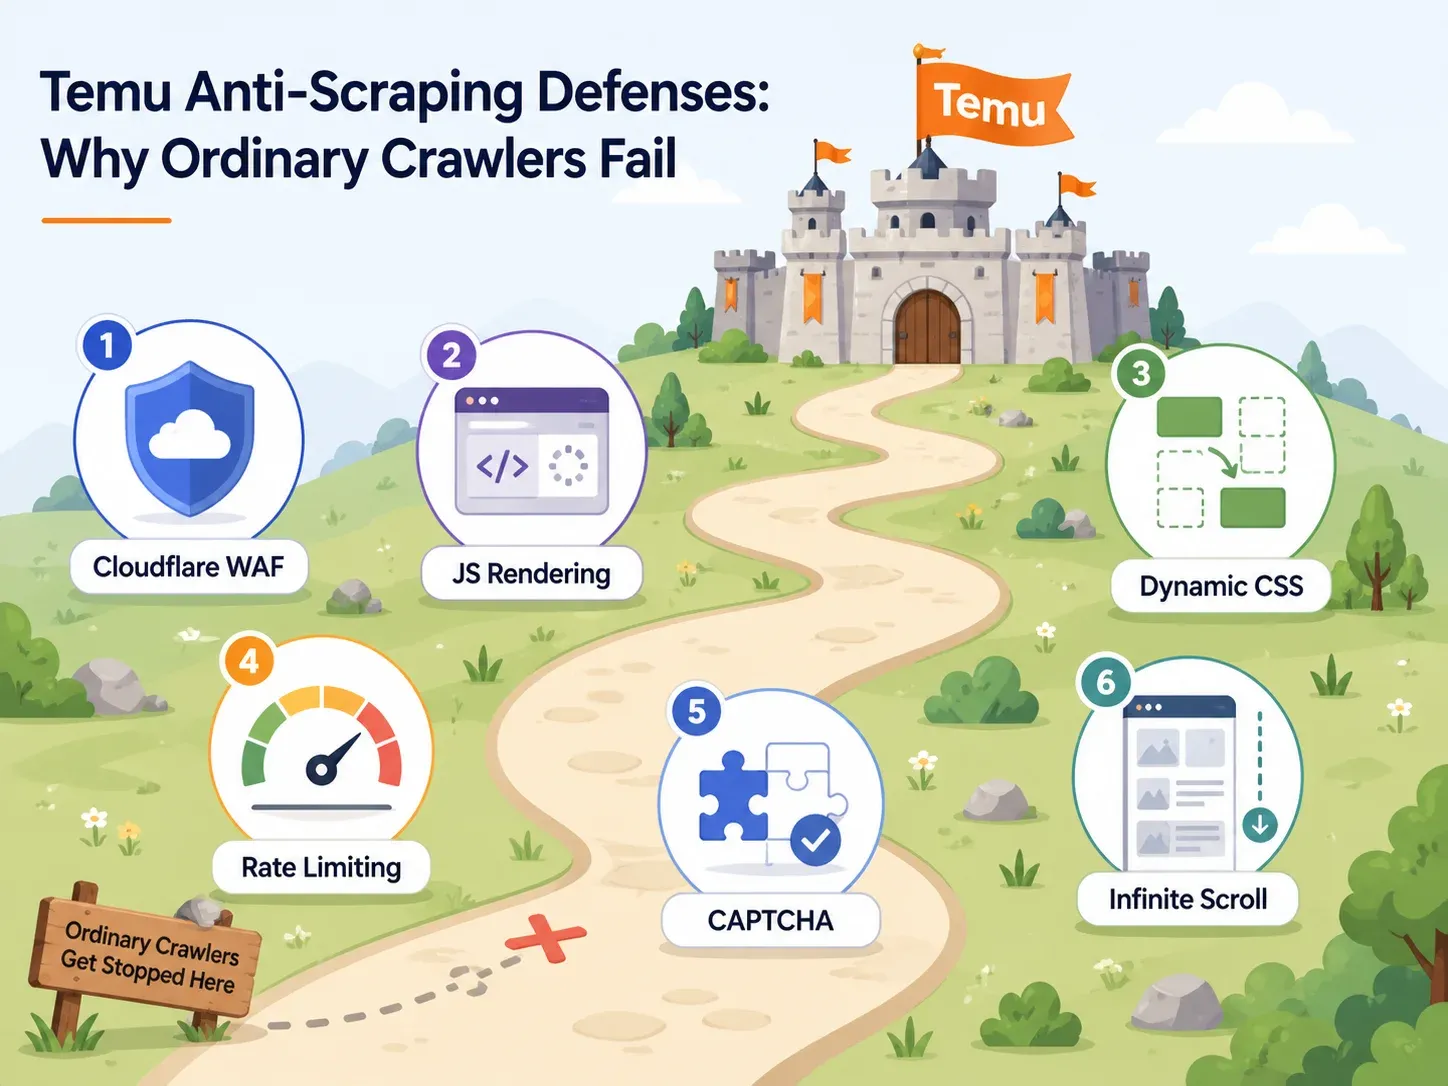
Om du väljer verktyg behöver du veta vilket försvar Temu använder och vilken funktion i verktyget som kringgår det. Här är den praktiska kartan:
| Temu-försvar | Vad det gör | Vilken funktion verktyget måste ha | Exempel på verktyg |
|---|---|---|---|
| Cloudflare WAF / webbläsarkontroller | Blockerar automatiserade user agents, känner igen bottar via fingerprint och returnerar utmaningssidor | Molninfrastruktur med roterande residential IP:er och riktiga webbläsarfingeravtryck | Thunderbit (cloud scraping), Bright Data, Oxylabs, ScraperAPI |
| Tung JavaScript-rendering | Produktdata laddas via JS; rå HTML är tom | Headless browser eller full webbläsar-rendering | Thunderbit (browser scraping-läge), Playwright, Selenium, ParseHub, Apify browser actors |
| Dynamiska CSS-selektorer | Klassnamn ändras mellan utrullningar, vilket bryter CSS-baserade scrapers | AI-baserad fältdetektering (inte beroende av fasta selektorer) | Thunderbit (AI läser sidan på nytt varje gång), Bright Data AI scraper builder |
| Rate limiting | Stryper snabba, sekventiella förfrågningar | Samtidiga molnförfrågningar med intelligent throttling | Thunderbit (upp till 50 sidor åt gången via molnet), ScraperAPI, Bright Data |
| CAPTCHA-utmaningar | Avbryter sessioner efter misstänkt beteende | Inbyggd CAPTCHA-lösning eller strategi som triggar mindre | Bright Data, Oxylabs, ScraperAPI premium/ultra-premium |
| Oändlig scroll / lazy loading | Bara de första produkterna visas utan interaktion | Smart scroll, pagination-detektering, automatisering av interaktion | Thunderbit pagination, Apify smart scrolling, Octoparse workflow builder |
Cloudflare WAF och IP-blockering
Temus entré bevakas av browser integrity checks av Cloudflare-typ. Vanliga HTTP-förfrågningar — sådana som ett enkelt Python-anrop med requests.get() gör — blir utmanade, får 403-svar eller serveras med ofullständig data.
Verktyg som fungerar här behöver roterande residential- eller mobil-IP:er och verkliga webbläsarfingeravtryck. Cloudflare’s 2025 Radar review rapporterade att icke-AI-bottar inledde 2025 med att stå för ungefär hälften av alla HTML-begäranden. Det är den skala av automatisering som plattformar som Temu försvarar sig mot.
JavaScript-rendering och dynamiska selektorer
Det är här de flesta nybörjarscrapers faller tyst.
Om du tittar i Temus sidkälla ser du ofta ett tomt skal — de faktiska produktkortens innehåll, priser och bilder injiceras via JavaScript efter att sidan laddats. En scraper som bara läser rå HTML kommer därför inte att ge något användbart. Utöver det ändras Temus CSS-klasser och DOM-struktur mellan utrullningar. En scraper som bygger på en fast CSS-selektor som .product-card__price fungerar idag men kan ge tomma kolumner imorgon.
AI-baserade scrapers (som Thunderbit) läser sidan semantiskt varje gång, så de är inte beroende av att specifika klassnamn förblir desamma.
Rate limiting och CAPTCHA-utmaningar
Om du träffar Temu för snabbt eller för många gånger från samma IP triggar du rate limits eller CAPTCHA-utmaningar. Vissa verktyg hanterar detta med intelligent throttling och inbyggd CAPTCHA-lösning. Andra lämnar det åt dig — vilket för en icke-teknisk användare i praktiken är en återvändsgränd.
För molnscraping är nyckeln samtidiga förfrågningar fördelade över rena IP:er med automatisk retry-logik.
Bästa Temu-scrapers efter kunskapsnivå: en komplett genomgång
Hitta din rad och hoppa till rätt avsnitt:
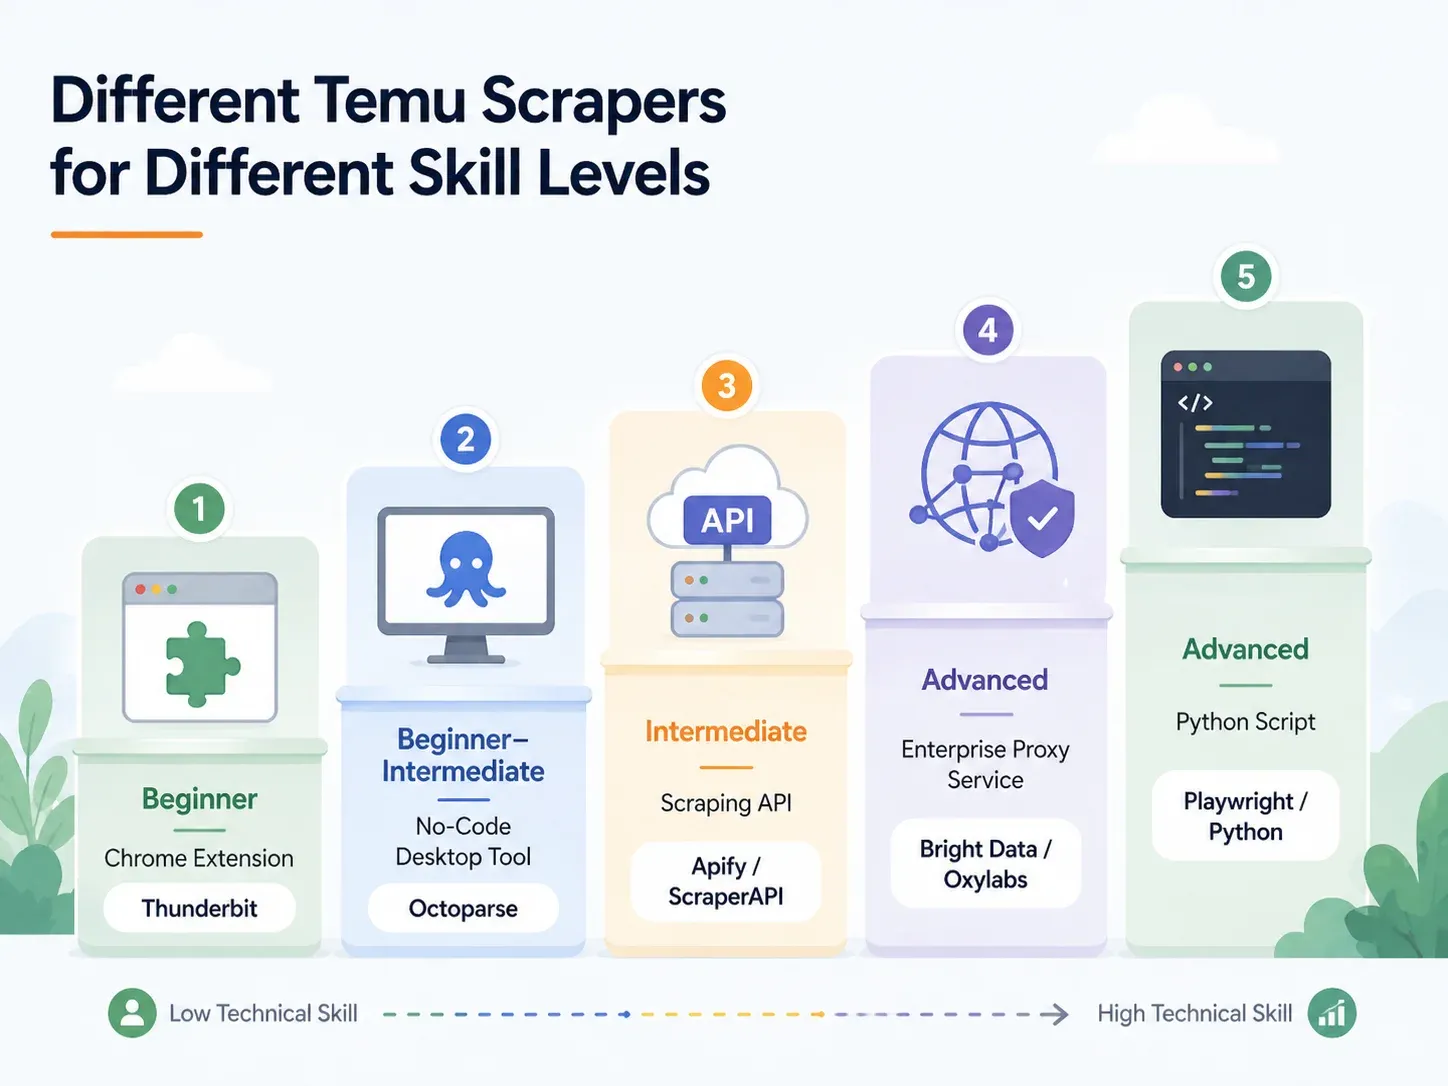
| Metod | Kunskapsnivå | Tid att komma igång | Hantering av anti-bot | Bäst för |
|---|---|---|---|---|
| AI Chrome-tillägg (t.ex. Thunderbit) | Nybörjare | < 2 min | Hanteras (moln eller webbläsare) | Dropshippare, marknadsförare, e-handelsdrift |
| No-code desktopverktyg (t.ex. Octoparse, ParseHub) | Nybörjare–medel | 10–60 min | Delvis (proxykonfiguration krävs) | Regelbunden scraping med mallar |
| Scraping API/tjänst (t.ex. ScraperAPI, Apify) | Medel | 15–45 min | Inbyggd | Utvecklare som integrerar i pipelines |
| Hanterad proxy/enterprise (t.ex. Bright Data, Oxylabs) | Avancerad/Enterprise | Timmar–dagar | Full infrastruktur | Hög volym, leverans till datalager |
| Egen Python-skriptlösning (Playwright/Selenium) | Avancerad | 1–4 timmar+ | Manuell (proxy + CAPTCHA-konfiguration) | Full kontroll, specialanpassningar |
Thunderbit: bästa Temu-scraper för icke-tekniska användare
Thunderbit är ett AI-drivet Chrome-tillägg byggt för affärsanvändare — säljteam, e-handelsoperatörer, dropshippare och marknadsförare — som behöver strukturerad data från webbplatser utan att skriva kod. Jag arbetar i Thunderbit-teamet, så jag känner produkten väl. Jag ska vara rak om vad den gör och var den passar.
Det centrala arbetsflödet är ett klick: öppna en Temu-sida och klicka på One-Click Extract — AI Suggest Fields föreslår kolumnerna (produktnamn, pris, bild, betyg osv.) och körningen fortsätter av sig själv om du inte ingriper.
Thunderbits AI läser sidstrukturen och föreslår kolumnnamn och datatyper automatiskt. Den förlitar sig inte på fasta CSS-selektorer, så när Temu ändrar sina klassnamn eller kortlayout anpassar sig scrapers automatiskt.
Viktiga funktioner för Temu:
- Cloud scraping-läge: Snabbare för publika sidor, bearbetar upp till 50 sidor åt gången. Bäst för kategorisidor, sökresultat och produktlistningar som inte kräver inloggning.
- Browser scraping-läge: Använder din nuvarande Chrome-session, inklusive cookies, språk/region och inloggningsstatus. Bäst när region, popup-fönster eller inloggat innehåll påverkar vad sidan visar.
- Scrape Subpages: Efter att du har skrapat en listningssida kan du klicka på "Scrape Subpages" för att besöka varje produkts detaljsida och lägga till kolumner som full beskrivning, varianter, säljarinfo, leveransestimat och specifikationer — utan extra konfiguration.
- Field AI Prompts: Kategorisera, översätt eller omformatera data under själva scraping-körningen. Till exempel: "Kategorisera den här produkten som Kitchen Utensils, Small Appliances, Storage eller Other."
- Schemalagd scraping: Ställ in ett naturligt språk-schema ("varje måndag kl. 9"), ange URL:er och Thunderbit kör scraping i molnet och exporterar till Google Sheets, Airtable eller ett annat mål.
- Gratis export: Excel, CSV, Google Sheets, Airtable, Notion, JSON — ingen betalvägg för export. Bilder exporteras som faktiska bilagor i Airtable och Notion.
Pris: gratisnivå med upp till 6 sidor per månad; betalplaner börjar runt $15/månad (månad) eller $9/månad (årsvis) för 500 credits, där 1 credit = 1 utdata-rad.
Scrapa Temu-data med AI Get Started Free
Jämförelse sida vid sida: Thunderbit vs. Python-skript på samma Temu-sida
Kontrasten är tydlig:
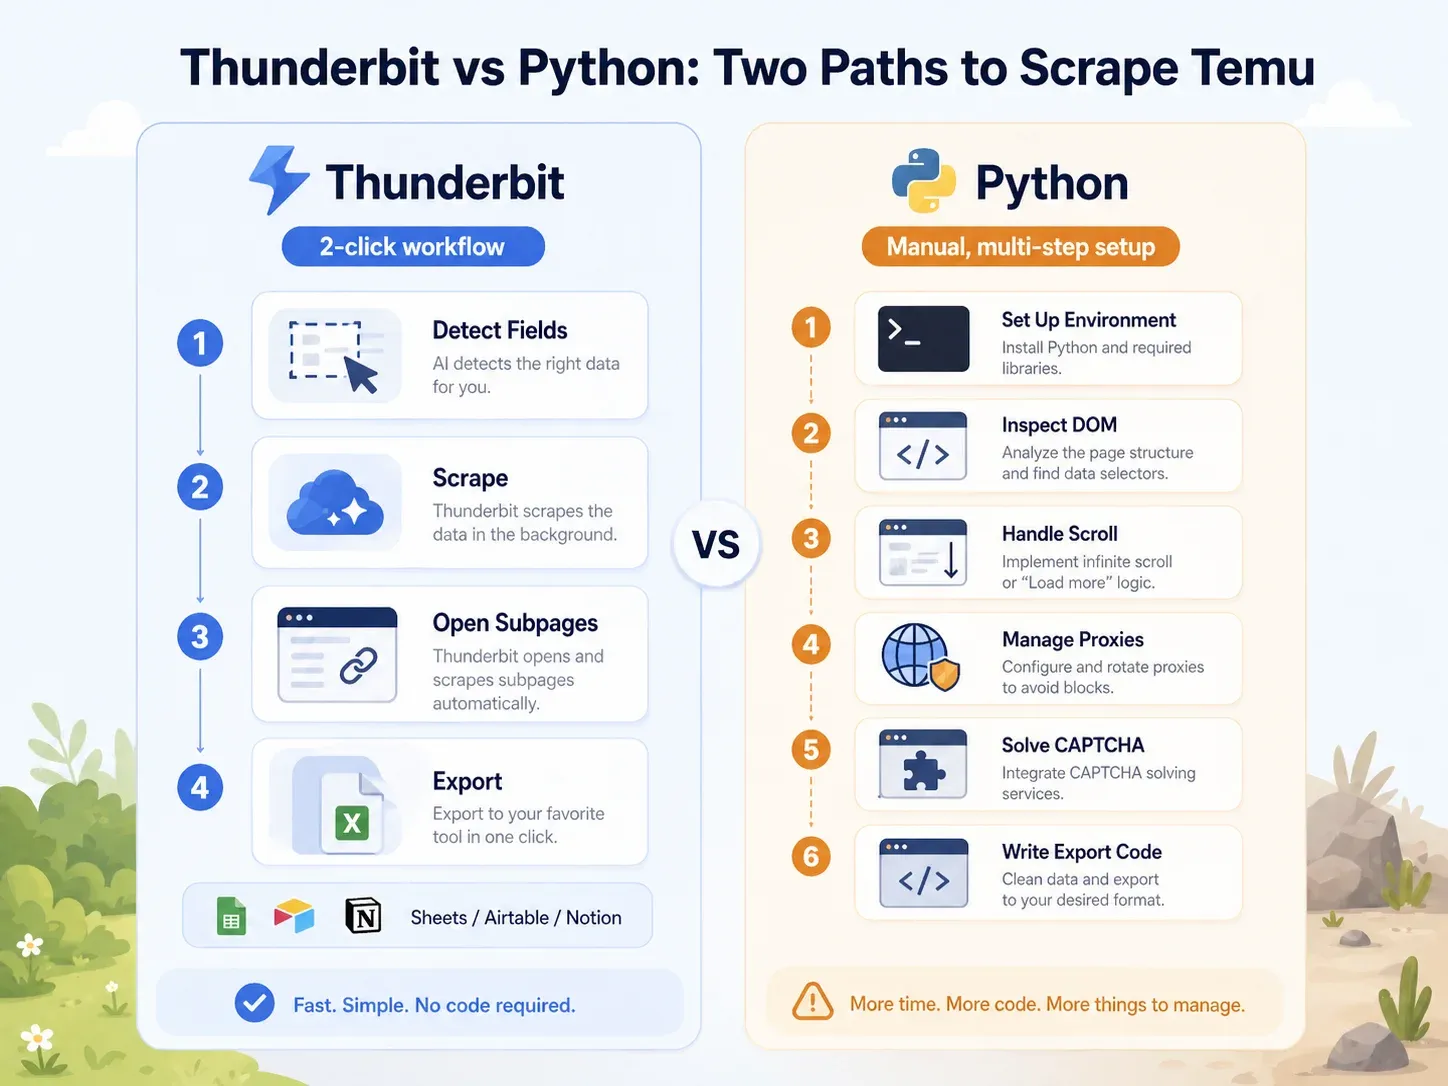
| Uppgift | Thunderbit | Python (Playwright) |
|---|---|---|
| Öppna Temu-kategorisida | Öppna sidan i Chrome | Sätt upp Python-miljö, installera Playwright, installera webbläsare |
| Identifiera fält | Klicka på "AI Suggest Fields" | Inspektera DOM, nätverksanrop, JSON-payloads |
| Hantera dynamisk laddning | Browser/cloud-läge + pagination | Skriv logik för scroll/wait, avlyssna requests |
| Hantera blockeringar | Testa cloud-läge eller browser-läge | Lägg till proxies, headers, fingerprinting, retries, CAPTCHA |
| Extrahera listningsfält | Klicka på "Scrape" | Skriv selektorer eller logik för API-analys |
| Berika produktsidor | Klicka på "Scrape Subpages" | Bygg en separat PDP-crawler |
| Exportera | Klicka Sheets/Airtable/Notion/Excel | Skriv integrationskod för CSV/JSON/Sheets |
| Typisk uppsättning för en affärsanvändare | Under 2 minuter | Minst 1–4 timmar; löpande underhåll |
Ett minimalt Playwright-prototyp för Temu kan se ut så här (pseudokod — inte produktionsklar):
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=False)
    page = browser.new_page()
    page.goto("https://www.temu.com/search_result.html?search_key=kitchen+organizer")
    page.wait_for_load_state("networkidle")
    for _ in range(8):
        page.mouse.wheel(0, 2000)
        page.wait_for_timeout(1200)
    cards = page.locator("[data-product-id], a[href*='goods.html']")
    # Produktionskod kräver fortfarande selektorer, proxies, retries,
    # CAPTCHA-hantering, PDP-crawling och exportlogik.
    print(cards.count())
Det där är 10+ rader innan du ens har extraherat ett enda fält, och då har du inte ens rört proxies, CAPTCHA, berikning av produktsidor eller export. För en icke-teknisk användare komprimerar Thunderbit hela det flödet till ett par klick. För en utvecklare ger Python-spåret mer kontroll — men till en betydligt högre underhållskostnad.
Octoparse och ParseHub: no-code desktop-scrapers för Temu
Om du vill ha mer kontroll än ett Chrome-tillägg men inte vill skriva kod, är Octoparse och ParseHub de främsta alternativen.
Octoparse har en offentlig Temu Details Scraper-mall. Exempelutdata inkluderar produkt-ID, titlar, priser, säljar-/butiksdata, bild-URL:er, rabatter, butik-URL:er och detaljerade specifikationer. Det är en riktig fördel — du kan börja med en mall i stället för att bygga ett arbetsflöde från grunden. Octoparse stödjer också molnextraktion, schemaläggning och visuell byggnad av arbetsflöden.
Nackdelarna för Temu:
- Anti-bot-tillägg (residential proxies för $3/GB, CAPTCHA-lösning för $1–$1.50 per tusen) kan snabbt bli dyra.
- Mallar kan gå sönder när Temu ändrar layout. Du kan behöva uppdatera selektorer eller vänta på att Octoparse underhåller mallen.
- Uppstarten tar 10–60 minuter beroende på sidans komplexitet.
Octoparse-priser: gratisplan med 10 uppgifter och 50K månatlig dataexport; Standard från $69/månad och Professional $249/månad, båda faktureras årsvis (månad-till-månad kostar mer). Tillägg för proxies, CAPTCHA och hanterade tjänster tillkommer.
ParseHub är en visuell desktop-/webbscraper som hanterar dynamiska sidor bra (den kör en full Chromium-browser). Men betalda planer börjar på $189/månad, vilket är högt för en ensam operatör. Jag hittade ingen stark offentlig Temu-specifik mall i min research. ParseHub passar bättre för team som redan är vana vid att bygga visuella scraping-projekt.
| Verktyg | Styrkor för Temu | Svagheter på Temu | Pris |
|---|---|---|---|
| Octoparse | Offentlig Temu-mall, visuellt arbetsflöde, molnextraktion, schemaläggning | Mallunderhåll, anti-bot-tillägg ökar kostnaden | Gratis; från $69/mån Standard och $249/mån Pro (faktureras årsvis); tillägg extra |
| ParseHub | Hantering av dynamiska sidor, projektbyggare, IP-rotation på betalda planer | Högre ingångspris, ingen offentlig Temu-mall hittades | Betalda planer från $189/mån |
Scraping-API:er: ScraperAPI, Apify och Bright Data för Temu
API-baserade scraping-tjänster hanterar proxies, rendering och anti-bot-logik så att utvecklare kan fokusera på att tolka och lagra data. De passar när du bygger en pipeline, inte när du gör en engångsexport till ett kalkylblad.
ScraperAPI är ett utvecklar-API för proxyrotation och rendering. På prissidan anges en 7-dagars provperiod med 5 000 credits, Hobby för $49/månad för 100 000 credits, och högre nivåer därifrån. Knäckfrågan för Temu: JavaScript-rendering och premium proxy-pooler kostar 10–75 credits per begäran beroende på nivå. Den multiplikationen gör att din faktiska kostnad per rad kan bli mycket högre än priset på startsidan.
Apify är en plattform med en marknadsplats av färdiga "actors" (scrapers). Flera Temu-actors finns. En community-underhållen Temu Scraper anger pay-per-event-priser runt $5 per 1 000 produkter på gratisnivån. En annan Temu Products Scraper anger $4 per 1 000 resultat. Risken: kvaliteten varierar, underhållet beror på communityn, och vissa actors kan vara föråldrade eller gå sönder när Temu uppdaterar. Kontrollera alltid "last modified" och användarbetyg innan du binder dig.
Bright Data är enterprise-alternativet. Deras Temu scraper-sida säger att jobben körs på Bright Data-infrastruktur med proxyrotation, geo-targeting, CAPTCHA-/unblocking-logik och autoskalning. Exportformat inkluderar JSON, CSV, Parquet samt direkt leverans till S3, GCS, Azure Blob, BigQuery och Snowflake. Branschrecensioner uppger Web Scraper API pay-as-you-go runt $1.5 per 1 000 poster, med avtalade planer från ungefär $499/månad. Kraftfullt, men prissatt för team med riktiga budgetar.
Oxylabs har också en dedikerad Temu Scraper API-sida. Planer börjar på $49/månad, med en gratis provperiod på upp till 2 000 resultat. Det är ett starkt alternativ till Bright Data för utvecklingsteam som vill ha strukturerad Temu-data via API.
| API/Plattform | Bevis för Temu | Styrka | Svaghet | Bäst för |
|---|---|---|---|---|
| ScraperAPI | Ingen Temu-specifik sida hittades, men anti-bot-funktioner för e-handel är dokumenterade | Enkelt endpoint, JS-rendering, premium proxies | Kreditmultiplikatorer för premiumfunktioner; utvecklaren måste tolka datan | Developer pipelines |
| Apify | Flera Temu-actors i marknadsplatsen | Snabbaste utvecklarvägen om actor:n passar och underhålls | Kvalitet varierar; vissa är föråldrade | Utvecklare som vill ha actor-marknadsplats + schemaläggning |
| Bright Data | Dedikerad Temu-scraper-sida | Enterprise-infrastruktur, unblocking, leverans till datalager | Dyrt; kräver ändå webbskrapningskunskap | Enterprise-datateam |
| Oxylabs | Dedikerad Temu Scraper API-sida | Tydlig prisbild per resultat, JS-hantering, IP/CAPTCHA-påståenden | Arbetsflöde för utvecklar-API | Utvecklingsteam som behöver Temu-API-åtkomst |
Egna Python-skript (Playwright/Selenium): full kontroll, högt arbete
Egenbyggda Python-scrapers ger maximal flexibilitet — det är plusset. Playwright är i regel en bättre startpunkt än Selenium för Temu tack vare sin auto-wait-modell och bättre hantering av JS-tunga sidor.
Men kompromissen är brutal.
En prototyp tar 1–4 timmar. En produktionsklar scraper behöver proxyrotation, realistiska webbläsarfingeravtryck, CAPTCHA-strategi, retries, schema-validering, lagring av output, övervakning, larm och juridisk granskning.
Och den går sönder. Reddit-communityn för scraping beskriver gång på gång modern e-handelsscraping som instabil när sajter använder Cloudflare, JavaScript-rendering och anti-bot-fingerprints.
| Feltyp | Vanlig orsak | Motåtgärd | |---|---|---|---| | Tom HTML / saknade produkter | JS laddar produktkort efter den initiala HTML:en | Använd Playwright, vänta på nätverk och DOM | | Bara de första produkterna visas | Oändlig scroll / lazy loading | Scroll-loop, network idle-väntan, tröskel för antal kort | | Priser saknas eller varierar | Region-/sessions-/valutastatus eller anti-bot-svar | Sätt locale, cookies, geotargeted proxy | | 403 / utmaning / CAPTCHA | IP-rykte, headless-fingerprint, förfrågningshastighet | Residential proxies, stealth-browser, lägre hastighet | | Sönderbrutna selektorer | DOM-/klassändringar, A/B-tester | Semantisk extraktion eller API-analys om tillgängligt |
Egna skript är inte det "gratis" alternativet. De flyttar kostnaden från prenumerationsavgifter till utvecklartid, proxykostnader, CAPTCHA-kostnader och underhållsrisk. Om du har en scrapingingenjör på plats och behöver ovanlig logik är det rätt väg. För alla andra är det i praktiken det dyraste alternativet.
Bästa praxis: subpage-scraping för komplett Temu-produktdata
Det här är den enskilt viktigaste bästa praxisen i artikeln — och nästan ingen annan guide tar upp den.
En Temu-kategori- eller söksida visar grunderna: titel, miniatyrbild, pris och ungefärligt betyg. Men de fält som faktiskt gör en rad användbar — detaljerade beskrivningar, varianter, fullständigt antal recensioner, leveransestimat, säljarens namn och specifikationstabeller — finns på produktsidans detaljsida (PDP).
Om du bara scrapar listningssidan arbetar du med en ofullständig datamängd.
Tvåstegsflödet:
- Steg 1 — Scrapa listningssidan (PLP): Extrahera produktnamn, pris, miniatyrbild och betyg från en Temu-sök- eller kategorisida.
- Steg 2 — Berika via subpage-scraping: Besök varje produkts PDP och lägg till kolumner som full beskrivning, antal recensioner, varianter, leveranstid och säljarinfo.
Så här ser datan ut före och efter:
| Fält | Från PLP (Steg 1) | Läggs till från PDP (Steg 2) | |---|---|---|---| | Produkttitel | ✅ | — | | Pris | ✅ | ✅ (verifierat / rabatt %) | | Miniatyrbild | ✅ | — | | Stjärnbetyg | ✅ | ✅ (med antal recensioner) | | Full beskrivning | ❌ | ✅ | | Varianter (storlekar, färger) | ❌ | ✅ | | Säljarens namn | ❌ | ✅ | | Leveransestimat | ❌ | ✅ | | Detaljerade specifikationer | ❌ | ✅ |
I Thunderbit är detta ett klick: efter din första scraping klickar du på "Scrape Subpages." AI:n besöker varje produkt-URL och lägger till extra kolumner — ingen extra konfiguration, ingen separat spider, inget underhåll av selektorer. Octoparse Temu Details-mall och Apify Temu actor stödjer också fält på PDP-nivå, men kräver mer setup och underhåll. I Python behöver du bygga en separat PDP-crawler, underhålla dess selektorer och hantera pagination inne i detaljsidorna — en betydande extra investering.
Bästa praxis: schemalagd Temu-scraping för löpande pris- och lagerövervakning
Engångsscrapes är användbara för produktupptäckt. Konkurrensintelligens kräver upprepad övervakning.
Priser ändras, produkter tar slut, nya artiklar dyker upp dagligen och rabatternas djup skiftar med kampanjer. En veckovis eller daglig scraping skapar en historik som teamet faktiskt kan agera på.
Tre användningsområden som är värda att automatisera:
- Prisövervakning: Följ en konkurrents 50 viktigaste Temu-SKU:er varje vecka. Få uppdaterade priser automatiskt exporterade till Google Sheets för snabb jämförelse med din egen prissättning.
- Lager- och tillgänglighetsövervakning: Upptäck när en trendande produkt tar slut, när en ny variant dyker upp eller när leveransestimat ändras.
- Upptäckt av nya produkter/trender: Schemalägg en daglig scraping av Temus "New Arrivals" eller en prioriterad kategorisida. Sortera efter antal sålda eller antal recensioner för att fånga upp produkter i uppgång tidigt.
I Thunderbit ställer du in detta genom att beskriva intervallet med naturligt språk ("varje måndag kl. 9"), ange dina mål-URL:er och klicka på "Schedule." Scrapen körs i molnet och exporteras till ditt valda mål. Eftersom AI:n läser sidan på nytt varje gång anpassar sig schemalagda scrapes automatiskt till Temus layoutändringar — du behöver inte uppdatera selektorer när Temu gör om ett produktkort.
Alternativet: sätt upp ett cron-jobb, underhåll ett Python-skript, konfigurera proxyrotation, bygg en exportpipeline och fixa selektorer varje gång Temu ändrar layout. För ett icke-tekniskt team är det inte realistiskt. För en utvecklare är det ett löpande overhead-problem. Apify och Bright Data stödjer också schemalagda körningar, men med mer teknisk setup och högre kostnadsnivåer.
Bästa praxis: hela Temu-dataflödet från början till slut (scrapa → städa → exportera → agera)
De flesta scraping-guider slutar vid "ladda ner CSV."
Men affärsanvändare behöver data i de verktyg de faktiskt jobbar i — Google Sheets för samarbete, Airtable för produktdatabaser, Notion för teamets dashboards. Den verkliga bästa praxisen är ett end-to-end-flöde:
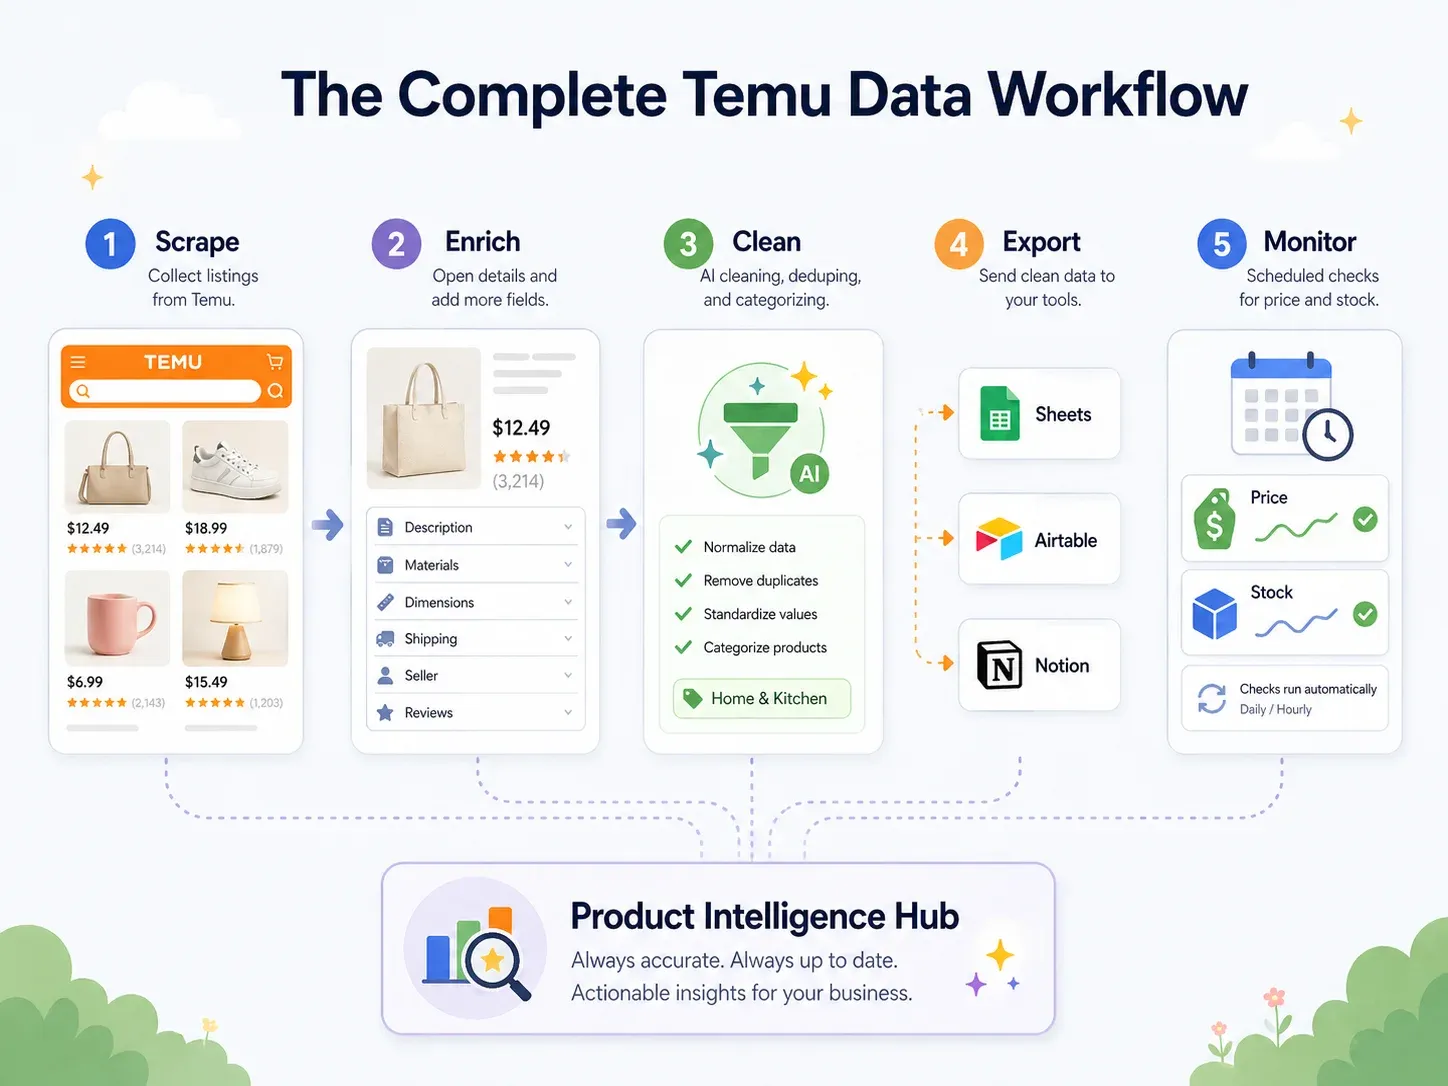
| Steg i flödet | Vad som händer | Thunderbit-funktion | |---|---|---|---| | Scrape | Extrahera data från Temu-sidor | AI Suggest Fields → Scrape (2 klick) | | Berika | Besök varje produkts detaljsida | Scrape Subpages (1 klick) | | Städa & märka | Kategorisera produkter, normalisera priser, översätta titlar | Field AI Prompt — märk, formatera och översätt under scraping | | Exportera | Skicka data till affärsverktyg | Gratis export till Excel, Google Sheets, Airtable, Notion; ladda ner CSV/JSON | | Övervaka | Följ förändringar över tid | Scheduled Scraper med naturliga språk-intervall |
Ett konkret exempel: Du scrapar 200 Temu-produkter för kök. Under körningen kategoriserar en Field AI Prompt automatiskt varje produkt som "Utensils / Small Appliances / Storage / Cleaning / Decor." Priserna normaliseras till numeriska USD-värden. Kinesiska produktnamn översätts till engelska. Datan exporteras direkt till en Airtable-bas med produktbilderna intakta (inte bara URL:er — faktiska bildbilagor, som beskrivs i Thunderbits guide om bildscraping). En schemalagd scraping uppdaterar datan varje vecka.
Några användbara Field AI Prompt-instruktioner för Temu-data:
- "Kategorisera den här produkten som ett av följande: Kitchen Utensils, Small Appliances, Storage, Cleaning, Decor, Other. Returnera bara kategorin."
- "Översätt produktnamnet till kortfattad engelska och behåll varumärken, antal, storlekar och modellnummer."
- "Normalisera priset som ett tal utan valutasymboler."
- "Märk efterfrågan som High, Medium eller Low baserat på betyg, antal recensioner och antal sålda. Om data saknas, returnera Unknown."
Det här flödet förvandlar en rå scraping till en levande produktintelligensdatabas — utan att en utvecklare bygger en separat ETL-pipeline.
Jämförelse av de bästa Temu-scrapers: tabell sida vid sida
| Verktyg | Kunskapsnivå | Tid att komma igång | Hantering av anti-bot | Subpage-scraping | Schemaläggning | Exportalternativ | Prisnivå | Bäst för |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Nybörjare | Minuter | Browser-läge, cloud-läge, AI-fältdetektering | Ja (Scrape Subpages) | Ja (naturliga språk-scheman) | Excel, CSV, Google Sheets, Airtable, Notion, JSON | Gratis 6 sidor; betalt från ~ $9–15/mån för 500 credits | Icke-tekniska e-handelsteam, dropshippare |
| Octoparse | Nybörjare–medel | 10–60 min | Molnextraktion, proxy/CAPTCHA-tillägg | Ja (mallarbetsflöden) | Ja (betalda/molnplaner) | Excel, CSV, JSON, HTML, XML, databas, Google Sheets | Gratis; från $69/mån Standard (faktureras årsvis); tillägg extra | Operatörer som vill ha visuella arbetsflöden + Temu-mall |
| ParseHub | Nybörjare–medel | 30–60 min | Dynamisk rendering, betald IP-rotation | Ja (projektflöden) | Betalda planer | CSV/JSON, Dropbox/S3 på betalda planer | Betalda planer från $189/mån | Team som bygger visuella projekt för dynamiska sajter |
| ScraperAPI | Utvecklare | Timmar | Proxyrotation, JS-rendering, premium-pooler | Egen kod | DataPipeline/scheduler | HTML/JSON/CSV | Trial 5K credits; Hobby $49/mån; högre nivåer finns | Utvecklare som bygger egna Temu-pipelines |
| Apify | Medel | 10–30 min om actor passar | Actor-specifik browser/proxy-logik | Beror på actor | Ja | JSON, CSV, Excel, API/datasets | Gratis plattform; Temu-actors ~$4–5/1K produkter | Utvecklare/operatörer som kan granska actor-kvalitet |
| Bright Data | Avancerad/Enterprise | Timmar–dagar | Full proxy, CAPTCHA, unblocking, autoskalning | Egen via scraper/API | Ja | JSON, CSV, Parquet, S3, GCS, Azure, BigQuery, Snowflake | ~$1.5/1K poster PAYG; Scale från $499/mån | Enterprise-datateam, extraktion i hög volym |
| Oxylabs | Avancerad | Timmar | JS-hantering, IP/CAPTCHA-påståenden | Egen via API | Ja | JSON/API-output | Från $49/mån; trial upp till 2K resultat | Utvecklingsteam som behöver Temu-API-åtkomst |
| Eget Python (Playwright) | Avancerad | 1–4 timmar+; löpande underhåll | Manuella proxies, CAPTCHA, fingerprints | Helt anpassningsbart | Cron/kö/manuellt | Anpassat | Utvecklartid + proxy/CAPTCHA/hostingkostnader | Specialfall, team med scrapingingenjörer |
Vilken Temu-scraper ska du välja? Snabba rekommendationer
- Dropshippare som behöver snabb produktresearch? Börja med Thunderbits gratisnivå. Det är den snabbaste vägen från "jag vill ha Temu-data" till "jag har ett kalkylblad." Om det fungerar på dina målsidor (och det borde göra det för de flesta publika kategori- och produktsidor), är du klar.
- Operatör som vill ha visuell kontroll och återanvändbara mallar? Octoparse har en offentlig Temu Details-mall och en visuell workflow-byggare. Räkna med 10–30 minuters setup och viss proxy-/CAPTCHA-konfiguration.
- Utvecklare som bygger en datapipeline eller internt verktyg? ScraperAPI eller Apify ger API-/actor-flöden som går att integrera med kod och schemalagda jobb. Granska Apify-actors noga — kontrollera underhållsstatus och användarbetyg.
- Enterprise-team som behöver Temu-data i hög volym och leverans till datalager? Bright Data är infrastrukturspåret. Dyrt, men det hanterar skala, unblocking och leverans till S3/BigQuery/Snowflake.
- Scrapingingenjör som behöver ovanlig logik? Egen Playwright/Selenium ger full kontroll. Budgetera bara för löpande underhåll, proxykostnader och CAPTCHA-hantering.
För de flesta icke-tekniska affärsanvändare rekommenderar jag att först testa Thunderbits gratisnivå. Den omedelbara frågan är alltid "kan jag få ut de rader jag behöver från just den här Temu-sidan?" — och det kan du besvara på under två minuter utan att betala något. För utvecklare: kör ett benchmark för kostnad per lyckad rad över Apify, ScraperAPI och ett litet Playwright-prototyp innan du binder budget.
Testa Thunderbit gratis för Temu-scraping
Vanliga frågor om att scrapa Temu
Är det lagligt att scrapa Temu?
Det beror på jurisdiktion, vilken data du samlar in, hur du får tillgång till den och hur du använder datan. Temus Terms of Use begränsar uttryckligen automatiserad åtkomst, inklusive crawling, scraping eller spidering av sidor eller data. Amerikanska domstolar har gett viss gynnsam praxis för åtkomst till offentligt tillgänglig data (Ninth Circuits hiQ v. LinkedIn-beslut), men senare avgöranden har också upprätthållit krav om avtalsbrott och intrång. Det korta svaret: scraping av offentligt tillgänglig produktdata för research kan vara försvarbart i vissa sammanhang, men användarvillkor, integritetslagstiftning, upphovsrätt och hur du använder datan spelar alla roll. Detta är inte juridisk rådgivning — rådgör med jurist vid kommersiell användning.
Hur ofta ändrar Temu sin webbplatslayout?
Ingen offentlig frekvens har dokumenterats. Communityrapporter och verktygsekosystemet behandlar Temu som ett dynamiskt, ofta uppdaterat mål. Utgå från att CSS-selektorer kan gå sönder när som helst och föredra AI-/semantisk extraktion eller aktivt underhållna mallar framför hårdkodade selektorer.
Kan jag scrapa Temu utan att bli blockerad?
För begränsade publika sidor med rimlig takt, ja — särskilt med verktyg som har riktig webbläsar-rendering, sessionsstöd och throttling. Inget verktyg ska ses som en universell garanti. Molnscraping med roterande IP:er fungerar bra för publika katalogsidor; browser scraping med din nuvarande session fungerar bättre när region, inloggning eller popup-fönster påverkar datan.
Vilken data kan jag extrahera från Temus produktsidor?
Vanliga publika fält inkluderar produkttitel, URL, aktuellt pris, originalpris, rabattprocent, bild-URL:er, stjärnbetyg, antal recensioner, antal sålda, säljar-/butiksnamn, fraktinformation, kategori, produktspecifikationer, varianter (färger, storlekar) och tidsstämpel för scraping. Exakt vilka fält som finns beror på sidtyp (listning vs. detaljsida) och region.
Behöver jag proxies för att scrapa Temu?
För små manuella extraktioner i browser-läge (några sidor åt gången) kanske inte. För molnbaserad, schemalagd eller högvolymsinsamling behövs oftast proxies eller hanterad anti-blockering-infrastruktur. Verktyg som Thunderbit, Bright Data och ScraperAPI paketerar proxyhanteringen i sina plattformar så att du slipper konfigurera den separat.
Om du vill fördjupa dig i närliggande ämnen kan du kolla våra guider om web scraping för prisjämförelse, bästa e-handelsscrapers, hur man scrapar data från webbplatser till Excel och hur man scrapar till Google Sheets. Du kan också se genomgångar på Thunderbits YouTube-kanal.
Testa Thunderbit för Temu-scraping Get Started Free
Läs mer




