
Webben växer snabbare än mitt kaffeberoende – och tro mig, det säger en del. År 2026 är webbdatautvinning inte bara en nischfärdighet för datanördar; det är ryggraden i affärsintelligens, AI-träning och automatisering. Oavsett om du spårar marknadstrender, driver din nästa generations LLM, eller bara försöker hålla jämna steg med dina konkurrenters prissättning, har behovet av realtids, strukturerad webbdata aldrig varit högre. Och i hjärtat av denna dataguldfeber? Python. Med sitt massiva ekosystem och tillgängliga syntax förblir Python det självklara språket för webbskrapning, som driver allt från snabba engångsskript till industriella crawlers.
Men här är haken: att välja rätt Python-webbskrapningspaket kan avgöra ditt projekts framgång eller misslyckande. Jag har sett team slösa dagar på att kämpa mot anti-bot-väggar med fel verktyg, eller bränna timmar på att tolka rörig HTML när ett smartare bibliotek skulle ha löst det på minuter. Så, som någon som har tillbringat år inom SaaS, automatisering och AI (och byggt Thunderbit för att göra skrapning enklare för alla), har jag sammanställt de 12 bästa Python-webbskrapningspaketen för 2026 – var och en med sina egna styrkor, egenheter och idealiska användningsområden. Låt oss dyka in och hitta den perfekta lösningen för ditt nästa dataäventyr.
Varför rätt Python-webbskrapningspaket är viktigt
Skrapa data från vilken webbplats som helst med AI Get Started Free
Låt oss vara ärliga: alla webbskrapningsprojekt är inte skapade lika. Ibland behöver du bara hämta några produktpriser från en statisk sida. Andra gånger brottas du med en JavaScript-tung webbplats som är mer envis än en katt vid badtid. Rätt paket kan spara dig timmar (eller dagar), minska fel och hjälpa dig att undvika vanliga fallgropar som anti-bot-blockeringar eller trasig HTML.
Pythons popularitet inom webbskrapning är inte bara hype. Bibliotek som requests och urllib3 har över 1 miljard nedladdningar per månad, och nästan varje större skrapningsverktyg är Python-först. Men med stor makt följer stort ansvar: välj fel verktyg, och du kan hamna i ett projekt som är långsammare än uppringt internet. Välj klokt, och du kommer att simma i ren, strukturerad data innan ditt kaffe kallnar.
Hur vi valde de bästa Python-webbskrapningspaketen
Jag kastade inte bara pilar på ett PyPI-diagram. Så här utvärderade jag varje paket:
- Prestanda & Samtidighet: Kan den hämta hundratals (eller tusentals) sidor snabbt?
- Användarvänlighet: Är den nybörjarvänlig, eller kräver den en doktorsexamen i datavetenskap?
- HTML-tolkningskraft: Hanterar den trasig markup, stöder XPath/CSS-väljare och gör datautvinning smärtfri?
- Stöd för dynamiskt innehåll: Kan den hantera JavaScript-tunga webbplatser, eller är den strikt för statiska sidor?
- Community & Dokumentation: Finns det en blomstrande användarbas och gedigen dokumentation, eller kommer du att fastna i Stack Overflow-skärselden?
- Bästa användningsfall: Är den för snabba skript, storskaliga crawlers, eller något däremellan?
Jag tog också hänsyn till verklig utvecklarfeedback, nya riktmärken och mina egna (ibland smärtsamma) erfarenheter inom området. Nu, låt oss möta utmanarna.
1. Thunderbit
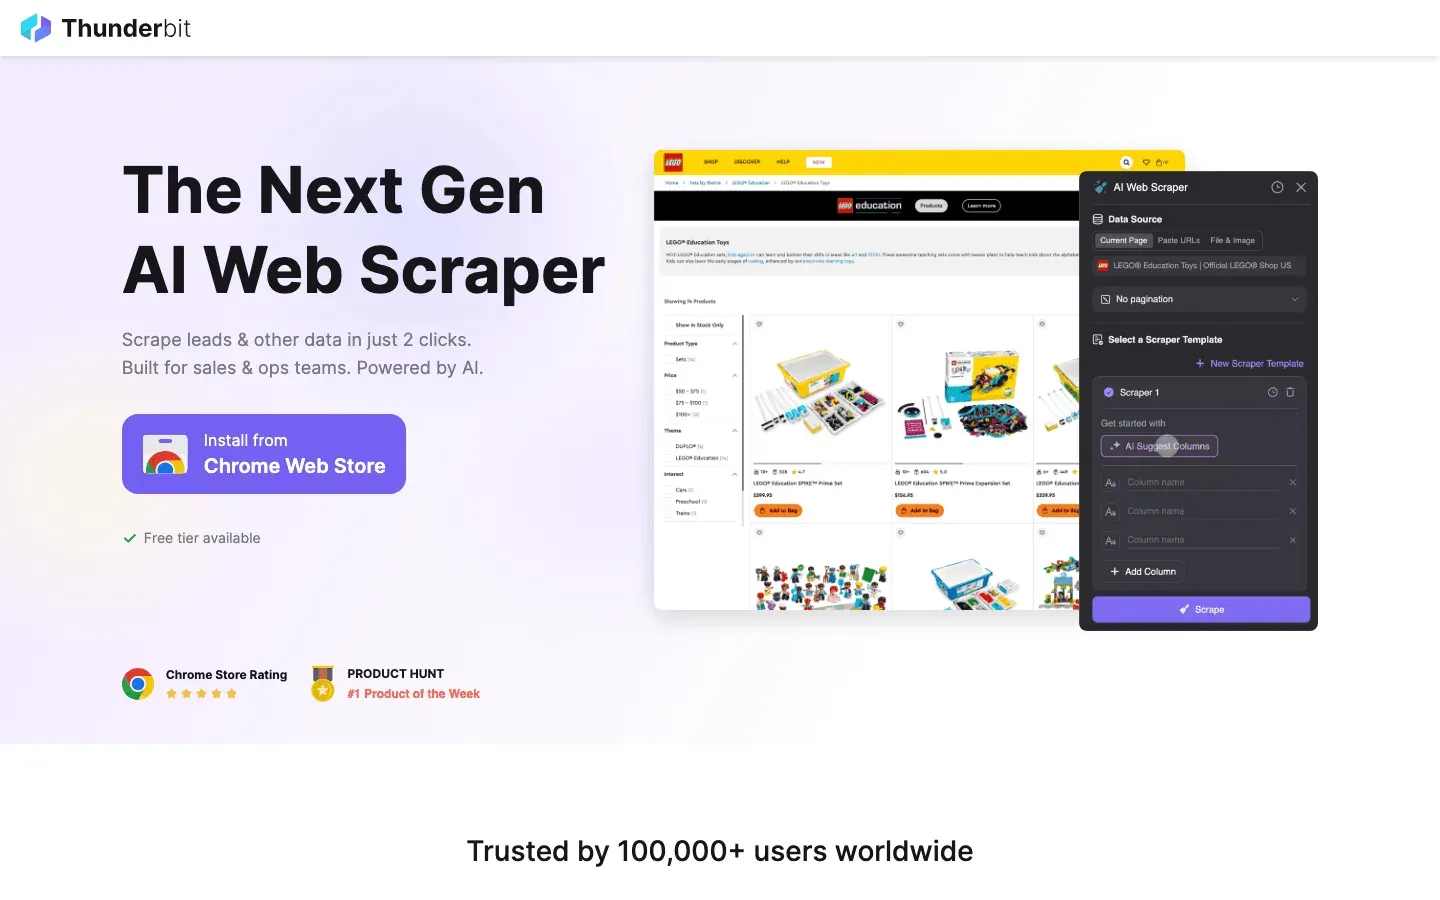 Thunderbit är inte ditt typiska Python-bibliotek – det är ett AI-drivet Chrome-tillägg som förändrar spelet för webbskrapning, särskilt för Python-utvecklare som vill ha snabbhet, noggrannhet och en touch av AI-magi. Vad gör Thunderbit unikt? Det låter dig använda naturliga språkanvisningar för att berätta för AI:n vilken data du vill ha, och sedan hanterar den allt: fältförslag, navigering till undersidor, paginering och till och med export till Excel, Google Sheets, Notion eller Airtable.
Thunderbit är en räddare i nöden för att skrapa komplex, ostrukturerad data – tänk röriga kataloger, produktlistor eller webbplatser där HTML är mer "abstrakt konst" än "strukturerat dokument". Dess funktion AI Suggest Fields läser sidan och föreslår de bästa kolumnerna, medan Subpage Scraping låter dig berika din datamängd genom att automatiskt besöka länkade detaljsidor. Och om du är trött på anti-bot-huvudvärk, har Thunderbits webbläsarbaserade och molnskrapningsalternativ dig täckt.
Python-utvecklare älskar Thunderbit för snabb prototypning, leadgenerering och marknadsundersökningar. Du kan använda dess utdata direkt i din Python-datapipline, eller till och med automatisera skrapningsarbetsflöden med dess API. Det är inte ett traditionellt kodbibliotek, men det blir snabbt en favorit för alla som vill spendera mindre tid på att koda och mer tid på att analysera data.
Nyckelfunktioner:
- AI-driven fältförslag och datautvinning
- Hanterar undersidor, paginering och till och med PDF:er/bilder
- Exporterar till CSV, Excel, Google Sheets, Notion, Airtable
- Ingen kodning krävs – perfekt för både icke-tekniska användare och Python-proffs som vill agera snabbt
- Gratis nivå tillgänglig; betalda planer skalas med dina behov
Bäst för: Leadgenerering, marknadsundersökningar, snabb prototypning och skrapning av komplex eller rörig webbdata.
Prova Thunderbit AI Web Scraper gratis
2. Beautiful Soup
 Beautiful Soup är originalet för HTML-tolkning i Python. Om du precis har börjat, eller behöver extrahera data från statiska webbsidor, är detta din bästa vän. Beautiful Soup är utmärkt på att navigera och tolka dåligt strukturerad HTML ("taggsoppa"), vilket gör den till en räddare i nöden för att skrapa webbplatser som inte följer reglerna.
API:et är nybörjarvänligt – tänk .find(), .select() och .text – och det passar perfekt med requests för att hämta webbsidor. Under huven kan du välja olika parsers (som lxml för snabbhet eller html5lib för maximal kompatibilitet). Dokumentationen är förstklassig, och communityn är massiv.
Nyckelfunktioner:
- Intuitivt, Pythoniskt API för att navigera HTML/XML
- Hanterar trasig eller inkonsekvent markup elegant
- Fungerar med flera parsers för snabbhet eller kompatibilitet
- Stor community och massor av handledningar
Bäst för: Snabba skript, skrapning av statiska sidor och nybörjare som vill ha en mild inlärningskurva.
3. Scrapy
 Scrapy är tungviktsmästaren för storskalig, automatiserad webbcrawling. Om du behöver skrapa hundratals eller tusentals sidor, hantera pipelines eller schemalägga återkommande jobb, är Scrapy det ramverk de flesta team landar på. Det körs fortfarande på en Twisted-reaktor under huven, men från och med version 2.14 omskrevs en stor del av dess asynkrona interna delar som inbyggda
asyncio-korutiner, och det finns nu AsyncCrawlerProcess / AsyncCrawlerRunner-ingångspunkter som fungerar bra med resten av det moderna Python-asynkrona ekosystemet. Det är snabbt, stöder samtidig crawling, item pipelines för datarensning och exporterar till JSON, CSV eller databaser.
Scrapy är utbyggbart, med plugins för proxyservrar, cachning och till och med begränsad JavaScript-rendering (via Splash- eller Selenium-integration). Inlärningskurvan är brantare än för Beautiful Soup, men om du menar allvar med webbdata i stor skala är Scrapy det du växer in i.
Nyckelfunktioner:
- Asynkron crawling via Twisted-reaktor + inbyggda
asyncio-korutiner (Scrapy 2.14+, Python 3.10+) - Inbyggda pipelines för datarensning och lagring
- Export till flera format (JSON, CSV, DB)
- Stor, aktiv community och plugin-ekosystem
Bäst för: Storskaliga, återkommande skrapningsprojekt, datapiplines och alla som behöver snabbhet och tillförlitlighet.
4. Selenium
 Selenium är det självklara verktyget för att skrapa JavaScript-tunga eller interaktiva webbplatser. Det automatiserar riktiga webbläsare (Chrome, Firefox, etc.), vilket låter dig simulera användaråtgärder som klick, rullning och formulärinlämningar. Om den data du behöver bara visas efter att JavaScript körts, kan Selenium hämta den – oavsett hur envis webbplatsen är.
Nackdelen? Selenium är långsamt och resurskrävande. Du kör en fullständig webbläsare för varje skrapning, så förvänta dig inte att bearbeta tusentals sidor per minut. Men för de scenarier där "inget annat verktyg kan göra det" är Selenium en räddare i nöden.
Nyckelfunktioner:
- Fullständig webbläsarautomatisering (stöder Chrome, Firefox, Edge, etc.)
- Hanterar JavaScript-renderat innehåll och interaktiva element
- Stöder headless-läge för snabbare, UI-lös skrapning
- Stor community och omfattande dokumentation
Bäst för: Skrapning av dynamiska, JavaScript-tunga webbplatser, automatisering av inloggningsflöden och hantering av CAPTCHAs eller komplexa användarinteraktioner.
Läs mer om Selenius styrkor och svagheter
5. PyQuery
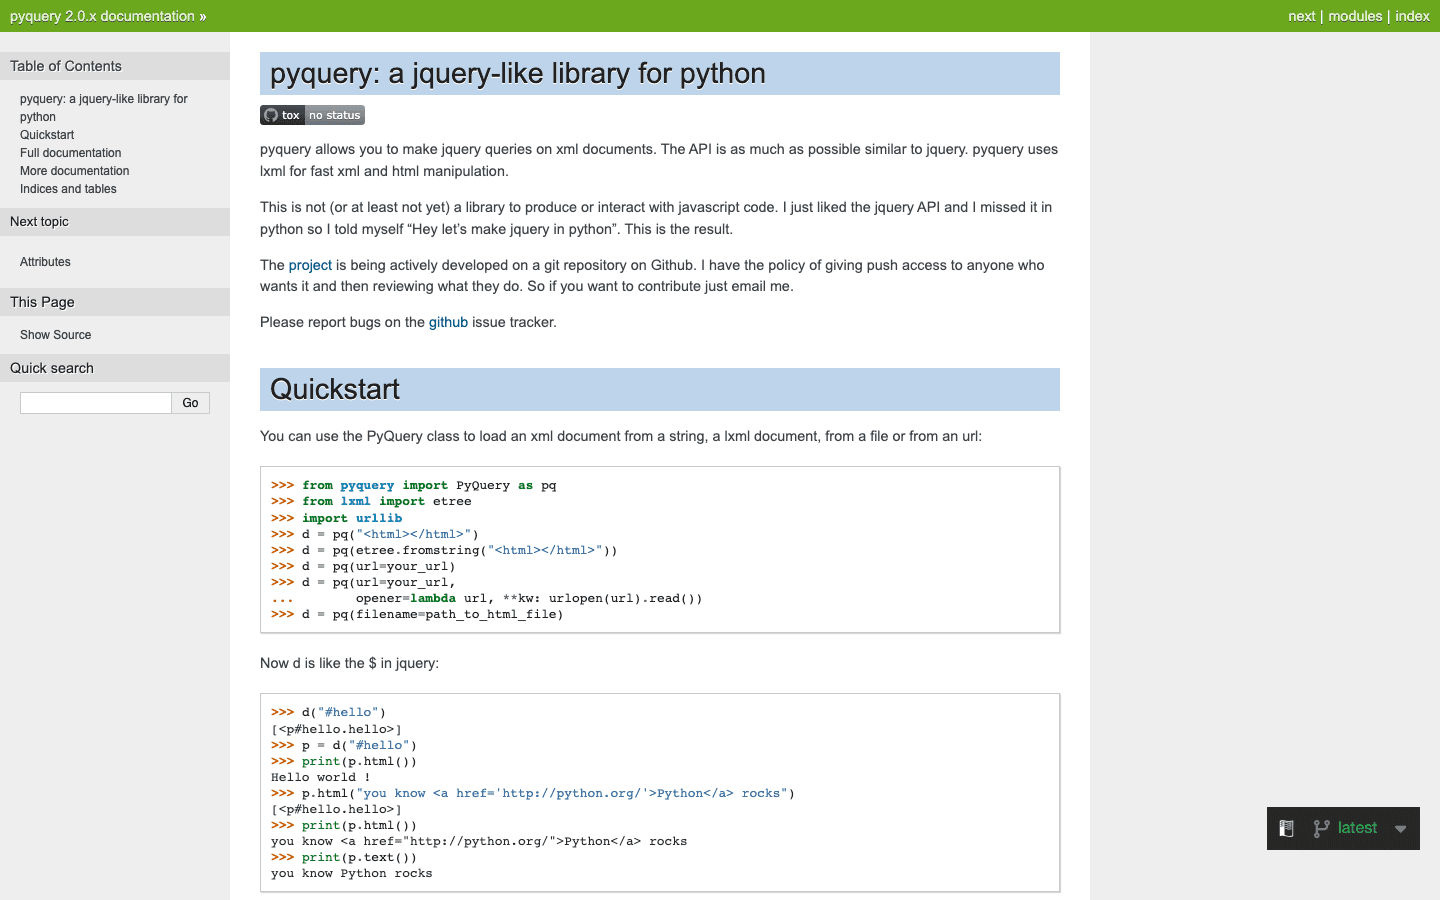 PyQuery för med sig jQuery-liknande syntax till Python, vilket gör HTML-tolkning bekant för alla som har arbetat med jQuery i JavaScript. Det omsluter den snabba
lxml-parsern och låter dig använda CSS-väljare som $('div.classname') för att hitta element.
PyQuery är utmärkt för snabb prototypning och för utvecklare som vill ha koncis, läsbar kod. Det är snabbare än Beautiful Soup för komplexa frågor och integreras enkelt med asynkrona verktyg eller Selenium för mer avancerade arbetsflöden.
Nyckelfunktioner:
- jQuery-liknande väljare och syntax i Python
- Snabb tolkning med lxml-backend
- Utmärkt för utvecklare som övergår från JavaScript
- Stöder kedjning och koncisa frågor
Bäst för: Prototyping, jQuery-fans och alla som vill skriva mindre kod för HTML-tolkning.
PyQuery-handledning och jämförelse
6. LXML
 LXML är snabbhetsdemon för HTML- och XML-tolkning i Python. Byggd ovanpå C-biblioteken
libxml2 och libxslt, är den känd för sin prestanda och kraftfulla stöd för XPath- och CSS-väljare. Om du hanterar stora dokument eller behöver köra komplexa frågor är lxml ditt bästa val.
Den kan användas direkt eller som backend för Beautiful Soup eller PyQuery. API:et är lite mer avancerat, men snabbheten och flexibiliteten är värda det för stora jobb.
Nyckelfunktioner:
- Snabbaste tolkningen tillgänglig i Python
- Fullt stöd för XPath- och CSS-väljare
- Hanterar stora och komplexa dokument effektivt
- Kan användas fristående eller som en parser för andra bibliotek
Bäst för: Högpresterande tolkning, storskalig skrapning och projekt som kräver avancerade frågor.
Varför lxml sticker ut för tolkning
7. Requests
 Requests är de facto-standarden för att göra HTTP-förfrågningar i Python. Dess rena, intuitiva API gör det lika enkelt att hämta webbsidor som
requests.get(url). Den hanterar cookies, sessioner och till och med JSON-avkodning direkt.
Även om Requests är synkront (varje förfrågan väntar på att slutföras), är det perfekt för snabba skript och småskalig skrapning. Kombinera det med Beautiful Soup eller lxml för ett klassiskt skrapningsarbetsflöde.
Nyckelfunktioner:
- Enkelt, Pythoniskt API för HTTP-förfrågningar
- Hanterar cookies, sessioner och omdirigeringar
- Integreras sömlöst med tolkningsbibliotek
- Massiv community och dokumentation
Bäst för: Enkla skript, skrapning av statiska sidor och nybörjare som vill komma igång snabbt.
Se varför Requests är så populärt
8. MechanicalSoup
 MechanicalSoup är ett lättviktsbibliotek som automatiserar enkla webbläsarinteraktioner – som att fylla i formulär eller navigera i flerstegs inloggningsflöden – utan att starta en fullständig webbläsare. Det omsluter
requests och Beautiful Soup, vilket gör det mycket snabbare och lättare än Selenium för webbplatser som inte förlitar sig tungt på JavaScript.
Om du behöver logga in, skicka formulär eller klicka dig igenom några sidor (och webbplatsen inte är för dynamisk), är MechanicalSoup en utmärkt medelväg.
Nyckelfunktioner:
- Automatiserar formulärifyllning och navigering
- Byggd ovanpå Requests och Beautiful Soup
- Lättviktig och snabb (ingen webbläsaroverhead)
- Lätt att använda för måttlig interaktivitet
Bäst för: Webbplatser som kräver inloggning eller formulärinlämning, enkla automatiseringsuppgifter och alla som vill undvika Selenius overhead.
MechanicalSoup-handledning
9. Aiohttp
 Aiohttp är den asynkrona kraftpaketet för höghastighets, samtidiga webbförfrågningar. Om du behöver skrapa hundratals sidor snabbt, låter aiohttp dig skicka förfrågningar parallellt, vilket dramatiskt minskar den totala körtiden. I ett riktmärke tog en 50-sidors skrapning bara 3 sekunder med aiohttp, jämfört med 16 sekunder med synkrona förfrågningar (se prestandaskillnaden).
Aiohttp kräver att man skriver async def-kod och använder await, men hastighetsvinsterna är värda det för storskaliga jobb.
Nyckelfunktioner:
- Asynkront HTTP-klient/server-ramverk
- Stöder sessioner, cookies och HTTP/2
- Massiv hastighetsökning för samtidiga förfrågningar
- Integreras med asynkrona tolkningsbibliotek
Bäst för: Höghastighets, storskalig skrapning, API-hämtning och alla som är bekväma med asynkron programmering.
10. Twisted
 Twisted är den händelsedrivna nätverksmotorn som driver Scrapy. Även om det inte är ett skrapningsbibliotek i sig, kan avancerade användare använda Twisted direkt för att bygga anpassade crawlers, hantera icke-HTTP-protokoll eller implementera hyper-samtidiga spindlar.
Twisted är kraftfullt men har en brant inlärningskurva. Det är bäst för mycket anpassade scenarier eller när man bygger ramverk från grunden.
Nyckelfunktioner:
- Händelsedrivet nätverk för HTTP, WebSockets, SSH och mer
- Stöder SSL, samtidighet och anpassade protokoll
- Ligger till grund för Scrapy's asynkrona motor
- Mycket flexibelt för avancerade användningsfall
Bäst för: Anpassade protokoll, byggande av skrapningsramverk och avancerade användare som behöver maximal kontroll.
11. Grab
 Grab är ett allt-i-ett-skrapningsverktyg som kombinerar HTTP-förfrågningar, tolkning, automatisering, proxyrotation och CAPTCHA-hantering. Det liknar Scrapy i andan men syftar till att vara lättare att lära sig och använda, med inbyggt stöd för proxyservrar, cachning och asynkrona spindlar.
Grabs utmärkande funktion är dess Grab:Spider-system, som kan köra tusentals förfrågningar parallellt med multicurl. Om du behöver en allt-i-ett-lösning med mindre installation än Scrapy, är Grab värd en titt.
Nyckelfunktioner:
- Inbyggt stöd för proxyservrar, user-agent-rotation och cachning
- Asynkront spindelsystem för hög samtidighet
- XPath-tolkning och modulär arkitektur
- Används i produktion för storskalig skrapning
Bäst för: Allt-i-ett-skrapningsprojekt, proxy-tunga uppgifter och användare som vill ha kraft utan Scrapy's komplexitet.
Introduktion till Grab-ramverket
12. Urllib3
 Urllib3 är den lågnivå HTTP-motorn som driver många Python-klienter, inklusive Requests. Den erbjuder anslutningspoolning, trådsäkerhet, återförsök och finkornig kontroll över HTTP-anslutningar. Medan de flesta utvecklare använder den indirekt, är urllib3 ditt självklara val när du behöver maximal prestanda eller bygger högre nivåers bibliotek.
Den är inte lika nybörjarvänlig som Requests, men den är beprövad och mycket tillförlitlig.
Nyckelfunktioner:
- Anslutningspoolning och trådsäkerhet
- Finkornig kontroll över HTTP-anslutningar
- Används som grund för många andra bibliotek
- Hög prestanda för upprepade förfrågningar
Bäst för: Anpassade HTTP-klienter, flertrådade crawlers och utvecklare som bygger ovanpå Python HTTP-stacken.
Jämförelsetabell: Python-webbskrapningspaket i korthet
| Paket | Användarvänlighet | Prestanda | Dynamiskt innehåll | Tolkningskraft | Community/Dokumentation | Bäst för |
|---|---|---|---|---|---|---|
| Thunderbit | ★★★★☆ (GUI/AI) | Snabb (moln/lokal) | Ja (via AI) | Autofält, undersida | Växande (AI-trend) | Lead-generering, marknadsundersökning, användare utan kod |
| Beautiful Soup | ★★★★★ (enkel) | Medel | Nej | HTML/XML, förlåtande | Enorm | Statiska sidor, nybörjare |
| Scrapy | ★★☆☆☆ (brant) | ★★★★★ (mycket hög) | Endast plugins | CSS/XPath, pipelines | Stor, aktiv | Storskalig, återkommande skrapning |
| Selenium | ★★☆☆☆ (medel) | ★☆☆☆☆ (långsam) | Ja (full) | Full DOM, JS | Mogen | JS-tunga, interaktiva webbplatser |
| PyQuery | ★★★★☆ (jQuery) | Snabb (lxml) | Nej* | jQuery-väljare | Måttlig | Prototypning, jQuery-utvecklare |
| LXML | ★★★☆☆ (avancerad) | ★★★★★ (snabbast) | Nej | XPath/CSS, XML | Måttlig | Stora dokument, avancerade frågor |
| Requests | ★★★★★ (mycket enkel) | ★★☆☆☆ (synkron) | Nej | HTTP, JSON | Massiv | Enkla skript, statiska sidor |
| MechanicalSoup | ★★★★☆ (enkel) | ★★☆☆☆ (synkron) | Nej | Formulär, navigering | Liten | Inloggningsflöden, formulärautomatisering |
| Aiohttp | ★★☆☆☆ (asynkron) | ★★★★★ (samtidig) | Nej | Asynkron HTTP | Stor (asynkron) | Höghastighets, samtidig skrapning |
| Twisted | ★☆☆☆☆ (komplex) | ★★★★★ (anpassad) | Nej | Nätverk, protokoll | Nisch | Anpassade ramverk, avancerade användare |
| Grab | ★★★☆☆ (modulär) | ★★★★☆ (asynkron) | Nej | Proxyservrar, XPath | Liten | Allt-i-ett, proxy/captcha-tung |
| Urllib3 | ★★★★☆ (lågnivå) | ★★★★☆ (poolad) | Nej | HTTP, poolning | Massiv | Anpassade klienter, flertrådade crawlers |
*PyQuery kan kombineras med Selenium för dynamiska webbplatser.
Hur du väljer rätt Python-webbskrapningspaket för dina behov
Vad är dataskrapning och hur man gör det 2026 Get Started Free
Så, vilket paket ska du välja? Här är min fusklapp:
- Statiska sidor, små jobb, eller om du är nybörjare på skrapning: Börja med Requests + Beautiful Soup.
- Storskalig, återkommande eller produktionsskrapning: Scrapy eller Grab (för allt-i-ett-behov).
- JavaScript-tunga eller interaktiva webbplatser: Selenium (eller Thunderbit om du vill ha AI-driven, kodfri skrapning).
- Höghastighets, samtidig skrapning: Aiohttp (om du är bekväm med asynkron programmering).
- Formulärautomatisering eller inloggningsflöden: MechanicalSoup (för enkla webbplatser), Selenium (för komplex JS).
- Avancerad tolkning eller massiva dokument: LXML eller PyQuery.
- Anpassat nätverk eller protokollarbete: Twisted.
- Snabb prototypning, lead-generering eller rörig/ostrukturerad data: Thunderbit.
Och var inte rädd för att blanda och matcha – många arbetsflöden kombinerar dessa verktyg för maximal effektivitet. Du kan till exempel använda Selenium för att rendera en sida, och sedan skicka HTML:en till Beautiful Soup eller PyQuery för tolkning.
Slutsats: Superladda din webbskrapning med rätt Python-verktyg
Webbskrapning 2026 är kraftfullare – och mer nödvändigt – än någonsin. Med rätt Python-webbskrapningspaket kan du förvandla webbens kaos till ren, användbar data för ditt företag, din forskning eller din nästa stora idé. Oavsett om du är en erfaren utvecklare eller bara doppar tårna i datapoolen, finns det ett verktyg på den här listan som passar dina behov.
Om du vill se hur AI-driven, kodfri skrapning ser ut, prova Thunderbit. Och om du är hungrig på fler tips, djupdykningar och handledningar, kolla in Thunderbit Blog för det senaste inom webbskrapning, automatisering och datadrivna arbetsflöden.
Prova Thunderbit AI Web Scraper gratis
Lycka till med skrapningen – och må dina väljare alltid matcha, dina proxyservrar aldrig misslyckas och din data vara lika ren som din kod.
Vanliga frågor
1. Vilket är det bästa Python-webbskrapningspaketet för nybörjare? För de flesta nybörjare är kombinationen av Requests och Beautiful Soup det enklaste sättet att komma igång. Båda har intuitiva API:er, massor av handledningar och hanterar de flesta uppgifter för skrapning av statiska sidor.
2. Hur skrapar jag JavaScript-tunga webbplatser med Python? Använd Selenium för att automatisera en riktig webbläsare, eller prova Thunderbit för AI-driven, kodfri skrapning som kan hantera dynamiskt innehåll. För storskaliga behov kan Scrapy kombineras med Splash eller Selenium.
3. Vilket paket är bäst för storskalig, höghastighetsskrapning? Scrapy är byggt för storskalig, asynkron crawling. Om du behöver ännu mer hastighet och är bekväm med asynkron kod, är aiohttp ett toppval för samtidiga förfrågningar.
4. Kan jag kombinera dessa paket i mitt arbetsflöde? Absolut! Många utvecklare använder Requests eller Selenium för att hämta sidor, och tolkar sedan med Beautiful Soup, lxml eller PyQuery. Thunderbits exporter kan matas in i Python-skript för ytterligare analys.
5. Är Thunderbit ett Python-bibliotek eller ett fristående verktyg? Thunderbit är ett AI-drivet Chrome-tillägg och en plattform, inte ett traditionellt Python-bibliotek. Dess utdata (CSV, Excel, Sheets, Notion, Airtable) integreras dock sömlöst i Python-datapiplines, vilket gör det till en kraftfull följeslagare för Python-utvecklare.
6. Ersätter AI-kodningsagenter Python-skrapningsbibliotek 2026? Inte än, men de är värda att känna till. Verktyg som Claude Code och OpenAI Codex kan generera ett fungerande Requests + Beautiful Soup- eller Scrapy-skript från en enkel engelsk prompt på några sekunder, vilket är genuint användbart för engångsjobb och prototypning. För naturliga språkliga webbläsarflöden (inloggningar, dynamisk JS, flerstegsnavigering) är Browser Use det öppen källkods-alternativ som folk använder, och Firecrawl är populärt när målet är att mata ren markdown till en LLM. Inget av dessa tar bort de svåra delarna – anti-bot-försvar, hastighetsbegränsningar och användarvillkor gäller fortfarande – och för produktionscrawlers i stor skala vinner Scrapy + aiohttp fortfarande på kostnad och kontroll. Behandla AI-agenter som ett snabbare sätt att skriva skraparen, inte en direkt ersättning för biblioteken på den här listan.
Vill du ligga steget före inom webbskrapning? Prenumerera på Thunderbit YouTube-kanal och håll ett öga på Thunderbit Blog för fler guider, jämförelser och automatiseringstips.
Prova Thunderbit AI Web Scraper gratis Get Started Free
Läs mer




