
Vilket programmeringsspråk ska du använda för web scraping? Det beror helt på projektet — och jag har sett utvecklare ge upp av frustration efter att ha valt fel.
Marknaden för web scraping-programvara nådde 1,01 miljarder dollar 2024 och väntas mer än fördubblas till 2032. Rätt språk kan ge snabbare resultat och mindre underhåll. Fel språk leder till trasiga scrapers och bortslösade helger.
Jag har byggt automationsverktyg i flera år. Här är sju språk jag har använt för scraping — med kodexempel, ärliga avvägningar och en titt på när du helt bör hoppa över kodning och använda Thunderbit i stället.
Så valde vi det bästa språket för web scraping
När det gäller web scraping är inte alla programmeringsspråk skapade lika. Jag har sett projekt lyckas — och falla — beroende på några avgörande faktorer:
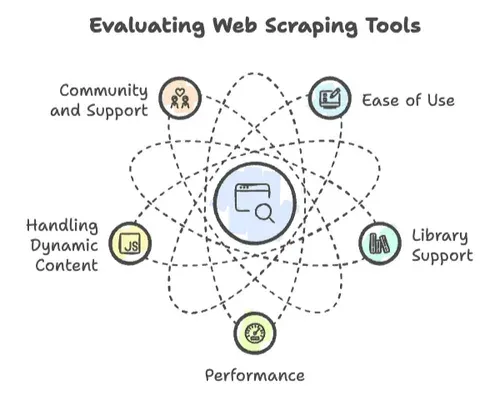
- Enkel att använda: Hur snabbt kommer du igång? Är syntaxen smidig, eller behöver du nästan en doktorsexamen i datavetenskap bara för att skriva “Hello, World”?
- Bibliotekstöd: Finns det stabila bibliotek för HTTP-anrop, HTML-parsing och hantering av dynamiskt innehåll? Eller måste du bygga allt från scratch?
- Prestanda: Klarar det att skrapa miljontals sidor, eller dör det efter några hundra?
- Hantering av dynamiskt innehåll: Moderna sajter älskar JavaScript. Hänger ditt språk med?
- Community och support: När du kör fast — och det gör du förr eller senare — finns det ett community som kan hjälpa?
Utifrån de här kriterierna — och mycket testande sena kvällar — är här de sju språken jag går igenom:
- Python: Förstahandsvalet för både nybörjare och proffs.
- JavaScript & Node.js: Kungen av dynamiskt innehåll.
- Ruby: Ren syntax, snabba skript.
- PHP: Enkelhet på serversidan.
- C++: För när du behöver rå fart.
- Java: Skalbart och redo för enterprise.
- Go (Golang): Snabbt och parallellt.
Och om du tänker: “Shuai, jag vill inte koda alls,” så stanna kvar till slutet för Thunderbit.
Python för web scraping: nybörjarvänlig kraftfullhet
Vi börjar med publikens favorit: Python. Om du frågar ett rum fullt av datafolk: “Vilket är det bästa programmeringsspråket för web scraping?” — då får du sannolikt höra Python tillbaka som ett körsångs-svar.
Varför Python?
- Nybörjarvänlig syntax: Du kan läsa Python-kod högt och den låter nästan som engelska.
- Oslagbart bibliotekstöd: Från BeautifulSoup för HTML-parsing, till Scrapy för storskalig crawling, Requests för HTTP och Selenium för webbläsarautomation — Python har allt.
- Stort community: Över 33 000+ Stack Overflow-frågor om just web scraping.
Exempel: Python-kod för att hämta sidans titel
import requests
from bs4 import BeautifulSoup

response = requests.get("<https://example.com>")
soup = BeautifulSoup(response.text, 'html.parser')
title = soup.title.string
print(f"Page title: {title}")
Styrkor:
- Snabb utveckling och prototypbygge.
- Massor av guider och svar i Q&A-forum.
- Perfekt för dataanalys — skrapa med Python, analysera med pandas, visualisera med matplotlib.
- Biblioteken fortsätter utvecklas: Scrapy 2.14 (januari 2026) införde inbyggt
async/awaitgenom hela ramverket, så asynkront arbete är inte längre bara en Selenium/Playwright-grej.
Begränsningar:
- Långsammare än kompilerade språk för riktigt stora jobb.
- Superdynamiska sajter kan bli krångliga att hantera (även om Selenium och Playwright hjälper).
- Inte optimalt om du ska skrapa miljontals sidor i högsta hastighet.
Kort sagt:
Om du är ny på scraping, eller bara vill få jobbet gjort snabbt, är Python det bästa språket för web scraping — punkt. Mer om varför Python dominerar web scraping.
JavaScript & Node.js: skrapa dynamiska webbplatser utan krångel
Om Python är schweiziska armékniven, så är JavaScript (och Node.js) en borrmaskin — särskilt för moderna webbplatser med mycket JavaScript.
Varför JavaScript/Node.js?
- Inbyggt för dynamiskt innehåll: Det körs i webbläsaren och ser därför det användaren ser — även om sidan bygger på React, Angular eller Vue.
- Asynkront från början: Node.js kan hantera hundratals förfrågningar samtidigt.
- Känt av webbutvecklare: Har du byggt en webbplats kan du redan en del JavaScript.
Viktiga bibliotek:
- Playwright: Stöd för flera webbläsare (Chromium, Firefox, WebKit) med automatisk väntan och proxies per kontext. Om du startar en ny Node-scraper 2026 är detta standardvalet.
- Puppeteer: Headless Chrome via Chrome DevTools Protocol. Fortfarande starkt för jobb som bara körs i Chrome och för lättare beroenden.
- Cheerio: jQuery-lik HTML-parsing för Node när du inte behöver en riktig webbläsare.
Exempel: Node.js-kod för att hämta sidans titel med Puppeteer
const puppeteer = require('puppeteer');

(async () => {
  const browser = await puppeteer.launch();
  const page = await browser.newPage();
  await page.goto('<https://example.com>', { waitUntil: 'networkidle2' });
  const title = await page.title();
  console.log(`Page title: ${title}`);
  await browser.close();
})();
Styrkor:
- Hanterar JavaScript-renderat innehåll direkt.
- Perfekt för oändlig scroll, popups och interaktiva sajter.
- Effektivt för stora, parallella scrapingjobb.
Begränsningar:
- Asynkron programmering kan vara knepigt för nybörjare.
- Headless-browsers slukar minne om du kör för många samtidigt.
- Färre verktyg för dataanalys jämfört med Python.
När är JavaScript/Node.js det bästa programmeringsspråket för web scraping?
När målsajten är dynamisk, eller när du vill automatisera webbläsarhandlingar. Mer om Node.js för att skrapa dynamiskt innehåll.
Ruby: ren syntax för snabba scraping-skript
Ruby är inte bara för Rails-appar och elegant kodpoesi. Det är också ett stabilt val för web scraping — särskilt om du gillar kod som läses nästan som en haiku.
Varför Ruby?
- Läsbar och uttrycksfull syntax: Du kan skriva en scraper i Ruby som nästan är lika lätt att läsa som din inköpslista.
- Bra för prototyper: Snabbt att skriva, enkelt att justera.
- Viktiga bibliotek: Nokogiri för parsing, Mechanize för att automatisera navigation.
Exempel: Ruby-kod för att hämta sidans titel
require 'open-uri'
require 'nokogiri'

html = URI.open("<https://example.com>")
doc = Nokogiri::HTML(html)
title = doc.at('title').text
puts "Page title: #{title}"
Styrkor:
- Väldigt lättläst och koncis.
- Bra för små projekt, engångsskript eller om du redan använder Ruby.
Begränsningar:
- Långsammare än Python eller Node.js vid större jobb.
- Färre scraping-bibliotek och mindre community-stöd för just scraping.
- Inte optimalt för JavaScript-tunga sajter (även om du kan använda Watir eller Selenium).
Passar bäst för:
Om du redan är Ruby-användare eller vill få ihop ett snabbt skript är Ruby riktigt trevligt. För storskalig och dynamisk scraping är det bättre att välja något annat.
PHP: enkelhet på serversidan för webbdatakompisning
PHP kan kännas som en relik från webbens tidiga dagar, men det lever fortfarande — särskilt om du vill skrapa data direkt på servern.
Varför PHP?
- Körs överallt: De flesta webbservrar har redan PHP installerat.
- Enkelt att koppla till webbappar: Skrapa och visa data på din sajt i samma flöde.
- Viktiga bibliotek: cURL för HTTP, Guzzle för förfrågningar, Symfony Panther för headless browser-automation.
Exempel: PHP-kod för att hämta sidans titel
<?php
$ch = curl_init("<https://example.com>");
curl_setopt($ch, CURLOPT_RETURNTRANSFER, true);
$html = curl_exec($ch);
curl_close($ch);

$dom = new DOMDocument();
@$dom->loadHTML($html);
$title = $dom->getElementsByTagName("title")->item(0)->nodeValue;
echo "Page title: $title\n";
?>
Styrkor:
- Lätt att driftsätta på webbservrar.
- Bra för scraping som en del av ett webbarbetsflöde.
- Snabbt för enkla scrapinguppgifter på serversidan.
Begränsningar:
- Begränsat bibliotekstöd för mer avancerad scraping.
- Inte byggt för hög samtidighet eller skrapning i stor skala.
- JavaScript-tunga sajter är knepiga att hantera (även om Panther hjälper).
Passar bäst för:
Om din stack redan är PHP-baserad, eller om du vill skrapa och direkt visa data på din sajt, är PHP ett praktiskt val. Mer om PHP vs Python för scraping.
C++: högpresterande web scraping för stora projekt
C++ är programmeringsspråkens muskelbil. Om du behöver rå fart och kontroll — och inte räds lite manuellt arbete — kan C++ ta dig långt.
Varför C++?
- Extremt snabbt: Slår de flesta språk i CPU-tunga uppgifter.
- Fin kontroll på låg nivå: Hantera minne, trådar och prestandajusteringar.
- Viktiga bibliotek: libcurl för HTTP, htmlcxx för parsing.
Exempel: C++-kod för att hämta sidans titel
#include <curl/curl.h>
#include <iostream>
#include <string>

size_t WriteCallback(void* contents, size_t size, size_t nmemb, void* userp) {
    std::string* html = static_cast<std::string*>(userp);
    size_t totalSize = size * nmemb;
    html->append(static_cast<char*>(contents), totalSize);
    return totalSize;
}

int main() {
    CURL* curl = curl_easy_init();
    std::string html;
    if(curl) {
        curl_easy_setopt(curl, CURLOPT_URL, "<https://example.com>");
        curl_easy_setopt(curl, CURLOPT_WRITEFUNCTION, WriteCallback);
        curl_easy_setopt(curl, CURLOPT_WRITEDATA, &html);
        CURLcode res = curl_easy_perform(curl);
        curl_easy_cleanup(curl);
    }

    std::size_t startPos = html.find("<title>");
    std::size_t endPos = html.find("</title>");
    if(startPos != std::string::npos && endPos != std::string::npos) {
        startPos += 7;
        std::string title = html.substr(startPos, endPos - startPos);
        std::cout << "Page title: " << title << std::endl;
    } else {
        std::cout << "Title tag not found" << std::endl;
    }
    return 0;
}
Styrkor:
- Oöverträffad hastighet för stora scrapingjobb.
- Bra när scraping ska integreras i högpresterande system.
Begränsningar:
- Brant inlärningskurva (ta med kaffe).
- Manuell minneshantering.
- Begränsat med högnivåbibliotek; inte idealiskt för dynamiskt innehåll.
Passar bäst för:
När du ska skrapa miljontals sidor, eller när prestanda är helt avgörande. Annars riskerar du att lägga mer tid på felsökning än på scraping.
Java: enterprise-anpassade lösningar för web scraping
Java är arbetsdjuret i företagsvärlden. Om du bygger något som ska köras länge, hantera enorma datamängder och överleva en zombieapokalyps, då är Java din vän.
Varför Java?
- Robust och skalbart: Bra för stora, långlivade scrapingprojekt.
- Stark typning och felhantering: Färre överraskningar i produktion.
- Viktiga bibliotek: Jsoup för parsing, Selenium WebDriver för webbläsarautomation, Apache HttpClient för HTTP.
Exempel: Java-kod för att hämta sidans titel
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;

public class ScrapeTitle {
    public static void main(String[] args) throws Exception {
        Document doc = Jsoup.connect("<https://example.com>").get();
        String title = doc.title();
        System.out.println("Page title: " + title);
    }
}
Styrkor:
- Hög prestanda och bra samtidighet.
- Utmärkt för stora, underhållbara kodbaser.
- Bra stöd för dynamiskt innehåll via Selenium eller HtmlUnit.
Begränsningar:
- Verbos syntax; kräver mer uppsättning än skriptspråk.
- Överdrivet för små engångsskript.
Passar bäst för:
Scraping i enterprise-skala, eller när du behöver stenhög stabilitet och skalbarhet.
Go (Golang): snabbt och parallellt web scraping
Go är den nya spelaren på plan, men har redan gjort stort avtryck — särskilt för snabb och parallell scraping.
Varför Go?
- Kompilerad hastighet: Nästan lika snabbt som C++.
- Inbyggd samtidighet: Goroutines gör parallell scraping enkel.
- Viktiga bibliotek: Colly för scraping, Goquery för parsing.
Exempel: Go-kod för att hämta sidans titel
package main

import (
    "fmt"
    "github.com/gocolly/colly"
)

func main() {
    c := colly.NewCollector()
    c.OnHTML("title", func(e *colly.HTMLElement) {
        fmt.Println("Page title:", e.Text)
    })
    err := c.Visit("<https://example.com>")
    if err != nil {
        fmt.Println("Error:", err)
    }
}
Styrkor:
- Super snabbt och effektivt för storskalig scraping.
- Enkelt att driftsätta som en enda binär fil.
- Bra för parallell crawling.
Begränsningar:
- Mindre community än Python eller Node.js.
- Färre avancerade scrapingbibliotek.
- JavaScript-tunga sajter kräver extra setup (Chromedp eller Selenium).
Passar bäst för:
När du behöver skrapa i stor skala, eller när Python helt enkelt inte är tillräckligt snabbt. Go vs Python för scraping: prestandajämförelse.
Jämförelse av de bästa programmeringsspråken för web scraping
Låt oss sammanfatta. Här är en jämförelse sida vid sida som hjälper dig välja bästa språk för web scraping 2026:
| Språk/verktyg | Enkel att använda | Prestanda | Bibliotekstöd | Hantering av dynamiskt innehåll | Bästa användningsområde |
|---|---|---|---|---|---|
| Python | Mycket hög | Medel | Utmärkt | Bra (Selenium/Playwright) | Allround, nybörjare, dataanalys |
| JavaScript/Node.js | Medel | Hög | Stark | Utmärkt (inbyggt) | Dynamiska sajter, asynkron scraping, webbutvecklare |
| Ruby | Hög | Medel | Hyfsat | Begränsat (Watir) | Snabba skript, prototyper |
| PHP | Medel | Medel | Okej | Begränsat (Panther) | Serversidan, integration i webbappar |
| C++ | Låg | Mycket hög | Begränsat | Mycket begränsat | Prestandakritiskt, mycket stor skala |
| Java | Medel | Hög | Bra | Bra (Selenium/HtmlUnit) | Enterprise, långkörande tjänster |
| Go (Golang) | Medel | Mycket hög | Växande | Medel (Chromedp) | Snabb, parallell scraping |
När du bör hoppa över kod: Thunderbit som no-code-lösningen för web scraping
Prova Thunderbit Agentic Web Scraper No-code, AI-driven web scraping för affärsanvändare, marknadsförare och säljteam. Get Started Free
Okej, om vi ska vara ärliga: ibland vill man bara ha datan — utan kod, felsökning eller huvudvärken av “varför fungerar inte den här selektorn?”. Det är där Thunderbit kommer in.
Som medgrundare av Thunderbit ville jag bygga ett verktyg som gör web scraping lika enkelt som att beställa takeaway. Här är vad som skiljer Thunderbit från mängden:
- Inställning med ett klick: Klicka bara på “One Click Extract”. Inget pill med HTTP-anrop, proxies eller anti-bot-tricks.
- Smarta mallar: En scraper-mall kan anpassas till flera sidlayouter. Du behöver inte skriva om scrapen varje gång en sajt ändras.
- Scraping i webbläsare och moln: Välj mellan att köra i webbläsaren (perfekt för inloggade sajter) eller i molnet (snabbt för publik data).
- Hanterar dynamiskt innehåll: Thunderbits AI styr en riktig webbläsare — så den klarar oändlig scroll, popups, inloggningar och mer.
- Exportera vart du vill: Ladda ner till Excel, Google Sheets, Airtable, Notion eller kopiera bara till urklipp.
- Inget underhåll: Om en sajt ändras, kör bara AI-förslaget igen. Inga sena felsökningspass längre.
- Schemaläggning och automation: Ställ in scrapers som körs enligt schema — inga cron-jobb, ingen serverkonfiguration.
- Specialiserade extraktorer: Behöver du e-postadresser, telefonnummer eller bilder? Thunderbit har ett-klicks-extraktorer för det också.
Och det bästa? Du behöver inte kunna en enda rad kod. Thunderbit är byggt för affärsanvändare, marknadsförare, säljteam, fastighetsproffs — alla som behöver data snabbt.
Vill du se Thunderbit i praktiken? Ladda ner Chrome-tillägget eller kolla in vår YouTube-kanal för demos.
Prova Thunderbit Agentic Web Scraper gratis Hoppa helt över språkdebatten: Thunderbits agentic web scraper läser vilken sida som helst och extraherar data med ett klick, helt utan kod. Get Started Free
Slutsats: välja bästa språket för web scraping 2026
Se hur agentic web scraping står sig mot kod Thunderbits AI läser en sida och väljer fälten själv, vilket med ett klick gör det som ett scraping-skript annars tar timmar att skriva. Get Started Free
Web scraping 2026 är mer tillgängligt — och mer kraftfullt — än någonsin. Här är vad jag har lärt mig efter många år i automationsgruvorna:
- Python är fortfarande det bästa språket för web scraping om du vill komma igång snabbt och ha massor av resurser nära till hands.
- JavaScript/Node.js är oslagbart för dynamiska sajter med mycket JavaScript.
- Ruby och PHP är utmärkta för snabba skript och webb-integration, särskilt om du redan använder dem.
- C++ och Go är dina vänner när du behöver fart och skala.
- Java är förstahandsvalet för enterprise och långsiktiga projekt.
- Och om du vill hoppa över kod helt? Thunderbit är ditt hemliga vapen.
Innan du kör igång, fråga dig själv:
- Hur stort är mitt projekt?
- Behöver jag hantera dynamiskt innehåll?
- Hur bekväm är jag tekniskt?
- Vill jag bygga själv, eller bara få fram datan?
Testa ett kodexempel ovan, eller ge Thunderbit en chans i ditt nästa projekt. Och om du vill gå djupare, kolla in vår Thunderbit-blogg för fler guider, tips och verkliga scraping-berättelser.
Lycka till med scrapen — och må din data alltid vara ren, strukturerad och bara ett klick bort.
P.S. Om du någon gång fastnar i ett web scraping-kaninhål klockan 02:00, kom ihåg: det finns alltid Thunderbit. Eller kaffe. Eller båda.
Prova Thunderbit Agentic Web Scraper nu Get Started Free
Vanliga frågor
1. Vilket är det bästa programmeringsspråket för web scraping 2026?
Python är fortfarande förstahandsvalet tack vare sin lättlästa syntax, kraftfulla bibliotek (som BeautifulSoup, Scrapy och Selenium) och stora community. Det är perfekt för både nybörjare och proffs, särskilt om du vill kombinera scraping med dataanalys.
2. Vilket språk är bäst för att skrapa webbplatser med mycket JavaScript?
JavaScript (Node.js) är bästa valet för dynamiska sajter. Verktyg som Puppeteer och Playwright ger dig full kontroll över webbläsaren och låter dig interagera med innehåll som laddas via React, Vue eller Angular.
3. Finns det ett no-code-alternativ för web scraping?
Ja — Thunderbit är en no-code agentic web scraper som hanterar allt från dynamiskt innehåll till schemaläggning. Klicka bara på “One Click Extract” och börja skrapa. Perfekt för sälj-, marknads- och operations-team som snabbt behöver strukturerad data.
4. Behöver jag fortfarande välja språk om en AI-kodagent kan skriva scrapen åt mig?
En rimlig fråga 2026. Verktyg som Claude Code, Cursor och OpenAI Codex kan gärna generera en Scrapy-spider, ett Playwright-skript eller en Go + Colly-crawler från en kort prompt — så tröskeln för “vilket språk ska jag lära mig först” är verkligen mycket lägre än för två år sedan. Men agenten skriver fortfarande kod i något språk, och du (eller den som tar över projektet) behöver ändå läsa, felsöka och driftsätta den. Så valet spelar fortfarande roll; det handlar bara mer om underhåll än om de första 30 raderna. Om du inte vill röra kod alls är det där Thunderbit passar — det hoppar över språkfrågan helt.
Läs mer:




