
Trasiga länkar. Föräldralösa sidor. En “test”-sida från 2019 som Google på något sätt har indexerat. Om du ansvarar för en webbplats känner du igen frustrationen.
En bra webbspindel fångar upp allt det där — och kartlägger hela sajten så att du faktiskt kan åtgärda problemen. Men många blandar ihop “web crawler” med “web scraper”. Det är inte samma sak.
Jag har testat 10 gratis crawlers på riktiga sajter. Vissa är riktigt bra för SEO-granskning. Andra passar bättre för datauttag. Här är vad som fungerade — och vad som inte gjorde det.
Vad är en webbspindel? Grunderna förklarade
Låt oss reda ut begreppen direkt: en webbspindel är inte samma sak som en webbskrapa. Jag vet, orden slängs runt lite hur som helst, men i grunden är de olika. Tänk på en spindel som sajtens kartograf – den utforskar varje hörn, följer varje länk och bygger en karta över alla sidor. Dess uppgift är upptäckt: att hitta URL:er, kartlägga webbplatsens struktur och indexera innehåll. Det här är vad sökmotorer som Google gör med sina botar, och vad SEO-verktyg använder för att granska sajtens hälsa (Thunderbit Blog: What Is a Web Crawler?).
En webbskrapa, däremot, är datainsamlaren. Den bryr sig inte om hela kartan — den vill bara åt guldet: produktpriser, företagsnamn, recensioner, e-postadresser, allt möjligt. Skrapor hämtar specifika fält från de sidor som spindeln hittar (Thunderbit Blog: How to Web Crawl a Site?).
En enkel liknelse:
- Spindel: Personen som går igenom varje gång i en mataffär och gör inventering av alla produkter.
- Skrapa: Personen som går direkt till kaffehyllan och skriver upp priset på varje ekologisk blandning.
Varför spelar det här roll? För om du bara vill hitta alla sidor på din webbplats (till exempel inför en SEO-granskning) behöver du en spindel. Om du vill hämta alla produktpriser från en konkurrents sajt behöver du en skrapa — eller helst ett verktyg som gör båda.
Varför använda en webbspindel online? Viktiga affärsfördelar
Så varför ens bry sig om en webbspindel? Webben blir ju inte mindre. Faktum är att över 54 % av företagsvarumärken använder dedikerade crawlingplattformar för att optimera sina sajter, och vissa SEO-verktyg crawlar 7 miljarder sidor per dag.
Här är vad crawlers kan hjälpa dig med:
- SEO-granskning: Hitta trasiga länkar, saknade titlar, duplicerat innehåll, föräldralösa sidor och mer (SEO.ai).
- Länkkontroll och QA: Fånga 404:or och omdirigeringsloopar innan användarna gör det (Screaming Frog).
- Sajtkarta: Skapa XML-sajtkartor automatiskt för sökmotorer och planering (PowerMapper).
- Innehållsinventering: Bygg en lista över alla sidor, deras hierarki och metadata.
- Efterlevnad och tillgänglighet: Kontrollera varje sida för WCAG, SEO och juridisk efterlevnad (SiteOne Crawler).
- Prestanda och säkerhet: Markera långsamma sidor, stora bilder eller säkerhetsproblem (SiteOne Crawler).
- Data för AI och analys: Mata in crawlad data i analysverktyg eller AI-lösningar (Thunderbit Blog: Crawl4AI Review).
Här är en snabb tabell som kopplar användningsområden till affärsroller:
| Användningsområde | Passar bäst för | Fördel / resultat |
|---|---|---|
| SEO & sajtgranskning | Marknadsförare, SEO, småföretagare | Hitta tekniska problem, optimera struktur, förbättra ranking |
| Innehållsinventering & QA | Innehållsansvariga, webbansvariga | Granska eller migrera innehåll, fånga trasiga länkar/bilder |
| Leadgenerering (skrapning) | Sälj, affärsutveckling | Automatisera prospektering, fyll CRM med nya leads |
| Konkurrensbevakning | E-handel, produktchefer | Följ konkurrenters priser, nya produkter och lagersaldon |
| Kopiering av sajtkarta & struktur | Utvecklare, DevOps, konsulter | Spegla sajtstrukturen för redesign eller backup |
| Innehållsinsamling | Forskare, media, analytiker | Samla data från flera sajter för analys eller trendbevakning |
| Marknadsundersökning | Analytiker, AI-träningsteam | Samla stora datamängder för analys eller träning av AI-modeller |
(Thunderbit Blog: How to Web Crawl a Site?)
Så valde vi de bästa gratisverktygen för webbspindling
Jag har lagt många sena kvällar (och druckit mer kaffe än jag vill erkänna) på att gå igenom crawlers, läsa dokumentation och köra testspindlingar. Här är vad jag tittade efter:
- Teknisk kapacitet: Klarar verktyget moderna sajter (JavaScript, inloggningar, dynamiskt innehåll)?
- Användarvänlighet: Är det lätt för personer utan teknisk bakgrund, eller kräver det kommandoradskunskaper?
- Begränsningar i gratisplanen: Är det verkligen gratis, eller bara en teaser?
- Tillgänglighet online: Är det ett molnverktyg, ett skrivbordsprogram eller ett kodbibliotek?
- Unika funktioner: Gör det något särskilt — som AI-utdrag, visuella sajtkartor eller händelsestyrd crawling?
Jag testade varje verktyg, kollade användaromdömen och jämförde funktioner sida vid sida. Om ett verktyg fick mig att vilja kasta laptopen genom fönstret, kom det inte med.
Snabb jämförelsetabell: 10 bästa gratis webbspindlar i korthet
| Verktyg & typ | Kärnfunktioner | Bästa användningsområde | Tekniska krav | Detaljer om gratisplanen |
|---|---|---|---|---|
| Bright Data (Cloud/API) | Crawling för företag, proxies, JS-rendering, CAPTCHA-lösning | Datainsamling i stor skala | Viss teknisk vana är bra | Gratisnivå: 5 000 poster/månad i Web Scraper API, inget kreditkort |
| Crawlbase (Cloud/API) | API-crawling, anti-bot, proxies, JS-rendering | Utvecklare som behöver backend-infrastruktur för crawling | API-integration | Gratis: upp till 20 000 förfrågningar att börja med, inget kreditkort; därefter betalning per förfrågan |
| ScraperAPI (Cloud/API) | Proxyrotation, JS-rendering, asynkron crawling, färdiga endpoints | Utvecklare, prisbevakning, SEO-data | Minimal uppsättning | Gratis: 5 000 API-anrop i 7 dagar, därefter 1 000/månad |
| Diffbot Crawlbot (Cloud) | AI-baserad crawling + extraktion, knowledge graph, JS-rendering | Strukturerad data i stor skala, AI/ML | API-integration | Gratis: 10 000 krediter/månad för extraktions-API:erna; Crawl kräver Plus-planen |
| Screaming Frog (Desktop) | SEO-granskning, länkar/meta-analys, sitemap, anpassad extraktion | SEO-granskning, sajtansvariga | Skrivbordsapp, GUI | Gratis: 500 URL:er per crawl, bara kärnfunktioner |
| SiteOne Crawler (Desktop) | SEO, prestanda, tillgänglighet, säkerhet, offline-export, Markdown | Utvecklare, QA, migrering, dokumentation | Skrivbord/CLI, GUI | Gratis och öppen källkod, 1 000 URL:er i GUI-rapporten (kan konfigureras) |
| Crawljax (Java, OpenSrc) | Händelsestyrd crawling för JS-tunga sajter, statisk export | Utvecklare, QA för dynamiska webbappar | Java, CLI/konfiguration | Gratis och öppen källkod, inga begränsningar |
| Apache Nutch (Java, OpenSrc) | Distribuerad, plugin-baserad, Hadoop-integration, egen sökning | Egna sökmotorer, crawling i stor skala | Java, kommandorad | Gratis och öppen källkod, endast infrastrukturkostnad |
| YaCy (Java, OpenSrc) | Peer-to-peer-crawling och sökning, integritet, indexering av webb/intranät | Privat sökning, decentralisering | Java, webbläsargränssnitt | Gratis och öppen källkod, inga begränsningar |
| PowerMapper (Desktop/SaaS) | Visuella sajtkartor, tillgänglighet, QA, webbläsarkompatibilitet | Byråer, QA, visuell kartläggning | GUI, enkelt att använda | Gratis provperiod: 30 dagar, 100 sidor (desktop) eller 10 sidor (online) per skanning |
Ett viktigt förtydligande innan du scrollar vidare: “gratis” betyder väldigt olika saker i den sista kolumnen. SiteOne, Crawljax, Nutch och YaCy är öppen källkod — gratis utan tak, förutom din egen hårdvara. Screaming Frog är gratis för alltid, men begränsad till 500 URL:er per crawl. Bright Data, ScraperAPI och Diffbot har riktiga men små gratisnivåer, och i Diffbots fall täcker gratisplanen inte just crawler-delen. Crawlbase ger dig ett startpaket med gratis förfrågningar och tar sedan betalt per anrop. PowerMapper är det enda rena testabonnemanget på listan — när 30 dagar har gått börjar betalningen.
Bright Data: molnbaserad webbspindel i företagsklass
Bright Data är “storviltet” inom webbspindling. Det är en molnplattform med ett enormt proxy-nätverk, JavaScript-rendering, CAPTCHA-hantering och en IDE för anpassade crawls. Om du kör datainsamling i stor skala — tänk övervakning av hundratals e-handelsbutiker för prisändringar — är Bright Datas infrastruktur svår att slå (aimultiple.com).
Styrkor:
- Klarar svåra sajter med anti-bot-skydd
- Skalar för företagsbehov
- Färdiga mallar för vanliga sajter
Begränsningar:
- Gratisnivån finns på riktigt men är liten: 5 000 poster i månaden i Web Scraper API
- Kan vara överdimensionerat för enkla granskningar
- Viss inlärningskurva för icke-tekniska användare
Om du behöver crawla webben i stor skala är Bright Data som att hyra en Formel 1-bil. De gratis 5 000 posterna per månad räcker för en provtur runt kvarteret; efter det debiteras användningen (Bright Data Pricing).
Crawlbase: API-driven gratis webbspindel för utvecklare
Crawlbase (tidigare ProxyCrawl) handlar om programmatisk crawling. Du skickar en URL till deras API och får tillbaka HTML — medan proxies, geolokalisering och CAPTCHAs hanteras i bakgrunden (Capterra).
Styrkor:
- Hög lyckandefrekvens (99 %+)
- Klarar JavaScript-tunga sajter
- Bra för att integrera i egna appar eller arbetsflöden
Begränsningar:
- Kräver viss API- eller SDK-integration
- Gratisplan: upp till 20 000 förfrågningar för att komma igång (inget kreditkort), sedan betalning per förfrågan
Om du är utvecklare och vill crawla (och kanske skrapa) i stor skala utan att själv hantera proxies är Crawlbase ett stabilt val (Crawlbase Pricing).
ScraperAPI: gör dynamisk webbspindling enklare
ScraperAPI är API:t för dig som vill att någon annan bara ska hämta sidan. Du anger en URL, och tjänsten hanterar proxies, headless-webbläsare och anti-bot-skydd, och ger dig HTML:en (eller strukturerad data för vissa sajter). Den är särskilt bra för dynamiska sidor, även om “gratis” är ganska begränsat: 5 000 API-krediter under de första 7 dagarna, inget kort krävs, och därefter 1 000 krediter i månaden på den löpande gratisplanen (ScraperAPI Pricing).
Styrkor:
- Väldigt enkelt för utvecklare (bara ett API-anrop)
- Hanterar CAPTCHA, IP-blockering och JavaScript
- Gratis: 5 000 API-anrop i 7 dagar, därefter 1 000/månad
Begränsningar:
- Inga visuella crawlrappor
- Du behöver skriva logiken själv om du vill följa länkar
Om du vill få in webbcrawling i din kodbas på några minuter är ScraperAPI ett självklart val.
Diffbot Crawlbot: automatiserad upptäckt av sajtstruktur
Diffbot Crawlbot är där det blir riktigt smart. Den crawlar inte bara — den använder AI för att klassificera sidor och extrahera strukturerad data (artiklar, produkter, evenemang osv.) till JSON. Det är som att ha en robotpraktikant som faktiskt förstår det den läser (Diffbot Free Plan).
Styrkor:
- AI-driven extraktion, inte bara crawling
- Klarar JavaScript och dynamiskt innehåll
- Gratis: 10 000 krediter/månad, inget kreditkort, för Extract, Natural Language, Knowledge Graph och Search
Begränsningar:
- Mer utvecklarorienterat (API-integration)
- Inte ett visuellt SEO-verktyg — mer lämpat för dataprojekt
- Själva Crawlbot-delen — den som spiderar en hel sajt — ligger på Plus-planen och uppåt; gratisnivån täcker extraktions-API:erna (Diffbot Pricing)
Om du behöver strukturerad data i stor skala, särskilt för AI eller analys, är Diffbot en riktig kraftmaskin.
Screaming Frog: gratis desktop-crawler för SEO
Screaming Frog är den klassiska desktop-crawlerspindeln för SEO-granskning. Gratisversionen crawlar upp till 500 URL:er per körning och ger dig allt: trasiga länkar, metataggar, duplicerat innehåll, sajtkartor och mer (Screaming Frog User Guide).
Styrkor:
- Snabb, grundlig och välkänd inom SEO-världen
- Ingen kod behövs — skriv bara in en URL och kör
- Gratis för upp till 500 URL:er per crawl
Begränsningar:
- Endast desktop (ingen molnversion)
- Avancerade funktioner (JS-rendering, schemaläggning) kräver betald licens
Om du menar allvar med SEO är Screaming Frog ett måste — men räkna inte med att den crawlar din 10 000-sidors sajt gratis.
SiteOne Crawler: export av statiska sajter och dokumentation
SiteOne Crawler är den schweiziska armékniven för tekniska granskningar. Den är öppen källkod, plattformsoberoende och kan crawla, granska och till och med exportera din sajt till Markdown för dokumentation eller offline-användning (SiteOne Crawler).
Styrkor:
- Täcker SEO, prestanda, tillgänglighet och säkerhet
- Exporterar sajter för arkivering eller migrering
- Gratis och öppen källkod, utan användningsgränser
Begränsningar:
- Mer tekniskt än vissa GUI-verktyg
- Granskningsrapporten i GUI är som standard begränsad till 1 000 URL:er (kan konfigureras)
Om du är utvecklare, QA eller konsult och vill ha djup insikt (och gillar öppen källkod) är SiteOne en dold pärla.
Crawljax: öppen källkod i Java för dynamiska sidor
Crawljax är en specialist: den är byggd för att crawla moderna webbappar med mycket JavaScript genom att simulera användarinteraktioner (klick, formulärifyllning osv.). Den är händelsestyrd och kan till och med skapa en statisk version av en dynamisk sajt (Wikipedia: Crawljax).
Styrkor:
- Svårslagen för SPA:er och AJAX-tunga sajter
- Öppen källkod och utbyggbar
- Inga användningsgränser
Begränsningar:
- Kräver Java och viss programmering/konfiguration
- Inte för icke-tekniska användare
Om du behöver crawla en React- eller Angular-app som en riktig användare är Crawljax din vän.
Apache Nutch: skalbar distribuerad webbspindel
Apache Nutch är urfadern bland öppna crawlers. Den är byggd för enorma, distribuerade crawls — tänk att bygga din egen sökmotor eller indexera miljontals sidor (Martechvibe).
Styrkor:
- Skalar till miljarder sidor med Hadoop
- Mycket konfigurerbar och utbyggbar
- Gratis och öppen källkod
Begränsningar:
- Brant inlärningskurva (Java, kommandorad, konfiguration)
- Inte för små sajter eller tillfälliga användare
Om du vill crawla webben i stor skala och inte räds lite kommandoradsjobb är Nutch verktyget för dig.
YaCy: peer-to-peer webbspindel och sökmotor
YaCy är en unik, decentraliserad crawler och sökmotor. Varje instans crawlar och indexerar sajter, och du kan gå med i ett peer-to-peer-nätverk för att dela index med andra (TechRadar: YaCy).
Styrkor:
- Integritetsfokuserad, ingen central server
- Bra för privat sökning eller intranätssök
- Gratis och öppen källkod
Begränsningar:
- Resultaten beror på nätverkets täckning
- Kräver viss uppsättning (Java, webbläsargränssnitt)
Om du gillar decentralisering eller vill bygga din egen sökmotor är YaCy ett fascinerande alternativ.
PowerMapper: visuell sajtkarta för UX och QA
PowerMapper handlar om att visualisera webbplatsens struktur. Den crawlar sajten och skapar interaktiva sajtkartor, samtidigt som den kontrollerar tillgänglighet, webbläsarkompatibilitet och grundläggande SEO (Slickplan Review).
Styrkor:
- Visuella sajtkartor passar bra för byråer och designers
- Kontrollerar tillgänglighet och efterlevnad
- Enkelt GUI, inga tekniska kunskaper behövs
Begränsningar:
- Endast gratis provperiod (30 dagar, 100 sidor i desktop/10 sidor online per scan)
- Fullversionen är betald
Om du behöver presentera en sajtkarta för kunder eller kontrollera efterlevnad är PowerMapper ett användbart verktyg.
Välj rätt gratis webbspindel för dina behov
Med så många alternativ, hur väljer man? Här är min snabba guide:
- För SEO-granskning: Screaming Frog (små sajter), PowerMapper (visuell), SiteOne (djupgranskning)
- För dynamiska webbappar: Crawljax
- För storskalig eller anpassad sökning: Apache Nutch, YaCy
- För utvecklare som behöver API-tillgång: Crawlbase, ScraperAPI, Diffbot
- För dokumentation eller arkivering: SiteOne Crawler
- För företagsnivå med liten stående gratisnivå: Bright Data, Diffbot
Viktiga faktorer att tänka på:
- Skalbarhet: Hur stor är din sajt eller crawl-uppgift?
- Användarvänlighet: Är du bekväm med kod, eller vill du klicka dig fram?
- Dataexport: Behöver du CSV, JSON eller integration med andra verktyg?
- Support: Finns det ett community eller hjälpguider om du fastnar?
När webbspindling möter webbskrapning: därför är Thunderbit ett smartare val
Skrapa data från vilken webbplats som helst med AI Thunderbits agenterade webbskrapa läser vilken webbplats du än behöver crawla och extraherar strukturerad data med ett klick — gratis för 6 sidor i månaden. Get Started Free
Så här är verkligheten: de flesta crawlar inte webbplatser bara för att göra snygga kartor. Det verkliga målet är oftast att få ut strukturerad data — vare sig det handlar om produktlistor, kontaktuppgifter eller innehållsinventeringar. Det är där Thunderbit kommer in.
Thunderbit är inte bara en crawler eller en skrapa — det är ett AI-drivet Chrome-tillägg som kombinerar båda. Så här fungerar det:
- AI-crawler: Thunderbit utforskar sajten, precis som en crawler.
- Waterfall Crawling: Om Thunderbits egen motor inte kommer åt sidan (kanske på grund av ett tufft anti-bot-skydd) faller den automatiskt tillbaka på tredjepartstjänster för crawling — utan manuell konfiguration.
- AI-datastrukturering: När HTML:en väl är hämtad föreslår Thunderbits AI rätt kolumner och extraherar strukturerad data (namn, priser, e-post, etc.) utan att du behöver skriva en enda selector.
- Skrapning av undersidor: Behöver du detaljer från varje produktsida? Thunderbit kan automatiskt besöka varje undersida och berika tabellen.
- Datarensning och export: Det kan sammanfatta, kategorisera, översätta och exportera data till Excel, Google Sheets, Airtable eller Notion med ett klick.
- No-code på riktigt: Kan du använda en webbläsare kan du använda Thunderbit. Ingen kod, inga proxies, inga problem.
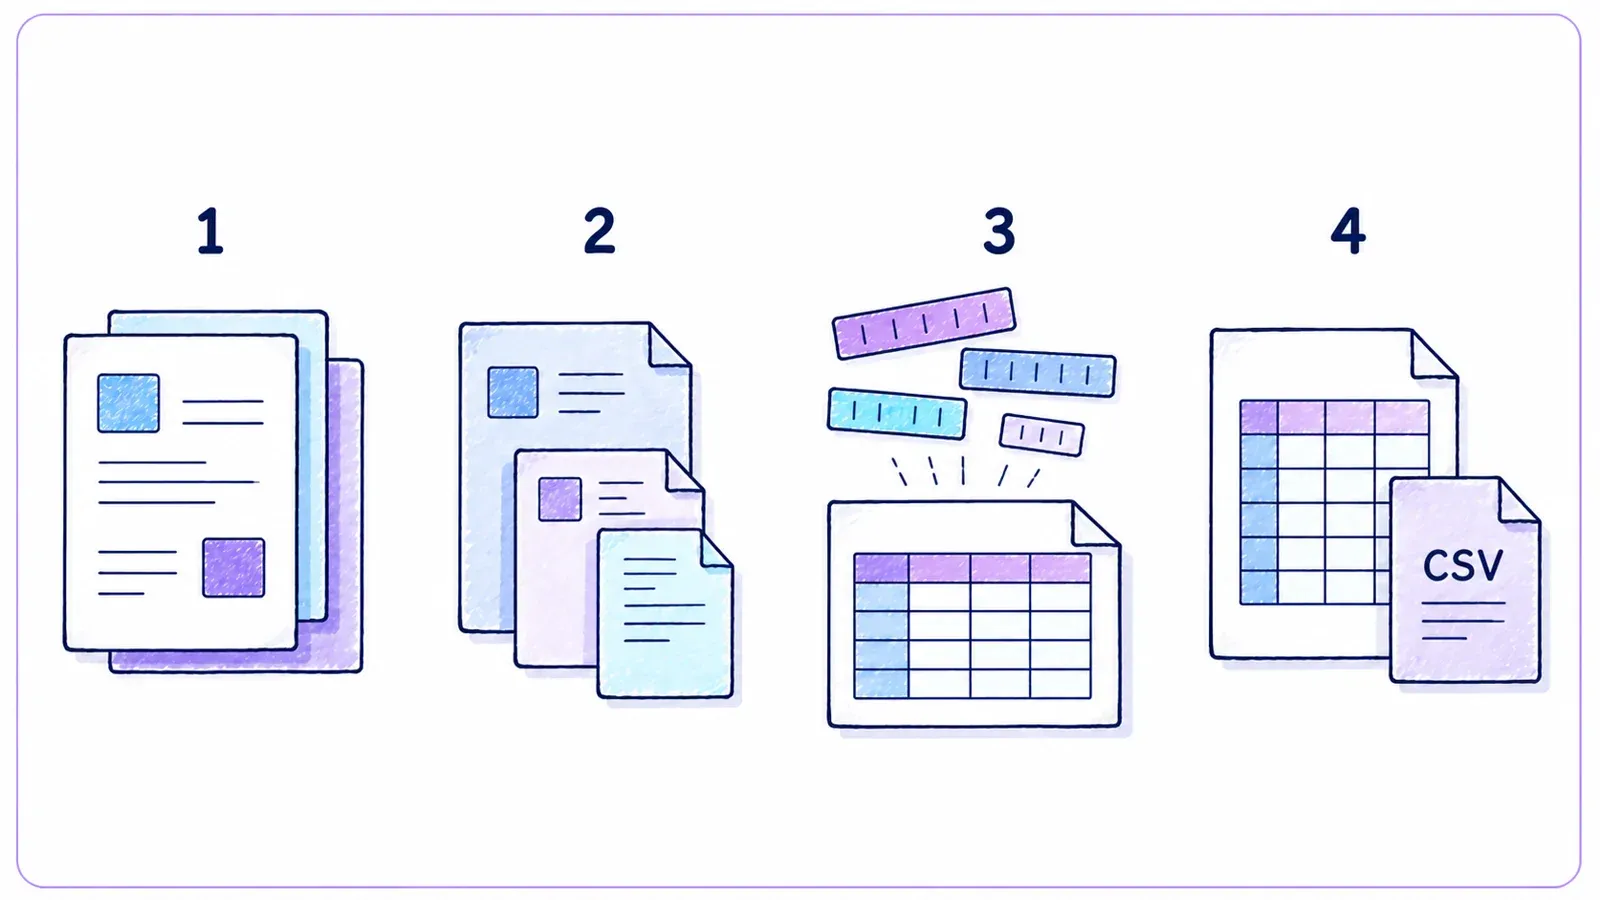
När ska du välja Thunderbit framför en traditionell crawler?
- När slutmålet är ett rent och användbart kalkylblad — inte bara en lista med URL:er.
- När du vill automatisera hela processen (crawl, extrahera, rensa, exportera) på ett ställe.
- När du vill spara tid och slippa huvudvärk.
Du kan ladda ner Thunderbits Chrome-tillägg här och själv se varför så många affärsanvändare byter.
Testa Thunderbit gratis – agenterad webbskrapa Installera det kostnadsfria Chrome-tillägget och börja crawla vilken webbplats som helst med ett klick, utan kod. Get Started Free
Slutsats: få ut mer av gratis webbspindlar
Se hur agenterad webbskrapning fungerar Thunderbits AI läser en sida som en människa och avgör vad som ska extraheras, vilket ersätter manuell crawler-konfiguration. Get Started Free
Webbspindlar har kommit långt. Oavsett om du är marknadsförare, utvecklare eller bara någon som vill hålla sin sajt frisk finns det ett gratisverktyg — eller åtminstone ett som går att testa gratis — för dig. Från företagsplattformar som Bright Data och Diffbot, till open source-favoriter som SiteOne och Crawljax, till visuella kartverktyg som PowerMapper, har alternativen aldrig varit fler.
Men om du letar efter ett smartare och mer integrerat sätt att gå från “jag behöver den här datan” till “här är mitt kalkylblad”, testa Thunderbit. Det är byggt för affärsanvändare som vill ha resultat, inte bara rapporter.
Redo att börja crawla? Ladda ner ett verktyg, kör en skanning och se vad du har missat. Och om du vill gå från crawling till användbar data med ett klick, kolla in Thunderbit.
För fler djupdykningar och praktiska guider, besök Thunderbit Blog.
Skrapa webbplatsdata med AI i ett klick Ställ in Thunderbit att följa undersidor och köra på schema så att din crawl hålls uppdaterad utan att du behöver köra om den manuellt. Get Started Free
Testa agenterad webbskrapa Get Started Free
FAQ
Vad är skillnaden mellan en webbspindel och en webbskrapa?
En spindel hittar och kartlägger alla sidor på en webbplats (tänk: bygger en innehållsförteckning). En skrapa hämtar specifika datafält (som priser, e-postadresser eller recensioner) från de sidorna. Spindlar hittar, skrapor gräver (Thunderbit Blog: What Is a Web Crawler?).
Vilken gratis webbspindel är bäst för icke-tekniska användare?
För små sajter och SEO-granskning är Screaming Frog användarvänligt. För visuell kartläggning är PowerMapper bra under provperioden. Thunderbit är enklast om målet är strukturerad data och du vill ha en no-code-lösning direkt i webbläsaren.
Finns det webbplatser som blockerar webbspindlar?
Ja — vissa sajter använder robots.txt-filer eller anti-bot-skydd, som CAPTCHAs eller IP-blockering, för att stoppa crawlers. Verktyg som ScraperAPI, Crawlbase och Thunderbit (med waterfall crawling) kan ofta ta sig runt detta, men crawla alltid ansvarsfullt och respektera sajtens regler (Bright Data Pricing).
Har gratis webbspindlar begränsningar i antal sidor eller funktioner?
De flesta har det. Till exempel är Screaming Frogs gratisversion begränsad till 500 URL:er per crawl; PowerMappers provperiod gäller 100 sidor. API-baserade verktyg har ofta månatliga kreditgränser. Öppen källkod som SiteOne eller Crawljax har vanligtvis inga hårda gränser, men du begränsas av din egen hårdvara.
Är det lagligt och integritetsmässigt korrekt att använda en webbspindel?
Generellt sett är det lagligt att crawla offentliga webbsidor, men kontrollera alltid sajtens användarvillkor och robots.txt. Crawla aldrig privata eller lösenordsskyddade data utan tillstånd, och tänk på integritetslagar om du extraherar personuppgifter (Crawlbase Guide).



