
Amazon har nästan 2 miljoner säljande partner och hundratals miljoner artiklar i sin katalog. Har du någon gång försökt kopiera produkttitlar, priser, betyg och ASIN-nummer för hand in i ett kalkylblad vet du att smärtan är högst verklig – och att den växer snabbt.
Jag jobbar på Thunderbit, där vi bygger en agentisk webbskrapa, så jag ägnar mycket tid åt att fundera på hur folk får ut data från webbsidor. Men i den här artikeln ville jag göra något som ingen annan jämförelse verkar göra: ställa sju riktiga Chrome-tillägg som du faktiskt kan installera och köra på Amazon bredvid varandra, testa dem på samma sidor och ge dig ett rakt svar om vad som fungerar, vad som inte gör det och var respektive verktyg passar in. Jag bedömde varje tillägg utifrån åtta kriterier som hänger direkt ihop med den frustration jag ser i forum och hos våra egna användare – saker som AI-fältigenkänning, skrapning av undersidor, risk för blockering, gratisnivåer och exportmöjligheter. Oavsett om du är Amazon-säljare, marknadsförare eller bara less på att klippa och klistra är den här guiden för dig.
Prova Thunderbit för Amazon-skrapning Installera Thunderbits Chrome-tillägg och hämta titlar, priser och bilder från Amazon med ett klick – helt utan kod. Get Started Free
Varför skrapa produktdata från Amazon över huvud taget?
Så vilka är det egentligen som skrapar Amazon, och varför?
Det korta svaret är: i stort sett alla som säljer, marknadsför eller researchar produkter på nätet. Amazon uppger att mer än 60 % av försäljningen i butiken kommer från oberoende säljare, och de säljarna håller ständigt koll på varandra. Här är de vanligaste användningsfallen jag ser:
| Användningsfall | Vilka gör det | Vad de får ut |
|---|---|---|
| Prisbevakning av konkurrenter | Säljare, prissättningsteam, byråer | Pris- och lagerdata i realtid för konkurrerande produkter |
| Produktresearch och trendbevakning | Amazon-säljare, marknadsanalytiker | Upptäck växande kategorier, nya aktörer och skiften i efterfrågan |
| Sentimentanalys av recensioner | Private label-säljare, varumärkesteam | Återkommande klagomål, funktionsluckor och möjligheter |
| Leadsgenerering (säljarkontakter) | Grossistteam, byråer | Säljarnamn, butiker och kontaktuppgifter |
| Katalog- och lagerbevakning | E-handelsdrift, varumärkesskydd | Följ lagersaldon, listningsändringar och obehöriga säljare |
| Sökords- och listningsoptimering | Varumärkesägare, marknadsplatsoperatörer | Sökordsdata, listningstexter och konkurrenters sökord |
Avkastningen är påtaglig. Amazons egna fallstudier visar att thefitguys kvartalsförsäljning steg med över 40 % efter att de optimerat för de bästa söktermerna med hjälp av strukturerad data. Och en undersökning från Parseur visade att anställda lägger mer än 9 timmar i veckan på repetitiv datainmatning. Kan du automatisera bara en del av det frigör du rejält med tid för faktiskt beslutsfattande.
Vad kännetecknar ett bra Chrome-tillägg för Amazon-skrapning (mina testkriterier)
Alla Chrome-tillägg är inte skapade lika – och de flesta jämförelseartiklar klumpar ihop API:er, skrivbordsprogram och webbläsartillägg som om de vore utbytbara. Det är de inte. Så här ser ramverket jag använde ut, och varför varje kriterium spelar roll:
- Enkel att komma igång med – Kan en icke-teknisk användare få resultat på under 5 minuter? (Forumtrådarna bekräftar att detta är det som oroar mest.)
- AI-driven fältigenkänning – Hittar verktyget produktfälten automatiskt, eller måste du ställa in selektorer för hand? (Ingen konkurrerande artikel behandlar ens detta som en egen kategori.)
- Skrapning av undersidor/detaljsidor – Kan du berika listningsdata med information från produktsidorna i ett och samma flöde?
- Hantering av anti-bot och blockeringsrisk – Hur hanterar verktyget Amazons aggressiva botdetektering? (Problem nummer ett i användarforumen.)
- Stöd för paginering – Kan det skrapa över flera resultatsidor automatiskt?
- Gratisnivå och prissättning – Vad får du faktiskt utan att betala? (Användare frågar uttryckligen om gratisalternativ, och ingen konkurrent ger ett användbart svar.)
- Exportmöjligheter – CSV, Excel, Google Sheets, Airtable, Notion?
- Schemaläggning och automatisering – Går det att ställa in återkommande körningar?
Jag testade varje tillägg på Amazon US sökresultat och produktsidor, med samma sökningar och samma förutsättningar.
AI-driven kontra selektorbaserad skrapning: varför det spelar roll för Amazon
Det finns en skillnad som ingen annan Amazon-jämförelse tar upp – och den är den enskilt viktigaste faktorn för hur mycket underhåll din skrapa kommer att kräva.
De flesta Chrome-tillägg för skrapning fungerar genom att koppla CSS-selektorer till datafält. Du (eller verktygets mall) pekar ut HTML-elementet för "pris" eller "titel", och skrapan hämtar det som råkar stå där. Problemet? Amazon ändrar sin underliggande HTML och CSS dagligen för att sabotera skrapor. Forumanvändare beskriver hashade eller skiftande klassnamn som ett vanligt sätt att gå sönder på.
Så här står sig de tre huvudsakliga angreppssätten mot varandra:
| Angreppssätt | Så fungerar det | När Amazon ändrar layouten |
|---|---|---|
| Selektorbaserat (traditionellt) | Användaren kopplar CSS-selektorer till fält för hand | Går sönder – användaren måste ställa om allt |
| Mallbaserat | Färdiga recept för Amazon-sidor | Går sönder tills utvecklaren uppdaterar mallen |
| AI-drivet (t.ex. Thunderbit) | AI:n läser sidans innehåll och hittar fälten själv | Anpassar sig automatiskt – inget underhåll |
Bara ett av de sju tillägg jag testade – Thunderbit – använder AI-fältigenkänning som standardväg. Resten bygger på selektorer eller mallar, vilket betyder mer pyssel varje gång Amazon oundvikligen justerar sina sidor. Att förstå den här skillnaden kommer att bespara dig en hel del huvudvärk längre fram.
1. Thunderbit – det AI-drivna Chrome-tillägget för Amazon-skrapning
Thunderbit är verktyget vi byggt på mitt eget företag, så det säger jag rakt ut. Men jag tycker också uppriktigt att det passar bäst för icke-tekniska användare som vill ha snabb och korrekt Amazon-data utan att brottas med selektorer eller kod.
Den stora skillnaden heter One Click Extract. När du öppnar en sökresultatsida på Amazon och klickar på knappen läser Thunderbits AI av sidan och hämtar de kolumner som betyder något – titel, pris, betyg, ASIN, antal recensioner, produkt-URL och mer därtill. Du konfigurerar ingenting. AI:n listar ut vad som finns på sidan och avgör vilka fält och datatyper som är rätt.
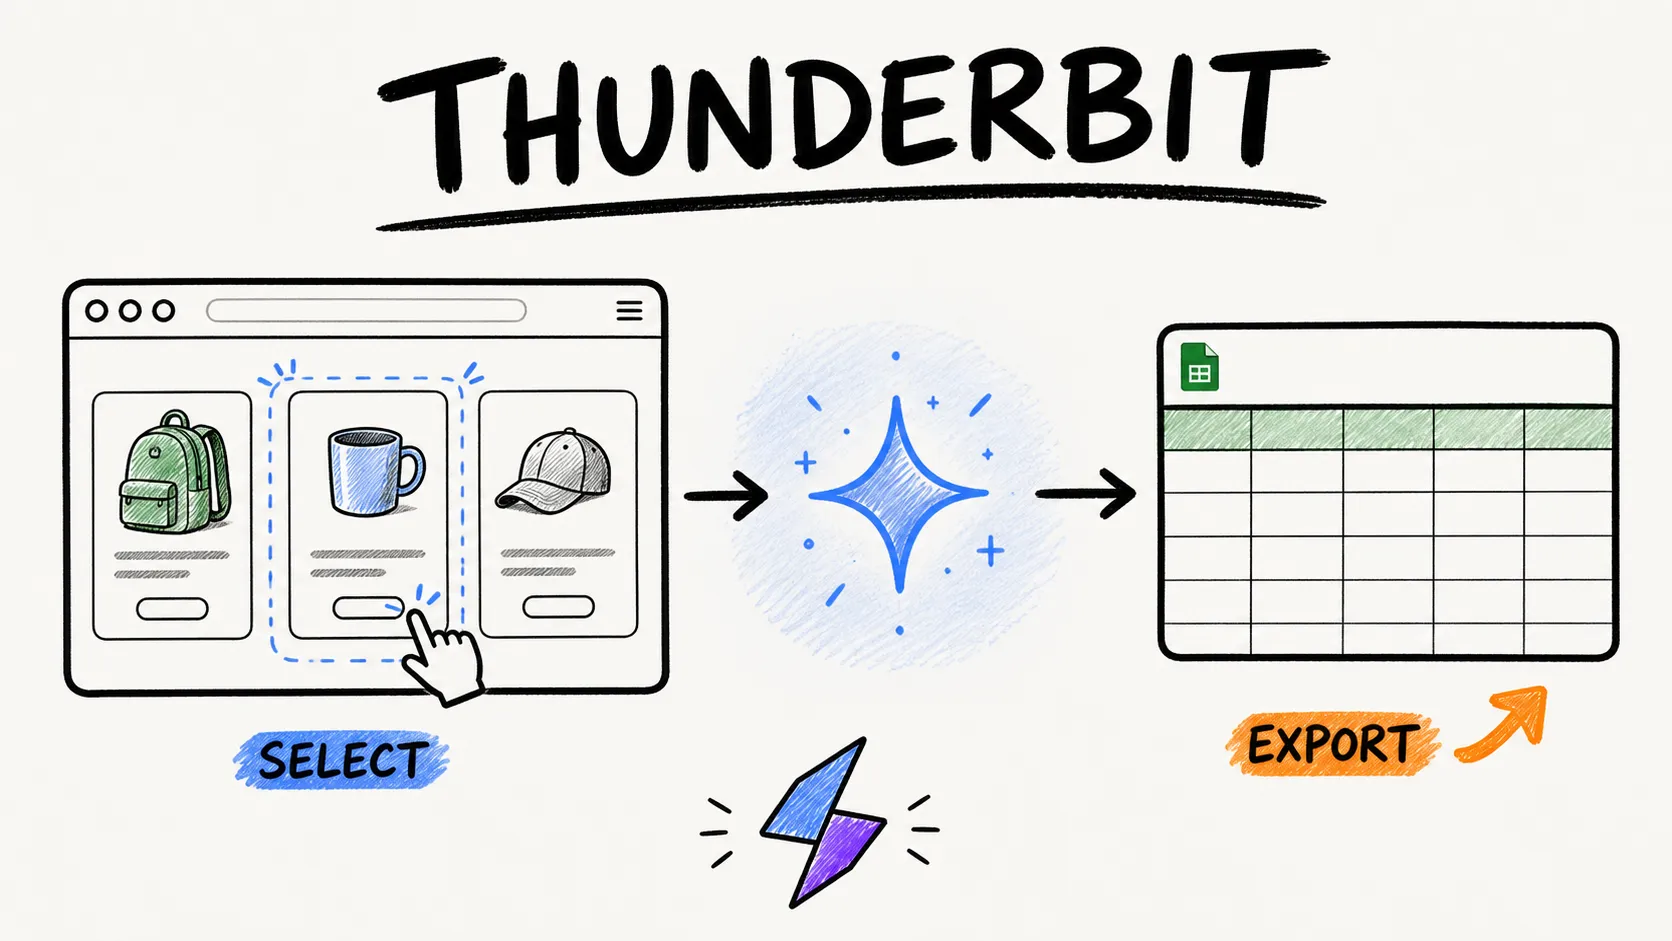
Så här ser en typisk skrapsession på Amazon ut:
- Installera Thunderbits Chrome-tillägg och öppna en sökresultatsida på Amazon.
- Klicka på One Click Extract – AI:n läser sidan, listar ut strukturen och fyller i datan direkt.
- För populära Amazon-sidor kan du också utgå från den färdiga Amazon Scraper-mallen, som redan är inställd för den sidtypen.
Det som verkligen skiljer Thunderbit från mängden är skrapning av undersidor. När du skrapat listningssidan klickar du på Scrape Subpages – Thunderbit besöker varje produkt-URL och lägger till detaljfält (fullständiga beskrivningar, punktlistor, säljarinfo, bild-URL:er) i samma tabell. De flesta konkurrerande tillägg erbjuder helt enkelt inte det här.
Det finns också en växel mellan moln och webbläsare. Molnläget skrapar upp till 50 sidor samtidigt för offentliga listningar. Webbläsarläget använder din egen Chrome-session – perfekt när du är inloggad i Seller Central eller vill hålla en låg profil.
Schemaläggningen sker på vanlig svenska: beskriv tidsintervallet, så omvandlar AI:n det till ett schema.
Exportmöjligheterna omfattar Excel, Google Sheets, Airtable, Notion, CSV och JSON – allt ingår i gratisnivån.
Fördelar och nackdelar med Thunderbit
Fördelar:
- AI hittar fälten automatiskt – ingen selektoruppsättning, inget underhåll när Amazon ändrar layouten
- Berikning av undersidor med ett klick
- Växel mellan moln och webbläsare för flexibilitet och lägre blockeringsrisk
- Bredast exportmöjligheter (Sheets, Airtable, Notion, Excel, CSV, JSON)
- Schemaläggning med naturligt språk
- Färdig Amazon-mall för resultat direkt
Nackdelar:
- Kreditbaserat system innebär att storanvändare behöver ett betalabonnemang
- AI-fältigenkänningen lägger till ett kort bearbetningssteg (några sekunder)
- Nyare verktyg, alltså mindre community-dokumentation än äldre alternativ
Thunderbits priser
- Gratisnivå: 6 sidor (10 med testboost), inklusive AI-funktioner och alla exportformat
- Betalabonnemang: Från cirka 9 USD/månad (årsvis) för 500 krediter; 1 kredit = 1 rad i resultatet
- Se Thunderbits prissida för de senaste detaljerna
Skrapa Amazon-sidor med AI Thunderbits agentiska webbskrapa läser själv av Amazons produktsidor och avgör vilka fält som ska hämtas, ett klick i taget. Get Started Free
2. Instant Data Scraper – det gratis och avskalade alternativet
Instant Data Scraper är ett Chrome-tillägg som med hjälp av heuristiska algoritmer hittar tabelldata på webbsidor automatiskt. Det har funnits i många år och är fortfarande en av de mest nedladdade gratisskraporna i Chrome Web Store.
På Amazon aktiverar du tillägget på en sökresultatsida, varpå det försöker hitta datatabellen på egen hand. Ibland behöver du klicka på "try another table" om första försöket missar målet. För enkla engångsskrapningar fungerar det hyfsat bra.
Det finns dock en viktig reservation för 2026: den officiella landningssidan uppger nu att Instant Data Scraper varken ägs, utvecklas eller stöds av Web Robots längre. Det betyder inga uppdateringar, inga buggfixar och inga nya funktioner. I en Reddit-tråd berättade en användare att det klarade översiktssidor men körde fast när det krävdes klick ner på detaljnivå.
Fördelar och nackdelar med Instant Data Scraper
Fördelar:
- 100 % gratis, inget konto krävs
- Lättviktigt och snabbt för enkla tabeller
- Stöder grundläggande paginering (klickar på "Nästa"-knappen)
Nackdelar:
- Ingen AI-fältigenkänning (bygger på mönstermatchning, som kan läsa Amazons komplexa layout fel)
- Ingen skrapning av undersidor
- Endast export till CSV/Excel
- Ingen schemaläggning, inget molnalternativ
- Underhålls inte längre – går sönder när Amazon ändrar layouten, och ingen fixar det
3. Web Scraper – veterantillägget för manuell konfiguration
Web Scraper är ett av de mest etablerade Chrome-tilläggen för skrapning och bygger på en visuell sitemap-byggare. Du öppnar DevTools, skapar en "sitemap" genom att peka och klicka för att definiera selektorer, ställer in paginering och kan följa länkar vidare till produktsidorna.
Web Scraper erbjuder också en mall för Amazon Products Listings Scraper i sin marknadsplats, som hanterar navigering, paginering och extrahering från produktsidor. Deras steg-för-steg-guide går igenom en uppsättning i 8 steg – installera, generera selektorer, ställa in paginering, följa produktlänkar och köra lokalt eller i molnet.
Molnversionen lägger till schemaläggning, API-åtkomst, proxyrotation, CAPTCHA-kringgående och integration med Google Sheets.
Fördelar och nackdelar med Web Scraper
Fördelar:
- Moget, väldokumenterat och med stöd från en aktiv community
- Gratis webbläsartillägg (obegränsad lokal användning)
- Marknadsplatsmallar för Amazon
- Molnalternativ för att skala upp (schemaläggning, IP-rotation, integrationer)
- Stöder att följa länkar till produktsidor (delvis berikning av undersidor)
Nackdelar:
- Kräver manuell uppsättning av selektorer – brantare inlärningskurva för icke-tekniska användare
- Ingen automatisk AI-igenkänning av fält
- Mallar kan gå sönder när Amazon uppdaterar layouten
- Avancerade funktioner ligger bakom betalda molnabonnemang
Web Scrapers priser
- Gratis: Chrome-tillägget, obegränsad lokal skrapning
- Molnabonnemang: Från 50 USD/månad (Project), 100 USD/månad (Professional), från 200 USD/månad (Scale)
4. Octoparse – den funktionsrika plattformen (med ett förbehåll kring Chrome-tillägget)
Octoparse är en kraftfull no-code-plattform för skrapning med färdiga Amazon-mallar för produktdetaljer, sökordssökningar och recensioner. Den stöder molnskrapning, schemaläggning och arbetsflöden i flera steg.
En viktig nyans, dock: Octoparses tillägg i Chrome Web Store heter för närvarande Octoparse AI Web Automation, och där står det uttryckligen att det bara fungerar tillsammans med Octoparse AI Bot på Windows. Den verkliga skrapupplevelsen är alltså plattformsdriven, inte tilläggsdriven. Letar du efter ett renodlat "installera och skrapa i Chrome"-flöde är Octoparse snarare ett skrivbordsprogram med en webbläsarhjälpreda.
Med det sagt är mallarna utmärkta. Du matar in en sök-URL, Octoparse extraherar produktdatan automatiskt, och du kan bygga egna arbetsflöden med peka-och-klicka-selektorer, paginering och länkföljning till detaljsidor.
Fördelar och nackdelar med Octoparse
Fördelar:
- Gedigen funktionsuppsättning med Amazon-mallar
- Molnnoder för fart, schemaläggning och extrahering från undersidor via arbetsflöden
- Hanterar paginering bra
- Bra för komplexa skrappipelines i flera steg
Nackdelar:
- Full kraft kräver skrivbordsappen – ingen renodlad Chrome-tilläggsupplevelse
- Ingen AI som föreslår fält automatiskt (det finns en separat produkt, Chat4Data, men det är ett annat tillägg)
- Gratisplanen har tak på cirka 50 000 dataexporter/månad och 10 000 rader per export
- Gränssnittet kan kännas komplext för nybörjare
Octoparses priser
- Gratis: Begränsad (lokal extrahering, exporttak på 50 000)
- Standard: cirka 75–83 USD/månad
- Professional: cirka 208–249 USD/månad
- Tillägg: IP-rotation för 3 USD/GB, CAPTCHA-lösning för 2–2,50 USD per 1 000
5. Axiom.ai – no-code-byggaren för botar
Axiom.ai är ett Chrome-tillägg för att bygga botar för webbläsarautomatisering med en visuell no-code-byggare. Det är mer ett allmänt automatiseringsverktyg än en renodlad skrapa, men det har mallar för Amazon-skrapning och guider för ASIN-extrahering.
Du skapar en bot (eller hämtar en mall) som loopar igenom produkt-URL:er i ett Google Sheet, besöker varje sida, extraherar data via peka-och-klicka-selektorer och skriver tillbaka resultaten till kalkylbladet. Schemaläggning ingår i betalabonnemangen, och molnkörningar erbjuds numera med 1 bot i molnet på Starter och Pro, upp till 20 samtidiga molnbotar på Ultimate.
Fördelar och nackdelar med Axiom.ai
Fördelar:
- Mångsidig no-code-automatisering (inte bara skrapning)
- Inbyggd integration med Google Sheets
- Schemaläggning och molnkörningar i betalabonnemangen
- Mallar för Amazon
- Bra för arbetsflöden i flera steg utöver ren dataextrahering
Nackdelar:
- Tyngre uppsättning för en enkel skrapning (kräver botdesign, konfiguration av Google Sheet och testkörning av loopen)
- Ingen AI-fältigenkänning
- Ingen berikning av undersidor med ett klick (du måste bygga ett separat botsteg)
- Export begränsad till Google Sheets eller CSV
Axiom.ai:s priser
- Gratis: 2 timmars körtid
- Starter: 15 USD/månad
- Pro: 50 USD/månad
- Pro Max: 150 USD/månad
- Ultimate: 250 USD/månad
6. Data Miner – tillägget som drivs av recept
Data Miner är ett Chrome-tillägg inriktat på att extrahera data med hjälp av "recept" – fördefinierade eller egna skrapmallar. Du söker efter ett befintligt Amazon-recept i det publika biblioteket eller skapar ett eget genom att markera element på sidan.
Data Miner stöder paginering via funktionen Next Page Automation, och det erbjuder faktiskt ett Crawl Scrape-flöde för att besöka detalj-URL:er och köra ett andra recept på dem. Så det stämmer inte att det saknar skrapning av undersidor – men det är en manuell process i flera steg snarare än berikning med ett klick.
Den stora begränsningen är gratisnivån: 500 sidor/månad, och vissa domäner är spärrade i gratisversionen. Recepten är webbplatsspecifika, och Data Miners egen dokumentation varnar för att receptet slutar fungera om sajten ändras och den underliggande HTML-koden ändras.
Fördelar och nackdelar med Data Miner
Fördelar:
- Enkelt att köra ett färdigt recept
- Receptbibliotek från communityn
- Stöder paginering och genomsökning av detaljsidor (manuell uppsättning)
- Enkelt gränssnitt
Nackdelar:
- Gratisnivån är begränsad till 500 sidor/månad
- Ingen AI-fältigenkänning
- Recepten går sönder när Amazon ändrar layouten
- Ingen molnskrapning, ingen schemaläggning enligt den publika dokumentationen
- Export: CSV, Excel, urklipp; Google Sheets i betalabonnemangen
Data Miners priser
- Gratis: 500 sidor/månad
- Betalt: 19,99, 49, 99 och 200 USD/månad med stigande gränser och funktioner
7. Helium 10 – analyssviten för Amazon-säljare
Helium 10 är en heltäckande verktygslåda för Amazon-säljare, inte en allmän webbskrapa. Dess Chrome-tillägg (Xray) lägger data direkt ovanpå Amazons sökresultat – med uppskattad försäljning, intäkter, recensionstrender, BSR och mer. Det är byggt för Amazon-säljare som gör produktresearch, inte för att extrahera rådata från sidor.
Helium 10 har faktiskt en gratisplan 2026, även om åtkomsten till Chrome-tillägget är begränsad där. Tillägget kan exportera resultat till CSV eller Excel och stöder arbetsflöden via urklipp.
Fördelar och nackdelar med Helium 10
Fördelar:
- Djupa Amazon-specifika insikter (försäljningsuppskattningar, sökordsdata, BSR-trender)
- Anlitas av professionella säljare
- Molnbaserad data och schemaläggning för sökords- och rankningsbevakning
- Gratisplan finns (begränsad)
Nackdelar:
- Ingen allmän skrapa – kan inte extrahera egna datafält från godtyckliga sidor
- Dyrt jämfört med verktyg inriktade på skrapning
- Begränsade exportformat (CSV, Excel)
- Ingen AI-fältigenkänning, ingen berikning av undersidor i skrapningsmening
Helium 10:s priser
- Gratis: Begränsad åtkomst, inklusive Chrome-tillägget
- Starter: 49 USD/månad
- Platinum: 229 USD/månad
- Diamond: 359 USD/månad
Chrome-tillägg för Amazon-skrapning jämförda: hela tabellen sida vid sida
Här är den ärliga jämförelsetabellen. Jag har korrigerat ett par antaganden från tidigare utkast efter praktiska tester och verifiering under 2026:
| Funktion | Thunderbit | Instant Data Scraper | Web Scraper | Octoparse | Axiom.ai | Data Miner | Helium 10 |
|---|---|---|---|---|---|---|---|
| Huvudkategori | AI-skrapa som tillägg | Gratis heuristisk skrapa | Selektor-/mallskrapa | No-code-plattform för skrapning | Byggare av webbläsarbotar | Receptbaserat skraptillägg | Överlägg för säljarresearch |
| AI föreslår fält automatiskt | Ja | Nej | Nej | Nej (separat Chat4Data) | Nej | Nej | Nej |
| Berikning av undersidor | Ja (1 klick) | Nej | Ja (manuell sitemap) | Ja (arbetsflöde) | Ja (manuellt botsteg) | Ja (manuell crawl) | Ej tillämpligt |
| Molnskrapning | Ja | Nej | Ja (betalt) | Ja (betalt) | Ja (betalt) | Nej | Molnbaserad analys |
| Schemaläggning | Ja | Nej | Ja (betalt) | Ja (betalt) | Ja (betalt) | Nej | Ja (sökords-/rankningsbevakning) |
| Gratisnivå | Ja (6–10 sidor) | Ja (helt gratis) | Ja (endast webbläsare) | Ja (begränsad) | Ja (2 tim körtid) | Ja (500 sidor/mån) | Ja (begränsad) |
| Färdig Amazon-mall | Ja | Nej | Ja | Ja | Ja (guider) | Receptbibliotek | Ej tillämpligt |
| Export till Sheets/Airtable/Notion | Ja (alla) | Endast CSV/Excel | CSV, Excel, JSON; Sheets via molnet | CSV, Excel, JSON, fler | Google Sheets, CSV | CSV, Excel; Sheets i betalversion | CSV, Excel |
Ett par saker sticker ut. Thunderbit är det enda tillägget med AI-fältigenkänning och de bredaste exportmöjligheterna redan på gratisnivån. Instant Data Scraper är det enklaste gratisalternativet, men det underhålls inte längre. Web Scraper och Octoparse är kraftfulla för den som är beredd att lägga tid på uppsättningen, men ingen av dem är en renodlad "installera och kör"-tilläggsupplevelse. Axiom.ai passar bäst för automatisering i flera steg utöver skrapning. Data Miner är enkelt när man kör befintliga recept, men gratisnivån är snål. Helium 10 är ett analysverktyg för säljare, inte en allmän skrapa.
Moln kontra webbläsare vid Amazon-skrapning: vad du behöver veta om blockeringsrisken
Det här är elefanten i rummet. Amazon upptäcker och blockerar aktivt automatiserad skrapning. Användare på Reddit rapporterar att CAPTCHA:er dyker upp även för den som skrapar i liten skala, och Amazons egna användarvillkor säger uttryckligen att licensen inte omfattar "any use of data mining, robots, or similar data gathering and extraction tools".
Så vad är den praktiska skillnaden mellan skrapning i webbläsaren och i molnet?
- Skrapning i webbläsaren körs i din egen Chrome-session – riktiga cookies, inloggat läge, naturligt surfbeteende. Det ser mer mänskligt ut vid låga volymer men beslagtar din webbläsare.
- Molnskrapning använder fjärrservrar för fart (Thunderbit klarar 50 sidor åt gången i molnläge), men kräver hastighetsbegränsning och proxyrotation för att undvika upptäckt.
Här är beslutsmatrisen jag själv använder:
| Scenario | Rekommenderat läge | Varför |
|---|---|---|
| Skrapa 20 produktsidor för research | Webbläsare | Låg volym, naturligt beteende |
| Bevaka 500 konkurrent-SKU:er varje vecka | Moln | Farten är avgörande, offentlig data |
| Skrapa medan du är inloggad i Seller Central | Webbläsare | Kräver din inloggningssession |
| Engångsexport av en hel kategori | Moln | Parallell skrapning för farten |
Av de sju tilläggen finns molnskrapning i Thunderbit, Web Scraper (betalt), Octoparse (betalt), Axiom.ai (betalt) och Helium 10 (för analysdelen). Instant Data Scraper och Data Miner körs bara i webbläsaren.
Praktiska tips för att minska blockeringsrisken: Håll rimliga intervall mellan anropen, undvik att skrapa under högtrafiktimmar och rotera user agents om ditt verktyg stöder det. Och lova dig aldrig själv "noll risk" – hantera den i stället.
Från listningssida till produktsida: så fungerar skrapning av undersidor på Amazon
Det här arbetsflödet är underskattat – och ingen konkurrerande artikel visar det från början till slut.
När du skrapar en sökresultatsida på Amazon får du översiktsdata: produkttitlar, priser, betyg, ASIN-nummer och produkt-URL:er. Men ofta behöver du data från detaljsidorna också – fullständiga beskrivningar, punktlistor, bild-URL:er, säljarinfo, fördelning av recensioner. Det är där skrapning av undersidor kommer in.
Med Thunderbit ser flödet ut så här:
- Skrapa Amazons sökresultatsida -> du får en tabell med produkter (titel, pris, betyg, ASIN, produkt-URL).
- Klicka på "Scrape Subpages" -> Thunderbit besöker varje produkt-URL och lägger till detaljfält (beskrivning, antal recensioner, säljarnamn, bild-URL:er och så vidare) i samma tabell.
- Exportera den berikade tabellen till Google Sheets, Airtable, Notion eller Excel.
AI:n känner av undersidornas struktur och berikar tabellen automatiskt – ingen manuell konfiguration. Min erfarenhet är att det sparar minst en timme per omgång jämfört med att öppna varje produktsida och kopiera fälten för hand.
Andra verktyg klarar det här också, men med mer jobb:
- Web Scraper: Du ställer in en sitemap som följer produktlänkarna och definierar selektorer för varje detaljfält. Det fungerar, men det är en manuell process i flera steg.
- Octoparse: Du bygger ett arbetsflöde med steg som följer länkar. Kraftfullt, men långt ifrån ett klick.
- Axiom.ai: Du designar en botloop som besöker varje URL och extraherar data. Flexibelt, men kräver att du kan bygga botar.
- Data Miner: Du använder funktionen Crawl Scrape för att besöka sparade URL:er och köra ett andra recept. Manuellt och beroende av recepten.
- Instant Data Scraper och Helium 10: Inget flöde för berikning av undersidor.
Behöver du regelbundet både data på listningsnivå och detaljnivå från Amazon bör verktyget du väljer göra det här flödet enkelt – inte bara möjligt.
Den ärliga genomgången av gratisnivåerna: vad du faktiskt får utan att betala
Det här frågar forumanvändare om oftare än något annat, och ingen konkurrerande artikel svarar transparent på det.
| Tillägg | Gratisnivå | Vad du får gratis | När du behöver uppgradera |
|---|---|---|---|
| Thunderbit | Ja (6 sidor, 10 med testperiod) | One Click Extract, alla exportformat (Excel, Sheets, Airtable, Notion), extraktorer för e-post/telefon | Behov av fler sidor eller schemalagd skrapning |
| Instant Data Scraper | Ja (helt gratis) | Grundläggande tabelligenkänning, export till CSV/Excel | Ej tillämpligt (ingen betalnivå, men inga uppdateringar heller) |
| Web Scraper | Ja (endast webbläsare) | Skrapning i webbläsaren, CSV-export | Molnskrapning, schemaläggning, integrationer |
| Octoparse | Ja (begränsad) | Cirka 50 000 exporter/månad, lokal extrahering | Fler poster, molnnoder |
| Axiom.ai | Ja (2 tim körtid) | Grundläggande automatiseringar, Google Sheets | Fler körningar, schemaläggning, moln |
| Data Miner | Ja (500 sidor/mån) | Recept, CSV/Excel, Next Page Automation | Fler sidor, Sheets, crawl-funktioner |
| Helium 10 | Ja (begränsad) | Begränsad åtkomst till Chrome-tillägget | Fullt Xray, sökordsverktyg, schemaläggning |
Den viktigaste insikten: Thunderbits gratisnivå omfattar AI-funktioner och samtliga exportformat – de flesta konkurrenter låser avancerad export eller AI bakom betalabonnemang. Instant Data Scraper är helt gratis men saknar AI, undersidor och schemaläggning (och underhålls inte längre). Helium 10 har faktiskt en gratisplan, men åtkomsten till tillägget är begränsad och det är ingen allmän skrapa.
Min rekommendation efter scenario:
- "Vill bara känna på det" -> Instant Data Scraper (helt gratis) eller Thunderbits gratisnivå
- "Behöver regelbunden, pålitlig skrapning" -> Thunderbit eller Web Scrapers betalabonnemang
- "Amazon-säljare som behöver marknadsinsikter" -> Helium 10
Vilket Chrome-tillägg för Amazon-skrapning ska du välja?
Efter att ha testat alla sju är min ärliga bedömning den här:
- Bäst för icke-tekniska användare som vill ha snabba, AI-drivna resultat: Thunderbit. AI hittar fälten automatiskt, berikning av undersidor med ett klick, bredast exportmöjligheter, växel mellan moln och webbläsare. Vill du gå från Amazon-sida till kalkylblad på under två minuter är det här valet.
- Bästa helt gratis alternativet för snabba engångsskrapningar: Instant Data Scraper. Kostar inget, kräver inget konto, men har begränsade funktioner och underhålls inte längre.
- Bäst för dig som är bekväm med manuell konfiguration: Web Scraper. Flexibel sitemap-byggare, bra molnalternativ, väldokumenterat.
- Bäst för komplexa skrappipelines i flera steg: Octoparse (skrivbord + tillägg) eller Axiom.ai (webbläsarbotar). Båda är kraftfulla, men ingen av dem är ett renodlat "installera och kör"-Chrome-tillägg.
- Bäst för enkel receptbaserad extrahering: Data Miner. Lätt att köra befintliga recept, men snål gratisnivå och ingen AI.
- Bäst för säljarinsikter på Amazon (inte allmän skrapning): Helium 10. Specialbyggt, med djup egen data, men dyrt och ingen allmän skrapa.
Vill du se hur AI-driven Amazon-skrapning faktiskt ser ut, testa Thunderbits gratisnivå. Jag tror att du blir överraskad över hur mycket du hinner med på ett enda klick. Och om Thunderbit inte visar sig passa perfekt, prova ett par av de andra i listan – det har aldrig funnits ett bättre läge att sluta klippa och klistra och börja skrapa smartare.
Vill du ha fler tips om Amazon-skrapning kan du läsa våra guider om hur du skrapar produkter och recensioner från Amazon, att skrapa priser på Amazon och att extrahera och analysera försäljningsdata från Amazon. Du kan också se instruktionsvideor på Thunderbits YouTube-kanal.
Prova AI-driven Amazon-skrapning med Thunderbit Get Started Free
Vanliga frågor
1. Är det lagligt att skrapa produktdata från Amazon?
Att skrapa offentligt synlig data är i allmänhet tillåtet, men Amazons användarvillkor förbjuder uttryckligen datautvinning och automatiserad extrahering utan skriftligt medgivande. Den här artikeln utgör inte juridisk rådgivning – gå alltid igenom Amazons villkor innan du skrapar i stor skala.
2. Kan Amazon upptäcka och blockera skrapor som körs som Chrome-tillägg?
Ja. Amazon har anti-botsystem som kan utlösa CAPTCHA:er, strypa anrop eller blockera IP-adresser. Rimlig anropsfrekvens, webbläsarbaserad skrapning för mindre jobb och molnskrapning med hastighetsbegränsning för större jobb minskar risken. Se avsnittet om moln kontra webbläsare ovan för en praktisk beslutsmatris.
3. Vilken data kan man skrapa från Amazon med ett Chrome-tillägg?
Vanliga fält är produkttitlar, priser, betyg, antal recensioner, ASIN-nummer, säljarnamn, beskrivningar, bild-URL:er, lagerstatus och fraktinformation. AI-drivna verktyg som Thunderbit kan hitta och föreslå de här fälten automatiskt, utan manuell uppsättning.
4. Behöver jag kunna koda för att använda ett Chrome-tillägg för Amazon-skrapning?
Nej – alla sju testade verktyg är gjorda för icke-tekniska användare. Vissa kräver mer uppsättning (Web Scraper, Octoparse, Axiom.ai) medan andra är i princip konfigurationsfria (Thunderbit, Instant Data Scraper). Avvägningen handlar oftast om flexibilitet kontra användarvänlighet.
5. Vilket Chrome-tillägg för Amazon-skrapning har bäst gratisnivå?
Thunderbits gratisnivå omfattar AI-fältigenkänning och samtliga exportformat (Sheets, Airtable, Notion, Excel, CSV, JSON), vilket de flesta konkurrenter låser bakom betalabonnemang. Instant Data Scraper är helt gratis men saknar AI, undersidor och schemaläggning. Data Miner erbjuder 500 gratissidor per månad. Helium 10:s gratisplan är begränsad och inriktad på säljarresearch, inte allmän skrapning.
Läs mer




