Wikipedia Scraper per Infobox, Citazioni e Sezioni













Organizza gli articoli di Wikipedia per la ricerca
Tieni separati i fatti dell’articolo, i valori dell’infobox, le citazioni e il contesto delle sezioni.
Estrai i dati di Wikipedia in un clic
Suggerisce le colonne per la pagina aperta e completa la raccolta in un’unica esecuzione. Se vuoi, puoi modificare o rinominare i campi in linguaggio naturale e rilanciare.
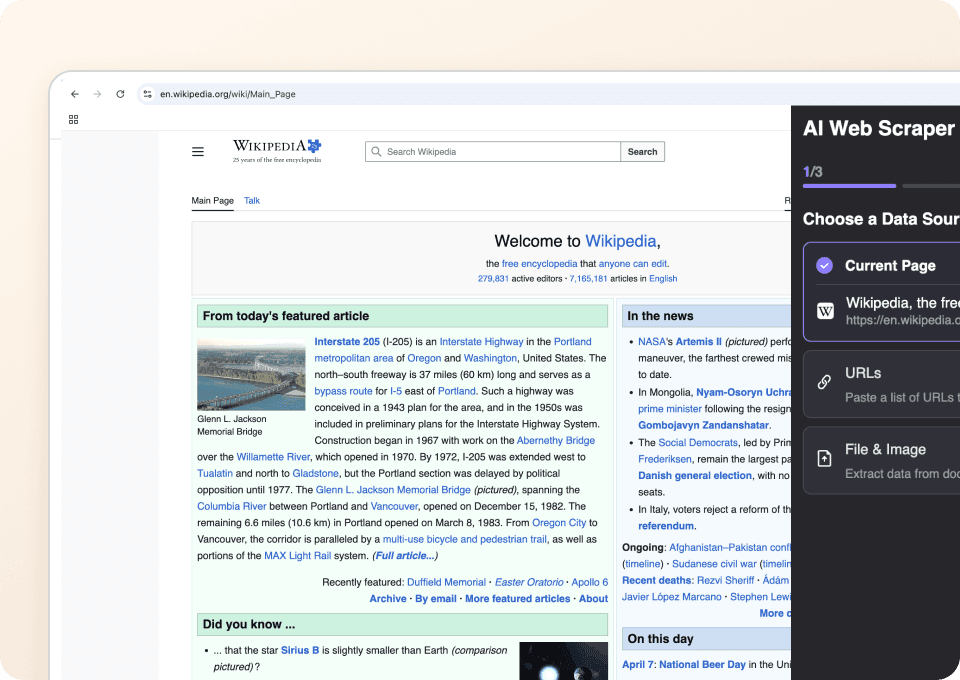
Funziona su diversi tipi di pagine Wikipedia
L’agente legge etichette visibili, intestazioni e titoli delle sezioni per mappare i valori nella pagina a cui puoi accedere. Se un campo non è presente, la colonna resta vuota.
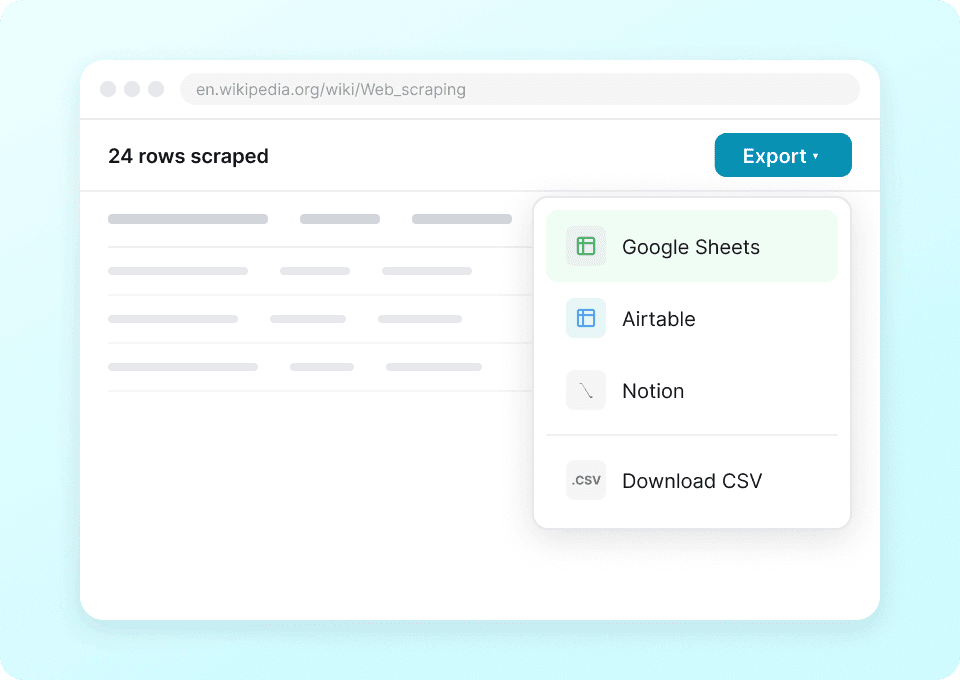
Esporta i dati di Wikipedia direttamente
Continua la ricerca in Google Sheets, Excel, Airtable, Notion oppure scarica un CSV.
Raccogli dati di ricerca da Wikipedia senza creare uno scraper
Riduci la manutenzione dei selettori per la ricerca su Wikipedia.
Configurazione manuale o basata su selettori
Tempo speso a mantenere le regoleAgente AI di Thunderbit
Suggerimenti sui campi e una sola esecuzioneColonne per fatti dell’articolo, infobox, citazioni e sezioni
Le colonne compaiono solo quando sono presenti nella pagina a cui puoi accedere.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.




Domande sulle raccolte di ricerca su Wikipedia
Risposte rapide per Agent Mode su Wikipedia.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Estrattore Flixster
L'Estrattore Flixster di Thunderbit ti permette di raccogliere dati dalle classifiche box office e dai cinema nelle vicinanze su Flixster. Grazie ai suggerimenti AI per i campi, puoi velocemente ottenere titoli dei film, incassi, valutazioni, date di uscita, nomi dei cinema, indirizzi e film disponibili per analisi o ricerche.
Scopri di più ->
Estrattore olympustaff.com
L’Estrattore Web olympustaff.com di Thunderbit ti permette di raccogliere dati da elenchi di fumetti e commenti su olympustaff.com. Grazie ai suggerimenti intelligenti basati su AI, puoi estrarre rapidamente titoli, autori, date di pubblicazione e feedback dei lettori per analisi o ricerche. Perfetto per marketer, ricercatori e content creator che desiderano dati strutturati da olympustaff.com.
Scopri di più ->
Estrattore Hatena
L'Estrattore Hatena di Thunderbit ti permette di raccogliere dati da blog e liste di argomenti su Hatena grazie ai suggerimenti intelligenti dei campi basati su AI. Puoi ottenere titoli dei blog, nomi degli autori, date di pubblicazione, riassunti dei contenuti e argomenti di tendenza, utili per ricerche, marketing o analisi dei contenuti. Perfetto per marketer, ricercatori e content creator che desiderano dati strutturati da Hatena.
Scopri di più ->
Estrattore namu.wiki
L'Estrattore Web namu.wiki di Thunderbit ti permette di raccogliere dati da namu.wiki, comprese le pagine richieste e le discussioni più recenti. Grazie ai suggerimenti intelligenti basati su AI, puoi velocemente ottenere titoli delle pagine, URL, date dell’ultima modifica, argomenti delle discussioni e nomi dei partecipanti, ideali per ricerche, creazione di contenuti o analisi delle community.
Scopri di più ->
Estrattore NetEase Music
L'Estrattore NetEase Music di Thunderbit ti permette di raccogliere dati dai risultati di ricerca e dalle pagine degli artisti su NetEase Music. Grazie ai suggerimenti intelligenti basati su AI, puoi velocemente ottenere titoli delle canzoni, nomi degli artisti, dettagli sugli album, durate e URL dei brani per analisi o ricerche. Perfetto per analisti musicali, marketer e appassionati che desiderano dati strutturati da NetEase Music.
Scopri di più ->
Estrattore QQ Music
L’Estrattore QQ Music di Thunderbit ti permette di raccogliere dati dai risultati di ricerca e dalle liste delle opere degli artisti su QQ Music. Grazie ai suggerimenti intelligenti basati su AI, puoi velocemente ottenere titoli delle canzoni, nomi degli artisti, dettagli sugli album, date di pubblicazione e molto altro, perfetto per analisi o ricerche. Ideale per analisti musicali, marketer e appassionati che desiderano dati strutturati da QQ Music.
Scopri di più ->Pronto a dare una spinta all'estrazione dati?
Unisciti a oltre 200.000 professionisti che già usano Thunderbit per automatizzare i loro flussi di web scraping.
La prova gratuita offre crediti illimitati per 8 pagine web.


