Tumblr Scraper













Sblocca i dati di Tumblr con Thunderbit
Estrai senza sforzo dati Tumblr come contenuti dei post e numero di like.
Ottieni la storia completa di Tumblr
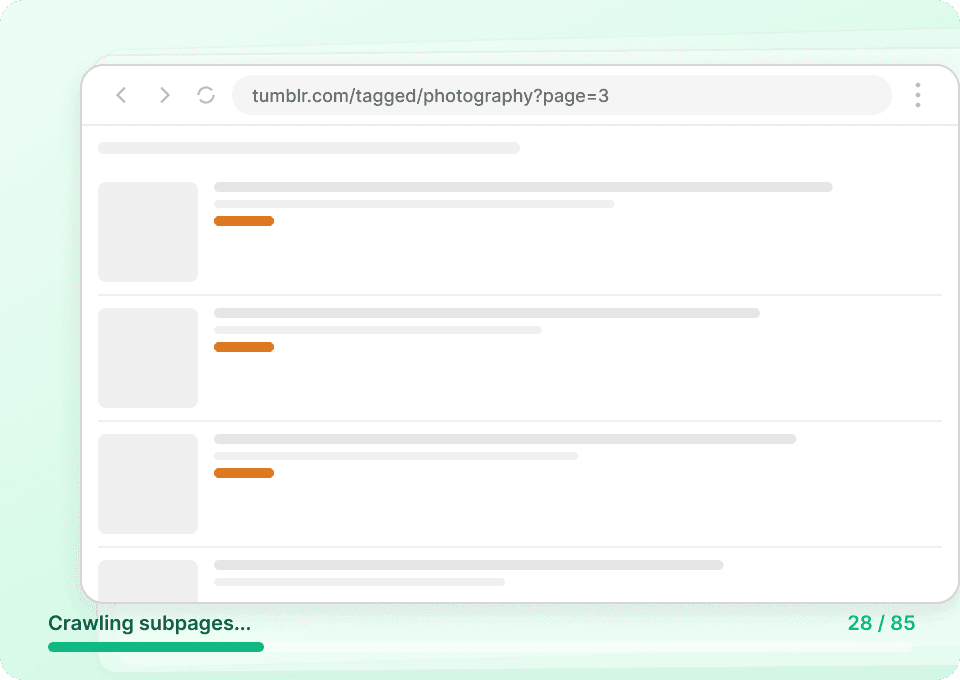
Le pagine elenco di Tumblr mostrano solo frammenti. Per avere il quadro completo, servono il contenuto integrale del post, i dettagli dell’autore e tutti i metadati associati. Thunderbit visita automaticamente ogni pagina del post collegato, estrae tutti i dettagli e li aggiunge come nuove colonne — così puoi raccogliere ID post, date di pubblicazione e molto altro senza alcun clic manuale.
Automatizza la raccolta dei dati Tumblr
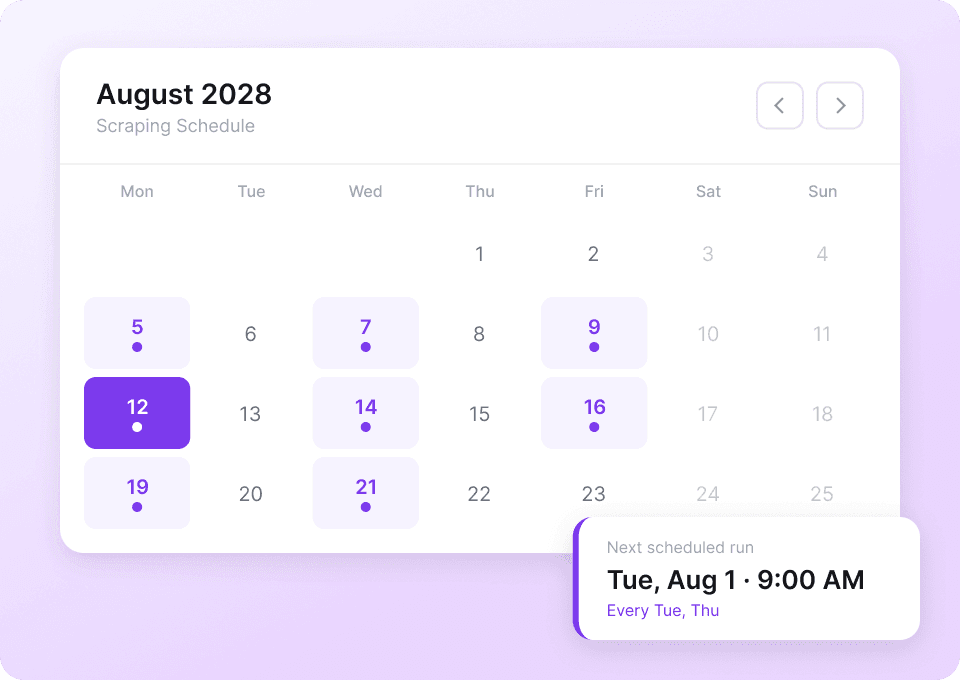
I dati su Tumblr cambiano di continuo. Tornare manualmente sugli stessi blog per rifare l’estrazione è noioso e soggetto a errori. Con lo scraping programmato di Thunderbit, puoi impostare estrazioni ricorrenti in modalità automatica. Ricevi i nuovi numeri di like e i contenuti dei post direttamente su Google Sheets — senza fare nulla a mano.
Estrai i post Tumblr in due clic
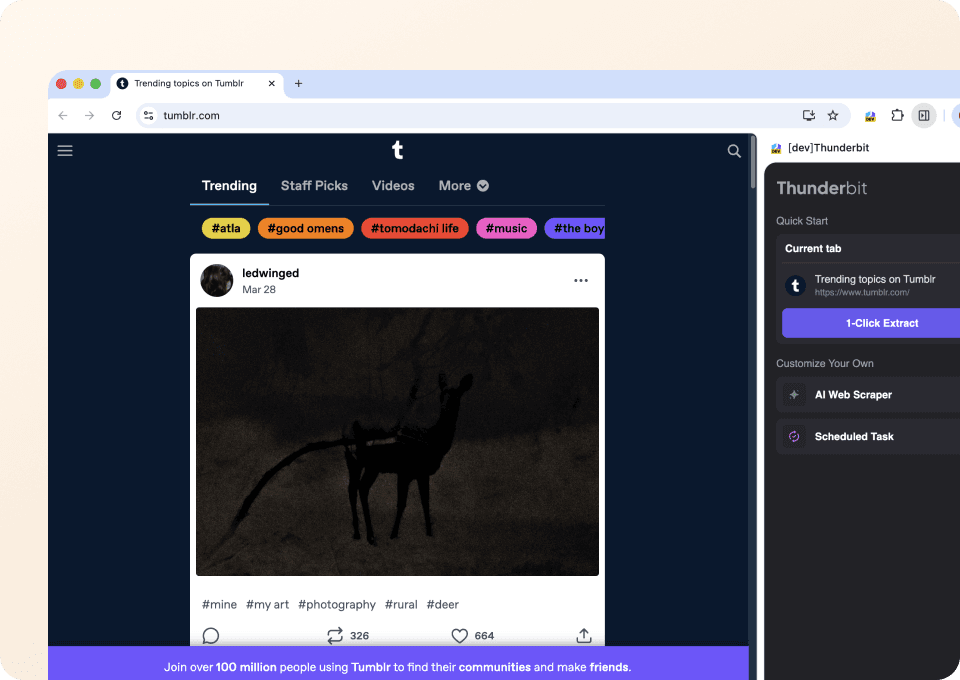
Nessun codice e nessun selettore CSS necessario. Thunderbit ti permette di estrarre dati da Tumblr in soli due clic. Ti basta indicare ciò che ti serve — tipo di post, autore, contenuto, numero di like — e l’IA semantica di Thunderbit individua i campi rilevanti ed estrae tutto automaticamente.
Perché Thunderbit è diverso dai tradizionali scraper per Tumblr?
Estrai i dati di Tumblr senza sforzo, anche quando il layout cambia o si modifica in modo inatteso.
Scraper tradizionali
Il vecchio modo di fareThunderbit AI
L’approccio più intelligente



Domande frequenti
Correlati casi d'uso
Esplora altri casi d'uso del web scraper di Thunderbit.
Estrattore Minds
L'Estrattore Minds di Thunderbit ti permette di raccogliere dati dai newsfeed e dai membri dei gruppi su Minds grazie a suggerimenti intelligenti basati sull'AI. Puoi ottenere titoli dei post, nomi degli autori, like, commenti e informazioni sui membri dei gruppi per ricerche, marketing o analisi delle community. Esporta rapidamente dati strutturati da Minds in modo semplice ed efficiente.
Scopri di più ->
Estrattore MeWe
L'Estrattore MeWe di Thunderbit ti permette di raccogliere dati dai profili utente e dai post dei gruppi su MeWe grazie ai suggerimenti intelligenti dei campi basati su AI. Puoi ottenere nomi profilo, biografie, date di iscrizione, contenuti dei post, like e commenti per attività di ricerca, marketing o analisi. Perfetto per marketer, ricercatori e aziende che hanno bisogno di dati strutturati da MeWe.
Scopri di più ->
Estrattore Parler
L'Estrattore Parler di Thunderbit ti permette di raccogliere dati dai risultati di ricerca e dagli elenchi di hashtag su Parler, grazie a suggerimenti intelligenti basati sull'AI. Puoi ottenere termini di ricerca, post degli utenti, hashtag, punteggi di popolarità e molto altro, utili per ricerche, marketing o analisi dei contenuti. Perfetto per marketer, ricercatori e aziende che desiderano dati strutturati da Parler.
Scopri di più ->
Estrattore Element
L'Estrattore Web Element di Thunderbit ti permette di raccogliere dati dalla Stanza Admin di Element Synapse grazie a suggerimenti intelligenti basati sull'AI. Puoi ottenere ID dei messaggi, nomi dei mittenti, orari, contenuti dei messaggi e allegati per analisi o monitoraggio. Perfetto per sviluppatori, community manager e ricercatori che hanno bisogno di dati strutturati da Element.
Scopri di più ->
Estrattore Odnoklassniki
L'Estrattore Odnoklassniki di Thunderbit ti permette di raccogliere dati da gruppi e liste di giochi su Odnoklassniki grazie ai suggerimenti intelligenti basati su AI. Raccogli nomi dei gruppi, descrizioni, conteggio membri, dettagli sui giochi, valutazioni e molto altro per ricerche, marketing o analisi. Perfetto per marketer, ricercatori e aziende che desiderano dati strutturati da Odnoklassniki.
Scopri di più ->
Estrattore Triller
L’Estrattore Triller di Thunderbit ti permette di raccogliere dati dalle pagine blog di Triller e dai profili dei creator. Grazie ai suggerimenti intelligenti basati su AI, puoi velocemente ottenere titoli dei post, date di pubblicazione, nomi degli autori, biografie dei creator e conteggi dei follower per ricerche, marketing o analisi.
Scopri di più ->Pronto a dare una spinta all'estrazione dati?
Unisciti a oltre 200.000 professionisti che già usano Thunderbit per automatizzare i loro flussi di web scraping.
La prova gratuita offre crediti illimitati per 8 pagine web.



