News Scraper: collega i titoli ai dettagli completi degli articoli





Collega i titoli delle notizie agli articoli completi
Trasforma una watchlist di titoli in schede articolo con contesto e fonte.
Apri gli articoli per ottenere i dettagli completi
Parti da una pagina tema, una sezione o una pagina risultati. Thunderbit può visitare ogni articolo collegato e aggiungere byline, orario di pubblicazione, sezione, riassunto e URL dell’articolo mostrati lì.
Elabora un elenco di URL degli articoli
Incolla i link selezionati da un editor o da un ricercatore. Ogni articolo accessibile diventa una riga separata, mantenendo la fonte e i dettagli di pubblicazione associati al titolo corretto.
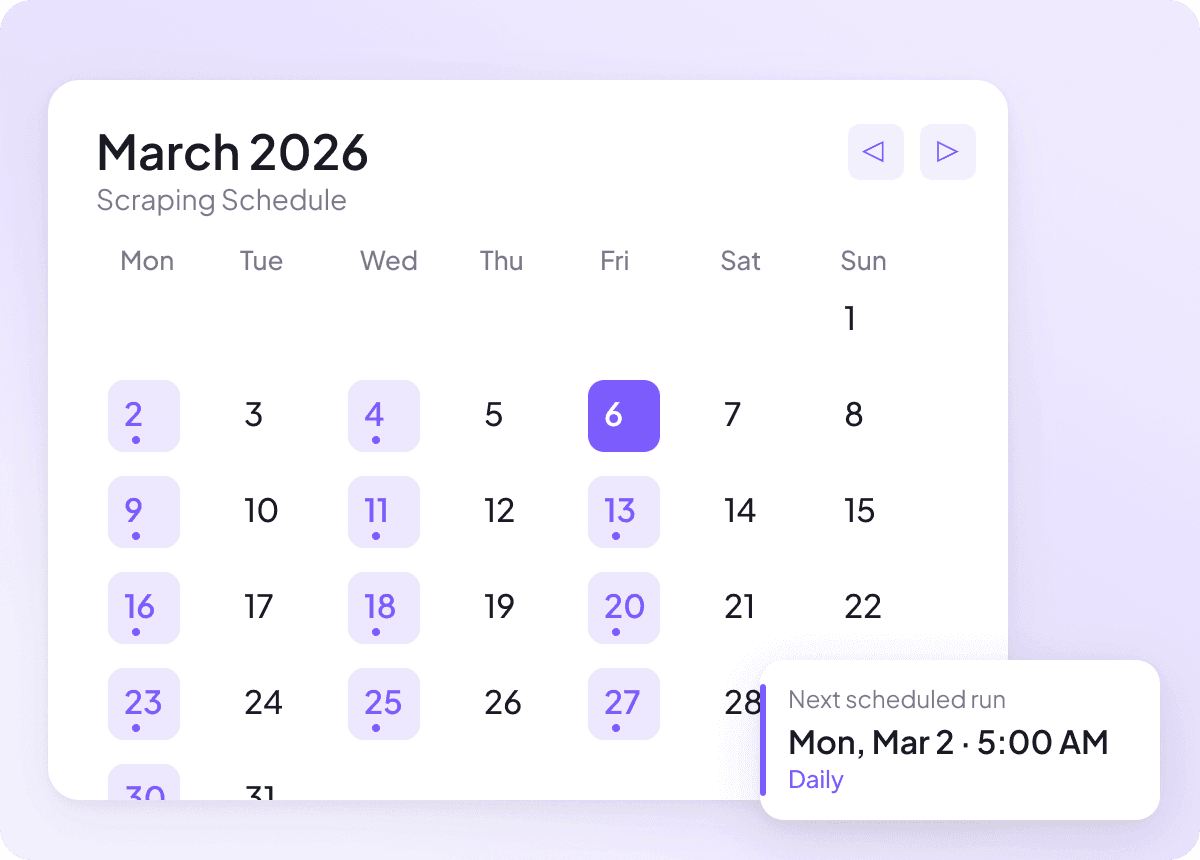
Aggiorna una watchlist di notizie
Pianifica nuovamente le stesse pagine sorgente per un’esecuzione successiva. La nuova tabella mostrerà gli articoli e i dettagli dei titoli visibili in quel momento.
Crea una watchlist di notizie senza costruire uno scraper
Passa dai titoli ai dettagli su autore, data, sezione e fonte in un’unica tabella.
Liste manuali o strumenti basati su selettori
Più configurazione per ogni fonteAgente AI di Thunderbit
Apri una pagina news e iniziaCampi degli articoli e delle liste inclusi
Catturati solo quando visibili nella tua sessione.
- headline
- article_url
- outlet_name
- author_name
- author_profile_url
- byline
- publication_date
- publication_time
- updated_date
- updated_time
- section
- subsection
- tags
- summary
- lead_paragraph
- body_text_snippet
- dateline_location
- estimated_read_time
- image_url
- image_caption
- image_credit
- video_url
- video_title
- video_duration
- gallery_image_count
- comment_count
- share_count
- related_titles
- related_urls
- publisher_logo_url
Watch news researchers build a usable watchlist
In user videos, news teams show how they match headlines with article details and check each row.



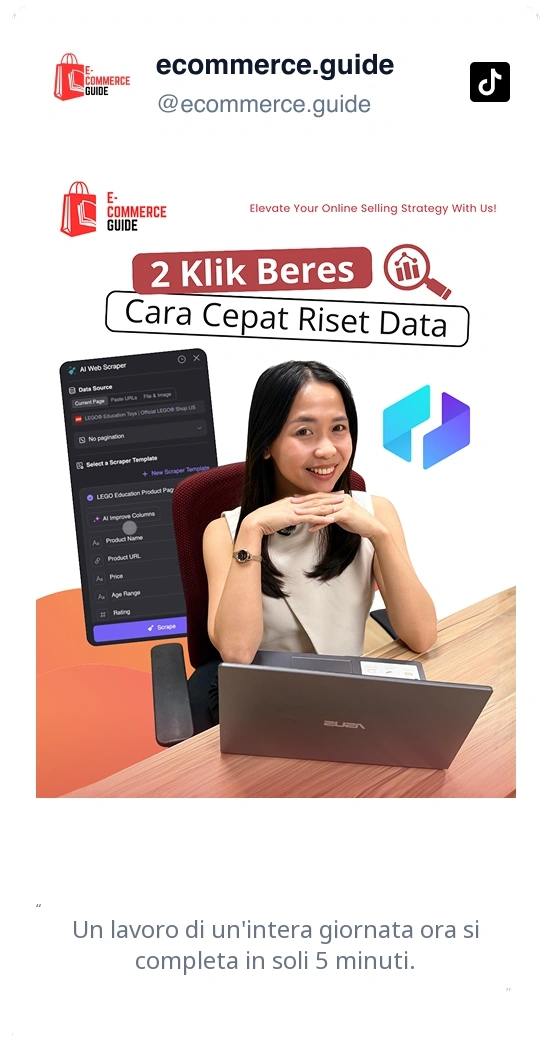


Domande sul passaggio dai titoli al contesto
Risposte rapide per liste di notizie e articoli.
Continue from headlines to source research
Collect author pages, press releases, publication archives, or topic feeds that support the same news question.
Estrattore ReverseAustralia
L’Estrattore ReverseAustralia di Thunderbit ti permette di raccogliere dati dalle pagine di reclami e commenti di ReverseAustralia. Grazie ai suggerimenti intelligenti basati su AI, puoi estrarre rapidamente numeri di telefono, descrizioni dei reclami, testi dei commenti, nomi degli utenti e molto altro per analisi o ricerche. Perfetto per marketer, ricercatori e aziende che desiderano dati strutturati sui feedback.
Scopri di più ->
Estrattore Web HKTVmall
Estrai nomi dei prodotti, prezzi, valutazioni e molto altro dalle inserzioni di HKTVmall in 2 clic, senza scrivere codice. Esporta direttamente su Excel, Google Sheets o Notion e trasforma i dati di HKTVmall in insight concreti.
Scopri di più ->
Scraper per Substack
Estrai in 2 clic il numero di iscritti su Substack, i titoli degli articoli e le descrizioni delle pubblicazioni — poi esporta tutto in Excel, Google Sheets o Notion. Non serve alcun codice: l’AI di Thunderbit si occupa automaticamente di strutturare i dati.
Scopri di più ->
Estrattore White Pages
L'Estrattore White Pages di Thunderbit ti permette di raccogliere dati dagli elenchi telefonici e aziendali di White Pages grazie ai suggerimenti intelligenti basati su AI. In pochi clic puoi ottenere nomi, numeri di telefono, indirizzi e siti web, ideali per generare contatti, attività di marketing o ricerche di mercato.
Scopri di più ->
Scraper Trustpilot per il monitoraggio delle recensioni
Trasforma i profili aziendali Trustpilot e le recensioni dei clienti in un dataset strutturato di feedback: valutazioni, date, contesto del recensore e risposte dell’azienda. Con un solo clic, l’agente AI di Thunderbit fa il resto, senza alcuna configurazione.
Scopri di più ->
Estrattore Amarillas.com
L'Estrattore Amarillas.com di Thunderbit ti permette di raccogliere dati strutturati da Amarillas.com, inclusi elenchi di motel e ristoranti. Grazie ai suggerimenti AI per i campi, puoi velocemente ottenere nomi delle attività, indirizzi, numeri di telefono, valutazioni e recensioni per ricerche, marketing o generazione di lead.
Scopri di più ->Pronto a potenziare la tua estrazione dati?
Unisciti a oltre 200.000 professionisti che già usano Thunderbit per automatizzare i loro flussi di lavoro di web scraping.
La prova gratuita offre crediti illimitati per 8 pagine web.


