
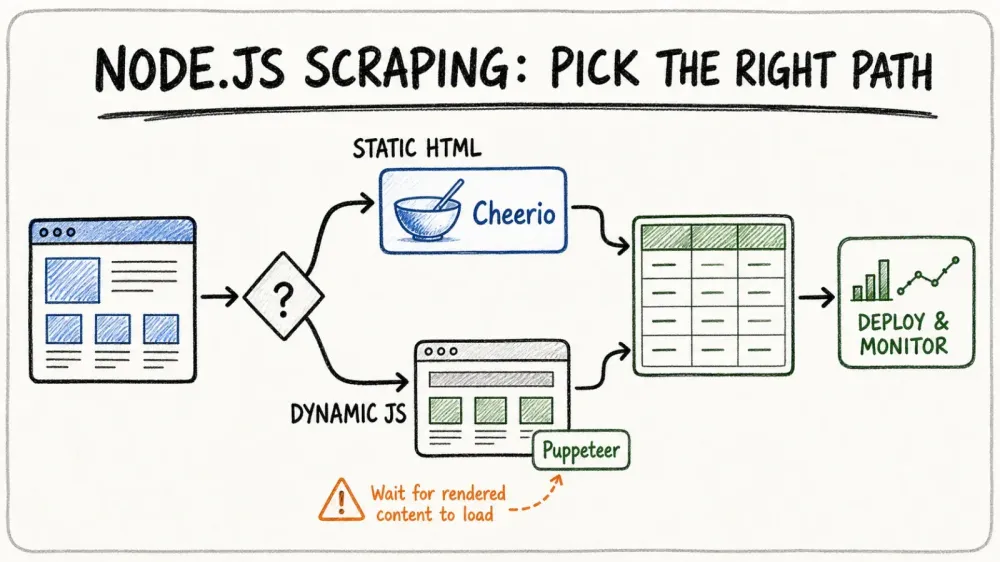
Il web non ha mai avuto così tanta fame di dati, e nel 2026 Node.js è in prima linea per i team che vogliono fare web scraping in modo più furbo, non più pesante. Che tu lavori nelle vendite, nell’ecommerce o sia semplicemente un appassionato di dati come me, avrai sicuramente notato che oggi lo scraping non vuol dire più solo “prendere le informazioni”: vuol dire farlo in fretta, su larga scala e senza ritrovarti con il tuo IP finito in una specie di prigione digitale. E la domanda non accenna a calare: i dati web pubblici sono diventati, quasi senza far rumore, la base su cui si reggono tantissimi processi moderni, dall’intelligence sui prezzi alle pipeline di training per LLM. In gioco ci sono più valore e più concorrenza che mai.
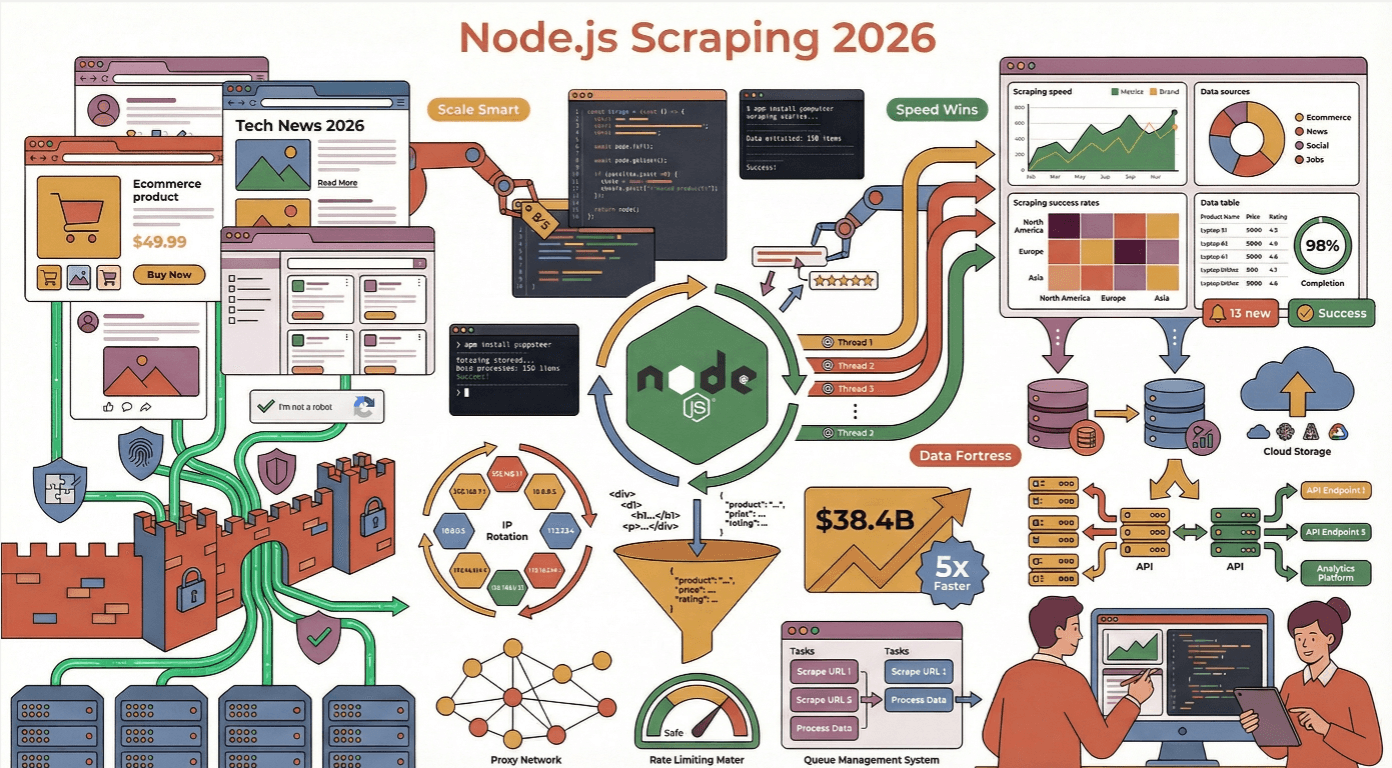
Ma c’è un problema: il web moderno è una fortezza fatta di contenuti dinamici, trappole anti-bot e layout che cambiano di continuo. Ho visto andare in fumo più scraper di quanti ne voglia ammettere — quasi sempre perché ignoravano le best practice o sottovalutavano quanto siano diventate sofisticate le difese anti-scraping. Quindi andiamo a vedere le vere best practice per fare web scraping con Node.js in modo efficiente, con qualche storia, un po’ di ironia e tanti consigli concreti.
Perché scegliere Node.js per uno scraping efficiente?
Se hai mai provato a fare scraping di centinaia o migliaia di pagine in una botta sola, sai che velocità e concorrenza contano tutto. Ed è qui che Node.js dà il meglio. Il suo modello I/O asincrono e non bloccante è pensato per gestire un numero enorme di richieste di rete contemporanee — immaginalo come il multitasker definitivo del web (Node.js Docs). Mentre altri linguaggi restano impantanati ad aspettare che ogni richiesta finisca, Node.js continua a far girare il suo event loop, destreggiandosi tra le richieste come un artista da circo pieno di caffeina.
Ho visto Node.js superare Python e Java in scenari in cui servono aggiornamenti in tempo reale ed estrazione su larga scala, soprattutto quando i siti di destinazione sono ricchi di JavaScript. In effetti, circa il 40% degli sviluppatori usa oggi Node.js per backend e automazione, rendendolo la tecnologia web più popolare al mondo.
Node.js contro altri framework per il web scraping
Facciamo un piccolo confronto tecnico:
| Framework | Punti di forza | Limiti | Casi d’uso ideali |
|---|---|---|---|
| Node.js | Asincrono, eccellente per la concorrenza, ecosistema npm enorme, JS nativo per siti dinamici | Può consumare molta memoria, callback hell (se non usi async/await) | Scraping in tempo reale, siti ricchi di JS, microservizi scalabili |
| Python | Tantissime librerie per lo scraping (BeautifulSoup, Scrapy), sintassi semplice | Più lento con concorrenza elevata, fatica sui siti renderizzati in JS | HTML statico, ricerca, prototipazione |
| Java | Tipizzazione forte, solido per l’enterprise | Verboso, meno flessibile per script rapidi | Scraping su larga scala, contesti enterprise |
| Go | Veloce, concorrenza efficiente | Ecosistema più piccolo, curva di apprendimento più ripida | Scraping ad alte prestazioni e bassa latenza |
Per la maggior parte degli utenti business, Node.js trova il punto di equilibrio perfetto: veloce, flessibile e perfettamente allineato al web moderno basato su JavaScript (Thunderbit Blog).
Come impostare un ambiente Node.js solido per il web scraping
Uno scraper efficace parte da basi solide. Ecco il mio setup di riferimento:
- Struttura del progetto: tieni tutto ben modulare. Usa cartelle come
/src,/libse/config. Conserva le informazioni sensibili (chiavi API, proxy) in variabili d’ambiente condotenv(Thunderbit Guide). - Client HTTP: usa axios, got o node-fetch per le richieste.
- Parsing HTML: Cheerio per HTML statico, Puppeteer o Playwright per contenuti dinamici.
- Utility: usa Lodash per trasformare i dati, e validator.js o Joi per la validazione.
- Testing e linting: Mocha per i test, ESLint per tenere il codice pulito (LogRocket).
Librerie Node.js essenziali per il web scraping
- Client HTTP (axios / got /
fetchintegrato): per inviare richieste. Vale la pena dirlo subito: da Node.js v18 puoi usarefetchin modo nativo, senza installare nulla, e con Node.js v22 è diventato stabile. In un progetto nuovo su una versione recente di Node probabilmente non ti serve affatto il pacchettonode-fetch— ti basta chiamare direttamentefetch. Io continuo a usare axios quando mi servono intercettori, JSON automatico e una Promise API familiare sia in Node sia nel browser, mentre got è la mia scelta quando ho bisogno di retry, stream o HTTP/2 già pronti. Scegli quello più adatto al tuo stack; per uno script veloce,fetchnativo va benissimo. - Cheerio: parser HTML veloce, simile a jQuery. Perfetto per le pagine statiche — analizza in circa 0,5 secondi (Oxylabs).
- Playwright / Puppeteer: automazione del browser headless per siti dinamici e pesanti in JS. Più lento (circa 4 secondi per pagina), ma indispensabile per i siti che caricano contenuti dopo il caricamento iniziale (Bright Data). Se parti da zero nel 2026, Playwright è la scelta predefinita: supporto multi-browser già incluso (Chromium / Firefox / WebKit), trace viewer integrato, e il team che ha creato originariamente Puppeteer ora lo sviluppa in Microsoft. Puppeteer è ancora mantenuto per i flussi solo Chrome, ma da un po’ di tempo le release note puntano più agli aggiornamenti di compatibilità con Chrome che a nuove funzionalità.
- dotenv: per gestire le variabili d’ambiente.
- csv-writer/jsonfile: per esportare i dati.
Evitare gli errori più comuni nello scraping con Node.js
Ho perso il conto delle volte in cui ho visto scraper bloccarsi, andare in crash o semplicemente produrre dati sporchi e confusi. Ecco cosa tenere d’occhio:
- Ignorare robots.txt e i Termini di servizio: controlla sempre prima di fare scraping. Violare queste regole può farti bannare l’IP — o, peggio, metterti nei guai dal punto di vista legale (ScraperAPI).
- Sovraccaricare i server: non sparare richieste a raffica. Limita il ritmo dello scraper con ritardi casuali (1–3 secondi), usa controlli di concorrenza e evita di comportarti come un robot iperattivo (ScrapeGraphAI).
- Non gestire gli errori: avvolgi sempre le richieste in try/catch, gestisci gli errori HTTP e registra i fallimenti. Riprova gli errori temporanei con exponential backoff (ScrapeGraphAI).
- Dimenticare gli header della richiesta: usa User-Agent realistici e ruotali. Aggiungi Accept-Language, Referer e altri header per imitare un browser vero (ScrapeGraphAI).
Come aggirare i meccanismi anti-scraping
I siti moderni sono pieni zeppi di tecnologie anti-bot. Ecco come evitare le mine digitali:
- Proxy/IP rotanti: usa un pool di proxy e alterna gli IP per evitare i ban (Medium).
- Header casuali: ruota User-Agent, Accept-Language e altri header a ogni richiesta.
- Stealth nei browser headless: usa plugin come
puppeteer-extra-plugin-stealthper mascherare le tracce dell’automazione. - Simulare il comportamento umano: inserisci ritardi casuali, movimenti del mouse, scroll e perfino piccoli errori di digitazione (ZenRows).
Simulare il comportamento umano negli scraper Node.js
Qui le cose si fanno divertenti, e un po’ strane. Invece di cliccare e scrollare all’istante, fai in modo che lo scraper:
- Aspetti intervalli casuali tra un’azione e l’altra (
await page.waitForTimeout(randomDelay)) - Muova il mouse con piccoli spostamenti irregolari (
page.mouse.move(x, y)) - Digiti con ritardi casuali e qualche refuso ogni tanto (
page.type(selector, text, {delay: random(100,200)})) - Scrolli in modo non uniforme, non solo fino in fondo
Queste tecniche possono aumentare parecchio il tasso di successo sui siti protetti (ScraperAPI).
Semplificare l’estrazione di dati complessi con Thunderbit
Estrai dati da qualsiasi sito con l’AI Salta tutta la parte di codice ripetitivo: l’agentic web scraper di Thunderbit legge qualsiasi pagina ed estrae i dati con un clic, senza dover mantenere codice Node.js. Get Started Free
Parliamo dell’elefante nella stanza: fare scraping è dura. Ma non deve per forza esserlo. È per questo che abbiamo creato Thunderbit.
Thunderbit è un’estensione Chrome con agentic web scraper che ti permette di estrarre dati da qualsiasi sito usando un semplice prompt in linguaggio naturale. Basta cliccare su “One Click Extract”, lasciare che l’AI capisca la pagina e poi premere “Scrape”. È come avere uno sviluppatore junior che non dorme mai e non chiede mai un aumento.
Ancora meglio, Thunderbit offre un’API, così puoi integrarlo direttamente nei tuoi flussi di lavoro Node.js. Invece di scrivere migliaia di righe di codice per lo scraping, puoi lasciare a Thunderbit il lavoro pesante — contenuti dinamici, sottopagine, paginazione e tutto il resto. Tu devi solo recuperare i dati strutturati (CSV, JSON o direttamente in Google Sheets, Airtable, Notion) e andare avanti con la tua giornata (Thunderbit Blog).
Prova gratis l’estensione Chrome di Thunderbit Installa l’estensione Chrome gratuita ed estrai dati strutturati con un solo clic — oppure chiama l’API di Thunderbit dalla tua app Node.js. Get Started Free
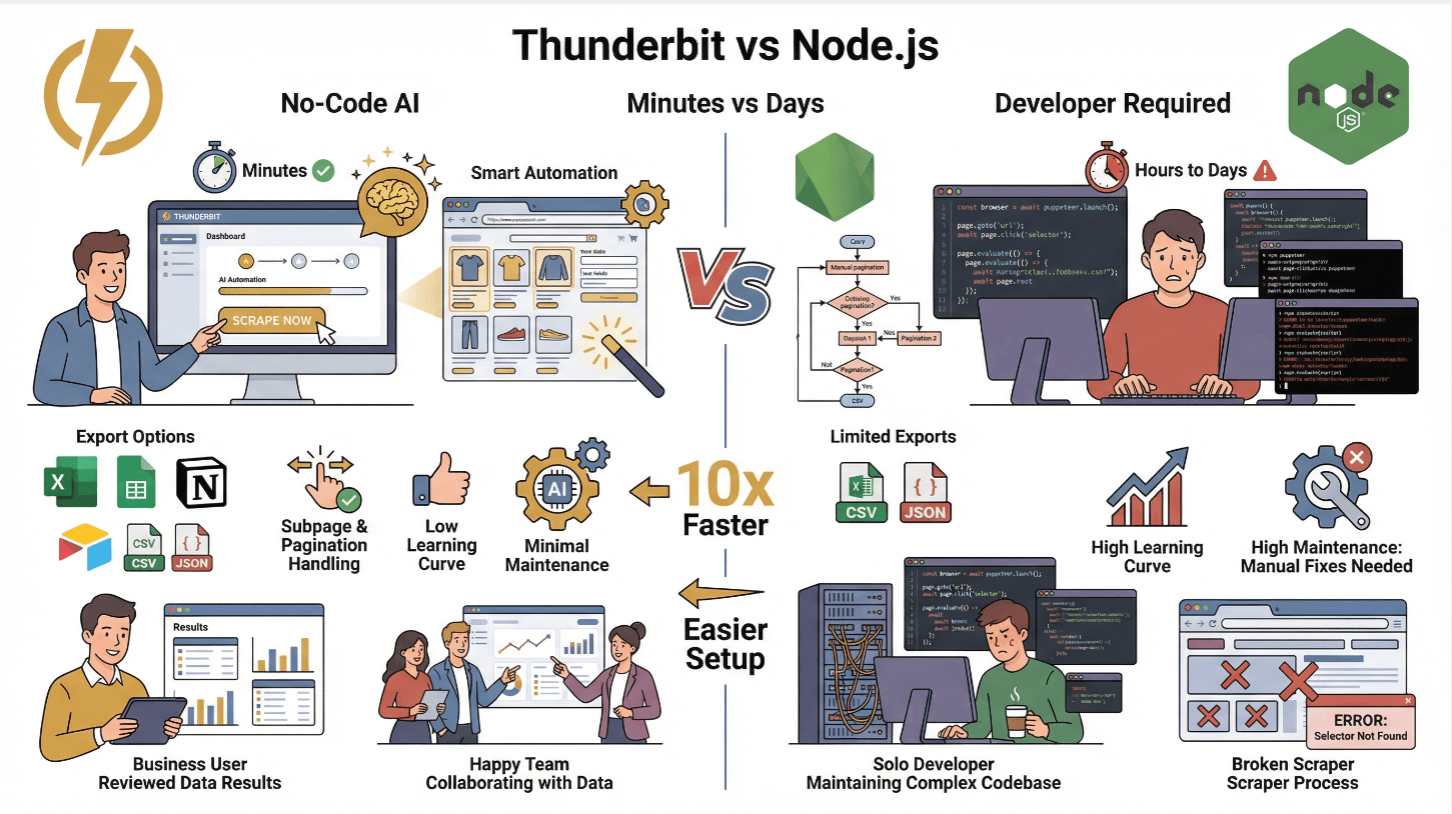
Thunderbit vs. scraping Node.js tradizionale
| Funzionalità | Thunderbit | Scraper Node.js tradizionale |
|---|---|---|
| Tempo di configurazione | Minuti (senza codice) | Ore o giorni (sviluppo, test) |
| Gestione contenuti dinamici | Sì (AI + browser) | Sì (con Puppeteer/Playwright) |
| Sottopagine e paginazione | Con un clic | Richiede codice manuale |
| Esportazione dati | Excel, Sheets, Notion, Airtable, CSV, JSON | CSV/JSON (codice personalizzato) |
| Curva di apprendimento | Bassa (utenti business) | Alta (sviluppatori) |
| Manutenzione | Minima (l’AI si adatta) | Elevata (correzioni manuali quando il sito cambia) |
Thunderbit è perfetto per i team non tecnici o per chi vuole evitare il lavoro ripetitivo e concentrarsi sugli insight. Per gli utenti avanzati, puoi comunque usare l’API di Thunderbit per automatizzare lo scraping su larga scala (Thunderbit Docs).
Unire Cheerio e Puppeteer per contenuti dinamici
Questa è la mia combinazione preferita per fare web scraping con Node.js. Ecco come funziona:
- Usa Puppeteer per caricare la pagina ed eseguire JavaScript (aspetta
networkidleper essere sicuro che tutti i contenuti siano caricati). - Recupera l’HTML con
await page.content(). - Analizza con Cheerio: passa l’HTML a Cheerio per un parsing velocissimo in stile jQuery e per estrarre i dati.
Questo approccio ibrido ti dà il meglio di entrambi i mondi: la potenza di Puppeteer per i contenuti dinamici e la velocità di Cheerio per il parsing (Browserless).
Consiglio sulle prestazioni: seleziona solo gli elementi che ti servono. Cheerio carica l’intero DOM in memoria, quindi evita selettori troppo larghi e metti in cache i risultati se fai scraping delle stesse pagine più volte (Oxylabs).
Ottimizzare il parsing HTML e l’estrazione dei dati
- Usa selettori specifici: evita
$('body *')— punta solo a ciò che ti serve. - Fai streaming delle pagine grandi: per HTML molto pesanti, valuta lo streaming oppure dividi il lavoro.
- Metti in cache l’HTML renderizzato: se torni sugli stessi URL, salva l’HTML per evitare richieste inutili.
- Valida e pulisci i dati: usa librerie di validazione per evitare di riempire il database di spazzatura (ScrapeGraphAI).
Deployment scalabile di uno scraper Node.js nel cloud
Devi fare scraping su larga scala? È il momento di passare al cloud.
- Dockerizza lo scraper: scrivi un
Dockerfile, copia il codice, installa le dipendenze e imposta l’entrypoint. - Distribuisci nel cloud: usa AWS EC2, Google Cloud Compute o Azure VM per lavori semplici. Per carichi davvero grandi, usa Kubernetes o servizi gestiti come AWS ECS/EKS, Google Cloud Run o Azure Kubernetes Service (DigitalOcean).
- Orchestra con Kubernetes: esegui più pod, scala automaticamente in base alla domanda e usa bilanciatori di carico per distribuire gli URL.
- Pianifica i job: usa scheduler cloud (CloudWatch Events, Cloud Scheduler) o job cron per avviare lo scraping a intervalli regolari.
In un caso reale, passare da 5 a 10 pod Kubernetes ha ridotto uno scraping di 400 pagine da diversi minuti a meno di un minuto (DigitalOcean).
Monitoraggio e auto-scaling dell’infrastruttura di scraping
- Logging: invia i log a CloudWatch, Stackdriver o Datadog. Imposta alert per errori o rallentamenti.
- Health check: usa Prometheus e Grafana per metriche come pagine scrappate al minuto, tasso di errore e stato dei pod.
- Auto-scaling: configura l’HPA di Kubernetes (Horizontal Pod Autoscaler) per scalare i pod in base alla CPU o al numero di richieste.
Implementa sempre retry con exponential backoff per recuperare da problemi di rete o ban temporanei.
Best practice per l’archiviazione e il post-processing dei dati
Una volta estratti i dati, devi archiviarli e ripulirli:
- Piccoli job: esporta in CSV, JSON oppure invia i dati a Google Sheets, Airtable o Notion (Thunderbit lo fa nativamente).
- Job grandi: usa SQL (MySQL/PostgreSQL) per dati strutturati, oppure NoSQL (MongoDB, DynamoDB) per schemi semi-strutturati o in evoluzione (ScrapeHero).
- Archiviazione cloud: S3 o Google Cloud Storage per file grezzi e backup.
- Pulizia dati: valida sempre i campi, normalizza i formati (date, numeri) e rimuovi i duplicati. Usa validatori di schema per garantire la qualità dei dati (ScrapeGraphAI).
Conserva sia i dati grezzi sia quelli puliti: non sai mai quando potresti doverli rielaborare o usarli per il debug.
Conclusione: i punti chiave per uno scraping efficiente con Node.js
Salta il codice dello scraper Scopri come l’agentic web scraper di Thunderbit si confronta con la scrittura e la manutenzione dei tuoi script di scraping. Get Started Free
Chiudiamo con i concetti essenziali:
- Sfrutta la potenza asincrona di Node.js per uno scraping massivo e concorrente — soprattutto sui siti ricchi di JavaScript.
- Combina gli strumenti giusti: usa axios/got per le richieste, Cheerio per l’HTML statico, Puppeteer per i contenuti dinamici, e mescolali per ottenere velocità e flessibilità.
- Evita le trappole anti-bot: ruota proxy e header, simula il comportamento umano e rispetta robots.txt.
- Semplifica con Thunderbit: per utenti business o prototipi rapidi, Thunderbit ti permette di estrarre dati complessi con l’AI e di collegarlo al tuo stack Node.js via API.
- Distribuisci su larga scala: usa Docker, Kubernetes e un monitoraggio continuo per garantire affidabilità.
- Archivia e pulisci i dati: scegli la soluzione di storage più adatta e valida sempre prima di usare i dati.
Il web non sta diventando più semplice, ma con queste best practice i tuoi scraper Node.js possono restare veloci, affidabili e sempre un passo avanti nella corsa agli anti-bot. E se ti stanchi di fare debug dei selettori alle 2 di notte, ricorda: l’AI di Thunderbit non dorme mai.
Vuoi approfondire? Dai un’occhiata al Thunderbit Blog per altri approfondimenti, oppure prova l’estensione Chrome di Thunderbit per vedere quanto può essere semplice lo scraping.
Fai web scraping con l’agentic web scraper di Thunderbit L’API Web Scraper di Thunderbit ti permette di avviare l’estrazione dal tuo codice Node.js, con un piano gratuito per iniziare. Get Started Free
FAQ
1. Perché Node.js è particolarmente adatto al web scraping nel 2025?
Il modello asincrono e orientato agli eventi di Node.js gli permette di gestire migliaia di richieste contemporanee, rendendolo ideale per estrarre grandi volumi di dati o aggiornamenti in tempo reale. Il suo enorme ecosistema npm e il supporto nativo a JavaScript sono perfetti per i siti moderni, ricchi di JS (Node.js Docs).
2. Come posso evitare di essere bloccato quando faccio scraping con Node.js?
Usa proxy rotanti, randomizza gli header delle richieste, limita il ritmo delle richieste con ritardi casuali e simula il comportamento umano (movimento del mouse, scrolling, digitazione) con strumenti come Puppeteer. Rispetta sempre robots.txt e i termini del sito (Medium).
3. Quando dovrei usare Cheerio invece di Puppeteer nel mio scraper Node.js?
Usa Cheerio per un parsing veloce dell’HTML statico, quando i dati sono già presenti nell’HTML grezzo. Usa Puppeteer per i siti che caricano contenuti dinamicamente con JavaScript. Per ottenere il meglio, usa Puppeteer per renderizzare la pagina e poi Cheerio per analizzare l’HTML (Bright Data).
4. In che modo Thunderbit semplifica il web scraping con Node.js?
Thunderbit ti consente di estrarre dati strutturati da qualsiasi sito usando l’AI e prompt in linguaggio naturale — senza scrivere codice. Gestisce contenuti dinamici, sottopagine e paginazione, e offre un’API per l’integrazione con Node.js. I dati possono essere esportati direttamente in Excel, Google Sheets, Airtable o Notion (Thunderbit Blog).
5. Qual è il modo migliore per scalare e monitorare gli scraper Node.js nel cloud?
Dockerizza lo scraper, distribuiscilo su Kubernetes o su servizi cloud gestiti e usa l’auto-scaling per gestire i picchi di domanda. Monitora log e metriche con strumenti come CloudWatch o Prometheus e configura alert per errori o rallentamenti (DigitalOcean).
Pronto a fare un salto di qualità nel tuo web scraping? Prova Thunderbit e fai in modo che i tuoi scraper siano veloci, discreti e sempre un passo avanti.
Prova l’agentic web scraper Get Started Free
Scopri di più
- Come padroneggiare il web scraping con Node per principianti: guida passo passo
- Come estrarre dati da un sito in modo efficiente con i migliori strumenti
- Come eseguire il crawl di un sito in modo efficiente: guida passo passo
- Come padroneggiare il crawling in JavaScript: guida per principianti
- Come padroneggiare il web scraping per il confronto prezzi nel 2026




