
C’è una cosa che chi lavora con i dati impara presto: il valore non è nelle informazioni che hai già sotto gli occhi, ma in quelle che riesci a mettere insieme da solo. E il web ne sforna di nuove ogni secondo. Non a caso le aziende stanno facendo a gara per automatizzare la raccolta dati online: secondo le stime, il mercato globale del web scraping toccherà i 2 miliardi di dollari entro il 2030. E c’è un numero che colpisce ancora di più: più del 65% delle organizzazioni ormai si appoggia a crawler o scraper per dar da mangiare a sistemi di AI, analytics e processi interni.
E tu come ci entri, in questo gioco? Nella maggior parte dei casi la risposta si chiama Python. È il linguaggio con cui si costruiscono i crawler per eccellenza: lineare, potente e con una valanga di librerie che ti tolgono metà delle grane di crawling e scraping. In questa guida vediamo cos’è davvero un website crawler, perché Python resta la scelta più sensata, come tirarne su uno un passo alla volta e in che modo strumenti come Thunderbit possono accorciare ancora di più la strada, soprattutto se preferisci cliccare invece di scrivere righe di codice. Sviluppatore, marketer con la testa sui numeri o semplicemente uno che non ne può più delle attività ripetitive: in ogni caso, qui trovi qualcosa da portarti a casa per fare un salto di qualità nella tua strategia sui dati web.
Cos’è un Website Crawler? (E perché dovrebbe importartene?)
In parole povere: un website crawler è un programma che gira il web da solo, apre le pagine, segue i link e, quando serve, raccoglie dati strada facendo. Immaginalo come un navigatore instancabile: non dorme mai, non si stufa e non chiude per sbaglio la scheda sbagliata. I crawler sono il motore dietro i motori di ricerca, Googlebot in testa, ma le aziende li usano per qualsiasi cosa, dal monitoraggio dei prezzi alle ricerche di mercato.
A questo punto sorge spontanea una domanda: che differenza c’è tra crawling e scraping? Il crawling serve a scoprire e attraversare le pagine, come tracciare la mappa di una città; lo scraping, invece, è l’atto di tirare fuori dati precisi da quelle pagine, tipo segnarsi i menu di tutti i ristoranti in giro. Nella realtà, quasi ogni progetto fa tutte e due le cose: prima si crawlano le pagine, poi si estrae ciò che interessa (Baeldung).
A cosa servono davvero i crawler in azienda:
- Generazione di lead: contatti raccolti in automatico da directory o social.
- Monitoraggio dei prezzi: prezzi e disponibilità dei concorrenti tenuti d’occhio su migliaia di prodotti.
- Monitoraggio dei contenuti: una notifica ogni volta che il tuo brand spunta su news, blog o forum.
- Audit SEO: una passata sul tuo sito per stanare link rotti o metadati mancanti.
- Ricerche di mercato: annunci immobiliari, offerte di lavoro o recensioni messi insieme per analisi più solide.
Se hai mai sognato di clonarti per stare dietro a tutta la ricerca online, ecco: un crawler è la cosa più vicina che troverai.
Perché i Website Crawler contano per l’automazione aziendale
Veniamo al sodo. Perché le aziende mettono soldi in crawler e scraper? Perché il ritorno è di quelli che si vedono. Ecco un quadro veloce di come i vari team li usano e di cosa ci guadagnano:
| Caso d’uso | Vantaggio principale | Chi lo usa |
|---|---|---|
| Generazione di lead | Crea liste di prospect in automatico e libera ore di lavoro | Vendite, Recruiting |
| Monitoraggio prezzi | Insight in tempo reale sui competitor, pricing dinamico | E-commerce, Product Team |
| Monitoraggio contenuti | Tutela del brand, trend individuati al volo | Marketing, PR |
| Audit SEO del sito | Salute del sito, ranking che migliora | SEO, Webmaster |
| Ricerche di mercato | Dataset aggiornati e su larga scala per l’analisi | Analyst, Team di ricerca |
In un caso reale, automatizzare una raccolta dati settimanale, cioè lo scraping di 5-7 siti, ha fatto risparmiare a una sola persona oltre 50 ore in un anno: moltiplica per tutto il team e capisci al volo perché, una volta partite con i crawler, le aziende “non riescono nemmeno a immaginare di tornare indietro”.
Python: la scelta più sensata per costruire un Website Crawler
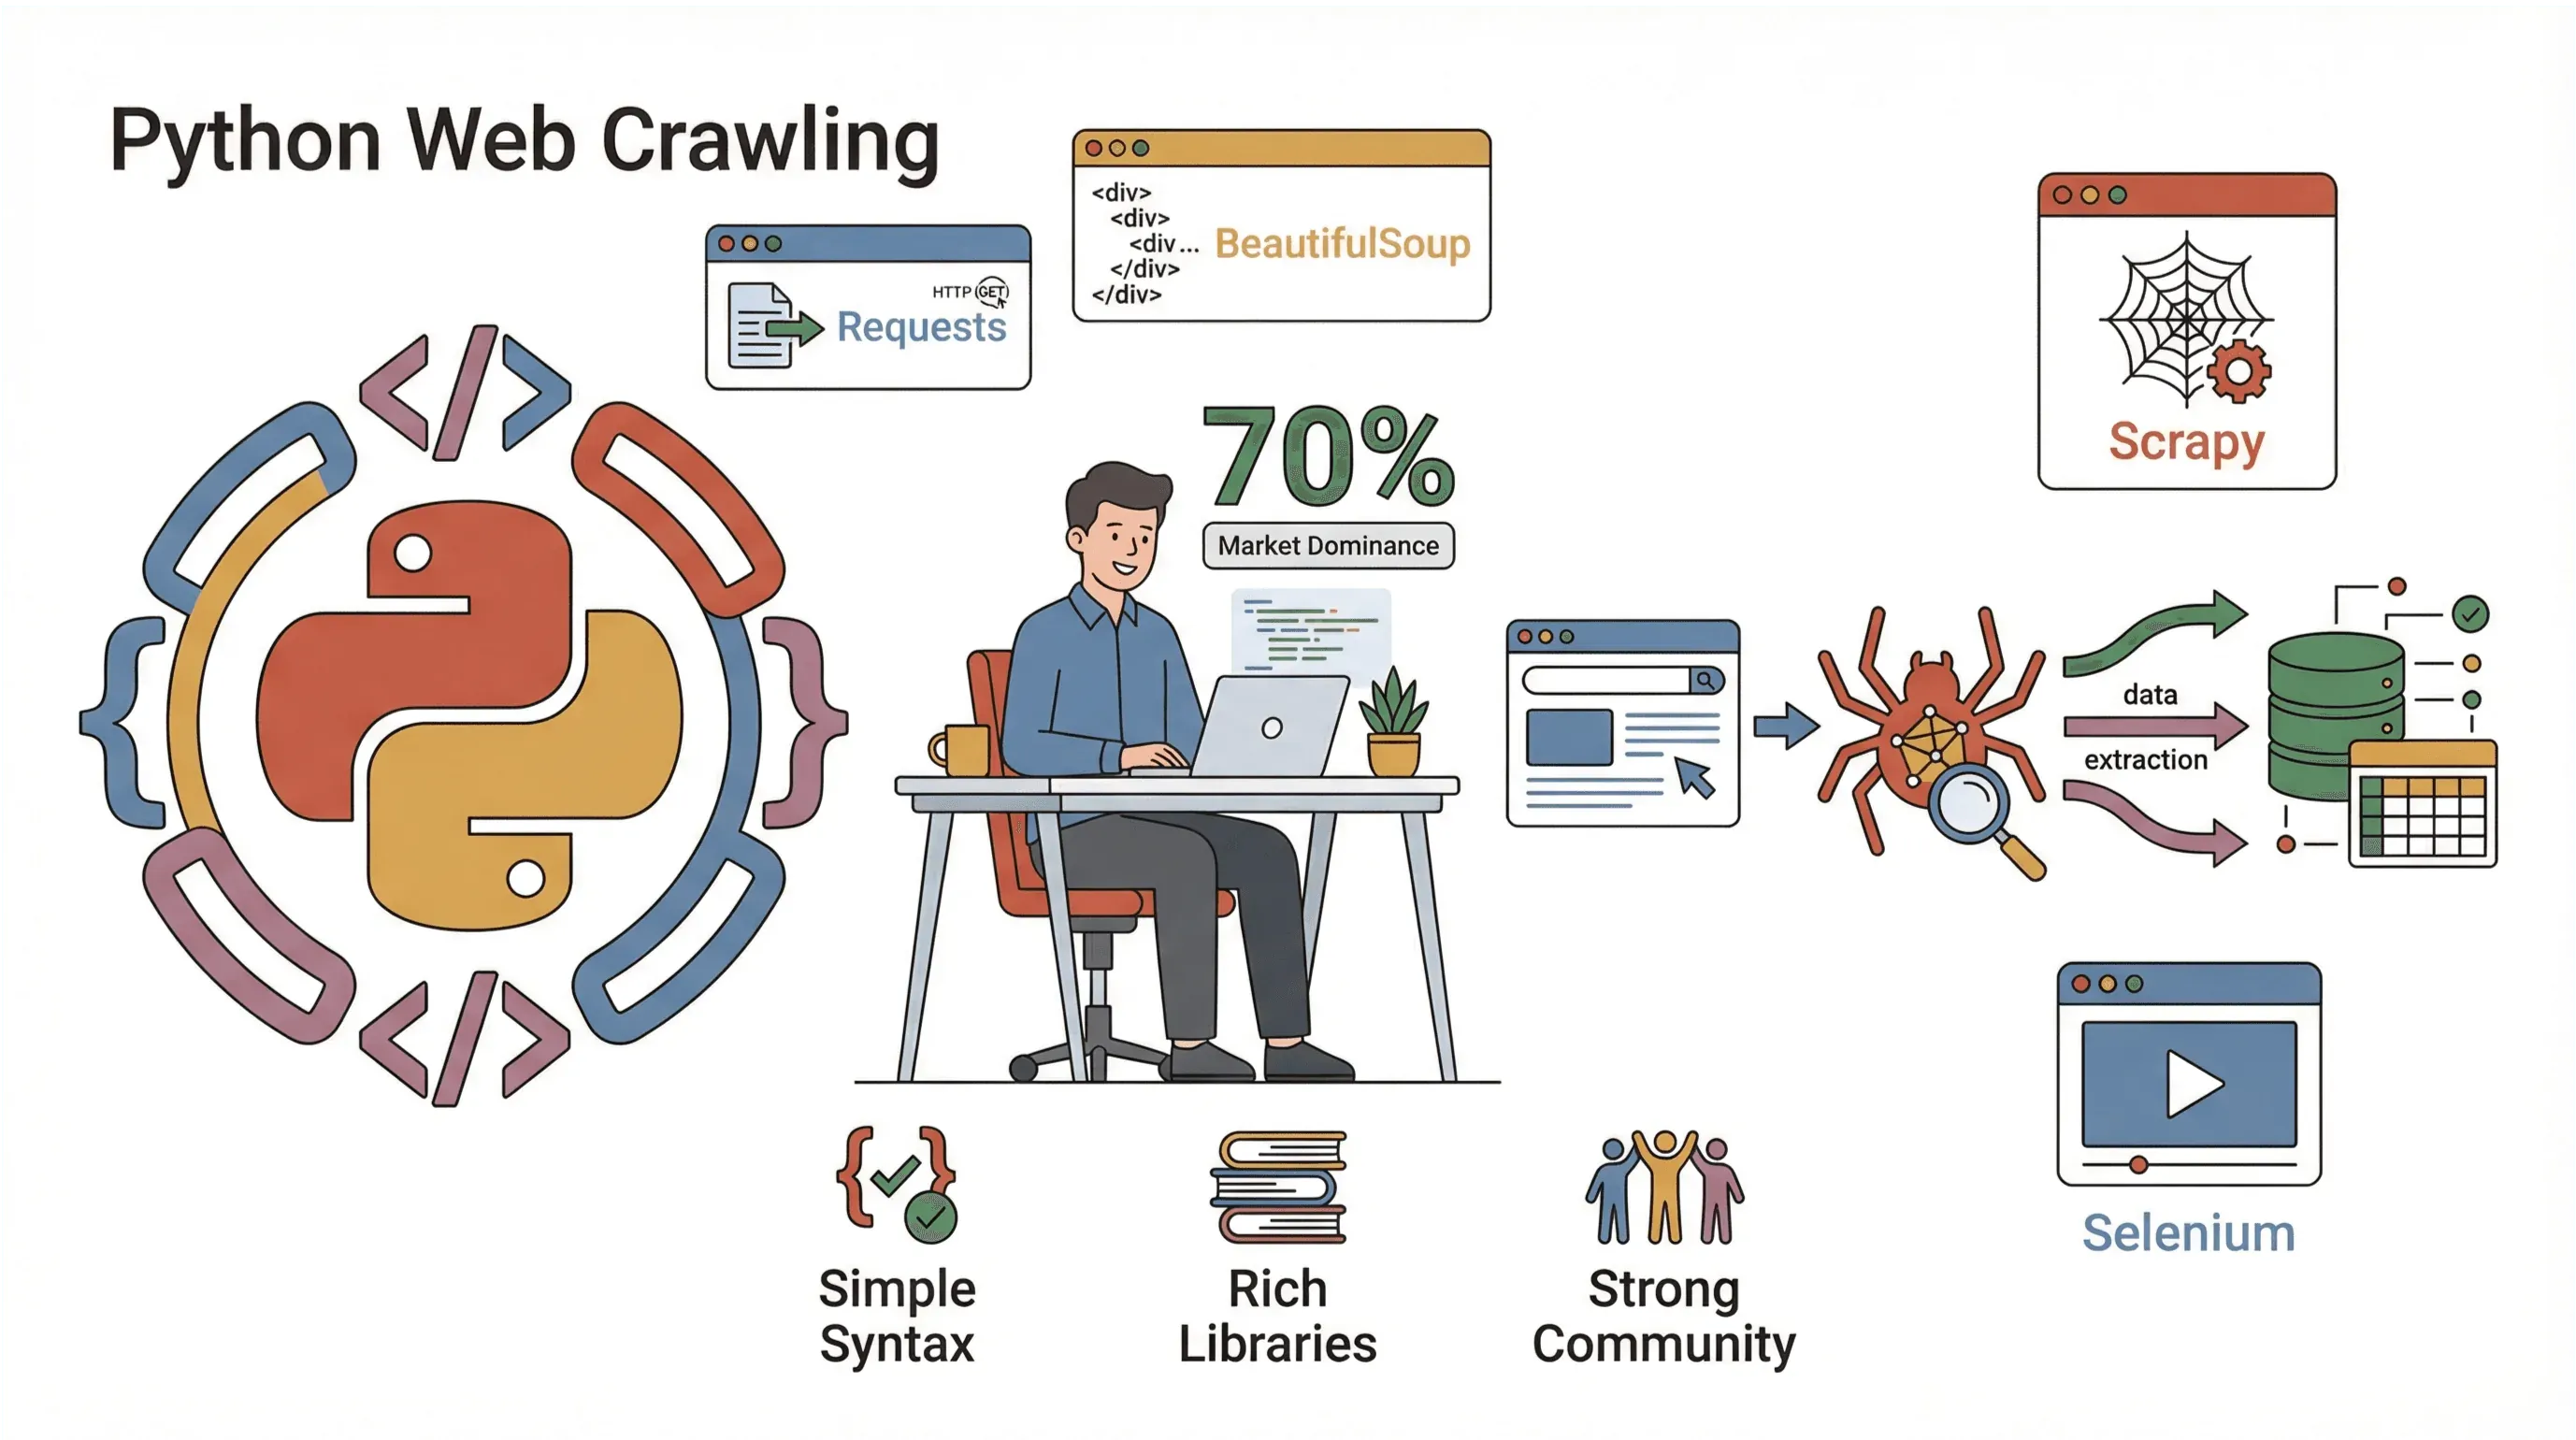 Allora, perché Python domina il web crawling? In sostanza per tre ragioni:
- Semplicità: la sintassi di Python è pulita, accessibile anche a chi è alle prime armi, e ti fa scrivere crawler che funzionano in una manciata di righe.
- Ecosistema di librerie: per ogni fase del crawling, Python ha la libreria giusta: scaricare pagine, leggere l’HTML, gestire il JavaScript e via dicendo.
- Community: con quasi il 70% dei progetti di web scraping costruiti in Python, hai dietro una community enorme, tutorial a non finire e una risposta pronta per quasi ogni intoppo.
Le librerie Python più usate per il web crawling:
- Requests: il modo più diretto per recuperare pagine web (HTTP GET/POST).
- BeautifulSoup: lo strumento di riferimento per leggere l’HTML e trovare gli elementi.
- Scrapy: un framework completo per crawling su larga scala.
- Selenium: pilota il browser per fare scraping di siti pieni di JavaScript.
Rispetto a linguaggi come Java o C#, con Python passi dall’idea a un crawler che gira in molto meno tempo. E se i dati sono il tuo pane, puoi spedire l’output del crawler dritto in Pandas per l’analisi, senza esportazioni e importazioni da incubo.
Metodi di parsing a confronto: Regex vs. BeautifulSoup vs. Scrapy
Quando arriva il momento di estrarre i dati dalle pagine, di strade ne hai più d’una. Ecco come si comportano i metodi principali messi a confronto:
| Metodo | Come funziona | Pro 🟢 | Contro 🔴 | Ideale per |
|---|---|---|---|---|
| Regex | Cerca pattern nell’HTML grezzo | Veloce sui pattern semplici e già noti | Fragile, si spacca se l’HTML cambia | Soluzioni al volo, estrazione di URL |
| BeautifulSoup | Trasforma l’HTML in un albero, ricerca per tag | Facile, flessibile, regge l’HTML disordinato | Più lento sulle pagine enormi, logica a mano | Script di scraping piccoli/medi |
| Scrapy | Framework completo, parsing CSS/XPath | Veloce, scalabile, gestisce crawling e parsing | Curva più ripida, vuole più setup | Crawler grandi e di produzione |
- Regex è come passare il metal detector sulla spiaggia: rapido, ma basta che la sabbia si sposti e ti perdi qualcosa.
- BeautifulSoup è come avere mappa e paletta: puoi scavare dove vuoi, ma la spiaggia te la fai tutta a mano.
- Scrapy è presentarsi con squadra al completo, camion e GPS: esagerato per una prova veloce, ma imbattibile sui lavori pesanti.
Se parti adesso, il mio consiglio è cominciare con Requests + BeautifulSoup. Ti fai le ossa, metti a fuoco le basi e, quando sei pronto a crescere, salti su Scrapy.
Passo dopo passo: come costruire un semplice Website Crawler in Python
Voglia di metterci le mani? Tiriamo su un crawler base che apre le pagine, segue i link e raccoglie qualche dato. Ti accompagno passo per passo, con codice che puoi copiare e adattare.
Passo 1: preparare l’ambiente Python
Prima cosa, controlla di avere Python 3.10+ installato. (Lo verifichi con python --version.) Ti suggerisco di creare un ambiente virtuale dedicato al progetto:
python -m venv venv
source venv/bin/activate  # Su Windows: venv\Scripts\activate
Poi installa le librerie che servono:
pip install requests beautifulsoup4
Fatto. Apri il tuo editor preferito e preparati a scrivere il crawler.
Passo 2: scrivere il tuo primo script di Website Crawler
Cominciamo recuperando una singola pagina. Ecco uno script davvero minimale:
import requests

def crawl_page(url):
    response = requests.get(url)
    response.raise_for_status()  # Genera errore se la risposta non è 200 OK
    print(response.text[:500])   # Stampa i primi 500 caratteri come anteprima

crawl_page("https://www.scrapingcourse.com/ecommerce/")
In console dovrebbe comparire un blocco di HTML: la conferma che stai dialogando col web.
Passo 3: seguire i link e raccogliere più dati
Ora facciamo seguire i link al crawler, così visita più pagine. Useremo una lista di URL da visitare e un insieme di URL già visti, per non finire in loop:
from bs4 import BeautifulSoup

start_url = "https://www.scrapingcourse.com/ecommerce/"
urls_to_visit = [start_url]
visited_urls = set()
max_pages = 20  # Limite di sicurezza

while urls_to_visit and len(visited_urls) < max_pages:
    current_url = urls_to_visit.pop(0)
    try:
        resp = requests.get(current_url)
        resp.raise_for_status()
    except Exception as e:
        print(f"Impossibile recuperare {current_url}: {e}")
        continue

    soup = BeautifulSoup(resp.text, "html.parser")
    print(f"Crawled: {current_url}")

    for link_tag in soup.find_all("a", href=True):
        url = link_tag['href']
        if not url.startswith("http"):
            url = requests.compat.urljoin(current_url, url)
        if url.startswith(start_url) and url not in visited_urls:
            urls_to_visit.append(url)
    visited_urls.add(current_url)
Questo script crawla fino a 20 pagine e segue solo i link che restano dentro lo stesso sito. Vedrai scorrere ogni URL man mano che viene visitato.
Passo 4: estrarre dati dalle pagine
Mettiamo che ti servano nome e prezzo dei prodotti da ogni pagina. Ecco una via per farlo:
product_data = []

while urls_to_visit and len(visited_urls) < max_pages:
    # ... (come sopra)
    soup = BeautifulSoup(resp.text, "html.parser")
    if "/page/" in current_url or current_url == start_url:
        items = soup.find_all("li", class_="product")
        for item in items:
            name = item.find("h2", class_="product-name")
            price = item.find("span", class_="price")
            link = item.find("a", class_="woocommerce-LoopProduct-link")
            if name and price and link:
                product_data.append({
                    "name": name.get_text(),
                    "price": price.get_text(),
                    "url": link['href']
                })
    # ... (resto della logica di crawling)

# Salva in CSV
import csv
with open("products.csv", "w", newline="") as f:
    writer = csv.DictWriter(f, fieldnames=["name", "price", "url"])
    writer.writeheader()
    writer.writerows(product_data)
print(f"Estratti {len(product_data)} prodotti.")
Ed ecco un file CSV con tutti i prodotti estratti, pronto per l’analisi, per essere caricato altrove o anche solo per fare bella figura con gli amici.
Passo 5: debug e ottimizzazione del crawler
Costruire un crawler è una cosa; renderlo robusto è tutto un altro paio di maniche. Ecco qualche dritta che mi sono guadagnato sul campo, mal di testa compresi:
- Imposta un header User-Agent: parecchi siti sbattono fuori “Python-requests” di default. Fatti passare per un browser:
headers = {"User-Agent": "Mozilla/5.0"} requests.get(url, headers=headers) - Gestisci gli errori con criterio: usa try/except per scavalcare le pagine rotte o bloccate.
- Tieni alla larga i loop infiniti: segnati sempre gli URL già visitati e fissa un tetto massimo di pagine.
- Vai piano con le richieste: infila un
time.sleep(1)tra una chiamata e l’altra per non farti bloccare. - Controlla robots.txt: rispetta sempre le regole di crawling del sito (approfondisci qui).
- Logga ciò che fai: stampa o registra ogni URL mentre lo visiti: in fase di debug vale oro.
Se il crawler viene bloccato, restituisce roba strana o si lascia per strada dei dati, dai un’occhiata agli header, rallenta e verifica di non aver fatto scattare qualche difesa anti-bot.
Thunderbit: il crawling reso semplice dall’AI
Estrai dati da qualsiasi sito web con l’AI Get Started Free
Parliamo ora del tasto “facile” del web crawling: Thunderbit. Per quanto io ami Python, certe volte i dati li vuoi e basta, senza configurazioni, debug o manutenzione. Thunderbit è un’estensione Chrome di AI web scraping che ti fa estrarre dati da qualsiasi sito in un paio di clic.
Cosa rende Thunderbit diverso?
- AI Suggest Fields: l’AI di Thunderbit guarda la pagina e ti propone quali dati puoi estrarre, senza che tu debba ispezionare l’HTML o scrivere selettori.
- No-code, dentro il browser: lavora direttamente nel browser, quindi se la cava anche con siti dietro login e pagine cariche di JavaScript.
- Subpage Scraping: ti servono più dettagli? Thunderbit visita da solo ogni sottopagina, tipo le schede prodotto, e arricchisce la tabella.
- Esportazione immediata: porta i dati in Excel, Google Sheets, Airtable o Notion, senza dover litigare con i CSV.
- Scraping cloud o locale: scegli tra scraping cloud veloce per i siti pubblici o modalità browser per quelli sotto login o più ostici.
- Pianificazione: programmi gli scraping in automatico, senza cron job né server.
Per chi lavora nel business, Thunderbit cambia davvero le carte in tavola. Passi da “mi servono questi dati” a “ecco il mio foglio di calcolo” in pochi minuti, non in ore. E se sei uno sviluppatore, Thunderbit fa squadra con i tuoi script: lo usi per i lavoretti veloci o come rete di sicurezza quando il codice ha bisogno di tirare il fiato.
Curioso di vederlo all’opera? Scarica l’estensione Chrome e prova a estrarre dati dal tuo sito preferito. Il piano gratuito ti fa raccogliere un numero limitato di pagine, mentre i piani a pagamento partono da appena 15 $ al mese per 500 crediti.
Prova gratis Thunderbit AI Web Scraper
Punti chiave da tenere a mente quando crei un Website Crawler in Python
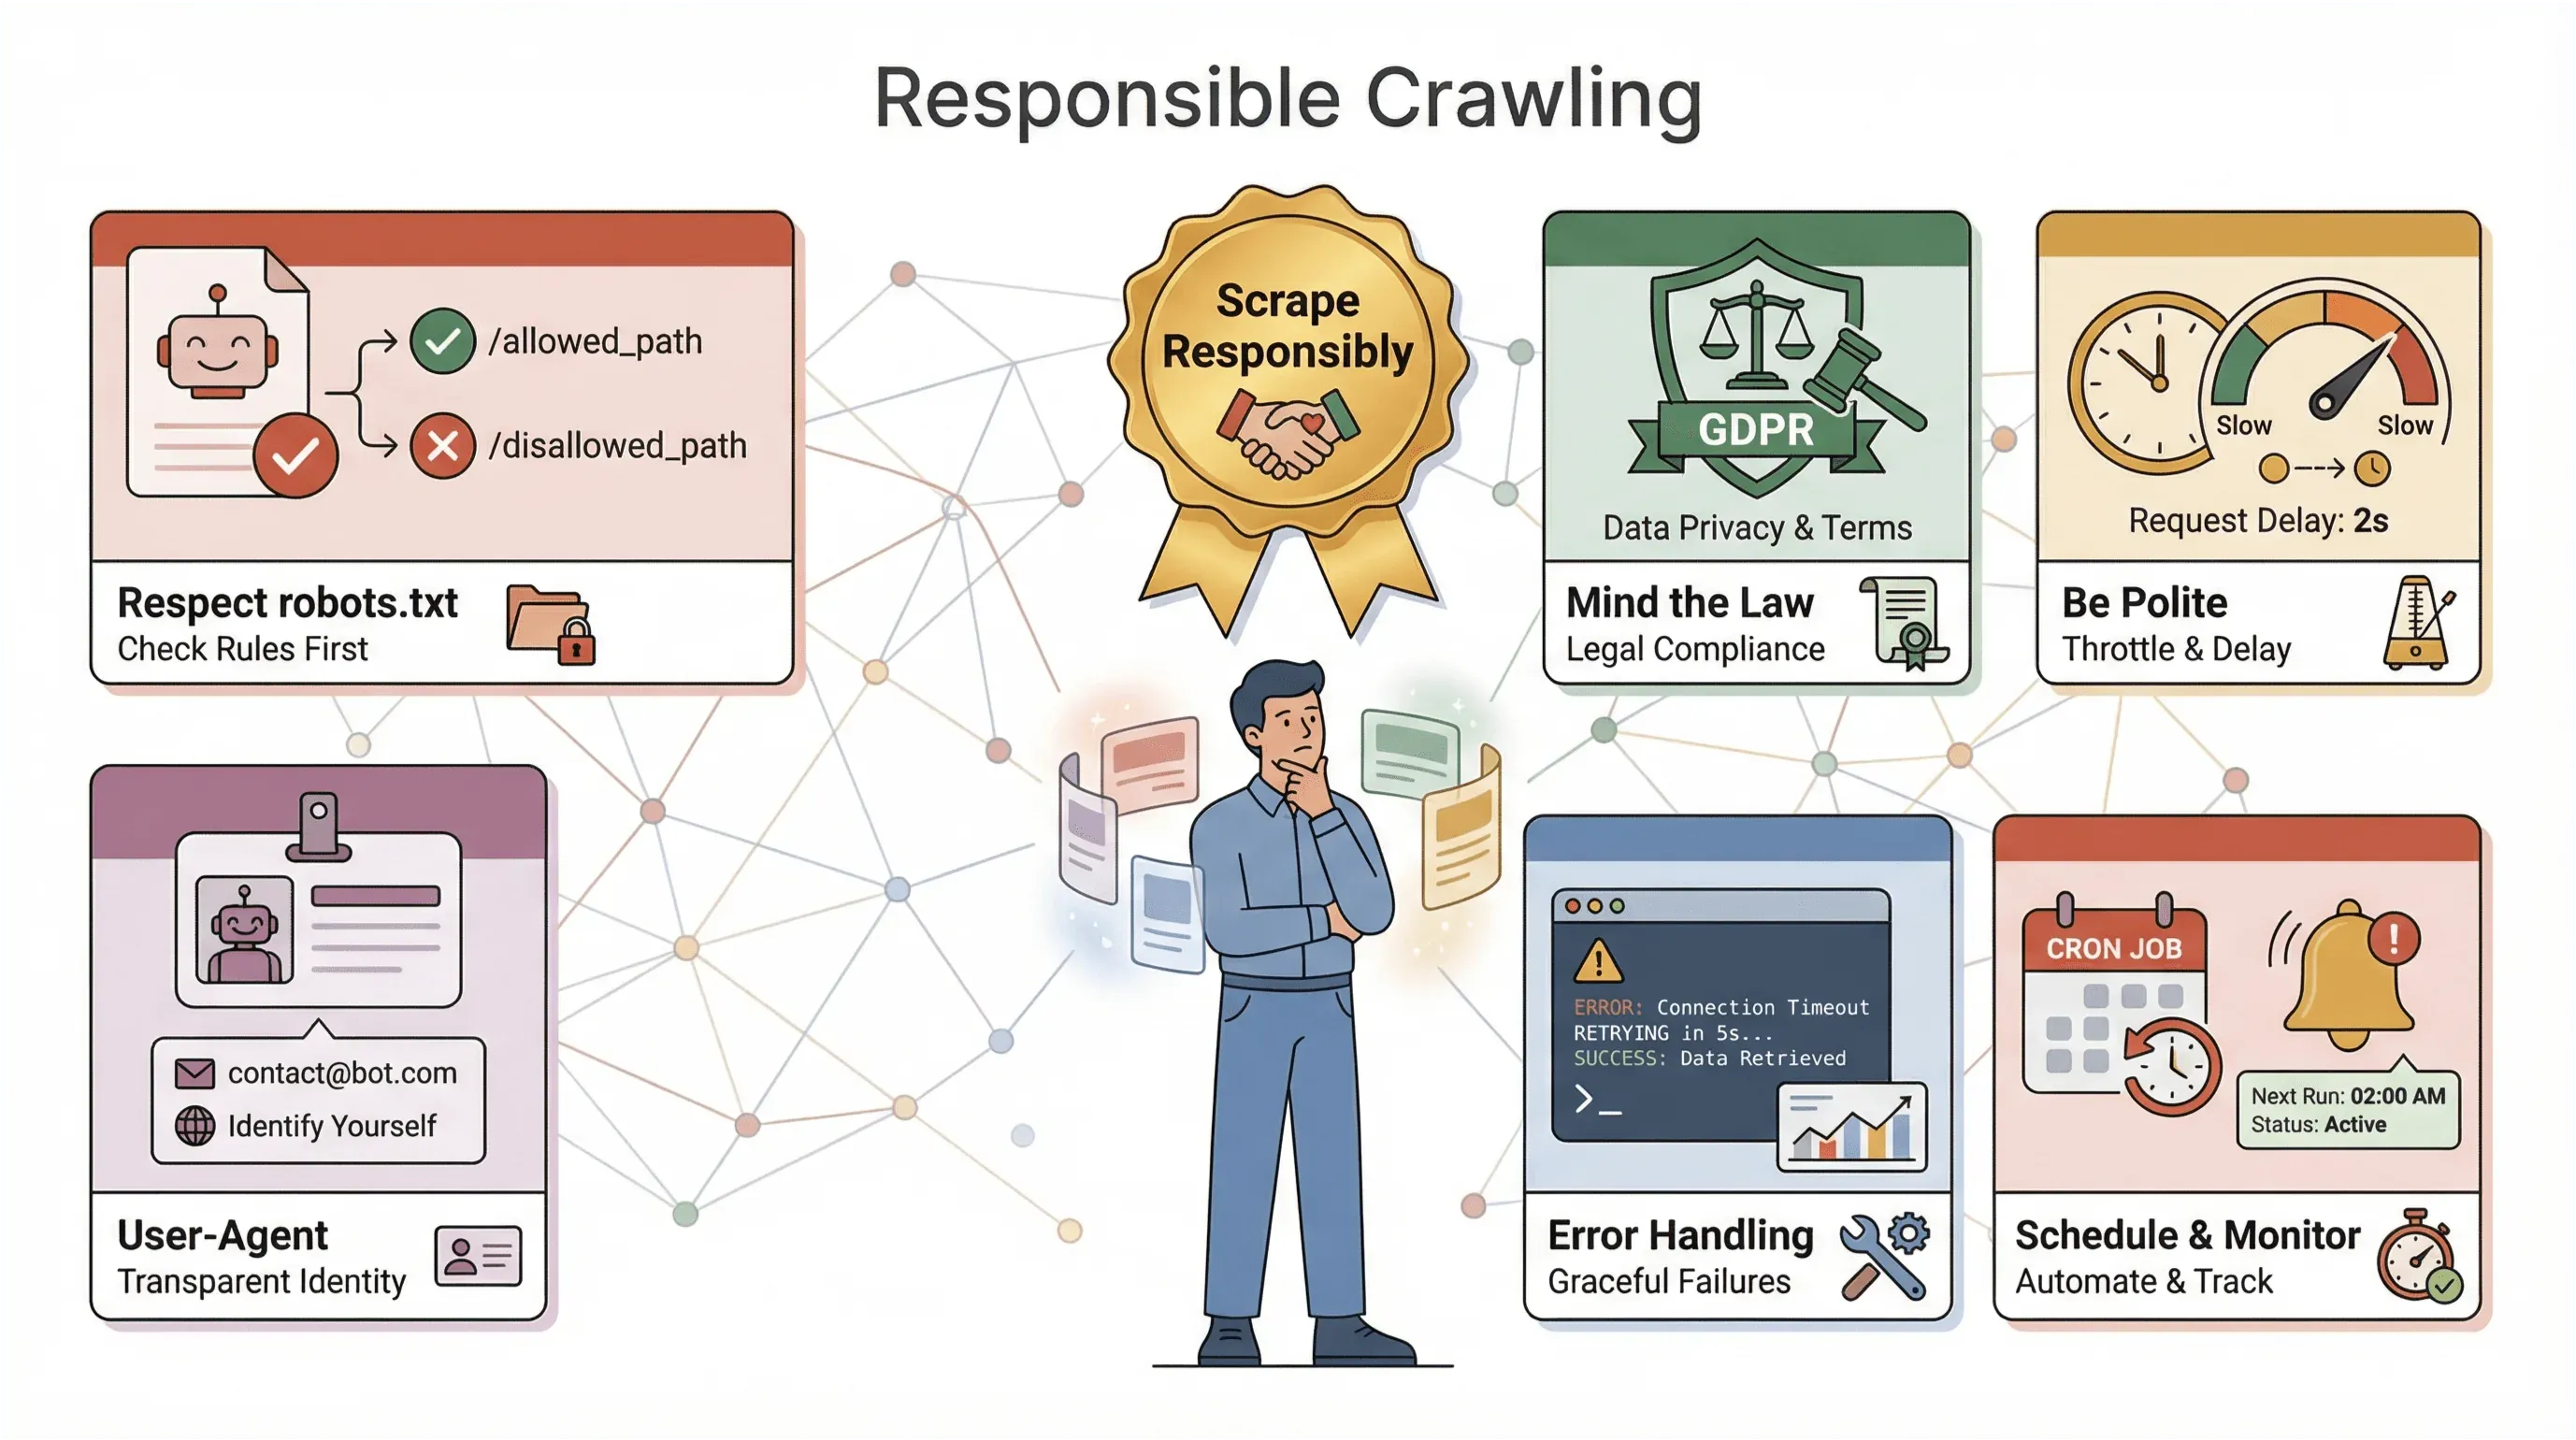 Prima di scatenare il crawler sul web, un paio di avvertenze importanti, più un po’ di sano buon senso da non dimenticare:
- Rispetta robots.txt: quasi tutti i siti pubblicano un file
robots.txtche dice cosa è permesso ai crawler. Tirare dritto può costarti il blocco o, peggio, dei guai legali. Controlla e segui sempre quelle regole (approfondisci qui). - Tieni d’occhio la legge: i termini di servizio di alcuni siti vietano lo scraping. E se raccogli dati personali, possono entrare in gioco normative sulla privacy come GDPR e CCPA (dataprixa.com). Nel dubbio, limitati a dati pubblici e non sensibili.
- Sii educato: non tempestare i siti di richieste a raffica; rallenta il crawler, randomizza le pause ed evita le ore di punta.
- Fatti riconoscere: usa una stringa User-Agent personalizzata e, se fai scraping su larga scala, valuta di lasciare un contatto.
- Gestisci errori e log: i siti cambiano, le pagine si rompono e i dati si sporcano. Metti in piedi error handling, logging e monitoraggio per chiudere i problemi in fretta.
- Pianifica e monitora: per i crawling ricorrenti, appoggiati a strumenti di schedulazione, come cron o lo scheduler integrato di Thunderbit, e imposta alert se il crawler comincia a fallire o a tornare a mani vuote.
La regola d’oro è una: scraping responsabile. Il web è una risorsa di tutti: non essere “quel bot” che rovina la festa agli altri.
Consigli avanzati: scalare e affinare il tuo Website Crawler in Python
Una volta che le basi sono solide, può venirti voglia di alzare l’asticella. Ecco qualche mossa avanzata:
- Gestire il JavaScript: usa Selenium o Playwright per i siti che caricano i dati in modo dinamico.
- Scalare: sui progetti grandi, passa a Scrapy o appoggiati a librerie asincrone, come
aiohttp, per le richieste in parallelo. - Usare proxy: ruota gli indirizzi IP per non farti bloccare quando crawli ad alto volume.
- Automatizzare le pipeline dati: scrivi direttamente su database o integra lo storage cloud per i dataset più grossi.
- Monitoraggio e alert: configura logging, health check e notifiche per i crawler che devono restare in piedi a lungo.
Se il crawler diventa mission-critical, valuta servizi gestiti o API per scaricarti del lavoro. E se fai scraping su più siti con layout diversi, spezza il codice in moduli, così aggiornare i parser diventa un attimo.
In sintesi e punti chiave
Cos’è il Data Scraping e come si fa nel 2025 Get Started Free
Costruire un website crawler in Python è una delle competenze più spendibili che puoi imparare oggi, in un mondo che gira intorno ai dati. Riepiloghiamo:
- I website crawler automatizzano la visita e l’estrazione dei dati dalle pagine: uno strumento che non può mancare per automazione aziendale, ricerca e competitive intelligence.
- Python è la scelta più sensata per costruirli, grazie alla sintassi semplice, alle librerie potenti e a una community sterminata.
- I metodi di parsing fanno la differenza: Regex per le soluzioni al volo, BeautifulSoup per la maggior parte degli script e Scrapy per i progetti grandi.
- Un passo alla volta, si arriva dal recupero di una pagina al crawling di un intero sito con dati strutturati salvati, e senza bisogno di un dottorato.
- Thunderbit spinge tutto ancora più in là, con scraping basato sull’AI, senza codice e con esportazioni immediate: perfetto per gli utenti business o per chi vuole risultati subito.
- Il crawling responsabile è imprescindibile: rispetta le regole dei siti, gestisci gli errori e metti sempre etica e buon senso al primo posto.
- Scalare è alla portata con gli strumenti giusti: Selenium per il JavaScript, Scrapy per il parallelismo o Thunderbit per l’automazione no-code.
Il modo migliore per imparare è partire piccoli: scrivi uno script, prova Thunderbit e scopri quali dati riesci a sbloccare. Il web è un oceano di occasioni, o un buffet di dati, se hai fame come me.
Vuoi andare più a fondo? Dai un’occhiata a queste risorse:
- Cos’è il Data Scraping e come si fa nel 2025
- Come estrarre dati da un sito web in Excel con l’AI
- Thunderbit Blog per altri consigli, guide e tecniche avanzate.
Buon crawling, e che i tuoi scraper siano veloci, i tuoi dati puliti e la tua tazza di caffè sempre piena.
Prova ora Thunderbit AI Web Scraper
FAQ
1. Che differenza c’è tra un website crawler e un web scraper?
Un crawler visita e scopre le pagine in modo sistematico, un po’ come mappare un sito, mentre uno scraper estrae dati precisi da quelle pagine. Nella maggior parte dei progetti reali si usano entrambi: prima si crawlano le pagine, poi si estraggono i dati.
2. Perché Python è così gettonato per creare website crawler?
Python è facile da imparare, ha librerie potenti, come Requests, BeautifulSoup, Scrapy e Selenium, e una community enorme. Quasi il 70% dei progetti di web scraping usa Python, tanto che è diventato lo standard del settore.
3. Quando conviene usare Regex, BeautifulSoup o Scrapy per il parsing?
Regex per i pattern semplici e prevedibili. BeautifulSoup è perfetta per la maggior parte degli script: facile e flessibile. Scrapy dà il meglio sui crawler su larga scala o di produzione che chiedono velocità, parallelismo e funzionalità robuste.
4. Come si pone Thunderbit rispetto a scrivere un crawler in Python?
Thunderbit ti fa estrarre dati con l’AI e senza codice: clicchi, scegli i campi ed esporti. Ideale per gli utenti business o per i lavori veloci. Python ti dà più controllo e personalizzazione, ma chiede codice e manutenzione.
5. A quali questioni legali o etiche devo stare attento quando faccio crawling di siti?
Controlla e rispetta sempre robots.txt, segui i termini di servizio del sito, evita di raccogliere dati sensibili o personali senza consenso e rallenta le richieste per non sovraccaricare i server. Uno scraping responsabile tiene il web aperto per tutti.
Pronto a fare un tentativo? Scarica Thunderbit oppure apri il tuo editor Python preferito e parti col crawling. I dati sono là fuori: vai a prenderteli!
Prova AI Web Scraper Get Started Free
Scopri di più
- Come scrivere un Web Scraper con Python: dall’inizio alla fine
- Python Web Crawler spiegato: dalle basi all’avanzato
- Guida completa al Web Scraping in Python: passo dopo passo
- Come fare crawling di siti web: guida per principianti passo dopo passo
- Come fare crawling di un sito web in modo efficiente: guida passo passo



