
Il web cresce a una velocità che fa sembrare il mio caffè del mattino quasi lento — e credetemi, lo bevo in fretta. Nel 2026, l’estrazione di dati dal web non è più un semplice “plus” per chi lavora in ambito tech: è l’ingrediente segreto che alimenta il sales prospecting, il monitoraggio dei prezzi nell’ecommerce, le ricerche di mercato e perfino le analisi immobiliari. Con oltre il 49% delle aziende che oggi usano strumenti di web scraping ogni settimana, scegliere la libreria o lo strumento giusto può fare la differenza tra ore di lavoro ripetitivo e un foglio di calcolo pieno di insight concreti — pronti prima ancora che la concorrenza finisca il pranzo.
Ma la parte interessante è un’altra: nel 2026 le librerie per il web scraping arrivano in tante forme diverse, dalle estensioni Chrome AI senza codice fino ai framework più avanzati per sviluppatori. Che tu sia un commerciale che vuole solo lead in Excel, un operations manager che monitora 500 SKU, o un mago di Python che costruisce un crawler personalizzato, c’è uno strumento adatto a te. Ho passato anni tra SaaS e automazione (e più notti insonni di quante ne voglia ammettere) a esplorare queste librerie: quindi vediamo insieme le 10 migliori librerie per il web scraping da conoscere quest’anno e come scegliere quella che ti semplificherà davvero la vita.
Cosa rende potente una libreria per il Web Scraping nel 2026?
Estrai dati da qualsiasi sito con l’AI Get Started Free
Prima di entrare nella lista, parliamo di ciò che conta davvero quando si sceglie una libreria per il web scraping. Per esperienza, i migliori strumenti del 2026 hanno alcuni elementi in comune:
- Facilità d’uso: anche chi non programma riesce a ottenere risultati in pochi minuti? Oppure serve quasi un dottorato in Python?
- Gestione dei contenuti dinamici: riesce a estrarre dati da siti moderni e pesanti in JavaScript? Oppure si blocca appena incontra qualcosa di più complesso di un HTML statico?
- Supporto per linguaggi e piattaforme: funziona nel linguaggio che preferisci — Python, JavaScript, Java — o addirittura direttamente nel browser?
- Scalabilità: riesce a gestire centinaia o migliaia di pagine senza andare in crisi?
- Integrazione ed esportazione: si integra bene con Excel, Google Sheets, Notion o con la tua pipeline dati?
- AI e automazione: nel 2026, gli strumenti guidati dall’AI che “funzionano e basta” con prompt in linguaggio naturale sono un enorme vantaggio — soprattutto per chi in azienda preferisce non toccare il codice.
La realtà è che i team business vogliono velocità, precisione e il minor setup possibile. Meno tempo perdi a sistemare scraper che si rompono o a combattere con il codice, più tempo hai per agire sui dati. E con la crescita dell’AI e dell’automazione nel browser, anche gli utenti non tecnici possono oggi estrarre dati che un tempo richiedevano l’aiuto di uno sviluppatore (PromptCloud).
Bene — passiamo alle cose interessanti.
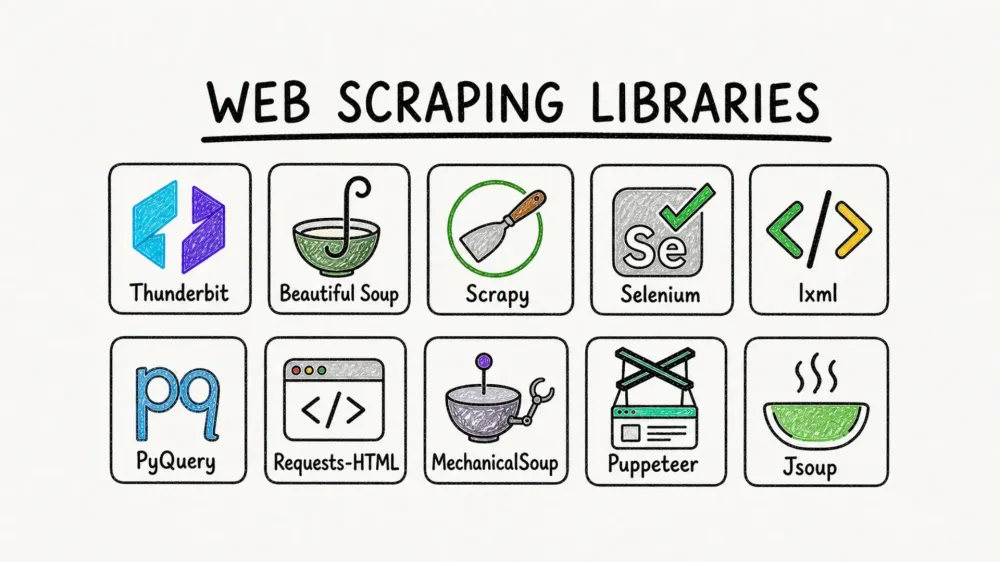
Le 10 migliori librerie potenti per il Web Scraping da usare nel 2026
- Thunderbit per il web scraping no-code e basato sull’AI direttamente nel browser
- Beautiful Soup per il parsing HTML e la pulizia dei dati in Python, in modo semplice
- Scrapy per crawling su larga scala, ad alta velocità e con pipeline strutturate
- Selenium per l’automazione del browser e l’estrazione da siti dinamici, ricchi di JavaScript
- lxml per un parsing XML/HTML velocissimo in Python
- PyQuery per selezionare HTML in Python con sintassi stile jQuery
- Requests-HTML per HTTP, parsing HTML e rendering JavaScript in un’unica soluzione Python
- MechanicalSoup per automatizzare form e attività browser semplici in Python
- Puppeteer per l’automazione di Chrome headless in Node.js
- Jsoup per un parsing HTML solido in Java
1. Thunderbit

Thunderbit è la mia prima scelta per chiunque voglia estrarre dati dal web senza scrivere nemmeno una riga di codice. Questa estensione Chrome basata sull’AI ti permette di descrivere ciò che vuoi (“Recupera tutti i nomi prodotto, i prezzi e le immagini da questa pagina”) e l’AI fa il resto. Niente template, nessuna configurazione: clicchi una volta, modifichi le colonne se vuoi, e l’estrazione parte anche senza ulteriori interventi.
Perché Thunderbit si distingue nel 2026:
- Interfaccia no-code in linguaggio naturale: chiunque può usarlo — sales, operations, marketing, real estate. Nessun bisogno di Python.
- Rilevamento automatico dei campi: l’AI ricava la struttura delle colonne direttamente dalla pagina.
- Estrazione da sottopagine: ti servono più dettagli? Thunderbit può visitare ogni sottopagina (per esempio pagine prodotto o profilo) e arricchire automaticamente la tabella (Thunderbit Blog).
- Template istantanei per siti popolari: Amazon, Zillow, Shopify e molti altri — estrai con un solo clic.
- Esporta in Excel, Google Sheets, Notion, Airtable: i dati arrivano dove serve al tuo team.
- Supporta 34 lingue: perfetto per team internazionali.
- Scraping in cloud o nel browser: scegli il flusso che preferisci — il cloud è velocissimo per i siti pubblici, mentre la modalità browser gestisce i login.
Thunderbit è usato da oltre 200.000 persone nel mondo, e il piano gratuito consente di estrarre fino a 6 pagine (o 10 con il bonus della prova). Se vuoi vedere come appare il web scraping moderno, questo è il posto da cui partire.
Prova gratis Thunderbit AI Web Scraper
2. Beautiful Soup
Beautiful Soup è una libreria Python classica, amatissima da data scientist e analisti per la sua semplicità e per la potenza con cui gestisce HTML disordinato. Se hai mai provato a estrarre dati da una pagina con tag rotti o formattazioni strane, Beautiful Soup è un alleato prezioso.
Perché Beautiful Soup è così utile:
- Gestisce HTML irregolare: perfetta per ripulire ed estrarre dati da pagine web “sporche” (Beautiful Soup Docs).
- Facile da imparare: anche chi è alle prime armi con Python può iniziare rapidamente.
- Flessibile: funziona bene con client HTTP come Requests e può essere combinata con lxml per migliorare la velocità.
- Casi d’uso tipici: estrazione rapida di dati, pulizia di dati web, integrazione con piccoli script.
Se lavori con pagine statiche o devi gestire markup disordinato, Beautiful Soup è una scelta solida.
3. Scrapy
Scrapy è il gigante del web scraping in Python. È un framework completo per costruire crawler scalabili e pipeline dati. Se devi estrarre migliaia di pagine, seguire link e processare dati su larga scala, Scrapy è fatto per questo.
Perché Scrapy è tra i migliori:
- Molto modulare: puoi costruire spider, pipeline e middleware complessi (Scrapy Docs).
- Perfetto per progetti grandi: ideale per ricerche di mercato, analisi competitiva o qualsiasi attività che richieda crawling ed estrazione su molti siti.
- Asincrono e veloce: progettato per offrire velocità ed efficienza.
- Community enorme: tantissimi plugin, tutorial e supporto.
Scrapy richiede un po’ di curva di apprendimento, ma per lavori importanti è una vera potenza.
4. Selenium
Selenium è lo strumento di riferimento per automatizzare i browser. Si usa per tutto: dai test delle web app allo scraping di siti che richiedono login, click o la gestione di popup. Se devi interagire con siti molto dinamici o ricchi di JavaScript, Selenium può imitare un vero utente (ScrapingBee Selenium Guide).
Punti di forza di Selenium:
- Automatizza browser reali: Chrome, Firefox, Safari, Edge — davvero tutti.
- Gestisce login, popup e azioni utente: perfetto per estrarre dati dopo l’autenticazione o per navigare workflow in più passaggi.
- Supporto multi-linguaggio: Python, Java, C# e altri.
- Ideale per: siti che bloccano i semplici scraper o quando serve simulare un comportamento utente reale.
È un po’ più pesante delle librerie basate su HTTP, ma a volte serve proprio un browser vero.
5. lxml
lxml è un parser XML e HTML ad alte prestazioni per Python. Se la tua priorità assoluta è la velocità (pensa: analizzare migliaia di documenti di grandi dimensioni), lxml è difficile da battere (Python HTML Parser Performance).
Perché lxml è così apprezzato:
- Velocissimo: supera molti altri parser Python, soprattutto sui file grandi.
- Robusto: gestisce sia XML che HTML e si integra bene con altri strumenti.
- Ottimo per: elaborare grandi dataset, oppure affiancarlo a Beautiful Soup o Scrapy per ottenere ancora più potenza.
Se fai scraping su larga scala o devi processare file enormi, lxml è uno strumento indispensabile.
6. PyQuery
PyQuery porta in Python la potenza della sintassi di selezione di jQuery. Se ti piace la semplicità con cui in jQuery selezioni elementi con $('.class'), PyQuery ti consente di fare lo stesso nei tuoi script di scraping (PyQuery Docs).
Punti forti di PyQuery:
- Selettori stile jQuery: intuitivi per chi ha familiarità con il front-end.
- Codice conciso e leggibile: semplifica selezioni complesse.
- Si integra con lxml: veloce ed efficiente sotto il cofano.
- Ideale per: progetti in cui vuoi manipolare HTML in Python in modo rapido e familiare.
È un ottimo ponte per chi passa dallo sviluppo web all’estrazione dati.
7. Requests-HTML
Requests-HTML è una libreria Python che unisce la semplicità di Requests per HTTP con il parsing HTML integrato e persino il rendering JavaScript.
Cosa rende Requests-HTML diverso dagli altri:
- Tutto in uno: scarica le pagine, analizza l’HTML e rende anche il JavaScript in un solo pacchetto.
- Adatto ai principianti: perfetto per progetti di scraping piccoli o medi.
- Ideale per: script rapidi, siti con una certa componente dinamica e utenti che cercano semplicità.
Se stai iniziando o ti serve uno strumento flessibile per lavori non troppo complessi, Requests-HTML è una scelta vincente.
8. MechanicalSoup
MechanicalSoup è una libreria Python che automatizza form web e interazioni browser semplici. Si basa su Beautiful Soup e Requests, quindi consente di fare login, compilare moduli e gestire workflow di base con molta facilità (ScrapingBee MechanicalSoup Guide).
Perché MechanicalSoup è utile:
- Automatizza form e login: ottimo per estrarre dati protetti da autenticazione.
- API semplice: facile da imparare anche per chi è alle prime armi.
- Ideale per: attività browser ripetitive, workflow semplici e siti per cui l’automazione completa del browser sarebbe eccessiva.
Non è potente quanto Selenium sui siti complessi, ma è molto più leggero e pratico per esigenze di base.
9. Puppeteer
Puppeteer è una libreria Node.js per controllare Chrome o Chromium in modalità headless. È una delle preferite per lo scraping di siti molto dinamici e ricchi di JavaScript (Scrape.do Puppeteer Guide).
I superpoteri di Puppeteer:
- Automazione completa del browser: clicca, scorri, compila moduli e interagisci proprio come un utente.
- Gestisce contenuti dinamici: perfetto per siti che caricano dati tramite JavaScript.
- Ideale per: ecommerce, social media o qualsiasi sito in cui i tradizionali scraper falliscono.
Se sei uno sviluppatore JavaScript o devi fare scraping del “web moderno”, Puppeteer è imprescindibile.
10. Jsoup
Jsoup è lo standard di riferimento per il parsing HTML in Java. È come Beautiful Soup, ma per chi sviluppa in Java (Baeldung Jsoup Guide).
Perché i team Java amano Jsoup:
- API semplice e potente: estrai e manipola dati con poche righe di codice.
- Gestisce HTML disordinato: pulisce e analizza anche pagine formattate male.
- Ideale per: integrare lo scraping in applicazioni business Java o nei workflow backend.
Se il tuo stack è Java, Jsoup è la scelta più naturale.
Tabella comparativa delle librerie per Web Scraping
Ecco una panoramica rapida, affiancata, delle 10 librerie:
| Libreria | Linguaggio | Facilità d’uso | Contenuti dinamici | AI/No-Code | Casi d’uso tipici | Ideale per |
|---|---|---|---|---|---|---|
| Thunderbit | Ext. Chrome | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Sì | Sales, operations, ricerca, real estate | Chi non programma, utenti business |
| Beautiful Soup | Python | ⭐⭐⭐⭐ | ⭐ | No | Parsing HTML, pulizia dati | Principianti Python, analisti |
| Scrapy | Python | ⭐⭐⭐ | ⭐⭐ | No | Crawling su larga scala, pipeline | Sviluppatori, progetti big data |
| Selenium | Multi | ⭐⭐ | ⭐⭐⭐⭐⭐ | No | Automazione browser, login | QA, siti dinamici |
| lxml | Python | ⭐⭐⭐ | ⭐ | No | Parsing veloce, file grandi | Power user, dataset enormi |
| PyQuery | Python | ⭐⭐⭐⭐ | ⭐ | No | Selezione stile jQuery | Web developer, script concisi |
| Requests-HTML | Python | ⭐⭐⭐⭐ | ⭐⭐ | No | Script rapidi, rendering JS | Principianti, piccoli progetti |
| MechanicalSoup | Python | ⭐⭐⭐⭐ | ⭐⭐ | No | Automazione form, login | Attività browser semplici |
| Puppeteer | Node.js | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | No | Siti pesanti in JS, automazione | Sviluppatori JS, scraping dinamico |
| Jsoup | Java | ⭐⭐⭐⭐ | ⭐ | No | Parsing HTML in Java | Team Java, workflow backend |
Come scegliere la libreria giusta per il Web Scraping nella tua azienda
Cos’è il data scraping e come farlo nel 2025 Get Started Free
Quindi, quale libreria dovresti usare? Ecco il mio consiglio, dopo anni di tentativi, errori e qualche sessione di debug fin troppo notturna:
- Chi non programma o utenti business: parti da Thunderbit. L’approccio AI/no-code ti permette di ottenere risultati in minuti, non in giorni. Se il tuo team vuole semplicemente dati in Excel o Sheets, non complicarti la vita.
- Sviluppatori Python: Beautiful Soup e Requests-HTML sono ottimi per i lavori piccoli. Scrapy è il tuo alleato per i progetti grandi. Combinalo con lxml o PyQuery per ottenere ancora più potenza.
- Devi gestire login o contenuti dinamici? Selenium (multi-linguaggio) o Puppeteer (Node.js) sono le scelte migliori.
- Team Java: Jsoup è il vincitore indiscusso per integrare lo scraping nelle applicazioni Java.
- Ti serve automatizzare form o workflow semplici? MechanicalSoup è leggero e facile da usare.
Fattori chiave da valutare:
- Livello tecnico: strumenti no-code come Thunderbit sono perfetti per team non tecnici. Gli sviluppatori potrebbero preferire la flessibilità delle librerie basate su codice.
- Complessità dei dati: per pagine semplici e statiche, Beautiful Soup o Jsoup sono ottime. Per siti dinamici e ricchi di JavaScript, meglio Selenium o Puppeteer.
- Scala: Scrapy e lxml brillano nei lavori ad alta velocità e su larga scala.
- Integrazione: l’esportazione diretta di Thunderbit verso Sheets, Notion e Airtable fa risparmiare tantissimo tempo nei workflow aziendali.
Per approfondire come scegliere lo strumento giusto, leggi la guida di PromptCloud.
Scopri i prezzi di Thunderbit e il piano gratuito
Conclusione: sbloccare i dati del web con gli strumenti giusti
Nel 2026 il web scraping non è più roba solo da programmatori o data scientist. Con l’esplosione degli strumenti AI e no-code, ogni team — dalle vendite alla ricerca — può attingere alla miniera d’oro dei dati del web. La libreria giusta può farti risparmiare centinaia di ore all’anno (Browsercat), aumentare la precisione e dare alla tua azienda un vantaggio reale.
Il mio consiglio? Parti dalle tue esigenze — velocità, scala, familiarità tecnica — e prova alcune opzioni. Il piano gratuito di Thunderbit è un ottimo modo per iniziare, mentre librerie open source come Beautiful Soup o Scrapy restano sempre lì se vuoi sporcarti le mani.
Vuoi approfondire? Dai un’occhiata al blog di Thunderbit per altre guide, oppure iscriviti al nostro canale YouTube per tutorial pratici.
Buon scraping — e che i tuoi dati siano sempre puliti, ben strutturati e pronti all’azione.
Prova gratis Thunderbit AI Web Scraper Get Started Free
FAQ
1. Qual è la libreria di web scraping più semplice per chi non programma nel 2026?
Thunderbit è la scelta migliore per chi non programma. La sua estensione Chrome basata sull’AI permette di estrarre dati con prompt in linguaggio naturale, senza scrivere codice.
2. Quale libreria è la migliore per estrarre dati da siti dinamici o ricchi di JavaScript?
Puppeteer (Node.js) e Selenium (multi-linguaggio) sono le opzioni migliori per siti dinamici renderizzati in JavaScript. Automatizzano browser reali e gestiscono interazioni complesse.
3. Qual è la differenza tra Beautiful Soup e Scrapy?
Beautiful Soup è ottimo per analizzare ed estrarre dati da pagine singole o piccoli progetti, soprattutto quando l’HTML è disordinato. Scrapy è un framework completo per costruire crawler scalabili e processare grandi dataset.
4. Posso esportare i dati estratti direttamente in Google Sheets o Notion?
Sì — Thunderbit offre esportazione diretta verso Google Sheets, Notion, Airtable ed Excel. La maggior parte delle librerie basate su codice richiede di scrivere da soli la logica di esportazione.
5. Come scelgo la libreria di web scraping giusta per la mia azienda?
Valuta le competenze tecniche del team, la complessità dei siti da estrarre, il volume dei dati e le necessità di integrazione. Gli strumenti no-code come Thunderbit sono ideali per i team business, mentre gli sviluppatori possono preferire librerie come Scrapy, Beautiful Soup o Puppeteer per avere più controllo.
Scopri di più
- Le 10 migliori librerie Python per Web Scraping e un’alternativa AI
- I 7 strumenti di web scraping più popolari da usare nel 2026
- I 5 migliori software per il web data scraping nel 2026
- I migliori strumenti e software per il Web Scraping nel 2025
- Come estrarre dati da un sito web in modo efficiente con i migliori strumenti



