
Quasi metà del traffico Internet ormai è generato dai bot. La maggior parte serve a estrarre link, dati e URL su larga scala. Se lo fai ancora a mano, stai restando indietro.
Ho testato 12 strumenti per l’estrazione di link — dalle estensioni Chrome potenziate dall’AI alle librerie Python — per capire quali funzionano davvero quando devi estrarre migliaia di URL in tempi stretti.
Ecco cosa ho scoperto.
Perché gli estrattori di link sono importanti
Diciamolo senza girarci intorno: il web è pieno zeppo di dati e le aziende stanno correndo per trasformare questo caos in insight utili. Link extractor e URL extractor sono ormai strumenti indispensabili per i team che vogliono:
- Generare lead: i team sales possono estrarre in pochi minuti i link ai profili aziendali da directory o LinkedIn e poi passarli a strumenti che recuperano i contatti. Basta clic infiniti.
- Raccogliere contenuti e migliorare la SEO: i marketer possono raccogliere tutti gli URL degli articoli di un blog, monitorare i backlink dei competitor o analizzare la struttura di un sito per scovare link rotti.
- Monitorare i competitor e fare ricerche di mercato: i team operations possono raccogliere in automatico link a nuovi prodotti, pagine prezzi o comunicati stampa, tenendo d’occhio la concorrenza senza impazzire.
- Automatizzare i workflow e risparmiare tempo: i moderni link scraper gestiscono URL in blocco, navigano tra le sottopagine ed esportano i dati in formati strutturati (CSV, Excel, Google Sheets, Notion e così via). Vuol dire dire addio a maratone di copia-incolla e file di testo da ripulire.
Considerando che ogni giorno vengono scansionate decine di miliardi di pagine web, farlo a mano non è proprio una strada praticabile. Il giusto estrattore di link è come avere un assistente instancabile che non perde mai un link e non chiede pause caffè.
Come abbiamo scelto i migliori estrattori di link
Con così tanti strumenti sul mercato, scegliere quello giusto può sembrare un speed date a una conferenza tech: tutti dicono di essere “quello giusto”, ma solo pochi mantengono davvero la promessa. Ecco come ho ristretto la selezione ai 12 migliori:
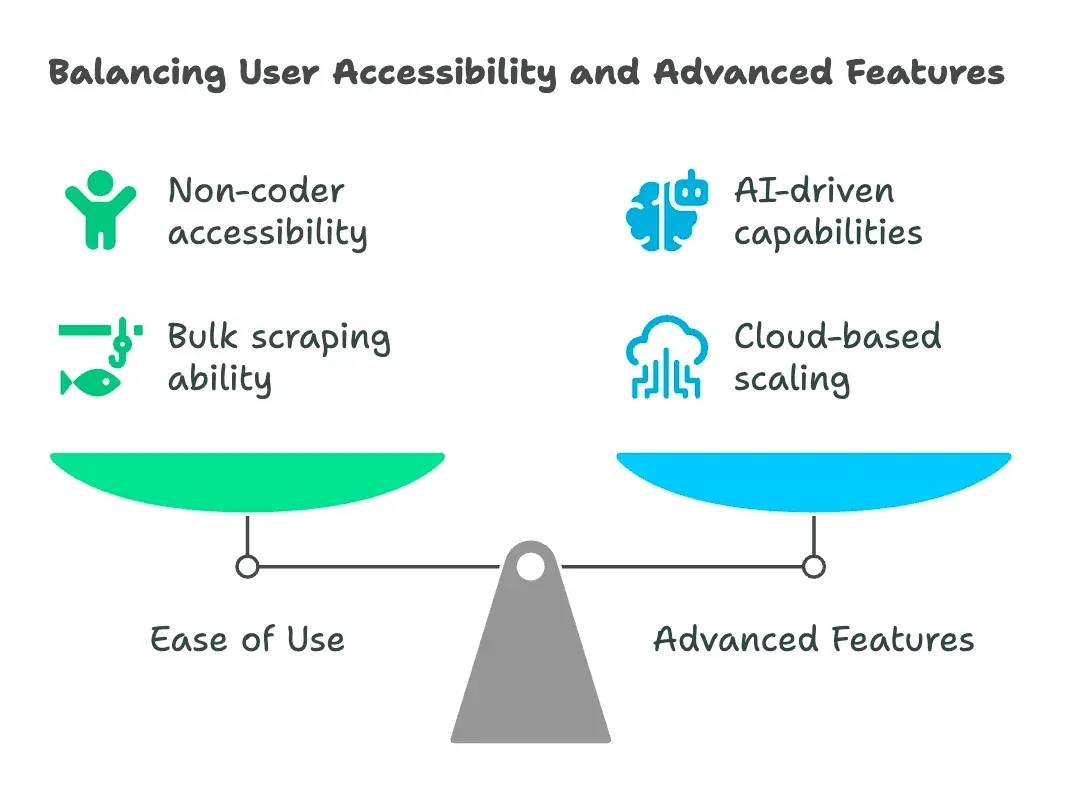
- Facilità d’uso: anche chi non sa programmare può usarlo senza un dottorato in regex? Le soluzioni no-code e low-code hanno guadagnato punti extra.
- Estrazione in blocco e a più livelli: riesce a gestire centinaia di URL in una volta sola? Crawlerizza le sottopagine e segue i link in automatico?
- Export e integrazioni: esporta in CSV, Excel, Google Sheets, Notion, Airtable o via API? Meno lavoro manuale c’è, meglio è.
- Tipo di utente e flessibilità: è pensato per utenti business, analisti o sviluppatori? Alcuni strumenti sono per tutti, altri più di nicchia.
- Funzioni avanzate: riconoscimento basato su AI, pianificazione, scalabilità cloud, pulizia dei dati e template per siti comuni.
- Prezzo e scalabilità: piano gratuito, pay-as-you-go o enterprise? Ho valutato il rapporto tra costo e valore.
Ho incluso un po’ di tutto, dalle estensioni browser alle piattaforme enterprise: quindi, che tu sia un founder in solitaria o un team dati di una Fortune 500, troverai qualcosa che fa per te.
Thunderbit: l’estrattore di link più intelligente per utenti business
Partiamo dal migliore. Thunderbit è il mio consiglio principale per l’estrazione di link, e non solo perché ho contribuito a crearlo. Thunderbit è un’estensione Chrome AI web scraper pensata per utenti business che vogliono risultati, e subito.
Cosa rende Thunderbit diverso? È come avere uno stagista AI che ascolta davvero. Puoi descrivere in linguaggio naturale quello che ti serve (“Prendi tutti i link dei prodotti e i prezzi da questa pagina”) e l’AI di Thunderbit si occupa del resto. Niente selettori da modificare, niente script da scrivere.
Ma non finisce qui:
- Supporto per URL in blocco: incolla un singolo URL o un elenco di centinaia — Thunderbit li gestisce tutti in un’unica esecuzione.
- Navigazione nelle sottopagine: devi estrarre link da una pagina elenco e poi visitare ogni pagina dettaglio per ottenere altri URL? La logica di scraping multilivello di Thunderbit ti copre.
- Export strutturato: una volta estratti i link, puoi rinominare i campi, categorizzarli ed esportarli direttamente in Google Sheets, Notion, Airtable, Excel o CSV. Niente più rogne di post-processing.
Estrai link da qualsiasi sito web usando l’AI Get Started Free
Thunderbit è usato da oltre 200.000 utenti in tutto il mondo, dai team sales agli agenti immobiliari fino ai piccoli e-commerce indipendenti. E sì, c’è anche un piano gratuito (fino a 6 pagine, oppure 10 con il boost di prova), quindi puoi provarlo senza rischi.
Prova gratis l’estrattore di link di Thunderbit
Le caratteristiche distintive di Thunderbit
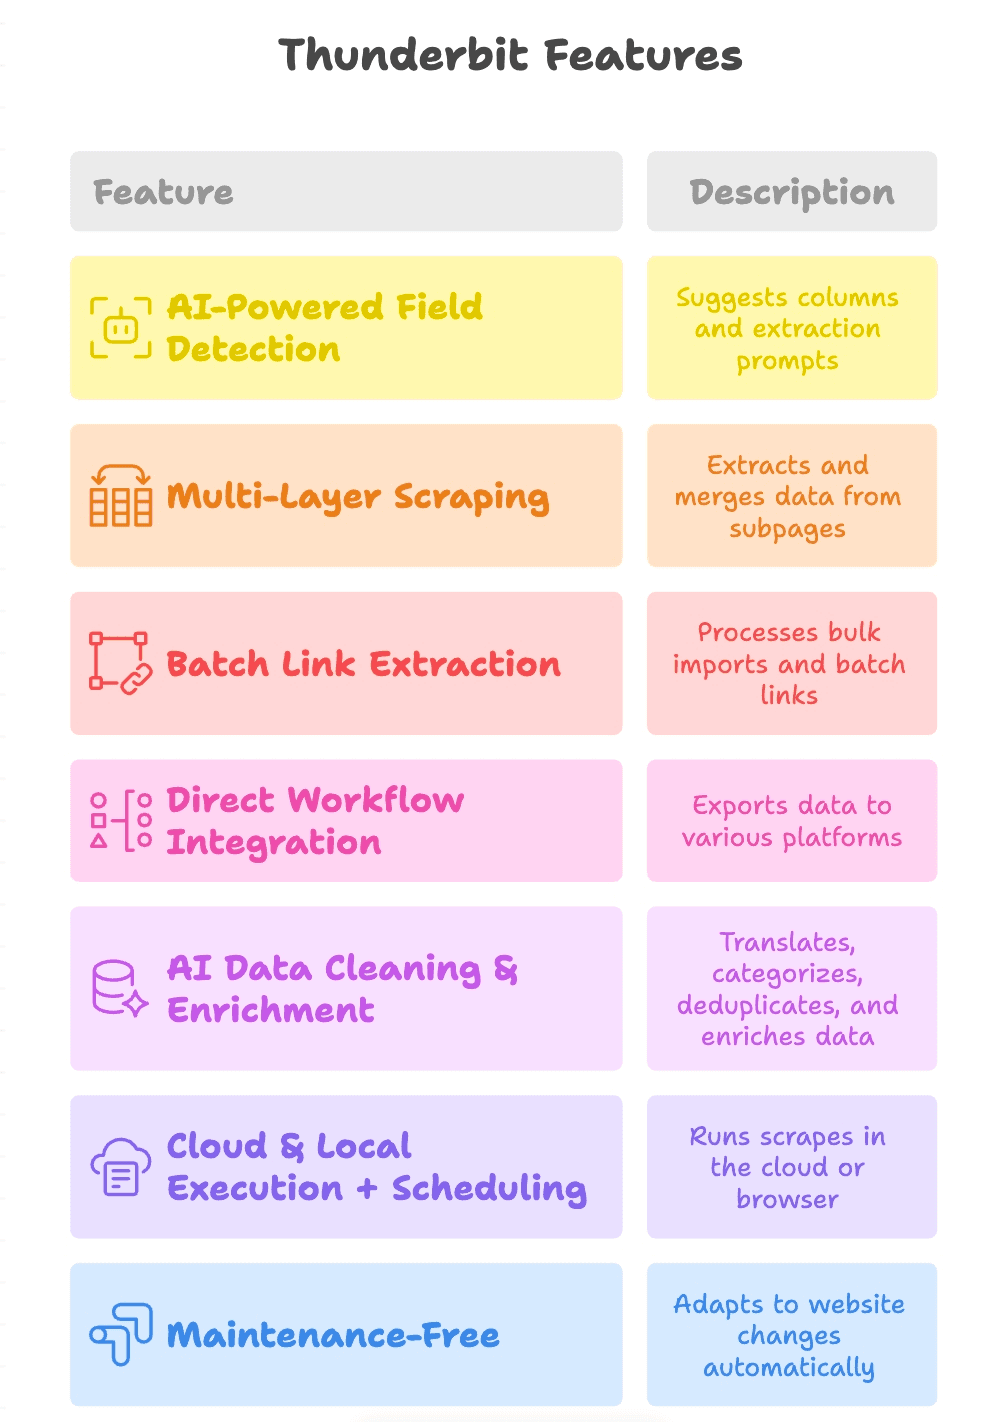
Vediamo meglio cosa rende Thunderbit davvero speciale:
- Rilevamento dei campi basato su AI: basta cliccare su “AI Suggest Fields” e Thunderbit legge la pagina, suggerisce le colonne (come “Link prodotto”, “URL PDF”, “Email contatto”) e crea persino i prompt di estrazione per ogni campo.
- Scraping multilivello: Thunderbit può seguire i link da una pagina principale alle sottopagine (come le schede prodotto o i download PDF), estrarre altri link e unire tutto in un’unica tabella.
- Estrazione in batch: che tu stia estraendo una pagina o mille, Thunderbit gestisce importazioni massive ed estrazione di link in batch con estrema facilità.
- Integrazione diretta nei workflow: esporta i risultati in Google Sheets, Notion, Airtable oppure scaricali in CSV/Excel. I dati arrivano esattamente dove servono al tuo team.
- Pulizia e arricchimento dati con AI: Thunderbit può tradurre, categorizzare, deduplicare e persino arricchire i dati mentre esegue lo scraping — così l’output è già pronto all’uso, non un semplice dump grezzo.
- Esecuzione cloud e locale + pianificazione: esegui gli scraping nel cloud per avere più velocità, oppure nel browser per i siti che richiedono il login. Pianifica job ricorrenti per tenere i dati sempre aggiornati.
- Senza manutenzione: l’AI di Thunderbit si adatta ai cambiamenti dei siti web, così passi meno tempo a sistemare scraper rotti e più tempo a ottenere risultati.
Octoparse: lo scraper di link no-code per tutti
Octoparse è un classico nel mondo dello scraping no-code. È un’app desktop (Windows/Mac) con un’interfaccia visiva, basata su click. Carichi una pagina, fai clic sui link che ti interessano e Octoparse fa il resto.
- Ottimo per chi inizia: non serve programmare. Basta cliccare, estrarre e via.
- Gestisce paginazione e contenuti dinamici: Octoparse può cliccare i pulsanti “Avanti”, scorrere la pagina e persino effettuare il login su alcuni siti.
- Scraping cloud e pianificazione: i piani a pagamento permettono di eseguire job nel cloud e programmare attività ricorrenti.
- Opzioni di export: scarica i dati in CSV, Excel, JSON o inviali a database.
Il piano gratuito è abbastanza generoso per piccoli lavori (fino a 10 task e 50.000 righe al mese), ma gli utenti più intensivi avranno bisogno di un piano a pagamento (da circa 69 $/mese).
Apify: estrattore di URL flessibile per workflow personalizzati
Apify è il coltellino svizzero del web scraping. Offre un marketplace di “actor” predefiniti (strumenti di scraping), oltre alla possibilità di scrivere i propri script in JavaScript o Python.
- Pronto all’uso ma personalizzabile: usa gli actor della community per attività comuni, oppure costruiscine uno per workflow su misura.
- Scraping in blocco e pianificato: metti in coda gli URL, esegui job in parallelo e programma estrazioni ricorrenti.
- API-first: esporta in JSON, CSV, Excel o Google Sheets e integralo nella tua pipeline dati.
- Pay-as-you-go: crediti gratuiti ogni mese, poi fatturazione basata sull’uso.
Apify è perfetto per team semi-tecnici e sviluppatori che cercano flessibilità e scalabilità.
Bright Data URL Scraper: scraping di link di livello enterprise
Bright Data è pensato per le aziende che devono estrarre dati su larga scala. La loro Web Scraper API offre scraper preimpostati e pronti all’uso per lavori ad alto volume.
- Gestisce volumi enormi: estrae migliaia o milioni di pagine, con un’infrastruttura proxy robusta per evitare blocchi.
- Template predefiniti: scraper già pronti per e-commerce, social, real estate e altro ancora.
- Funzioni enterprise: strumenti di compliance, supporto di esperti e anti-blocking avanzato.
- Prezzi: piano gratuito (5.000 crediti/mese), poi 1,50 $/1k record PAYG o 499 $/mese per lo Scale — sempre in fascia enterprise.
Se sei una startup, potrebbe essere più del necessario. Ma per scraping mission-critical ad alto volume, Bright Data è una vera potenza.
WebHarvy: estrattore di link visivo con semplicità point-and-click
WebHarvy è un’app desktop (Windows) che ti permette di estrarre link semplicemente cliccandoci sopra nel browser integrato.
- Estrema semplicità: fai clic su un link e WebHarvy evidenzia tutti gli elementi simili da estrarre.
- Supporto alle espressioni regolari: pattern integrati per attività comuni, senza bisogno di scrivere codice.
- Export in Excel, CSV, JSON, XML, SQL: perfetto per utenti business che vogliono i dati in formati familiari.
- Licenza una tantum: paghi una volta e lo usi per sempre.
Ideale per piccole imprese, ricercatori o chiunque voglia un modo rapido e senza complicazioni per ottenere link senza programmare.
Web Scraper (Chrome Extension): scraping rapido dei link direttamente nel browser
La Web Scraper Chrome Extension è uno strumento gratuito e open-source che trasforma il browser in uno scraper.
- Definizione dei sitemap: gli dici come navigare e cosa estrarre.
- Gestisce paginazione e crawling multilivello: esplora categorie, sottocategorie e pagine dettaglio.
- Export in CSV/XLSX: scarica i dati direttamente dal browser.
- Template della community: tanti sitemap condivisi per siti popolari.
È perfetta per lavori veloci e occasionali, oppure per studenti e piccoli team con budget limitato.
ScraperAPI: scraper di link scalabile per sviluppatori
ScraperAPI è pensato per sviluppatori che vogliono recuperare pagine web su larga scala senza preoccuparsi di proxy, blocchi o CAPTCHA.
- Basato su API: invii un URL e ricevi HTML o dati estratti.
- Gestisce scala e anti-bot: rotazione dei proxy, rendering JavaScript e risoluzione CAPTCHA integrati.
- Si integra con il tuo codice: usabile con Python, Node.js o qualsiasi altro linguaggio.
- Prezzi: prova gratuita (~5.000 crediti API), poi pagamento per richiesta.
Ottimo per crawler personalizzati o quando ti servono affidabilità e velocità su larga scala.
ParseHub: scraper di link visivo con selezione avanzata
ParseHub è un’app desktop (Windows, Mac, Linux) che ti permette di creare progetti di scraping in modo visivo.
- Selezione e navigazione avanzate: clicca, ripeti in loop ed estrai link in modo condizionale, anche da elementi dinamici o nascosti.
- Gestisce pagine annidate: esplora categorie, poi pagine dettaglio e poi estrai altri link.
- Export in CSV, Excel, JSON: esecuzioni cloud e accesso API nei piani a pagamento.
- Piano gratuito: 5 progetti, fino a 200 pagine per esecuzione.
ParseHub è molto apprezzato da marketer e ricercatori che vogliono potenza senza codice.
Scrapy: estrattore di link Python per sviluppatori
Scrapy è lo standard di riferimento per gli sviluppatori Python che vogliono il controllo totale.
- Approccio code-first: crea spider personalizzati per esplorare ed estrarre link su qualsiasi scala.
- Supporta crawling distribuito: efficiente, asincrono e altamente personalizzabile.
- Export in CSV, JSON, XML o database: sei tu a decidere l’output.
- Open-source e gratuito: ma dovrai gestire tu l’ambiente.
Se ti trovi a tuo agio con Python, Scrapy è difficile da battere in termini di potenza.
Diffbot: scraper di link potenziato dall’AI per dati strutturati
Diffbot è il “cervello AI” del web scraping. Analizza le pagine e restituisce dati strutturati — link inclusi — senza configurazioni manuali.
- Riconoscimento automatico dei contenuti: dai un URL e ottieni dati strutturati (articoli, prodotti, link, ecc.).
- Crawlbot e Knowledge Graph: esplora interi siti o interroga il loro enorme indice web.
- Basato su API: integrabile con strumenti BI o pipeline dati.
- Prezzo enterprise: parte da circa 299 $/mese, ma si paga anche per il valore ricevuto.
Perfetto per aziende che vogliono dati puliti e strutturati senza dover gestire gli scraper.
Cheerio: estrattore di link leggero per Node.js
Cheerio è un parser HTML rapido, simile a jQuery, per Node.js.
- Molto veloce: analizza l’HTML in pochi millisecondi.
- Sintassi familiare: se conosci jQuery, sai già usare Cheerio.
- Perfetto per pagine statiche: non esegue il rendering JavaScript, ma è ideale per contenuti renderizzati lato server.
- Open-source e gratuito: puoi affiancarlo ad axios o fetch per le richieste.
Ideale per sviluppatori che costruiscono script personalizzati e cercano velocità e semplicità.
Puppeteer: automazione browser per lo scraping avanzato di link
Puppeteer è una libreria Node.js per controllare Chrome in modalità headless.
- Automazione completa del browser: carica pagine, clicca, scorre e interagisce come un vero utente.
- Gestisce contenuti dinamici e login: perfetto per siti ricchi di JavaScript o workflow complessi.
- Controllo fine: attendi elementi, fai screenshot, intercetta richieste di rete.
- Open-source e gratuito: ma più pesante in termini di risorse e più lento degli strumenti leggeri.
Usa Puppeteer quando devi estrarre link da siti che non collaborano con gli scraper più basilari.
Confronto rapido: quale estrattore di link fa per te?
Ecco un confronto veloce dei 12 strumenti:
| Strumento | Ideale per | Supporto per batch e sottopagine | Opzioni di export | Prezzo |
|---|---|---|---|---|
| Thunderbit | Non programmatori, business | Sì (AI, multilivello) | Excel, CSV, Sheets, Notion, Airtable | Prova gratuita, da circa 9 $/mese |
| Octoparse | Utenti no-code, analisti | Sì | CSV, Excel, JSON, cloud storage | Piano gratuito, circa 69 $/mese |
| Apify | Semi-tech, sviluppatori | Sì | CSV, JSON, Sheets via API | Crediti gratuiti, uso a consumo |
| Bright Data | Enterprise | Sì (alto volume) | CSV, JSON, NDJSON via API | Piano gratuito, poi 1,50 $/1k record |
| WebHarvy | Non programmatori, desktop | Sì | Excel, CSV, JSON, XML, SQL | Licenza a pagamento |
| Web Scraper Extension | Chiunque, lavori rapidi/gratuiti | Sì | CSV, XLSX | Gratis, open-source |
| ScraperAPI | Sviluppatori, utenti API | Sì | JSON (HTML via API) | 5k crediti di prova gratuiti, piani a pagamento |
| ParseHub | Non programmatori, avanzato | Sì | CSV, Excel, JSON, API | 5 progetti gratuiti, poi a pagamento |
| Scrapy | Sviluppatori Python | Sì | CSV, JSON, XML, DB | Gratis, open-source |
| Diffbot | Enterprise, AI | Sì (crawling AI) | JSON (dati strutturati via API) | da circa 299 $/mese+ |
| Cheerio | Sviluppatori Node.js | Sì (codice personalizzato) | Personalizzato (JSON, ecc.) | Gratis, open-source |
| Puppeteer | Sviluppatori, siti complessi | Sì (automazione completa) | Personalizzato (output da script) | Gratis, open-source |
Scegliere lo scraper di link giusto per la tua azienda
Quindi, come si sceglie? Ecco la mia guida rapida:
- Nessuna competenza di coding? Parti da Thunderbit, Octoparse, ParseHub, WebHarvy o dall’estensione Web Scraper.
- Ti servono workflow personalizzati? Apify, ScraperAPI o Cheerio sono ottimi per gli sviluppatori.
- Scala enterprise? Bright Data o Diffbot sono fatti apposta.
- Sviluppatore Python o Node.js? Scrapy (Python) oppure Cheerio/Puppeteer (Node.js) ti danno pieno controllo.
- Vuoi export diretto in Sheets/Notion? Thunderbit è la scelta migliore.
Scegli lo strumento in base al tuo livello tecnico, al volume di dati e alle esigenze di integrazione. La maggior parte offre prove gratuite, quindi non aver paura di sperimentare.
Scopri altre guide sul web scraping Get Started Free
Il valore unico di Thunderbit per l’estrazione di link nel 2026
Torniamo a vedere cosa rende Thunderbit davvero diverso:
- Semplicità potenziata dall’AI: descrivi in linguaggio naturale ciò che ti serve — l’AI di Thunderbit fa il resto.
- Scraping multilivello: estrai link dalle pagine principali, segui le sottopagine e raccogli altri URL, tutto in un unico flusso.
- Import in blocco ed elaborazione batch: incolla centinaia di URL, estrai i link in massa ed esporta dati strutturati all’istante.
- Integrazione nei workflow: esporta direttamente in Google Sheets, Notion, Airtable o scarica in CSV/Excel.
- Manutenzione zero: l’AI di Thunderbit si adatta ai cambiamenti dei siti, così non devi sistemare di continuo scraper che si rompono.
Thunderbit colma il divario tra “estrarre dati” e “ottenere dati davvero utilizzabili”. È lo strumento che avrei voluto avere anni fa, quando ero sommerso da attività manuali sui dati.
Inizia gratis l’estrazione di link con Thunderbit
Conclusione: estrai i link in modo più intelligente e migliora i tuoi workflow
I dati web sono il carburante della crescita aziendale — e il giusto estrattore di link è il tuo motore. Che tu stia costruendo liste di lead, monitorando i competitor o automatizzando la ricerca, qui c’è uno strumento adatto alle tue esigenze e alle tue competenze.
Se vuoi vedere come funziona l’estrazione di link moderna, prova la versione gratuita di Thunderbit. Credo che resterai sorpreso da quanto puoi fare in pochi clic. E se Thunderbit non fosse il fit perfetto, prova anche alcuni degli altri strumenti di questa lista: non c’è mai stato momento migliore per automatizzare le attività noiose e concentrarsi su ciò che conta davvero.
Buono scraping — e che i tuoi link siano sempre puliti, strutturati e pronti all’uso. Se vuoi approfondire il web scraping, visita il Thunderbit Blog per altre guide e consigli.
Prova gratis l’estrattore di link Thunderbit Get Started Free
FAQ
1. Perché gli estrattori di link sono essenziali?
Con quasi metà del traffico Internet generato dai bot e le aziende che estraggono dati in modo aggressivo, gli estrattori di link sono fondamentali per trasformare il caos del web in insight azionabili. Aiutano ad automatizzare attività come generazione di lead, aggregazione di contenuti, audit SEO e monitoraggio dei competitor, facendo risparmiare enormi quantità di tempo e fatica.
2. Cosa rende Thunderbit diverso dagli altri estrattori di link?
Thunderbit usa l’AI per semplificare lo scraping: basta descrivere il tuo obiettivo in linguaggio naturale e lui fa il resto. Supporta input di URL in blocco, scraping multilivello, rilevamento intelligente dei campi ed export fluido verso piattaforme come Google Sheets e Notion. È ideale per chi non programma e per utenti business che vogliono risultati potenti senza complessità tecnica.
3. Esistono estrattori di link adatti agli sviluppatori e ai workflow personalizzati?
Sì. Strumenti come Apify, ScraperAPI, Cheerio, Puppeteer e Scrapy sono pensati per gli sviluppatori. Offrono scripting, integrazione via API e la flessibilità necessaria per gestire attività di scraping complesse, lavori su larga scala e automazione avanzata.
4. Quali strumenti sono migliori per chi non ha esperienza di programmazione?
Thunderbit, Octoparse, ParseHub, WebHarvy e l’estensione Web Scraper Chrome sono le scelte migliori per gli utenti non tecnici. Questi strumenti offrono interfacce visuali, template predefiniti e funzioni basate su AI che rendono l’estrazione di link accessibile a tutti.
5. Come scelgo l’estrattore di link giusto per le mie esigenze?
Valuta competenze tecniche, volume di dati ed esigenze di export. Chi non programma dovrebbe orientarsi su strumenti come Thunderbit o Octoparse, mentre gli sviluppatori potrebbero preferire Scrapy o Puppeteer. Le aziende enterprise possono considerare Bright Data o Diffbot per operazioni su larga scala. Parti sempre da una prova gratuita per capire cosa si adatta meglio.



