
Il mese scorso, l’integrazione Stripe di un amico ha iniziato a dare errori 503 in silenzio alle 23 di venerdì sera. Nessuno se n’è accorto fino al sabato mattina, quando la casella di supporto era già piena di oltre 200 email arrabbiate di clienti che non riuscivano a portare a termine il checkout.
Non è una storia così rara. Un benchmark molto citato stima il downtime medio in 5.600 dollari al minuto, mentre le interruzioni più pesanti possono arrivare a milioni l’ora. La cifra reale cambia in base a traffico, tasso di conversione, valore medio degli ordini, esposizione agli SLA e costi di ripristino — ma il punto è chiaro: API non monitorate non sono solo un grattacapo tecnico, sono un rischio vero per il business. E con una media di 131 API di terze parti in uso per organizzazione e solo il 16% che dice di saper gestire bene il rischio delle API di terze parti, il monitoraggio non è più un optional. In questa guida volevo fare qualcosa che non avevo visto altrove: organizzare gli strumenti in base al tuo caso d’uso, valutare la qualità degli alert (non solo il fatto che esistano), mostrare i prezzi reali del 2026 e misurare quanto in fretta puoi davvero partire. Non la solita lista piatta di loghi.
Un’altra cosa: se il tuo lavoro con le API include raccolta di dati dal web, alimentazione di LLM, costruzione di sistemi RAG, monitoraggio di pagine concorrenti o estrazione di prezzi/dati prodotto dai siti, il discorso sugli “strumenti API” non dovrebbe fermarsi al monitoraggio dell’uptime. Ti serve anche un modo affidabile per trasformare pagine web disordinate in dati strutturati. È qui che Thunderbit Open API entra in questa guida: non è un monitor di uptime, ma è uno dei modi più rapidi per trasformare siti web in Markdown pulito o JSON basato su schema tramite API.
Cos’è il monitoraggio API (e perché dovrebbe interessare al tuo team)?
Monitorare le API significa controllare in modo continuo che i tuoi endpoint siano disponibili, veloci e restituiscano i dati giusti. Non si tratta solo di chiedersi “il server è online?” — un buon monitor verifica codici HTTP, contenuto della risposta, latenza, certificati SSL, flussi multi-step (come login → ricerca → checkout) e persino la correttezza dello schema.
È diverso dal monitoraggio generico di un sito web (che controlla se una pagina si carica) e dall’APM (Application Performance Monitoring), che entra nel dettaglio di trace a livello di codice, query di database e runtime. Il monitoraggio API sta nel punto di contatto: testa ciò che utenti, partner e integrazioni sperimentano davvero quando chiamano i tuoi endpoint.
C’è anche una categoria vicina che vale la pena nominare: le web data API. Queste non servono a verificare se la tua API sta bene; aiutano il tuo prodotto o workflow a raccogliere in modo affidabile dati web esterni. Per esempio, Thunderbit Open API può ridurre una pagina web in Markdown pulito, estrarre campi strutturati in JSON e gestire job batch su tanti URL. Se il tuo progetto “API” dipende da dati aggiornati di fornitori, pagine prodotto, annunci pubblici, documentazione o fonti di ricerca, questo tipo di API per l’estrazione dati può contare quanto i controlli di uptime.
Perché anche chi non è tecnico dovrebbe interessarsene? Perché le API rappresentano il 71% del traffico web dinamico e il 62% dei professionisti API dice che le API generano ricavi in modo diretto. Quando salta un gateway di pagamento, un servizio di autenticazione o un’API di spedizione, non è un problema infrastrutturale astratto: significa ricavi persi, contratti con i partner messi a rischio, picchi di assistenza e fiducia erosa. Product manager, sales, operations e customer success hanno tutti interesse in questo tema.
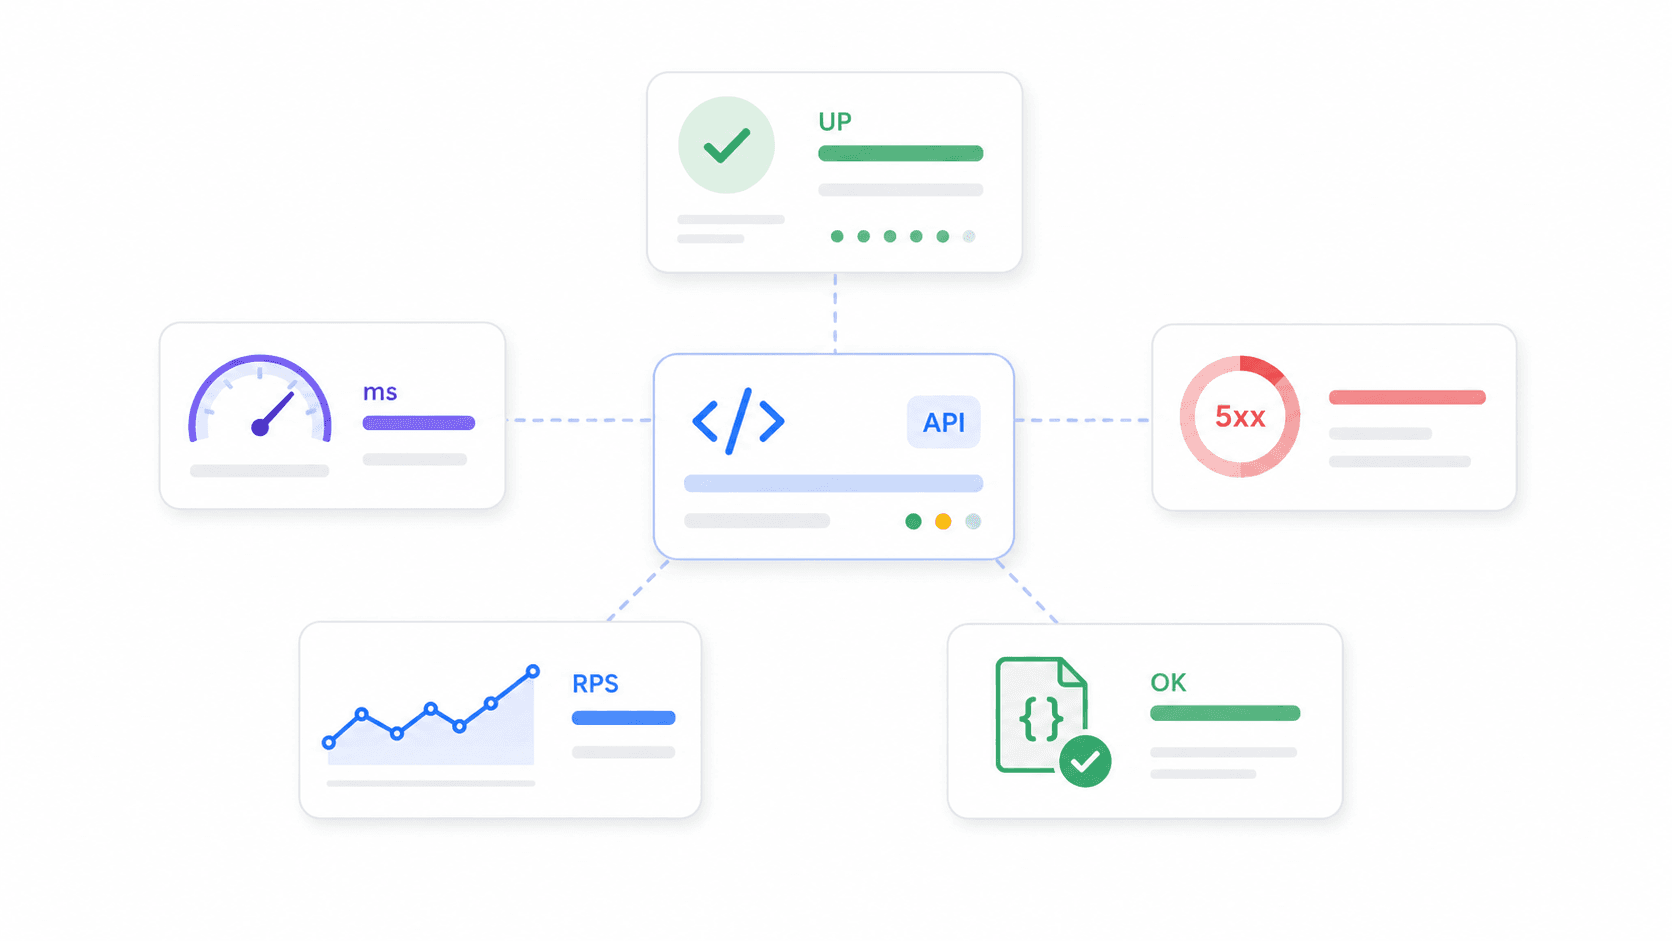
Metriche chiave da tenere d’occhio:
- Percentuale di uptime: quota di tempo in cui un endpoint resta disponibile
- Tempo di risposta / latenza: quanto ci mette l’endpoint a rispondere (media, p95, p99)
- Tasso di errore: quota di richieste che restituiscono 5xx, timeout o fallimenti di asserzione
- Throughput: richieste al secondo/al minuto
- Correttezza: se l’API restituisce i dati attesi, non solo un 200 OK
Come abbiamo valutato i migliori strumenti di monitoraggio API per il 2026
La maggior parte degli articoli sui “migliori strumenti di monitoraggio API” si limita ad accumulare nomi di vendor e funzionalità. Io volevo essere più rigoroso nei criteri di selezione — in parte perché ho passato molto tempo a leggere forum di sviluppatori, e in parte perché il team di Thunderbit mi ha aiutato a estrarre in blocco prezzi e funzionalità dai siti dei vendor per costruire un confronto reale (più avanti spiego meglio quel workflow).
Ecco i criteri a cui abbiamo dato più peso:
| Criterio | Perché conta |
|---|---|
| Facilità di configurazione / tempo al primo alert | I team piccoli hanno bisogno di copertura subito, non dopo un progetto di piattaforma |
| Intelligenza degli alert e riduzione del rumore | Se gli alert fanno troppo rumore, il team li ignora e si perde gli incidenti veri |
| Generosità del piano free | Side project e startup early-stage spesso partono gratis |
| Trasparenza dei prezzi | Le spese di observability possono esplodere tra host, seat, log, esecuzioni synthetic e ingest di dati |
| Ampiezza delle integrazioni | Gli alert devono arrivare dove il team lavora già (Slack, PagerDuty, ecc.) |
| Scalabilità e profondità dei dati | I team maturi hanno bisogno di trace, log, APM, RBAC, SSO, retention |
| Qualità della community e del supporto | I team open-source hanno bisogno di un buon ritmo di release; i team enterprise di SLA |
| Capacità di estrazione dati web | App AI, workflow RAG e strumenti di market research spesso hanno bisogno di dati esterni puliti, non solo dell’uptime di un endpoint |
Abbiamo anche diviso i consigli per caso d’uso — dev singolo, startup, e-commerce/SaaS, enterprise, puristi open-source, team prodotto API e team web data/AI — così puoi saltare direttamente al tuo contesto invece di leggere 14 schede sperando di intuire quale sia la tua. Un sondaggio Grafana del 2025 ha rilevato che il 46% degli intervistati cita l’interoperabilità e il 35% la facilità di cambiare strumento in futuro come criteri di scelta, a conferma che non si tratta solo di optional.
I migliori strumenti di monitoraggio API per caso d’uso: tabella rapida
Questa è la scorciatoia. Trova la tua riga, poi vai alle sezioni degli strumenti per il dettaglio completo.
| Caso d’uso | Strumenti consigliati | Differenziatore chiave |
|---|---|---|
| Team web data / app AI | Thunderbit Open API, Moesif, Apitally | Trasformano siti web in Markdown pulito o JSON strutturato per flussi LLM, RAG, prezzi e ricerca |
| Dev singolo / side project | UptimeRobot, Uptime Kuma, Gatus | Gratis o self-hosted, configurazione minima, avvio rapido |
| Startup (team di 5–15 persone) | Checkly, Better Stack, Postman | Alert intelligenti, setup veloce, prezzo accessibile, status page |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Metriche di business, APM/tracing, profondità SDK, synthetic multi-step |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distributed tracing, compliance, ambienti ibridi, RBAC/SSO |
| Puristi open-source | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Controllo totale, supporto nativo OTel, niente lock-in del vendor |
| Team prodotto API | Moesif, Apitally, New Relic | Uso per cliente, trend sugli endpoint, alert di anomalia |
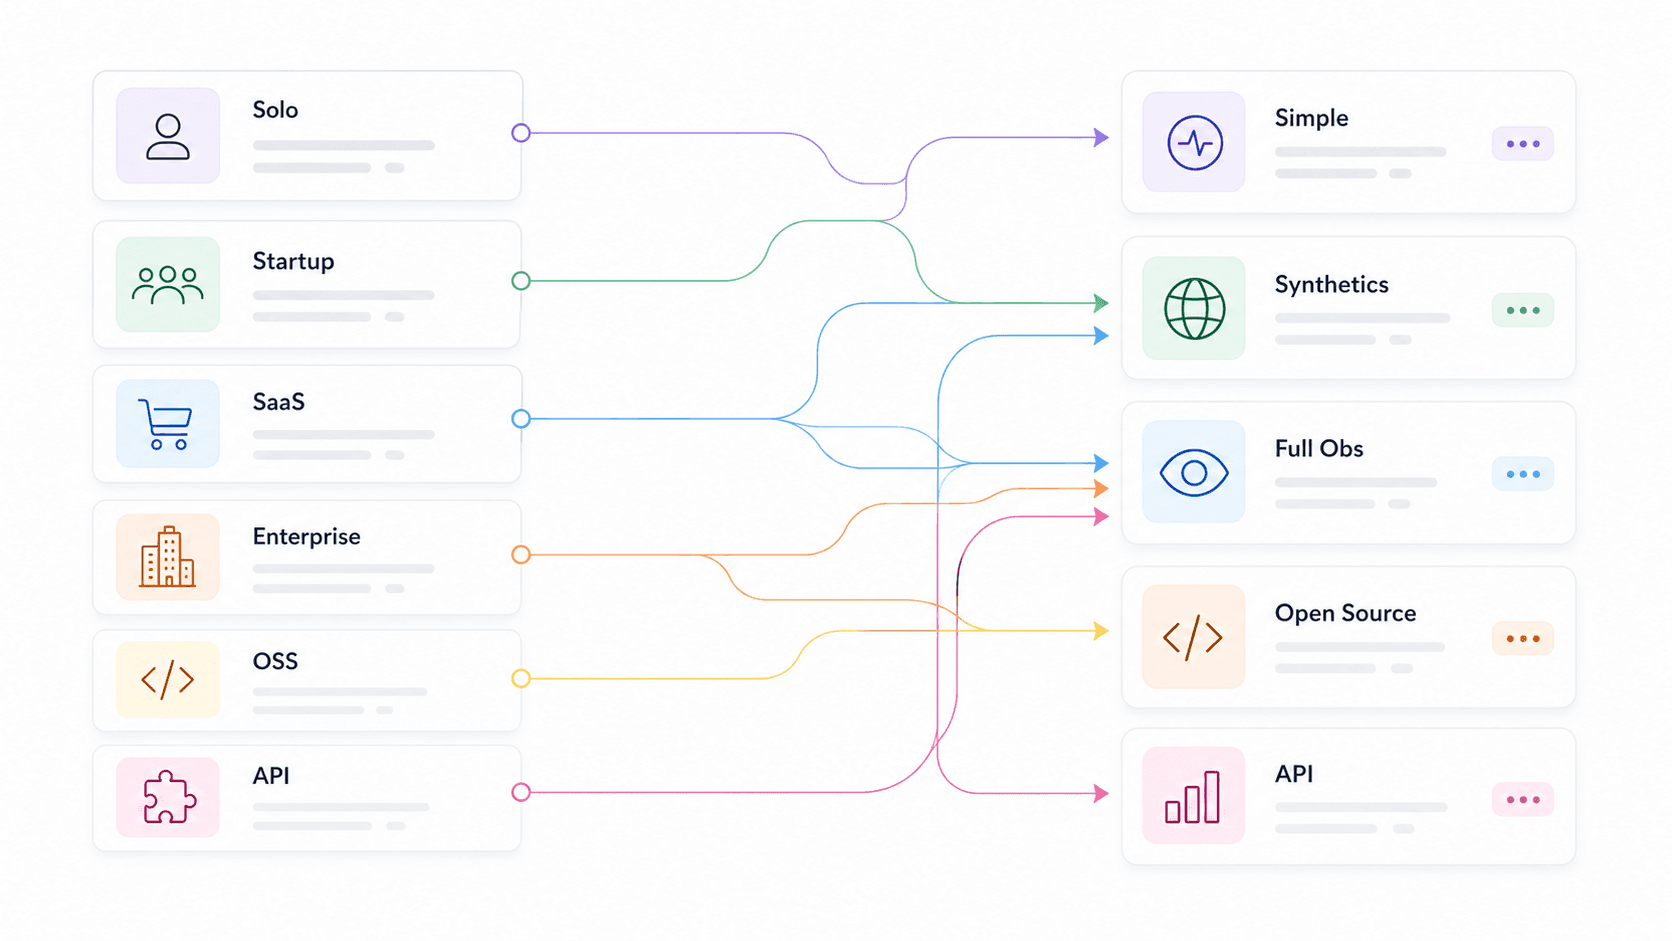
Il pattern più evidente: gli strumenti più rapidi da configurare tendono a offrire meno analitica, mentre le piattaforme più complete richiedono più configurazione e più disciplina sui costi. Non è un difetto — è un compromesso da conoscere. Thunderbit sta in una corsia un po’ diversa: dà il meglio quando il lavoro è trasformare pagine web in dati pronti per le API, non quando deve avvisare gli ingegneri di un downtime.
Thunderbit Open API: ideale per trasformare siti web in dati API strutturati
Inizia a costruire con Thunderbit Open API Riduci pagine in Markdown, estrai JSON strutturato ed elabora URL in batch senza dover mantenere l’infrastruttura di scraping. Get Started Free
Thunderbit Open API è l’API che metterei al primo posto per i team il cui flusso di “monitoraggio” o ricerca dipende da dati web esterni. Non è uno strumento tradizionale di monitoraggio dell’uptime come Checkly o UptimeRobot. Invece, Thunderbit trasforma qualsiasi pagina web in dati puliti e strutturati che app, agent, dashboard e pipeline LLM possono usare davvero.
L’API ha tre workflow principali. Distill converte una pagina in Markdown pulito, pronto per LLM. Extract parte da uno schema e restituisce campi JSON strutturati come nome prodotto, prezzo, disponibilità, dimensione aziendale, stage di funding o punteggio recensione. Batch permette di elaborare fino a 100 URL in modo asincrono con webhook, utile quando monitori pagine prezzi, cataloghi concorrenti, documentazione di fornitori, fonti di notizie o grandi liste di ricerca.
Il motivo per cui merita spazio in una guida sugli strumenti API è che i team spesso sottovalutano quanta infrastruttura serva per il semplice “estrai questa pagina”. I siti pesanti in JavaScript hanno bisogno di rendering. Alcune pagine richiedono routing geografico. L’HTML va ripulito da menu, banner, modali e testo ripetuto prima di risultare utile a un LLM. I selettori si rompono quando cambia il layout. Rotazione dei proxy, gestione anti-bot, retry, code e polling dei risultati possono trasformare un piccolo flusso dati in un progetto di manutenzione. Thunderbit assorbe gran parte di questo lavoro dietro una sola API.
Ideale per: chi costruisce app AI, team RAG, operations e-commerce, sales ops, growth team, ricercatori di mercato e sviluppatori che hanno bisogno di dati da siti web via API senza costruire e mantenere una scraping stack.
Prezzi: Gratis: 600 unità API una tantum, incluse fino a 600 pagine Distill o 30 pagine Extract, con 2 richieste concorrenti. Starter è indicato a 16 $/mese con fatturazione annuale per 60.000 unità API/anno e 30 richieste concorrenti. Pro è indicato a 40 $/mese con fatturazione annuale per 600.000 unità API/anno e 50 richieste concorrenti.
Velocità di avvio: circa 5–15 minuti per ottenere una chiave API ed eseguire la prima richiesta Distill o Extract con cURL, SDK o Thunderbit CLI.
Limiti: Thunderbit non sostituisce Datadog, New Relic, Better Stack o Checkly per controlli di uptime, escalation incident, trace, log o routing on-call. Pensalo come l’API che usi per raccogliere e strutturare dati web — inclusi prezzi dei vendor, documentazione, pagine dei concorrenti, listing di prodotto o dataset pubblici — non come il sistema che sveglia l’ingegnere di turno.
Datadog: il migliore per la visibilità full-stack
Datadog è lo strumento che vedo più spesso negli stack enterprise e mid-market SaaS, e per ottimi motivi. Non è solo monitoraggio API — è una piattaforma di observability completa che collega i test synthetic API a trace distribuite, log, metriche infrastrutturali e real user monitoring in un’unica vista.
Per il monitoraggio API specifico, Datadog supporta HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC e test API multi-step. I suoi monitor di anomaly detection imparano i pattern attesi e segnalano le deviazioni invece di soglie statiche — un salto di qualità rispetto al classico “avvisa se la latenza supera i 500 ms”. Offre anche monitor previsionali che anticipano quando una metrica supererà una soglia, oltre a monitor compositi che combinano più condizioni.
Ideale per: team e-commerce, SaaS ed enterprise che vogliono una vista unica su API, infrastruttura, log e trace.
Prezzi: i dettagli del piano free variano per prodotto. Infrastructure Pro parte da 15 $/host/mese; i test synthetic API costano 5 $ ogni 10.000 esecuzioni. Oltre 800 integrazioni.
Velocità di avvio: circa 15–30 minuti per installare l’agente e creare un test synthetic di base.
Limiti: può diventare costoso su larga scala — il tema del “bill shock” è ricorrente su Hacker News e Reddit. Il numero enorme di SKU (host, log, metriche custom, synthetic, utenti) significa che serve qualcuno che tenga d’occhio la fattura, non solo le dashboard. La curva di apprendimento è reale per l’intera piattaforma.
Checkly: il migliore per controlli synthetic pensati per gli sviluppatori
Checkly è lo strumento che darei a un team engineering di startup che vuole controlli API vicini al codice. L’idea centrale è “monitoring as code”: definisci controlli API e browser in modo programmatico, li esegui da location globali, li integri con le pipeline CI/CD e gestisci tutto tramite Git.
Il tema della qualità degli alert è forte. La logica di retry di Checkly è descritta esplicitamente come la “prima linea di difesa” contro i falsi positivi — puoi configurare retry fissi, lineari o esponenziali, retry dalla stessa location o da location diverse, e durate massime dei retry prima che parta l’alert. Distingue anche tra stato degradato, fallito e recuperato, aiutando a ridurre alert rumorosi.
Ideale per: startup e team dev che vogliono controlli API programmabili, browser check basati su Playwright, integrazione CI/CD e avvio rapido.
Prezzi: dati pubblici recenti mostrano un piano free con 10 uptime monitor, 1.000 browser check e 10.000 API check. Starter intorno a 24 $/mese con fatturazione annuale — verifica la pagina prezzi ufficiale prima dell’acquisto.
Velocità di avvio: circa 10–20 minuti per un primo API check e il canale di alert.
Limiti: è focalizzato sui controlli synthetic. Non sostituisce APM avanzato, analitica dei log o distributed tracing. Se devi correlare un guasto API con un collo di bottiglia nel database, ti servirà un altro strumento in parallelo.
UptimeRobot: il migliore per un tracciamento uptime semplice ed economico
UptimeRobot è la Honda Civic del monitoraggio API. Fa bene una cosa: crei un monitor HTTP, keyword, ping, porta, SSL o heartbeat, imposti un intervallo e ricevi un alert se fallisce. Fine.
Ideale per: dev singoli, piccoli team, agenzie o chiunque abbia bisogno di uptime e latenza di base senza troppa complessità.
Prezzi: gratis: 50 monitor, intervalli di 5 minuti. Piano Solo a partire da circa 7 $/mese con fatturazione annuale. Nessuna carta di credito richiesta per il piano free. Velocità di avvio: circa 2–5 minuti — la più veloce in questa lista.
Limiti: intelligenza degli alert limitata. Alert di soglia basilari, niente anomaly detection, niente distributed tracing, niente analitica profonda. Se devi capire perché un endpoint è lento (e non solo che è lento), UptimeRobot non basta.
Uptime Kuma: il migliore strumento di monitoraggio API free e self-hosted
Uptime Kuma è il beniamino della community self-hosting, e i numeri GitHub lo confermano: 86.637 stelle, 7.831 fork, 1.060 contributor, e release 2.3.2 a maggio 2026. È sotto licenza MIT, supporta HTTP(s), keyword, query JSON, WebSocket, TCP, ping, DNS, push, Docker, più pagine di stato e oltre 90 servizi di notifica.
Ideale per: dev singoli e team che vogliono controllo totale, privacy e zero costi SaaS ricorrenti — se hanno un server.
Prezzi: gratis. Il costo reale è la VM/container, i backup, gli aggiornamenti e il fatto di assicurarsi che anche il monitor resti online. Velocità di avvio: circa 5–15 minuti con Docker per un controllo base; 15–30 minuti se aggiungi notifiche e rifinitura della status page.
Limiti: la manutenzione è tutta a tuo carico. E c’è un problema serio: se ospiti Uptime Kuma sulla stessa infrastruttura che deve monitorare, un guasto cloud o DNS può buttare giù sia l’app sia il monitor. Meglio ospitarlo all’esterno o affiancarlo a un controllo SaaS.
Better Stack: il migliore per una risposta rapida agli incidenti
Better Stack (spesso ancora chiamato Better Uptime dagli utenti) unisce monitoraggio uptime, incident management, turni on-call, policy di escalation e status page in un’unica piattaforma. Il suo punto forte non è l’analitica, ma il workflow di gestione incidenti costruito attorno al monitoraggio.
Le policy di escalation definiscono chi viene avvisato, in quale ordine e con quali ritardi, fino alla presa in carico. Il routing basato su metadata invia gli incidenti in base alla gravità o al team responsabile. Si integra con Slack, Teams, webhook e Zapier.
Ideale per: startup e team di medie dimensioni che vogliono monitoraggio + incident response + status page senza dover cucire insieme tre strumenti separati.
Prezzi: piano free: 10 monitor/heartbeat, 1 status page. Team intorno a 29 $/mese con fatturazione annuale. Velocità di avvio: circa 5–10 minuti tramite procedura guidata GUI.
Limiti: meno profondità nell’analisi dei payload API, nel distributed tracing o nell’analisi dei KPI di business rispetto a Datadog, New Relic o Moesif.
Prometheus + Grafana: il miglior stack open-source per il monitoraggio API
Questa è la combinazione open-source standard del settore. Prometheus raccoglie e memorizza metriche time-series. Grafana (73.705 stelle GitHub, 3.010 contributor) fornisce dashboard e alerting. Alertmanager gestisce routing, grouping, deduplica, silenziamento e inhibition. Per i controlli sugli endpoint API, i team aggiungono Blackbox Exporter per il probing HTTP, HTTPS, DNS, TCP, ICMP e gRPC.
Ideale per: puristi open-source, team Kubernetes/SRE e organizzazioni già standardizzate su metriche Prometheus.
Prezzi: gratis se self-hosted. Grafana Cloud ha un piano free (100k esecuzioni API test/mese) e piani paid basati sull’utilizzo.
Velocità di avvio: 1–4 ore per una base con Blackbox + Prometheus + Grafana + Alertmanager. Giorni per avere HA in produzione e ottimizzare gli alert.
Limiti: PromQL, YAML, relabeling, design delle dashboard, retention, storage, HA e tuning degli alert richiedono vero lavoro operativo. Il compromesso ricorrente è “meno UI, più YAML”. È lo stack per chi ragiona già in metriche e vuole un unico control plane — non per chi vuole il monitoraggio pronto per pranzo.
New Relic: il migliore per le performance delle app SaaS
New Relic combina APM, monitoraggio infrastrutturale, log, distributed tracing, synthetic monitoring, alert, dashboard e analisi incidenti assistita da AI. Il suo piano free — 100 GB/mese di ingest dati e 1 utente full platform — è davvero generoso per i piccoli team.
L’intelligenza degli alert è il punto in cui New Relic brilla nel discorso sull’alert fatigue. Le sue funzionalità di incident intelligence includono correlazione degli eventi, anomaly detection, alert predittivi, root cause analysis e soppressione del flapping. New Relic ha pubblicato un esempio in cui un’efficacia anti-flapping del 97,2% significa solo 28 problemi visibili ogni 1.000 incidenti flapping — un numero concreto di riduzione del rumore.
Ideale per: team SaaS e piattaforme e-commerce che vogliono un monitoraggio API strettamente integrato con trace applicative, errori, throughput e impatto sugli utenti.
Prezzi: gratis: 100 GB/mese, 1 utente full. I piani a pagamento si basano su pricing per utente e per dati.
Velocità di avvio: circa 15–30 minuti per installare l’agente e completare la configurazione guidata.
Limiti: il prezzo può diventare complesso su larga scala. La configurazione degli alert ha una curva di apprendimento — la piattaforma è potente, ma non immediata.
Moesif: il migliore per analytics API e metriche di business
Moesif non è un monitor di uptime tradizionale. È API analytics e product intelligence: capire l’uso delle API per cliente, endpoint, cohort, azienda, geografia, SDK, piano e comportamento. Se la tua domanda è “quale cliente è impattato?” invece di “l’endpoint è online?”, Moesif è pensato proprio per questo.
Supporta alert statici a soglia e alert dinamici di anomalia per metriche API come picchi/cali di traffico, latenza e cambiamenti di comportamento. Gli alert dinamici hanno bisogno di qualche giorno di comportamento API per costruire un modello, ma una volta addestrati rilevano cambiamenti che le regole statiche non vedono.
Ideale per: team prodotto API, aziende SaaS e piattaforme e-commerce che devono collegare le performance API a ricavi, engagement e retention.
Prezzi: disponibile piano free/trial; i piani a pagamento scalano con il volume di eventi API. I prezzi self-service non erano pienamente estraibili nella mia ricerca — verifica la pagina attuale.
Velocità di avvio: circa 20–45 minuti (integrazione SDK/proxy/gateway più profonda di un semplice ping esterno).
Limiti: più orientato all’analitica che al monitoraggio uptime tradizionale. Probabilmente vorrai abbinarlo a Checkly, UptimeRobot o ai synthetic di Datadog per i controlli esterni di disponibilità.
Splunk: il migliore per log enterprise e compliance
Splunk è lo strumento che scegli quando aggregazione dei log, ricerca, correlazione, auditability pronta per la compliance e supporto ibrido/multi-cloud sono imprescindibili. Splunk Observability Cloud copre infrastruttura, APM, synthetic, real user monitoring, log e incident response. ITSI/Event Analytics può raggruppare eventi significativi in episodi e ridurre il rumore tra silos di monitoraggio.
La ricerca di observability 2025 di Splunk è piuttosto netta: il 73% degli intervistati ITOps/engineering ha riportato outage dovuti ad alert ignorati o soppressi, il 59% ha difficoltà con troppi strumenti diversi e il 52% con falsi alert.
Ideale per: team enterprise e multi-cloud con requisiti rigorosi di compliance, sicurezza, audit e ricerca nei log.
Prezzi: basati sull’utilizzo e quasi sempre su preventivo. Niente piano free semplice per la produzione.
Velocità di avvio: l’onboarding cloud può essere più rapido, ma un deployment enterprise richiede spesso da giorni a settimane.
Limiti: costoso su larga scala. Configurazione complessa. Eccessivo per dev singoli e piccole startup.
Postman: il migliore per i team che già testano le API
Postman è soprattutto una piattaforma di sviluppo e testing API, ma il suo prodotto di monitoring permette ai team di pianificare collection Postman ed eseguirle da location cloud. L’argomento più forte è il riuso: se il tuo team QA o dev ha già collection con asserzioni, trasformarle in monitor è un passaggio naturale.
Ideale per: team dev e QA che già usano collection Postman e vogliono controlli programmati senza comprare uno strumento synthetic separato.
Prezzi: esiste un piano free. Extra di monitoraggio a 0,75 $ ogni 1.000 chiamate; pacchetto aggiuntivo da 50.000 chiamate a 20 $/mese. Verifica la pagina dei piani attuale — il packaging di Postman cambia spesso.
Velocità di avvio: circa 10 minuti se le collection esistono già.
Limiti: le funzionalità di monitoring sono più leggere rispetto a strumenti dedicati come Checkly, Datadog o New Relic. Le opzioni di alert sono basilari.
Altri strumenti di monitoraggio API da considerare
Gatus: dashboard di health leggera, self-hosted e guidata dalla configurazione. 10.906 stelle GitHub, supporta HTTP, ICMP, TCP, DNS, metriche compatibili con Prometheus e badge di uptime. Ottimo per dev singoli che vogliono qualcosa di più semplice di Prometheus ma preferiscono YAML/config-as-code rispetto alla UI di Uptime Kuma.
Apitally: strumento più recente focalizzato su analytics del traffico API e tracciamento della qualità per startup. Dichiarano configurazione in meno di 5 minuti con alert custom su 14 metriche. Buono per analytics API leggere senza adottare una piattaforma di observability completa.
Sematext: monitoraggio full-stack con log, synthetic e visibilità infrastrutturale. Synthetic intorno a 2 $ per monitor HTTP, 7 $ per browser monitor, minimo 5 $/mese. Un’alternativa più economica a Datadog per team mid-market.
Uptrace: backend APM, tracing, metriche e log nativo per OpenTelemetry. 4.198 stelle GitHub. Non è un semplice checker di uptime, ma è ideale per i team che standardizzano su OTel e vogliono un backend di tracing open-source-friendly.
Build vs buy: conviene costruirsi il monitoraggio API da soli?
“Meglio scrivere uno script che pinga gli endpoint, o usare uno strumento dedicato?”
Questa domanda salta fuori di continuo nei forum degli sviluppatori. Ho letto abbastanza thread su Reddit per vedere il pattern con chiarezza: i team partono con curl + cron, per un po’ funziona, e poi cambiano quando servono dashboard, storico, controlli multi-regione, routing affidabile degli alert o visibilità cross-team.
Una matrice decisionale onesta:
| Fattore | Script personalizzato | Strumento specializzato |
|---|---|---|
| Tempo di setup | 1–4 ore (base); giorni (robusto) | 5–30 minuti |
| Manutenzione | È tutto a tuo carico per sempre | Il provider gestisce gli aggiornamenti |
| Qualità degli alert | Base (su/giù) | Intelligente (trend di latenza, anomaly, retry) |
| Costo | Gratis (ma c’è il tuo tempo) | 0–500+ $/mese |
| Dashboard | Da costruire da zero | Già pronta, personalizzabile |
| Ha più senso quando… | ≤3 endpoint, team molto tecnico, hobby project | 5+ endpoint, team ops/prodotto, ricavi in gioco |
L’idea chiave che emerge dai forum: chi costruisce tutto da sé spesso se ne pente quando ha bisogno di dashboard, dati storici o visibilità tra team. E poi c’è il problema nel problema — “ti serve monitoraggio sul tuo monitoraggio”. Anche un monitor self-hosted, il database, i backup, la rete e il provider di alert devono essere affidabili.
Costruisci se hai 2 endpoint e ti piace smanettare. Compra se hai un prodotto da far uscire.
La stessa logica vale per l’estrazione di dati web. Puoi scrivere uno scraper, eseguire browser headless, ruotare proxy, mantenere selettori, pulire l’HTML e gestire una coda. Ma se il compito è alimentare in modo affidabile un prodotto API, un agent AI o un workflow di ricerca con dati web, usare Thunderbit Open API è di solito più veloce che costruire da zero l’infrastruttura di scraping.
Alert fatigue: perché la qualità degli alert batte la quantità
Forse questo è il criterio più sottovalutato quando si sceglie uno strumento di monitoraggio API. L’alert fatigue è ciò che succede quando i team ricevono così tanti alert rumorosi, duplicati o non azionabili da finire per ignorarli tutti — e poi perdere gli incidenti veri.
I numeri sono impressionanti. Il report 2025 di BigPanda ha rilevato che l’organizzazione mediana generava 2.350 alert al giorno e 803.406 alert all’anno. L’azione effettiva sugli incidenti era solo del 18% — quindi meno di uno su cinque incidenti derivati da alert era davvero azionabile. Un sondaggio NeuBird del 2026 ha trovato che il 77% dei team on-call riceve almeno 10 alert al giorno e l’80% dice che metà o meno di questi alert è azionabile.
Il miglior strumento di monitoraggio è quello di cui ti fidi davvero. Ecco come i vari strumenti gestiscono l’intelligenza degli alert:
| Strumento | Tipo di alert | Metodo di riduzione del rumore | Canali di alert |
|---|---|---|---|
| Datadog | Anomalia ML, forecast, composito | Fasce di anomalia storiche, baseline dinamiche, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Threshold + stato di degradazione | Retry prima del firing, retry stessa/diversa location | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | Grouping AI degli issue, anomalia, predittivo | Correlazione eventi, soppressione flapping, contesto root cause | Slack, PagerDuty, Teams, webhook |
| Moesif | Anomalia comportamentale | Modelli dinamici dopo alcuni giorni di comportamento | Slack, PagerDuty, email, SMS |
| Better Stack | Uptime/incident/on-call | Policy di escalation, routing per ownership, ritardi | Slack, Teams, webhook, Zapier |
| Prometheus + Alertmanager | Alert su regole PromQL | Grouping, deduplica, silenziamento, inhibition | Email, PagerDuty, Opsgenie, webhook |
| Splunk | Eventi, episodi, health dei servizi | ITSI Event Analytics, grouping degli episodi, ticketing | Splunk On-Call, ServiceNow, webhook |
| Thunderbit Open API | Non è una piattaforma di alerting | Da usare con il tuo scheduler, workflow tool o stack di monitoraggio | Webhook per job batch; alert gestiti all’esterno |
Consiglio pratico: parti con meno alert ma più affidabili. Usa retry prima del firing, conferma multi-regione, alert basati sul burn rate degli SLO, deduplica e routing per ownership. Allerta sull’impatto utente e sui flussi business-critical (checkout fallito, autenticazione fallita, errori 5xx nei pagamenti), non su ogni sintomo interno.
Piani gratuiti e prezzi 2026: quanto paghi davvero
Le pagine prezzi cambiano. I piani free si modificano. I costi nascosti (host, seat, log, esecuzioni synthetic, ingest dati) possono sorprenderti. Questa è la sezione che avrei voluto vedere in ogni articolo sui “migliori strumenti”. Ecco la foto del 2026:
| Strumento | Piano free | Prezzo di partenza | Carta di credito richiesta? | Miglior caso d’uso gratuito |
|---|---|---|---|---|
| Thunderbit Open API | 600 unità API una tantum | ~16 $/mese annuale | No | Estrazione dati web per LLM, RAG, pricing e ricerca |
| Uptime Kuma | Illimitato (self-host) | — | No | Monitoraggio completo, server proprio |
| UptimeRobot | 50 monitor, intervalli di 5 min | ~7 $/mese | No | Controlli uptime di base |
| Better Stack | 10 monitor, 1 status page | ~29 $/mese | No | Uptime startup + status page |
| Checkly | 10 uptime, 10k API check | ~24 $/mese | Sì | API check synthetic |
| Postman | Account free + quota monitoring | ~14 $/utente/mese | No | Riutilizzo di collection esistenti |
| Prometheus + Grafana | Illimitato (self-host) | — | No | Metriche + visualizzazione |
| Grafana Cloud | 100k esecuzioni API test/mese | 29 $/mese piattaforma + uso | Verificare | Trial di synthetic gestiti |
| New Relic | 100 GB/mese, 1 utente full | Per utente + dati | Alcuni piani | APM + observability base |
| Datadog | Trial/varia per prodotto | 15 $/host/mese (Infra Pro) | Spesso sì | Valutazione full-stack |
| Moesif | Free/trial disponibile | Basato sul volume | Verificare | Valutazione analytics API |
| Splunk | Trial disponibile | Su preventivo | Flusso sales | Proof of concept enterprise |
| Gatus | Illimitato (self-host) | — | No | Dashboard di stato guidata da YAML |
| Apitally | Free/trial disponibile | Verificare | Verificare | Analytics API leggera |
| Sematext | Trial/free variabile | ~2 $/monitor HTTP | Verificare | Synthetic/log a costo più basso |
| Uptrace | Free self-hosted | I piani cloud variano | Verificare | Valutazione APM OTel |
Nota sui costi nascosti: gli strumenti self-hosted (Uptime Kuma, Prometheus, Gatus) sono “gratuiti” sul piano licenza, ma una piccola VM, backup, tempo di manutenzione e failover esterno possono diventare il costo reale. Per le web data API, il costo nascosto è spesso diverso: mantenere browser headless, selettori rotti, pool di proxy, workaround anti-bot e pulizia HTML.
Stima per piccoli team: per 10 endpoint API e 3 membri del team, il percorso SaaS più economico è spesso UptimeRobot free o low-paid, Better Stack free/Team, oppure Checkly se il volume di esecuzioni rientra. Datadog e New Relic possono essere accessibili per la fase di valutazione, ma il conto reale dipende da host, utenti, log, trace e volume dei synthetic run. Se il tuo progetto ha bisogno di dati web via API, le unità API free di Thunderbit bastano per testare il workflow prima di passare a un piano a pagamento.
Scorecard della complessità di setup: quanto arrivi velocemente al primo alert
Non ho trovato quasi nessun articolo concorrente che valuti il time-to-value — quanto tempo passa dalla registrazione al primo alert davvero utile. Per i team piccoli, questo conta più della profondità funzionale.
| Strumento | Tempo al primo alert | Competenze tecniche richieste | Approccio alla configurazione |
|---|---|---|---|
| Thunderbit Open API | ~5–15 minuti | Basso–Medio | API key, cURL/SDK/CLI |
| UptimeRobot | ~2–5 minuti | Basso | GUI, click per aggiungere |
| Better Stack | ~5–10 minuti | Basso | Procedura guidata GUI |
| Checkly | ~10–20 minuti | Basso–Medio | Codice o GUI |
| Postman | ~10 minuti (con collection già pronte) | Basso–Medio | Scheduler delle collection |
| Uptime Kuma | ~5–30 minuti | Medio | Docker + GUI |
| Gatus | ~15–45 minuti | Medio | YAML + Docker |
| Datadog | ~15–30 minuti | Medio | Installazione agente + GUI |
| New Relic | ~15–30 minuti | Medio | Agente + setup guidato |
| Moesif | ~20–45 minuti | Medio | Integrazione SDK/proxy |
| Grafana Cloud Synthetics | ~15–45 minuti | Medio | GUI, Terraform opzionale |
| Prometheus + Grafana | 1–4 ore | Medio–Alto | YAML, PromQL |
| Uptrace | 30–90 minuti | Medio–Alto | Integrazione SDK OTel |
| Splunk | Da ore a settimane | Alto | Onboarding enterprise |
Se il monitoraggio deve essere live entro fine giornata, parti dalla metà alta di questa tabella. Se l’obiettivo è una observability solida a livello di piattaforma, pianifica un progetto separato per la metà bassa. E se il tuo primo traguardo è “ottenere dati puliti da queste 100 pagine web dentro un’app”, inizia con Thunderbit prima di costruire un’infrastruttura di scraping personalizzata.
Confronto completo dei migliori strumenti di monitoraggio API
Una tabella da scorrere prima di decidere:
| Strumento | Caso d’uso migliore | Piano free | Intelligenza alert | Tempo di setup | Hosting | Funzionalità distintiva |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Estrazione dati web / pipeline dati API | 600 unità API | Non è uno strumento di alerting | 5–15 min | Cloud | Trasforma pagine in Markdown o JSON strutturato basato su schema |
| Datadog | Enterprise / SaaS full-stack | Trial/varia | Anomaly, forecast, AI | 15–30 min | Cloud | Correlazione tra synthetic, log, trace e infrastruttura |
| Checkly | Synthetic per developer | Generoso, basato sui check | Retry, degradation | 10–20 min | Cloud | Monitoring as code + Playwright |
| UptimeRobot | Uptime semplice | 50 monitor | Soglie basilari | 2–5 min | Cloud | Il monitor base più veloce ed economico |
| Uptime Kuma | Self-hosted gratuito | Illimitato | Status/threshold di base | 5–30 min | Self-hosted | UI pulita, nessuna fee SaaS |
| Better Stack | Incident response / status page | 10 monitor | Escalation, routing | 5–10 min | Cloud | Monitoring + on-call + status page |
| Prometheus + Grafana | Stack metriche open-source | Illimitato (self-host) | Grouping di Alertmanager | 1–4 ore | Self-hosted/cloud | Profondità dell’ecosistema PromQL |
| New Relic | APM SaaS + API check | 100 GB/mese, 1 utente | Grouping AI, soppressione flapping | 15–30 min | Cloud | APM forte + synthetic insieme |
| Moesif | Analytics API / metriche business | Free/trial | Anomalie comportamentali | 20–45 min | Cloud | Analytics del comportamento API per cliente |
| Splunk | Log enterprise / compliance | Trial | Episodi ITSI, AIOps | Giorni+ | Cloud/self-managed | Ricerca log enterprise e governance |
| Postman | Team che già testano API | Account free | Alert monitor basilari | 10 min | Cloud | Riutilizza collection di test API |
Come Thunderbit può accelerare la valutazione degli strumenti API
Dichiarazione trasparente: Thunderbit non è uno strumento di monitoraggio API — è uno scraper web agentico e una Open API per trasformare pagine web in Markdown pulito o JSON strutturato. Questo lo rende utile in una fase diversa della scelta dello strumento di monitoraggio: raccogliere prezzi dei vendor, limiti dei piani, claim sulle funzionalità, dettagli della documentazione e liste di integrazioni prima di scegliere una piattaforma.
Invece di aprire manualmente oltre 10 pagine prezzi, copiare nomi dei piani, limiti dei monitor, intervalli di check, integrazioni e requisiti di carta di credito in un foglio di calcolo, abbiamo usato la Thunderbit Chrome Extension per estrarre dati strutturati da ogni pagina prezzi e funzionalità. L’AI di Thunderbit legge ogni pagina e suggerisce i campi — nome del piano, dettagli del free tier, prezzo, integrazioni supportate — poi struttura l’output in un foglio esportabile.
Per i workflow da sviluppatore, Thunderbit Open API ti offre la stessa idea in modo programmatico. Usa Distill quando vuoi Markdown pulito per LLM o RAG. Usa Extract quando ti servono campi specifici restituiti come JSON. Usa Batch quando devi processare un elenco di pagine prezzi, URL di documentazione, pagine prodotto o pagine concorrenti e ricevere i risultati in modo asincrono.
Il workflow:
- Apri la pagina prezzi di un vendor (Datadog, Checkly, UptimeRobot, ecc.)
- Clicca “One Click Extract” — l’AI di Thunderbit legge la pagina, ne capisce la struttura e compila una tabella in un solo passaggio
- Usa lo scraping delle sottopagine per visitare le pagine prezzi, funzionalità e documentazione di ciascun vendor
- Esporta in Google Sheets, Excel, Airtable, Notion o CSV
Per i team API-first, il workflow via API è altrettanto diretto:
- Ottieni una chiave API gratuita da Thunderbit
- Chiama l’endpoint Distill per ottenere Markdown pulito da qualsiasi pagina pubblica
- Chiama l’endpoint Extract con descrizioni di schema per ottenere JSON strutturato
- Usa gli endpoint Batch e i webhook per liste di URL più grandi
- Invia l’output alla tua app, foglio di calcolo, data warehouse, database vettoriale o workflow di monitoraggio
Per un confronto su oltre 10 vendor, il copia-incolla manuale può facilmente richiedere 2–3 ore se includi sottopagine prezzi, documentazione e integrazioni. Thunderbit ha ridotto la nostra estrazione iniziale a circa 15–30 minuti, con il tempo restante dedicato a verifica e decisioni. Se il tuo team ops, procurement, ricerca o prodotto AI deve valutare strumenti sotto pressione, è una scorciatoia pratica. Puoi approfondire questo tipo di workflow nella guida web scraping senza codice, esplorare i prezzi API di Thunderbit oppure visitare il nostro canale YouTube per le demo.
Come scegliere il miglior strumento di monitoraggio API per il tuo team
Il miglior strumento di monitoraggio API dipende da dimensione del team, profondità tecnica, budget e da cosa significa davvero un guasto per il tuo prodotto.
Un dev singolo non ha bisogno di Splunk. Un’azienda regolamentata non dovrebbe affidarsi a uno script cron. Un team prodotto API potrebbe aver bisogno di analytics cliente in stile Moesif più che di ping di uptime. Un team e-commerce dovrebbe dare priorità ai controlli critici su login, ricerca, aggiunta al carrello, checkout e autorizzazione pagamento. Un team AI o data potrebbe aver bisogno prima di tutto di estrazione dati web in stile Thunderbit, e solo dopo di observability completa.
Tre principi che hanno retto in tutta la mia ricerca:
- Abbina lo strumento al tuo caso d’uso. La tabella rapida esiste per questo — parti da lì.
- Dai priorità alla qualità degli alert rispetto alla quantità. Se il team ignora gli alert, non hai monitoraggio. Hai rumore.
- Non sottovalutare la velocità di setup. Un monitor live oggi, che invia alert affidabili, è meglio di un piano di piattaforma perfetto che lascia il checkout non monitorato per un altro mese.
Se stai confrontando più strumenti contemporaneamente e vuoi velocizzare la ricerca, prova Thunderbit per estrarre in blocco i dati dei vendor in un unico foglio. Se stai costruendo un prodotto API, una pipeline RAG, un agent AI o un workflow di market intelligence che ha bisogno di dati web puliti, inizia con Thunderbit Open API. Non sceglierà lo strumento di monitoraggio al posto tuo — ma ti porterà alla decisione più in fretta e può dare al tuo prodotto un livello dati web affidabile.
FAQ sui migliori strumenti di monitoraggio API
Qual è il miglior strumento gratuito di monitoraggio API nel 2026?
Per semplicità SaaS, UptimeRobot offre 50 monitor gratuiti con intervalli di 5 minuti senza richiesta di carta di credito. Per il controllo self-hosted, Uptime Kuma è open-source, illimitato e ha una UI pulita con oltre 90 servizi di notifica. Per i team che vogliono profondità nelle metriche e hanno già competenze tecniche, Prometheus + Grafana + Alertmanager è il miglior stack open-source — anche se richiede ore, non minuti.
Se il tuo obiettivo non è il monitoraggio uptime ma l’estrazione di dati web via API, Thunderbit Open API ha un piano free con 600 unità API una tantum, sufficienti per testare la conversione pagina→Markdown o l’estrazione JSON basata su schema prima di scalare.
Qual è la differenza tra monitoraggio API e APM?
Il monitoraggio API controlla dall’esterno disponibilità, tempo di risposta, errori e correttezza degli endpoint — simulando ciò che sperimenta un utente o un’integrazione. L’APM (Application Performance Monitoring) entra più in profondità nell’applicazione: trace a livello di codice, query di database, errori runtime, latenza delle code e dipendenze dei servizi. Strumenti come Datadog e New Relic offrono entrambi; UptimeRobot e Uptime Kuma si concentrano sui controlli di uptime esterni.
Thunderbit Open API è diverso da entrambi: è una web data API. Ti aiuta a trasformare siti esterni in Markdown o JSON strutturato, utile per app LLM, workflow di ricerca, pricing intelligence e pipeline dati.
Con che frequenza dovrei monitorare le mie API?
Le API di produzione critiche per il fatturato (checkout, auth, pagamenti) andrebbero in genere controllate ogni 1 minuto. Le API interne o a basso traffico possono spesso essere verificate ogni 5 minuti. Ma la frequenza da sola non basta — usa retry, più regioni e asserzioni significative, così ogni controllo è rapido e affidabile. Un controllo ogni minuto che genera falsi allarmi è peggio di un controllo ogni 5 minuti di cui ti puoi fidare.
Per i workflow di estrazione dati web, la frequenza dipende da quanto cambia la fonte. Le pagine prezzi possono richiedere estrazione giornaliera o settimanale. Dati di inventario, travel o marketplace in rapido movimento possono richiedere refresh orari o più frequenti. L’API batch e i webhook di Thunderbit sono utili quando devi processare molti URL secondo una pianificazione.
Posso monitorare le API senza scrivere codice?
Sì. UptimeRobot, Better Stack e Uptime Kuma si possono usare interamente via GUI. Checkly supporta sia configurazione GUI sia code-based. Postman usa un’interfaccia basata su collection. Prometheus/Grafana di solito richiede YAML e PromQL. Datadog e New Relic possono partire con setup guidato, ma diventano più potenti con strumentazione più profonda.
Se vuoi estrarre dati da siti web senza scrivere codice, l’estensione Chrome di Thunderbit è la strada no-code. Se vuoi automatizzare lo stesso workflow da un’applicazione, Thunderbit Open API offre agli sviluppatori endpoint Distill, Extract e Batch.
Come riduco l’alert fatigue nel monitoraggio API?
Scegli strumenti con alert intelligenti: anomaly detection (Datadog, New Relic), retry prima del firing (Checkly), anomalie comportamentali (Moesif) o grouping/silencing (Prometheus Alertmanager). Parti con meno alert ma più affidabili e focalizzati sull’impatto lato utente. Usa alert basati sul burn rate degli SLO invece di soglie statiche, deduplica tra servizi, instrada per ownership e misura l’azionabilità — se meno del 20% dei tuoi alert porta a un’azione reale, riduci il rumore prima di tutto.
Prova Thunderbit Open API per l’estrazione di dati web Get Started Free
Scopri di più



