Wikipedia Scraper untuk Infobox, Sitasi, dan Bagian Artikel













Rapikan Artikel Wikipedia untuk Riset
Simpan fakta artikel, nilai infobox, sitasi, dan konteks bagian artikel ke field yang terpisah.
Ekstrak Data Wikipedia dalam Sekali Klik
Alat ini mengusulkan kolom untuk halaman yang Anda buka dan menyelesaikan pengambilan data dalam satu kali proses. Anda juga bisa menyesuaikan atau mengganti nama field dengan bahasa natural, lalu menjalankannya ulang jika perlu.
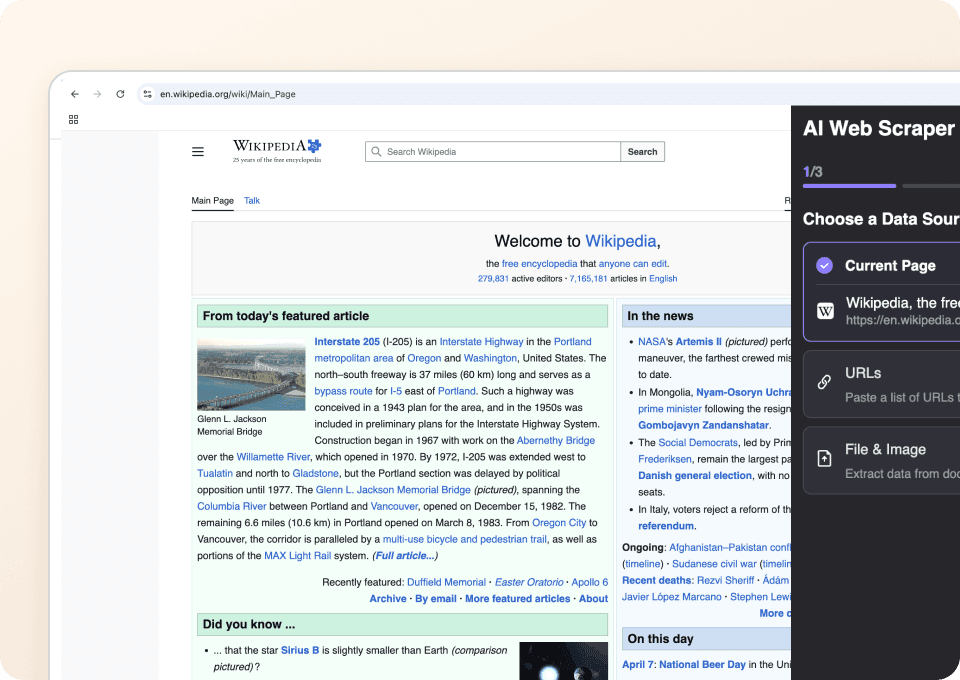
Bekerja di Berbagai Jenis Halaman Wikipedia
Agen membaca label, header, dan judul bagian yang terlihat untuk memetakan nilai di halaman yang bisa Anda akses. Jika suatu field tidak ada, kolomnya akan tetap kosong.
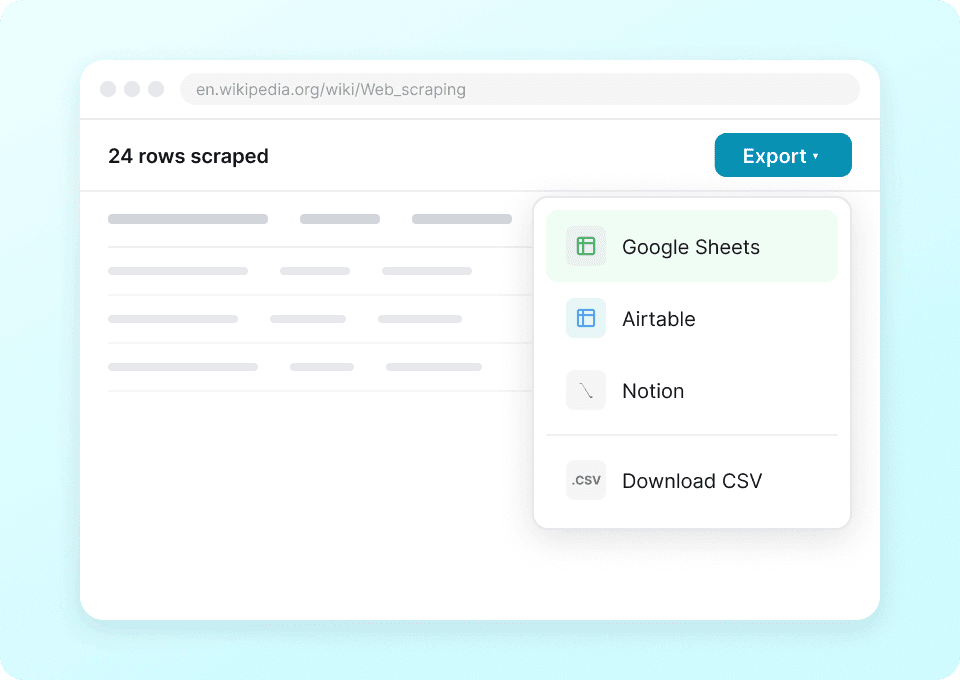
Ekspor Data Wikipedia Secara Langsung
Lanjutkan riset Anda ke Google Sheets, Excel, Airtable, Notion, atau unduh dalam format CSV.
Kumpulkan Data Riset Wikipedia Tanpa Membangun Scraper
Kurangi beban pemeliharaan selector untuk riset Wikipedia.
Setup manual atau berbasis selector
Waktu yang habis untuk memelihara aturanThunderbit AI Agent
Saran field dan satu kali prosesKolom untuk fakta artikel, infobox, sitasi, dan bagian artikel
Kolom hanya muncul jika ditampilkan di halaman yang bisa Anda akses.
- page_title
- page_url
- lead_paragraph
- first_sentence
- infobox_image_url
- infobox_image_caption
- birth_name
- birth_date
- death_date
- birth_place
- death_place
- nationality
- occupation
- years_active
- employer
- alma_mater
- spouse
- children
- website
- notable_works
- latitude
- longitude
- categories
- reference_titles
- reference_links
- external_links
- article_sections
- table_of_contents
- hatnotes
- page_last_edited_date
See researchers capture structured facts from open pages
In user-recorded videos, researchers pick page facts, check the rows, and move the result into their own tools.


Pertanyaan tentang run riset Wikipedia
Jawaban singkat untuk Agent Mode di Wikipedia.
When your research spans Wikimedia projects
Pair Wikipedia articles with Wikidata items, Commons groups, or media pages.
Framer Scraper
Framer Scraper dari Thunderbit membantu Anda mengekstrak daftar template dan contoh di Framer Showcase dengan dukungan AI. Ambil data dari kategori seperti template Portfolio, lalu kunjungi setiap subhalaman template atau showcase untuk menangkap detail seperti judul, tag, tautan pratinjau, dan metadata. Ekspor hasil ke Excel, Google Sheets, Airtable, atau Notion hanya dalam beberapa klik.
Pelajari lebih lanjut ->
Scraper WordPress.org
Scraper WordPress.org dari Thunderbit membantu Anda mengekstrak data terstruktur dari direktori plugin WordPress dan pustaka block pattern dengan dukungan AI. Ambil data dari halaman listing dan lengkapi hasilnya lewat detail subpage seperti statistik plugin, versi, rating, serta metadata pattern—lalu ekspor ke Excel, Google Sheets, Airtable, atau Notion.
Pelajari lebih lanjut ->
Capterra scraper
Ekstrak nama software, rating, dan model harga dari Capterra hanya dalam 2 klik—lalu ekspor langsung ke Excel, Google Sheets, atau Notion. Tanpa coding.
Pelajari lebih lanjut ->
CoinMarketCap scraper
Ekstrak data kripto — harga, kapitalisasi pasar, dan volume 24 jam — dari CoinMarketCap hanya dalam 2 klik. Buka halaman apa pun, biarkan AI mengenali field secara otomatis, lalu ekspor langsung ke Excel, Google Sheets, atau Notion.
Pelajari lebih lanjut ->
GoDaddy Scraper
Arahkan ke nama domain, status ketersediaan, atau harga di GoDaddy — AI Thunderbit mengekstrak datanya dalam 2 klik dan langsung mengekspornya ke Excel, Google Sheets, atau Notion.
Pelajari lebih lanjut ->
Goodreads scraper
Ekstrak judul buku, nama penulis, rating, dan jumlah ulasan dari Goodreads dalam 2 klik — lalu ekspor data Anda ke Excel, Google Sheets, atau Notion, siap untuk dianalisis.
Pelajari lebih lanjut ->Siap meningkatkan ekstraksi datamu?
Bergabunglah dengan 200.000+ profesional yang sudah menggunakan Thunderbit untuk mengotomatiskan workflow web scraping mereka.
Uji coba gratis memberi kredit tak terbatas untuk 8 halaman web.


