
Dua orang mencari "Thunderbit vs ZenRows" pada sore yang sama, tapi mereka sebenarnya mengharapkan jawaban yang sama sekali berbeda. Yang satu adalah manajer sales ops yang butuh daftar prospek dari situs direktori sebelum jam 3 sore dan seumur hidupnya belum pernah membuka terminal. Yang satu lagi adalah backend engineer yang lagi berusaha mengambil 40.000 halaman produk dari situs yang dilindungi Cloudflare tanpa kena IP ban sampai selesai. Google, ya lumayan juga, malah ngasih mereka daftar tujuh alat yang hampir tidak menyebut Thunderbit dan cuma menaruh ZenRows sebagai satu baris kecil di spreadsheet.
Saya menjalankan Thunderbit, jadi jelas saya punya kepentingan di sini. Tapi saya juga sudah cukup lama berkecimpung di SaaS dan otomasi (salam untuk masa-masa Automation Anywhere, tempat saya belajar bahwa "no-code" dan "benar-benar bisa dipakai orang non-teknis" itu dua janji yang sangat berbeda) untuk tahu bahwa kebanyakan artikel perbandingan ditulis oleh orang yang tidak pernah benar-benar memakai salah satu produk itu untuk kerjaan nyata. Jadi, ini usaha saya buat kasih perbandingan yang lebih nyata: tabel fitur lengkap, rekomendasi berdasarkan jenis pekerjaan dan level skill alih-alih "pemenang" palsu, contoh harga yang dihitung dengan multiplier kredit ZenRows yang sebenarnya, dan penjelasan jujur kenapa membandingkan "success rate" dua alat ini sedikit mirip membandingkan pisau lipat Swiss Army dengan mobil derek.
Apa Itu Thunderbit dan ZenRows? (Definisi Singkat)
Sebelum masuk ke fitur, penting untuk paham bahwa dua alat ini sebenarnya hampir tidak sedang berebut pekerjaan yang sama. Mereka cuma sering muncul di hasil pencarian yang sama karena orang menganggap "web scraper" itu satu kategori produk. Padahal, tidak sesederhana itu.
Thunderbit: AI Web Scraper Tanpa Kode untuk Tim Bisnis
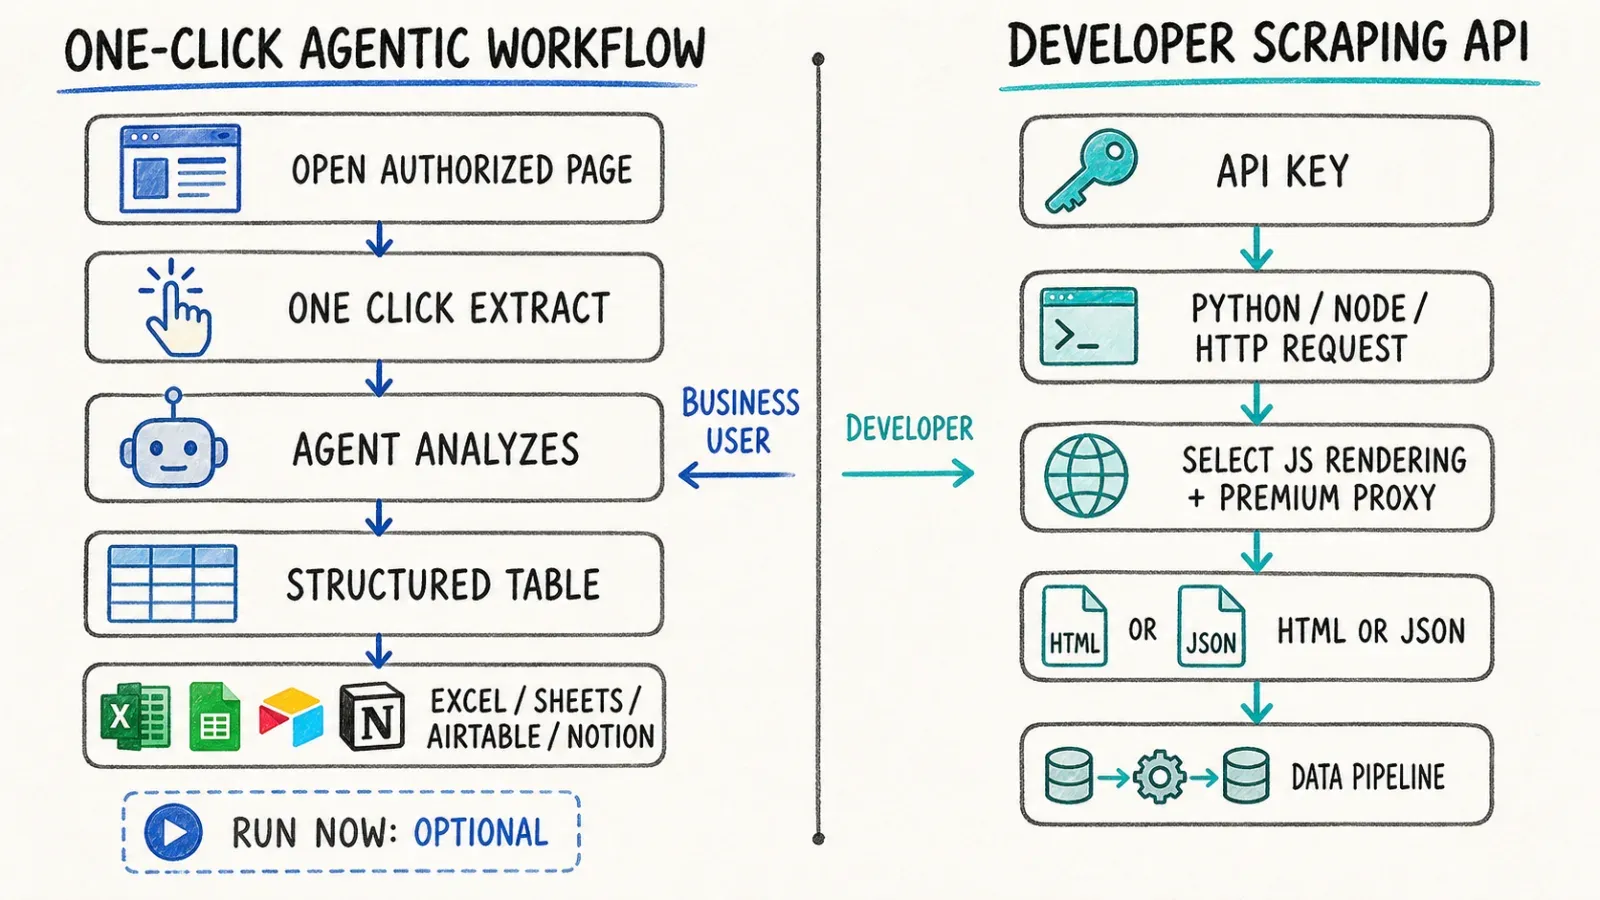
Thunderbit awalnya adalah ekstensi browser yang dibuat untuk orang-orang yang butuh data dari halaman web tapi sama sekali tidak tertarik menulis parser. Pengalaman utamanya ada di Thunderbit Chrome Extension: Anda buka halaman, klik One Click Extract, lalu agent membaca halaman tersebut, menentukan data apa yang paling masuk akal untuk diambil, dan menyiapkan field-nya sendiri. Ada tombol Run Now kalau Anda ingin langsung menjalankannya, tapi kalau Anda diam saja sambil minum kopi, prosesnya juga akan mulai otomatis. Satu klik, tanpa bikin schema, tanpa CSS selector.

Itulah tampilan yang biasanya orang bayangkan saat dengar "Thunderbit." Tapi tim saya juga membangun Open API, MCP Server, dan CLI untuk developer yang ingin kecerdasan ekstraksi yang sama dipasang ke pipeline backend atau AI agent, bukan ke tab browser. Saya mau jujur di sini: ekstensi dan API itu bukan produk yang sama cuma dengan topi berbeda. Keduanya adalah permukaan yang berbeda untuk pekerjaan yang berbeda, dan saya akan balik lagi ke perbedaan ini di bawah karena itu sangat penting untuk pertanyaan "sebenarnya saya butuh yang mana?"
ZenRows: API Web Scraping untuk Developer
ZenRows adalah infrastruktur. Ini bukan alat klik lalu ekspor spreadsheet — ini API yang Anda panggil dari Python atau Node, dan hasilnya bisa berupa HTML, Markdown, atau data terstruktur, tergantung konfigurasi request Anda. Keluarga produknya mencakup Universal Scraper API, Scraping Browser untuk otomasi interaktif (klik, mengetik, navigasi), Residential Proxies untuk geotargeting, dan MCP Server miliknya sendiri untuk workflow agent.
Inti utamanya sederhana: kirim URL, tentukan apakah butuh rendering JavaScript atau premium proxies, lalu ZenRows menangani permainan kucing-kucingan anti-bot — fingerprinting, rotasi header, tantangan Cloudflare, dan semua kerumitannya — supaya scraper Anda tidak ditandai. Itu pekerjaan engineering yang memang berat, dan itulah alasan ZenRows ada. Tapi semua itu butuh kode. Setiap request lewat API key dan daftar parameter. Tidak ada opsi "klik di sini" untuk orang marketing yang cuma ingin file CSV.
Thunderbit vs ZenRows: Tabel Perbandingan Head-to-Head Lengkap
Saya lihat halaman-halaman teratas untuk kata kunci "Thunderbit vs ZenRows" sebelum menulis ini, dan yang ada di luar sana lumayan berantakan. Blog milik ZenRows sendiri menempatkan Thunderbit cuma sebagai satu entri dalam roundup tujuh alat. Halaman perbandingan Slashdot menampilkan widget rating kosong untuk kedua produk, yang jelas tidak memberi tahu apa-apa. Artikel benchmark Scrapeway bahkan tidak memasukkan Thunderbit sama sekali. Tidak ada yang benar-benar membuat tabel langsung, fitur per fitur, untuk dua produk ini secara spesifik, jadi ini upaya saya untuk membuatnya.
| Kategori | ZenRows | Thunderbit |
|---|---|---|
| Alur kerja inti | Request API + kode (Python/Node) | One Click Extract di ekstensi browser — deteksi agentik, Run Now opsional |
| Paling cocok untuk | Developer yang membangun pipeline scraping | Pengguna bisnis / tugas ekstraksi satu kali atau berulang |
| Anti-bot / CAPTCHA / Cloudflare | Dirancang khusus dengan rotasi proxy + infrastruktur headless | Ekstraksi lewat sesi browser yang berwenang pada halaman yang kompatibel; bukan diposisikan sebagai API bypass anti-bot |
| Halaman dengan render JS | Ya, lewat rendering headless | Ya, pada halaman yang didukung/kompatibel |
| Tujuan ekspor | JSON/CSV lewat respons API | Ekspor ke Excel, Google Sheets, Airtable, Notion (cek daftar terbaru) |
| Waktu setup | Butuh kode + konfigurasi API key | Tidak perlu setup schema untuk alur kerja browser default |
| Model harga | Berbasis kredit, multiplier per tipe request | Pastikan struktur paket/kredit live sebelum membeli |
Catatan singkat, karena saya pernah rugi gara-gara tabel harga yang sudah basi: data ini diverifikasi per Agustus 2026. Harga, unit kredit, dan daftar integrasi ekspor di kedua sisi berubah lebih sering daripada yang mungkin ingin diakui dua perusahaan ini. Silakan cek halaman harga live ZenRows dan halaman harga Thunderbit sebelum Anda ambil keputusan berdasarkan angka-angka di sini.
Cara Kerja One Click Extract di Thunderbit
Inti dari ekstensi browser ini adalah hampir tidak ada yang perlu dipelajari. Anda buka halaman yang ingin diambil datanya — entah itu daftar direktori, katalog produk, job board, atau apa pun — lalu klik One Click Extract. Agent akan melihat struktur halaman, menentukan field apa yang paling masuk akal (nama, harga, email, apa pun yang memang ada di sana), dan menyiapkannya tanpa Anda perlu bilang harus cari apa.
Run Now memang muncul sebagai opsi, tapi benar-benar opsional. Kalau Anda tidak menyentuh apa pun, proses ekstraksi akan mulai sendiri. Saya pernah ngobrol dengan pengguna yang tidak sadar soal ini dan mengira mereka harus klik dua kali — ya wajar sih, kebanyakan software memang bikin kita terbiasa dengan langkah konfirmasi. Setelah selesai, Anda bisa menyesuaikan field dengan instruksi bahasa sehari-hari (memformat nomor telepon, menerjemahkan kolom, mengkategorikan entri) lalu mengirim hasilnya ke Excel, Google Sheets, Airtable, atau Notion.
Yang bukan workflow ini: pipeline backend. Kalau Anda butuh ekstraksi yang dihubungkan ke scheduled job, sistem RAG, atau agent yang jalan tanpa manusia membuka tab browser, itulah fungsi Open API dan MCP Server. Saya tekankan ini karena saya sering lihat orang memaksa ekstensi browser masuk ke peran yang memang bukan buat itu, dan itu seperti mencoba menjalankan lini produksi dengan gunting dapur. Alatnya benar, pekerjaannya salah.
Cara Kerja Workflow API Scraping di ZenRows
Alur ZenRows biasanya dimulai dengan membuat API key, lalu menulis request — umumnya lewat SDK Python atau Node mereka, meski HTTP call mentah juga bisa. Anda mengirim URL target dan sekumpulan parameter: apakah butuh rendering JavaScript, apakah ingin premium (residential) proxies, apakah responsnya mau dalam bentuk HTML mentah atau dikonversi ke Markdown atau plain text. API menjalankan request lewat infrastrukturnya dan mengembalikan apa pun yang Anda minta.
Di sinilah sistem kredit mulai penting, dan memang layak diberi sorotan sejak awal karena akan muncul lagi di bagian harga: request halaman statis dasar biayanya 1x kredit, tapi kalau ditambah rendering JavaScript atau premium proxies multiplier-nya naik. Saya akan jelaskan angka-angka sebenarnya sebentar lagi.
Bagi tim yang tidak ingin membangun backend penuh di atas ini, ZenRows juga terhubung ke platform otomasi low-code seperti Zapier, Make, dan n8n, jadi data hasil scraping bisa diarahkan ke tempat yang berguna tanpa harus ada engineer khusus yang terus menjaga glue code. Ini kompromi yang masuk akal, walaupun Anda tetap berada di dunia API dan parameter, bukan dunia klik-klik langsung.
Thunderbit vs ZenRows: Mana yang Cocok untuk Pekerjaan dan Level Skill Anda
Setiap artikel perbandingan yang saya baca memperlakukan ini seperti lomba checklist fitur — yang centangnya paling banyak menang. Padahal memang bukan begitu cara orang memilih alat scraping. Pertanyaan sebenarnya adalah siapa Anda dan apa yang sedang Anda scrape, jadi begini cara saya membaginya kalau ada teman yang nanya saat makan siang.
Pilih ZenRows jika:
- Anda developer yang melakukan scraping ribuan halaman yang dilindungi Cloudflare atau CAPTCHA di dalam pipeline berkode
- Tim Anda sudah punya infrastruktur untuk parsing, retry, dan penyimpanan, dan Anda hanya butuh akses halaman yang andal
- Concurrency dan kontrol proxy/rendering yang sangat detail lebih penting daripada kecepatan setup
Pilih Thunderbit jika:
- Anda orang sales, ops, atau riset yang non-teknis dan butuh daftar prospek, katalog produk, atau data listing dari halaman terbuka yang memang bisa diakses
- Anda ingin menghindari menulis kode dan langsung dari "buka halaman" ke "data masuk spreadsheet"
- Alur One Click Extract di ekstensi browser lebih cocok dengan workflow harian Anda dibanding editor kode
Pilih Thunderbit Open API atau MCP Server jika:
- Anda ingin akses backend, RAG, atau pipeline otomatis tapi tidak mau membangun infrastruktur scraping sekelas ZenRows sendiri
- Anda sudah bekerja di Claude, Cursor, atau AI agent lain yang kompatibel dengan MCP dan ingin ekstraksi tersedia sebagai alat yang bisa dipanggil
Perhatikan bahwa "Thunderbit" muncul dua kali dalam bentuk yang berbeda — itu memang disengaja. Memilih ekstensi atau API adalah keputusan yang benar-benar berbeda, dan pura-pura keduanya bisa dipertukarkan justru merugikan pembaca.
Perbandingan Harga: Apa Sebenarnya Arti "Lebih Murah" di Skala Besar
Di sinilah semuanya mulai rumit, dan menurut saya banyak artikel perbandingan either melewatkan hitungannya sama sekali atau salah hitung. ZenRows tidak menarik biaya flat per request — mereka memakai saldo kredit dengan multiplier yang bergantung pada jenis halaman yang Anda tuju. Paket yang mengiklankan "250.000 request" terdengar sangat besar sampai Anda sadar angka itu mengasumsikan setiap halaman adalah request statis dasar, yang hampir tidak pernah terjadi di dunia nyata.
Penjelasan Harga ZenRows Berbasis Multiplier Kredit
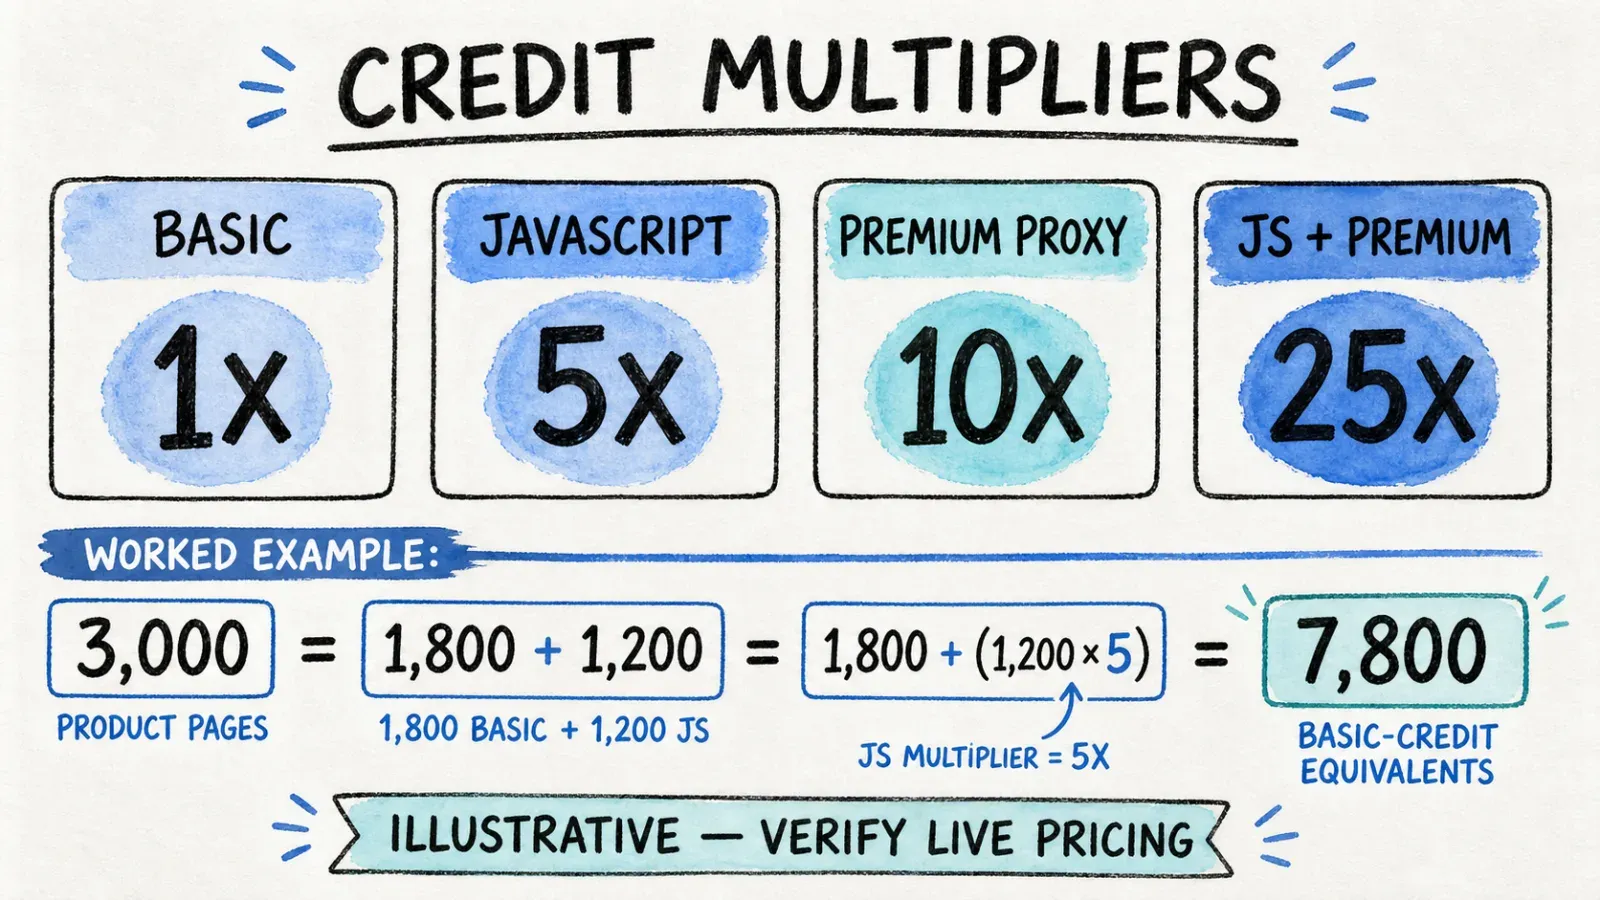
Menurut dokumentasi harga resmi ZenRows, multiplier untuk Universal Scraper API saat ini adalah sebagai berikut: request dasar 1x kredit, rendering JavaScript 5x, premium proxies 10x, dan kombinasi rendering JavaScript + premium proxies 25x. Itu rentangnya besar sekali — halaman yang butuh JS rendering dan premium proxies biayanya 25 kali lipat dari halaman statis biasa.
Ada satu detail lagi yang sering bikin orang kepleset: request yang gagal atau diulang tidak dikenakan biaya, dan itu memang adil. Tapi respons HTTP 404 dan 410 tetap dihitung sukses dan tetap ditagihkan. Jadi kalau daftar target Anda banyak berisi link mati, Anda tetap membayar untuk itu juga.
Tier standar saat ini, menurut dokumen yang sama: Trial memberi allowance bersama senilai $1 (kira-kira 1.000 request dasar, 200 request hanya JS, 100 request hanya premium-proxy, atau 40 hasil yang sepenuhnya terlindungi). Developer seharga $69.99/bulan untuk 250.000 request dasar atau 10.000 hasil terlindungi dengan 20 koneksi paralel. Startup naik menjadi $129.99/bulan untuk 1 juta request dasar atau 40.000 hasil terlindungi, dengan concurrency 50. Business dimulai dari $299.99/bulan untuk 3 juta request dasar atau 120.000 hasil terlindungi, concurrency 100, dan tier Business yang lebih tinggi berkisar dari $499.99 sampai $2,999.99 per bulan sebelum masuk ke harga Enterprise kustom.
Model Harga Thunderbit
Struktur Thunderbit berbeda — ini dibangun di atas tier paket yang terikat pada workflow berbasis browser, bukan sistem multiplier per request, karena kebanyakan pengguna menjalankan tugas ekstraksi pada halaman individual alih-alih mengirim ribuan API call programatik. Saya tidak mau mengutip angka kredit spesifik di sini karena struktur paket bisa berubah, dan saya tidak ingin angka yang sudah basi membuat seseorang salah budgeting. Silakan cek tier terbaru langsung di halaman harga Thunderbit sebelum berlangganan.
Yang bisa saya bilang dengan yakin: tidak ada multiplier 25x yang ngintip di workflow browser. Anda tidak membayar jauh lebih mahal cuma karena sebuah halaman kebetulan memuat JavaScript. Kesederhanaan ini memang inti dari alat berbasis browser — ekstraksi terjadi di dalam sesi browser sungguhan, jadi pertanyaan "apakah halaman ini dirender dengan JS" bukan lagi pertanyaan harga seperti pada API yang harus menyalakan rendering headless saat perlu.
Contoh Perhitungan: Scraping 1.000–5.000 Halaman Produk
Misalnya Anda perlu data produk dari 3.000 halaman e-commerce, dan sekitar 40% di antaranya butuh rendering JavaScript untuk memuat harga (situasi yang cukup umum pada storefront modern). Di ZenRows, itu berarti sekitar 1.800 halaman dengan tarif dasar dan 1.200 halaman dengan multiplier 5x untuk rendering JS — artinya "3.000 halaman" Anda sebenarnya menghabiskan kredit setara kira-kira 7.800 request dasar (1.800 + 1.200×5). Kalau ada halaman yang juga berada di balik perlindungan anti-bot dan butuh premium proxy, angkanya naik cepat, karena multiplier untuk kombinasi JS + premium proxy mencapai 25x.
Di ekstensi browser Thunderbit, Anda akan menjalankan One Click Extract halaman demi halaman (atau memakai pagination / subpage enrichment pada workflow list-to-detail yang kompatibel), dan model biayanya tidak melonjak liar hanya karena satu halaman memuat JavaScript — biayanya terikat pada tier paket Anda, bukan multiplier per halaman. Untuk pekerjaan sebesar ini, obrolan biayanya memang sangat berbeda.
Saya ingin sangat jelas bahwa ini contoh perhitungan, bukan penawaran harga. Biaya riil tergantung pada tingkat perlindungan situs target, tier paket Anda, dan apa pun yang tertulis di halaman harga live pada hari Anda cek. Anggap contoh ini sebagai cara memahami masalah multiplier, bukan angka untuk menyusun anggaran final.
Success Rate dan Penanganan Anti-Bot: Kenapa Ini Bukan Perbandingan yang Sejajar
Beberapa situs benchmark (termasuk Scrapeway dan numerous.ai) mempublikasikan persentase success rate untuk ZenRows terhadap target yang terkenal sulit seperti Amazon, Zillow, dan Walmart. Angka-angka itu berguna kalau Anda sedang mengevaluasi API bypass anti-bot satu sama lain. Tapi angka itu hampir tidak memberi tahu apa-apa tentang Thunderbit, karena Thunderbit memang tidak dibangun untuk menyelesaikan masalah yang sama.
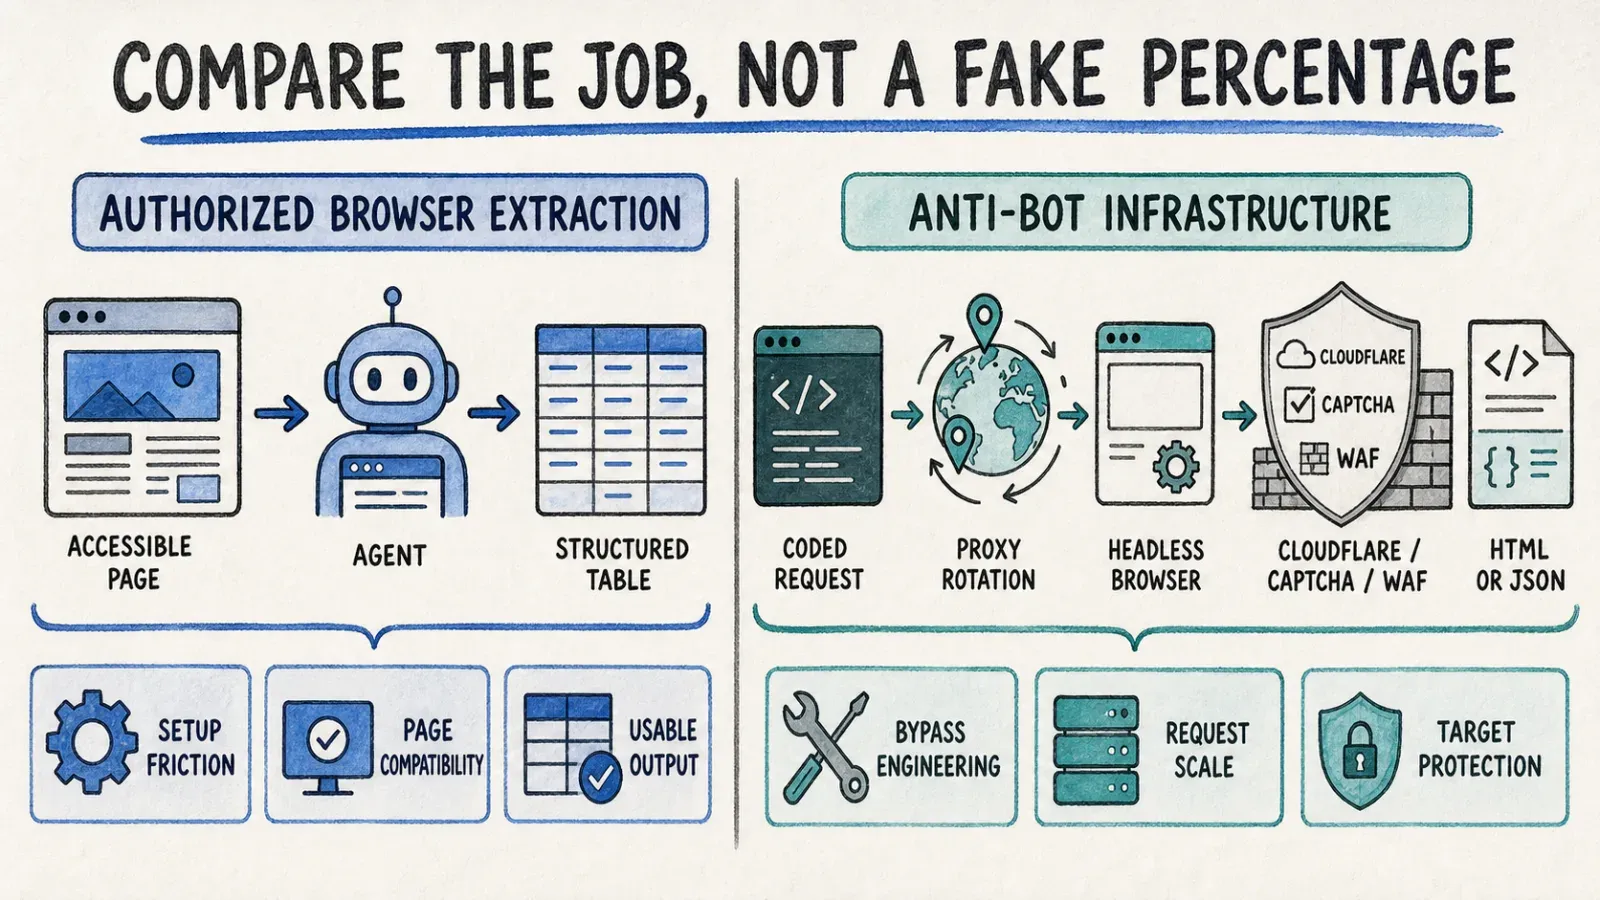
ZenRows memang dibuat khusus untuk menaklukkan CAPTCHA, tantangan Cloudflare, dan web application firewall dalam skala besar, menggunakan rotasi proxy dan infrastruktur headless yang dirancang untuk pertarungan itu. Thunderbit melakukan ekstraksi di dalam sesi browser yang memang sudah berwenang pada halaman yang bisa Anda akses — ini adalah agentic scraper untuk mengambil data terstruktur dari halaman, bukan layanan yang dirancang untuk menerobos pertahanan situs yang memang aktif memblokir bot. Menerbitkan "success rate Thunderbit terhadap sistem anti-bot Amazon" akan tidak jujur, karena memang bukan itu tujuan alat ini dibuat.
Perbandingan yang lebih adil adalah friction setup, model otorisasi, dan kompatibilitas halaman target. Pengalaman satu klik Thunderbit memang benar-benar satu klik — tapi deskripsi itu berlaku untuk halaman yang kompatibel dan berwenang, bukan jaminan untuk semua situs atau semua lingkungan anti-bot di internet. Kalau Anda mencoba scraping situs yang sedang aktif melawan akses otomatis dengan aturan WAF kelas enterprise, itu jelas wilayah ZenRows, dan pura-pura sebaliknya justru merugikan pembaca.
Ekspor, Integrasi, dan Ke Mana Data Anda Berakhir
ZenRows mengembalikan JSON atau HTML lewat respons API, yang berarti Anda (atau alat otomasi yang terhubung) bertanggung jawab mengarahkannya ke tempat yang berguna — database, spreadsheet, atau data warehouse. Ini bukan kritik terhadap ZenRows; memang begitu cara kerja API infrastruktur. ZenRows memberi Anda bahan mentah dan menyerahkan sisanya kepada Anda.
Thunderbit mengekspor langsung ke tempat yang paling sering dipakai tim bisnis: Excel, Google Sheets, Airtable, dan Notion, tanpa menulis satu baris kode pun untuk mewujudkannya. Bagi siapa pun yang melakukan lead generation atau menarik data produk e-commerce, bedanya adalah antara "saya sekarang punya file JSON" dan "saya punya spreadsheet yang bisa langsung saya serahkan ke atasan."
Kedua alat ini juga bisa terhubung ke platform otomasi yang lebih luas seperti Zapier, Make, atau n8n untuk routing yang lebih kompleks, jadi keduanya tidak terkunci pada jalur ekspor default kalau workflow Anda butuh sesuatu yang lebih canggih.
Pertimbangan Hukum dan Kepatuhan Saat Memilih Scraper
Saya singkat saja karena ini memang perlu disebut, bukan diurai seperti disertasi. Kedua alat harus dipakai untuk mengumpulkan data publik atau data lain yang memang diizinkan, sambil tetap menghormati terms of service situs, robots directives, dan hukum privasi yang berlaku seperti GDPR atau CCPA, tergantung di mana data dan pengguna Anda berada. Thunderbit maupun ZenRows — atau alat scraping apa pun, jujur saja — tidak menjamin kepatuhan hukum secara otomatis. Tanggung jawab itu ada pada orang yang menjalankan prosesnya, bukan pada softwarenya.
Kesimpulan: Thunderbit atau ZenRows — Mana yang Harus Anda Pilih?
Jawaban jujurnya adalah kedua alat ini dibuat untuk menyelesaikan masalah yang berbeda, dan memilih "pemenang" itu agak mirip bertanya apakah sepeda atau truk pengantar lebih bagus. Thunderbit adalah jalur no-code berbasis browser untuk pengguna bisnis yang butuh ekstraksi cepat dan berwenang tanpa menyentuh editor kode — dan kalau Anda butuh kecerdasan yang sama di backend, Open API atau MCP Server akan menanganinya tanpa memaksa Anda membangun infrastruktur sekelas ZenRows. ZenRows adalah API pilihan developer untuk tim yang membangun pipeline berkode pada target ber-volume tinggi yang dilindungi, ketika bypass anti-bot memang jadi masalah engineering utama yang sedang Anda pecahkan.
Sesuaikan alat dengan pekerjaan yang ada di depan Anda, bukan dengan checklist fitur generik. Kalau Anda masih belum yakin Anda termasuk kubu yang mana, biasanya itu tanda bagus bahwa Anda belum butuh infrastruktur yang lebih berat — dan tim saya membangun Thunderbit Chrome Extension justru untuk orang-orang yang lebih suka klik tombol daripada menulis scraper dari nol.
FAQ
Apakah Thunderbit cocok untuk non-coder?
Ya — itu memang inti desainnya. Workflow One Click Extract di ekstensi browser berarti agent membaca halaman dan menyiapkan field sendiri; Anda tidak perlu menulis selector, membuat schema, atau menyentuh kode. Run Now sifatnya opsional, karena ekstraksi akan otomatis mulai kalau Anda tidak mengklik apa pun. Itu sebabnya alat ini cocok untuk tim sales, ops, dan riset yang butuh data tanpa menulis kode.
Apakah ZenRows bisa melewati Cloudflare dan CAPTCHA?
Ya, itu inti dari desainnya. ZenRows memakai rotasi proxy, manajemen header/fingerprint, dan Adaptive Stealth Mode secara khusus untuk melewati sistem anti-bot seperti Cloudflare dan CAPTCHA. Untuk detail terbaru soal bagaimana alat ini menangani lapisan perlindungan tertentu, cek langsung dokumentasi Universal Scraper API ZenRows, karena taktik anti-bot di kedua sisi terus berkembang.
Mana yang lebih murah, Thunderbit atau ZenRows?
Sangat tergantung pada jenis pekerjaan dan volumenya. Multiplier kredit ZenRows membuat halaman dengan JavaScript rendering atau perlindungan proxy bisa berbiaya sampai 25 kali lipat dibanding request statis dasar, yang diam-diam bisa membengkakkan kapasitas nyata dari paket yang kelihatannya "murah". Paket berbasis browser Thunderbit tidak punya struktur multiplier per halaman seperti itu. Hitung kebutuhan Anda sendiri berdasarkan contoh di atas dan selalu verifikasi harga terbaru di halaman harga ZenRows serta halaman harga Thunderbit sebelum memutuskan.
Bisakah Thunderbit menggantikan API untuk pipeline data backend?
Ekstensi browser-nya sendiri memang tidak dirancang untuk itu — alat ini dibuat untuk ekstraksi no-code pada halaman yang sedang dibuka dengan bantuan klik manusia. Untuk pekerjaan pipeline backend, terjadwal, atau digerakkan agent, yang relevan adalah Open API atau MCP Server milik Thunderbit, yang memberi developer akses programatik tanpa harus membangun infrastruktur ala ZenRows dari nol.
Bisakah saya memakai Thunderbit dan ZenRows bersama-sama?
Bisa, dan itu bukan kombinasi aneh. Sebagian tim memakai ZenRows untuk menangani akses mentah ke target berlapis proteksi dan bervolume tinggi di dalam pipeline custom, lalu memakai Thunderbit untuk ekstraksi bisnis yang sifatnya ad hoc, daftar prospek cepat, atau tugas yang dilihat agent dan tidak butuh level engineering anti-bot seperti itu. Keduanya menyelesaikan lapisan masalah yang berbeda dalam problem besar yang sama, jadi tidak ada larangan untuk menjalankan keduanya tergantung pekerjaan apa yang sedang Anda hadapi.




