
Saya sering ditanya soal dua tools ini, dan jujur saja, ini memang menarik untuk dibahas karena keduanya sama-sama memakai AI di bagian workflow yang berbeda secara signifikan, sementara para pembeli masih mencoba memahami arti perbedaannya dalam penggunaan nyata. Jadi, mari kita bahas benar-benar, bukan sekadar mengulang materi marketing.
Versi singkatnya sebelum masuk lebih dalam: Thunderbit dibuat untuk orang yang membuka halaman web lalu ingin langsung mendapatkan data terstruktur dalam satu klik, tanpa selector, tanpa setup. Simplescraper dibangun di sekitar "Recipes" yang bisa digunakan berulang — Anda mengonfigurasi ekstraksi sekali (sekarang makin banyak dibantu AI), menyimpannya, lalu menjalankannya lagi dan lagi lewat API, jadwal, atau integrasi. Keduanya tools yang sah dan berguna. Hanya saja, mereka dioptimalkan untuk momen workflow yang berbeda.
Jawaban Singkat
Kalau Anda tipe orang yang membuka sepuluh website berbeda dalam seminggu dan cuma butuh datanya keluar — daftar sales, katalog produk, listing direktori — alur satu klik Thunderbit akan terasa jauh lebih cepat karena hampir tidak ada yang perlu dikonfigurasi.
Kalau Anda membangun pipeline data berulang yang harus berjalan terjadwal, memicu webhook, atau mengalir ke sistem yang lebih besar berbasis API, model Recipe dari Simplescraper memberi Anda infrastruktur yang lebih mudah dipakai ulang.
Dan untuk adil terhadap Simplescraper — saya sering melihat konten perbandingan menggambarkannya seolah-olah "hanya selector manual," padahal itu sudah tidak akurat. Simplescraper sekarang punya Smart Extract, yang memungkinkan Anda menjelaskan kebutuhan data dalam bahasa Inggris biasa lalu AI akan membuat CSS selector untuk Anda. Jadi mereka juga dibantu AI. Perbedaan utamanya bukan "AI vs tanpa AI" — melainkan apa yang terjadi setelah ekstraksi pertama itu dan seberapa banyak struktur reusable yang akhirnya perlu Anda rawat.
Thunderbit vs Simplescraper Sekilas
| Kategori | Thunderbit | Simplescraper |
|---|---|---|
| Model utama | Agentic — menafsirkan halaman saat runtime | Berbasis Recipe — membangun selector yang bisa dipakai ulang, dibantu AI atau manual |
| Alur penggunaan pertama | Klik One Click Extract; agent mendeteksi field dan langsung berjalan otomatis (Run Now opsional) | Buat Recipe lewat point-and-click atau Smart Extract (jelaskan field dengan bahasa Inggris biasa) |
| Ekstraksi AI | Ya — deteksi agentic di level halaman | Ya — Smart Extract menghasilkan selector dari skema yang dijelaskan |
| Konfigurasi tersimpan yang bisa dipakai ulang | Bukan model intinya (ekstraksi ditafsirkan ulang setiap kali) | Ya — Recipes adalah aset reusable utama |
| Browser + cloud | Ya | Ya |
| Deep scraping / subpage | Didukung pada halaman yang kompatibel | Didukung (deep scraping, infinite scroll, login flow) |
| API khusus | Open API | Scrape API dengan manajemen Recipe, batch run, ekstraksi langsung |
| Integrasi MCP / AI agent | MCP Server + CLI | Tidak diposisikan sebagai tool native MCP |
| Output screenshot / Markdown | Bukan fitur inti | Ya — ada API khusus untuk screenshot dan ekstraksi Markdown |
| Transformasi AI setelah ekstraksi | Instruksi di level field saat ekstraksi | AI Enhance — langkah terpisah setelah scraping untuk ringkas/transformasi |
| Model kredit / harga | Lihat harga Thunderbit | Berbasis kredit: 1 kredit/halaman (tanpa JS), 2 kredit/halaman (dengan JS, default aktif) |
⚠️ Catatan jujur: tabel fitur seperti ini cepat basi. Kedua vendor rutin memperbarui dokumentasi dan harga, jadi anggap ini sebagai snapshot dari riset pertengahan 2026, bukan kebenaran mutlak.
Apa Itu Thunderbit?
Thunderbit adalah web scraper agentic yang dibuat untuk pengguna bisnis — orang-orang yang perlu mengambil data dari website tetapi tidak ingin memikirkan CSS selector, struktur DOM, atau skema API. Tim saya membangunnya berdasarkan ide sederhana: kebanyakan orang hanya ingin melihat halaman, klik satu tombol, lalu mendapatkan tabel yang rapi.

Ini alur yang benar-benar saat ini, bukan UI lama yang masih digambarkan oleh beberapa ulasan lama:
- Anda membuka halaman yang memang Anda berwenang untuk akses.
- Anda klik One Click Extract.
- Agent Thunderbit mendeteksi struktur halaman, membaca isinya, menganalisis bagian yang berguna, lalu menyiapkan field — otomatis.
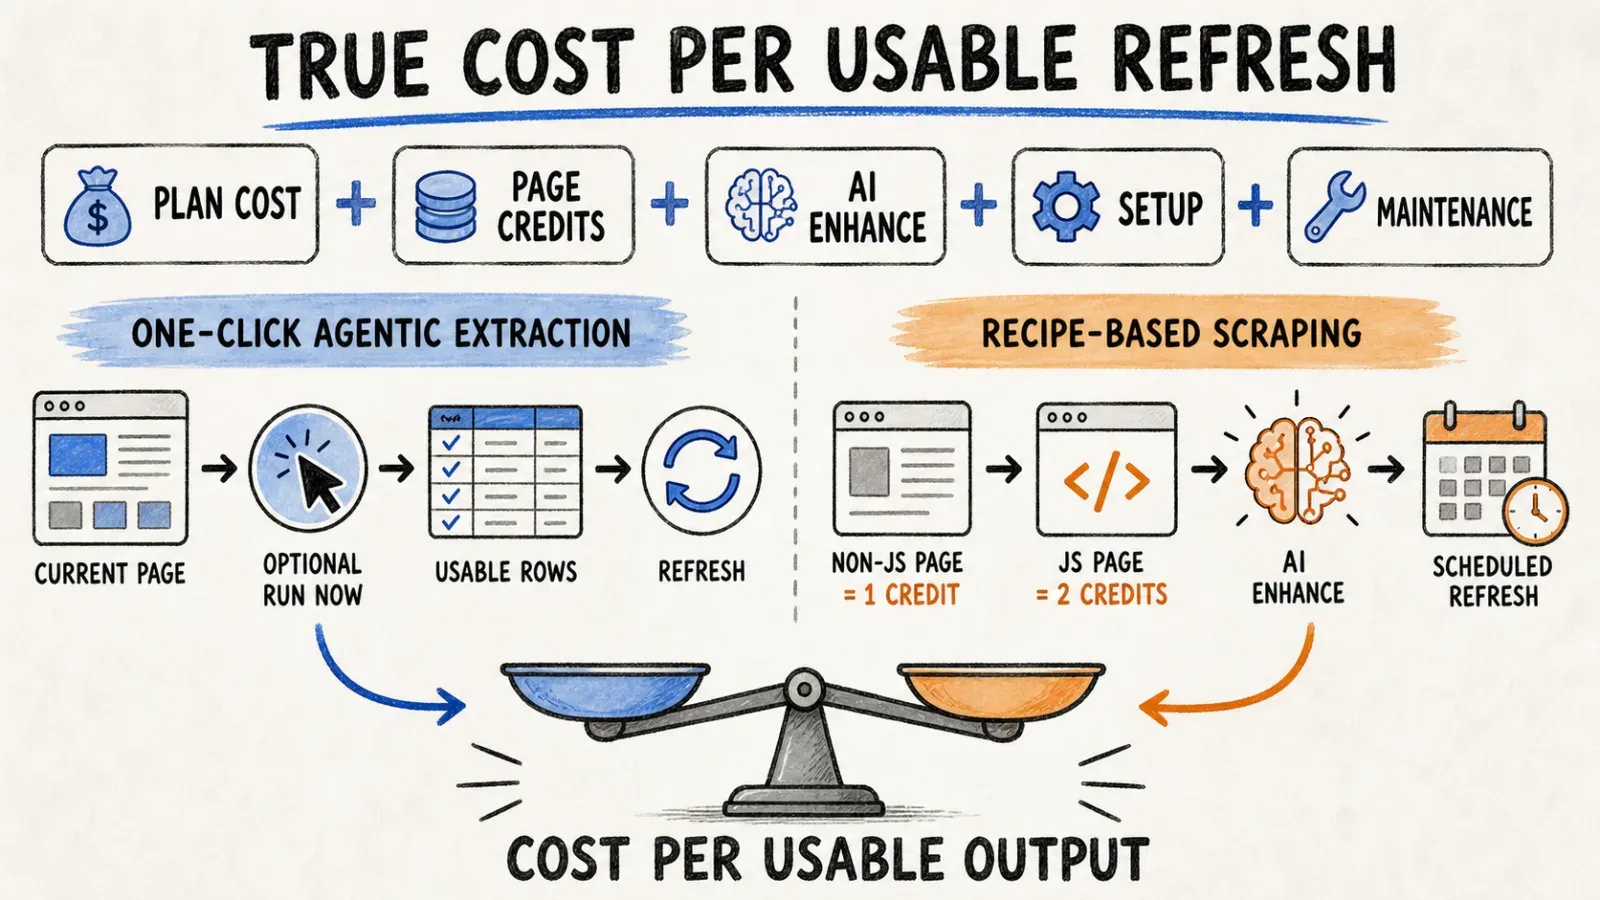
- Proses berjalan otomatis. Run Now tersedia kalau Anda ingin langsung memicunya, tetapi itu opsional — ekstraksi akan mulai sendiri jika Anda tidak melakukan apa pun.
Selesai. Tidak ada ritual multi-langkah "suggest fields, lalu review, lalu edit, lalu scrape" yang sering digambarkan review lama (dan beberapa ulasan yang sudah usang). Di halaman yang kompatibel, ini benar-benar cuma satu klik yang diperlukan.
Di luar alur satu halaman itu, Thunderbit juga mendukung pagination dan enrichment subpage pada halaman yang kompatibel, eksekusi browser dan cloud tergantung tugasnya, Web App, Open API untuk developer, MCP Server untuk AI agent seperti Claude atau Cursor, CLI untuk workflow terminal, serta ekspor ke Excel, Google Sheets, Airtable, dan Notion.
Apa Itu Simplescraper?
Simplescraper adalah kombinasi browser extension dan platform cloud/API, dan seluruh arsitekturnya berpusat pada sesuatu yang disebut Recipe — konfigurasi ekstraksi yang disimpan, dibuat sekali, lalu dipakai berulang.
Sekarang Anda bisa membuat Recipe dengan dua cara:
- Point-and-click: pilih elemen di halaman yang ingin diambil secara manual, lalu Simplescraper membuat CSS selector di balik layar.
- Smart Extract: jelaskan data yang Anda butuhkan dalam bahasa Inggris biasa, lalu AI mengusulkan skema dan menghasilkan selector reusable untuk Anda.
Begitu Recipe siap, Anda bisa menjalankannya pada daftar URL massal, menjadwalkannya agar berjalan berulang, memicu webhook saat selesai, mengirim hasil ke Google Sheets atau Airtable, atau memanggil Scrape API mereka secara programatis. Ada juga Screenshot API, ekstraksi Markdown (berguna jika Anda memasukkan konten ke pipeline LLM), scraping SERP, dan fitur deep-scraping seperti penanganan infinite scroll serta dukungan sesi login.
Ada juga AI Enhance, yang terpisah dari Smart Extract — ini adalah langkah setelah ekstraksi yang mengubah, meringkas, atau memperkaya data yang sudah Anda scrape. Anggap saja ini lapisan pembersihan/analisis yang berjalan setelah scraping, bukan saat deteksi field awal.
Perbedaan Inti: Interpretasi Agentic Saat Runtime vs Recipe Reusable yang Dibuat AI
Alur satu klik Thunderbit pada halaman saat itu juga
Thunderbit sebenarnya tidak membangun "recipe" permanen dalam arti tradisional. Setiap kali Anda klik One Click Extract, agent akan melihat halaman dari awal, menentukan apa yang terstruktur dan berguna, lalu mengekstraknya. Anda bisa memberi instruksi penyempurnaan dalam bahasa natural ("hanya sertakan listing dengan harga," "terjemahkan kolom deskripsi ke bahasa Inggris"), tetapi tidak ada artefak terpisah yang harus Anda rawat saat layout halaman berubah — agent menafsirkan ulang setiap kali.
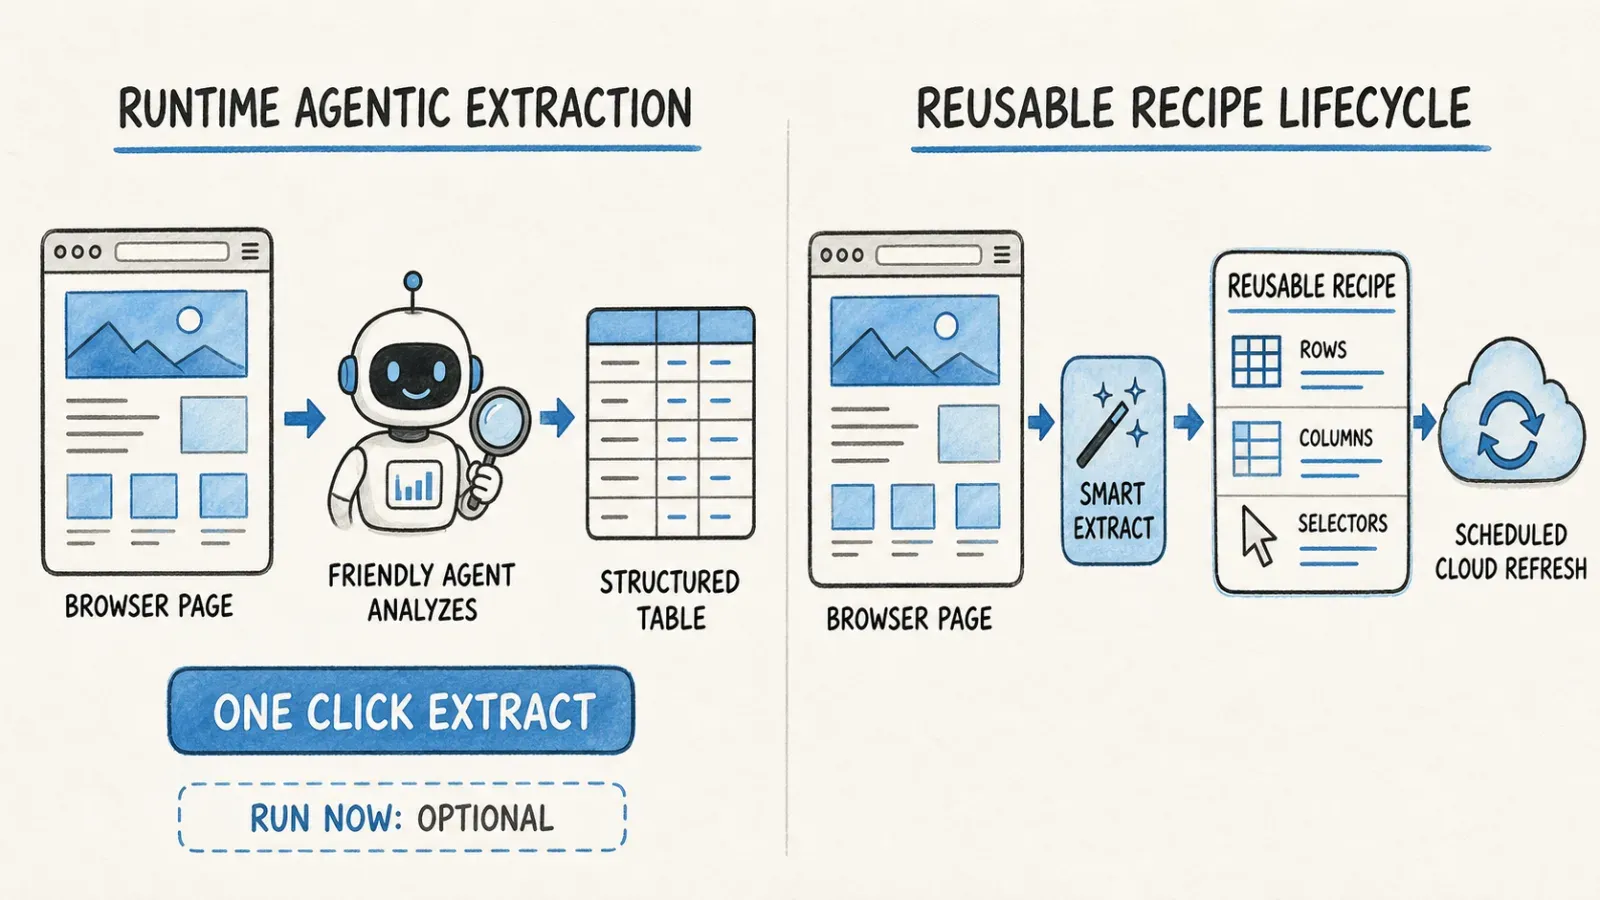
Smart Extract dan siklus hidup Recipe di Simplescraper
Model Simplescraper pada dasarnya berfokus pada pembuatan sesuatu yang reusable. Bahkan dengan selector buatan AI dari Smart Extract, hasil akhirnya tetap Recipe — konfigurasi tersimpan yang terikat pada CSS selector tertentu dan akan dijalankan ulang oleh Simplescraper. Recipe ini menjadi aset di akun Anda: bisa dijadwalkan, dijalankan secara batch, dibagikan, dan diberi versi.
Apa yang terjadi saat situs berubah
Di sinilah trade-off-nya terasa nyata. Jika situs target mengubah layout, CSS selector yang tersimpan di Recipe Simplescraper bisa rusak — termasuk yang dibuat AI, karena semuanya terkunci saat dibuat. Biasanya Anda perlu menjalankan ulang Smart Extract atau memperbaiki Recipe secara manual.
Pendekatan agentic Thunderbit berarti setiap ekstraksi menafsirkan ulang halaman, yang secara teori lebih adaptif terhadap perubahan layout — tetapi ini bukan sihir. Pada layout yang tidak biasa, markup yang sangat disamarkan, atau halaman di balik proteksi anti-bot yang agresif, deteksi agentic juga tidak selalu berhasil. Tidak ada pendekatan yang benar-benar kebal; mereka hanya gagal dengan cara yang berbeda. Recipe Simplescraper gagal secara lebih terprediksi (selector yang rusak mudah didiagnosis). Interpretasi runtime Thunderbit kadang bisa menghasilkan struktur berbeda dari yang Anda harapkan, sehingga butuh cek cepat dari manusia.
Perbandingan Workflow Langsung
Ekstraksi daftar/tabel ad hoc
Thunderbit: buka halaman, klik One Click Extract, selesai. Simplescraper: buka extension, buat atau jalankan Recipe (Smart Extract kalau baru, atau pilih yang tersimpan), lalu ekstrak.
Untuk pekerjaan sekali jalan pada halaman yang belum pernah Anda scrape sebelumnya, alur Thunderbit lebih ringkas karena tidak ada yang perlu disimpan atau dikonfigurasi.
Scraping terjadwal berulang
Ini memang lahan utama Simplescraper. Simpan Recipe, pasang jadwal, biarkan berjalan ke struktur halaman yang sama secara berulang, lalu kirim hasilnya lewat webhook atau integrasi Sheets. Thunderbit memang mendukung penjadwalan pada plan dan surface yang memungkinkan, tetapi pusat desain platformnya lebih condong ke ekstraksi interaktif per halaman, bukan Recipe yang berjalan lama tanpa pengawasan.
Banyak URL dan workflow halaman detail
Keduanya mendukung ini — Simplescraper lewat daftar URL massal dan deep scraping ke halaman detail dari halaman listing; Thunderbit lewat subpage enrichment pada halaman yang kompatibel (ambil daftar, lalu otomatis kunjungi halaman detail tiap item untuk field tambahan).
Ekstraksi terstruktur berbasis API
API guide Simplescraper mendokumentasikan eksekusi Recipe, ekstraksi langsung Markdown/HTML/screenshot, Smart Extract via API, dan batch run hingga 5.000 URL per request (tergantung kredit). Open API Thunderbit mendokumentasikan ekstraksi terstruktur dan workflow batch asinkron untuk developer yang membangun ekstraksi ke aplikasi mereka sendiri.
Screenshot atau Markdown untuk AI downstream
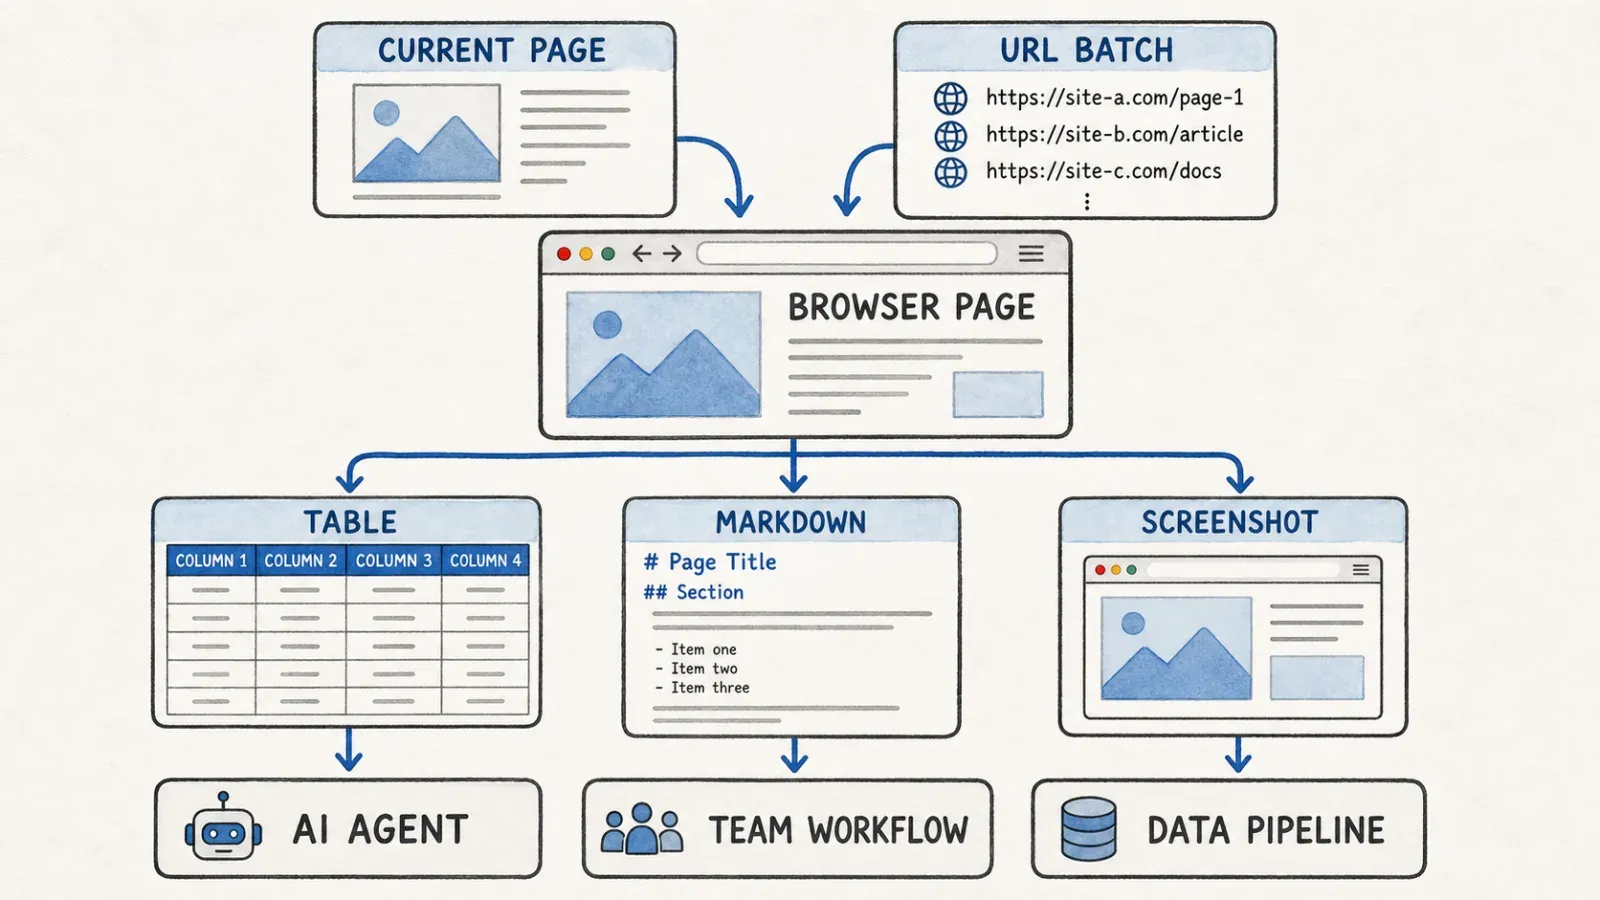
Simplescraper punya endpoint khusus untuk ini — kalau Anda memasukkan halaman ke LLM dan butuh Markdown yang bersih atau screenshot visual, ini adalah use case yang didokumentasikan dan jadi fitur utama. Kekuatan inti Thunderbit adalah ekstraksi field terstruktur, bukan konversi mentah halaman ke Markdown.
Integrasi API dan Agent
Kalau Anda seorang developer, bagian ini mungkin lebih penting daripada perbandingan UI di atas.
API Simplescraper memang luas: Anda bisa membuat, melihat, membaca, dan memperbarui Recipe; mengambil hasil terbaru atau historis; menjalankan batch job pada daftar URL; memakai endpoint ekstraksi langsung untuk Markdown/HTML/screenshot; memanggil Smart Extract secara programatis; bahkan menemukan URL dari sitemap. Proses async mengembalikan result ID yang bisa Anda poll, dan webhook juga didukung untuk notifikasi selesai.
Thunderbit mengambil sudut pandang berbeda di sisi developer/agent. Selain Open API, ada MCP Server khusus — ini penting kalau Anda bekerja di dalam Claude, Cursor, atau host AI lain yang kompatibel MCP dan ingin kemampuan ekstraksi Thunderbit tersedia sebagai tool native yang bisa dipanggil langsung oleh agent, bukan dengan menulis kode integrasi API khusus. Ada juga CLI untuk scripting dari terminal atau lingkungan coding-agent.
Kalau prioritas Anda adalah "API scraping serbaguna yang matang dengan banyak permukaan," dokumentasi Simplescraper saat ini memang mencakup lebih banyak area. Kalau prioritas Anda adalah "saya ingin AI agent memanggil tool scraping secara native tanpa saya menulis glue code," MCP adalah jawaban yang lebih langsung, dan itu memang jalur Thunderbit.
Harga dan Perhitungan Kredit
Mari kita hitung benar-benar, bukan cuma mengutip angka nominal, karena ini bagian yang paling sering membuat halaman marketing menyesatkan — bukan sengaja, tetapi karena "hingga X halaman" selalu mengasumsikan kondisi terbaik.
Harga resmi Simplescraper berdasarkan riset:
| Paket | Harga | Kredit |
|---|---|---|
| Gratis | $0 | Browser scraping gratis + 100 kredit cloud awal |
| Plus | $39/bulan | 6.000 kredit |
| Pro | $70/bulan | 15.000 kredit |
| Premium | $150/bulan | 40.000 kredit |
| Scale | $249/bulan | 100.000 kredit |
Dan inilah bagian yang benar-benar penting untuk budgeting nyata, dari dokumentasi kredit mereka:
- 1 kredit per halaman tanpa rendering JavaScript
- 2 kredit per halaman dengan rendering JavaScript — dan rendering JavaScript aktif secara default
- AI Enhance memakan 1 kredit per 500 kata yang diproses (menghitung input dan output)
Jadi, kalau plan Plus bilang "6.000 halaman"? Kalau situs target Anda butuh rendering JavaScript (yang sejujurnya dibutuhkan oleh sebagian besar website modern), Anda sebenarnya hanya melihat sekitar 3.000 halaman untuk biaya $39 yang sama. Tambahkan AI Enhance di atas itu dan angkanya turun lagi tergantung berapa banyak teks yang Anda proses per baris. Ini bukan kritik terhadap Simplescraper — dokumentasi mereka cukup transparan — tapi memang ini hal yang sering dilewatkan artikel perbandingan karena menghitungnya lebih repot daripada menyalin tabel harga.
Untuk harga Thunderbit saat ini, cek langsung halaman harga live daripada percaya angka yang disalin belakangan — halaman harga bisa berubah, dan saya lebih suka mengarahkan Anda ke sumber aslinya daripada memakai angka yang sudah kedaluwarsa.
Saran jujurnya: apa pun workload yang benar-benar Anda jalankan — situs target yang sama, jumlah baris yang sama, field yang sama — uji di kedua tools dengan biaya kredit atau unit yang nyata sebelum berkomitmen pada plan. Jumlah kredit nominal antar vendor tidak bisa dibandingkan secara langsung karena "biaya per unit kerja" berbeda tergantung aturan rendering JS, penggunaan AI enhancement, dan bagaimana tiap platform mendefinisikan action yang bisa ditagih.
Otomasi, Ekspor, dan Serah Terima ke Tim
Simplescraper sangat condong ke wilayah "set sekali, biarkan jalan terus": schedule, webhook, integrasi native Google Sheets/Airtable/Zapier, dan di paket Scale mereka bahkan akan membantu Anda menyiapkan Recipes dan Live Data Feeds. Kalau tim Anda punya kebutuhan data berulang — misalnya memantau harga kompetitor tiap minggu — infrastrukturnya memang dibuat untuk itu.
Cerita otomasi Thunderbit lebih berpusat pada momen ekstraksi itu sendiri yang cukup cepat sehingga otomasi tidak selalu diperlukan — tetapi bila diperlukan, penjadwalan didukung pada plan yang sesuai, dan kombinasi browser/cloud/API/MCP membuat Anda bisa menyerahkan kemampuan yang sama ke rekan non-teknis (browser extension) atau developer (API/MCP) tergantung siapa yang mengerjakan minggu itu.
Pertanyaan sebenarnya untuk tim Anda: apakah Anda memelihara Recipe sebagai aset jangka panjang, atau Anda menjalankan ulang ekstraksi interpretatif setiap kali butuh data baru? Keduanya valid — hanya saja mereka menciptakan beban maintenance yang berbeda di kemudian hari.
Mana yang Sebaiknya Anda Pilih?
Pilih Thunderbit jika...
Anda seorang pengguna bisnis, sales, operator ecommerce, atau peneliti yang perlu data dari halaman sekarang juga, tidak ingin membangun atau memelihara konfigurasi selector, dan lebih suka agent menafsirkan ulang halaman setiap kali daripada mengelola library Recipe. Thunderbit juga sangat cocok jika Anda membangun workflow AI-agent dan ingin integrasi MCP native, bukan kode glue API kustom.
Pilih Simplescraper jika...
Anda membangun pipeline data produksi yang harus berjalan terjadwal, memicu webhook, terintegrasi secara native dengan Zapier/Airtable/Sheets, atau Anda butuh screenshot dan ekstraksi Markdown sebagai output utama. Ini juga pilihan yang lebih pas kalau tim Anda nyaman memelihara Recipes dan menginginkan permukaan API yang matang dan luas untuk pengembangan kustom.
Pakai keduanya jika...
Jujur saja? Banyak tim akhirnya sampai di sini. Gunakan Thunderbit untuk kebutuhan ekstraksi ad hoc dan sekali pakai pada halaman apa pun yang sedang dibuka seseorang hari itu, dan Simplescraper untuk dua atau tiga pipeline berulang yang memang diuntungkan oleh scheduled Recipes dan otomasi webhook. Saya sudah melihat pola ini berkali-kali — alat berbeda untuk momen berbeda dalam workflow yang sama, bukan keputusan menang-kalah mutlak.
Putusan Akhir
Baik Thunderbit maupun Simplescraper adalah tools scraping modern yang sah dan didukung AI — dan saya ingin jujur bahwa banyak konten perbandingan lama menggambarkannya sebagai "tool AI baru vs scraper manual klasik," yang sekarang sudah tidak adil untuk Simplescraper. Mereka sudah membangun kemampuan ekstraksi AI yang nyata lewat Smart Extract, dan AI Enhance adalah lapisan pemrosesan lanjutan yang memang berguna.
Keputusan sebenarnya kembali ke ini: apakah Anda ingin jalur sesingkat mungkin dari "saya menemukan halaman yang punya data" ke "saya punya tabel yang bersih" — itu filosofi desain Thunderbit. Atau Anda ingin membangun infrastruktur ekstraksi yang reusable, bisa dijadwalkan, dan berbasis API sehingga tim bisa memeliharanya dari waktu ke waktu — itu kekuatan Simplescraper.
Rekomendasi jujur saya: pilih satu pekerjaan nyata yang memang perlu Anda selesaikan — halaman target yang nyata, kumpulan field yang nyata, frekuensi refresh yang nyata — lalu jalankan di kedua tools memakai paket gratisnya. Ukur waktu setup, hitung baris usable yang benar-benar Anda dapatkan, cek apa yang terjadi kalau Anda menjalankannya lagi seminggu kemudian, dan hitung biaya kredit per ekstraksi yang selesai secara nyata, bukan berdasarkan angka nominal. Lima belas menit pengujian itu akan memberi Anda informasi lebih banyak daripada artikel perbandingan mana pun, termasuk yang ini.
Dan kalau Anda memilih Thunderbit, ekstensi Chrome bisa dicoba gratis — tanpa kartu kredit, cukup klik One Click Extract pada halaman yang ingin Anda lihat hasilnya.
FAQ
Apakah Simplescraper memakai AI? Ya. Fitur Smart Extract dari Simplescraper memungkinkan Anda menjelaskan skema data yang diinginkan dalam bahasa Inggris biasa, lalu AI akan menghasilkan skema dan CSS selector reusable. Ada juga AI Enhance, fitur terpisah setelah scraping untuk mengubah, meringkas, atau memperkaya data yang sudah diambil.
Apakah Thunderbit membutuhkan CSS selector? Tidak. Model agentic Thunderbit menafsirkan halaman saat proses ekstraksi — Anda klik One Click Extract, lalu agent mendeteksi dan mengusulkan field tanpa Anda menulis atau mengonfigurasi selector. Ini bekerja di halaman yang kompatibel; layout yang tidak biasa atau situs yang sangat disamarkan mungkin tetap perlu ditinjau manual.
Apa itu Simplescraper Recipe? Recipe adalah konfigurasi ekstraksi Simplescraper yang disimpan dan bisa dipakai ulang — dibuat lewat pemilihan elemen point-and-click atau lewat selector buatan AI dari Smart Extract. Recipe bisa dijadwalkan, dijalankan batch pada daftar URL, dan dipicu lewat API atau webhook.
Bagaimana kredit Simplescraper bekerja? Menurut dokumentasi kredit mereka, halaman tanpa rendering JavaScript dikenai 1 kredit, halaman dengan rendering JavaScript (aktif secara default) dikenai 2 kredit, dan AI Enhance memakan 1 kredit per 500 kata yang diproses (input plus output digabung).
Mana yang menawarkan API lebih baik? Tergantung prioritas Anda. API Simplescraper saat ini punya cakupan dokumentasi yang lebih luas — manajemen Recipe, batch run hingga 5.000 URL, ekstraksi langsung Markdown/HTML/screenshot, dan penemuan sitemap. Open API Thunderbit plus MCP Server adalah pilihan yang lebih kuat jika Anda secara spesifik menginginkan integrasi native AI-agent (Claude, Cursor, dll.) daripada kode glue API kustom.
Apakah keduanya mendukung scraping halaman detail dan JavaScript? Ya, keduanya mendukung ekstraksi dari halaman listing ke detail/subpage di situs yang kompatibel, dan keduanya menangani konten yang dirender JavaScript — meskipun Simplescraper secara eksplisit menagih rendering JS dua kali lipat secara default, yang patut Anda masukkan ke perhitungan penggunaan.
Apakah salah satu bisa scrape semua website? Tidak. Tidak ada tool yang menjamin kompatibilitas universal untuk semua website. Kebutuhan autentikasi, proteksi anti-bot, struktur halaman yang tidak biasa, dan pembatasan akses spesifik situs dapat membatasi kedua platform. Selalu uji pada halaman target Anda, dan hanya scrape data yang memang Anda berwenang untuk akses.




