
Setiap beberapa bulan sekali, pasti ada saja rekan satu tim yang nanya hal yang sama di Slack: "Kita bikin spider Scrapy aja untuk ini, ya?" Dan tiap kali itu muncul, jawaban saya selalu sama: tergantung siapa yang nanya dan sebenarnya mau mencapai apa. Nah, justru itu inti artikel ini, tapi izinkan saya benar-benar menebus gaji saya dan menjelaskannya dengan tuntas.
Saya sudah hampir satu dekade berkecimpung di SaaS dan automasi — mulai dari Automation Anywhere, lihat perusahaan besar mengotomatiskan hampir semuanya kecuali bagian ketika masih ada orang yang harus copy-paste data dari website, lalu sekarang membangun Thunderbit, tempat masalah "copy-paste dari website" justru jadi musuh utama yang ingin kami habisi. Sementara itu, Scrapy sudah lama diam-diam menopang pipeline data internet jauh sebelum istilah "agentic AI" jadi bahan obrolan di meja makan. Membandingkan keduanya sebenarnya bukan soal Thunderbit vs Scrapy dalam arti mencari pemenang. Lebih pas kalau dibilang seperti membandingkan pisau lipat Swiss Army dengan bengkel mesin lengkap — dua-duanya bisa menghasilkan potongan logam yang sama, tapi prosesnya, skill yang dibutuhkan, dan kekacauan setelahnya jelas beda jauh.
Jawaban Singkat
Kalau mau versi pendek sebelum masuk ke detail: Thunderbit adalah agentic web scraper yang dikelola — Anda buka halaman, klik sekali, lalu dia yang mencari struktur datanya untuk Anda, baik Anda bekerja di browser, Web App, Open API, MCP Server, atau CLI. Scrapy adalah framework Python open-source yang sudah matang — Anda menulis spider, menentukan selector, membangun pipeline, dan bertanggung jawab atas setiap baris kode yang menyentuh data Anda.
Tidak ada satu pun yang secara universal "lebih baik". Keduanya dibuat untuk orang yang berbeda dan masalah yang berbeda, dan jujur saja, fakta bahwa artikel-artikel pembanding sering mereduksi ini jadi satu verdict tunggal adalah alasan kenapa saya ingin menulis artikel ini dengan benar.
Sekilas
Inilah tabel yang dulu saya harap sudah ada saat pertama kali mencarinya. Setiap artikel "Thunderbit vs Scrapy" yang saya temukan entah menenggelamkan dua alat ini di dalam roundup Scrapy vs BeautifulSoup yang lebih luas, atau cuma memberi Anda widget direktori tipis tanpa penilaian. Jadi kami bikin versi yang benar-benar berguna.
| Dimensi | Scrapy | Thunderbit |
|---|---|---|
| Apa itu | Framework Python open-source (spider, pipeline, middleware, engine asinkron) | Web scraper no-code agentic — ekstensi browser, Web App, Open API, MCP Server, CLI |
| Setup | Instal environment Python, tulis spider, tentukan selector, atur pipeline | Buka halaman target, klik One Click Extract — ekstraksi langsung mulai otomatis (Run Now opsional) pada halaman yang kompatibel dan berwenang |
| Skill yang dibutuhkan | Python, selector XPath/CSS, konsep asinkron | Tidak perlu coding untuk alur browser; API/CLI/MCP membutuhkan konfigurasi developer standar |
| Konten JS/dinamis | Perlu scrapy-playwright atau integrasi ala Selenium | Bekerja dari halaman yang sudah dirender dan sedang terbuka di browser, termasuk sesi login yang didukung — tidak dijamin di semua situs |
| Penanganan anti-bot | Middleware manual (rotasi proxy, deteksi ban), tanpa bypass yang dijamin | Rendering terkelola pada halaman yang didukung dan berwenang, juga tanpa bypass yang dijamin |
| Skala/tugas berulang | Dibuat untuk crawl besar, bisa di-script, dan dijadwalkan | Penjadwalan tersedia bila didukung oleh paket/surface; lebih cocok untuk tugas terarah atau volume moderat |
| Ekspor | Dikodekan secara kustom (JSON, CSV, database, pipeline) | Ekspor ke tujuan yang didukung seperti Excel, Google Sheets, Airtable, atau Notion, plus format unduhan |
| Perawatan | Spider bisa rusak saat layout berubah; perlu waktu developer untuk memperbaiki | Ekstraksi berbasis AI dapat menyesuaikan sebagian perubahan layout, tetapi tetap bisa gagal jika struktur berubah drastis |
| Model biaya | Gratis/open-source + waktu developer + hosting + biaya proxy | Berbasis langganan/kredit — cek halaman harga sebelum menyebut angka |
Apa Itu Thunderbit?
Thunderbit lahir dari satu observasi yang cukup bikin pusing: kebanyakan orang yang butuh data dari web itu bukan developer, sementara kebanyakan alat scraping web berasumsi Anda memang developer. Celah itulah yang jadi alasan utama kami ada.
Alur inti di browser sengaja dibuat sesimpel mungkin. Anda buka halaman yang ingin diambil datanya, klik One Click Extract, lalu agen akan mengurus sisanya — membaca halaman, mencari apa yang bisa diekstrak (daftar produk, lowongan kerja, info kontak, apa pun yang sedang tampil), lalu menyiapkan field secara otomatis. Ada tombol Run Now kalau Anda ingin langsung memulainya, tapi kalau Anda cuma santai sambil minum kopi, ekstraksi tetap akan jalan sendiri. Tanpa selector, tanpa menulis skema, tanpa ritual "inspect element".

Selain alur browser satu klik, Thunderbit juga tersedia di beberapa permukaan lain tergantung apa yang sedang Anda bangun:
- Chrome Extension menangani skenario "saya sedang lihat halaman ini sekarang dan butuh datanya".
- Web App mendukung pengumpulan berbasis cloud dan tugas berulang untuk pengguna bisnis yang tidak ingin menyentuh kode.
- Open API menyediakan endpoint Distill dan Extract terstruktur untuk workflow backend dan aplikasi.
- MCP Server memungkinkan agen AI di Claude, Cursor, atau Windsurf memanggil Thunderbit langsung sebagai tool.
- CLI ditujukan untuk developer dan coding agent yang hidup di terminal.
Thunderbit juga menangani pagination dan enrichment subpage pada situs yang kompatibel, dan Anda bisa menyempurnakan field dengan instruksi bahasa sehari-hari alih-alih regex. Semua ini tentu tidak menjamin hasil sempurna di setiap website di dunia — nanti saya jelaskan bagian jujurnya — tapi desainnya memang dibuat supaya tim sales ops atau analis properti tidak perlu buka code editor.
Apa Itu Scrapy di 2026?
Scrapy bukan alat lama yang berdebu. Situs resmi Scrapy mencantumkan versi 2.17.0 sebagai rilis stabil saat ini, dan proyeknya terus berkembang — rilis terbarunya bahkan menambahkan dukungan HTTP/2 dan SOCKS proxy pada jalur download handler. Jadi ini bukan cerita "AI membunuh framework lama". Scrapy masih sangat hidup dan, terus terang, masih sangat bagus untuk tugasnya.
Pada dasarnya, Scrapy adalah framework Python yang dibangun di atas engine crawling asinkron. Anda menulis kelas Spider, menentukan start URL (atau start method), lalu Scrapy mengirim Request dengan fungsi callback yang memproses respons. Dari sana, Anda ambil data dengan selector CSS atau XPath (atau regex biasa kalau Anda suka gaya lama), bungkus ke dalam Item, lalu jalankan lewat pipeline untuk pembersihan, validasi, dan penyimpanan. Dokumentasi resmi menjelaskan alur ini secara lengkap, dan sistemnya memang elegan begitu Anda sudah paham.
Yang Anda dapat dari investasi belajar itu adalah kontrol nyata: cookie dan session, alur autentikasi, caching, kepatuhan terhadap robots.txt, batas kedalaman crawl, dan AutoThrottle supaya IP Anda tidak diblokir admin server yang sedang emosi. Ekosistem middleware dan extension-nya juga luas banget — rotasi proxy, custom download handler, hook monitoring, dan belakangan add-on untuk rendering berbasis Playwright serta tool scaffolding coding agent yang otomatis membuat boilerplate spider untuk Anda.
Satu hal yang perlu diluruskan: core engine Scrapy adalah HTTP crawler, bukan browser. Ia tidak merender JavaScript dengan sendirinya. Kalau Anda butuh itu, Anda harus pakai scrapy-playwright, middleware bergaya Selenium, atau layanan rendering eksternal. Itu bukan kekurangan mutlak — itu keputusan desain yang sengaja bikin core framework tetap ramping dan cepat — tapi artinya "menangani situs yang banyak JS" adalah keputusan proyek, bukan perilaku bawaan.
Perbedaan Inti: Workflow Agentic yang Dikelola vs Framework Milik Sendiri
Waktu menuju dataset pertama
Saya tidak akan mengarang angka stopwatch di sini — saya sudah terlalu sering lihat artikel yang bilang Scrapy punya "learning curve yang curam" tanpa pernah nunjukin hitungannya. Jadi mari kita lihat langkah nyatanya saja.
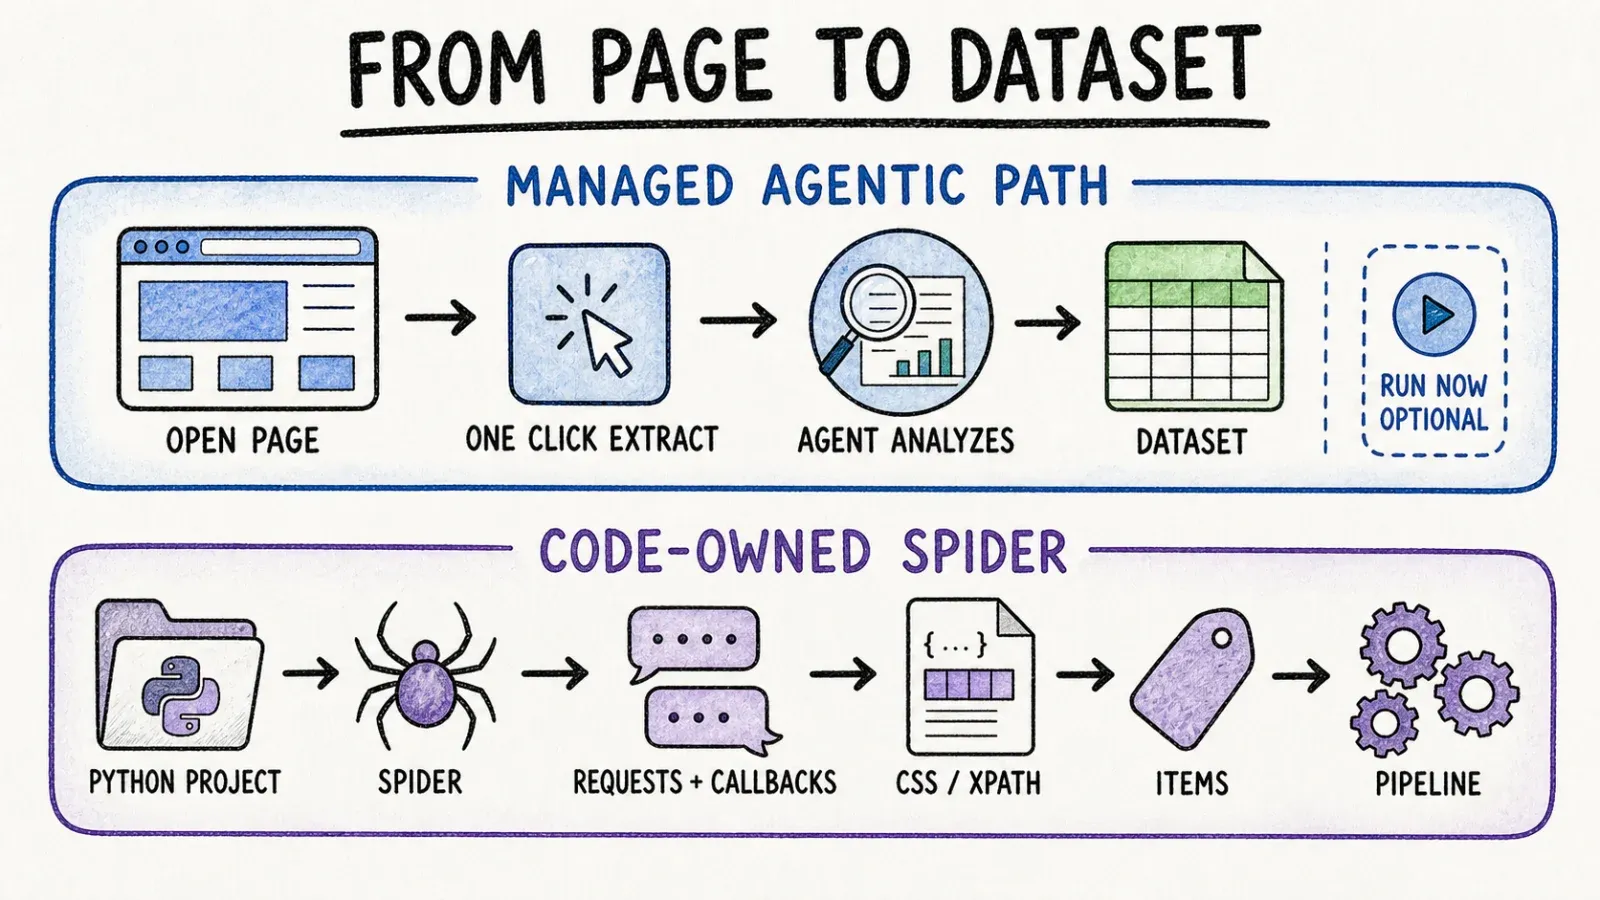
Jalur Scrapy untuk, misalnya, mengambil data dari halaman daftar produk:
- Siapkan virtual environment Python dan instal Scrapy.
- Generate spider dari template.
- Cek HTML halaman dan tulis selector XPath/CSS untuk setiap field.
- Konfigurasikan item pipeline untuk pembersihan dan ekspor.
- Jalankan spider, debug selector yang meleset, lalu jalankan ulang.
Jalur Thunderbit untuk tugas yang sama:
- Buka halaman di browser Anda.
- Klik One Click Extract.
- Agen mengidentifikasi field yang bisa diekstrak dan mulai berjalan (atau Anda tekan Run Now).
Itu lima langkah dengan environment Python di belakangnya versus tiga langkah tanpa setup environment sama sekali. Saya bukan bilang jumlah langkah adalah satu-satunya metrik penting — lima langkah di Scrapy memberi Anda kontrol jauh lebih besar atas apa yang terjadi — tapi kalau target Anda memang "masukkan tabel ini ke spreadsheet hari ini", ya perbedaan langkah itulah ceritanya.
Kontrol dan extensibility
Di sini Scrapy unggul, dan saya akan tidak jujur kalau pura-pura sebaliknya. Karena source code-nya milik Anda, Anda bisa membangun apa saja: retry logic kustom, pola pagination yang aneh, alur autentikasi multi-langkah, integrasi dengan data warehouse yang sudah ada, apa pun yang dituntut arsitektur Anda. Pendekatan agentic Thunderbit mengoptimalkan "dapatkan data terstruktur dengan cepat tanpa menulis kode", yang secara definisi berarti ia mengambil keputusan untuk Anda alih-alih membuka semua tuas. Untuk 80% tugas ekstraksi bisnis, trade-off ini sangat bagus. Untuk 20% sisanya — logika crawling yang benar-benar rumit dan sangat spesifik — Anda butuh framework yang bisa Anda tekuk sesuka hati.
Kepemilikan maintenance dan operasional
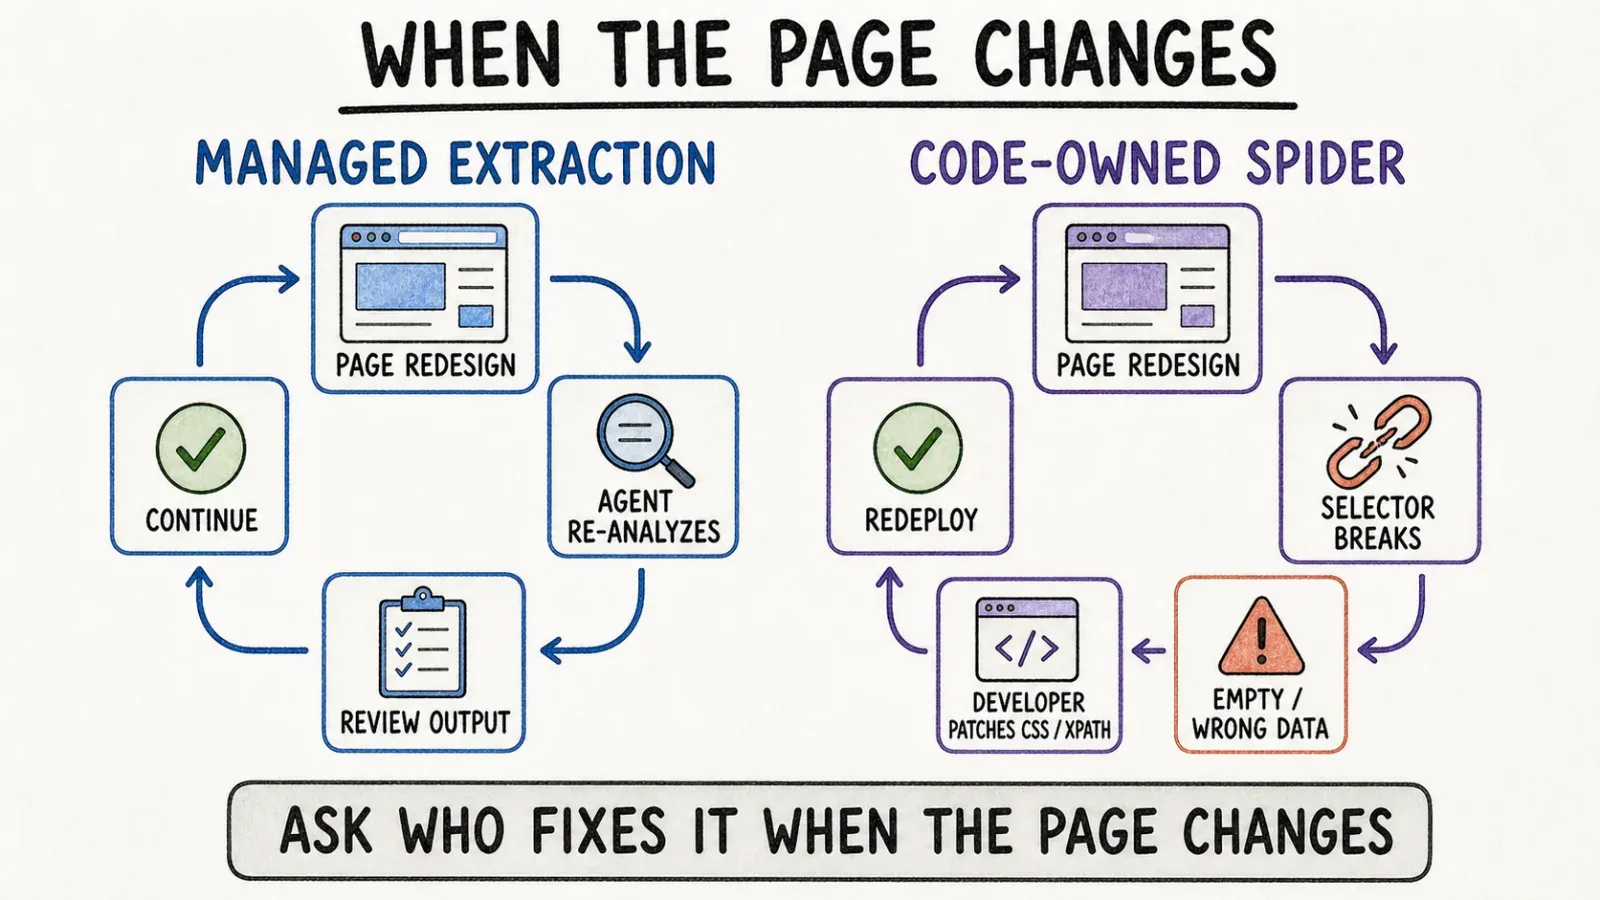
Spider bisa rusak. Ini bukan sindiran untuk Scrapy — semua scraper, baik agentic maupun yang ditulis manual, tetap bergantung pada website yang dituju. Tapi saat spider Scrapy rusak karena sebuah situs mendesain ulang HTML-nya, seseorang di tim Anda harus sadar, mendiagnosis, dan memperbaikinya. Itu benar-benar waktu developer, setiap saat.
Ekstraksi berbasis AI dari Thunderbit bisa menyesuaikan sebagian perubahan layout secara otomatis karena dia menalar struktur halaman, bukan mencocokkan jalur selector yang di-hardcode. Meski begitu, saya mau jujur: ini bukan berarti kebal. Perubahan struktur yang cukup drastis tetap bisa bikin dia gagal. Bedanya lebih ke siapa yang melakukan penyesuaian — algoritma yang menebak sebaik mungkin, atau developer yang menulis ulang XPath jam 11 malam.
Skenario Praktis
Direktori atau tabel produk satu kali pakai
Kalau Anda butuh tabel daftar restoran, harga produk, atau detail acara dari satu halaman atau daftar halaman pendek, bikin proyek Scrapy jelas berlebihan — Anda akan menulis spider yang dipakai sekali lalu tidak pernah disentuh lagi. Ini jelas wilayah Thunderbit lewat ekstensi browser: buka, klik, ekstrak, ekspor ke Google Sheets, selesai.
Crawl custom skala besar dengan aturan bisnis
Sekarang bayangkan Anda perlu merayapi 50.000 halaman produk di belasan domain, menerapkan logika deduplikasi kustom, lalu memasukkan semuanya ke model pricing milik sendiri. Itu habitat alami Scrapy. Arsitektur pipeline, kontrol concurrency, ekosistem middleware — semuanya memang disiapkan untuk pekerjaan sebesar ini dengan logika kustom sebanyak itu.
Situs dinamis yang berat JavaScript
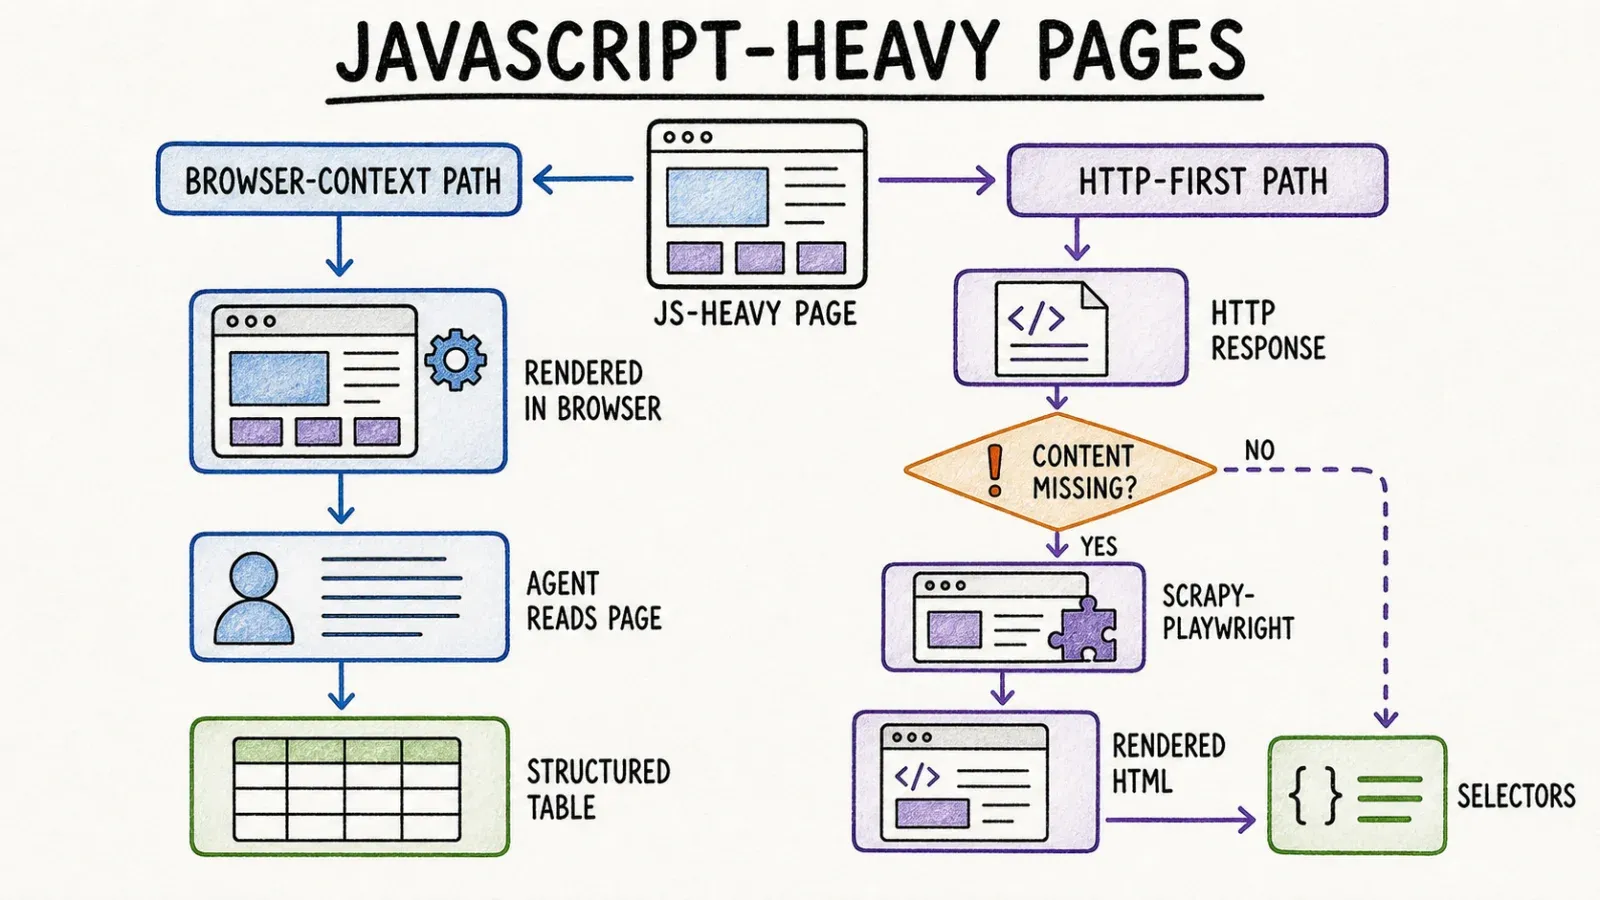
Kedua alat ini sama-sama butuh bantuan di sini, cuma bentuk bantuannya beda. Scrapy butuh integrasi rendering eksplisit seperti scrapy-playwright yang dipasangkan, jadi ada tambahan dependensi dan permukaan maintenance. Ekstensi browser Thunderbit bekerja dari halaman yang sudah dirender di browser Anda — termasuk beberapa sesi login yang didukung — sehingga banyak setup bisa dilewati. Tapi saya harus tegas: tidak ada pendekatan yang menjamin menang melawan sistem anti-bot agresif atau pola konten dinamis yang aneh. Siapa pun yang bilang sebaliknya sedang jualan sesuatu.
Integrasi agen AI atau aplikasi
Kalau Anda membangun workflow agen AI di Claude atau Cursor dan ingin dia mengambil data web langsung sebagai bagian dari loop penalarannya, bikin integrasi kustom dengan Scrapy itu lumayan besar pekerjaannya. MCP Server dari Thunderbit memang dibuat untuk ini — ia mengekspos ekstraksi sebagai tool yang bisa dipanggil langsung oleh agen Anda.
Akurasi, Skala, dan Maintenance
Akurasi Scrapy bersifat deterministik dalam arti terbaik — selector yang ditulis dengan benar akan mengambil field yang memang Anda minta, setiap kali, sampai HTML dasarnya berubah. Kepastian seperti ini sangat berharga untuk pipeline produksi saat Anda perlu tahu persis kenapa sesuatu gagal.
Deteksi agentic Thunderbit bekerja beda. Ia menafsirkan halaman seperti cara manusia melihatnya dan memutuskan mana yang kemungkinan harga, judul, atau deskripsi. Ini sangat berguna untuk kecepatan dan fleksibilitas, tapi model akurasinya juga beda — lebih dekat ke "biasanya benar, kadang perlu dorongan" daripada "selalu persis seperti yang dikatakan selector". Saya lebih pilih jujur soal trade-off ini daripada pura-pura ekstraksi berbasis AI itu sempurna.
Untuk throughput mentah, engine asinkron Scrapy memang dirancang untuk menangani volume request yang sangat besar secara efisien — itu memang bagian dari DNA desainnya. Thunderbit lebih dioptimalkan untuk pekerjaan terarah dengan volume moderat, di mana hasil terstruktur yang rapi dan cepat lebih penting daripada crawl satu juta halaman semalaman. Kalau Anda sedang merencanakan crawl yang benar-benar besar, cek batas paket yang berlaku sebelum mengasumsikan salah satu alat akan scale sesuai kebutuhan Anda.
Satu hal lagi yang berlaku untuk keduanya: penggunaan yang berwenang itu penting. Apa pun alat yang Anda pilih, menghormati robots.txt, syarat situs, dan hukum yang berlaku bukan pilihan — itu bagian dari praktik yang bertanggung jawab.
Harga, Lisensi, dan Total Biaya
Ada jebakan yang sering banget saya lihat: menganggap "gratis" dan "tanpa biaya" itu hal yang sama. Scrapy memang tidak punya biaya lisensi — open source, titik. Tapi software "gratis" tetap butuh tempat untuk berjalan, dan tempat itu ada biayanya: hosting, layanan proxy kalau volumenya besar, tool browser automation kalau Anda perlu rendering JS, monitoring supaya Anda tahu saat spider mati diam-diam, dan — yang paling besar — waktu developer untuk membangun, menguji, dan memperbaikinya saat rusak.
Thunderbit memakai model langganan/kredit, dan saya sarankan Anda merujuk ke halaman harga resmi alih-alih percaya angka yang saya sebutkan di sini, karena struktur harga bisa berubah dan saya lebih suka Anda lihat ketentuan terbaru langsung. Yang dibeli dari langganan itu adalah berkurangnya sebagian besar beban setup dan maintenance tadi — untuk alur kerja yang didukung, tentu saja.
Pertanyaan sebenarnya bukan "mana yang lebih murah di atas kertas." Pertanyaannya adalah "tim Anda lebih punya apa — jam kerja developer atau budget langganan?" Tim data engineering berisi lima orang dengan waktu luang mungkin akan menemukan total biaya Scrapy lebih rendah setelah faktor skill yang sudah mereka miliki. Tim ops tiga orang tanpa engineer internal akan merasa bahwa framework "gratis" justru menelan biaya invoice kontraktor dan penundaan tiga minggu sebelum mereka melihat satu baris data pun.
Siapa yang Sebaiknya Memilih Thunderbit?
Thunderbit paling masuk akal kalau Anda operator non-teknis — sales, marketing, ecommerce, real estate, recruiting — yang butuh data terstruktur sekarang dan tidak ingin buka tiket engineering cuma untuk mendapatkannya. Ini juga cocok untuk developer yang ingin akses programatik tanpa membangun logika ekstraksi dari nol, karena Open API dan CLI sudah menangani lapisan itu untuk Anda. Kalau workflow Anda berkaitan dengan lead generation, monitoring ecommerce, atau scraping LinkedIn untuk riset rekrutmen, ini biasanya jalur yang lebih cepat.
Siapa yang Sebaiknya Memilih Scrapy?
Scrapy adalah pilihan yang tepat kalau Anda punya developer Python di tim, Anda sedang membangun infrastruktur crawling yang harus bertahan bertahun-tahun, dan Anda butuh kontrol penuh atas logika request, perilaku retry, dan pipeline data. Ini juga lebih cocok kalau persyaratan compliance atau arsitektur mengharuskan kode sepenuhnya milik Anda — bisa diaudit, self-hosted, tanpa ketergantungan eksternal.
Bisakah Tim Menggunakan Keduanya?
Banyak tim melakukannya, dan menurut saya itu bukan jawaban yang muter-muter. Developer bisa menjalankan spider Scrapy yang tahan lama dan berskala besar untuk infrastruktur crawling yang memang harus selalu ada, sementara bagian organisasi lainnya memakai Thunderbit untuk riset ad hoc, pengambilan data satu kali, dan pekerjaan eksploratif yang tidak pantas dapat sprint engineering penuh. Tidak ada integrasi resmi antara kedua tool ini — saya mau jelas soal itu — tapi secara operasional, tidak ada yang menghalangi Anda menjalankannya berdampingan sesuai kecocokan tiap pekerjaan.
Putusan Akhir
Kalau saya harus merangkumnya jadi satu pertanyaan instingtif: Anda sedang mengoptimalkan kontrol atau kecepatan? Scrapy memberi Anda kontrol total dengan harga waktu setup dan maintenance yang terus berlanjut. Thunderbit memberi Anda kecepatan dan aksesibilitas dengan harga fleksibilitas yang lebih terbatas. Tidak ada jawaban yang secara objektif paling benar — semuanya tergantung apakah orang yang melakukan scraping itu tahu Python atau lebih paham pipeline sales-nya. Untuk pembahasan yang lebih luas tentang bagaimana ekstraksi berbasis AI dibandingkan metode tradisional, ulasan kami tentang AI web scraping dan web scraping tanpa coding membahas lanskap yang lebih besar di luar perbandingan ini saja.
FAQ
Apakah Scrapy gratis? Framework Scrapy sendiri adalah open source tanpa biaya lisensi, sesuai situs resmi Scrapy. Biaya nyata datang dari hosting, proxy, tool rendering kalau Anda butuh dukungan JS, dan waktu developer untuk membangun serta memelihara spider.
Apakah Scrapy merender JavaScript sendiri? Tidak. Core Scrapy adalah HTTP crawler, bukan browser, jadi ia tidak mengeksekusi JavaScript secara bawaan. Tim biasanya menambahkan scrapy-playwright atau middleware bergaya Selenium ketika perlu meng-scrape situs yang banyak JS, sesuai dokumentasi resmi Scrapy.
Apakah Thunderbit mendukung akses API dan MCP? Ya. Thunderbit menyediakan Open API dengan endpoint Distill dan Extract terstruktur untuk penggunaan programatik, serta MCP Server yang memungkinkan agen AI di tool seperti Claude dan Cursor memanggil Thunderbit secara langsung.
Mana yang lebih cepat untuk pengguna bisnis? Thunderbit, memang didesain begitu. Alur ekstensi browser One Click Extract memulai ekstraksi otomatis setelah menganalisis halaman, tanpa selector atau setup skema — jauh lebih singkat daripada memasang Python dan menulis spider.
Mana yang lebih baik untuk crawl yang sangat kustom? Scrapy. Middleware, arsitektur pipeline, dan akses penuh ke source code memberi developer kontrol yang dibutuhkan untuk logika crawling yang sangat spesifik, tugas terjadwal berskala besar, dan pipeline data kustom yang memang bukan target pengganti tool agentic.




