
Saya sudah berkali-kali menerima pertanyaan ini di inbox: "Harus pakai Thunderbit atau ScrapeStorm untuk tarik data?" Dan jujur, pertanyaannya memang masuk akal — keduanya sama-sama menjanjikan data terstruktur dari website tanpa perlu merekrut developer. Tapi cara kerjanya benar-benar beda, dan kalau salah pilih untuk workflow Anda, hasilnya bisa dua macam: buang-buang waktu bikin aturan yang sebenarnya tidak perlu, atau mentok saat Anda justru butuh kontrol yang lebih detail.
Jadi, saya mengulas kedua produk ini, membaca dokumentasi resminya, lalu memetakan di mana masing-masing benar-benar unggul. Berikut rangkuman jujurnya — tanpa embel-embel marketing, hanya apa yang benar-benar dilakukan tiap tool dan siapa yang paling cocok memakainya.
Jawaban Singkat
Kalau mau versi pendeknya: Thunderbit dirancang untuk orang yang lebih suka agent membaca halaman lalu langsung memahami datanya, daripada duduk dan merancang logika ekstraksi sendiri. Anda klik One Click Extract, tool membaca halaman, lalu mulai menarik data terstruktur — Run Now tersedia kalau Anda ingin langsung memulainya, tapi sifatnya opsional karena tugasnya memang akan jalan otomatis.
Di sisi lain, ScrapeStorm menyediakan Smart Mode untuk deteksi otomatis pada halaman daftar dan konten yang umum, plus Flowchart Mode tempat Anda bisa menyusun logika klik-scroll-tunggu-loop secara eksplisit saat situs membutuhkan lebih dari sekadar pengenalan pola.
Keduanya bukan "yang manual" dan keduanya juga bukan "yang sepenuhnya otomatis." Itulah salah satu kesalahpahaman terbesar yang sering saya lihat di artikel perbandingan — ScrapeStorm sering digambarkan seolah-olah sepenuhnya berbasis aturan dan ribet, padahal itu meremehkan Smart Mode; sementara Thunderbit sering digambarkan seolah-olah bisa bekerja ajaib di semua situs, yang juga tidak realistis. Kompatibilitas dan otorisasi tetap penting untuk keduanya.
Thunderbit vs ScrapeStorm Sekilas
Sebelum masuk lebih dalam, berikut tabel yang saya harap sudah ada saat pertama kali membandingkan keduanya:
Saya sengaja tidak memasukkan peringkat kecepatan dan akurasi di sini. Saya belum melihat benchmark independen yang benar-benar terkontrol untuk membandingkan keduanya secara head-to-head, dan klaim kecepatan dari vendor (seperti "3-10x" dari ScrapeStorm) sangat bergantung pada waktu loading halaman dan bagaimana tugasnya dirancang. Jadi saya tidak mau pura-pura punya data yang memang tidak saya miliki.
Apa Itu Thunderbit?
Thunderbit adalah produk yang kami bangun di perusahaan saya — sebuah agentic web scraper yang dibuat untuk orang yang sama sekali tidak ingin belajar XPath atau CSS selectors, tapi sangat butuh spreadsheet data sebelum hari berakhir.

Berikut alur kerja yang benar-benar sekarang, karena saya sering melihat ulasan lama menggambarkan antarmuka yang sudah tidak ada lagi (nanti saya bahas soal isu "0 Ratings" itu): Anda klik One Click Extract di ekstensi browser, lalu agent Thunderbit mendeteksi, membaca, dan menganalisis halaman yang sedang dibuka. Ia menentukan field yang masuk akal — nama produk, harga, info kontak, apa pun yang sesuai dengan struktur halaman — lalu langsung berjalan. Run Now ada kalau Anda ingin memicunya segera, tapi kalau tidak diklik pun prosesnya tetap akan mulai sendiri.
Bagian ini yang sering mengejutkan orang. Tidak ada langkah "review selector" atau fase membangun schema. Anda bisa menyempurnakannya setelah itu dengan bahasa biasa — misalnya minta format tanggal diubah atau kolom nama dipisah — dan pada halaman yang kompatibel, Thunderbit bisa menangani pagination serta subpage enrichment (misalnya: scrape halaman daftar, lalu otomatis ambil detail tambahan dari setiap halaman detail yang ditautkan).
Selain ekstensi browser, Thunderbit juga punya Web App, Open API untuk developer yang ingin memicu ekstraksi secara terprogram, MCP Server agar AI agent seperti Claude atau Cursor bisa memakai Thunderbit sebagai tool, dan CLI untuk workflow berbasis terminal. Hasil ekspor tersedia ke Excel, Google Sheets, Airtable, Notion, dan format lain yang didukung.
Saya tegaskan saja: semua ini hanya berjalan baik pada halaman yang kompatibel dan yang memang Anda berwenang untuk akses. Ini bukan kunci universal yang bisa membuka semua pintu terkunci di internet.
Apa Itu ScrapeStorm?
ScrapeStorm mengambil pendekatan arsitektur yang sangat berbeda. Ini adalah aplikasi yang diunduh — Windows, macOS, atau Linux — dan sudah cukup lama hadir hingga punya fitur yang benar-benar sangat lengkap.
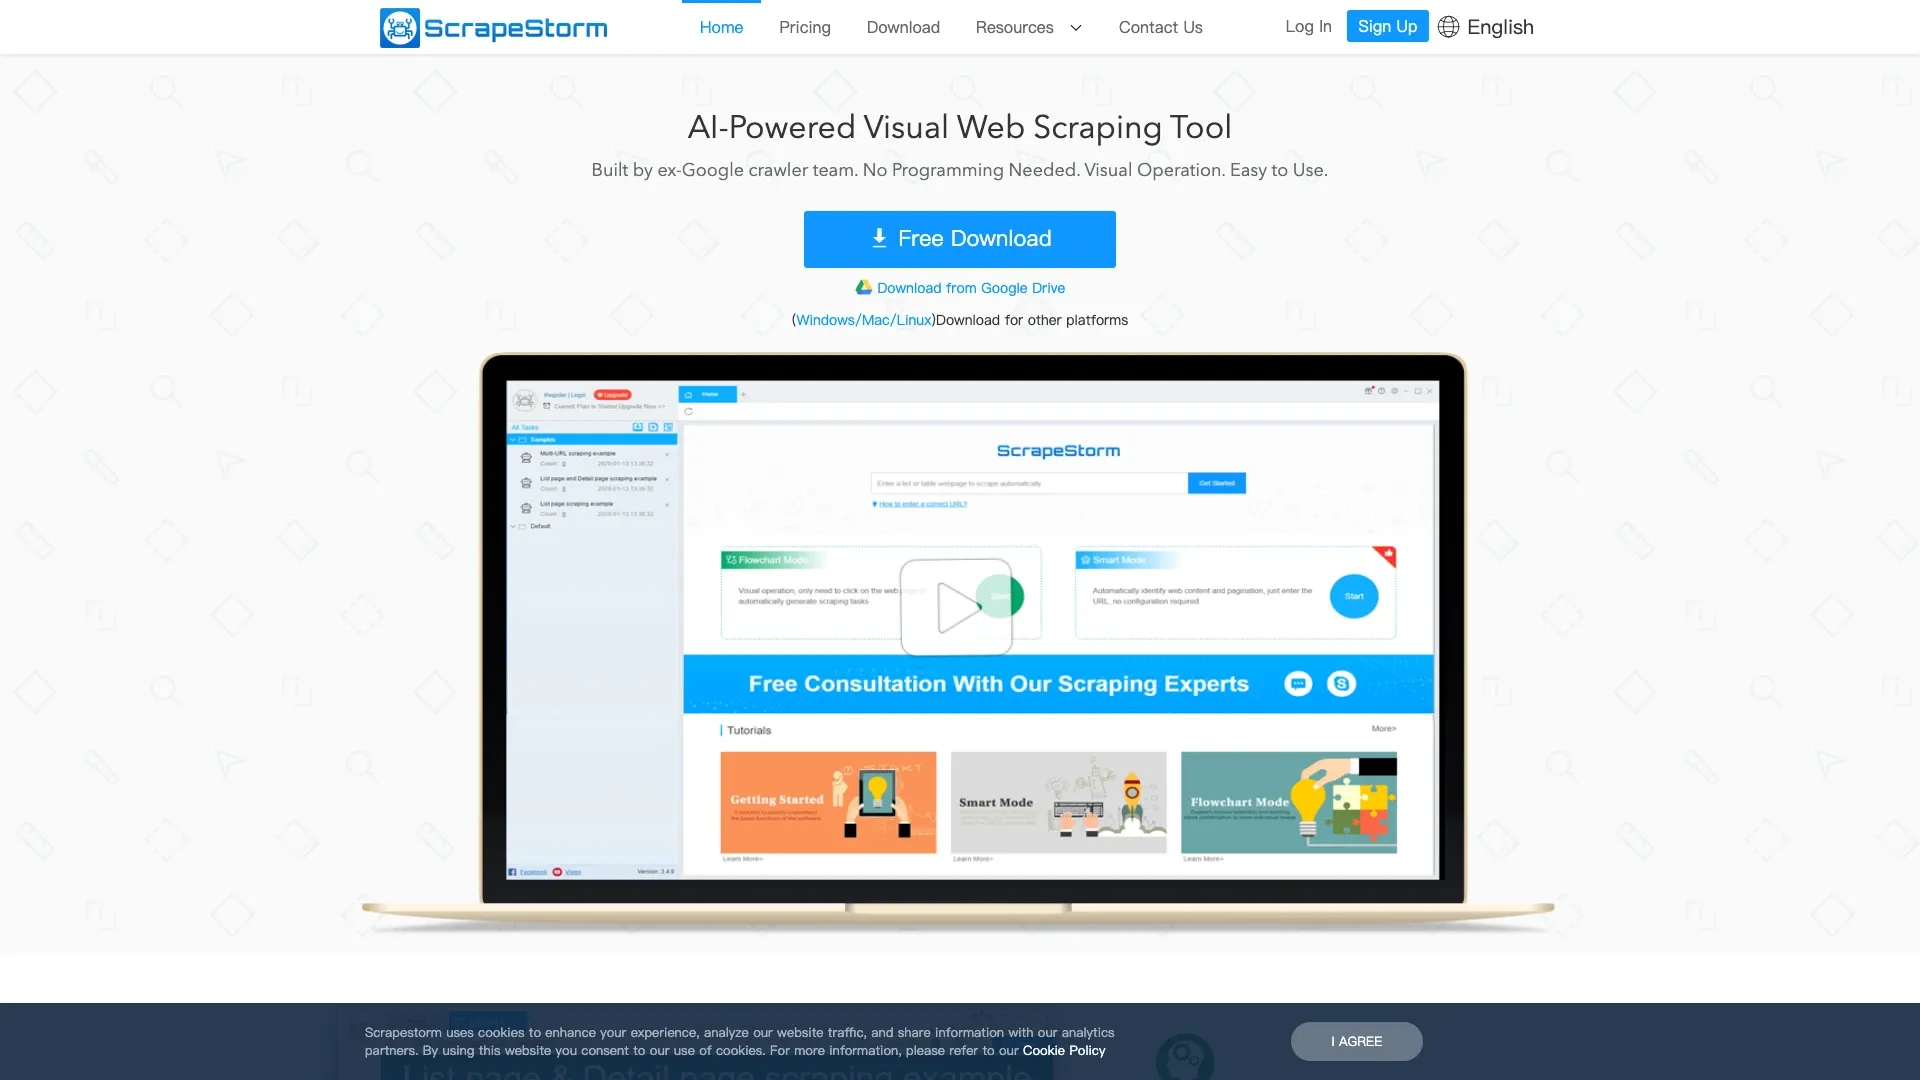
Inti dari ScrapeStorm ada pada dua mode operasinya, dan memahami perbedaannya sangat penting untuk menentukan apakah tool ini cocok untuk kebutuhan Anda.
Smart Mode mencoba mengenali konten dan struktur pagination secara otomatis pada halaman daftar dan halaman bergaya konten. Menurut tutorial resmi ScrapeStorm tentang cara memilih mode yang tepat, mode ini bekerja baik ketika halaman mengikuti pola yang mudah dikenali — misalnya grid listing produk, feed artikel, dan sejenisnya.
Flowchart Mode adalah bagian yang membuat ScrapeStorm benar-benar kuat untuk situs yang kompleks. Anda menyusun flowchart visual menggunakan komponen yang dijelaskan di referensi komponen Flowchart: membuka URL, klik sesuatu, menunggu loading, scroll ke bawah, mengetik ke field form, hover untuk memunculkan dropdown, membuat cabang kondisi, looping hasil pagination atau variasi SKU, kembali ke halaman sebelumnya, menyalin nilai, bahkan menangani langkah CAPTCHA.
Kontrol granularnya banyak sekali. Kalau sebuah situs mengharuskan Anda login, lalu memfilter lewat dropdown, lalu klik lima tab sebelum data yang Anda cari muncul, Flowchart Mode memberi Anda alat untuk memodelkan urutan itu persis seperti aslinya.
ScrapeStorm juga mendukung eksekusi lokal di mesin Anda atau mode cloud/server, ekspor langsung ke database seperti MySQL, PostgreSQL, SQL Server, dan MongoDB, serta pada tier lebih tinggi, penjadwalan otomatis dan integrasi Google Sheets.
Perbedaan Inti: Delegasi ke Agent vs Kontrol Visual Hibrida
Oke, saya ingin sedikit filosofis di sini, karena menurut saya inilah kerangka keputusan yang benar-benar penting — lebih penting daripada daftar fitur apa pun.
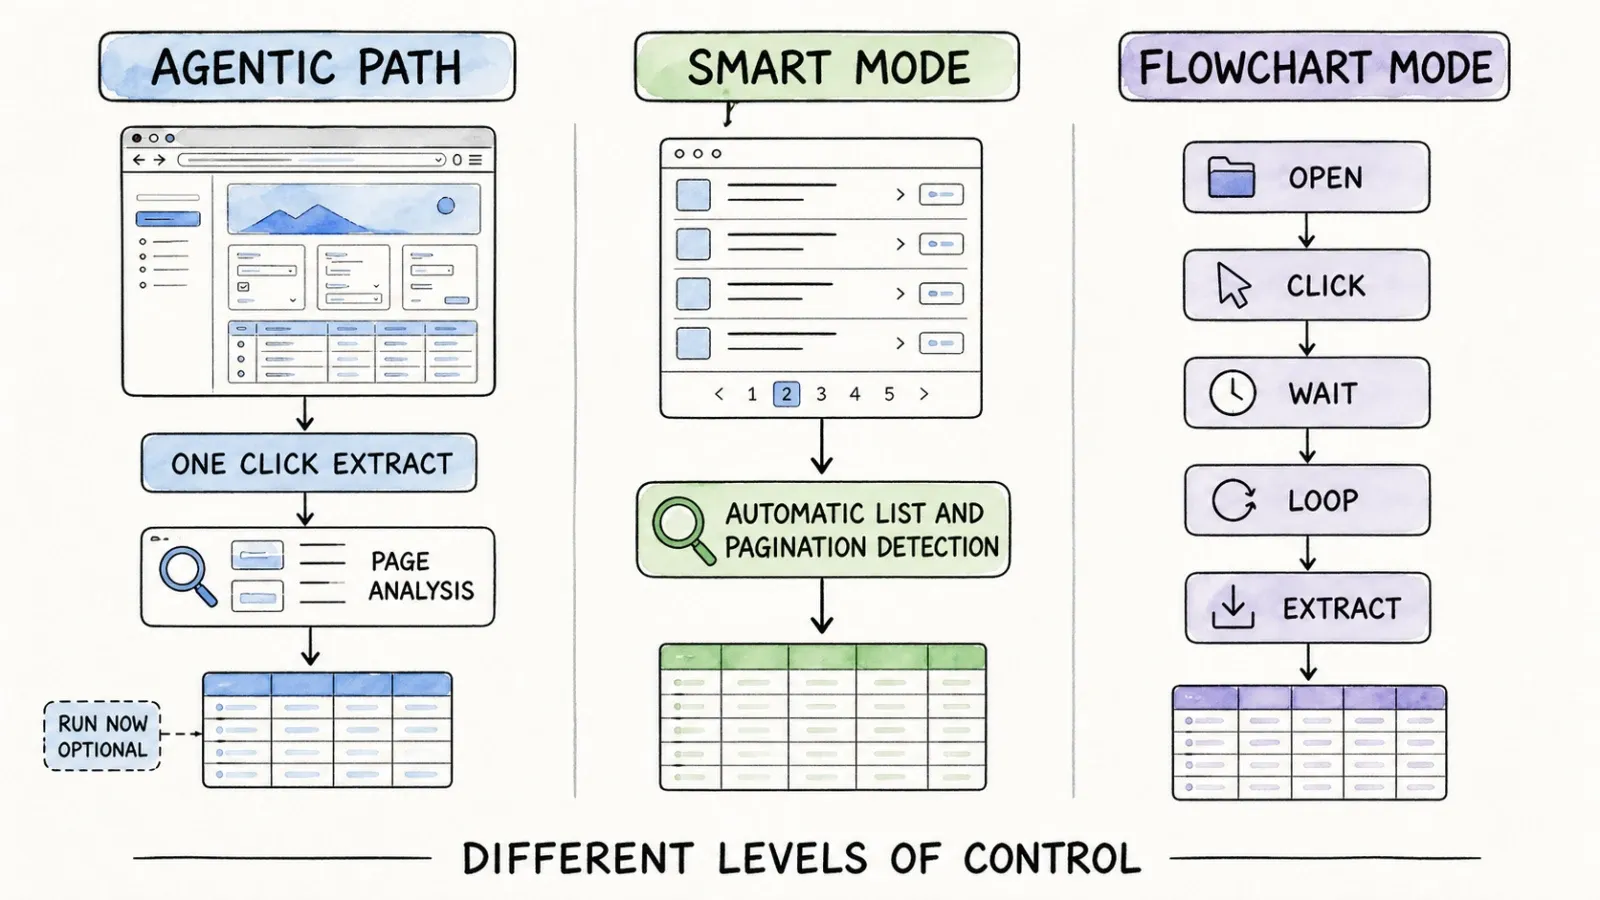
Jalur agentik satu klik milik Thunderbit
Premis utama Thunderbit adalah delegasi. Anda tidak memberi tahu tool, "harga ada di div ini, judul ada di span itu." Anda pada dasarnya berkata, "cari tahu sendiri" — lalu agent yang mengerjakannya. Ini memang jauh lebih cepat untuk memulai karena tidak ada langkah konfigurasi antara "saya sudah membuka halaman" dan "saya punya data terstruktur."
Tantangannya adalah Anda mempercayakan interpretasi pada agent. Untuk sebagian besar halaman standar — listing produk, direktori, halaman ulasan — ini bekerja sangat baik. Untuk halaman dengan struktur yang aneh atau data yang ambigu, Anda mungkin perlu mengarahkannya dengan instruksi bahasa alami.
Smart Mode milik ScrapeStorm
Smart Mode adalah jawaban ScrapeStorm untuk masalah yang sama, dan saya rasa tidak adil jika menyebutnya "manual" — ini tetap deteksi pola otomatis, hanya saja dibangun di atas pengenalan tipe halaman tertentu, bukan penalaran agentik yang terbuka. Saat bekerja, setup-nya memang ringan. Saat halaman tidak cocok dengan pola yang dikenali, Anda akan diarahkan ke Flowchart Mode.
Flowchart Mode milik ScrapeStorm
Ini adalah mode yang memang membutuhkan penyusunan workflow secara nyata. Anda membangun urutan langkah, mengujinya, lalu debugging kalau ada klik yang tidak terbaca atau waktu tunggu yang terlalu singkat. Mode ini kuat, tapi jenis pekerjaannya berbeda — lebih mirip pemrograman ringan dengan blok visual daripada sekadar "arah ke halaman lalu dapat data."
Perbedaan yang terus saya tekankan: Thunderbit langsung memberi output tabel pada halaman yang kompatibel. Flowchart Mode ScrapeStorm memberi Anda workflow yang Anda bangun, uji, dan sekarang bisa dipakai berulang dengan hasil yang konsisten — tapi Anda membayar kepastian itu dengan waktu setup.
Perbandingan Workflow Praktis
Izinkan saya membahas beberapa skenario realistis, karena perbandingan fitur yang terlalu abstrak biasanya kurang membantu.
Daftar atau tabel sederhana
Kalau Anda mengambil tabel yang straightforward — misalnya direktori bisnis berisi nama, alamat, dan nomor telepon — alur satu klik Thunderbit sangat cepat. Smart Mode ScrapeStorm juga seharusnya mampu menangani ini, selama halaman tersebut cocok dengan pola listing yang dikenali.
Pagination dan infinite scroll
Ini salah satu masalah yang paling sering saya lihat disebut dalam feedback pengguna — tidak ada yang ingin klik "next page" lima puluh kali secara manual. Thunderbit menangani pagination yang kompatibel dan subpage enrichment secara otomatis sebagai bagian dari alur agentiknya, selama struktur halamannya mendukung. Smart Mode ScrapeStorm juga bisa mendeteksi pagination otomatis pada tipe halaman yang didukung, dan jika itu gagal, Flowchart Mode menyediakan komponen loop eksplisit yang memang dibuat untuk hal ini — looping antar halaman atau scrolling untuk konten infinite-scroll.
Tidak ada tool yang menjamin berhasil di setiap pola pagination yang ada. Beberapa situs memakai logika pagination yang memang sulit (tombol "load more" berbasis JavaScript dengan timing yang aneh), dan kedua tool tetap bergantung pada perilaku aktual halaman target.
Halaman detail dan navigasi multi-langkah
Di sinilah perbedaannya makin terasa. Jika Anda perlu masuk dari halaman daftar ke halaman detail individual dan mengambil field tambahan dari masing-masing item, subpage enrichment Thunderbit pada halaman yang kompatibel akan melakukannya dalam workflow agentik yang sama — tanpa konfigurasi terpisah. ScrapeStorm juga bisa melakukan ini, tetapi biasanya membutuhkan Flowchart Mode untuk memodelkan urutan klik-masuk-ke-halaman-detail-lalu-ekstrak secara eksplisit.
Login, form, dan pekerjaan yang banyak interaksi
Ini pertanyaan yang memang sering muncul: "bisa jalan di balik login nggak?" Thunderbit bisa bekerja di dalam sesi browser yang sudah login dan berwenang, jika didukung — artinya kalau Anda sudah login ke suatu situs di browser, ekstensi dapat berjalan dalam sesi tersebut. Tapi ini bukan jaminan untuk semua metode autentikasi atau semua sistem anti-bot.
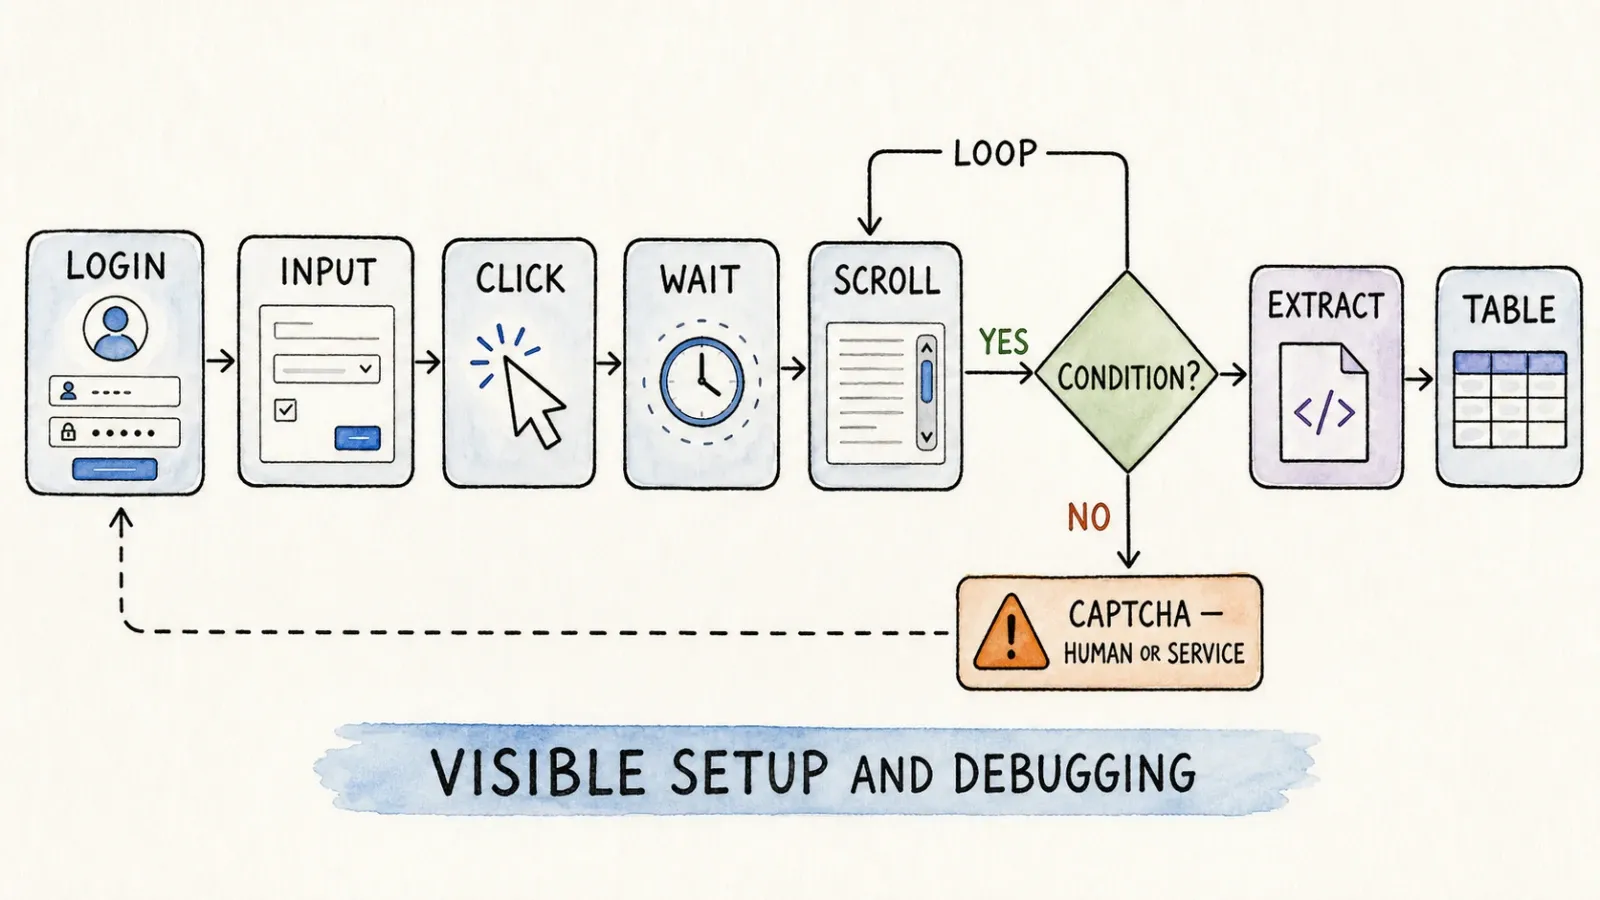
Flowchart Mode ScrapeStorm memberi komponen input dan klik yang eksplisit, jadi Anda bisa memodelkan urutan login langkah demi langkah jika perlu — ketik username, ketik password, klik submit, tunggu redirect. Lebih hands-on, tapi juga lebih transparan soal apa yang terjadi di setiap langkah.
Untuk CAPTCHA: tier Business ScrapeStorm menyertakan fitur penanganan CAPTCHA. Tidak ada tool yang seharusnya digambarkan bisa menembus semua sistem anti-bot — itu klaim yang tidak realistis untuk alat scraping mana pun.
Pengumpulan terjadwal berulang
Kalau Anda butuh data ini mingguan atau harian, keduanya mendukung scheduling — Thunderbit melalui paket berbasis cloud (cek paket Anda untuk detailnya), sedangkan ScrapeStorm mulai dari tier Premium dengan opsi per jam/harian/mingguan serta ekspor otomatis.
Otomasi dan Akses Developer
Untuk tim yang ingin melampaui point-and-click, keduanya punya lapisan untuk developer, tetapi dibangun dengan cara yang berbeda.
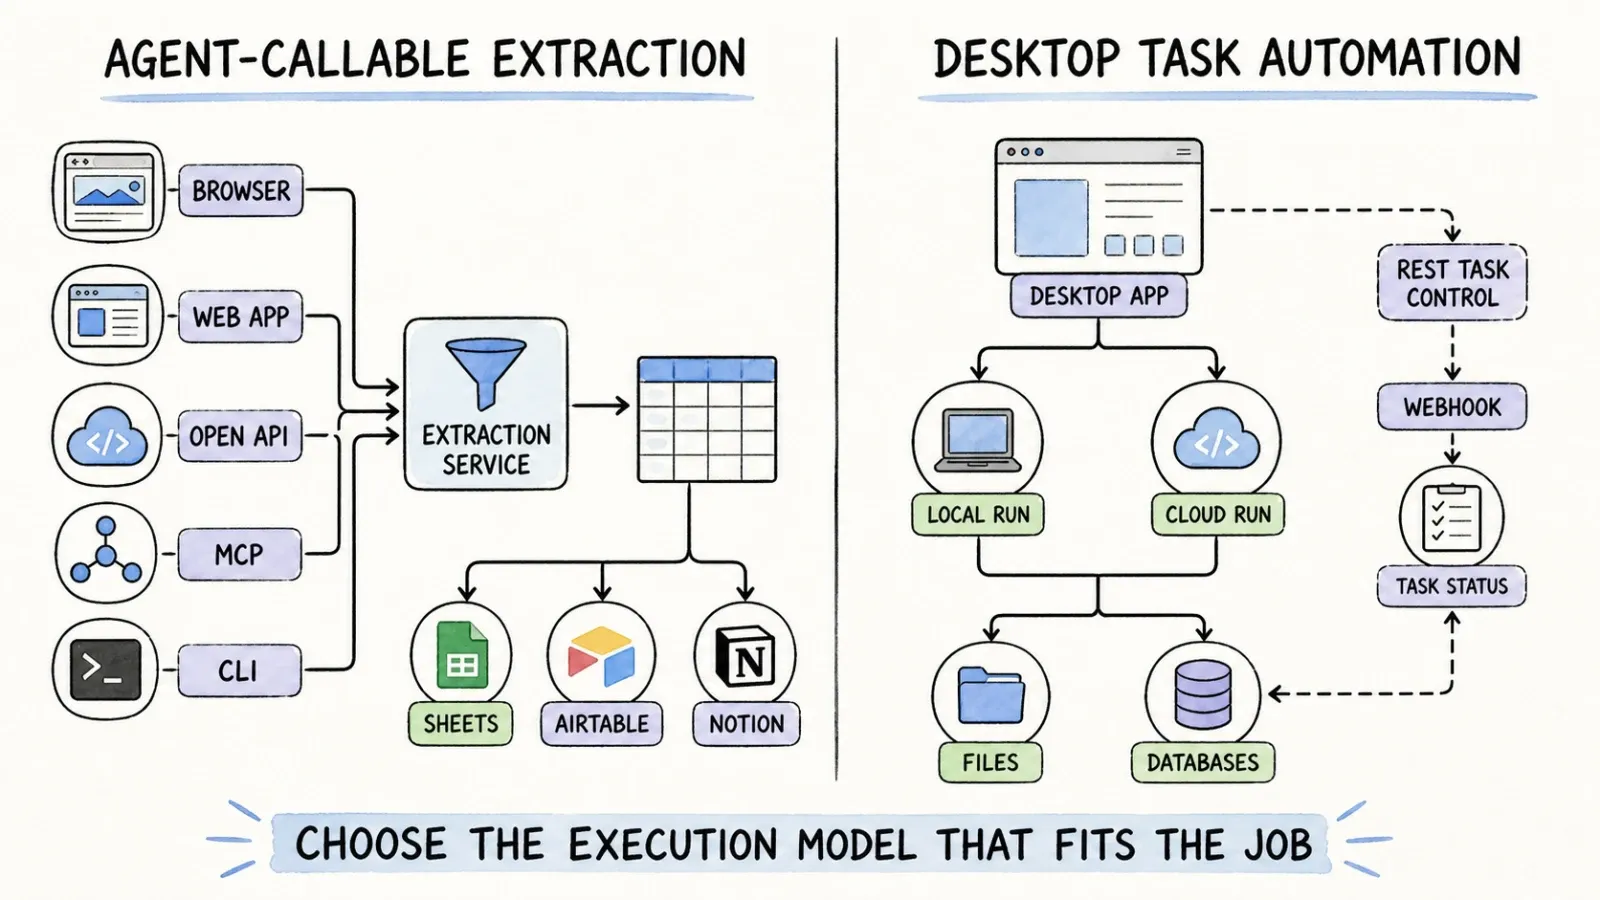
Tier Business ScrapeStorm menyertakan RESTful API yang memungkinkan Anda mengontrol tugas yang berjalan di aplikasi ScrapeStorm lokal — memuat tugas, memeriksa status, memulai, menghentikan, membersihkan data, dan semacamnya. Ada juga webhook dan task group. Saya ingin akurat di sini: ini adalah otomasi kontrol tugas untuk aplikasi desktop yang berjalan lokal, bukan hosted extraction API yang mengambil dan mengembalikan data dari server di tempat lain. Perbedaan ini penting kalau Anda sedang merancang sistem di sekitarnya.
Open API milik Thunderbit dirancang lebih seperti API tradisional — Anda bisa memicu ekstraksi dan mendapatkan data terstruktur secara programatik tanpa perlu aplikasi desktop berjalan di komputer lokal. MCP Server juga sangat menarik bagi siapa pun yang sedang membangun dengan AI agent saat ini — ia mengekspos kemampuan ekstraksi Thunderbit sebagai tool yang bisa dipanggil langsung oleh agent di Claude, Cursor, atau lingkungan serupa. Dan CLI memberi pengguna yang nyaman dengan terminal cara untuk menskrip job ekstraksi.
Kalau Anda membangun workflow agentik atau ingin menempatkan ekstraksi sebagai satu langkah di pipeline otomasi yang lebih besar, menurut saya kombinasi API/MCP adalah tempat arsitektur Thunderbit benar-benar unggul untuk use case developer.
Ekspor dan Deployment
Opsi ekspor ScrapeStorm sangat condong ke workflow file lokal dan database: Excel, TXT, CSV, HTML secara lokal, plus koneksi langsung ke MySQL, PostgreSQL, SQL Server, dan MongoDB. Integrasi Google Sheets dan ekspor otomatis muncul mulai dari tier Premium.
Ekspor Thunderbit dirancang di sekitar tool yang memang sudah dipakai tim bisnis sehari-hari — Excel, Google Sheets, Airtable, Notion — plus format lain yang saat ini didukung (cek situs Thunderbit untuk daftar terbarunya).
Perbedaan operasional yang lebih dalam ada di sini: model desktop-first ScrapeStorm berarti Anda mengelola file tugas dan menjalankan aplikasi di mesin tertentu (atau sampai tiga mesin sekaligus pada paket Business). Sementara model browser dan cloud Thunderbit berarti overhead pengelolaan mesin lebih kecil, tetapi juga mengurangi kendali model "semua ini hidup sepenuhnya di komputer saya" yang kadang lebih disukai tim yang sangat sensitif terhadap data.
Harga
Saya selalu menyarankan orang untuk mengecek halaman harga langsung sebelum memutuskan, karena harga langganan berubah lebih sering dari yang kita inginkan. Meski begitu, berikut yang ditampilkan di halaman harga resmi ScrapeStorm saat saya melakukan riset:
- Starter (Gratis): 10 tugas, satu run lokal bersamaan, URL/halaman tak terbatas per tugas, tetapi dibatasi 100 baris ekspor per hari
- Professional ($45/bulan, atau $39/bulan bila ditagih tahunan): 100 tugas, dua run lokal bersamaan, batas ekspor 10.000 baris/hari, rotasi IP
- Premium ($89/bulan, atau $79/bulan tahunan): tugas tak terbatas, run lokal bersamaan tak terbatas, ekspor data tak terbatas, scheduling, integrasi Google Sheets, unduhan gambar
- Business ($179/bulan, atau $158/bulan tahunan): semua yang ada di Premium ditambah REST API, webhook, task group, unduhan file, fitur penanganan CAPTCHA, dan hingga tiga komputer bersamaan
- Customized: hubungi untuk penawaran
Saya ingin menyorot satu hal penting tentang frasa "URL/halaman tak terbatas per tugas" di tier gratis — crawling halaman yang tidak terbatas bukan berarti output yang bisa dipakai juga tak terbatas, karena Anda tetap dibatasi 100 baris ekspor per hari. Daya komputasi lokal, perilaku situs target, batas concurrency, dan biaya proxy (yang mungkin dijual terpisah) semuanya memengaruhi seperti apa arti "tak terbatas" dalam praktik.
Untuk harga Thunderbit saat ini, silakan cek langsung halaman harga resmi — struktur paket dan sistem kredit bisa berubah, dan saya lebih suka mengarahkan Anda ke sumber paling valid daripada menyebut angka di sini yang bisa saja sudah usang saat Anda membacanya.
Harus Pilih yang Mana?
Pilih Thunderbit jika...
Anda adalah pengguna bisnis — sales, ops, marketing, research — yang butuh data cepat dan tidak ingin menghabiskan siang hanya untuk mempelajari logika workflow tool baru. Anda bekerja terutama di browser, Anda ingin pagination yang kompatibel dan subpage enrichment ditangani tanpa konfigurasi tambahan, dan Anda lebih suka menyempurnakan hasil dengan bahasa biasa daripada debugging flowchart.
Pilih ScrapeStorm jika...
Anda nyaman dengan — atau memang menginginkan — kontrol granular atas logika interaksi browser. Anda menghadapi situs yang membutuhkan navigasi multi-langkah yang kompleks — urutan login, filter dropdown, cabang kondisi — dan Anda ingin cara visual untuk memodelkan serta debugging urutan tersebut. Anda juga ingin ekspor ke database lokal dan tidak keberatan mengelola aplikasi desktop di mesin tim Anda.
Gunakan keduanya jika...
Jujur, ini lebih sering terjadi daripada yang orang akui. Saya pernah berbicara dengan tim yang memakai Thunderbit untuk tarik data browser yang cepat dan sekali pakai, serta riset ad hoc, sementara ScrapeStorm tetap dipakai untuk job terjadwal Flowchart Mode di beberapa situs kompleks yang terkunci login dan memang butuh kontrol langkah demi langkah. Tidak ada aturan yang mewajibkan Anda memilih hanya satu tool untuk semua pekerjaan scraping di organisasi Anda.
Kesimpulan Akhir
Kalau harus diringkas dalam satu kalimat: Thunderbit memberi Anda jalur tercepat dari "buka halaman" ke "data terstruktur" lewat delegasi ke agent, sedangkan ScrapeStorm memberi Anda gabungan deteksi otomatis dan kontrol visual langsung untuk saat sebuah situs benar-benar membutuhkan logika langkah demi langkah.
Tidak ada yang secara objektif "lebih baik" dalam ruang hampa — framing seperti itu jujur saja agak malas. Saran saya: pilih satu situs target nyata yang memang Anda berwenang untuk scrape, yang benar-benar penting bagi workflow Anda, lalu uji kedua tool di situ. Ukur berapa lama setup-nya. Lihat apakah output langsung bisa dipakai atau masih perlu dibersihkan. Pikirkan siapa di tim Anda yang harus memelihara ini enam bulan lagi.
Itulah perbandingan yang sesungguhnya — bukan tabel fitur semata (meskipun yang di atas cukup bagus), melainkan data nyata Anda dan seberapa sabar tim Anda terhadap konfigurasi. Kalau Anda ingin melihat bagaimana pendekatan agentik menangani halaman spesifik Anda, ekstensi Chrome Thunderbit bisa dicoba gratis — klik One Click Extract pada halaman yang penting bagi Anda dan lihat hasilnya sebelum Anda berkomitmen ke solusi yang lebih rumit.
FAQ
Apakah ScrapeStorm benar-benar bertenaga AI?
Smart Mode ScrapeStorm memakai pengenalan pola otomatis untuk mengidentifikasi struktur daftar dan konten plus pagination pada banyak tipe halaman, yang dipasarkan vendor sebagai fitur AI/smart-detection. Ini kemampuan yang nyata, tetapi cakupannya terbatas pada pola halaman yang bisa dikenali, bukan penalaran agentik yang lebih terbuka seperti yang dipakai Thunderbit untuk menafsirkan struktur halaman apa pun.
Apa bedanya Smart Mode dan Flowchart Mode?
Smart Mode secara otomatis mencoba mendeteksi data dan pagination pada halaman bergaya daftar/konten dengan setup minimal. Flowchart Mode mengharuskan Anda membangun workflow visual eksplisit menggunakan komponen seperti klik, tunggu, scroll, input, kondisi, dan loop — memberi Anda kontrol lebih besar untuk halaman yang tidak bisa ditangani Smart Mode dengan bersih, tetapi dengan waktu setup yang lebih lama.
Apakah Thunderbit memerlukan selector atau coding?
Tidak. Workflow browser default-nya bersifat agentik — klik One Click Extract dan tool akan mendeteksi, membaca, serta menganalisis halaman untuk mengusulkan field, lalu berjalan otomatis (Run Now hanya memungkinkan Anda memulai segera, bukan menunggu). Tidak perlu XPath, CSS selector, atau desain schema manual untuk alur standar.
Apakah keduanya bisa menangani pagination dan halaman login?
Keduanya punya kemampuan yang relevan, tetapi tidak ada jaminan berhasil di semua kondisi. Thunderbit mendukung pagination yang kompatibel dan subpage enrichment pada halaman yang didukung, serta bisa bekerja dalam sesi browser yang sudah login dan berwenang jika didukung. Smart Mode ScrapeStorm mendeteksi pagination otomatis pada banyak tipe halaman, dan Flowchart Mode memiliki komponen eksplisit untuk memodelkan login dan navigasi kompleks. Hasil tetap bergantung pada struktur situs, metode autentikasi, dan proteksi anti-bot yang digunakan.
Apakah ScrapeStorm menyediakan API?
Ya, pada tier Business. Itu adalah RESTful API untuk mengontrol tugas yang berjalan di aplikasi ScrapeStorm yang diinstal secara lokal — memulai, menghentikan, memeriksa status, dan membersihkan tugas, plus dukungan webhook. Ini otomasi kontrol tugas, bukan hosted extraction API yang berjalan terpisah dari instalasi desktop lokal.
Tool mana yang lebih baik untuk ekstraksi terjadwal?
Keduanya mendukung scheduling. ScrapeStorm menawarkan penjadwalan berbasis desktop mulai dari tier Premium, dengan opsi per jam/harian/mingguan dan ekspor otomatis. Thunderbit menawarkan penjadwalan berbasis cloud tergantung paket Anda saat ini — cek halaman harga Thunderbit untuk detail terbaru yang akurat.
Apakah salah satunya bisa scrape semua website?
Tidak, dan tool yang mengklaim begitu seharusnya membuat Anda waspada. Baik Thunderbit maupun ScrapeStorm bergantung pada halaman target yang bisa diakses, kompatibel secara struktural, dan memang boleh Anda akses. Sistem anti-bot yang ketat, rendering JavaScript yang tidak biasa, dan autentikasi yang ketat bisa membatasi keduanya. Selalu uji pada target nyata Anda sebelum memutuskan workflow.




