
Setiap beberapa minggu, ada saja orang dari tim support kami yang meneruskan pertanyaan yang sama dari calon pengguna: “Apa bedanya Thunderbit dengan ScraperAPI?” Wajar kalau orang bingung — keduanya muncul di pencarian Google yang sama untuk kata kunci “web scraping tool”, keduanya menonjolkan kata “scrape” atau “scraper” di homepage, dan keduanya sama-sama menjanjikan data dari internet. Tapi setelah bertahun-tahun membangun produk otomasi dan AI (ditambah cukup banyak waktu sebelumnya membongkar alur data yang berantakan di Automation Anywhere), saya bisa bilang dua alat ini sebenarnya menjawab pertanyaan yang sangat berbeda.
Ini bukan perbandingan model “mana yang lebih bagus” — lebih mirip membandingkan jasa pindahan dengan asisten pribadi. Keduanya memang membantu Anda menyelesaikan pekerjaan, tapi Anda tidak akan menyewa salah satunya untuk mengerjakan tugas yang lain. Jadi, mari saya jelaskan apa sebenarnya ScraperAPI, apa sebenarnya Thunderbit, berapa biaya masing-masing untuk skenario nyata (sesuatu yang menurut saya jarang sekali ditaruh berdampingan), dan siapa sebaiknya memilih yang mana. Tanpa basa-basi, tanpa jawaban kabur “tergantung” kalau memang bisa dihindari.
Thunderbit vs ScraperAPI: Jawaban Singkat dalam Sekilas
Versi satu kalimatnya begini, karena saya tahu sebagian dari Anda sedang baca cepat saat jam makan siang: ScraperAPI adalah infrastruktur untuk developer yang ingin scraping dalam skala besar — proxy, penanganan CAPTCHA, dan rendering, semuanya disediakan lewat API. Thunderbit adalah lapisan ekstraksi no-code yang bersifat agentic, mengubah halaman yang sedang Anda lihat menjadi data terstruktur, dengan dukungan browser extension, Web App, Open API, dan MCP Server.
Ini tabel ringkas yang saya harap sudah ada sejak pertama kali saya menjawab pertanyaan seperti ini:
| ScraperAPI | Thunderbit | |
|---|---|---|
| Terbaik untuk | Tim engineering yang membangun pipeline scraping | Pengguna bisnis, marketer, ops, dan developer yang butuh data terstruktur dengan cepat |
| Setup yang diperlukan | API key + parameter request + logika parsing sendiri | Klik One Click Extract di halaman (browser extension), atau gunakan Open API/MCP untuk otomasi |
| Format output | HTML/JSON mentah, parser terstruktur untuk situs yang didukung | Tabel terstruktur yang siap diekspor |
| Perlu coding? | Ya, untuk sebagian besar alur kerja nyata | Tidak untuk alur browser; ya, jika memakai API/CLI/MCP |
| Pengguna ideal | Developer atau tim ops teknis | Operator non-teknis, plus developer yang ingin lapisan data terstruktur yang lebih cepat |
Kalau Anda sudah tahu Anda masuk kubu yang mana, langsung saja ke bagian di bawah yang sesuai — satu membahas ScraperAPI lebih dalam, satu membahas Thunderbit, dan lebih ke bawah ada rincian harga nyata serta kerangka keputusan yang seharusnya bisa menjawab pertanyaan “yang mana cocok untuk saya” dalam waktu kurang dari dua menit.
Apa Itu ScraperAPI? Dibuat untuk Developer dan Infrastruktur Scraping
Secara sederhana, ScraperAPI adalah layanan yang menerima URL dari Anda, lalu mengembalikan konten halaman sambil diam-diam menangani bagian-bagian yang merepotkan dalam scraping — rotasi proxy, retry request yang gagal, menghindari CAPTCHA dan sistem deteksi bot, serta opsional merender halaman berat JavaScript seperti browser sungguhan. Namun Anda tetap pihak yang menulis kode untuk memanggil API dan memproses hasilnya.
Itu perbedaan penting yang menurut saya belum cukup sering ditegaskan. ScraperAPI sekarang bukan cuma “raw HTML only” — fitur terkininya mencakup auto-parsing JSON dan endpoint data terstruktur untuk target yang didukung, plus produk DataPipeline dan akses crawler penuh untuk pekerjaan yang lebih besar. Jadi ini bukan produk yang tertinggal di 2018. Tapi asumsi inti yang tertanam dalam produknya tetap sama: Anda sudah punya, atau sedang membangun, workflow engineering di sekitarnya — sesuatu yang mengirim request, memeriksa respons, menangani retry di level aplikasi, dan menyimpan hasilnya di tempat yang berguna.
Kekuatan utama ScraperAPI benar-benar terasa pada pekerjaan skala infrastruktur: ratusan ribu hingga jutaan request per bulan, menuju situs yang aktif melawan dengan deteksi bot. Itu masalah yang sulit, dan menyerahkan pengelolaan proxy kepada perusahaan yang memang fokus di proxy management adalah langkah cerdas untuk banyak tim engineering. Saya bilang ini dengan tegas karena beberapa artikel perbandingan suka berlebihan ke dua arah: ScraperAPI tidak menjamin bisa menembus semua sistem anti-bot di dunia, dan klaim pemasaran seperti persentase uptime adalah klaim vendor, bukan benchmark pihak ketiga. Anggap itu sebagai titik awal, bukan kebenaran mutlak.
Siapa yang Sebaiknya Mempertimbangkan ScraperAPI?
Anda kemungkinan cocok jika:
- Anda nyaman menulis kode yang mengirim request API dan memproses respons
- Anda perlu scraping dalam skala besar — misalnya puluhan ribu hingga jutaan halaman per bulan
- Anda butuh rotasi proxy, geotargeting, dan penanganan anti-bot langsung di pipeline request Anda
- Anda sudah punya (atau ingin membangun) data pipeline yang menjadikan ScraperAPI sebagai lapisan “akses”
Kalau poin-poin itu terasa pas, simpan ScraperAPI dalam daftar pertimbangan Anda. Kalau justru bikin Anda pusing, tunggu dulu — bagian berikutnya mungkin lebih cocok untuk Anda.
Apa Itu Thunderbit? Lapisan Ekstraksi Agentic Tanpa Kode
Thunderbit memulai dari pendekatan yang sangat berbeda: alih-alih mengasumsikan Anda akan menulis logika ekstraksi sendiri, Thunderbit yang mencari logika ekstraksinya untuk Anda. Klik One Click Extract, lalu AI Thunderbit merekomendasikan field dan strategi ekstraksi yang tepat, kemudian mengubah halaman menjadi data terstruktur — nama produk, harga, info kontak, lowongan kerja, atau apa pun isi halaman tersebut.

Kesederhanaan itu sangat penting bagi pengguna non-teknis yang menjadi target Thunderbit: dari halaman web ke spreadsheet yang siap pakai hanya butuh satu klik, tanpa selector, tanpa desain skema, tanpa kode scraping. Tidak ada yang mau diberi PR dulu sebelum bisa membuka spreadsheet.
Thunderbit juga tidak berhenti di browser. Ada Web App untuk proses berbasis cloud, Open API untuk developer yang ingin memanggil ekstraksi secara programatis, MCP Server untuk menghubungkan Thunderbit ke AI agent seperti Claude atau Cursor, dan CLI untuk workflow berbasis terminal. Jadi walaupun pengalaman unggulannya adalah no-code, Thunderbit bukan alat no-code semata — lebih akurat menyebutnya sebagai lapisan ekstraksi terstruktur dengan beberapa pintu masuk ke kapabilitas yang sama.
Dan untuk konteks yang akan saya lanjutkan nanti: Thunderbit bukan produk rotasi proxy atau bypass anti-bot. Produk ini dibuat untuk mengekstrak data terstruktur dari halaman yang memang sudah bisa Anda akses, bukan untuk menembus dinding CAPTCHA dalam skala besar. Dua pekerjaan yang sangat berbeda.
Siapa yang Sebaiknya Mempertimbangkan Thunderbit?
Anda kemungkinan cocok jika:
- Anda orang sales, marketing, ops, atau riset yang butuh data dari halaman web hari ini, bukan setelah sprint engineering dua minggu
- Anda ingin data langsung masuk ke tempat yang berguna — Excel, Google Sheets, Airtable, Notion — tanpa harus menulis parser
- Anda lebih suka klik tombol daripada menulis scraper, dan itu bukan kelemahan karakter, itu cuma efisien
- Anda developer yang ingin lapisan output terstruktur yang lebih cepat untuk alat internal, meskipun Anda nyaman coding
Cara Kerja Keduanya: Arsitektur dan Workflow Berdampingan
Cara paling sederhana untuk menjelaskan perbedaannya adalah begini: ScraperAPI memberi Anda bahan mentah dan percaya Anda bisa merakit furniturnya sendiri. Thunderbit berusaha memberi Anda furnitur yang sudah jadi.
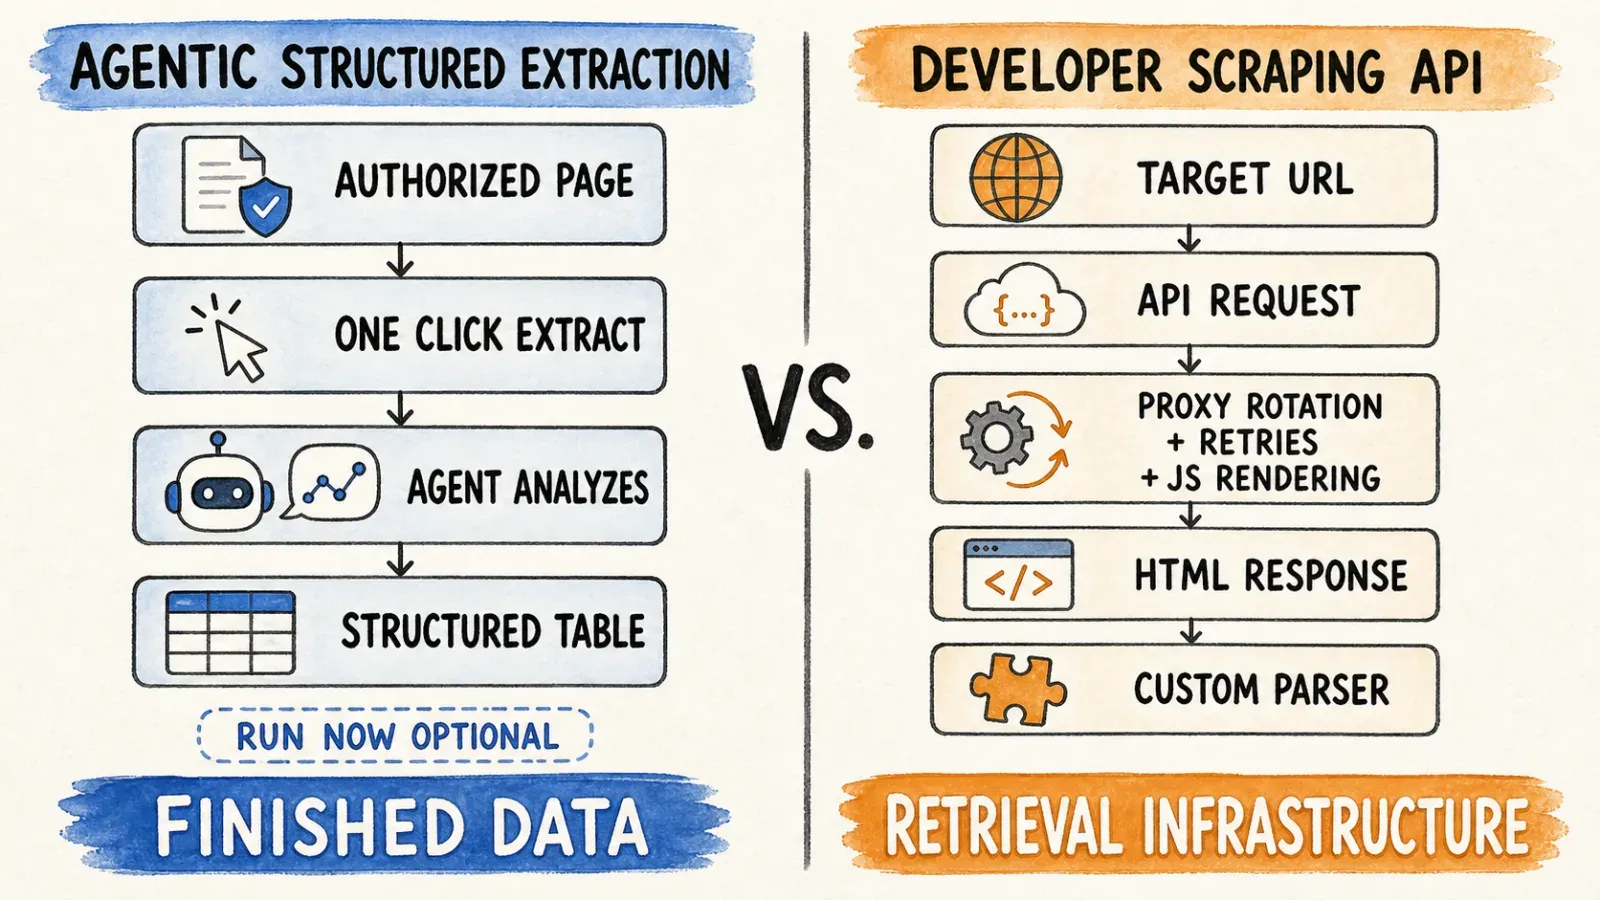
Di balik layar, arsitektur ScraperAPI berangkat dari proxy dan rendering. Request Anda melewati jaringannya, diarahkan melalui residential atau mobile IP sesuai kebutuhan, mungkin dirender lewat headless browser jika perlu eksekusi JavaScript, lalu kembali ke Anda dalam bentuk HTML, JSON, atau struktur yang sudah diparsing untuk domain yang didukung. Semua tahap lanjut — desain skema, penyimpanan, deduplikasi, penjadwalan — ada di tangan Anda, kecuali Anda memakai produk DataPipeline atau crawler mereka yang memang dibangun khusus untuk itu.
Arsitektur Thunderbit berangkat dari analisis dulu. Agen membaca struktur dan isi halaman sebelum memutuskan apa yang harus diekstrak, artinya tahap “skema” yang biasanya harus dikodekan manual oleh developer ditangani secara otomatis. Output-nya bukan bahan mentah — melainkan tabel yang bisa langsung Anda serahkan ke sales manager tanpa perlu meminta maaf soal formatnya.
Tabel Perbandingan: Mekanisme Inti
| ScraperAPI | Thunderbit | |
|---|---|---|
| Model inti | Rotasi proxy + rendering HTML/JS mentah via API | Analisis halaman oleh agen → ekstraksi terstruktur via extension, Web App, API, MCP Server |
| Setup | Kirim request ke endpoint dengan parameter | Klik One Click Extract; AI merekomendasikan field dan strategi ekstraksi, lalu menjalankan ekstraksi |
| Output | HTML/JSON mentah, parser terstruktur untuk situs yang didukung | Data terstruktur yang siap diekspor |
| Terbaik untuk | Pipeline scraping skala infrastruktur | Ekstraksi cepat, terstruktur, no-code dari halaman yang bisa diakses |
Tidak ada model yang “lebih baik” kalau dilihat secara terpisah — keduanya dibuat untuk mengatasi bottleneck yang berbeda. Bottleneck ScraperAPI adalah akses (melewati penghalang). Bottleneck Thunderbit adalah pemahaman (mengubah halaman yang berantakan menjadi baris data yang bisa dipakai).
Harga Thunderbit vs ScraperAPI: Biaya Nyata per 1.000 Halaman
Bagian inilah yang sebenarnya membuat saya ingin menulis artikel ini. Hampir semua pembahasan mendalam soal harga ScraperAPI menjelaskan sistem pengali credit mereka sampai detail, dan setiap halaman harga Thunderbit menjelaskan paketnya sendiri — tetapi hampir tidak ada yang menaruh keduanya berdampingan lalu berkata, “oke, tapi sebenarnya ini habis berapa untuk tugas yang ingin saya lakukan?”
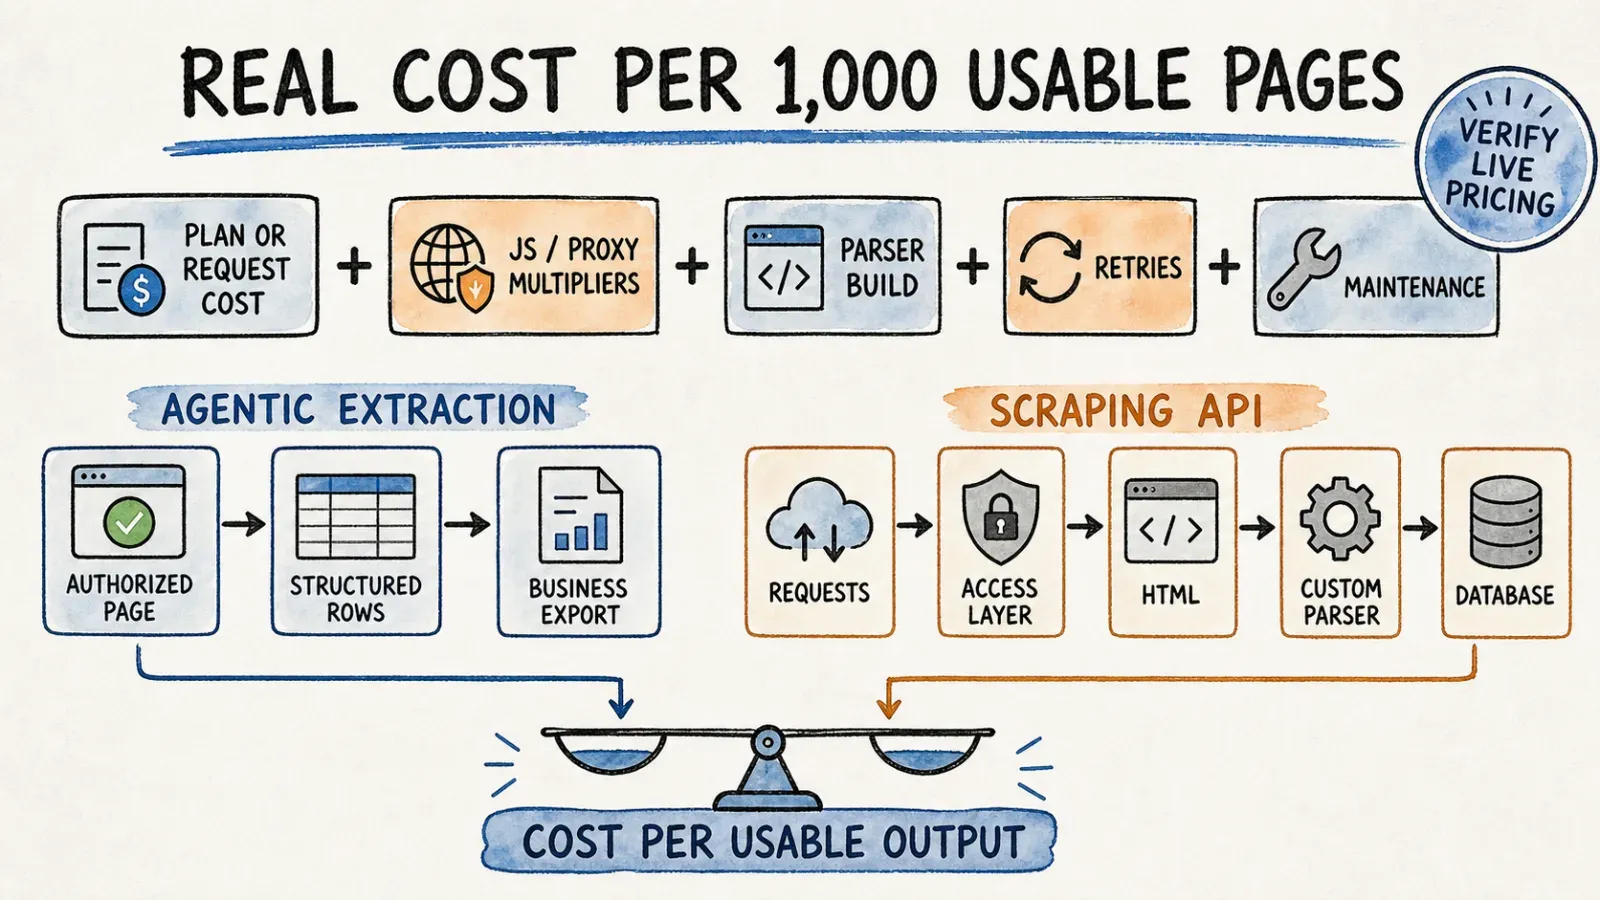
Jadi mari kita hitung berdasarkan dokumentasi resmi ScraperAPI. Sistem credit-nya mengenakan tarif dasar berbeda tergantung target: halaman biasa 1 credit, Amazon 5 credit, hasil pencarian Google atau Bing 25 credit, dan LinkedIn 30 credit. Di atas itu, melewati sistem proteksi bot seperti Cloudflare atau DataDome bisa menambah 10 credit lagi, dan rendering JavaScript atau fitur premium proxy bisa menambah lebih banyak lagi — jumlah pastinya bergantung pada target, jadi estimator biaya ScraperAPI di dashboard adalah satu-satunya sumber yang benar-benar bisa diandalkan sebelum Anda mengambil paket.
Dengan memakai paket Hobby ($49 untuk 100.000 credit, atau sekitar $0,00049 per credit) sebagai dasar untuk 1.000 halaman:
| Skenario | Biaya ScraperAPI per 1.000 halaman (tarif Hobby) | Biaya ScraperAPI per 1.000 halaman (tarif Business) |
|---|---|---|
| Halaman statis sederhana (1 credit/halaman) | ~$0,49 | ~$0,10 |
| Halaman e-commerce seperti Amazon (5 credit/halaman) | ~$2,45 | ~$0,50 |
| Scraping SERP Google/Bing (25 credit/halaman) | ~$12,25 | ~$2,49 |
| Halaman LinkedIn (30 credit/halaman) | ~$14,70 | ~$2,99 |
Rentangnya cepat melebar begitu Anda menambahkan biaya tambahan untuk rendering JS atau bypass bot, dan akan jauh lebih kecil pada paket volume tinggi karena tarif per credit turun saat Anda naik dari Hobby ke Business, Scaling, atau Professional. Bagian inilah yang sering dilewati artikel perbandingan lain — biaya efektif per halaman di ScraperAPI sangat bergantung pada jenis situs target dan tier paket yang Anda gunakan.
Model harga Thunderbit bekerja berbeda di level struktural: alih-alih pengali spesifik domain, di mana scraping LinkedIn bisa 30 kali lebih mahal daripada scraping blog statis, paket Thunderbit dibangun di atas alokasi credit bulanan yang terkait dengan jumlah baris atau halaman yang Anda ekstrak, dan skalanya mengikuti tier paket. Saya tidak akan mengarang angka per credit di sini, karena halaman harga bisa berubah dan saya lebih suka mengarahkan Anda ke halaman harga Thunderbit yang live daripada Anda mengutip angka yang sudah usang tiga bulan lagi. Yang bisa saya sampaikan secara garis besar adalah untuk pekerjaan satu kali — misalnya menarik 500 lead dari direktori atau scraping beberapa ratus listing produk untuk audit klien — Anda tidak akan duduk menghitung pengali credit sebelum menekan run. Anda tinggal ekstrak, lalu tier paket Anda menentukan berapa banyak run yang bisa Anda lakukan per bulan.
Intinya: jika Anda menjalankan scraping skala infrastruktur lintas banyak jenis domain dan bisa memprediksi pengali credit Anda sebelumnya, model biaya ScraperAPI menguntungkan perencanaan dan volume. Jika Anda melakukan ekstraksi terstruktur, ad hoc, atau untuk kebutuhan bisnis, di mana nilainya ada pada tabel akhir bukan pada jumlah request mentah, model Thunderbit memang dirancang untuk use case itu.
Mana yang Harus Anda Pilih? Kerangka Keputusan Berdasarkan Persona
Saya perhatikan artikel-artikel teratas untuk perbandingan ini sering kali tidak benar-benar menjawab pertanyaan yang sebenarnya dicari orang, yang intinya adalah “saya developer yang butuh infrastruktur, atau saya orang bisnis yang cuma butuh data.” Jadi biar saya jawab langsung.
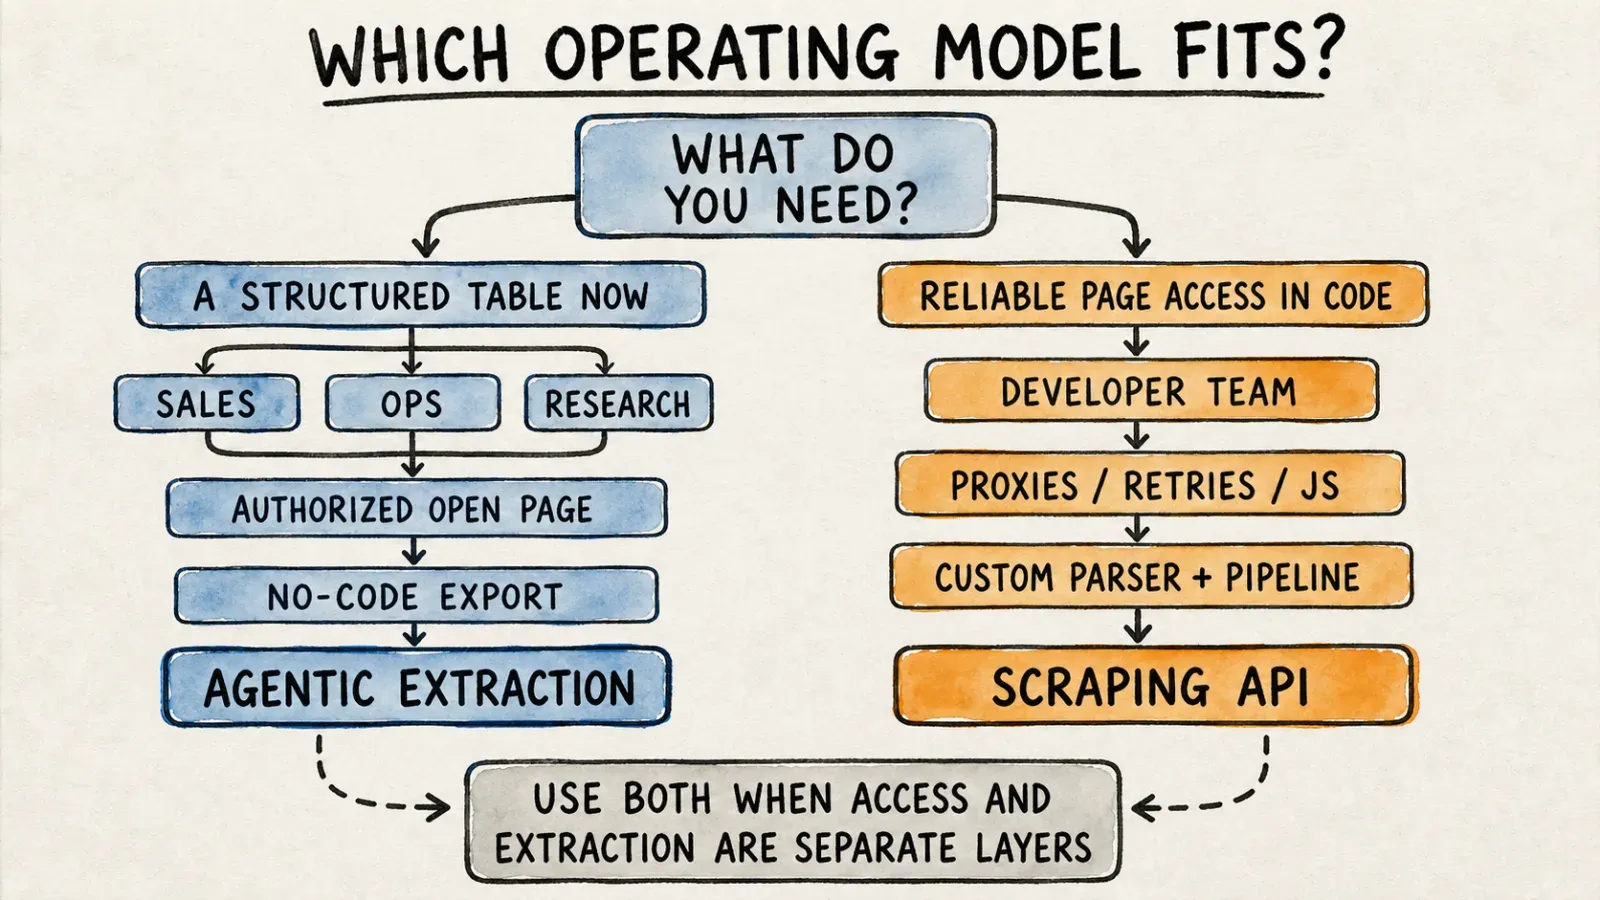
Pilih ScraperAPI Jika...
- Anda developer atau tim engineering yang membangun infrastruktur scraping dalam skala besar
- Anda butuh rotasi proxy dan penanganan CAPTCHA yang tertanam langsung di API call Anda
- Anda nyaman menulis logika request dan memproses respons HTML atau JSON mentah
- Use case Anda melibatkan jutaan request per bulan di banyak domain berbeda
Pilih Thunderbit Jika...
- Anda pengguna bisnis, marketer, atau operator yang butuh data terstruktur dari halaman yang sudah Anda lihat
- Anda lebih suka klik One Click Extract dan membiarkan agen menentukan field daripada menulis satu baris kode scraping
- Anda ingin output langsung masuk ke Excel, Google Sheets, Airtable, atau Notion
- Anda developer yang ingin lapisan terstruktur yang lebih cepat untuk alat internal tanpa harus membangun logika ekstraksi dari nol
Saya orang pertama yang mengakui bahwa ini bukan pilihan biner untuk semua orang. Saya pernah bicara dengan tim yang memakai keduanya — engineering memegang pipeline ScraperAPI untuk akses infrastruktur volume tinggi, sementara sales dan marketing memakai Thunderbit untuk permintaan “saya perlu daftar lead ini sebelum Kamis” yang kalau tidak akan menumpuk dua minggu di backlog engineering. Kombinasi itu justru sangat masuk akal begitu Anda berhenti memaksa satu alat mengerjakan pekerjaan alat yang lain.
Apakah Thunderbit Menggantikan ScraperAPI? Meluruskan Kebingungan
Di sinilah saya paling sering melihat kebingungan, dan saya ingin menegaskannya secara langsung, bukan berputar-putar demi SEO. Orang mencari “AI scraper tool” lalu memasukkan semua hasil — termasuk Thunderbit — ke dalam satu kotak mental yang sama dengan “scraping infrastructure.” Padahal itu bukan kotak yang sama.
Thunderbit adalah lapisan ekstraksi terstruktur. Alat ini dibuat untuk mengubah halaman yang sudah bisa Anda akses menjadi data yang berguna dan siap diekspor, dengan AI yang membantu menentukan field tanpa Anda harus mendefinisikan skema secara manual. Thunderbit bukan produk infrastruktur rotasi proxy atau bypass anti-bot seperti ScraperAPI. Kalau Anda perlu menerobos tantangan Cloudflare di sepuluh ribu domain berbeda setiap hari, itu memang wilayah ScraperAPI, bukan Thunderbit.
Sebaliknya, ScraperAPI juga tidak menyediakan deteksi field AI tanpa kode. ScraperAPI dengan senang hati akan memberi Anda HTML dari halaman yang dilindungi deteksi bot berat, tapi Anda tetap pihak yang menentukan apa arti “harga” atau “jabatan” di HTML itu dan menulis kode untuk mengekstraknya. Kedua alat ini tidak sedang mencoba menjadi alat yang lain, dan saya lebih memilih menjelaskannya secara gamblang daripada Anda baru tahu tiga minggu di tengah proyek.
Untuk crawling skala besar dengan risiko blok tinggi, pool proxy dan penanganan anti-bot ScraperAPI tetap lebih cocok. Untuk ekstraksi cepat dan terstruktur dari halaman yang sudah bisa Anda atau tim Anda akses, pendekatan agentic Thunderbit memang dibuat untuk itu. Dan agar adil untuk kedua produk, tidak satu pun klaim harus dibesar-besarkan — Thunderbit tidak menjanjikan bisa melewati semua sistem anti-bot di luar sana, dan klaim uptime serta keberhasilan ScraperAPI juga merupakan klaim yang dilaporkan sendiri, bukan diverifikasi independen.
Tabel Perbandingan Fitur: Thunderbit vs ScraperAPI
Selain perbedaan arsitektur dan harga, berikut adalah perbandingan hal-hal praktis yang benar-benar penting bagi tim sehari-hari.
| Fitur | ScraperAPI | Thunderbit |
|---|---|---|
| Perlu coding | Ya, untuk sebagian besar use case nyata | Tidak, untuk alur browser extension |
| Format output | HTML/JSON mentah, parser terstruktur untuk situs yang didukung | Tabel terstruktur, siap diekspor |
| Opsi ekspor | Dikelola developer (bangun sendiri penyimpanan/distribusinya) | Ekspor ke Excel, Google Sheets, Airtable, Notion |
| Penjadwalan | Tersedia lewat DataPipeline untuk workflow yang didukung | Tersedia pada paket dan surface produk yang didukung |
| Penanganan proxy/anti-bot | Tertanam di setiap request, fitur inti produk | Bukan fungsi inti; target ekstraksi adalah halaman yang dapat diakses/diizinkan |
| Surface otomasi | REST API, DataPipeline, akses crawler | Browser extension, Web App, Open API, MCP Server, CLI |
| Tim yang paling cocok | Engineering/ops teknis | Sales, marketing, ops, riset, plus workflow developer |
Baris terakhir itu sebenarnya inti cerita dalam satu kalimat. Kalau channel Slack tim Anda penuh dengan engineer, ScraperAPI mungkin sudah terasa masuk akal. Kalau channel Slack tim Anda penuh dengan permintaan “bisa tolong tarik daftar ini ke spreadsheet?”, maka Thunderbit memang dibuat untuk itu.
Akses Data, Kepatuhan, dan Penggunaan yang Bertanggung Jawab
Saya akan singkat di bagian ini karena saya rasa tidak pantas jika saya atau perusahaan mana pun memberikan nasihat hukum. Kedua alat ini mengharuskan Anda bekerja dengan data publik atau data lain yang memang diizinkan, menghormati kontrol akses di situs sumber, mematuhi hukum privasi yang berlaku, dan menaati ketentuan layanan situs target. Baik jaringan proxy ScraperAPI maupun ekstraksi AI Thunderbit tidak otomatis membuat pekerjaan scraping apa pun menjadi legal atau patuh aturan — tanggung jawab itu ada pada pihak yang menjalankan ekstraksi, bukan alat yang mengekstraknya. Jika Anda meng-scrape data yang melibatkan data pribadi, sesi login, atau situs dengan klausul eksplisit “no scraping” dalam syaratnya, itu sudah masuk ranah tim legal Anda, bukan sekadar centang fitur.
FAQ: Thunderbit vs ScraperAPI
Apakah Thunderbit punya API seperti ScraperAPI? Ya. Open API Thunderbit mendukung Distill dan structured Extract untuk workflow programatis yang ditujukan bagi developer. Pengalamannya berbeda dari browser extension no-code, dan dirancang untuk tim yang ingin memanggil ekstraksi dari aplikasi mereka sendiri atau pipeline backend.
Apakah Thunderbit bisa menangani CAPTCHA/IP blocking seperti ScraperAPI? Tidak. Thunderbit tidak menyediakan infrastruktur rotasi proxy dan bypass CAPTCHA seperti yang menjadi dasar ScraperAPI. Thunderbit dibuat untuk ekstraksi terstruktur dari halaman yang bisa diakses dan diizinkan — bukan untuk menghindari sistem anti-bot dalam skala besar.
Mana yang lebih murah untuk 10.000 atau 100.000 halaman? Sungguh tergantung skenarionya. Pekerjaan halaman statis dalam volume tinggi cenderung lebih cocok dengan harga infrastruktur ScraperAPI setelah Anda berada di paket tier yang lebih tinggi. Pekerjaan ekstraksi terstruktur yang ad hoc — di mana nilai utamanya ada pada tabel akhir, bukan jumlah request mentah — cenderung lebih cocok dengan Thunderbit. Cek rincian berbasis skenario di atas sebelum berasumsi salah satu otomatis lebih murah.
Apakah Thunderbit alternatif yang bagus untuk ScraperAPI? Hanya untuk kebutuhan ekstraksi terstruktur tanpa kode. Thunderbit bukan pengganti langsung untuk infrastruktur rotasi proxy atau anti-bot skala besar, dan saya lebih suka menjelaskannya sejak awal daripada Anda baru tahu di tengah proyek.
Bisakah saya memakai Thunderbit dan ScraperAPI bersama-sama? Banyak tim memang melakukan itu — engineering memakai ScraperAPI untuk akses skala besar di level infrastruktur, sementara tim bisnis memakai Thunderbit untuk pekerjaan ekstraksi terstruktur, sekali pakai, atau berulang yang tidak butuh sprint engineering penuh. Tidak ada aturan yang mengharuskan Anda memilih salah satunya saja.
Memilih di antara keduanya pada dasarnya kembali ke satu pertanyaan jujur: apakah Anda sedang membangun infrastruktur, atau Anda hanya butuh tabel data sebelum hari berakhir? ScraperAPI adalah infrastruktur scraping kelas developer — proxy, penanganan CAPTCHA, dan rendering, dibuat untuk tim yang nyaman menulis logika request dalam skala besar. Thunderbit adalah lapisan ekstraksi agentic tanpa kode yang dibuat untuk pengguna bisnis, marketer, dan peneliti yang butuh data terstruktur dari halaman dengan cepat, plus lapisan API dan MCP untuk developer yang ingin kecepatan yang sama secara programatis. Pilih alat yang sesuai dengan pekerjaan nyata di depan Anda, bukan yang landing page-nya paling mencolok — dan kalau Anda tipe orang yang lebih suka klik tombol daripada menulis scraper hari ini, Anda bisa mencoba Thunderbit Chrome extension dan lihat seberapa jauh satu klik bisa membawa Anda.




