
Seseorang di Discord kami bertanya langsung ke saya bulan lalu: "Apa bedanya Thunderbit dengan Nimble?" Saya sempat cari jawaban yang benar-benar akurat, tapi hasilnya nihil. Hampir semua halaman yang muncul cuma widget auto-generated yang tipis, daftar buatan kompetitor yang menaruh Thunderbit di catatan kaki sebagai "ringan/no-code", atau artikel Thunderbit-vs-sesuatu-lain yang kebetulan ranking karena nama merek saling berdekatan. Tidak ada yang benar-benar duduk dan membandingkan kedua produk ini fitur demi fitur.
Jadi saya bongkar sendiri, sebagian karena saya CEO salah satu perusahaan ini dan sebagian lagi karena saya memang penasaran bagaimana produk kami dibandingkan dengan platform yang dibangun untuk pembeli yang sama sekali berbeda. Inilah yang saya temukan — dan spoiler: dua alat ini sebenarnya tidak benar-benar saling berebut pelanggan yang sama, justru itu yang bikin perbandingannya makin menarik.
Jawaban Singkat
Kalau Anda mau versi ringkasnya sebelum masuk ke detail:
- Thunderbit dibuat untuk kerja cepat dari halaman ke tabel. Anda buka halaman, klik sekali, lalu dapat dataset terstruktur — dengan Open API, MCP Server, dan CLI saat developer ingin menghubungkannya ke sistem yang lebih besar.
- Nimble adalah platform data web untuk developer dan enterprise, mencakup produk Search, Extract, Crawl, Map, dan Agent, plus Data Services terkelola untuk tim yang menjalankan pipeline skala besar.
- Pilihan yang tepat tergantung siapa yang menjalankan workflow-nya — tenaga sales yang perlu susun daftar prospek sore ini, atau data engineer yang menyiapkan infrastruktur produksi untuk sistem RAG.
Sekilas Perbandingan
Saya suka tabel karena memaksa kita jujur — Anda tidak bisa muter-muter dalam perbandingan tabel seperti saat menulis narasi biasa. Berikut cara kedua produk ini dipetakan pada dimensi yang benar-benar penting saat Anda memilih di antara keduanya.
| Dimensi | Thunderbit | Nimble |
|---|---|---|
| Pengguna utama | Pengguna bisnis non-teknis (sales, ops, marketing) | Engineer AI/data, tim enterprise |
| Antarmuka awal | Ekstensi browser, Web App | REST API, SDK |
| Upaya setup | Satu klik, tanpa schema atau selector | API key, pemilihan driver/tier, konfigurasi schema |
| Cakupan ekstraksi | Satu halaman atau kumpulan halaman, enrichment subpage | Produk Search, Extract, Crawl, Map, Agent |
| Pendekatan anti-bot | Managed rendering pada halaman yang didukung/diizinkan | "Driver" bertingkat (VX6/VX8/VX10) dengan opsi stealth |
| Output | Table, Excel, Google Sheets, Airtable, Notion | HTML, Markdown, JSON, screenshot, parsing terstruktur |
| Penjadwalan | Run terjadwal tergantung paket | Job sync/async, callback webhook |
| Permukaan developer | Open API, MCP Server, CLI | SDK, integrasi MCP di Data Services terkelola |
| Observabilitas | Riwayat run dasar di aplikasi | Status job, callback, integrasi cloud storage |
| Model harga | Berbasis credit, paket self-serve | PAYG berbasis penggunaan plus tier managed tahunan |
| Paling cocok untuk | Kebutuhan data terstruktur cepat, sekali jalan atau berulang | Infrastruktur data web skala produksi |
Apa Itu Thunderbit?
Thunderbit adalah agentic web scraper yang utamanya hidup sebagai ekstensi browser. Alur kerjanya memang sengaja dibuat sesederhana mungkin: Anda buka halaman yang memang berwenang Anda lihat, klik One Click Extract, lalu agen membaca halaman, menentukan bagian mana yang perlu diambil, dan menyiapkan field secara otomatis. Akan muncul tombol Run Now — klik kalau Anda mau langsung jalan, atau tunggu sebentar, karena ekstraksi akan mulai otomatis kalau Anda tidak melakukan apa pun. Selesai. Tanpa selector, tanpa schema, tanpa Python.
Meski begitu, Thunderbit bukan cuma alat klik-dan-pilih. Ada Web App untuk menjalankan dan mengelola ekstraksi dari browser tanpa ekstensi, Open API untuk tim yang ingin memicu ekstraksi dari aplikasi mereka sendiri, MCP Server untuk menghubungkan Thunderbit ke Claude, Cursor, Windsurf, dan agen AI lain yang kompatibel dengan MCP, serta CLI untuk workflow coding-agent dan terminal. Begitu data terstruktur didapat, Anda bisa mengekspornya ke Excel, Google Sheets, Airtable, atau Notion, lalu menyempurnakan field dengan instruksi bahasa biasa, bukan regex.

Saya ingin hati-hati di sini, karena saya sudah sering lihat copy marketing "AI scraper" yang melebih-lebihkan kemampuan alat seperti ini. Ekstraksi satu klik memang bekerja bagus di halaman yang didukung dan diizinkan — ini bukan jalan pintas universal untuk menembus semua login wall atau sistem anti-bot di internet. Tapi ini memang cara yang sangat cepat untuk mengubah halaman yang sudah bisa Anda lihat jadi spreadsheet, dan itu sudah mencakup banyak kebutuhan nyata pengguna bisnis sehari-hari.
Apa Itu Nimble?
Nimble adalah sesuatu yang beda total — ini platform data web yang dibangun untuk engineer, bukan untuk orang kantor yang masih menyebut spreadsheet sebagai "database." Menurut dokumentasi Nimble sendiri, keluarga produknya mencakup Search API, Extract API, Crawl, Map, produk Web Search Agent, dan jaringan Proxy, semuanya dirangkai sebagai SDK yang diintegrasikan developer ke aplikasi mereka sendiri.
Extract API saja sudah menyediakan HTML, Markdown, screenshot, header, atau parsing terstruktur, rendering JavaScript, driver stealth untuk situs yang terlindungi, skema parsing berbasis CSS selector, bahkan aksi browser yang discript seperti klik, scroll, dan mengetik. Anda bisa menargetkan request berdasarkan negara, negara bagian, atau kota, menambahkan header dan cookie kustom, menangkap traffic jaringan, dan menjalankan job secara sinkron maupun asinkron dengan callback webhook. Crawl dan Map memperluasnya ke seluruh domain, sementara Web Search Agent menawarkan extractor berbasis template untuk situs populer yang butuh konfigurasi manual lebih sedikit.
Di atas semua API mentah itu, Nimble menjual Managed Data Services — kontrak tahunan yang menggabungkan pipeline ETL agen kustom, jendela retensi data, dan integrasi MCP untuk tim yang ingin Nimble pada dasarnya menjalankan operasi data web mereka untuk mereka. Ini infrastruktur enterprise, bukan alat browser, dan cara jualnya memang seperti itu.
Perbedaan Inti: Ekstraksi untuk Pengguna Bisnis vs Infrastruktur Data Web
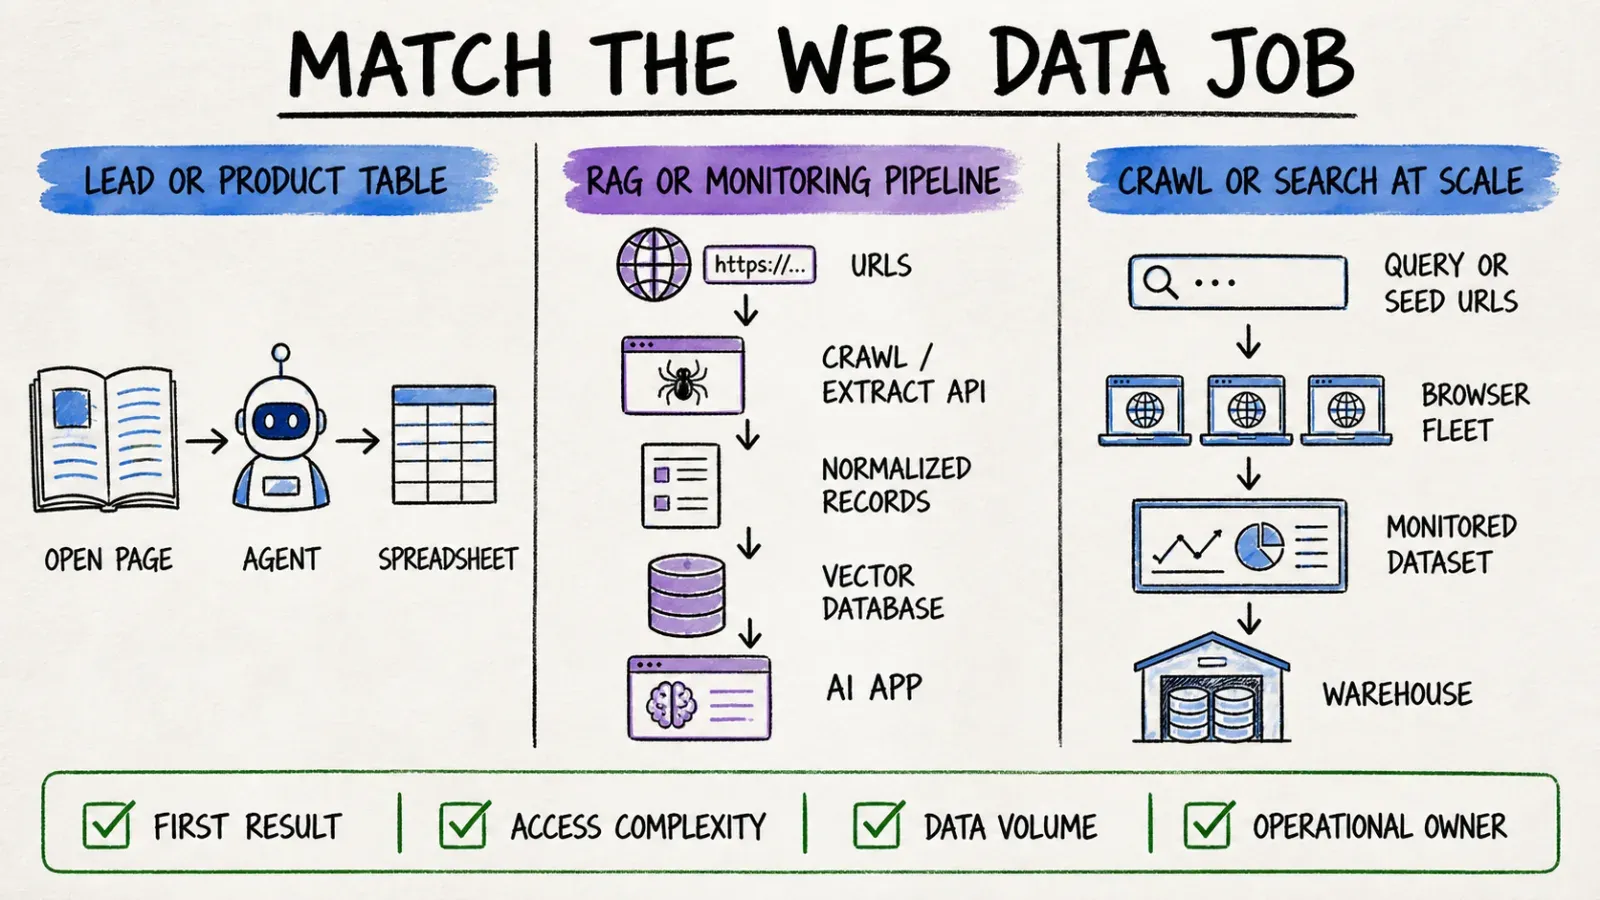
Tugas browser yang langsung dibutuhkan saat itu juga
Cara paling gampang menjelaskannya: Thunderbit dibuat untuk momen ketika Anda sedang membuka sebuah halaman sekarang dan butuh datanya jadi tabel hari ini, tanpa harus bikin tiket ke tim IT. Itu inti dari ekstensi browser — Anda bukan merancang pipeline, Anda cuma ingin 200 baris daftar produk masuk ke spreadsheet sebelum meeting dimulai.
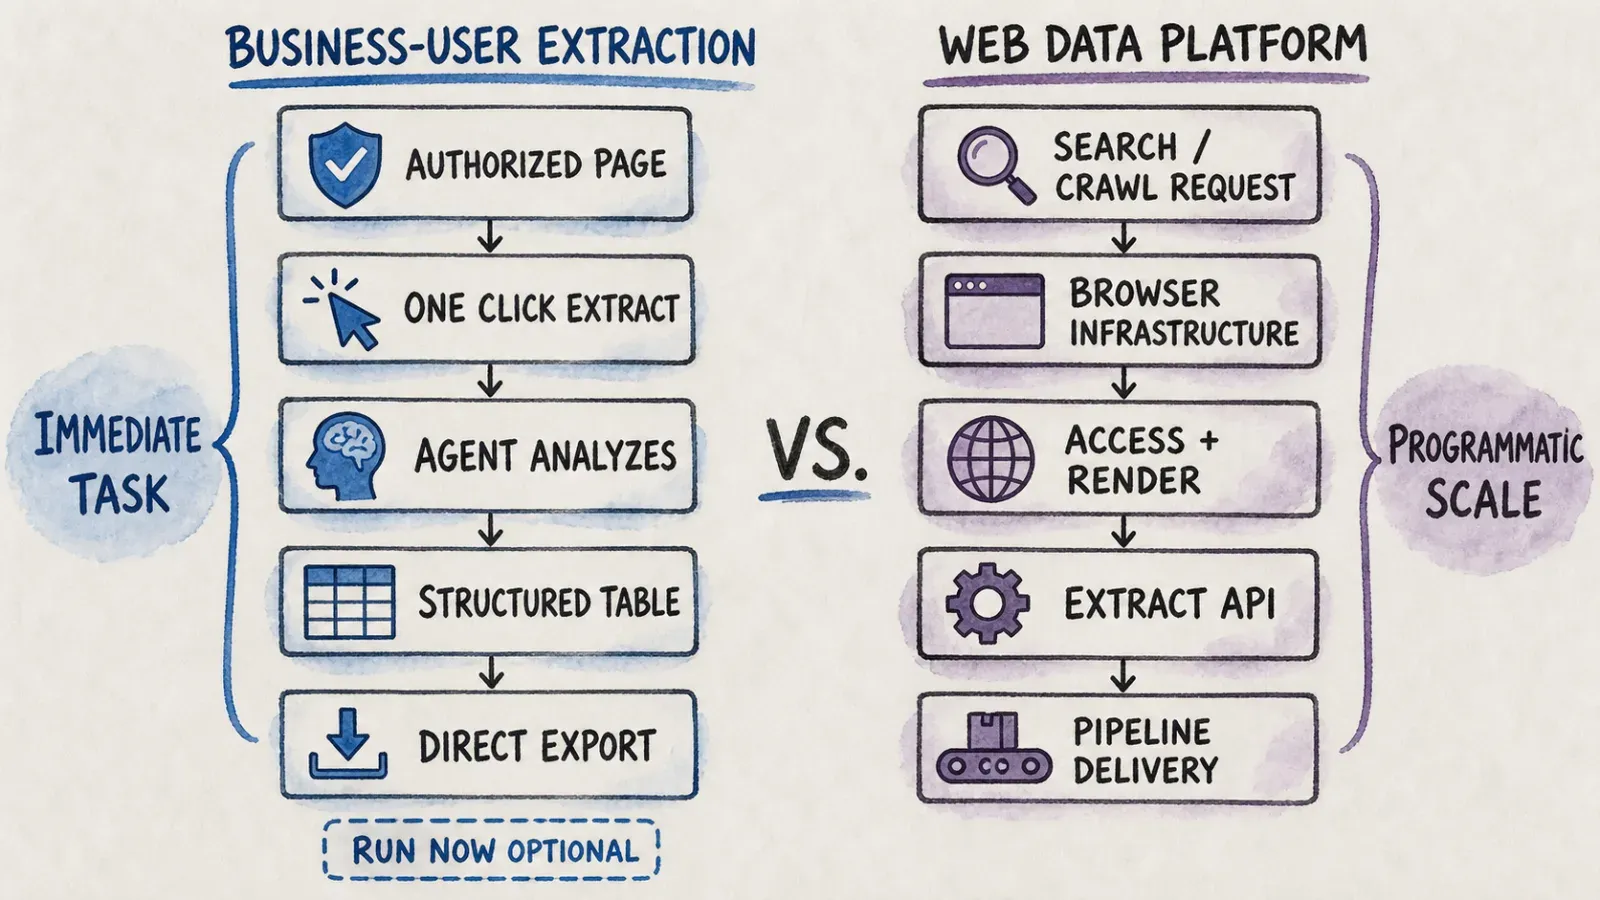
Workflow programatik untuk search/crawl/extract
Nimble berasumsi Anda tidak sedang melihat satu halaman saja — Anda sedang membangun sesuatu yang jalan terus, dalam skala besar, lintas ribuan atau jutaan URL, untuk memberi makan sebuah sistem, bukan spreadsheet. Memilih driver tier, menulis parsing schema, dan menghubungkan callback webhook adalah cara berpikir yang sangat beda dari sekadar klik tombol di browser. Ini kerja infrastruktur, dan memang itu tujuan utamanya.
Operasi enterprise dan governance
Tier Managed Data Services Nimble ada karena sebagian perusahaan tidak mau memikul kerja infrastruktur itu sendiri — mereka ingin SLA, kebijakan retensi, dan vendor yang bertanggung jawab atas uptime. Thunderbit tidak bermain di area itu; paketnya dibangun untuk credit self-serve dan tim bisnis, bukan kontrak enterprise tahunan dengan jaminan concurrency khusus.
Skenario Praktis
Perbandingan cepat sering jadi terlalu abstrak, jadi saya ingin membumikannya dengan situasi yang memang sering muncul.
Membuat tabel prospek atau produk dari halaman terbuka
Misalnya Anda di sales ops dan bos Anda minta daftar semua exhibitor di sebuah trade show, diambil dari situs event, lengkap dengan nama perusahaan, nomor booth, dan URL website. Anda buka halamannya, klik One Click Extract, biarkan agen menentukan kolomnya, ekspor ke Google Sheets, dan selesai dalam beberapa menit. Ini jelas wilayah Thunderbit — lihat pembahasan kami tentang AI lead generation kalau ini bagian rutin dari pekerjaan Anda.
Memberi makan pipeline RAG atau monitoring
Sekarang bayangkan Anda membangun sistem retrieval-augmented generation yang butuh konten segar dari ribuan URL setiap hari, dengan parsing terstruktur dan notifikasi webhook saat job selesai. Di sinilah API Extract dan Crawl Nimble bekerja sesuai desainnya — job async, cloud storage, dan schema yang bisa langsung dikonsumsi layanan downstream tanpa ada manusia yang perlu melihat output mentah.
Crawl atau search dalam skala besar
Kalau tugasnya adalah "temukan setiap halaman di domain ini" atau "telusuri web dan rangkum apa yang ada," Anda sudah keluar dari ranah ekstraksi dan masuk ke discovery — itulah produk Search, Map, dan Answer Nimble, yang menggabungkan retrieval dengan ringkasan hasil AI, bukan cuma menarik field terstruktur dari halaman yang sudah diketahui.
Integrasi dengan AI agent
Kedua produk sekarang sama-sama bisa ngobrol dengan AI agent, cuma dari arah yang berbeda. MCP Server Thunderbit memungkinkan sesi Claude atau Cursor memanggil tool ekstraksi Thunderbit secara langsung, sedangkan Data Services terkelola Nimble mencantumkan integrasi MCP sebagai bagian dari penawaran enterprise-nya. Tidak ada satu pun perusahaan yang memonopoli istilah "agent-ready" — bedanya, akses agent Thunderbit berada di atas produk one-click yang juga dipakai tenaga sales, sementara Nimble menaruhnya di atas stack infrastruktur yang lebih luas.
Kualitas Data, Blocking, dan Maintenance
Ini bagian yang ingin saya sampaikan secara terus terang, karena vendor di kedua sisi — termasuk saya — punya insentif untuk melebih-lebihkan reliabilitas. Managed rendering Thunderbit menangani banyak halaman berat-JavaScript secara otomatis, tapi itu berlaku pada halaman yang didukung dan diizinkan — bukan jaminan untuk menembus semua sistem anti-bot di luar sana. Model driver Nimble justru secara eksplisit mengakui trade-off ini: mereka menawarkan tiga tier — VX6 untuk request HTTP statis standar, VX8 untuk rendering JavaScript, dan VX10 untuk stealth rendering pada situs terlindungi — lalu membiarkan harga naik seiring makin sulitnya target diakses.
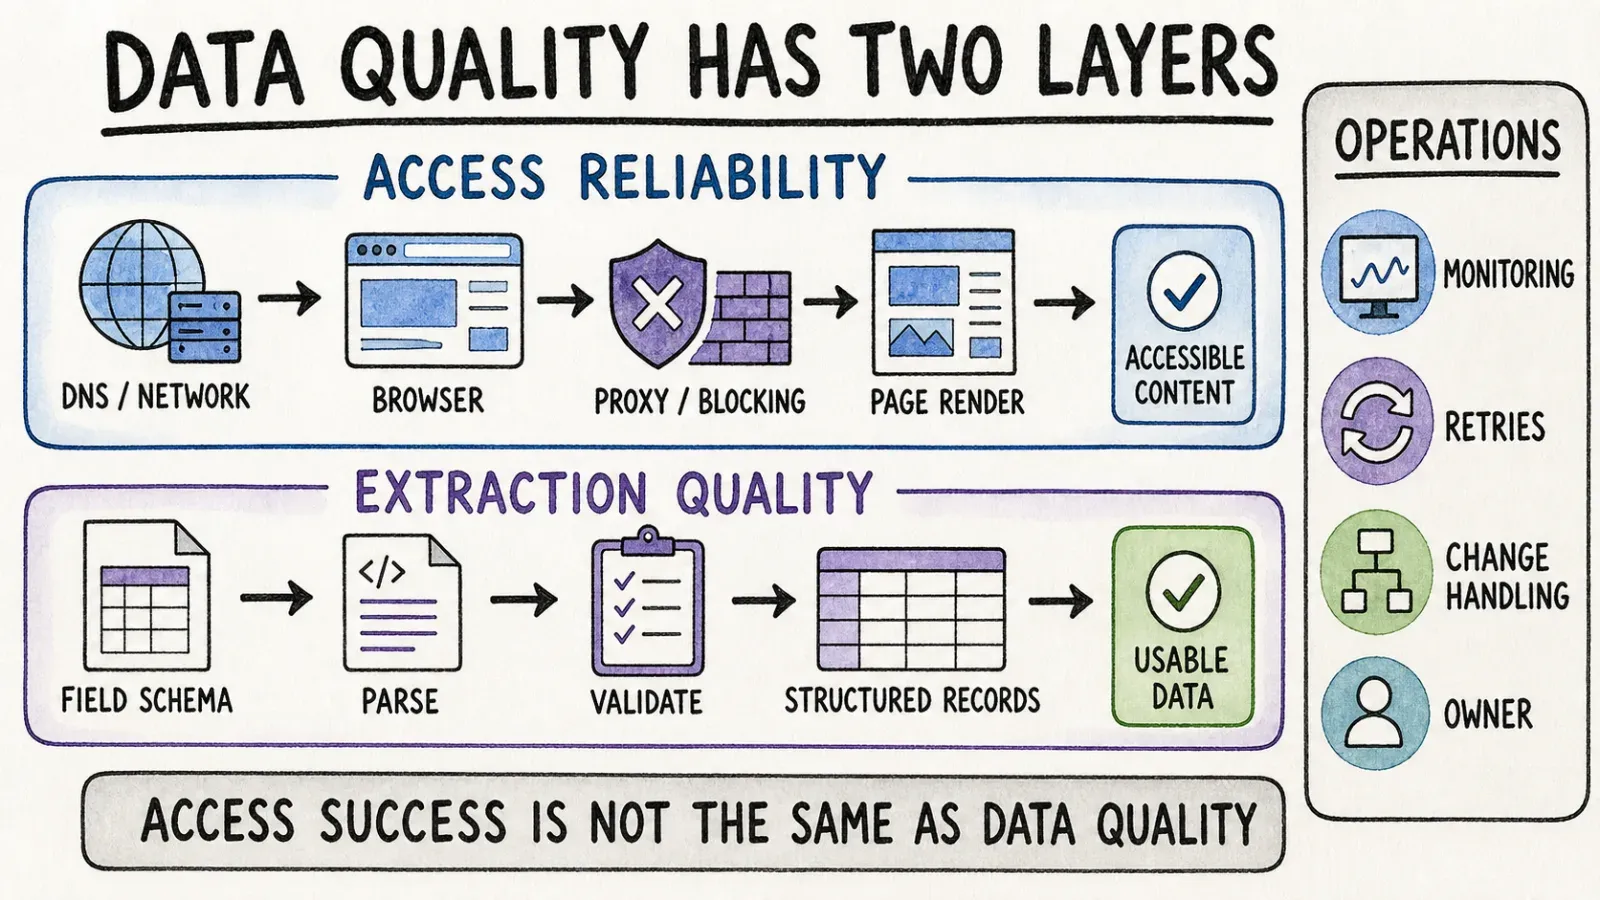
Saya justru menghargai keterbukaan Nimble yang mengaitkan kompleksitas tier ke harga, karena itu jujur terhadap realitas yang dihadapi setiap vendor scraping: makin keras situs melawan, makin besar infrastruktur yang dibutuhkan untuk menembusnya, dan seseorang harus membayar infrastruktur itu dengan cara apa pun. Tidak ada satu pun perusahaan yang bisa menjanjikan zero blocking atau zero maintenance di semua situs internet, dan saya bakal curiga sama alat yang mengklaim sebaliknya.
Yang beda adalah siapa yang memikul beban maintenance berkelanjutan. Dengan Thunderbit, tim saya yang memegang logika ekstraksi dan agen yang menafsirkan halaman — Anda tidak menulis atau memelihara selector. Dengan Nimble, kalau Anda memakai parsing schema berbasis CSS selector di Extract API, Anda yang harus menjaga selector tetap sinkron ketika situs target mengubah layout, kecuali Anda mengandalkan Web Search Agents berbasis template sebagai gantinya.
Harga dan Total Biaya
Perbandingan harga untuk duel ini hampir tidak ada di internet, lumayan mengejutkan mengingat begitu banyak konten yang membandingkan masing-masing alat dengan produk lain. Berikut yang saya temukan di halaman resmi, dengan catatan bahwa halaman harga bisa berubah dan Anda sebaiknya selalu cek versi live sebelum bikin anggaran.
| Item | Thunderbit | Nimble |
|---|---|---|
| Titik awal | Paket self-serve, berbasis credit | Uji coba gratis: 5.000 halaman web, tanpa kartu kredit |
| Ekstraksi dasar | Credit meningkat sesuai paket (lihat Thunderbit Pricing) | Extract/Crawl/Map di VX6: $0,90 per 1.000 URL |
| Rendering JS | Termasuk dalam ekstraksi agentik | VX8: $1,30 per 1.000 URL |
| Situs stealth/terlindungi | Dikelola otomatis bila didukung | VX10: $1,45 per 1.000 URL |
| Search/Answer | Bukan surface produk utama | Halaman harga dan dokumen SDK Nimble sendiri tidak konsisten di sini — satu menyebut $5 per 1.000 input, dokumen lain $1 per 1.000, jadi verifikasi langsung sebelum menyusun anggaran |
| Ekstraksi berbasis agent | Termasuk dalam paket | Mulai dari $3 per 1.000 halaman yang dipindai, plus 10% untuk Web Search Agents terkelola |
| Residential proxy | Tidak relevan | $5,30 per GB |
| Tier enterprise/managed | Bukan positioning saat ini | Managed Data Services mulai dari $2.500/bulan untuk 350.000 page credit hingga $15.000/bulan untuk 3 juta halaman, atau Enterprise kustom |
Beberapa catatan jujur. Pertama, halaman harga Nimble dan dokumentasi SDK mereka sendiri saling bertentangan soal harga Search API — satu bilang $5 per 1.000 input, yang lain $1 per 1.000. Itu tipe beda angka yang saya ingin bereskan sebelum tanda tangan kontrak, dan saya tandai di sini daripada memilih angka yang terdengar lebih enak. Kedua, model berbasis credit Thunderbit pernah muncul sebagai titik friksi ringan di ulasan G2, dengan beberapa pengguna bilang harganya "bisa lebih terjangkau" untuk pemakaian berat — masukan yang fair, dan tentu kami perhatikan seiring produk berkembang. Ketiga, membandingkan keduanya murni dari harga saja agak seperti membandingkan tarif taksi dengan biaya sewa mobil — total biaya Nimble juga mencakup waktu engineer untuk membangun dan memelihara integrasi, sesuatu yang tidak pernah muncul di halaman harga tapi sangat nyata.
Siapa yang Sebaiknya Memilih Thunderbit?
Thunderbit paling pas kalau Anda operator non-teknis — sales, marketing, recruiting, ecommerce ops — yang butuh data terstruktur dari sebuah halaman web hari ini, tanpa nunggu tim engineering. Ini juga cocok untuk tim kecil yang ingin satu alat yang menangani ekstraksi cepat satu klik sekaligus, kalau perlu, bisa dihubungkan ke API atau AI agent yang kompatibel dengan MCP tanpa harus merekrut data engineer khusus. Kalau tim Anda pernah bilang, "kita cuma butuh daftar ini masuk spreadsheet," itulah use case-nya. Untuk gambaran yang lebih luas tentang di mana ekstraksi no-code cocok dipakai, artikel kami tentang web scraping tanpa coding membahas lebih banyak.
Siapa yang Sebaiknya Memilih Nimble?
Nimble masuk akal kalau Anda tim engineering atau data yang membangun sesuatu yang harus jalan terus dan dalam skala besar — job search, crawl, atau ekstraksi puluhan ribu sampai jutaan halaman, untuk mengisi pipeline RAG, sistem monitoring, atau data warehouse internal. Kalau Anda butuh kontrol level driver atas rendering JavaScript dan perilaku stealth, request dengan target geografis, capture jaringan, atau SLA enterprise dengan storage dan concurrency khusus, itulah infrastruktur yang memang tidak sedang coba diwakili Thunderbit.
Apakah Keduanya Bisa Saling Melengkapi?
Saya akui, ini sempat saya pikirkan saat riset — apakah sebuah tim masuk akal memakai keduanya? Secara teori, ya, sebagai lapisan arsitektur yang terpisah: Nimble menangani discovery dan retrieval skala besar, Thunderbit menangani tugas last-mile yang berhadapan langsung dengan manusia, yakni mengubah halaman tertentu jadi tabel bersih untuk stakeholder non-teknis. Saya juga ingin hati-hati supaya tidak terkesan ada kemitraan atau integrasi resmi antara kedua perusahaan, karena sejauh yang saya tahu memang tidak ada. Hanya saja, produk-produk ini ada di lapisan yang berbeda dalam stack hipotetis, seperti jaringan proxy dan alat spreadsheet yang ada di lapisan berbeda tanpa perlu saling bicara langsung.
Kesimpulan
Kalau saya harus merangkum semuanya jadi satu saran: pilih berdasarkan siapa yang menjalankan workflow, bukan berdasarkan perusahaan mana yang marketing AI-nya paling heboh. Tim sales lima orang yang ingin bikin daftar prospek tidak butuh driver tier dan callback webhook — mereka butuh klik tombol dan dapat spreadsheet, dan itulah alasan saya habiskan beberapa tahun terakhir membangun Thunderbit seperti sekarang. Tim data engineering yang membangun infrastruktur RAG produksi di atas satu juta halaman tidak mau ekstensi browser — mereka butuh API dengan kontrol akses bertingkat dan dukungan enterprise, dan itu memang alasan Nimble ada.
Volume juga jadi pembeda. Di bawah beberapa ribu halaman per bulan, ekstraksi satu klik menghemat lebih banyak waktu daripada biayanya. Setelah lewat itu, ekonominya mulai lebih berpihak ke infrastruktur yang bisa Anda otomatisasi dan monitor secara programatik — di situlah alat seperti Open API kami atau platform seperti Extract API milik Nimble mulai benar-benar bernilai. Dan soal maintenance: kalau tidak ada orang di tim Anda yang mau bertanggung jawab atas selector logic atau konfigurasi driver, itu tanda kuat bahwa Anda butuh produk yang mengabstraksikannya, bukan yang menyerahkan kendalinya ke Anda.
FAQ
Apakah Nimble itu ekstensi browser?
Tidak. Nimble berbasis API dan SDK — produk Search, Extract, Crawl, Map, dan Agent diakses lewat integrasi developer, bukan lewat alat browser klik-dan-pilih. Sebaliknya, Thunderbit menawarkan ekstensi browser sebagai titik masuk utamanya.
Apakah Thunderbit punya akses API dan MCP?
Ya. Thunderbit menyediakan Open API untuk ekstraksi programatik, MCP Server untuk AI agent seperti Claude, Cursor, dan Windsurf, serta CLI untuk workflow terminal dan coding-agent, di samping ekstensi browser no-code.
Mana yang lebih baik untuk crawl skala besar?
Nimble memang dibangun khusus untuk crawling dan searching skala besar melalui API Crawl, Map, dan Search, dengan tier driver dan penanganan job async yang dirancang untuk volume. Thunderbit dioptimalkan untuk ekstraksi level halaman dan multi-halaman dengan subpage enrichment, bukan crawling lintas domain secara menyeluruh.
Mana yang lebih mudah untuk pengguna bisnis?
Thunderbit, jauh lebih mudah. Workflow ekstraksi satu klik-nya tidak memerlukan selector, schema, atau kode — Anda buka halaman, klik, lalu dapat output terstruktur. Nimble mengasumsikan ada developer yang mengonfigurasi request, yang jelas jauh lebih tinggi ambang masuknya buat pengguna non-teknis.
Bagaimana perbedaan model harga saat ini?
Thunderbit memakai paket self-serve berbasis credit (lihat Thunderbit Pricing). Nimble memakai harga pay-as-you-go berbasis penggunaan yang terkait kompleksitas driver, plus kontrak Managed Data Services tahunan yang mulai sekitar $2.500 per bulan untuk kebutuhan skala enterprise. Selalu cek halaman harga live dari kedua perusahaan, karena dokumentasi Nimble sendiri menunjukkan ketidakkonsistenan antara halaman harga dan dokumen SDK.




