
Data Miner sudah bertahun-tahun nangkring di banyak folder ekstensi Chrome, diam-diam bantu banyak orang yang membangun sendiri perpustakaan pribadi berisi "recipe" scraping mereka. Saya berkali-kali lihat alat ini muncul di forum setiap kali ada yang tanya cara mengambil tabel dari website tanpa nulis kode. Ini alat yang sah dan memang berguna. Tapi, ini juga contoh bagus bahwa istilah "no-code" kadang tetap berarti "tanpa coding, tapi Andalah yang menyusun logikanya."
Itulah pertanyaan sebenarnya yang sering muncul saat orang mengetik "Thunderbit vs Data Miner" di Google: apakah saya mau membangun aturan yang bisa dipakai ulang sendiri, atau saya mau agen yang memahami halaman untuk saya? Mari kita jawab itu secara langsung, berdampingan, alih-alih melakukan hal yang sering dilakukan artikel lain — mengulas Data Miner dulu, lalu belok mendadak ke promosi Thunderbit tanpa pernah menempatkan keduanya dalam tabel yang sama.
Thunderbit vs Data Miner Sekilas
Saya jujur dari awal: saya menjalankan Thunderbit, jadi anggap saja sudut pandang saya tetap perlu sedikit disikapi dengan skeptis. Tapi saya berusaha menjaga tabel ini tetap jujur soal apa yang benar-benar dilakukan masing-masing alat, bukan soal apa yang ingin dipercaya oleh halaman marketing mereka.
| Kategori | Data Miner | Thunderbit |
|---|---|---|
| Metode ekstraksi | "Recipe" manual yang dibangun dari selector CSS/HTML | AI agentic — klik One Click Extract, lalu sistem mendeteksi dan membaca halaman, kemudian berjalan otomatis |
| Setup pertama kali | Buat recipe pribadi, atau cari/lihat recipe publik | Tanpa selector atau skema — cukup satu klik sengaja di halaman yang didukung |
| Pagination | Tambahkan selector "Next" ke List Recipe | Pagination yang kompatibel ditangani otomatis pada halaman yang didukung |
| Enrichment halaman detail | Alur dua recipe: List Recipe → simpan URL → Detail Recipe → Crawl | Enrichment subpage yang kompatibel, digabung ke tabel yang sama |
| Halaman login | Berfungsi pada konten yang terlihat dalam sesi browser yang sudah diotorisasi | Berfungsi pada konten yang terlihat dalam sesi browser yang sudah diotorisasi |
| Ekspor | CSV, Excel, clipboard, Google Sheets (paket berbayar) | Ekspor ke tujuan yang didukung (Sheets, Airtable, Notion) plus unduhan |
| Permukaan otomasi | Otomasi browser, otomasi halaman berikutnya, custom JS, crawl otomatis | Eksekusi browser/cloud, jadwal jika didukung, Open API, MCP Server, CLI |
| Keterpakaian ulang | Recipe bisa dibagikan dan dipakai ulang — pustaka komunitas yang besar | AI menafsirkan ulang tiap halaman; tidak ada pustaka recipe yang perlu dipelihara |
| Model harga | Kredit halaman bulanan, bertingkat sesuai volume | Berbasis paket, lihat harga terbaru |
| Paling cocok untuk | Target yang stabil dan berulang dengan recipe yang sudah tersedia | Halaman baru atau bervariasi, pengguna nonteknis, pekerjaan cepat satu kali |
Belum banyak yang menempatkan keduanya berdampingan seperti ini. Saya sudah cari. Agak aneh, mengingat keyword ini sering banget dicari.
Apa Itu Thunderbit?
Thunderbit adalah yang saya sebut sebagai agentic web scraper — kata "agentic" itu penting karena ini bukan sekadar mengotomatisasi klik, melainkan menafsirkan halaman seperti manusia, lalu memutuskan data apa yang kemungkinan penting. Kamu instal ekstensi Chrome, buka halaman yang memang kamu berwenang untuk lihat, lalu klik One Click Extract. Serius, itu saja langkah yang dibutuhkan. Agen akan membaca halaman, memahami field yang berguna, lalu mulai berjalan — kamu bisa tekan Run Now kalau mau langsung mulai, tapi kalau dibiarkan, prosesnya akan jalan otomatis dengan sendirinya.

Saya membangun ini khusus karena saya capek melihat rekan kerja nonteknis di pekerjaan sebelumnya mentok begitu alat scraping minta mereka menentukan "selector." Kebanyakan orang tidak tahu apa itu CSS selector, dan jujur saja, mereka juga tidak seharusnya perlu tahu.
Selain ekstensi, ada Web App, Open API untuk developer yang ingin akses programatik, MCP Server untuk workflow AI agent (bayangkan Claude, Cursor, dan ekosistem sejenis), serta CLI untuk otomasi berbasis terminal. Di halaman yang kompatibel, Thunderbit menangani pagination dan bisa memperkaya baris daftar dengan data dari halaman detail, lalu menggabungkan semuanya menjadi satu tabel.
Apa Itu Data Miner?
Data Miner lebih tua, lebih mapan, dan dibangun dengan filosofi yang sama sekali berbeda: recipe. Recipe adalah kumpulan instruksi yang disimpan — pada dasarnya selector yang dipetakan ke baris dan kolom — dan diikat ke struktur HTML website tertentu. Dokumentasi bantuan milik Data Miner sendiri menjelaskan bahwa recipe punya tiga jenis: public (dibagikan pengguna lain), generic (dibuat agar bekerja cukup luas di banyak situs), dan private (yang kamu buat sendiri).
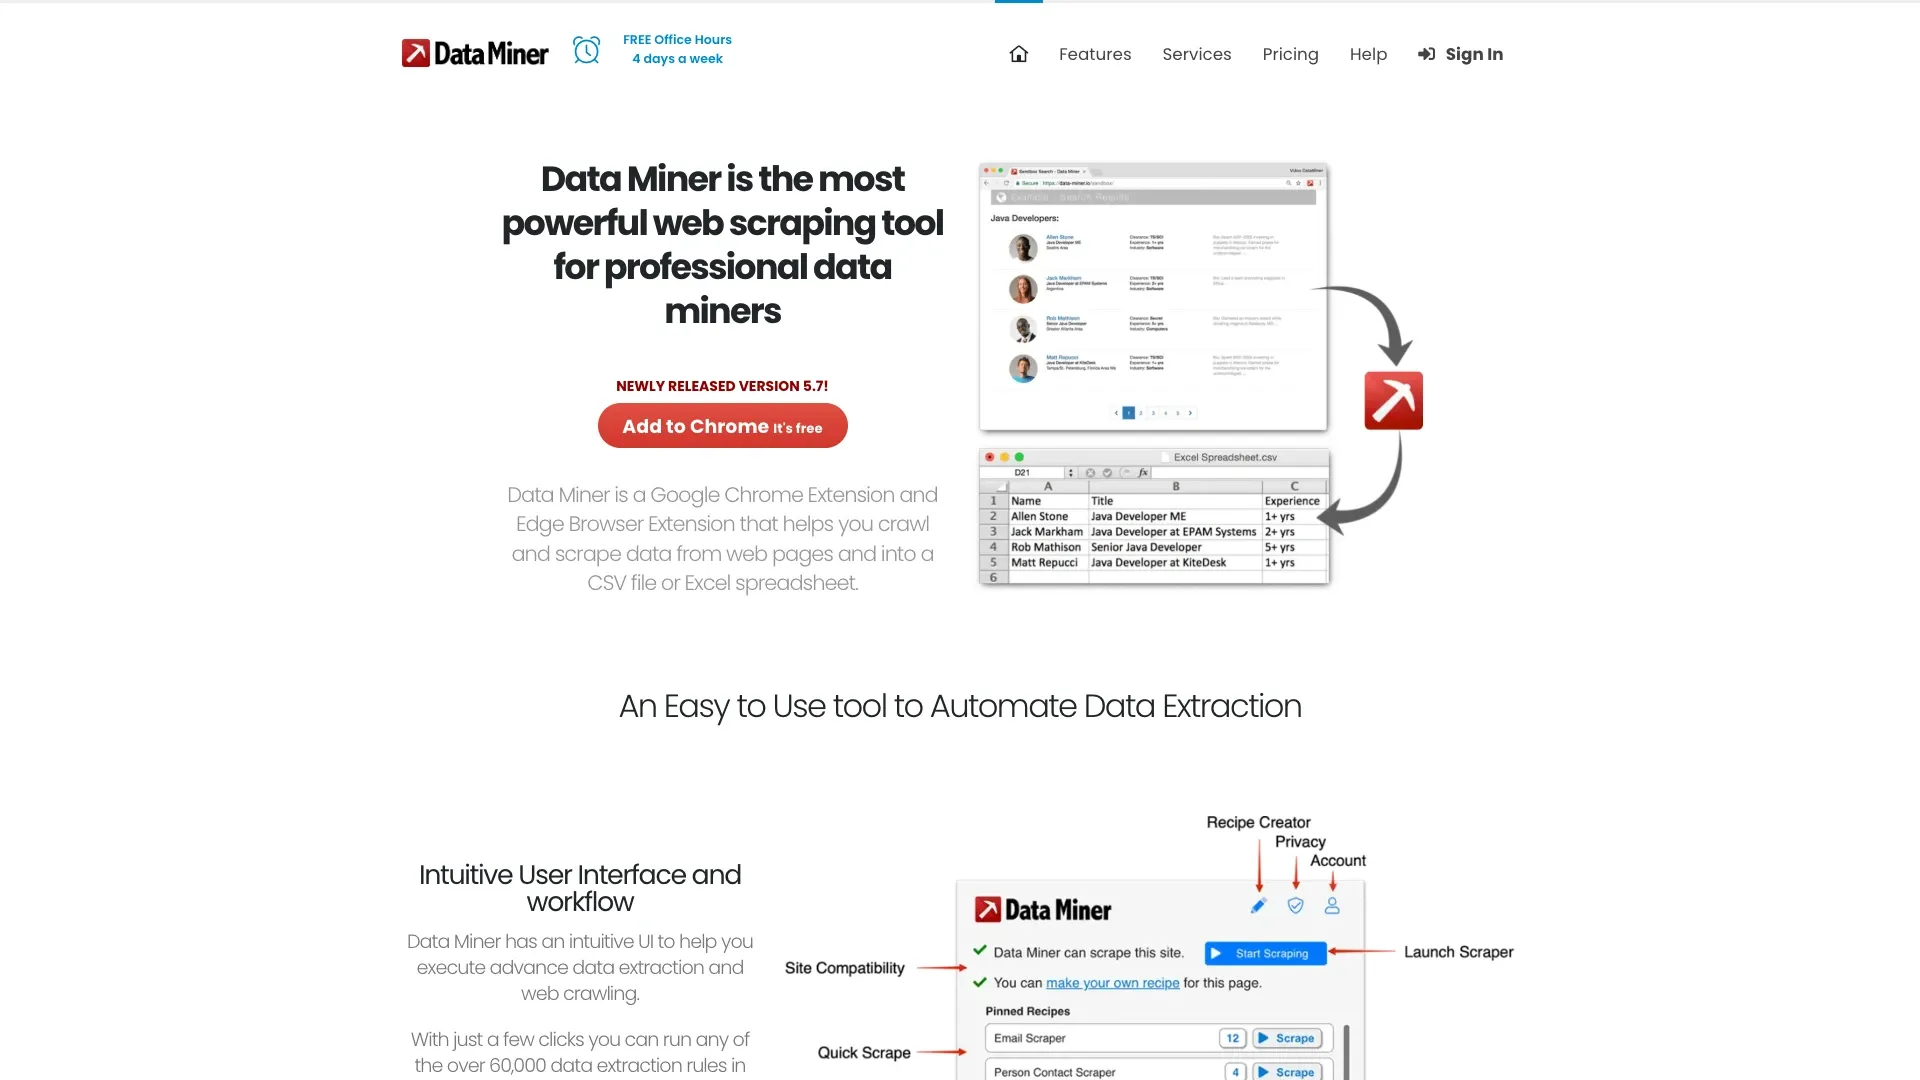
Situsnya mengklaim lebih dari 50.000 recipe publik yang mencakup lebih dari 15.000 website populer — walaupun menariknya, bagian lain di situs mereka sendiri menuliskan "60.000." Saya akan menyebutnya saja "puluhan ribu" dan silakan kamu simpulkan sendiri seberapa presisi hitungannya.
Data Miner mendukung Page Scrape, Next Page Automation, URL Crawl (untuk mengambil daftar URL), pengisian formulir otomatis, dan custom JavaScript untuk pengguna tingkat lanjut. Alat ini berjalan di browser, artinya ia bisa mengakses konten dalam sesi login seperti yang kamu lihat secara manual, dan pelanggan Enterprise mendapat opsi eksekusi di sisi server.
Perbedaan Utamanya: Pemahaman Halaman Saat Runtime vs Recipe Tersimpan
Di sinilah menurut saya banyak artikel perbandingan jadi malas. Mereka akan bilang "Data Miner berbasis recipe, Thunderbit berbasis AI" lalu selesai — tanpa contoh, tanpa alur, tanpa sesuatu yang benar-benar bisa kamu bayangkan.
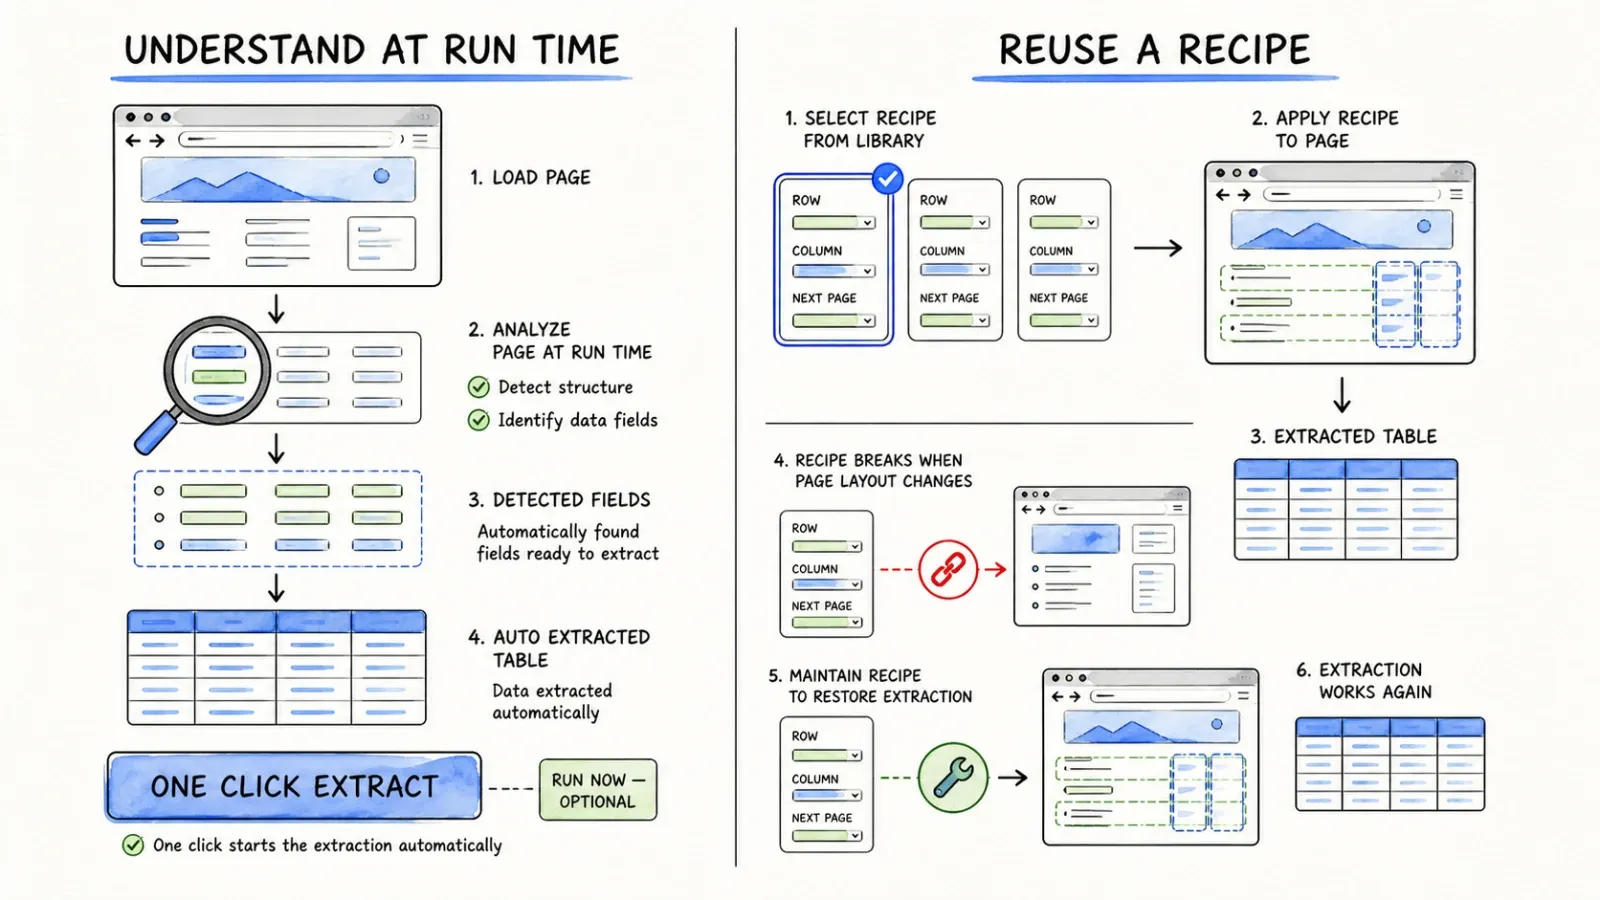
Thunderbit menyerahkan interpretasi ke agen. Setiap kali kamu membuka halaman baru, AI melihatnya dari awal. Ia tidak sedang merujuk buku aturan tersimpan untuk situs itu — ia membaca DOM, memahami struktur, dan mengambil keputusan tentang data apa yang penting. Artinya, tidak ada waktu setup pada halaman yang belum pernah kamu lihat sebelumnya, tetapi AI juga memang melakukan kerja real-time setiap kali run, bukan memutar ulang skrip yang dihafal.
Data Miner memakai ulang instruksi selector. Begitu sebuah recipe ada — entah kamu yang membuatnya atau orang lain — menjalankannya lagi jadi cepat karena logikanya sudah terkunci. Kekurangannya, yang diakui juga oleh dokumentasi Data Miner sendiri, kalau HTML situs berubah, recipe bisa rusak. Kamu akhirnya debugging selector, bukan scraping.
Kapan salah satunya menjadi "one click": Data Miner memang bisa benar-benar one-click — kalau recipe publik untuk target kamu sudah tersedia dan masih berfungsi. Tapi itu benar-benar kata "kalau." Klaim one-click Thunderbit berlaku untuk halaman yang bisa berhasil ditafsirkan agen; itu juga bukan jaminan untuk semua situs di internet, terutama situs dengan anti-bot yang kuat atau tata letak yang tidak biasa.
Tak satu pun alat punya monopoli atas kata "mudah." Mereka hanya mendefinisikan mudah dengan cara yang berbeda — satu lewat shortcut yang dibangun komunitas, satu lewat interpretasi saat runtime.
Perbandingan Alur Kerja Praktis
Mengambil tabel sederhana: Dengan Data Miner, kamu akan cek dulu apakah ada recipe publik untuk situs itu, lihat pratinjaunya, lalu scraping kalau cocok. Kalau tidak ada, kamu menyusun baris dan kolom secara manual pakai Easy Finder. Dengan Thunderbit, kamu cukup klik One Click Extract dan biarkan sistem mendeteksi struktur tabelnya sendiri.
Menangani pagination daftar produk atau direktori: Data Miner mengharuskan kamu menambahkan selector navigasi ke List Recipe supaya sistem tahu seperti apa bentuk "Next." Thunderbit menangani pagination yang kompatibel secara otomatis pada halaman yang didukung, tanpa langkah manual itu.
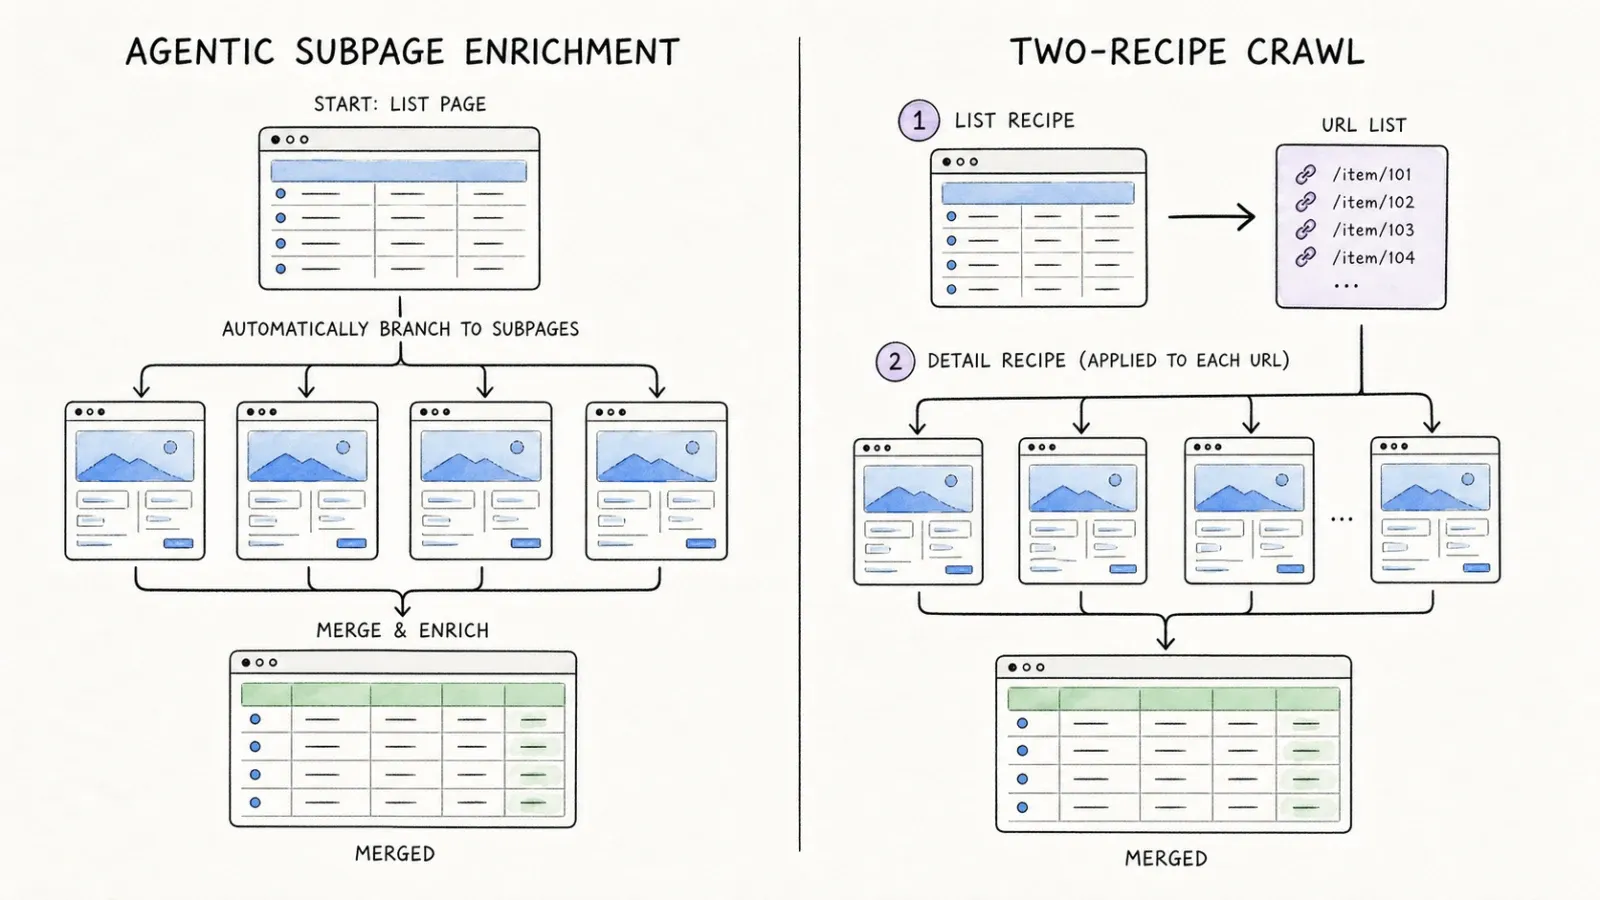
Memperkaya baris daftar dari halaman detail: Di sinilah alurnya paling jelas berbeda. Dokumentasi Crawl milik Data Miner menjelaskan proses yang benar-benar multi-langkah: buat List Recipe untuk mengumpulkan URL halaman detail, simpan daftar URL itu, buat Detail Recipe terpisah, buat job Crawl yang menghubungkan keduanya, validasi URL, jalankan, lalu ekspor. Fungsinya ada, tetapi memang melibatkan beberapa langkah terpisah dengan dua recipe berbeda. Enrichment subpage yang kompatibel di Thunderbit memasukkan data halaman detail ke tabel yang sama tanpa tarian pairing recipe itu — walaupun jujur saja, ini hanya bekerja dengan andal pada halaman yang bisa dibaca agen dengan baik.
Bekerja di balik login yang sah: Kedua alat bekerja pada konten yang terlihat di sesi browser kamu, jadi kalau kamu login ke akun yang memang berwenang, keduanya bisa melihat apa yang kamu lihat. Tak satu pun secara ajaib melewati autentikasi — mereka hanya bekerja dengan apa yang dirender di layar.
Otomasi, Ekstensi, dan Akses Developer
Otomasi Data Miner hidup di browser: next-page automation, crawl URL otomatis, dan custom JavaScript bagi mereka yang nyaman menulis skrip sendiri. Integrasi Google Sheets tersedia di paket berbayar. Pelanggan Enterprise bisa memindahkan eksekusi ke server Data Miner alih-alih menjalankan semuanya di sisi klien.
Permukaan Thunderbit lebih luas ke arah yang berbeda. Selain eksekusi browser dan cloud dengan jadwal pada halaman yang didukung, ada Open API untuk integrasi backend, dan MCP Server — yang ternyata lebih penting daripada kedengarannya. MCP memungkinkan AI agent (Claude Code, Cursor, dan alat serupa) memanggil Thunderbit langsung sebagai bagian dari workflow mereka sendiri. Kalau kamu membangun sesuatu di mana agen AI perlu mengambil data web terstruktur sebagai satu langkah di dalam pipeline yang lebih besar, itu kemampuan yang sangat berbeda dibandingkan "saya menulis custom JavaScript di ekstensi browser saya."
Biar jelas, custom JS milik Data Miner memang berguna buat power user yang ingin kontrol detail. Hanya saja, itu bukan kategori alat yang sama dengan public API atau MCP server yang bisa dipanggil agen.
Ekspor, Privasi, dan Penanganan Data
Data Miner mengekspor ke CSV, Excel, clipboard, atau Google Sheets pada paket berbayar. FAQ harganya menyatakan data hasil scraping tidak dijual atau dibagikan, dan dokumentasi crawl berbasis browser menyebutkan data tidak disimpan di server Data Miner selama crawl otomatis standar — kamu diharapkan menyimpannya sendiri setelah job selesai. Job server-side untuk Enterprise adalah model eksekusi yang berbeda.
Thunderbit mengekspor ke tujuan yang didukung seperti Google Sheets, Airtable, dan Notion, plus unduhan standar, dan menawarkan mode eksekusi browser maupun cloud tergantung alur kerja kamu.
Saya tidak akan pura-pura bahwa salah satu arsitektur ini secara universal "lebih privat" daripada yang lain — semuanya bergantung pada apa yang kamu scrape, seberapa sensitif datanya, dan mode eksekusi mana yang kamu pilih. Kalau sensitivitas data penting untuk kasus kamu, itu hal yang layak dibahas dengan vendor mana pun sebelum kamu berkomitmen, bukan sesuatu yang bisa diasumsikan dari artikel perbandingan.
Harga: Batas Halaman dan Biaya Recipe
Berikut harga Data Miner saat tulisan ini dibuat:
| Paket | Harga | Halaman/bulan |
|---|---|---|
| Free | $0 | 500 (beberapa domain dibatasi) |
| Solo | $19.99/bulan | 500 |
| Small Business | $49/bulan | 1.000 |
| Business | $99/bulan | 4.000 |
| Business Plus | $200/bulan | 9.000 |
| Enterprise | Kustom | Kustom |
Kredit direset setiap bulan dan tidak dibawa ke bulan berikutnya — dan FAQ mereka sendiri menyebut bahwa kalau batas 500 halaman pada paket gratis terlampaui, akun gratis bisa terkunci sampai kamu upgrade. Ini penting untuk diketahui sebelum proyek kamu sudah setengah jalan.
Hal yang hampir tak pernah disebut orang saat mengulas Data Miner: mereka juga menjual pengembangan recipe kustom sebagai layanan berbayar. Satu recipe kustom biayanya $150 sekali bayar; recipe multi-level (yang biasanya kamu butuhkan untuk crawl dari daftar ke detail) biayanya $300 sekali bayar; untuk kebutuhan yang lebih kompleks, biayanya berbasis penawaran. Kalau situs target kamu tidak punya recipe publik yang berfungsi dan kamu tidak ingin membuatnya sendiri, itu biaya nyata di luar langgananmu.
Untuk harga Thunderbit saat ini, lihat halaman harga langsung daripada mempercayai angka apa pun yang saya sebutkan di sini — paket bisa berubah, dan saya lebih suka mengarahkan kamu ke sumber asli daripada membiarkan angkanya jadi usang.
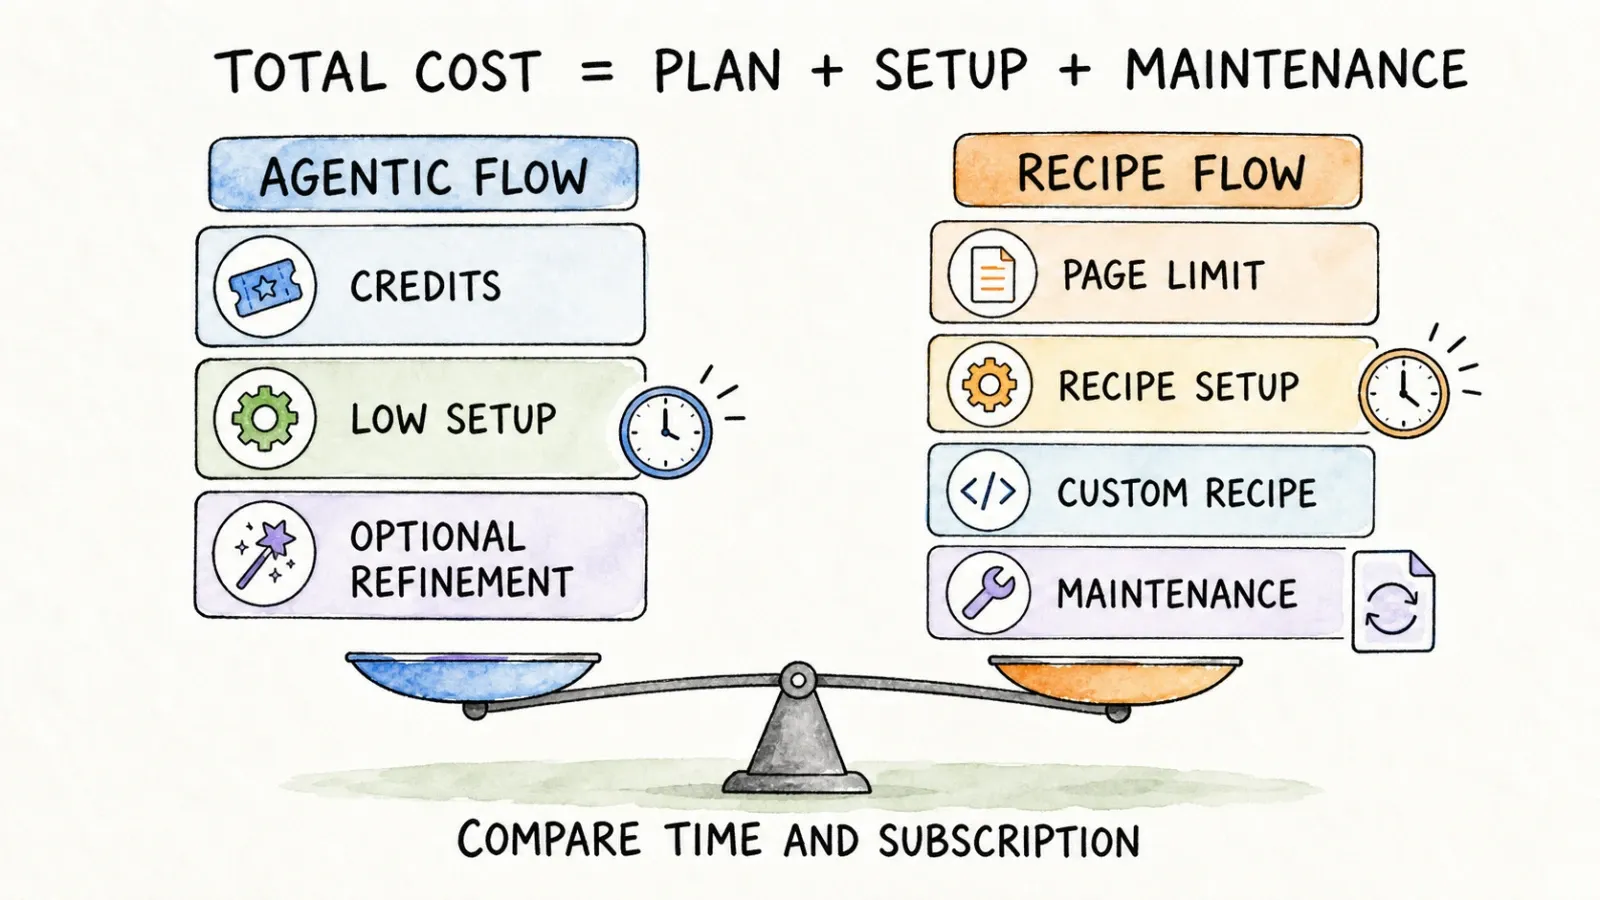
Pertimbangan biaya yang lebih besar sebenarnya bukan harga di label paket salah satu alat — melainkan total waktu yang dihabiskan. Membuat dan memelihara recipe makan jam kerja yang tidak dibayar kecuali kamu menghitung gaji kamu sendiri. Interpretasi ulang oleh agen menghindari beban maintenance itu, tetapi berarti AI melakukan kerja baru setiap run, yang merupakan jenis biaya berbeda (biaya komputasi, bukan biaya sore kamu).
Jadi, Mana yang Harus Kamu Pilih?
Pilih Thunderbit jika... kamu tidak teknis, kamu sedang menghadapi halaman yang belum pernah kamu scrape sebelumnya, atau kamu ingin melewatkan proses membuat/mencari recipe sama sekali. Tim sales ops yang ambil lead list dari direktori, peneliti pasar yang cek halaman harga kompetitor setiap minggu, atau siapa pun yang cuma ingin data sekarang tanpa fase setup.
Pilih Data Miner jika... kamu punya target yang stabil dan berulang, recipe publiknya sudah ada dan berfungsi, atau kamu tipe orang yang memang suka kontrol selector yang sangat granular dan tidak keberatan bikin ulang recipe ketika sebuah situs didesain ulang. Power user yang nyaman dengan custom JavaScript juga akan merasa cocok di sini.
Gunakan keduanya jika... kebutuhan kamu campuran — ada job lama pada situs yang sudah punya recipe Data Miner yang masih jalan (tidak ada alasan untuk membangunnya ulang), dan ada target baru yang bervariasi di mana kamu tidak ingin menghabiskan sore untuk mendefinisikan selector. Saya bicara dengan tim yang memang melakukan ini: recipe lama tetap dipakai, Thunderbit dicoba untuk hal-hal baru. Jadi ini bukan keputusan serba-atau-tidak-sama-sekali, walaupun banyak artikel "vs" terdengar seolah begitu.
Putusan Akhir
Memang semuanya kembali ke interpretasi agentic versus recipe yang bisa dipakai ulang — dan tak satu pun pendekatan unggul secara objektif di semua skenario. Data Miner memberi imbalan berupa kesabaran dan investasi spesifik per situs dengan run berulang yang benar-benar cepat. Thunderbit memberi imbalan kecepatan menuju hasil pertama dengan harga bahwa ia tidak pernah benar-benar "menghafal" situs seperti recipe.
Saran jujur saya: pilih satu target yang memang kamu berwenang akses dan benar-benar butuh datanya, lalu uji keduanya. Ukur berapa lama setup berlangsung, hitung berapa baris yang keluar bersih dan bisa dipakai, lihat apa yang terjadi setelah situs mengubah sesuatu (recipe bisa rusak, agent biasanya beradaptasi), dan jumlahkan biaya nyata termasuk biaya custom recipe kalau kamu membutuhkannya.
Kalau kamu ingin lihat versi one-click-nya secara langsung, ekstensi Chrome Thunderbit bisa dicoba gratis — tanpa perlu membangun recipe.
FAQ
Apakah Data Miner benar-benar one-click? Bisa, kalau sudah ada recipe publik yang berfungsi untuk situs target kamu. Kalau belum, kamu harus membuatnya dari nol lewat Recipe Creator mereka, dan itu butuh waktu setup yang nyata.
Apakah Data Miner memerlukan coding? Tidak untuk recipe dasar — Easy Finder memungkinkan kamu klik untuk memilih baris dan kolom. Custom JavaScript dan kerja selector tingkat lanjut bersifat opsional bagi power user yang ingin kontrol lebih.
Bisakah Data Miner mengambil banyak halaman dan halaman detail? Bisa, lewat Next Page Automation untuk pagination dan workflow Crawl dua recipe (List Recipe + Detail Recipe) untuk menarik data dari halaman detail yang terhubung.
Apakah Thunderbit memakai CSS selector? Tidak. Agen menafsirkan struktur halaman saat runtime, jadi tidak perlu definisi selector manual pada halaman yang didukung.
Mana yang lebih baik di balik login? Keduanya bekerja pada konten yang terlihat di sesi browser yang berwenang, jadi hasil lebih bergantung pada apa yang dirender di layar daripada alat mana yang kamu gunakan.
Bagaimana Data Miner menghitung halaman? Setiap paket memberi batas kredit halaman bulanan — 500 untuk Free dan Solo, naik hingga 9.000 di Business Plus. Kredit direset setiap bulan dan tidak dibawa ke bulan berikutnya.
Apakah salah satu produk ini menawarkan API? Thunderbit punya Open API, MCP Server, dan CLI untuk workflow developer dan agent. Otomasi Data Miner terutama berbasis browser, dengan opsi server-side tersedia untuk pelanggan Enterprise.
Bisakah salah satu scraper ini bekerja di semua website? Tidak. Keduanya bergantung pada kompatibilitas halaman, otorisasi, dan struktur situs — perlindungan anti-bot, layout yang tidak umum, atau rendering JavaScript yang berat bisa membatasi keduanya.




