
Beberapa minggu lalu, seseorang di tim kami mengirimkan thread issue GitHub ke saya — ada developer yang masih sibuk debug logika retry PlaywrightCrawler ketiganya pada jam 11 malam di hari Jumat. Tepat di bawahnya, orang lain membalas, "pakai Thunderbit saja untuk ini," lalu si pengirim thread membalas, "itu bukan inti masalahnya, saya butuh ini masuk ke pipeline saya." Keduanya sama-sama benar. Kurang lebih itulah inti perdebatan Thunderbit vs Crawlee dalam satu thread GitHub.
Saya sudah cukup lama bolak-balik di dunia SaaS dan tooling otomatisasi (salut untuk masa-masa saya di Automation Anywhere) untuk tahu bahwa pertanyaan "scraper mana yang lebih bagus" hampir selalu pertanyaan yang keliru. Pertanyaan yang tepat adalah: siapa yang sebenarnya melakukan scraping, dan mereka butuh apa setelahnya? Mari kita bahas.
Pertanyaan Sebenarnya Bukan "Tool Mana yang Lebih Baik" — Melainkan "Siapa yang Melakukan Scraping?"
Ada satu hal yang hampir selalu bikin orang salah paham saat mereka mencari di Google "Crawlee vs [apa pun]": mereka mengira ini akan jadi adu fitur detail demi detail, seperti membandingkan dua mesin kopi. Padahal Crawlee dan Thunderbit tidak bersaing untuk pekerjaan yang sama. Keduanya dibuat untuk dua tipe orang yang sangat berbeda, menghadapi dua masalah yang juga sangat berbeda.
Crawlee adalah pustaka crawling open-source yang dibangun oleh tim Apify, dan asumsi dasarnya adalah Anda seorang developer yang nyaman menulis JavaScript, TypeScript, atau Python. Anda akan memasangnya, menulis request handler, menentukan selector, lalu menjalankan kodenya. Thunderbit berangkat dari asumsi yang sangat berbeda: Anda adalah orang di tim sales, marketing, atau ops yang butuh data terstruktur dari sebuah halaman web sekarang juga, dan sama sekali tidak tertarik menyentuh terminal.
| Faktor | Crawlee | Thunderbit |
|---|---|---|
| Untuk siapa | Developer yang membangun crawler kustom | Pengguna non-teknis, tim ops/sales/marketing |
| Kebutuhan setup | Instal Node.js atau Python, tulis kode scraper | Instal ekstensi browser, klik One Click Extract |
| Perlu coding? | Ya (JS/TS atau Python) | Tidak |
| Paling cocok untuk | Pipeline produksi, logika kustom | Ekstraksi terstruktur ad-hoc atau berulang dari sebuah halaman |
Saya menekankan hal ini di awal karena menurut saya banyak artikel perbandingan melewatkan percabangan paling penting ini, padahal inilah yang sebenarnya menentukan tool mana yang layak Anda evaluasi. Kalau Anda developer yang butuh kontrol rinci atas retry, proxy, dan browser pool, kenyamanan satu klik tidak akan cukup. Sebaliknya, kalau Anda bukan developer, fleksibilitas Crawlee tidak akan banyak berarti — Anda memang tidak akan memakainya.
Apa Itu Thunderbit?
Thunderbit adalah yang saya sebut sebagai agentic web scraper — artinya lapisan AI-lah yang melakukan pekerjaan interpretasi untuk memahami isi halaman dan menentukan apa yang perlu diekstrak, alih-alih Anda menulis selector secara manual. Alur utamanya di Thunderbit Chrome Extension seperti ini: buka halaman yang datanya ingin Anda ambil, klik One Click Extract, lalu agen akan membaca dan menganalisis halaman, mencari field yang berguna, dan menyiapkannya untuk dijalankan. Tombol Run Now akan muncul supaya Anda bisa langsung memulainya, tetapi itu opsional — kalau Anda tidak melakukan apa-apa, proses ekstraksi akan berjalan otomatis.

Sederhana memang, dan benar-benar sesederhana itu. Tidak ada sesi membangun skema atau memetakan field: agen menganalisis halaman lalu ekstraksi langsung berjalan otomatis.
Selain ekstensi browser, Thunderbit juga punya Web App, Open API untuk akses programatik, MCP Server untuk penggunaan alat oleh AI agent, dan CLI untuk alur kerja berbasis terminal. Bagian terakhir ini lebih penting daripada yang banyak orang sadari — saya akan kembali ke sana nanti, karena itulah yang membuat artikel ini tidak sekadar "no-code menang".
Pada halaman yang kompatibel, Thunderbit juga bisa menangani pagination dan memperkaya subpage, dan setelah data didapat, Anda bisa mengekspornya ke spreadsheet atau tujuan lain yang didukung. Saya ingin memberi catatan yang sama seperti saat membahas semua klaim "AI membaca halaman": ini bekerja dengan baik pada halaman yang kompatibel dan berwenang, tetapi bukan janji bahwa setiap framework JavaScript atau tembok anti-bot di internet akan tunduk pada Anda.
Apa Itu Crawlee?
Crawlee adalah pustaka open-source — bukan produk hosted — untuk membangun web crawler dan scraper di JavaScript/TypeScript atau Python. Pustaka ini dikelola oleh Apify, dan saya ingin luruskan di sini karena banyak orang mencampuradukkan keduanya: Crawlee adalah library, sementara Apify adalah platform cloud terpisah, meski masih terkait, yang bisa menjalankan dan menampung proyek berbasis Crawlee. Mereka itu sepupu, bukan barang yang sama.
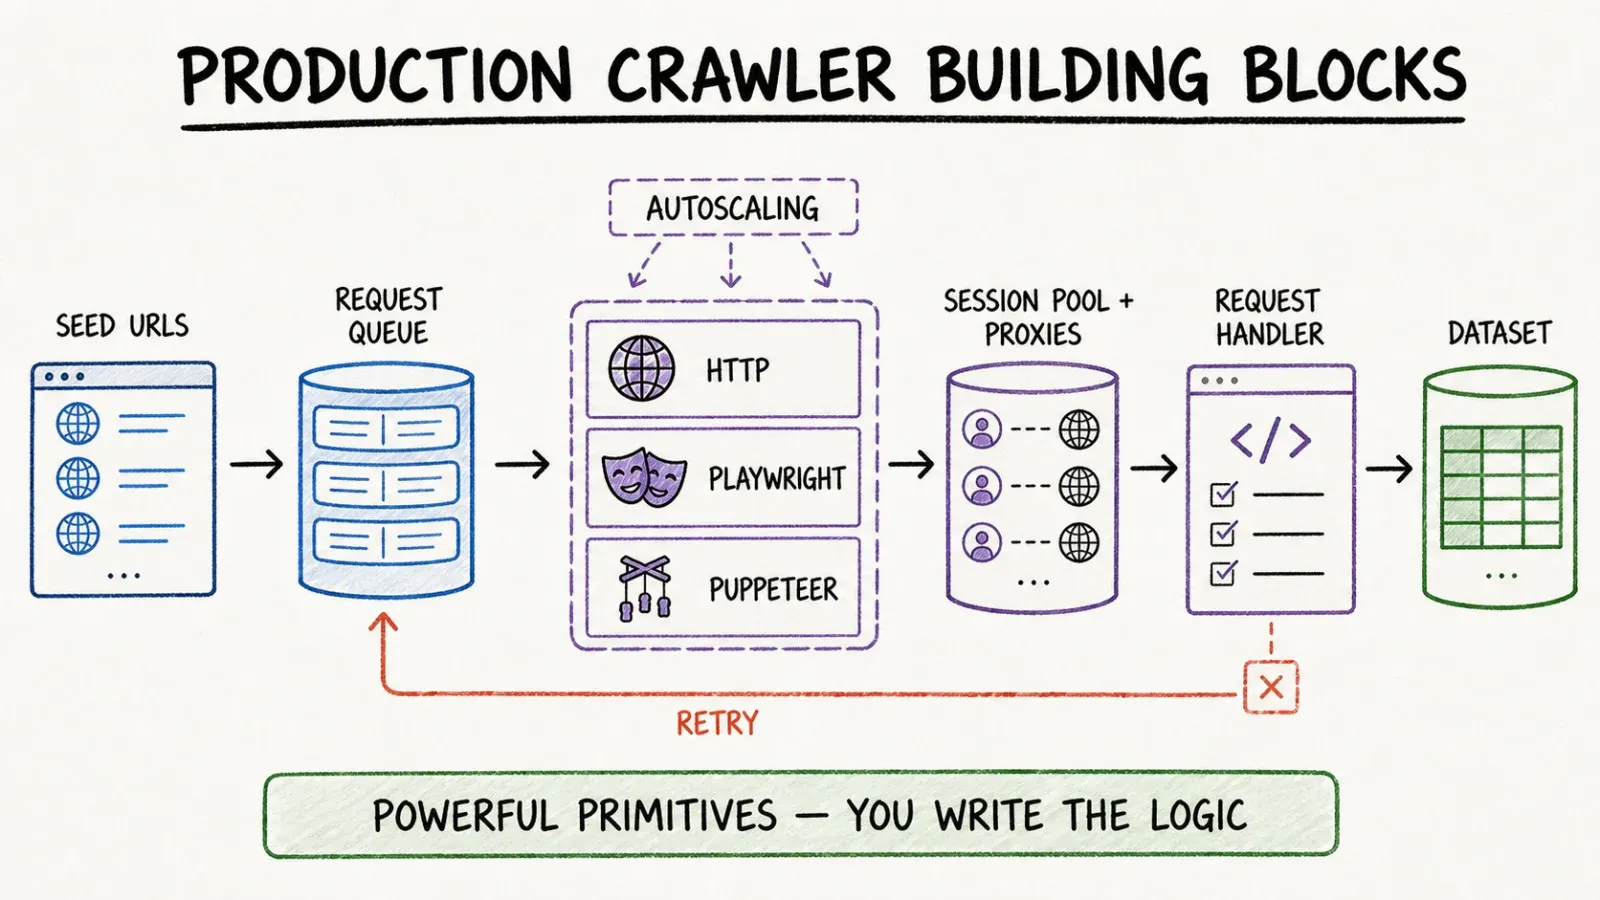
Yang benar-benar Anda dapatkan dari Crawlee adalah seperangkat alat. Ia menyediakan crawler berbasis HTTP untuk scraping ringan yang tidak terlalu bergantung pada JavaScript, plus browser crawler berbasis Playwright dan Puppeteer untuk situs yang membutuhkan rendering sungguhan. Ia menangani request queue supaya Anda tidak perlu melacak sendiri URL mana yang sudah dikunjungi. Ia mengelola penyimpanan data hasil ekstraksi. Ia juga punya autoscaling dan session pool bawaan, jadi kalau Anda menjalankan crawl untuk ribuan halaman, Anda tidak perlu membangun logika concurrency dari nol.
Namun semua ini tidak terjadi hanya dengan menekan tombol. Anda menulis kode — mendefinisikan request handler, menyiapkan instance crawler, lalu memberi tahu apa yang harus dilakukan ketika ia membuka halaman. Crawlee menyediakan kerangkanya; Anda tetap harus membangun rumahnya.
Perbedaan Inti: Produk Ekstraksi Terkelola vs Pustaka Kode
Waktu hingga tabel terstruktur pertama
Di sinilah jurangnya paling terasa. Dengan Thunderbit, dari membuka halaman sampai mendapatkan tabel data yang bisa dipakai, biasanya hanya butuh hitungan detik sampai beberapa menit pada halaman yang kompatibel — klik, biarkan agen mendeteksi dan menjalankan, selesai.
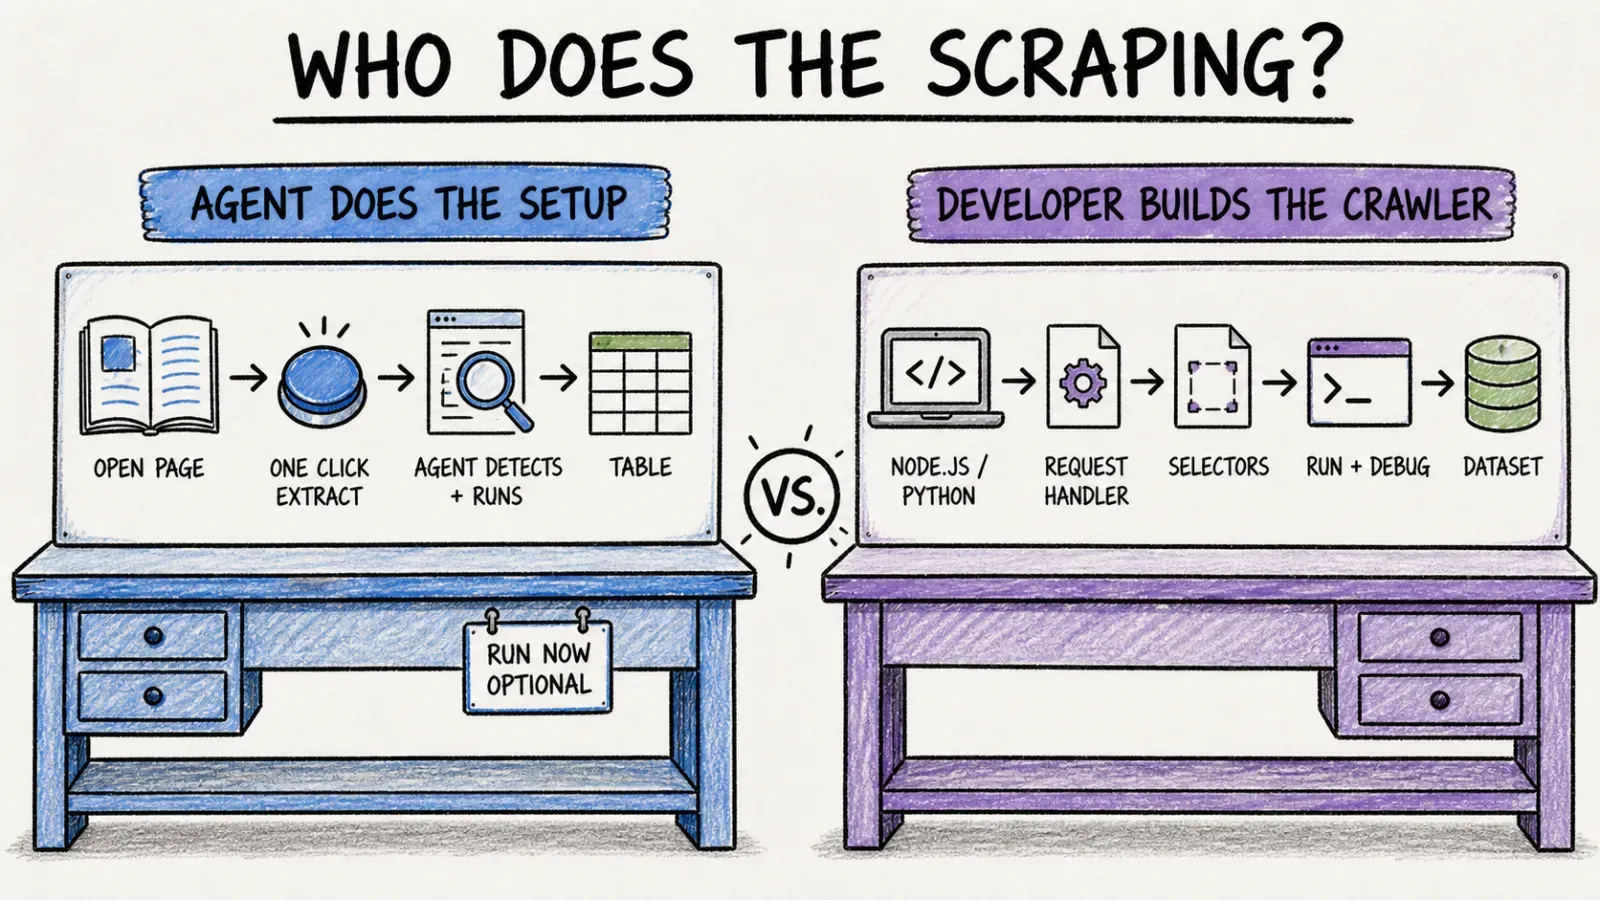
Dengan Crawlee, bahkan crawler pertama yang sederhana pun tetap butuh waktu setup yang nyata. Anda perlu memasang Node.js atau Python, menambahkan paket Crawlee, menulis request handler, menentukan selector secara manual lewat inspeksi halaman, lalu menjalankannya dan memperbaiki error yang muncul. Untuk orang yang baru mulai, saya perkirakan butuh sekitar 30–60 menit hanya untuk mendapatkan satu ekstraksi yang berjalan — dan itu pun dengan asumsi Anda sudah cukup paham JavaScript atau Python.
Kontrol atas logika browser/crawler
Di sini Crawlee menang telak, tidak ada perdebatan. Anda mengontrol semuanya: engine browser mana yang dipakai, bagaimana session dikelola, bagaimana proxy diputar, apa yang terjadi saat request gagal, seberapa dalam link discovery dilakukan, dan bagaimana throttling concurrency diatur. Jika crawl Anda butuh logika kustom — misalnya menangani alur login multi-langkah atau menjelajahi situs dengan pagination aneh yang merusak pola standar — Crawlee memberi Anda primitive untuk membangun persis seperti itu.
Pendekatan agentic Thunderbit menukar ketelitian itu dengan kecepatan dan kemudahan akses. Anda tidak menulis logikanya; AI yang menyimpulkannya berdasarkan apa yang terlihat di halaman. Itu sangat bagus saat berhasil, tetapi kurang ideal ketika Anda perlu memaksa pola ekstraksi yang sangat spesifik dan tidak terlihat jelas.
Kepemilikan deployment dan maintenance
Dengan Crawlee, deployment sepenuhnya menjadi tanggung jawab Anda. Artinya Anda bertanggung jawab atas hosting (server sendiri, atau platform Apify, atau tempat lain yang Anda pilih), atas perubahan markup situs yang bisa merusak selector, dan atas pembaruan dependensi. Ini memang kerja berkelanjutan yang nyata, tetapi kontrol yang Anda dapatkan juga nyata.
Thunderbit berjalan di infrastruktur terkelola — ekstensi browser berjalan secara lokal di sesi Anda atau di cloud untuk job terjadwal, dan pembaruan logika ekstraksi terjadi di sisi Thunderbit, bukan di sisi Anda.
Skenario Praktis
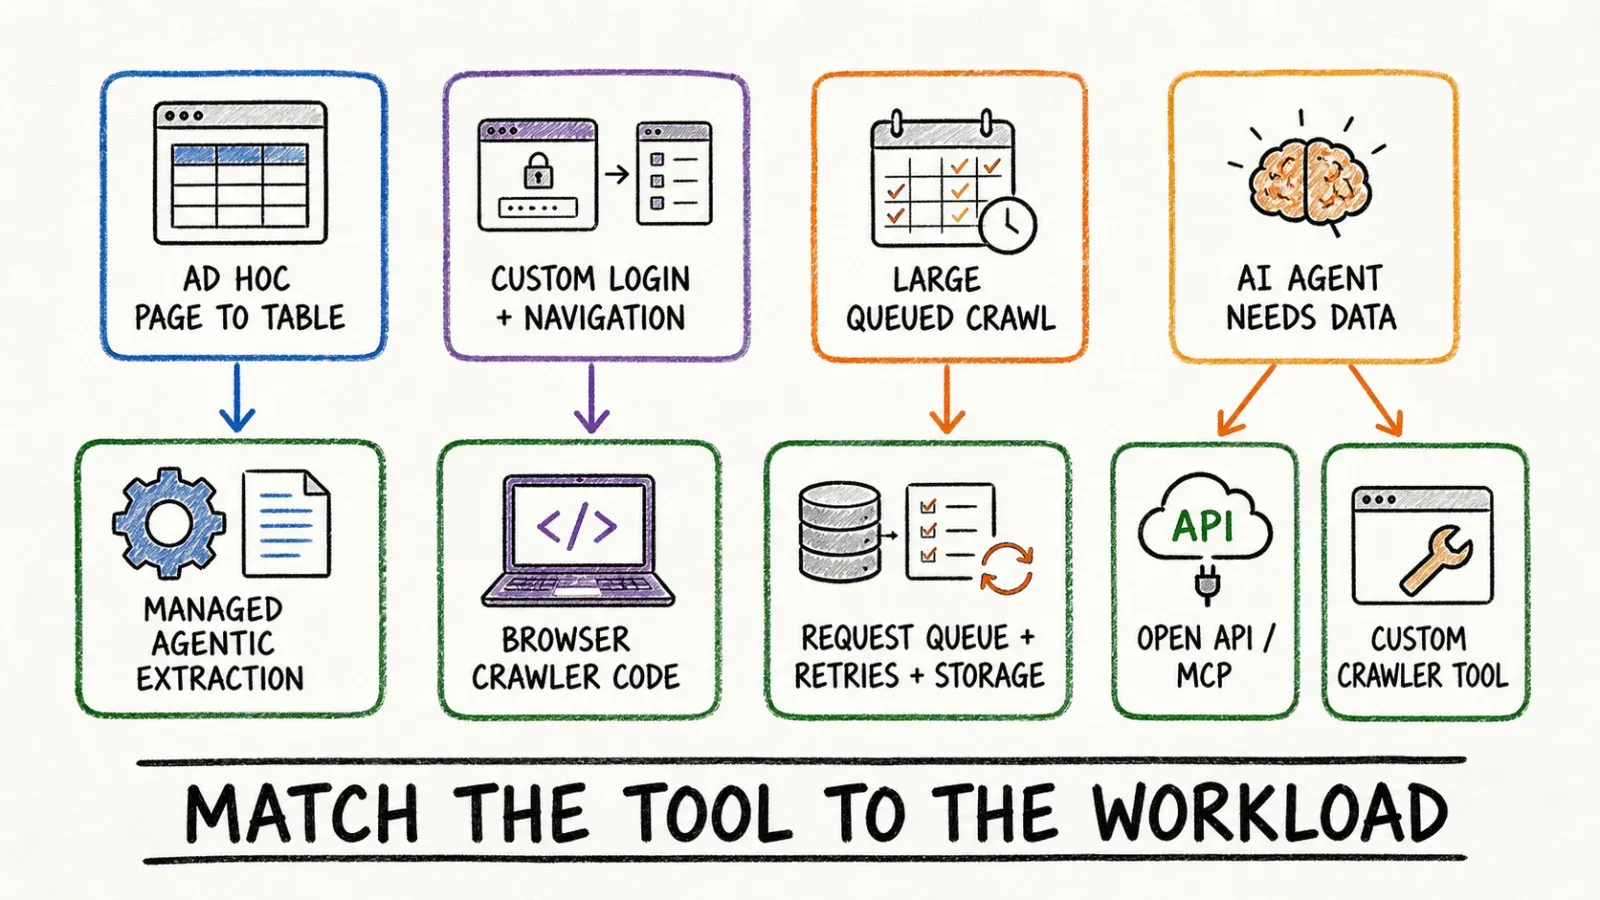
Ekstraksi halaman satu kali
Misalnya Anda perlu mengambil halaman listing produk kompetitor ke spreadsheet sebelum rapat jam 2 siang. Thunderbit memang dibuat untuk kasus seperti ini — buka halaman, klik One Click Extract, ekspor. Untuk tugas yang benar-benar sekali pakai, Crawlee terlalu berlebihan; waktu Anda akan habis untuk menulis skrip ketimbang waktu yang dihemat.
Crawl kustom dengan Playwright/Puppeteer
Sekarang bayangkan Anda sedang membangun pipeline monitoring yang harus login ke dashboard terautentikasi, menavigasi tiga tingkat ke dalam, lalu mengekstrak data dari situs yang merender semuanya lewat framework JS dengan timing DOM yang tidak biasa. Ini wilayah asli Crawlee. PlaywrightCrawler memberi primitive otomatisasi browser untuk menangani logika navigasi kustom seperti ini.
Crawl besar dengan antrean, retry, dan penyimpanan
Kalau Anda melakukan crawl terhadap puluhan ribu URL dan butuh logika retry otomatis, persistensi request queue, serta output penyimpanan data terstruktur, abstraksi request queue dan dataset bawaan Crawlee memang dirancang untuk skala seperti ini. Ini bukan use case khas ekstensi browser Thunderbit — itu alat untuk satu halaman demi satu halaman (atau subpage yang kompatibel), bukan sistem manajemen antrean.
Memanggil ekstraksi dari AI agent
Ini skenario yang biasanya sering disalahpahami dalam perbandingan seperti ini. Developer yang membangun workflow AI-agent kadang mengira bahwa "AI agent butuh data" otomatis berarti "tulis kode Crawlee kustom lalu bungkus sebagai tool." Itu salah satu jalur yang valid. Tetapi Thunderbit punya MCP Server justru supaya AI host — seperti Claude, Cursor, dan klien kompatibel lain — bisa memanggil kemampuan ekstraksi Thunderbit sebagai tool tanpa ada yang menulis crawler kustom. Ini antarmuka yang benar-benar berbeda dari alur browser satu klik, dan memang perlu konfigurasi, bukan "klik lalu jadi." Tapi itu juga tidak seberat membangun tool berbasis Crawlee dari nol.
Situs Dinamis, Skala, dan Keandalan
Saya ingin hati-hati di bagian ini karena di sinilah copy marketing (termasuk saya, secara historis) sering terlalu menjanjikan. Browser crawler Crawlee bisa menjalankan JavaScript, menunggu konten dinamis, dan berinteraksi dengan halaman seperti pengguna sungguhan — ini memang sangat berguna untuk situs yang rendering-nya berat. Ekstensi browser Thunderbit juga berjalan di konteks browser sungguhan dan bisa bekerja dengan halaman yang dirender oleh JS saat halaman itu Anda buka.
Namun tidak ada alat yang menjamin keberhasilan di semua situasi. Crawlee memberi developer alat untuk mengatur rotasi proxy dan session pool sendiri — ini kontrol manual yang bisa dituning, bukan bypass otomatis. Thunderbit menerapkan rendering terkelola dan penanganan anti-bot pada halaman yang didukung dan berwenang, yang juga bukan klaim universal bahwa "bisa jalan di semua hal." Kalau Anda membaca perbandingan mana pun yang menjanjikan keberhasilan 100% terhadap semua sistem anti-bot di internet, berarti perbandingan itu bohong — titik.
Harga, Lisensi, dan Total Biaya
Crawlee sendiri gratis dan open-source — versi Python, misalnya, dirilis di bawah Apache License 2.0. Tetapi "gratis" tidak berarti "tanpa biaya." Anda membayar dengan waktu developer untuk menulis dan memelihara crawler, dengan biaya hosting (server sendiri atau platform Apify, yang merupakan produk berbayar terpisah dari library-nya), dan dengan biaya layanan proxy jika situs target membutuhkan rotasi IP untuk menghindari blokir.
Thunderbit menggunakan model berlangganan/paket dengan pemakaian berbasis kredit — saya sarankan Anda langsung melihat halaman Thunderbit Pricing karena angkanya bisa berubah, dan saya tidak ingin mengutip angka yang sudah kedaluwarsa saat Anda membacanya nanti.
Perbandingan maintenance yang jujur: crawler Crawlee bisa rusak ketika situs target mengubah markup, karena selector Anda ditulis berdasarkan struktur DOM tertentu. Seseorang harus menyadari kegagalannya lalu memperbaiki kode. Ekstraksi agentic Thunderbit menganalisis ulang halaman setiap kali dijalankan, sehingga mengurangi — bukan menghilangkan — jenis kerusakan seperti ini. Perombakan layout besar di situs target tetap bisa mengacaukan hasil, tetapi Anda tidak perlu memelihara selector hardcoded dengan cara yang sama.
Siapa yang Sebaiknya Memilih Thunderbit?
Kalau Anda bukan developer dan butuh data terstruktur dari halaman web — untuk daftar lead, harga kompetitor, riset pasar, dan sejenisnya — Thunderbit memang dibuat untuk situasi Anda. Begitu juga jika Anda developer yang ingin menyerahkan alat ekstraksi self-serve ke tim non-teknis, atau jika Anda ingin akses programatik melalui Open API tanpa harus membangun crawler lengkap dari nol.
Siapa yang Sebaiknya Memilih Crawlee?
Kalau Anda sedang membangun pipeline data produksi yang membutuhkan logika navigasi kustom, kontrol yang sangat rinci atas retry dan perilaku proxy, serta ingin memiliki source code sepenuhnya dari ujung ke ujung, maka Crawlee adalah fondasi yang tepat. Ini juga pilihan yang lebih baik jika crawl Anda memang harus berjalan dalam skala nyata — puluhan ribu halaman dengan manajemen request queue — karena itulah bentuk masalah yang memang tidak dirancang untuk diselesaikan oleh alur kerja ekstensi browser.
Bisakah Tim Memakai Keduanya?
Secara realistis, ya, dan saya rasa itu bukan jawaban mengelak. Saya sudah melihat pola ini terjadi di banyak perusahaan tempat saya bekerja: tim engineering mengelola pipeline berbasis Crawlee untuk pekerjaan crawl terstruktur berulang dalam skala besar yang mengisi data warehouse, sementara tim sales, marketing, atau ops memakai ekstensi browser atau Web App Thunderbit untuk tugas ad-hoc "saya butuh data dari satu halaman ini sekarang" yang kalau tidak ada, biasanya akan berakhir jadi tiket di backlog engineering. Tidak ada integrasi resmi yang menghubungkan keduanya — saya tidak akan mengarangnya — tetapi dari sisi arsitektur, keduanya menyelesaikan masalah yang berdekatan dengan sangat baik sehingga banyak tim akhirnya memakai dua-duanya.
Kesimpulan
Kalau Anda developer yang membangun sesuatu yang harus hidup di dalam codebase, diskalakan ke ribuan halaman, atau menangani logika navigasi yang benar-benar kustom, Crawlee memberi Anda kontrol untuk mewujudkannya — dengan biaya waktu dan maintenance yang terus berjalan. Kalau Anda orang lain yang butuh data dari halaman web tanpa menulis kode, atau developer yang ingin mengekspos ekstraksi sebagai tool untuk AI agent tanpa membangun crawler dari nol, Thunderbit adalah jalur yang lebih cepat. Tidak ada satu tool pun yang "lebih baik" secara abstrak. Keduanya menyelesaikan masalah yang berbeda untuk orang yang berbeda, dan memilih yang salah untuk situasi Anda memang satu-satunya kesalahan yang perlu dihindari di sini.
FAQ
Apakah Crawlee sama dengan Apify? Tidak. Crawlee adalah pustaka crawling open-source yang dikelola oleh tim Apify. Apify adalah platform cloud terpisah yang bisa menjalankan dan menampung proyek berbasis Crawlee, bersama layanan lain seperti proxy dan penjadwalan. Keduanya saling terkait, tetapi merupakan produk yang berbeda dengan model harga yang berbeda.
Apakah Crawlee gratis? Library-nya sendiri gratis dan open-source (versi Python menggunakan Apache License 2.0). Biaya sebenarnya datang dari waktu developer, infrastruktur hosting, dan layanan proxy yang mungkin Anda butuhkan — bukan dari biaya lisensi.
Apakah Thunderbit mendukung akses API dan MCP untuk developer? Ya. Selain ekstensi browser, Thunderbit menawarkan Open API untuk akses programatik dan MCP Server yang memungkinkan AI host yang kompatibel memanggil tool ekstraksi Thunderbit secara langsung.
Mana yang lebih mudah untuk orang tanpa latar belakang coding? Thunderbit, tanpa ragu. Alur One Click Extract di ekstensi browser tidak membutuhkan kode, tidak perlu menulis selector, dan tidak perlu menyiapkan skema. Crawlee sejak awal mengasumsikan Anda menguasai JavaScript/TypeScript atau Python.
Tool mana yang memberi kontrol lebih besar atas perilaku crawler seperti retry dan proxy? Crawlee, jauh lebih besar. Ia mengekspos session pool, rotasi proxy, manajemen request queue, dan logika retry sebagai primitive yang bisa dikonfigurasi oleh developer. Thunderbit mengelola semua itu di sisinya, menukar kontrol manual tersebut dengan kesederhanaan dan kecepatan.




