
Saya sudah cukup sering lihat thread Slack tim engineering untuk tahu biasanya pertanyaan ini muncul dari mana: seseorang membagikan link daftar “web scraper terbaik”, lalu tiga engineer langsung balas, “kok Colly nggak disebut?” Itu bukan kebetulan. Saya meninjau empat artikel yang saat ini merangking untuk kata kunci “Thunderbit vs Colly”, dan semuanya membandingkan Thunderbit dengan alat no-code lain — Crawl4AI, Browse AI, rtrvr.ai, Chat4Data. Colly bahkan tidak muncul sekali pun.
Agak aneh juga, karena Colly punya basis pengguna yang nyata dan loyal di r/golang serta di tim-tim Go yang butuh crawler cepat yang kodenya mereka pegang sendiri. Jadi, inilah artikel yang benar-benar menjawab pertanyaannya — bukan artikel “perbandingan alat AI” yang cuma ganti judul lalu nama Colly ditempel di atas.
Jawaban Singkat
Kalau Anda lagi buru-buru di tengah rapat, ini versi singkatnya: Thunderbit adalah web scraper terkelola dan agentic yang tinggal klik lalu jalan — tanpa selector, tanpa coding, bisa dijalankan di browser atau cloud, plus Web App, Open API, MCP Server, dan CLI untuk developer yang ingin akses programatik. Colly adalah framework Go open-source — Anda yang menulis crawl-nya sendiri, Anda yang pegang logikanya, dan Anda juga yang mengatur concurrency.
Sebenarnya, keduanya bukan pesaing langsung dalam arti klasik. Yang satu adalah produk. Yang satu lagi library. Jadi, membandingkannya head-to-head baru masuk akal kalau Anda memang sedang di persimpangan jalan dan ingin tahu mana jalur yang paling cocok untuk kebutuhan nyata Anda — dan itu yang ingin saya bantu jelaskan.
Sekilas
| Dimensi | Thunderbit | Colly |
|---|---|---|
| Pengguna utama | Pengguna bisnis, tim operasional, developer yang butuh cepat | Developer Go |
| Setup | Klik One Click Extract di halaman | go get github.com/gocolly/colly + tulis kode Go |
| Waktu ke hasil pertama | Detik sampai menit, agen jalan otomatis | Tergantung seberapa cepat Anda menulis callback |
| Bahasa | Tidak perlu untuk penggunaan browser | Go |
| Model crawling | Analisis halaman secara agentic, kompatibel dengan pagination/subpage | Collector manual + callback OnHTML/OnResponse |
| Rendering | Browser terkelola / eksekusi cloud | Utamanya HTTP/HTML; situs berat JavaScript butuh tool tambahan |
| Aturan ekstraksi | Agen mengusulkan field, pengguna bisa menyempurnakan | Developer menulis CSS selector secara manual |
| Concurrency | Dikelola platform | Kontrol penuh lewat goroutine |
| Penyimpanan/ekspor | Ekspor ke spreadsheet, sheet, dan tujuan lain yang didukung | Dibangun sendiri oleh developer (file, database, Redis, dll.) |
| Deployment | Extension browser, Web App, API, MCP, CLI | Binary/script Go yang di-host sendiri |
| Maintenance | Logika ekstraksi dikelola; tetap bergantung pada kompatibilitas situs | Developer memperbaiki selector saat situs berubah |
| Lisensi/biaya | Paket berbasis credit (cek tier terkini di pricing) | Apache-2.0, gratis — tapi biaya infrastruktur/waktu dev tetap ada |
Apa Itu Thunderbit?
Workflow default Thunderbit memang benar-benar satu klik. Anda buka halaman yang memang berwenang Anda akses, tekan One Click Extract, lalu agen akan membaca halaman, mencari bagian yang layak diambil, dan mengusulkan field. Ada tombol Run Now, tapi jujur saja itu lebih mirip fitur tambahan untuk rasa aman — kalau Anda tidak mengubah apa pun, ekstraksi akan langsung berjalan sendiri. Tanpa menulis selector, tanpa setup schema, selama halaman itu didukung agen.
Setelah itu, Anda bisa menyempurnakan field kalau hasil usulan agen belum pas. Di situs yang kompatibel, Thunderbit juga bisa menelusuri pagination atau masuk ke subpage untuk enrichment — misalnya mengambil detail tambahan dari tiap halaman produk dalam sebuah daftar. Setelah data terkumpul, hasilnya bisa diekspor ke tujuan yang umum dipakai: Excel, Google Sheets, dan beberapa destinasi lain yang didukung.

Tapi extension browser itu cuma pintu depan. Kalau Anda developer, ada Open API untuk memicu ekstraksi dari kode Anda sendiri, MCP Server untuk menghubungkan ekstraksi ke Claude, Cursor, atau Windsurf sebagai tool yang bisa dipanggil, dan CLI untuk workflow terminal dan coding-agent. Saya sebutkan ini karena banyak framing “no-code vs code” memperlakukan Thunderbit seolah cuma alat untuk pengguna bisnis, padahal sekarang tidak sesempit itu lagi.
Apa Itu Colly?
Colly adalah library Go — titik. Tidak ada dashboard, tidak ada layanan hosted, tidak ada layer AI yang memutuskan apa yang harus di-scrape. Anda menulis Go, membuat Collector, lalu memasang callback seperti OnHTML dan OnResponse untuk memberi tahu persis apa yang harus dilakukan saat menyentuh sebuah halaman.
Kurang lebih begini bentuknya:
c := colly.NewCollector()

c.OnHTML("a[href]", func(e *colly.HTMLElement) {
    link := e.Attr("href")
    c.Visit(e.Request.AbsoluteURL(link))
})

c.OnResponse(func(r *colly.Response) {
    fmt.Println("Visited", r.Request.URL)
})

c.Visit("https://example.com")
Itulah model mentalnya: tentukan apa yang dicari, tentukan apa yang dilakukan saat ketemu, lalu biarkan collector melakukan crawling. Di baliknya, Anda dapat synchronous, asynchronous, dan parallel crawling, rate limiting per domain, penanganan cookie/session otomatis, caching request, kepatuhan terhadap robots.txt, rotasi proxy, serta backend penyimpanan yang bisa dipasang sesuai kebutuhan, termasuk Redis untuk setup terdistribusi.
Satu hal penting untuk jujur dari awal: Colly terutama adalah framework HTTP/HTML. Ia tidak menjalankan browser penuh seperti Playwright. Kalau target situs sangat bergantung pada rendering JavaScript, biasanya Anda harus mencari JSON API yang dipanggil situs itu, atau menggabungkan Colly dengan tool browser automation terpisah. Itu bukan kekurangan Colly — hanya filosofi desain yang berbeda dari produk yang benar-benar agentic dan sadar browser.
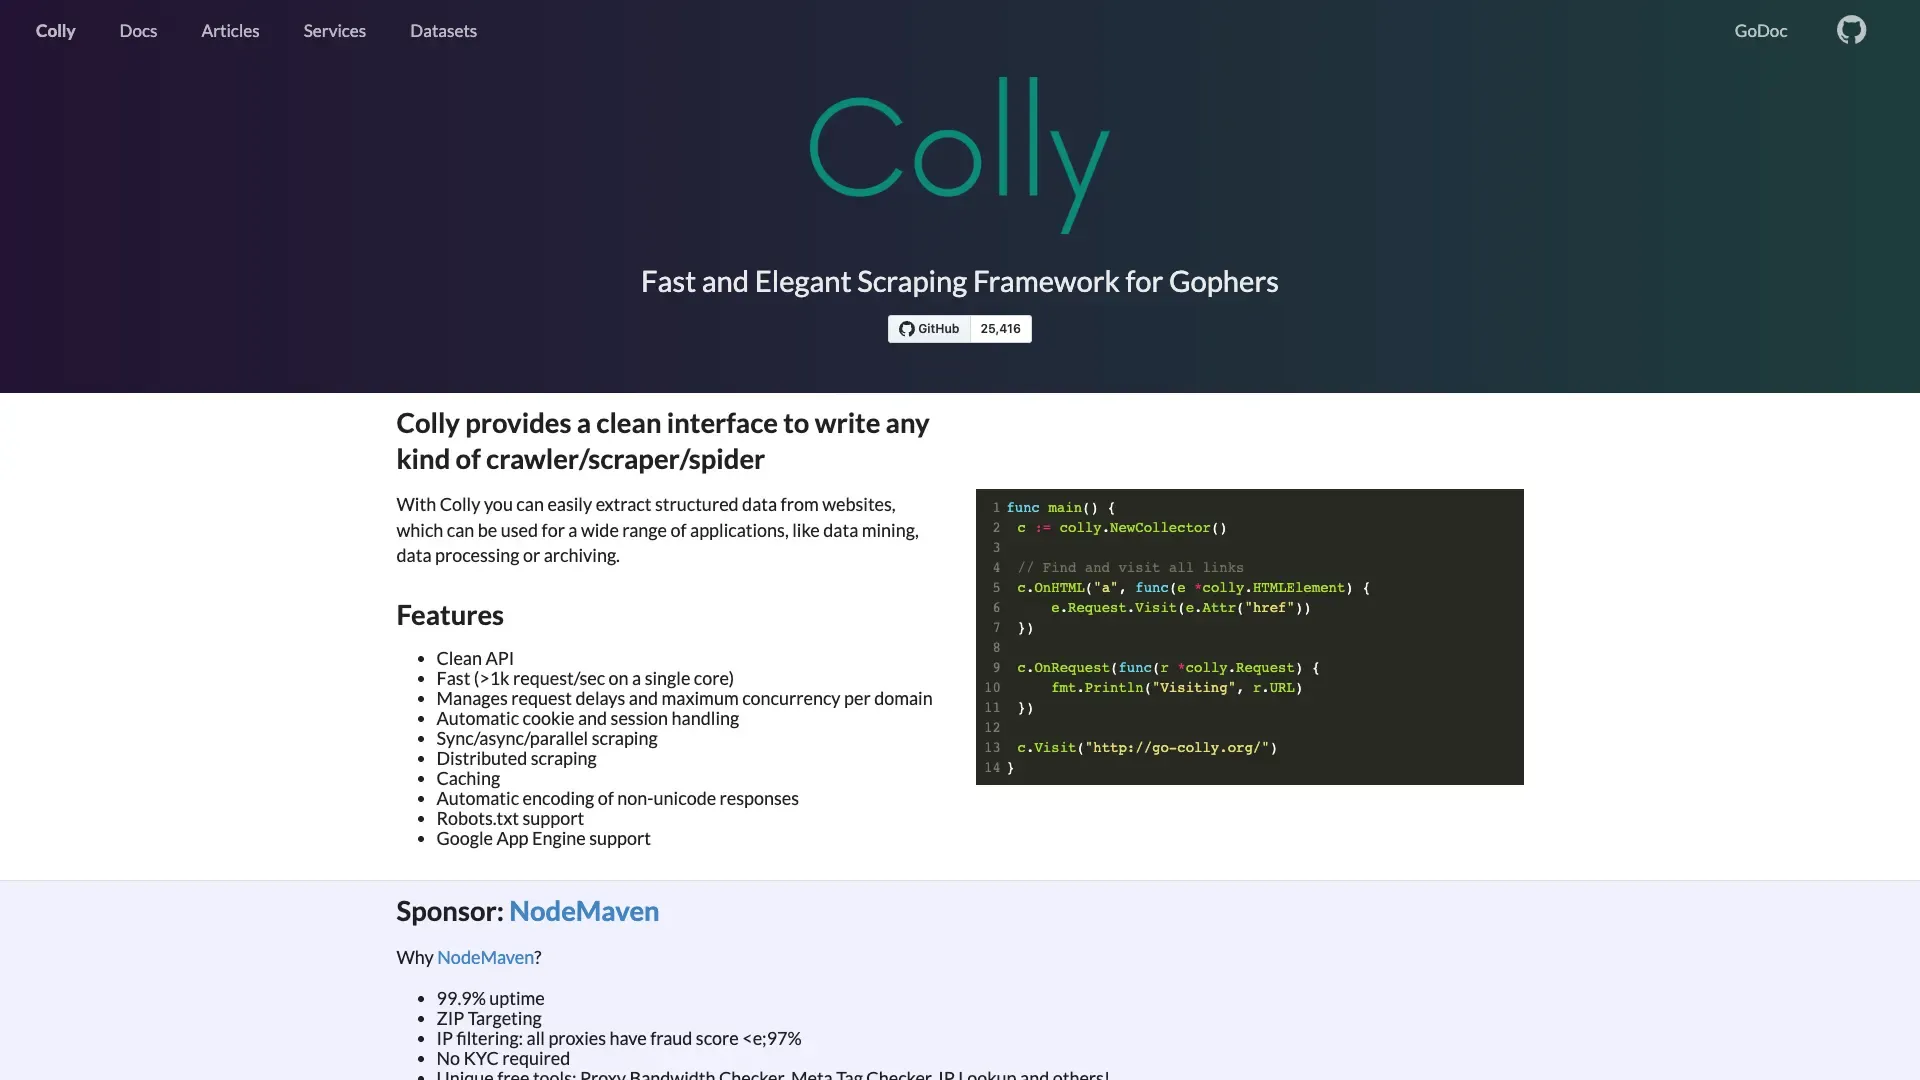
Perbedaan Inti: Ekstraksi Agentic Terkelola vs Framework Kode Go
Waktu ke tabel pertama
Di sini jaraknya paling terasa. Dengan Thunderbit, “waktu ke hasil pertama” dihitung dari seberapa lama Anda menekan tombol dan menunggu agen selesai membaca halaman — detik sampai beberapa menit, tergantung kompleksitas halaman. Dengan Colly, “waktu ke hasil pertama” mencakup menulis collector, mencari selector yang pas (biasanya lewat trial and error di dev tools), menangani logika pagination sendiri, lalu menjalankannya. Untuk tugas sekali pakai, itu biaya waktu yang nyata, bahkan buat developer Go yang sudah kompeten.
Performa dan kontrol
Colly menang dalam kontrol mentah, tidak ada debat soal itu. Karena Anda menulis logikanya sendiri, Anda menentukan berapa goroutine yang jalan bersamaan, seberapa agresif rate limiting-nya, apa yang di-cache, dan bagaimana error di-retry. Dokumentasi proyeknya sendiri menyebut lebih dari 1.000 request per detik pada satu core untuk target statis yang cocok — itu klaim benchmark Colly, bukan perbandingan terkontrol dengan Thunderbit, dan saya tidak akan pura-pura sebaliknya. Tapi ini memberi gambaran nyata: untuk target yang ramah HTTP, concurrency Go yang di-tuning manual memang sangat sulit dikalahkan.
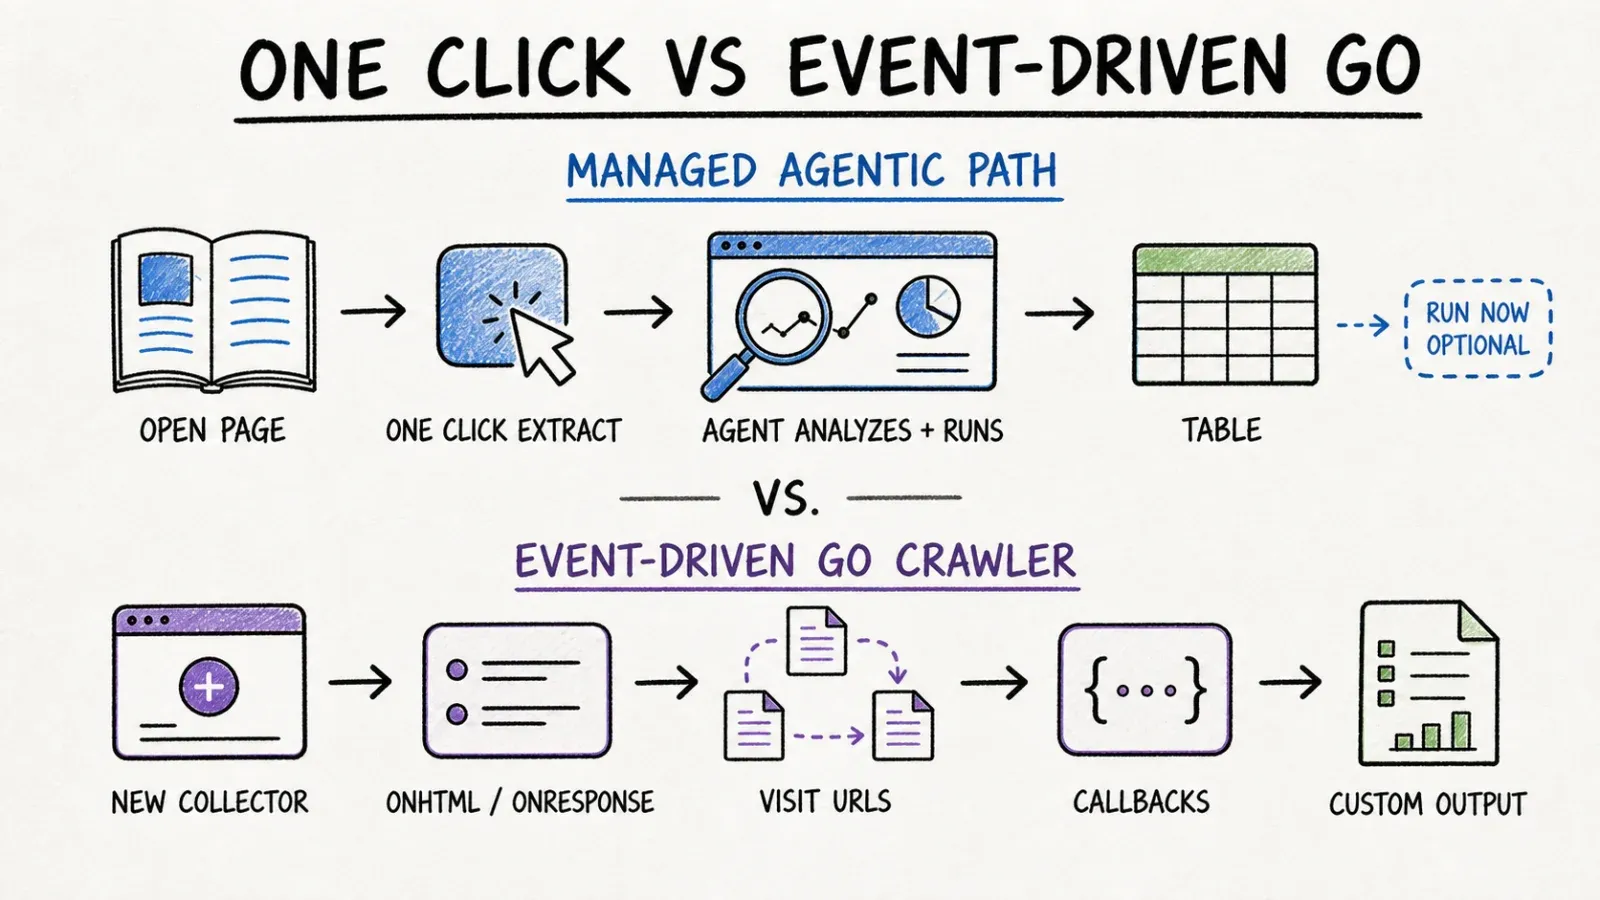
Thunderbit menukar kontrol detail itu dengan eksekusi terkelola. Anda tidak mengatur pool goroutine — Anda mengandalkan browser dan jalur eksekusi cloud milik platform, plus scheduled extraction kalau paket Anda mendukungnya. Itu pilihan yang tepat kalau Anda tidak mau memikul keputusan infrastruktur, dan pilihan yang kurang pas kalau tugas Anda memang harus memeras throughput maksimal dari crawler.
Kepemilikan deployment dan maintenance
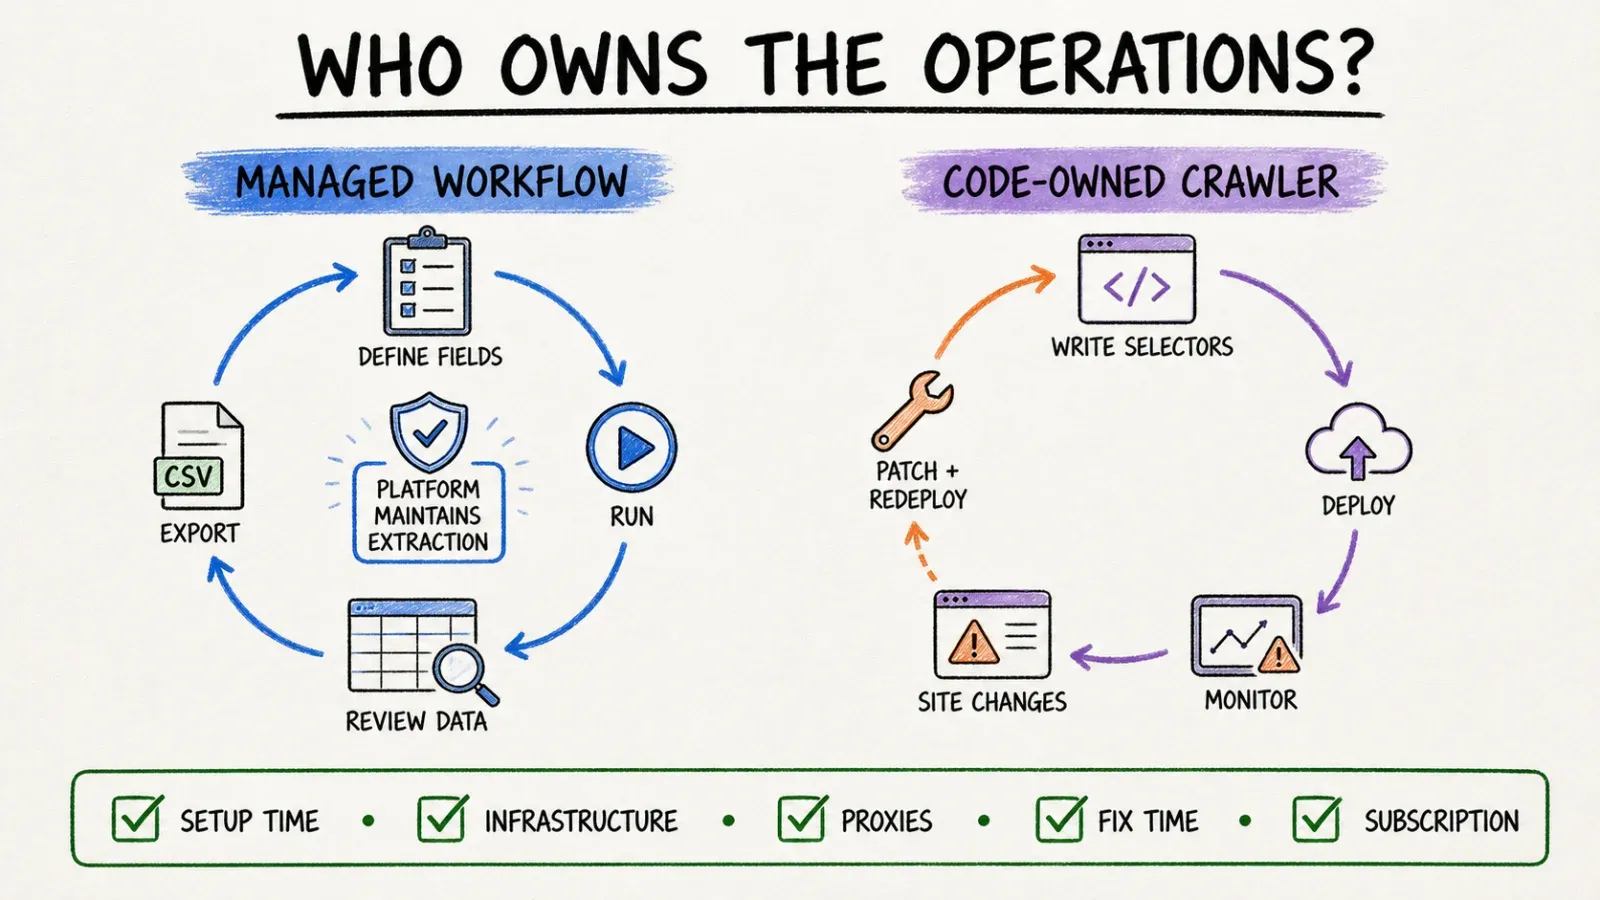
Ini bagian yang sering kurang dibahas. Colly “gratis” dalam arti lisensi Apache-2.0 tidak memungut biaya. Tapi tetap ada orang yang harus menulis, meng-host, memantau, dan — yang paling penting — memperbaikinya saat situs target mengubah HTML. Selector bisa rusak tanpa peringatan. Tidak ada notifikasi yang bilang, “hei, situs ini baru saja redesain halaman produknya.” Developer harus sadar pipeline mendadak diam atau mulai mengembalikan sampah, lalu memperbaikinya.
Dengan Thunderbit, logika ekstraksi dikelola oleh platform, dan analisis halaman secara agentic dirancang untuk menyesuaikan variasi layout pada halaman yang didukung dan memang Anda berwenang akses. Tapi saya mau hati-hati di sini — itu bukan jaminan mutlak. Halaman dengan perlindungan anti-bot yang kuat, konten yang terkunci login di luar akses yang diizinkan, atau situs yang memang kurang cocok ditangani agen adalah batasan nyata. Cara pandang yang jujur: dengan Colly, perbaikannya selalu ada di tangan Anda. Dengan Thunderbit, bebannya lebih ringan, tapi “lebih ringan” bukan berarti “nol” — hasil tetap bergantung pada apakah halaman target memang didukung Thunderbit dengan baik.
Skenario Praktis
Ekstraksi direktori/produk satu kali
Misalnya Anda perlu tabel berisi 200 produk dari halaman katalog kompetitor sebelum jam kerja selesai, dan Anda bukan developer (atau Anda developer, tapi punya hal yang lebih penting untuk dikerjakan). Ini wilayah Thunderbit — klik, biarkan agen mengusulkan field, rapikan kalau perlu, lalu ekspor ke Sheets. Menulis skrip Colly untuk ekstraksi sekali pakai memang bisa, tapi rasanya seperti memakai chainsaw untuk memangkas bonsai.
Custom Go crawler dengan throughput tinggi
Sekarang kebalik: Anda sedang membangun pipeline monitoring yang memanggil ribuan URL per hari, stack Anda sudah berbasis Go, dan Anda butuh kontrol presisi atas retry logic, penyimpanan terdistribusi lewat Redis, serta rate limit per domain yang disetel supaya tidak kena blokir. Ini jelas wilayah Colly. Anda tidak membayar subscription, Anda memiliki setiap baris logika, dan Anda bisa mengoptimalkan pola trafik spesifik Anda dengan cara yang memang tidak dirancang untuk diekspos oleh produk terkelola.
Target yang berat di JavaScript
Kalau situs target merender semuanya di sisi klien dengan JS yang berat, Colly saja kemungkinan bukan jawaban Anda — Anda akan mencari trik lewat JSON API yang dipanggilnya atau menambahkan layer browser automation terpisah. Jalur eksekusi browser/cloud terkelola Thunderbit dibangun dengan tipe halaman seperti ini dalam pikiran, walau tetap — uji kompatibilitas pada target Anda sendiri sebelum menganggapnya pasti langsung jalan.
Integrasi API atau AI agent
Sedang membangun tool internal di mana AI agent (misalnya yang berjalan di Claude atau Cursor) perlu menarik data terstruktur sebagai bagian dari workflow yang lebih besar? Di sini MCP Server milik Thunderbit jadi sangat berguna — ia mengekspos ekstraksi sebagai tool yang bisa dipanggil di dalam workflow agent, use case yang memang tidak dilayani Colly secara native karena Colly adalah library mandiri, bukan sesuatu yang bisa dipanggil AI agent sebagai tool secara bawaan.
Keandalan, Skala, dan Maintenance
Saya ingin memisahkan dua hal yang sering dicampur: throughput mentah dan tingkat keberhasilan total di situs web nyata. Colly bisa bergerak cepat pada halaman statis yang ramah HTTP — memang itulah desain utamanya. Tapi “cepat” tidak otomatis berarti “masih jalan tiga bulan lagi” saat situs target melakukan redesign. Setiap selector yang Anda tulis sekarang berpotensi usang, dan tidak ada yang memberi tahu sampai pipeline data Anda diam-diam mulai mengembalikan null.
Pendekatan agentic Thunderbit berarti Anda tidak perlu memelihara selector sendiri — tapi saya juga akan menolak framing apa pun, termasuk dari marketing Thunderbit sendiri kalau jujur, yang seolah menjanjikan reliabilitas universal di semua situs, terutama situs dengan proteksi anti-bot agresif atau konten yang berada di balik autentikasi yang tidak Anda berwenang akses. Kalau Anda mengevaluasi salah satu tool ini, pertanyaan yang lebih penting adalah “siapa yang memperbaikinya saat rusak, dan berapa lama waktunya” — bukan cuma “seberapa cepat di hari pertama.”
Harga, Lisensi, dan Total Biaya
Colly adalah open-source di bawah Apache 2.0 — library-nya gratis. Tapi total biaya kepemilikan mencakup jam kerja developer untuk menulis dan debug crawler, komputasi untuk menjalankannya, biaya proxy kalau Anda perlu rotasi IP, dan waktu berkelanjutan setiap kali situs target berubah lalu mematahkan selector Anda. Untuk tim yang sudah fasih Go, ini bisa benar-benar murah pada skala besar. Untuk tim yang tidak punya keahlian itu, “gratis” cepat berubah jadi “mahal dengan cara yang tersembunyi.”
Thunderbit berjalan dengan paket berbasis credit — cek halaman pricing terbaru karena tier dan jumlah credit itu bisa berubah, dan saya lebih memilih mengarahkan Anda ke sumber aslinya daripada menyebut angka yang sudah basi saat Anda membacanya. Trade-off-nya, Anda membayar untuk lebih sedikit pekerjaan maintenance langsung pada halaman yang didukung, bukan tanpa maintenance sama sekali di semua situasi.
Kalau Anda ingin kerangka pikir yang jujur, buat tabel kasar untuk kondisi Anda sendiri: waktu setup, biaya infra/proxy, waktu perbaikan berkelanjutan, dan biaya subscription. Mana pun yang unggul di tabel itu untuk skill dan beban kerja tim Anda — itulah jawabannya, bukan sekadar opini umum “open source lebih murah.”
Siapa yang Sebaiknya Memilih Thunderbit?
Kalau Anda pengguna bisnis, orang ops, atau anggota tim growth yang butuh data terstruktur sekarang juga dan tidak mau menyentuh kode, extension browser Thunderbit adalah pilihan yang paling jelas. Kalau Anda developer yang ingin menjadikan ekstraksi sebagai building block — lewat API, CLI, atau di dalam workflow AI agent via MCP — Thunderbit juga cocok, hanya lewat pintu yang berbeda dari cara klik-and-go.
Siapa yang Sebaiknya Memilih Colly?
Kalau Anda developer Go (atau tim Anda Go-first) dan Anda butuh crawler custom ber-throughput tinggi yang memberi Anda kontrol atas setiap request, setiap retry, setiap rotasi proxy — Colly memang dibangun untuk pekerjaan itu. Ini juga pilihan yang tepat kalau Anda memang ingin memiliki kode sepenuhnya tanpa ketergantungan subscription, dan Anda punya kapasitas engineering untuk merawatnya.
Bisakah Tim Menggunakan Keduanya?
Jujur saja, bisa, dan saya rasa itu bukan jawaban ngeles. Sangat umum bagi tim engineering menjalankan crawler Colly yang tahan lama dan berskala besar untuk pipeline data inti, sementara tim lain — sales, ops, marketing — memakai Thunderbit untuk ekstraksi ad hoc yang tidak layak dibuatkan dan dipelihara skrip sendiri. Saya tidak akan mengarang integrasi “resmi” antara keduanya di sini — setahu saya memang tidak ada — tetapi secara arsitektur, tidak ada yang menghalangi kedua tool ini hidup dalam organisasi yang sama untuk menyelesaikan masalah yang berbeda.
Kesimpulan
Pilih berdasarkan siapa yang mengerjakan dan apa yang sedang dioptimalkan. Kalau Anda punya skill Go, butuh logika kustom, dan ingin memiliki maintenance-nya dengan imbalan kontrol penuh serta tanpa biaya subscription, Colly adalah tool yang tepat. Kalau Anda ingin data cepat, tidak mau menulis atau memelihara kode, dan bersedia menukar sebagian kontrol low-level demi pengalaman terkelola — termasuk opsi menghubungkan ekstraksi ke API atau AI agent — Thunderbit lebih cocok. Tidak ada yang “lebih baik” secara absolut; keduanya dibuat untuk orang yang berbeda dan masalah yang berbeda.
FAQ
Apakah Colly gratis?
Ya — Colly adalah open-source di bawah lisensi Apache 2.0, jadi library-nya tidak berbiaya. Biaya sebenarnya datang dari waktu developer, hosting, proxy kalau diperlukan, dan maintenance berkelanjutan saat situs target berubah.
Apakah Colly bisa merender JavaScript?
Tidak secara native. Colly utamanya adalah framework HTTP/HTML, jadi situs yang berat JavaScript biasanya memerlukan pencarian JSON API yang dipanggil halaman tersebut, atau menggabungkan Colly dengan tool browser automation terpisah.
Apakah Thunderbit mendukung akses API dan MCP untuk developer?
Ya. Thunderbit menyediakan Open API untuk ekstraksi programatik dan MCP Server yang mengekspos ekstraksi sebagai tool yang bisa dipanggil di dalam workflow AI agent yang kompatibel seperti Claude, Cursor, atau Windsurf.
Mana yang lebih cepat untuk mulai dipakai?
Thunderbit, memang sengaja begitu — alur One Click Extract di extension browser memberi Anda hasil dalam hitungan detik sampai menit tanpa kode. Colly mengharuskan Anda menulis dan menguji kode Go sebelum hasil pertama muncul.
Mana yang memberi kontrol low-level lebih besar atas proses crawl?
Colly, tanpa ragu. Anda mengontrol concurrency lewat goroutine, rate limiting request, caching, rotasi proxy, dan backend penyimpanan langsung di dalam kode — tingkat tuning yang memang tidak diekspos oleh produk terkelola seperti Thunderbit secara desain.




