
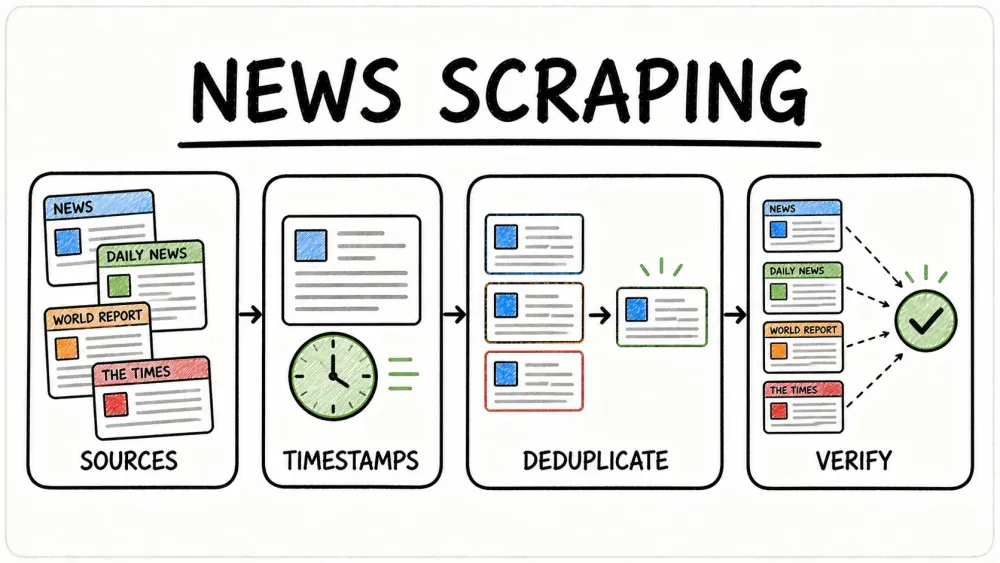
Kecepatan berita digital saat ini benar-benar gila. Setiap menit, ribuan judul berita dipublikasikan, diperbarui, atau diam-diam diedit—di media arus utama, blog niche, sampai feed media sosial.
Sebagai gambaran, LexisNexis Newsdesk memproses lebih dari 4 juta artikel berita setiap hari, sementara GDELT Project melacak berita dalam 100+ bahasa dan memperbarui feed globalnya setiap 15 menit.
Bagi siapa pun yang bekerja di media, riset, atau business intelligence, mengikuti arus informasi sebesar ini secara manual rasanya seperti menimba kapal bocor pakai cangkir kopi.
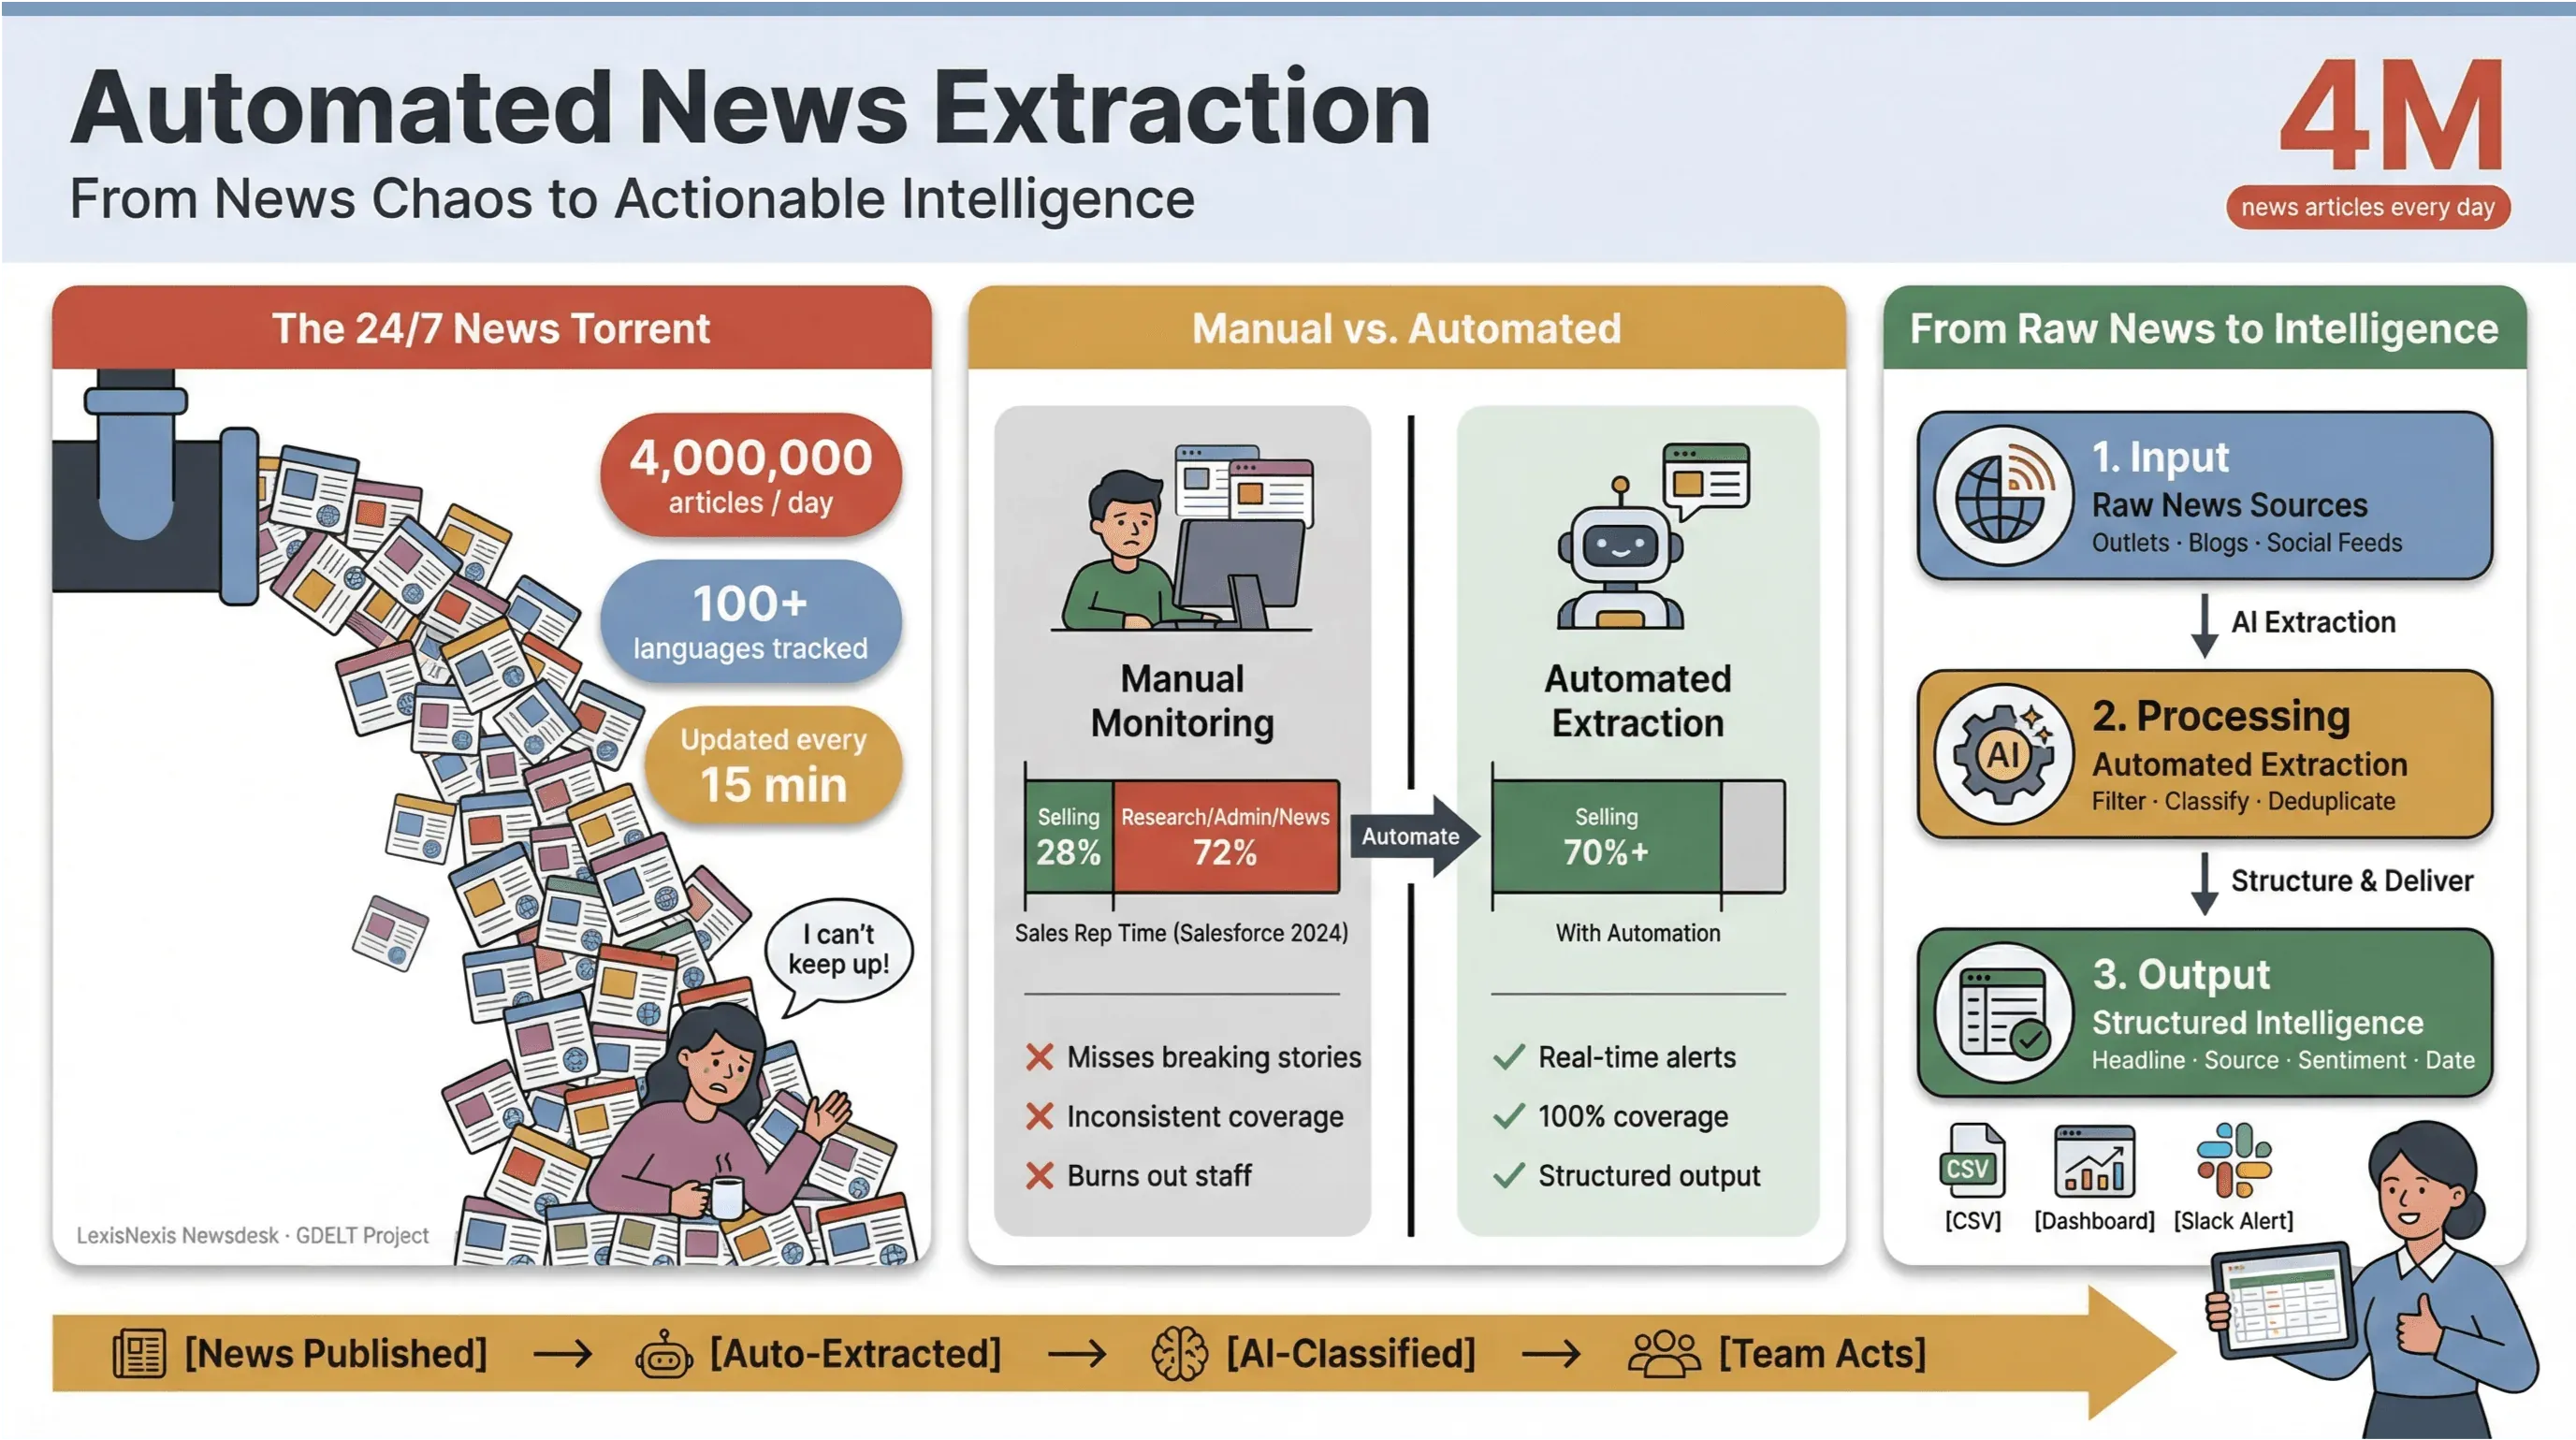
Saya sudah melihat sendiri bagaimana pemantauan berita manual bisa menghabiskan waktu dan menguras energi. Tim sales menghabiskan kurang dari sepertiga minggu kerja mereka untuk benar-benar menjual—hanya 28% menurut Salesforce—sementara sisanya habis untuk riset, administrasi, dan ya, bolak-balik buka banyak tab berita tanpa henti.
Itulah mengapa ekstraksi berita otomatis jadi senjata rahasia bagi tim modern: satu-satunya cara untuk mengubah kekacauan siklus berita 24/7 menjadi intelijen yang terstruktur dan bisa ditindaklanjuti—tanpa bikin tim kelelahan atau melewatkan cerita yang paling penting.
Mari kita bahas apa sebenarnya yang dimaksud dengan ekstraksi berita otomatis, mengapa ini penting bagi siapa pun yang peduli pada data berita real-time, dan bagaimana membangun alur kerja yang kuat serta patuh aturan menggunakan alat terbaik (termasuk bagaimana Thunderbit membuat seluruh proses ini jadi super mudah—even untuk orang non-teknis seperti ibu saya).
Coba Thunderbit untuk Ekstraksi Berita Otomatis Judul, waktu publikasi, penulis, dan ringkasan dari halaman berita apa pun — klik sekali lalu jadwalkan pengulangan. Get Started Free
Ekstraksi Berita Otomatis: Mengapa Ini Penting untuk Ruang Redaksi Modern
Ekstraksi berita otomatis persis seperti namanya: menggunakan perangkat lunak untuk mengumpulkan konten berita secara otomatis lalu mengubahnya menjadi data terstruktur yang gampang dicari—bayangkan baris dan kolom, bukan halaman web atau PDF yang berantakan. Dalam praktiknya, ini berarti Anda bisa memantau ratusan (bahkan ribuan) sumber, mengekstrak field penting seperti judul, waktu publikasi, penulis, dan isi artikel, lalu mengalirkan data itu ke dashboard, alert, atau analitik lanjutan—tanpa perlu menyentuh Ctrl+C/Ctrl+V.
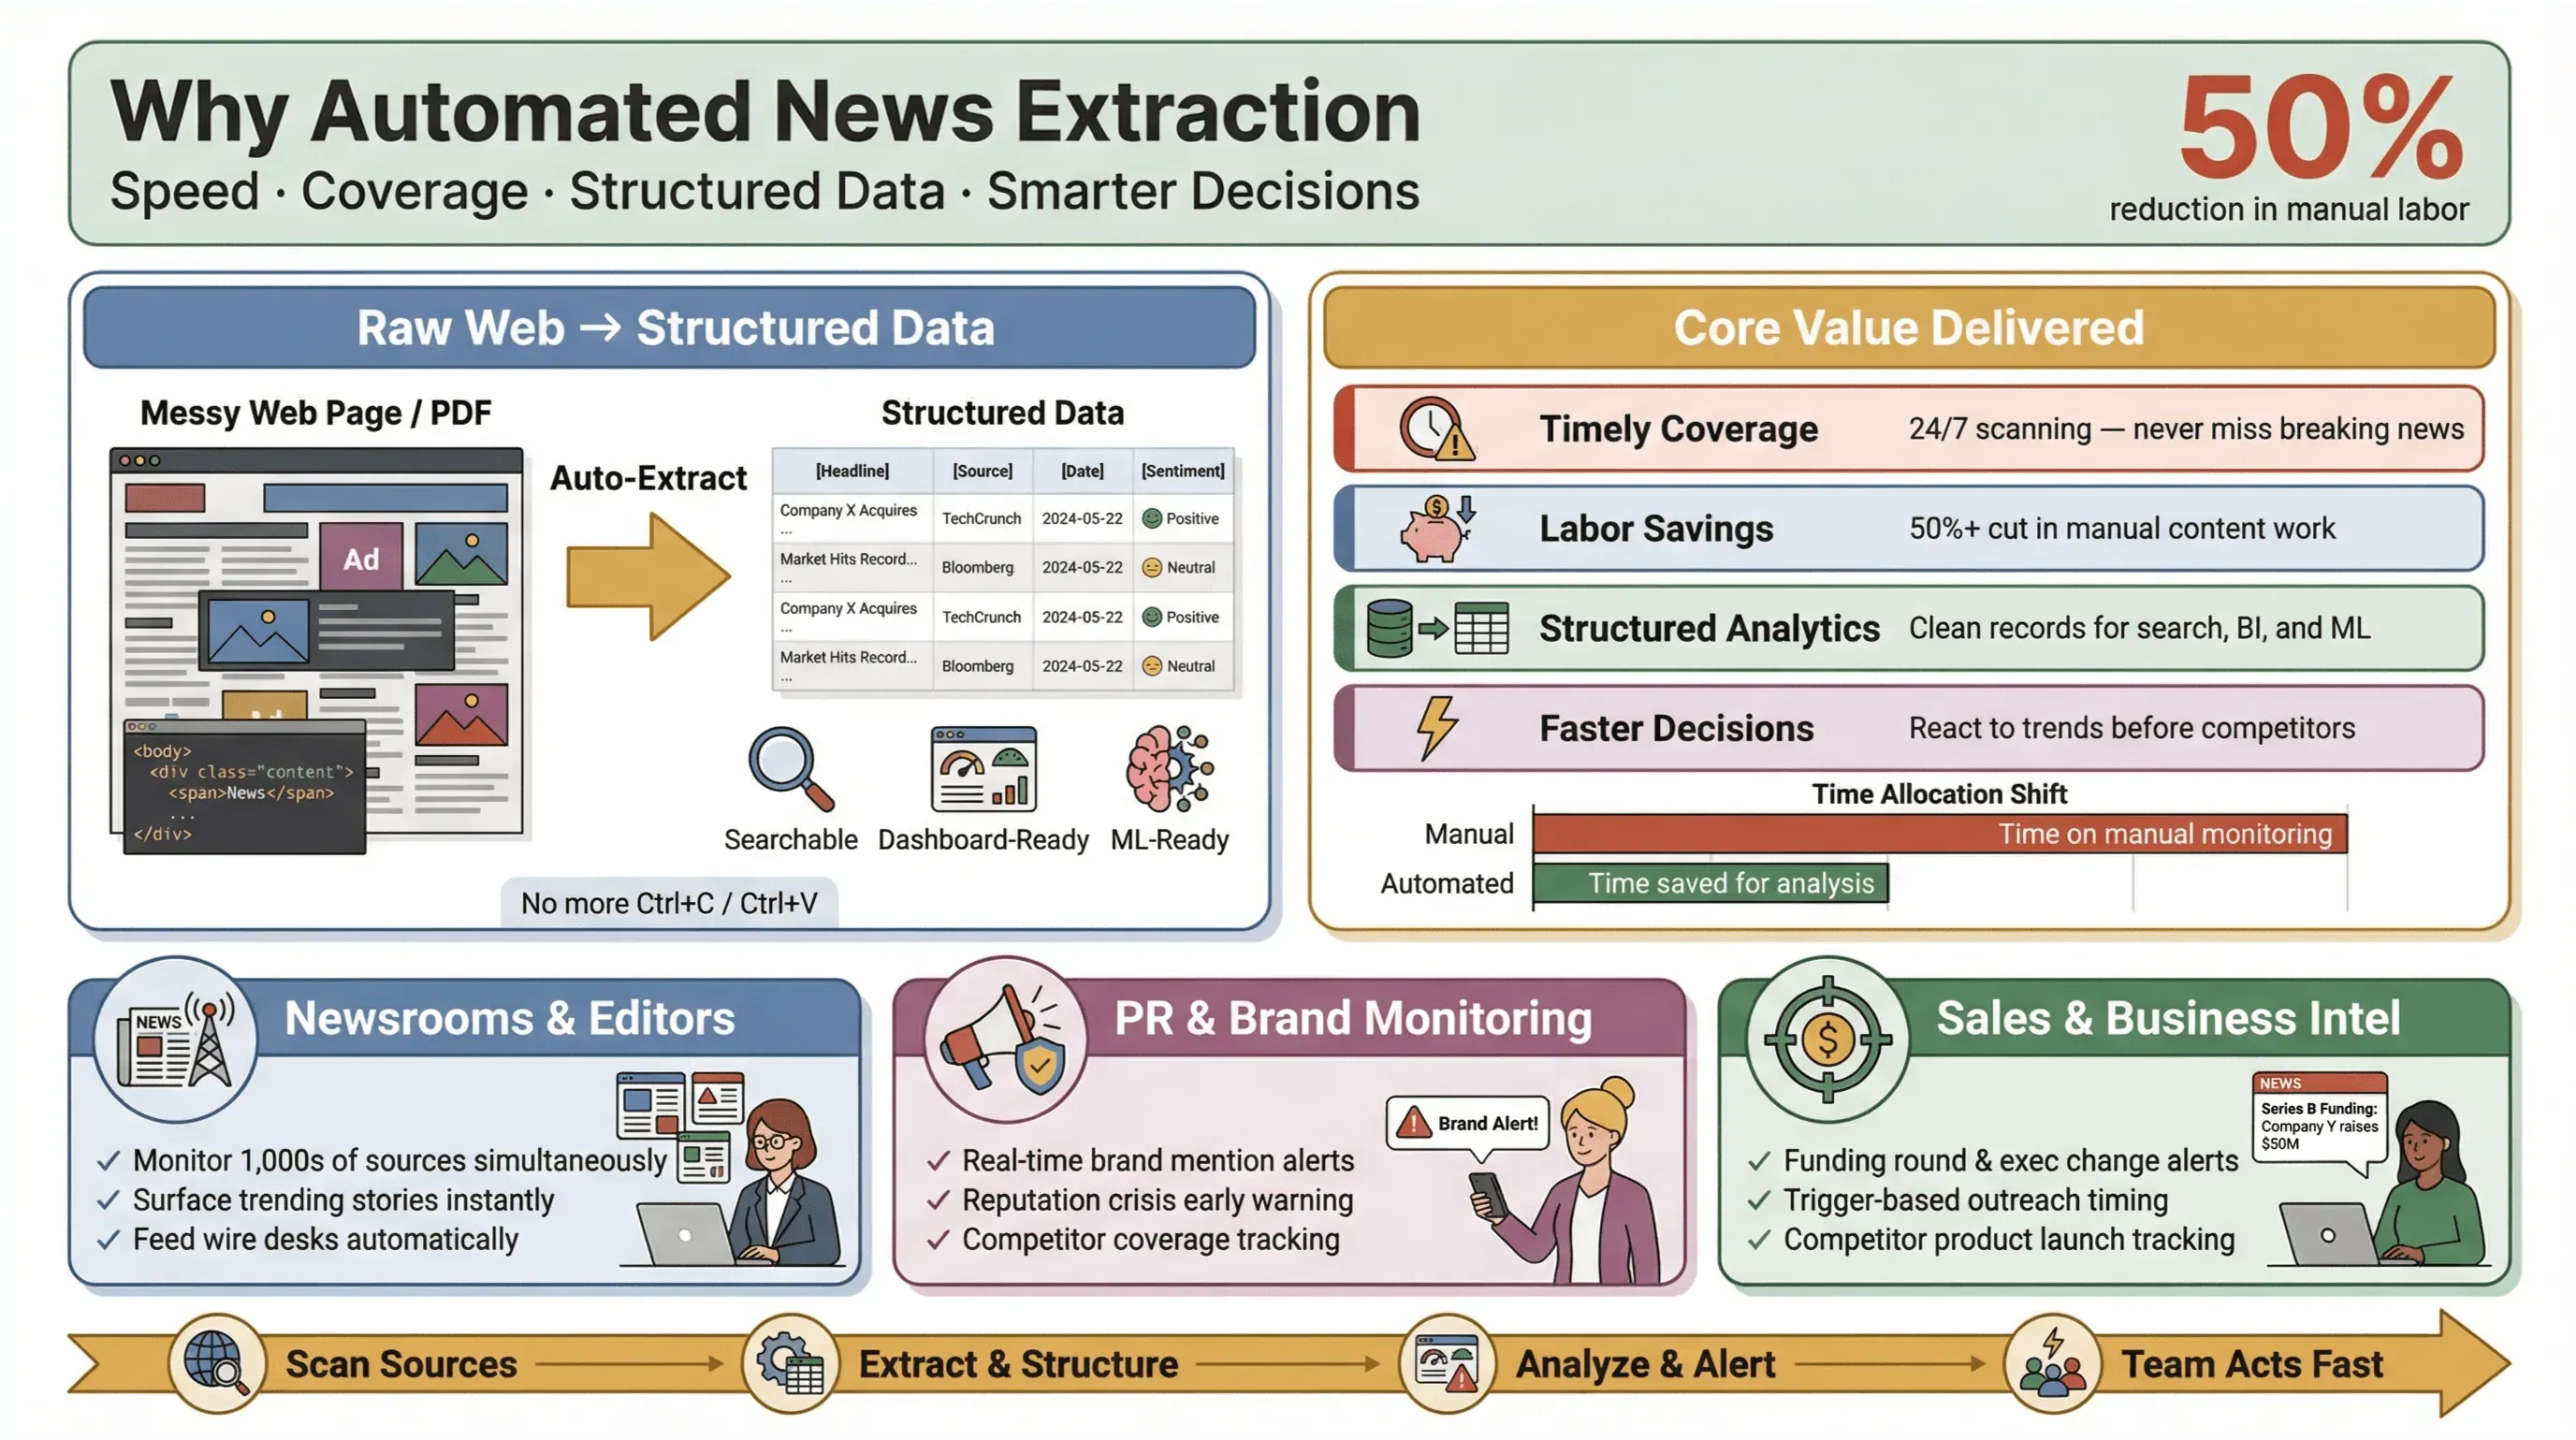 Mengapa ini penting? Karena di lanskap berita saat ini, kecepatan adalah segalanya. Baik Anda editor newsroom, manajer PR yang memantau penyebutan merek, maupun analis bisnis yang melacak gerakan kompetitor, jadi yang pertama tahu bisa menentukan apakah Anda menangkap peluang atau justru tertinggal. Alat ekstraksi otomatis memungkinkan tim kecil pun tampil sekelas tim besar—mengumpulkan data berita real-time dari seluruh web, mengurangi beban kerja manual, dan menampilkan cerita yang paling relevan.
Dampaknya juga nyata: studi menunjukkan otomatisasi dapat memangkas kerja manual untuk pembaruan konten hingga setidaknya 50%, sehingga waktu lebih banyak tersedia untuk analisis dan pengambilan keputusan.
Nilai Utama Ekstraksi Berita Otomatis di Industri Media
Mari kita lihat lebih praktis. Sebenarnya apa yang diberikan ekstraksi berita otomatis kepada newsroom dan tim bisnis?
- Cakupan yang cepat dan menyeluruh: Tidak ada lagi cerita penting yang kelewat hanya karena seseorang lupa cek feed.
- Hemat tenaga dan biaya: Tim kecil sampai menengah bisa memantau sebanyak sumber yang dipantau perusahaan besar—tanpa harus merekrut banyak intern.
- Data terstruktur untuk analitik: Alih-alih memilah artikel yang tidak terstruktur, Anda dapat catatan rapi yang siap dipakai untuk pencarian, dashboard, dan machine learning.
- Keputusan lebih cepat dan cerdas: Data berita real-time memungkinkan Anda bereaksi terhadap perubahan pasar, krisis PR, atau tren baru sebelum kompetitor.
Ambil contoh PR dan komunikasi: platform seperti Cision dan Meltwater menempatkan pemantauan media real-time sebagai hal penting untuk menjaga reputasi dan merespons cepat pemberitaan yang merugikan. Dalam sales, alert berita real-time bisa jadi “context card” untuk prospecting—misalnya putaran pendanaan, pergantian eksekutif, atau peluncuran produk yang memicu outreach di momen yang pas.
Memilih Alat Web Scraping Berita yang Tepat untuk Berbagai Skenario
Tidak semua alat scraping berita dibuat sama. Pilihan yang tepat bergantung pada tujuan, tingkat kenyamanan teknis, dan jenis berita yang ingin Anda pantau. Berikut kerangka sederhana untuk membantu memilih yang paling cocok:
- Menilai Kemudahan Penggunaan dan Aksesibilitas
- Pertimbangan Keamanan dan Privasi Data
- Menyesuaikan Alat dengan Jenis Berita dan Kebutuhan Industri
Menilai Kemudahan Penggunaan dan Aksesibilitas
Bagi kebanyakan pengguna bisnis dan jurnalis, kemudahan penggunaan itu wajib. Anda butuh alat yang langsung bisa dipakai, tanpa coding atau setting yang ribet. Platform no-code dan low-code seperti Thunderbit, Octoparse, dan ParseHub memungkinkan Anda membangun scraper secara visual—tinggal arahkan, klik, lalu ekstrak.
Thunderbit, khususnya, menonjol berkat alur satu klik: klik One Click Extract dan AI akan membaca halaman, mengenali field yang dibutuhkan, lalu menarik datanya. Bahkan pengguna non-teknis pun bisa menyiapkan pipeline data berita dalam hitungan menit, bukan jam.
Pertimbangan Keamanan dan Privasi Data
Semakin besar data, semakin besar juga tanggung jawabnya. Alat scraping berita sering mengakses konten sensitif, jadi keamanan dan kepatuhan harus jadi prioritas. Perhatikan hal berikut:
- Enkripsi data (saat dikirim maupun disimpan)
- Kebijakan privasi yang jelas (misalnya Thunderbit menyatakan tidak menjual data pengguna dan hanya mengakses konten yang Anda pilih untuk di-scrape)
- Izin akses yang granular (terutama untuk ekstensi browser—selalu cek data apa saja yang bisa diakses alat tersebut)
- Kepatuhan terhadap hukum setempat (GDPR, CCPA, dan bagi pengguna UE, DSM Copyright Directive)
Supaya lebih tenang, pilih vendor bereputasi baik, verifikasi izin ekstensi, dan batasi akses hanya pada data yang benar-benar dibutuhkan.
Menyesuaikan Alat dengan Jenis Berita dan Kebutuhan Industri
Beberapa alat unggul di domain berita tertentu:
- Keuangan: API seperti News API dan AYLIEN menyediakan clustering, sentiment, dan deteksi peristiwa untuk berita finansial.
- Tech & Startup: Scraping kustom dengan Thunderbit atau Octoparse membantu menargetkan blog niche, rilis pers, atau daftar acara.
- Politik & Kebijakan: Basis data berlisensi seperti Factiva dan LexisNexis menyediakan akses ke sumber premium dan arsip.
Kalau Anda perlu memantau campuran sumber arus utama, niche, dan internasional—termasuk yang tidak punya API—scraper berbasis AI yang fleksibel seperti Thunderbit adalah pilihan terbaik.
Keunggulan Unik Thunderbit untuk Ekstraksi Data Berita Real-Time
Scrape data berita real-time dengan Thunderbit AI membaca halaman dan mengenali field yang dibutuhkan — tanpa repot maintenance selector saat publisher mengubah desain. Get Started Free
Sekarang, mari kita bahas apa yang membuat Thunderbit menonjol untuk ekstraksi berita otomatis—terutama kalau Anda menginginkan data berita real-time tanpa pusing teknis.
Thunderbit adalah ekstensi Chrome AI web scraper yang dirancang untuk pengguna bisnis, jurnalis, dan analis yang membutuhkan konten berita terstruktur dan selalu terbaru dari situs mana pun. Inilah alasan mengapa alat ini jadi andalan saya:
- One Click Extract: Thunderbit membaca halaman berita dan menentukan kolom terbaik untuk diekstrak—judul, waktu publikasi, penulis, ringkasan, dan lainnya. Tidak perlu repot dengan selector atau template.
- Subpage Scraping: Butuh isi artikel lengkap, bukan cuma judul? Thunderbit bisa membuka setiap tautan berita, mengekstrak isi artikel, entitas, dan tag, lalu menggabungkannya ke dalam satu tabel terstruktur.
- Bulk Export & Instant Updates: Ekspor data berita langsung ke Excel, Google Sheets, Airtable, atau Notion dengan sekali klik. Tidak ada lagi maraton copy-paste atau ribet mengolah CSV.
- Scheduled Scraping: Atur pekerjaan berulang (per jam, harian, atau interval khusus) supaya pipeline berita tetap segar—ideal untuk breaking news, pemantauan pasar, atau riset berkelanjutan.
- Adaptability: AI Thunderbit menyesuaikan diri dengan perubahan layout dan situs berita long-tail, jadi Anda menghabiskan lebih sedikit waktu memperbaiki scraper yang rusak dan lebih banyak waktu menganalisis data.
Dengan 100,000+ pengguna di Chrome Web Store, Thunderbit dipakai oleh tim PR, peneliti sales, dan analis yang membutuhkan data berita tanpa harus terus-menerus menjaga scraper tetap hidup.
Deteksi Field Berbasis AI dan Subpage Scraping
Salah satu fitur andalan Thunderbit adalah deteksi field berbasis AI. Cukup klik “One Click Extract,” lalu alat ini akan memindai halaman berita—mengidentifikasi field penting seperti judul, tanggal, penulis, dan ringkasan. Anda bisa menyesuaikan atau menambahkan field khusus (misalnya, “beri tag artikel ini sebagai ‘earnings’ jika menyebut hasil kuartalan”), lalu AI Thunderbit akan mengurus sisanya.
Subpage scraping adalah game changer untuk berita: scrape halaman utama atau daftar kategori untuk mendapatkan judul, lalu biarkan Thunderbit membuka setiap URL artikel untuk mengekstrak cerita lengkap, entitas, bahkan gambar. Hasilnya, Anda mendapatkan catatan berita yang lengkap dan diperkaya—siap untuk pencarian, dashboard, atau analisis AI lanjutan.
Bulk Export dan Pembaruan Instan
Thunderbit membuat ekspor data berita jadi super gampang. Dengan satu klik, Anda bisa mengirim feed berita terstruktur ke Google Sheets, Airtable, Notion, atau mengunduhnya sebagai CSV/Excel. Bagi tim yang hidup di spreadsheet atau alat BI, ini benar-benar menghemat banyak waktu.
Dan karena Thunderbit mendukung scheduled scraping, Anda bisa mengaturnya berjalan setiap jam, setiap hari, atau mengikuti jadwal khusus Anda—jadi data berita selalu up to date. Tidak perlu lagi menunggu Google Alerts mengindeks berita beberapa hari terlambat.
Mengatasi Tantangan Operasional dalam Solusi Data Berita Real-Time
Bahkan dengan alat terbaik sekalipun, ekstraksi berita real-time tetap punya tantangannya sendiri. Berikut cara mengatasi yang paling umum:
Mengelola Latensi dan Kesegaran Data
- Jadwalkan scraping berdasarkan kecepatan berita: Untuk breaking news, atur scraper berjalan setiap 15–30 menit (selaras dengan siklus pembaruan GDELT Project). Untuk berita yang lebih lambat, harian atau per jam mungkin sudah cukup.
- Pantau jeda antara waktu publikasi dan waktu pengambilan: Lacak selisih antara kapan artikel terbit dan kapan sistem Anda mengambilnya. Kalau jedanya makin besar, cek kemungkinan blok atau pelambatan.
- Scrape ulang untuk “quiet edits”: Artikel berita sering diperbarui setelah terbit. Jadwalkan scraping kedua 24 jam kemudian untuk menangkap koreksi atau edit diam-diam (GDELT melakukannya secara desain).
Menangani Batas API dan Variasi Sumber
- Patuhi kuota API: Kalau Anda menggunakan API berita, perhatikan rate limit—sebarkan permintaan sepanjang waktu, dan simpan cache hasil bila memungkinkan (dokumentasi News API).
- Hilangkan duplikat dan gunakan canonical URL: Cerita berita sering muncul di banyak URL atau diperbarui. Simpan canonical URL dan gunakan hash (misalnya judul + tanggal) untuk menghindari duplikasi (panduan canonicalization Google).
- Tangani konten dinamis: Untuk situs dengan infinite scroll atau lazy loading, gunakan alat yang mendukung dynamic rendering dan pantau perubahan layout (panduan Octoparse).
Analisis Data Berita yang Cerdas: Peran AI dan Machine Learning
Menarik berita cuma langkah pertama. Nilai sebenarnya datang dari menganalisis dan bertindak berdasarkan data tersebut—dan di sinilah AI serta machine learning benar-benar bersinar.
- Entity extraction: Gunakan NLP untuk menarik nama orang, organisasi, dan tempat yang disebut dalam tiap artikel (panduan Google Cloud).
- Topic classification: Tandai artikel secara otomatis berdasarkan topik, sentimen, atau tingkat urgensi—mendukung dashboard dan alert yang lebih cerdas (dokumen taksonomi AYLIEN).
- Event clustering: Kelompokkan cerita yang duplikat atau saling terkait lintas media, supaya Anda melihat gambaran besarnya, bukan banjir headline yang hampir sama.
- Personalisasi dan targeting: Gunakan data berita real-time untuk segmentasi audiens, meningkatkan targeting iklan, atau merekomendasikan konten—yang pada akhirnya mendorong engagement dan ROI.
Misalnya, tim PR memakai analitik berita real-time untuk mendeteksi krisis yang mulai membesar sebelum viral, sementara tim sales memperkaya daftar prospek dengan “trigger events” seperti putaran pendanaan atau perekrutan eksekutif.
Checklist Praktik Terbaik untuk Ekstraksi Berita Otomatis
Berikut checklist singkat untuk menjaga pipeline ekstraksi berita Anda tetap lancar:
| Praktik Terbaik | Mengapa Penting | Cara Menerapkannya |
|---|---|---|
| Jadwalkan scraping secara rutin | Meminimalkan jeda data, menangkap breaking news | Sesuaikan frekuensi update dengan kecepatan berita (mis. setiap 15 menit untuk topik cepat) |
| Gunakan ekstraksi berbasis AI | Menyesuaikan diri dengan perubahan layout, mengurangi waktu setup | Alat seperti Thunderbit, Diffbot, Zyte API |
| Hilangkan duplikat dan gunakan canonical | Menghindari alert ganda, memastikan data bersih | Simpan canonical URL, gunakan hash untuk deduplikasi |
| Pantau kualitas ekstraksi | Menangkap field yang hilang, drift, atau kegagalan | Lacak persentase record lengkap, jeda, dan tingkat error |
| Patuhi batas hukum/kepatuhan | Menghindari risiko hukum, menjaga kepercayaan | Utamakan API/feed resmi, tinjau syarat, minimalkan data pribadi |
| Ekspor ke format terstruktur | Memudahkan analitik lanjutan | CSV, Excel, Sheets, Notion, Airtable |
| Jadwalkan scrape ulang untuk edit | Menangkap perubahan setelah publikasi | Kunjungi ulang artikel setelah 24 jam/1 minggu (model GDELT) |
| Amankan pipeline Anda | Melindungi data sensitif | Enkripsi, kontrol akses, alat tepercaya |
Membangun Workflow Ekstraksi Berita Otomatis yang Tangguh
Siap membangun “black box” Anda sendiri untuk data berita? Berikut alur kerja langkah demi langkah:
- Identifikasi sumber Anda: Buat daftar situs berita, blog, atau API yang ingin dipantau.
- Atur ekstraksi: Gunakan Thunderbit atau alat pilihan Anda untuk menentukan field (One Click Extract membuatnya sangat mudah).
- Jadwalkan scraping: Tentukan frekuensi berdasarkan kecepatan berita—per jam untuk breaking news, harian untuk topik yang lebih lambat.
- Perkaya subpage: Untuk setiap headline, scrape artikel lengkap untuk mendapatkan isi, entitas, dan tag.
- Hilangkan duplikat dan normalisasi: Simpan canonical URL, hash record, dan standarkan field.
- Ekspor dan integrasikan: Kirim data terstruktur ke Excel, Google Sheets, Airtable, atau Notion untuk dianalisis.
- Pantau dan sesuaikan: Lacak kualitas ekstraksi, waspadai perubahan layout, dan lakukan penyesuaian bila perlu.
- Tetap patuh: Tinjau syarat layanan, hormati robots.txt, dan minimalkan data pribadi.
Untuk gambaran visual, pikirkan:
Sumber → Ekstraksi (field AI) → Subpage enrichment → Deduplikasi → Ekspor → Analisis/Alert → Monitoring
Kesimpulan & Poin Penting
Ubah Halaman Berita Apa Pun Menjadi Tabel Gratis untuk memulai, tanpa perlu kartu kredit. Email, Phone Number, dan Image Extractor sudah termasuk di semua paket. Get Started Free
Ekstraksi berita otomatis bukan lagi sekadar fitur tambahan—ini sudah jadi kebutuhan bagi siapa pun yang harus tetap selangkah di depan di dunia yang berita dan perubahannya terjadi setiap menit. Dengan mengikuti praktik terbaik dan memakai alat yang tepat, Anda bisa mengubah derasnya berita digital menjadi aliran intelijen terstruktur yang stabil dan bisa ditindaklanjuti.
Poin penting:
- Skala dan kecepatan berita online menuntut otomatisasi—pemantauan manual tidak akan sanggup mengikutinya.
- Alat ekstraksi berita otomatis menghemat waktu, menekan biaya, dan memungkinkan tim kecil menyamai cakupan organisasi yang jauh lebih besar.
- Memilih alat yang tepat berarti menyeimbangkan kemudahan penggunaan, keamanan, dan adaptabilitas—Thunderbit menonjol berkat kesederhanaan berbasis AI dan opsi ekspor real-time.
- Bangun workflow Anda di sekitar kesegaran data, deduplikasi, kepatuhan, dan pemantauan kualitas untuk memastikan data berita yang andal dan bisa dipakai.
- AI dan machine learning membuka nilai yang lebih besar lagi—mulai dari targeting yang lebih cerdas, personalisasi, hingga pengambilan keputusan.
Kalau Anda masih copy-paste judul berita atau menunggu Google Alerts menampilkan cerita sehari terlambat, ada baiknya mencoba workflow otomatis. Instal ekstensi Chrome gratisnya, arahkan ke tiga atau empat sumber yang Anda cek setiap pagi, lalu lihat apakah ekspor terstruktur itu benar-benar menghemat waktu Anda. Untuk tips, workflow, dan pembahasan mendalam lainnya, kunjungi Thunderbit Blog.
Scrape Situs Berita dengan Thunderbit Atur jadwalnya dan biarkan alat ini memantau sumber yang Anda butuhkan. Hasil ekspor langsung masuk ke Sheets, Excel, Airtable, atau Notion. Get Started Free
FAQ
1. Apa itu ekstraksi berita otomatis, dan bagaimana cara kerjanya?
Ekstraksi berita otomatis adalah proses menggunakan perangkat lunak untuk mengumpulkan artikel berita lalu mengubahnya menjadi data terstruktur (seperti tabel atau JSON) untuk analisis, pencarian, atau alert. Alat seperti Thunderbit menggunakan AI untuk mengenali field penting (judul, waktu publikasi, penulis, isi artikel) dan mengekstraknya dari halaman web atau API secara otomatis.
2. Mengapa data berita real-time sangat penting bagi bisnis?
Data berita real-time memungkinkan bisnis merespons cepat terhadap peristiwa pasar, krisis PR, atau gerakan kompetitor. Baik Anda bekerja di sales, PR, maupun riset, berita yang selalu terbaru membantu Anda mengambil keputusan lebih cepat dan lebih cerdas, serta tetap unggul dari pesaing.
3. Bagaimana Thunderbit memudahkan scraping berita untuk pengguna non-teknis?
Thunderbit menawarkan alur satu klik yang sederhana: klik One Click Extract dan AI akan menentukan data apa yang perlu diambil. Dengan fitur seperti subpage scraping dan ekspor instan ke Excel atau Google Sheets, bahkan pengguna non-teknis pun bisa membangun pipeline data berita yang kuat dalam hitungan menit.
4. Apa saja pertimbangan hukum dan kepatuhan dalam scraping berita?
Selalu tinjau syarat layanan situs target Anda, utamakan API atau feed resmi jika tersedia, dan patuhi arahan robots.txt. Hindari scraping konten yang memerlukan login atau berada di balik paywall tanpa izin, dan minimalkan pengumpulan data pribadi agar tetap sesuai dengan hukum privasi.
5. Bagaimana cara memastikan workflow ekstraksi berita saya tetap andal dalam jangka panjang?
Jadwalkan scraping rutin, pantau kualitas ekstraksi, dan gunakan alat yang bisa menyesuaikan diri dengan perubahan layout (seperti ekstraksi berbasis AI dari Thunderbit). Hilangkan duplikat, lacak jeda antara publikasi dan ekstraksi, serta buat alert untuk kegagalan atau field yang hilang agar pipeline tetap sehat dan selalu up to date.
Coba Thunderbit AI Web Scraper Get Started Free
Pelajari Lebih Lanjut
- 10 Alat Web Scraping Otomatis yang Menghemat Jam Kerja Tim Saya (2026)
- 5 Software Scraping Data Web Terbaik di 2026
- 15 Alat Ekstraksi Data Terbaik di 2026: Daftar Pilihan Utama untuk Semua Tim
- Scraper Artikel Terbaik di 2026: Perbandingan Langsung
- Cara Menguasai Scraping Data Otomatis Menggunakan Thunderbit




