
MarkItDown sering dimasukkan ke dalam kelompok web scraper, padahal pengelompokan itu keliru. Alat ini tidak punya crawler, tidak memiliki mesin JavaScript, dan tidak bisa mengambil URL lalu membersihkan elemen bawaan halaman. Fungsinya adalah mengolah byte yang sudah Anda punya — PDF, dokumen Word, spreadsheet, slide deck — lalu mengubah semuanya menjadi Markdown yang bisa dibaca model bahasa.
Selama beberapa minggu, saya menjalankan MarkItDown milik Microsoft pada serangkaian dokumen nyata di satu Mac, menilai setiap tabel berdasarkan manifest yang saya siapkan sebelum pengujian, dan mengukur waktu setiap konversi. Ringkasnya: pada input yang bersih, alat ini cepat dan akurat; paket instalasinya menyembunyikan runtime machine learning 73 MB yang tidak Anda minta; dan tabelnya rusak dengan cara yang masih lolos dari pemeriksaan "teksnya masih ada?" tetapi gagal pada pemeriksaan "data ada di kolom yang benar?". Berikut gambaran lengkapnya, beserta angkanya.
Sebenarnya MarkItDown itu apa
MarkItDown adalah utilitas Python dari Microsoft untuk mengonversi file dan dokumen Office menjadi Markdown yang dioptimalkan untuk LLM. Arahkan ke PDF, .docx, .xlsx, .pptx, gambar, file HTML, atau beberapa format lain, lalu hasilnya adalah Markdown. Alat ini bisa dipanggil lewat tiga cara: CLI (markitdown file.pdf -o out.md, atau di-pipe dari stdin), Python API (MarkItDown().convert(...)), dan server MCP opsional untuk workflow agent.
Hal terpenting untuk dipahami adalah apa yang tidak dilakukannya, karena README juga tidak mengklaim itu dan saya sudah memastikannya lewat pengujian: tidak ada crawling, tidak ada rendering JS, tidak ada pengikut tautan, tidak ada pagination, dan tidak ada ekstraksi konten utama ala readability. Ini adalah konverter seluruh dokumen. Anda membawa byte-nya; alat ini menstandarkannya. Perbedaan tunggal itu menentukan apakah tool ini cocok masuk ke stack Anda atau tidak, jadi saya akan terus kembali ke poin itu.
Repositori ini sendiri terlihat “besar” lewat metrik kesukaan GitHub — 165.282 bintang dan 11.790 fork per pertengahan Juli 2026, berlisensi MIT, dengan rilis terbaru (v0.1.6) keluar pada 2026-05-26. Tapi angka bintang itu lebih mencerminkan antusiasme umum terhadap tool LLM dan repositori milik Microsoft, bukan kedewasaan mesin konversinya. Ada juga 833 issue terbuka, dan beberapa di antaranya penting untuk Anda sebelum menginstal (akan saya bahas di bawah).
HTML ke Markdown: cepat dan lengkap, boilerplate ikut terbawa
Karena seri ulasan scraper saya yang lain memakai empat fixture web yang sama, saya memberi MarkItDown file HTML lokal yang identik — bukan untuk menilainya sebagai scraper, melainkan untuk melihat seberapa baik kualitas konversi HTML ke Markdown-nya. Pada halaman yang markup-nya rapi, hasilnya memang bagus.
Keempat halaman berhasil dikonversi dengan instalasi inti tanpa tambahan apa pun, dan semua probe konten utama tetap lolos. Artikel Wikipedia tentang "Web scraping" (226 KB) keluar dengan pohon heading yang tergambar rapi — satu h1, tujuh h2, dua belas h3, sesuai struktur asli artikel — dan 418 tautan tetap terjaga sebagai [teks](url) yang benar. Tabel statistik hoki 25×9 pada halaman Scrape This Site forms berubah menjadi tabel pipe GFM 27 baris yang bersih (header + separator + 26 baris data), termasuk sel kosongnya. Kecepatannya juga tidak menjadi masalah: median 48 ms untuk halaman quotes kecil hingga 352 ms untuk halaman Wikipedia 226 KB.
Tapi ada satu catatan penting, dan ini pilihan desain, bukan bug. MarkItDown tidak membuang boilerplate. Ia mengonversi seluruh <body>, sehingga elemen navigasi dan chrome situs ikut terbawa — dan sisanya bertambah banyak seiring makin “ramai” halaman tersebut.
| Halaman | Karakter output | Heading (h1/h2/h3) | Link | Baris chrome situs |
|---|---|---|---|---|
| Books to Scrape | 10,478 | 1 / 0 / 0 | 94 | 0.6% (1/159) |
| Quotes to Scrape | 2,973 | 1 / 1 / 0 | 55 | 1.2% (1/86) |
| ScrapeThisSite forms | 3,385 | 1 / 0 / 0 | 31 | 6.7% (5/75) |
| Wikipedia Web scraping | 60,159 | 1 / 7 / 12 | 418 | 12.4% (42/338) |
Pada homepage Books yang hampir tanpa chrome, 0,6% baris output adalah chrome. Di Wikipedia, angkanya 12,4% — 42 dari 338 baris non-kosong berisi teks seperti "jump to content," "toggle the table of contents," "22 languages," "retrieved from," serta footer cookie dan lisensi. Banner pemeliharaan Wikipedia seperti ("Artikel ini membutuhkan sitasi tambahan") bahkan ikut dirender dengan setia menjadi tabel pipe dua kolom, dan dari situlah sembilan baris tabel muncul di halaman yang sebenarnya tidak punya tabel data nyata.
Semua itu bukan berarti MarkItDown salah bekerja. Ini konverter seluruh dokumen, bukan extractor readability: HTML ke Markdown yang setia adalah pekerjaan berbeda dari ekstraksi artikel yang bersih. Trafilatura dan tool bergaya Firecrawl memang bertujuan hanya mengambil konten utama; MarkItDown mengembalikan seluruh halaman. Di balik layar, _html_converter.py miliknya menghapus <script> dan <style>, lalu menyerahkan seluruh body ke library markdownify — tidak ada heuristik konten utama di jalurnya. Kalau Anda hanya ingin artikelnya, ini bukan lapisan yang tepat.
Wilayah utamanya: PDF, DOCX, XLSX, PPTX
Dokumen adalah medan utama MarkItDown. Saya mengujinya pada file publik nyata — paper arXiv dengan text layer, whitepaper Bitcoin, PDF hasil scan berbasis gambar yang saya render agar benar-benar tanpa teks, serta file DOCX/XLSX/PPTX dari test suite MarkItDown sendiri (diberi UUID agar saya bisa mendeteksi hilangnya konten secara diam-diam).
| Dokumen | Input | Karakter output | Probe | Waktu median | Catatan |
|---|---|---|---|---|---|
| arXiv 1706.03762 (PDF dengan text layer) | 2.2 MB | 40,174 | 7/7 | 3.7 s (warm) | judul, "Transformer", "BLEU", "References" semuanya ada |
| Bitcoin whitepaper (PDF 9 hlm.) | 184 KB | 22,485 | 6/6 | 1.4 s | "Satoshi Nakamoto", "proof-of-work", "Conclusion" ada |
| PDF hasil scan (tanpa text layer) | 89 KB | 0 | 0/4 | 15 ms | output kosong, tanpa error, tanpa OCR |
| DOCX (test.docx) | 136 KB | 4,651 | — | 70 ms | heading + tabel GFM; UUID tertanam tetap utuh |
| DOCX dengan equation | 15 KB | 240 | — | 101 ms | Office Math dipertahankan sebagai LaTeX |
| XLSX (test.xlsx) | 12 KB | 808 | — | 57 ms | tiap sheet → ## SheetName + tabel GFM |
| PPTX (test.pptx) | 278 KB | 2,047 | — | 52 ms | penanda nomor slide, tabel, chart → tabel |
Recall teks pada PDF yang punya text layer sangat bagus — 7 dari 7 probe yang saya daftarkan sebelumnya pada paper arXiv "Attention Is All You Need" dan 6 dari 6 pada Bitcoin whitepaper — dan tidak satu pun file Office kehilangan sentinel UUID, jadi tidak ada kehilangan konten diam-diam pada fixture regresi milik maintainers. Satu kemenangan kecil yang menarik: jalur DOCX (melalui mammoth) mempertahankan equation Office Math sebagai LaTeX, mengubah equations.docx menjadi math $$...$$ yang nyata. Kalau Anda memberi dokumen Word yang penuh matematika ke LLM, itu kekuatan yang nyata, meski cukup spesifik, dan saya tidak menemukan dokumentasi lain yang menyorotinya.
Ada dua temuan di area ini yang perlu perhatian khusus, karena keduanya paling mungkin menjatuhkan Anda.
PDF hasil scan yang menghilang
Berikan MarkItDown PDF berbasis gambar tanpa text layer, lalu ia mengembalikan string kosong. Nol karakter, tanpa exception, tanpa peringatan — selesai dalam sekitar 15 ms karena memang tidak ada yang bisa diekstrak. Jalur PDF MarkItDown hanya melakukan ekstraksi teks (mengandalkan pdfminer dan pdfplumber di balik layar), dan tidak menyertakan OCR baik di instalasi inti maupun lewat pip extra apa pun.
Ini penting saat diproses batch. Developer yang memberi folder PDF campuran, sebagian hasil scan, akan mendapat hasil kosong tanpa sinyal bahwa file-file itu dilewati. Saya memastikan fixture-nya bukan rusak dengan menjalankan extract_text milik pdfminer langsung ke file tersebut — hasilnya nol karakter yang disaring, tidak ada text layer, terkonfirmasi — jadi output kosong memang perilaku asli MarkItDown pada scan sungguhan. Ini mereproduksi celah fallback OCR yang sudah lama terbuka (#1268) yang memang sudah lama dilacak upstream. Jalur yang didokumentasikan adalah backend opsional Azure Document Intelligence atau plugin; keduanya tidak ada di instalasi default.
PDF keluar sebagai teks datar, bukan struktur
Pada kedua PDF yang punya text layer, MarkItDown menghasilkan nol penanda heading Markdown. PDF tidak membawa tag heading semantik, dan MarkItDown tidak menebaknya dari ukuran font, jadi setiap baris jatuh ke level body. Recall teks tinggi; strukturnya datar.
Ini bukan hanya hasil saya. Benchmark publik pihak ketiga menilai hierarki heading PDF MarkItDown sekitar 0,0 dan fidelitas tabelnya sekitar 0,27, jauh di bawah 0,88 milik Docling yang ditopang TableFormer (lihat perbandingan MarkItDown vs Docling vs Marker dan benchmark READoc). Fixture saya mereplikasi hasil mereka, dan itu menguatkan evidensinya — angka saya sejalan dengan sumber luar. Trade-off yang dilaporkan benchmark yang sama adalah MarkItDown berjalan kira-kira 100× lebih cepat daripada Docling, dan itu cocok dengan waktu hitungan detik, bukan menit, pada dokumen yang oleh tool berbasis model layout bisa habis dalam beberapa menit. Intinya: MarkItDown memberi Anda teks PDF yang bersih dan cepat; ia tidak memberi Anda struktur PDF. Jika heading dan tabel harus tetap utuh, tool berbasis layout model seperti Docling atau Marker adalah lapisan yang tepat.
Tabel: konten hampir selalu selamat, strukturnya belum tentu
Tabel adalah tempat di mana pertanyaan "teksnya selamat?" dan "datanya masih bisa dipakai?" mulai terpisah, jadi saya membuat matriks 13 kasus — satu <table> per kasus, masing-masing dinilai terhadap manifest yang ditulis sebelum pengujian — untuk memetakan tepatnya bentuk mana yang bertahan dan mana yang rusak.
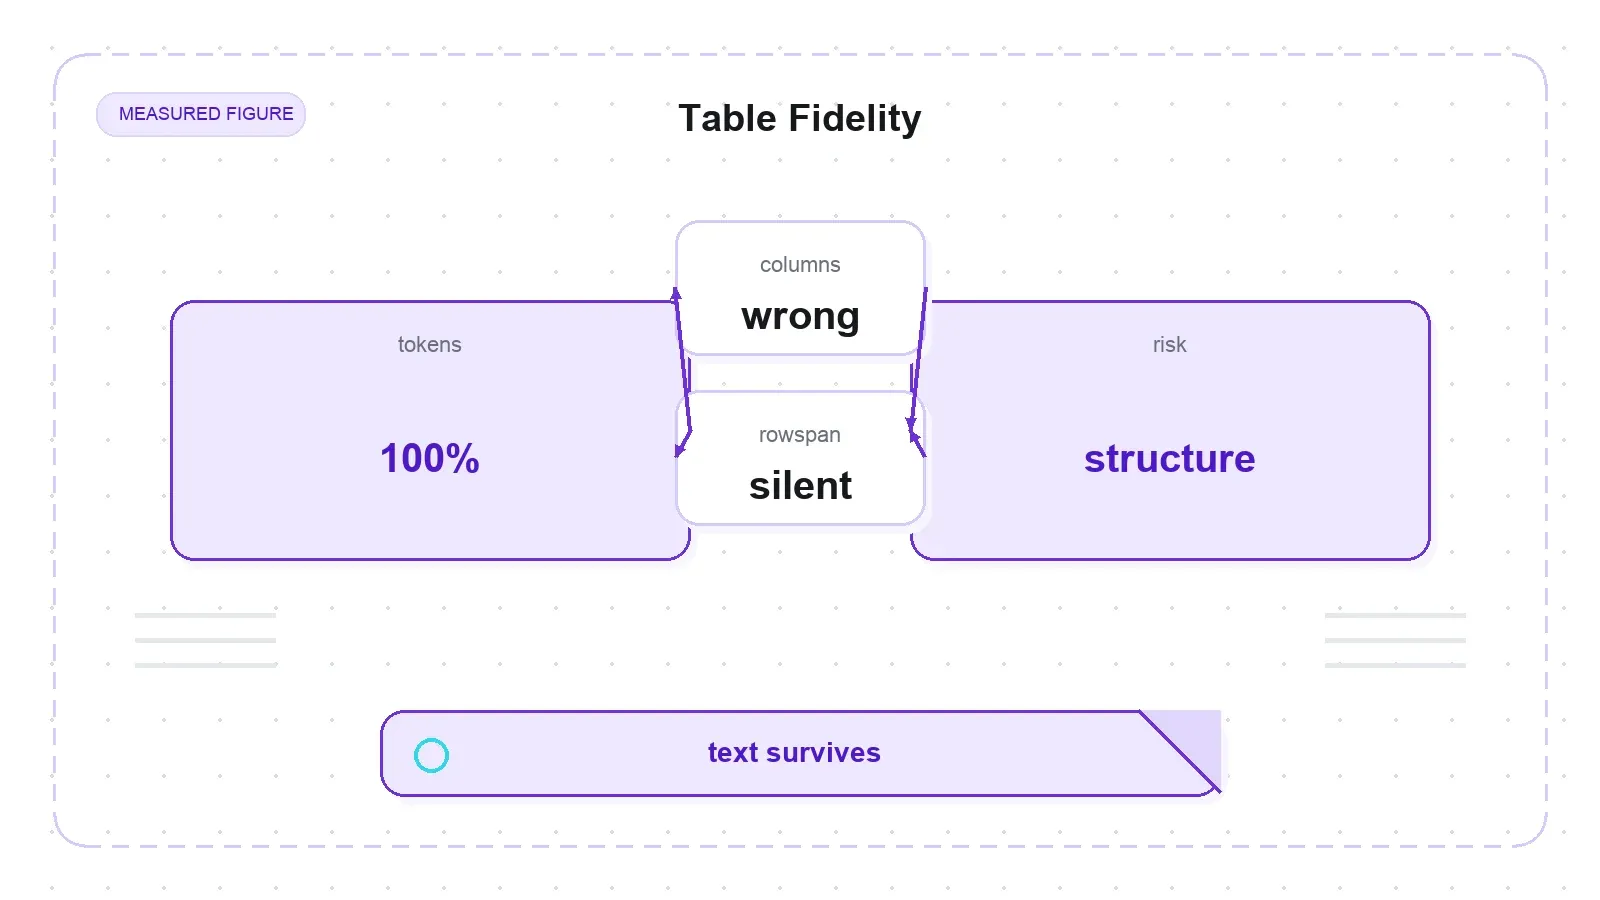
Garis besarnya: MarkItDown tidak pernah kehilangan isi tabel. Semua 13 kasus mempertahankan 100% token yang saya daftarkan sebelumnya. Namun fidelitas strukturalnya terbagi tiga. Tujuh dari tiga belas menghasilkan grid GFM yang rapi (plain, header-colspan, lebar 24 kolom, tanpa header, sel kosong, block-in-cell, dan bahasa Arab right-to-left). Empat menjadi berantakan, karena Markdown memang tidak mengenal sel yang menyatu, sehingga rowspan, colspan, dan sumber yang malformat menghasilkan baris pendek. Dan dua benar-benar rusak total.
Dua kerusakan itu penting untuk disebut. Tabel bersarang (sebuah <table> di dalam <td>) diratakan secara inline, sehingga pipe dan baris separator milik tabel anak masuk ke sel induk dan menghasilkan baris sampah 14 “kolom”. Lalu karakter literal | di dalam sel tidak di-escape — teks sel a | b berubah menjadi dua kolom, x || y menjadi tiga — sehingga tabel dua kolom menghasilkan baris dengan dua, tiga, dan empat kolom, dan parser Markdown downstream akan membaca batas yang salah. Menariknya, tanda bintang dan backtick di dalam sel di-escape, tetapi pipe tidak. Penyebab utamanya adalah jalur HTML MarkItDown memakai penanganan tabel default milik markdownify, sementara subclass kustomnya hanya menimpa link, gambar, dan heading, bukan sel tabel. Kelas bug escape pipe yang sama juga menjadi issue terbuka untuk konverter CSV (#2019), meskipun perbaikan itu tidak menyentuh jalur HTML yang saya uji.
Yang lebih halus — dan ini temuan yang paling ingin saya tunjukkan ke data engineer — adalah rowspan. Kasus t03 bukan sekadar menjadi berantakan; datanya bergeser tanpa peringatan. Label rowspan=2 ("Fruit") hanya muncul sekali, lalu baris di bawahnya menjadi baris dua kolom pendek (| Banana | 8 |), sehingga "Banana" jatuh di bawah kolom Group, bukan Item. Semua token ada. Konsumen naif yang hanya membaca kolom kedua akan mengambil nilai yang salah. Ini jenis bug yang lolos dari cek keberadaan teks tetapi diam-diam merusak dataset.
Keterbatasan span itu sendiri adalah constraint desain yang sudah diketahui dan dilacak (#1211, #1248) — grid pipe GFM yang datar memang tidak bisa merepresentasikan span atau nesting, jadi konverter menukar struktur demi kelengkapan konten. Ada juga perilaku yang bagus: tabel tanpa header diberi baris header kosong sintetis (jadi tidak ada data yang diam-diam dipromosikan menjadi header), sel kosong dipertahankan, dan <caption> tetap muncul sebagai baris teks di atas tabel.
Instalasi dan startup: biaya yang tidak diingatkan oleh kata "ringan"
Tidak ada bagian yang lebih mengejutkan dari ini, dan di sinilah framing "utilitas Python ringan" diam-diam terasa terlalu optimistis.
Pertama, jangan menjalankan pip install 'markitdown[all]'. Di Python 3.14, perintah itu diam-diam mundur ke markitdown 0.0.2 — rilis berusia dua tahun — dan saya mereproduksinya langsung di venv bersih. Saat dipin, penyebabnya terlihat: pip install 'markitdown[all]==0.1.6' gagal karena extra [all] mengunci youtube-transcript-api~=1.0.0, sementara di PyPI saat ini semua build dalam rentang itu dibatasi untuk Python <3.14, sedangkan satu-satunya build yang kompatibel dengan 3.14 berada di luar pin tersebut. Jadi resolver mundur jauh ke rilis terakhir yang dependensinya bisa dipenuhi. Ini sesuai dengan issue upstream yang masih terbuka (#2179). Solusinya sederhana — pin versinya dan pasang extra satu per satu: pip install 'markitdown==0.1.6', lalu pip install 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Masing-masing akan terselesaikan dengan mulus; hanya bundle [all] yang membawa pin bermasalah itu. (Jebakan ini juga bergantung pada versi Python — di Python 3.13 atau lebih lama, pembatasnya mungkin tidak kena, jadi [all] bisa saja terselesaikan berbeda.)
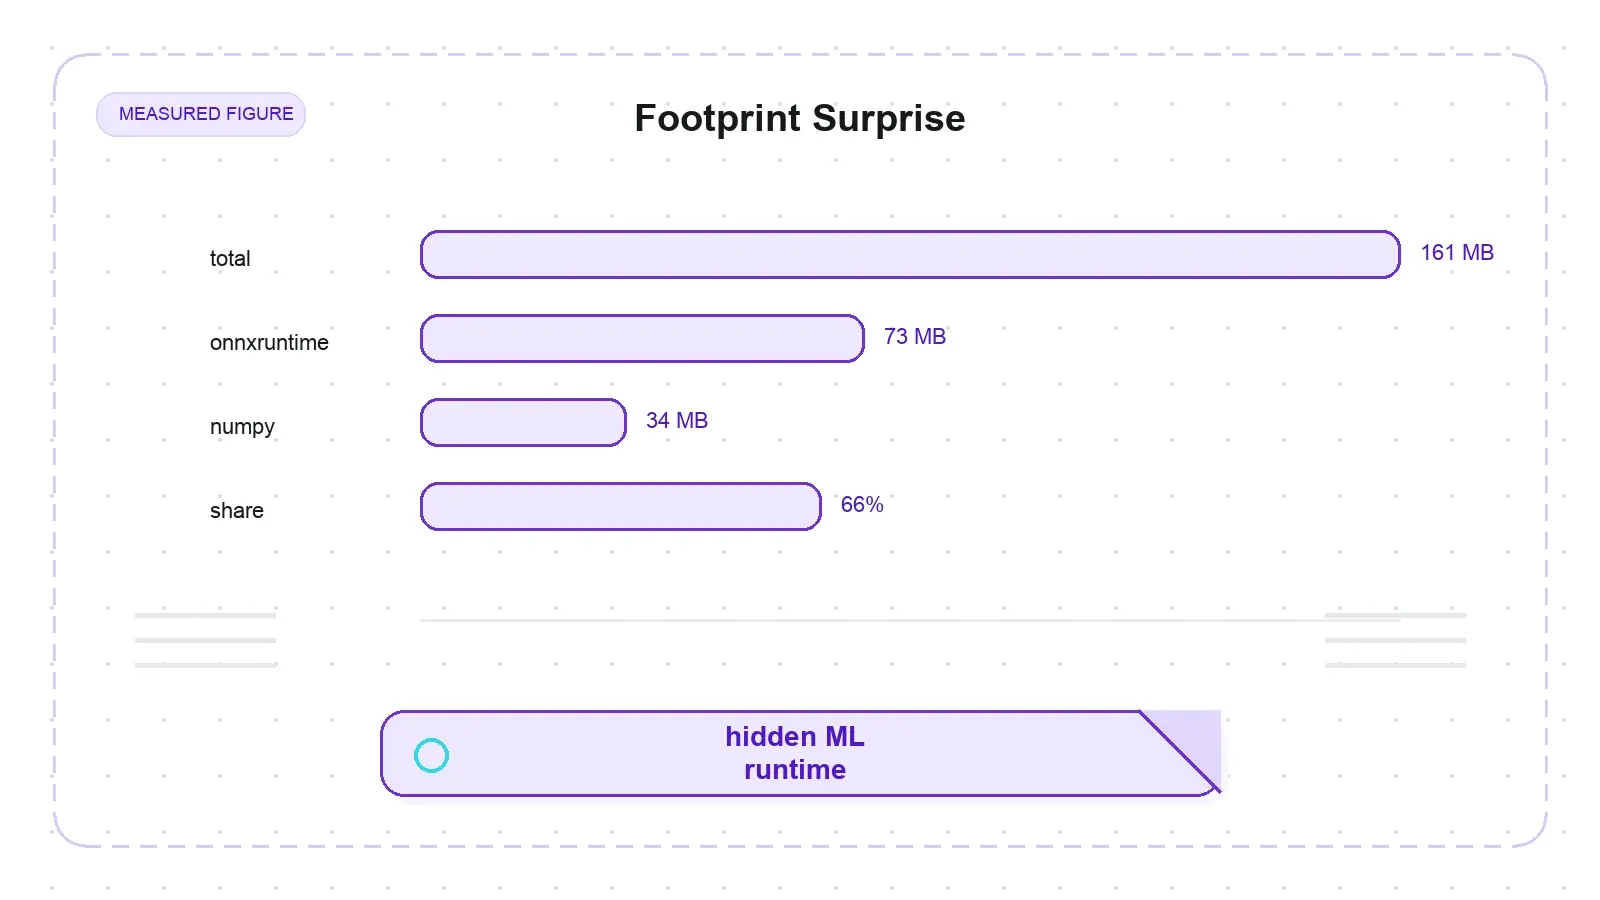
Kedua, jejak ukurannya. Instalasi inti membutuhkan 161 MB (venv kosong 13 MB plus 148 MB). Dari jumlah itu, onnxruntime (73 MB) dan numpy (34 MB) bersama-sama menyumbang 107 MB — 66% dari seluruh footprint inti — dan keduanya ditarik oleh satu hard dependency: magika, detector tipe file berbasis ML milik Google. Jadi, sebuah konverter teks membawa runtime inferensi ONNX 73 MB di instalasi dasarnya bahkan sebelum Anda menambahkan satu ekstra dokumen pun. Tambahkan extra dokumen, dan venv naik menjadi 310 MB. Ini jauh lebih ringan daripada stack headless browser, tetapi kalau Anda membayangkan alat mikro yang tinggal pip install lalu selesai, ketahuilah bahwa runtime ONNX ikut menumpang.
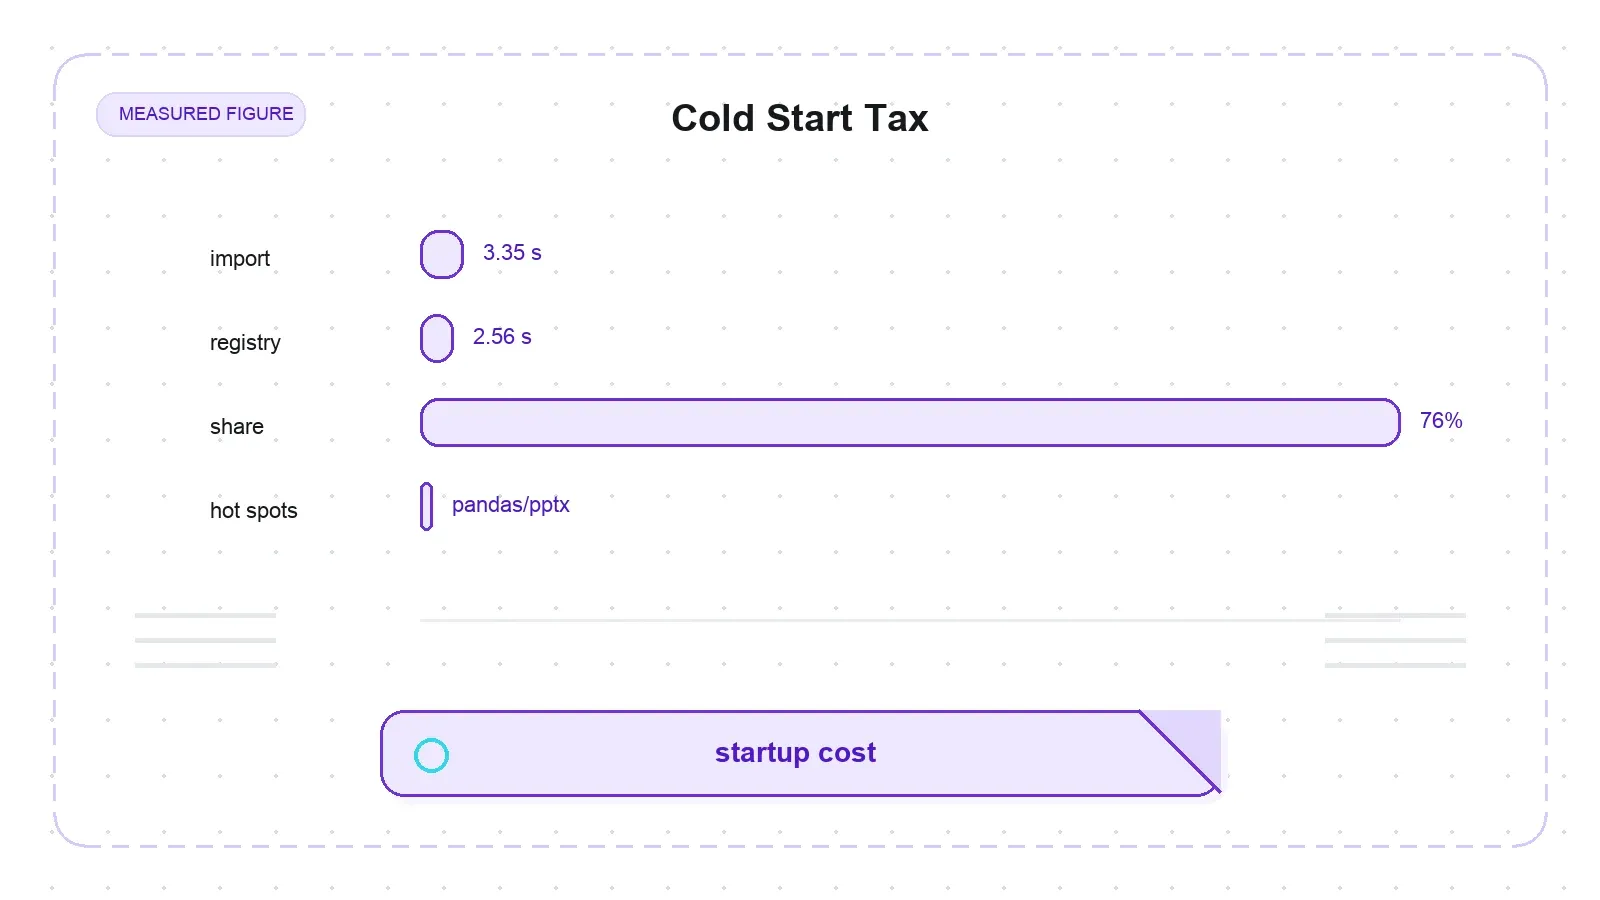
Ketiga — dan ini satu-satunya temuan dalam seluruh rangkaian saya yang lolos semua pengecekan kebaruan yang saya jalankan — bahkan setelah instalasi bersih, import markitdown memakan sekitar 3,35 detik di mesin ini. Biayanya hampir seluruhnya terjadi saat import: markitdown._markitdown memuat seluruh registry konverter secara eager (kumulatif 2,56 s, 76% dari total), yang ikut menarik pandas (1,21 s, lewat konverter XLSX), python-pptx (427 ms), magika (354 ms), dan requests (270 ms) — entah Anda akan mengonversi format-format itu atau tidak. Untuk service yang berjalan lama, biaya import ini akan teramortisasi dan tidak terlalu penting. Untuk CLI sekali jalan atau cold start serverless, ini adalah pajak per proses yang nyata dan tidak Anda duga dari label "utilitas ringan". (Catatan adil: ini satu run profiling saja, diperlakukan sebagai satu observasi, bukan distribusi multi-run.)
Skala: tidak crash, tapi siapkan CPU untuk PDF dan RAM untuk spreadsheet
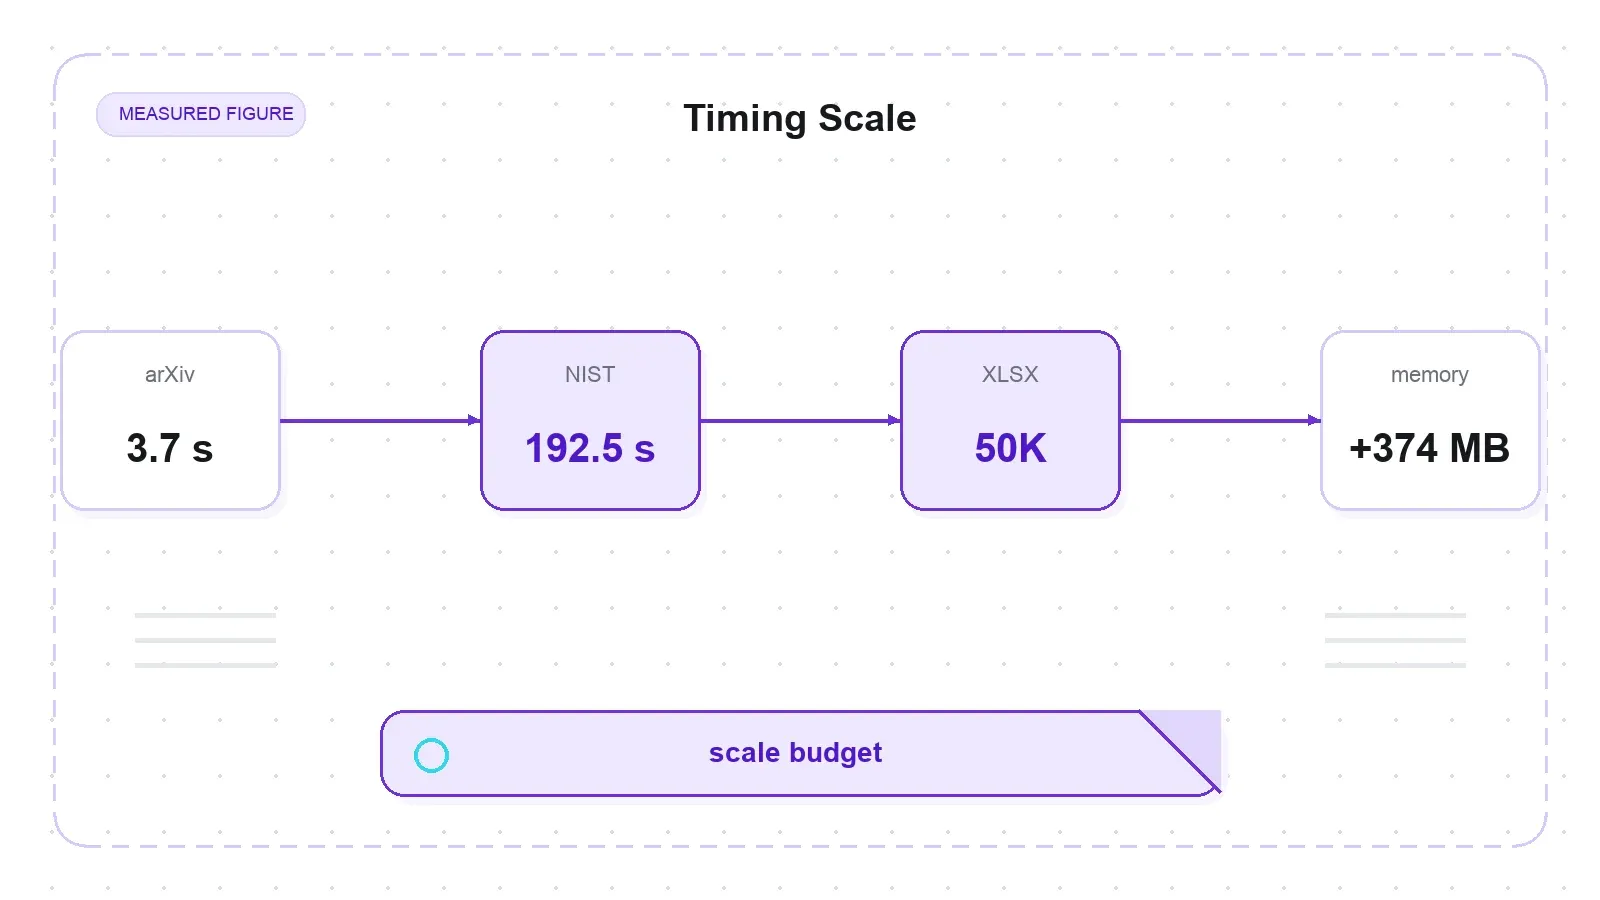
Saya mendorong empat subjek besar melewatinya, masing-masing di proses terpisah agar peak memory tidak terkontaminasi oleh run sebelumnya. Tidak ada yang crash. Namun profil biayanya timpang.
| Subjek | Input | Karakter output | Waktu median | Δ RSS puncak |
|---|---|---|---|---|
| NIST SP 800-53r5 (PDF 492 halaman) | 6.07 MB | 1,625,365 | 192.5 s | +40 MB |
| XLSX 50.000 baris × 8 kolom | 2.1 MB | 3,722,955 | 62.1 s | +374 MB |
| arXiv 1706.03762 (±15 halaman PDF) | 2.2 MB | 40,174 | 12.6 s | +25 MB |
| XLSX 200 baris × 64 kolom | 46 KB | 120,129 | 2.9 s | +22 MB |
PDF NIST 492 halaman membutuhkan median 192,5 detik — sekitar 3,2 menit, atau 0,39 dtk/halaman — karena pdfplumber menjalankan deteksi form posisi kata pada setiap halaman. Peak RSS tetap di +40 MB, jadi bottleneck-nya CPU, bukan memori. Bahkan PDF arXiv 15 halaman pun memakan 12,6 detik saat dijalankan di proses terisolasi, sekitar 3,4× lebih lambat daripada 3,7 detik yang sama-sama muncul saat proses warm dalam suite dokumen saya. Selisih itu adalah biaya proses dingin, dan menegaskan bahwa kerja per halaman, bukan ukuran byte mentah, yang menjadi penggerak utama. Kalau Anda butuh satu angka yang bisa dipindahkan untuk PDF itu, pakailah 12,6 dtk dari run terisolasi.
Jalur spreadsheet membalik bottleneck-nya. XLSX 2,1 MB dengan 50.000 baris melonjak menjadi +374 MB peak RSS (dan 3,7 juta karakter output) karena konverter memuat seluruh sheet dan membangun satu string Markdown besar. Jadi panduan praktisnya sederhana: PDF besar, siapkan CPU beberapa menit; spreadsheet besar, siapkan ratusan MB RAM. Angka ini berasal dari satu mesin, macOS arm64, dan Python 3.14, jadi konstanta per halaman dan per baris bersifat spesifik platform — tetapi bentuk umumnya (PDF lambat dan CPU-bound, XLSX berat di memori, tidak crash) adalah bagian yang dapat ditransfer.
Posisi Thunderbit — dan batasnya
Coba Thunderbit untuk Ekstraksi Data Web
Ini satu-satunya perbandingan yang mudah dibesar-besarkan, jadi saya akan membatasi dengan hati-hati. MarkItDown dan Thunderbit memecahkan masalah yang berdekatan, bukan masalah yang sama.
MarkItDown mengonversi file yang sudah Anda punya. Thunderbit mengambil halamannya terlebih dahulu. Endpoint /distill milik Thunderbit mengubah halaman web live menjadi Markdown yang bersih dan siap untuk LLM — menangani rendering JS, anti-bot, dan konten dinamis yang tidak bisa ditangani MarkItDown — dan endpoint /extract mengembalikan JSON terstruktur yang cocok dengan skema, bukan sekadar Markdown mentah. Bagi developer, semua itu tersedia lewat API (POST /distill / POST /extract), server MCP, dan CLI (npx @thunderbit/thunderbit-cli) di atas satu engine AI yang sama, engine yang juga berada di balik ekstensi dengan 100.000+ pengguna.
Jadi, keduanya hanya bertemu pada satu hal — sama-sama bisa menghasilkan “Markdown siap LLM” — tetapi domain inputnya berbeda: distill milik Thunderbit mengambil URL di web terbuka, sedangkan MarkItDown mengambil file lokal. Keduanya bukan pengganti langsung, dan saya tidak akan berpura-pura begitu. Stack yang realistis memakai keduanya: ambil dan crawl web dengan Thunderbit (atau layanan bergaya Firecrawl), lalu normalisasi juga dokumen lokal campuran yang Anda punya — PDF, deck, spreadsheet — dengan MarkItDown. Yang satu menangani jaringan; yang lain menangani laci file.
Kelebihan dan kekurangan
Kelebihan
- Recall penuh pada HTML yang bersih (4/4 halaman), dengan pohon heading dan link tetap terjaga akurat
- Recall teks PDF/DOCX tinggi (probe arXiv 7/7, Bitcoin 6/6) dan tidak ada kehilangan konten diam-diam pada fixture Office milik maintainers
- Office Math dipertahankan sebagai LaTeX — keunggulan niche yang nyata
- Tidak crash pada subjek skala apa pun, hingga PDF 492 halaman dan XLSX 50 ribu baris
- Sangat mudah dipanggil: CLI,
convert(), piping stdin, dan server MCP opsional - Berlisensi MIT, aktif dipelihara Microsoft, tracker issue responsif
Kekurangan
- Boilerplate tetap ikut terbawa — hingga 12,4% baris chrome di Wikipedia; bukan extractor artikel
- Tabel rusak pada span, nesting, dan pipe di dalam sel (2/13 rusak, 4/13 berantakan), dan rowspan bisa diam-diam menggeser data ke kolom yang salah
- PDF hasil scan/gambar saja menghasilkan output kosong tanpa OCR dan tanpa error
- Output PDF tidak punya struktur heading sama sekali (sesuai benchmark publik)
- Instalasi inti 161 MB membawa runtime ONNX 73 MB; cold import sekitar 3,35 dtk
- Extra
[all]bisa diam-diam mundur ke versi 0.0.2 yang berusia dua tahun di Python 3.14
Siapa yang sebaiknya memakai, dan siapa yang tidak
Pilih MarkItDown jika Anda sedang menstandarkan tumpukan dokumen lokal campuran — Word, Excel, PowerPoint, PDF dengan text layer — menjadi Markdown untuk pipeline LLM, dan Anda lebih peduli pada kelengkapan teks daripada struktur yang tetap utuh. Sebagai konverter tahap akhir dalam batch job, untuk memberi model teks yang bersih, alat ini cepat, akurat, dan gratis.
Lewatkan, atau gabungkan dengan tool lain, jika pekerjaan Anda salah satu dari ini: Anda hanya butuh artikel utama dari halaman web (pakai tool readability atau bergaya Firecrawl); Anda perlu heading dan tabel PDF tetap utuh (itu wilayah Docling atau Marker); atau input Anda mencakup dokumen hasil scan yang butuh OCR (Anda perlu backend Azure atau tool lain sepenuhnya). Dan kalau Anda mengira sedang mencari scraper — sesuatu yang mengambil dan melakukan crawling — ini sama sekali bukan itu.
Skor sementara yang saya jalankan dengan rubrik mirip scraper menempatkan MarkItDown di angka 60/100, dan skor rendah itu sebenarnya artefak karena saya menilai konverter dengan tes milik crawler. Di wilayahnya sendiri, skor fidelitas teksnya tinggi; titik lemahnya bersifat struktural (tabel, heading PDF) dan packaging (footprint, import, jebakan [all]), bukan kualitas teks. Jika dinilai sebagai apa adanya — konverter file ke Markdown — ini adalah tool yang solid, terawat baik, dengan beberapa sisi tajam yang sebaiknya Anda ketahui sebelum memasukkannya ke produksi.
Pertanyaan yang sering diajukan
Apakah MarkItDown itu web scraper?
Tidak. Alat ini tidak punya crawler, tidak merender JavaScript, tidak mengikuti tautan, dan tidak melakukan pagination. MarkItDown mengonversi file dan dokumen yang sudah Anda miliki — PDF, DOCX, XLSX, PPTX, gambar, HTML — menjadi Markdown. Jika Anda perlu mengambil dan melakukan crawl pada halaman web live, Anda memerlukan tool scraping seperti Thunderbit atau Firecrawl; MarkItDown adalah langkah setelahnya, yaitu mengubah file hasil ambil atau file lokal menjadi Markdown yang rapi.
Mengapa pip install markitdown[all] memasang versi lama?
Di Python 3.14, extra [all] mengunci youtube-transcript-api~=1.0.0, dan semua build dalam rentang itu dibatasi untuk Python di bawah 3.14. Resolver tidak bisa memenuhi pin itu, jadi ia diam-diam mundur ke markitdown 0.0.2, rilis berusia dua tahun. Solusinya adalah mengunci versi dan memasang extra satu per satu: pip install 'markitdown==0.1.6', lalu tambahkan 'markitdown[pdf,docx,pptx,xlsx,xls]==0.1.6'. Ini sedang dilacak sebagai issue #2179.
Apakah MarkItDown melakukan OCR pada PDF hasil scan?
Tidak pada instalasi default. Jalur PDF-nya hanya ekstraksi teks, jadi PDF berbasis gambar tanpa text layer akan mengembalikan string kosong — tanpa error, tanpa peringatan. OCR memerlukan backend opsional Azure Document Intelligence atau plugin, dan keduanya tidak dikirim secara default. Ini adalah celah yang sudah lama dilacak (issue #1268).
Seberapa baik MarkItDown menangani tabel?
Dari sisi konten, sangat baik — dalam uji 13 kasus saya, semua konten tabel tetap utuh 100%. Dari sisi struktur, tergantung bentuknya: tabel sederhana, lebar, tanpa header, dan dengan sel kosong keluar sebagai grid GFM yang rapi, tetapi rowspan dan colspan menjadi berantakan (dan rowspan bisa diam-diam menggeser data ke kolom yang salah), tabel bersarang diratakan menjadi baris sampah, dan karakter pipe literal di dalam sel tidak di-escape. Format tabel Markdown yang datar memang tidak bisa mewakili span atau nesting.
Apakah MarkItDown cukup cepat untuk dokumen besar?
Alat ini tidak crash pada file besar, tetapi siapkan sumber daya sesuai jenisnya. PDF 492 halaman membutuhkan sekitar 3,2 menit (kira-kira 0,39 dtk/halaman) karena ada deteksi form per halaman, dan sifatnya CPU-bound. Spreadsheet 50.000 baris selesai dalam sekitar satu menit tetapi memakai +374 MB RAM karena membangun satu string Markdown besar di memori. Untuk PDF besar, siapkan CPU beberapa menit; untuk spreadsheet besar, siapkan ratusan MB RAM.
Coba Thunderbit untuk Ekstraksi Data Web Get Started Free




