
“Apakah legal mengambil data dari website?”—itulah pertanyaan bernilai jutaan dolar yang hampir tiap minggu saya dengar dari tim sales, operasional, dan marketing. Karena web scraping sekarang dipakai untuk apa saja, mulai dari lead generation sampai competitive intelligence, wajar kalau banyak orang ingin jawaban yang tegas. Tapi kenyataannya? Lanskap hukumnya sejelas kopi yang sudah semalaman. Coba lihat saja judul-judul berita: satu pengadilan bilang mengambil data publik itu boleh, sementara pengadilan lain memperingatkan soal “pengambilan data yang melanggar hukum.” Tak heran banyak tim jadi waswas dan takut salah langkah.
Faktanya, lebih dari dua pertiga organisasi sekarang menggunakan web scraping untuk mendukung analitik dan proyek AI, dan 78% perusahaan e-commerce mengandalkannya untuk intelijen harga. Tapi dengan kasus-kasus besar seperti LinkedIn vs. hiQ Labs yang jadi sorotan, taruhannya sekarang jauh lebih tinggi. Jadi, bagaimana cara memanfaatkan data web tanpa terjerat masalah hukum? Mari kita bahas kerangka hukum, pengecekan kepatuhan, dan praktik terbaik yang wajib dipahami setiap pengguna bisnis. Dan ya, saya juga akan menunjukkan bagaimana Thunderbit membuat proses scraping yang patuh aturan jadi jauh lebih mudah.
Memahami Lanskap Hukum: Apakah Legal Mengambil Data dari Website?
Coba Web Scraper Patuh Aturan dari Thunderbit Web scraper agentic dari Thunderbit membaca halaman publik secara mandiri dan mengekstrak data dengan satu klik, dirancang untuk tim yang mengutamakan kepatuhan. Get Started Free
Langsung ke intinya: legalitas web scraping tergantung pada data apa yang Anda ambil, bagaimana cara mengambilnya, dan di mana Anda berada. Tidak ada satu hukum universal yang bilang “scraping legal” atau “scraping ilegal.” Yang ada justru kumpulan aturan yang saling tumpang tindih—mulai dari undang-undang anti-hacking, regulasi privasi, hak cipta, sampai syarat dan ketentuan situs web (Thunderbit Blog).
Berikut faktor-faktor utama yang menentukan apakah proyek scraping Anda masih aman:
- Data Publik vs. Privat: Mengambil data yang memang terbuka untuk semua orang (tanpa login, tanpa paywall) umumnya lebih aman. Kalau Anda mencoba mengakses konten di balik login, biasanya Anda sudah masuk wilayah yang berisiko ilegal.
- Jenis Data: Data pribadi (seperti nama, email, atau profil sosial) dan konten berhak cipta (artikel, gambar) jauh lebih berisiko dibanding data faktual seperti harga, spesifikasi produk, atau listing bisnis.
- Tujuan Penggunaan: Memakai data hasil scraping untuk keperluan internal (analisis atau riset) jauh lebih aman dibanding memublikasikan ulang atau menjualnya.
- Kepatuhan terhadap Aturan Situs: Melanggar syarat layanan situs atau mengabaikan file robots.txt bisa bikin Anda bermasalah—meskipun datanya publik.
- Pendekatan Teknis: Mengambil data dengan kecepatan yang mirip manusia dan tidak menerobos perlindungan keamanan (seperti CAPTCHA atau pemblokiran IP) membuat posisi Anda lebih kuat.
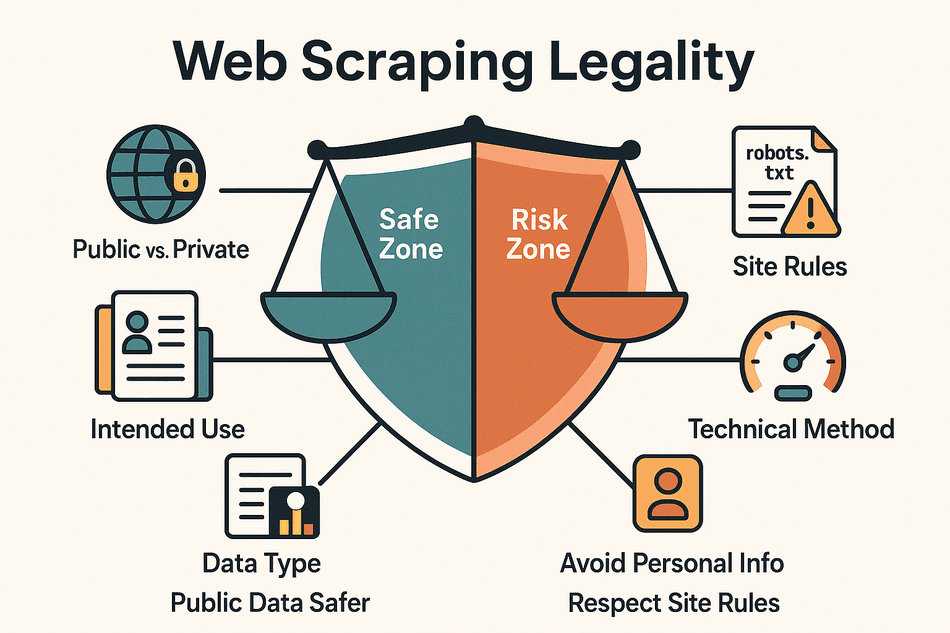
 Intinya? Scraping data publik yang bukan data pribadi untuk penggunaan internal umumnya diterima di banyak wilayah, tetapi ada banyak pengecualian penting—terutama terkait privasi, hak cipta, dan seberapa agresif proses scraping yang dilakukan (Thunderbit Blog).
Kerangka Hukum Data Scraping: Gambaran Regulasi Global Utama
 Mari kita lihat sekilas kerangka hukum utama untuk web scraping di berbagai wilayah:
Amerika Serikat: CFAA, Hak Cipta, dan Kontrak
- Computer Fraud and Abuse Act (CFAA): Undang-undang anti-hacking ini melarang akses ke sistem komputer “tanpa otorisasi.” Namun, pengadilan telah menegaskan bahwa scraping situs publik tidak melanggar CFAA, karena tidak ada “otorisasi” yang diperlukan (California Lawyers Association).
- Kasus Penting: Dalam hiQ Labs v. LinkedIn, Pengadilan Sirkuit Kesembilan memutuskan bahwa scraping profil LinkedIn yang publik bukan pelanggaran CFAA. Namun, LinkedIn masih bisa menggugat karena pelanggaran kontrak (melanggar terms of service) atau pelanggaran hak cipta.
- Risiko Lain: Kalau Anda melakukan scraping secara agresif, seperti bot di eBay v. Bidder’s Edge yang mengirim 100.000 permintaan per hari, Anda bisa dikenai tuduhan “trespass to chattels”—sederhananya, mengganggu server pihak lain (Wikipedia).
Uni Eropa: GDPR dan Hak atas Database
- GDPR: General Data Protection Regulation Uni Eropa tetap berlaku bahkan untuk data pribadi yang bersifat publik. Kalau Anda mengambil data apa pun yang bisa mengidentifikasi seseorang, Anda harus punya dasar hukum yang sah (seperti persetujuan atau legitimate interest) dan mengikuti aturan privasi yang ketat.
- Database Directive: Uni Eropa juga melindungi database secara keseluruhan. Mengambil “bagian substansial” dari database terstruktur (misalnya seluruh listing dari situs properti) bisa melanggar hak database—meskipun fakta individual di dalamnya tidak dilindungi hak cipta (Thunderbit Blog).
Inggris: UK GDPR dan Data Protection Act
- UK GDPR: Setelah Brexit, aturan Inggris pada dasarnya mirip dengan Uni Eropa. Scraping data publik yang bukan data pribadi umumnya aman, tetapi scraping data pribadi sangat diatur ketat.
- Computer Misuse Act: Mirip CFAA, undang-undang ini dapat menjadikan akses tanpa izin sebagai tindak pidana.
Tiongkok: PIPL dan Data Security Law
- Personal Information Protection Law (PIPL): Mengharuskan persetujuan untuk mengumpulkan data pribadi. Mengambil data pribadi dari situs web Tiongkok tanpa izin adalah pelanggaran besar.
- Data Security Law: Dipakai untuk menindak scraping yang merugikan pemilik data atau menimbulkan persaingan tidak sehat.
Wilayah Lain
- Kanada, Australia, APAC: Sebagian besar punya undang-undang anti-hacking dan aturan privasi yang mirip dengan Uni Eropa/Inggris. Selalu cek hukum lokal sebelum melakukan scraping.
Kesimpulan penting: Pilihan paling aman adalah mengambil data publik yang bukan data pribadi untuk penggunaan internal, dan selalu cek aturan di wilayah Anda (Thunderbit Blog).
Checklist Kepatuhan: Bagaimana Memastikan Data Scraping Anda Legal?
Sebelum mulai scraping, ikuti checklist kepatuhan ini:
- Baca Syarat Layanan Situs: Kalau ToS menyatakan “dilarang scraping,” pertimbangkan untuk berhenti atau minta izin terlebih dahulu (Thunderbit Blog).
- Fokus pada Data Publik: Jangan mengambil data yang berada di balik login atau paywall kecuali Anda punya otorisasi yang jelas.
- Periksa robots.txt: Kunjungi
site.com/robots.txtuntuk melihat apakah bot dilarang mengakses bagian tertentu. Walau tidak selalu mengikat secara hukum, tetap baik untuk menghormatinya. - Hindari Data Pribadi: Jangan scraping nama, email, atau PII lainnya kecuali Anda punya dasar hukum dan rencana privasi.
- Jangan Menyalin Konten Kreatif: Batasi pada fakta dan data. Memublikasikan ulang artikel, gambar, atau potongan besar konten bisa memicu klaim hak cipta.
- Gunakan API Resmi Jika Tersedia: Kalau situs menyediakan API, gunakan saja—lebih aman dan biasanya lebih stabil.
- Scraping dengan Lembut: Jangan membebani server. Jalankan dengan kecepatan seperti manusia dan hindari menerobos perlindungan teknis.
- Dokumentasikan Proses: Simpan catatan tentang data apa yang Anda ambil, kapan, dan untuk apa. Ini membantu kalau nanti muncul pertanyaan.
- Siap untuk Berhenti: Kalau Anda menerima surat cease-and-desist, segera hentikan scraping dan evaluasi ulang.
Praktik Scraping Patuh Aturan dari Thunderbit: Membuat Ekstraksi Data Lebih Aman dan Andal
Saat kami membangun Thunderbit, kepatuhan jadi fokus utama. Berikut cara Thunderbit membantu Anda tetap berada di jalur yang aman secara hukum:
- Scraping Berbasis Browser: Thunderbit hanya mengambil data yang terlihat di browser Anda—tanpa panggilan API tersembunyi, tanpa trik membobol login. Kalau Anda tidak bisa melihatnya, Thunderbit juga tidak bisa mengambilnya (Thunderbit Blog).
- Peringatan Bawaan: Kalau Anda mencoba scraping situs dengan kebijakan anti-scraping yang ketat, Thunderbit akan menampilkan peringatan. Rasanya seperti ada ahli kepatuhan yang ikut mengawasi.
- Ekstrak Satu Klik: AI Thunderbit memindai halaman dan merekomendasikan field yang relevan saja—membantu Anda menghindari pengambilan data sensitif atau tidak perlu secara tidak sengaja (Thunderbit Blog).
- Kecepatan Seperti Manusia: Baik saat scraping lokal maupun di cloud, Thunderbit mengatur ritmenya agar tidak membanjiri server.
- Data Tidak Disimpan di Server Kami: Data hasil scraping langsung dikirim ke Anda—Thunderbit tidak menyimpan salinannya, yang sangat membantu untuk kepatuhan privasi.
- Ekspor Ramah Kepatuhan: Ekspor data langsung ke Google Sheets, Excel, Airtable, atau Notion—cocok untuk penggunaan internal.
- Penanganan Subpage & Pagination: Thunderbit menavigasi situs seperti pengguna sungguhan, berpindah antar halaman dan subhalaman tanpa brute-force endpoint.
- Scheduled Scraping dengan Bijak: Atur scraping terjadwal dengan interval yang masuk akal, jadi tidak membombardir situs setiap menit.
- Dukungan Multi-Bahasa: UI Thunderbit kini tersedia dalam 55 bahasa di Chrome Web Store, sehingga prompt kepatuhan dan petunjuk field tetap mudah dipahami oleh tim non-Inggris (Chrome Web Store listing).
Singkatnya, Thunderbit “menanamkan kepatuhan ke dalam produknya,” sehingga Anda diarahkan untuk scraping secara bertanggung jawab—meskipun Anda bukan ahli hukum (Thunderbit Blog).
Coba Thunderbit untuk Web Scraping yang Patuh Aturan Pasang ekstensi Chrome gratis Thunderbit dan ekstrak data dari halaman publik mana pun dengan satu klik. Get Started Free
Data Scraping vs. Penggunaan Ulang Data: Di Mana Batas Hukumnya?
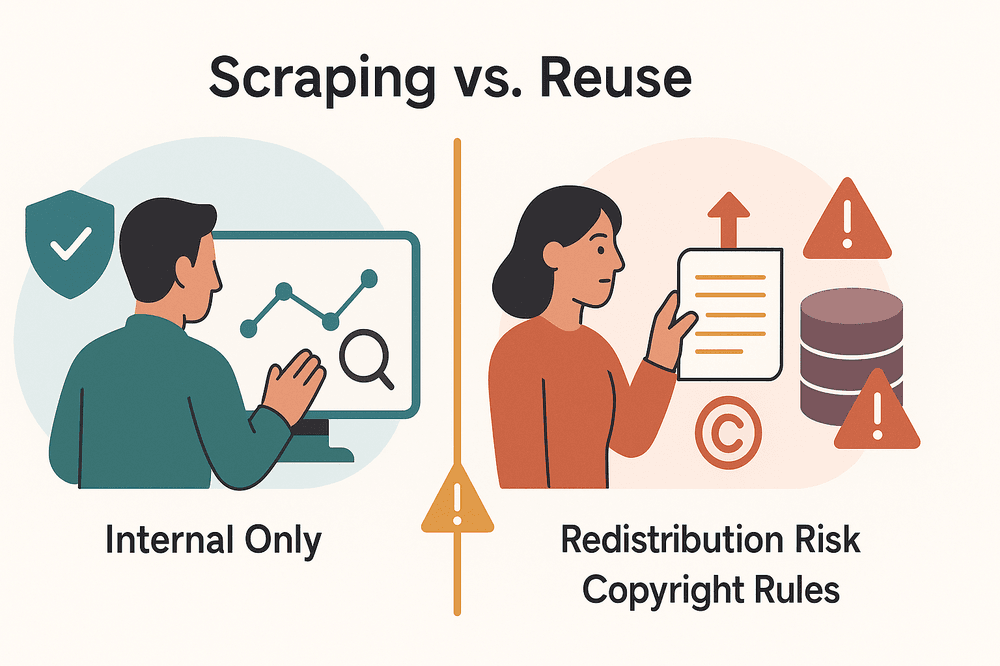 Scraping data untuk penggunaan internal sendiri itu satu hal, sementara memublikasikan ulang, menjual kembali, atau memakai ulang data tersebut untuk tujuan lain adalah hal yang berbeda. Di sinilah garis hukumnya jadi jauh lebih tegas:
- Penggunaan Internal: Scraping data publik untuk analisis internal (seperti lead penjualan atau pemantauan harga) umumnya aman—selama Anda tidak mengambil data pribadi atau melanggar aturan privasi.
- Redistribusi atau Penjualan Kembali: Memublikasikan ulang data hasil scraping (di situs Anda, dalam produk, atau dijual) dapat memicu klaim hak cipta, hak database, atau pelanggaran kontrak.
- Hak Cipta & Hak Database: Di AS, fakta tidak bisa dilindungi hak cipta, tetapi pemilihan atau penyusunan data mungkin bisa. Di Uni Eropa/Inggris, mengambil “bagian substansial” dari database bisa melanggar sui generis database rights.
- Fair Use: Hukum AS mengizinkan “fair use” dalam beberapa kasus (misalnya untuk komentar atau analisis), tetapi menyalin dan menempelkan potongan besar konten hampir tidak pernah dianggap fair use.
- Atribusi: Selalu cantumkan sumber kalau Anda memakai data hasil scraping secara publik—tetapi ingat, atribusi tidak otomatis membuatnya legal kalau Anda melanggar hak lain.
- Jangan Menjual Data Mentah: Menjual dataset hasil scraping tanpa modifikasi sangat berisiko. Gunakan data itu untuk menghasilkan insight, bukan sebagai produk mentah.
Tips cepat: Pakai data hasil scraping untuk intelijen internal dan pengambilan keputusan. Kalau harus dibagikan ke pihak luar, agregasikan atau ubah dulu bentuknya, dan selalu cek apakah Anda memerlukan izin (Thunderbit Blog).
Studi Kasus Industri: Cara Meminimalkan Risiko Hukum
Mari lihat beberapa kasus nyata—karena tak ada pelajaran kepatuhan yang lebih kuat daripada melihat apa yang salah pada orang lain:
LinkedIn vs. hiQ Labs
- Yang terjadi: hiQ Labs melakukan scraping profil LinkedIn yang publik untuk membangun analitik mengenai perputaran karyawan. LinkedIn berusaha memblokir, tetapi pengadilan memutuskan bahwa scraping data publik bukan pelanggaran CFAA.
- Pelajaran: Scraping data publik bisa dibela secara hukum di AS, tetapi Anda tetap harus waspada terhadap syarat layanan dan klaim privasi (California Lawyers Association).
eBay vs. Bidder’s Edge
- Yang terjadi: Bidder’s Edge melakukan scraping listing lelang eBay secara agresif (100.000 permintaan/hari), melanggar terms dan robots.txt eBay. Pengadilan mengeluarkan injunction atas dasar “trespass to chattels.”
- Pelajaran: Bahkan scraping data publik bisa melanggar hukum kalau dilakukan terlalu agresif atau melanggar aturan situs yang eksplisit (Wikipedia).
Facebook (Meta) vs. Power Ventures
- Yang terjadi: Power Ventures melakukan scraping data Facebook dengan persetujuan pengguna, tetapi setelah Facebook mencabut akses dan memblokir IP mereka, Power Ventures tetap melanjutkan scraping. Pengadilan memutuskan itu sebagai “akses tanpa izin.”
- Pelajaran: Kalau pemilik situs sudah meminta Anda berhenti, Anda harus berhenti—kalau tidak, Anda berisiko melanggar undang-undang anti-hacking.
Kisah Sukses Kepatuhan
Banyak situs perbandingan harga di Uni Eropa beroperasi secara legal dengan hanya mengambil data faktual, menghormati opt-out, dan tidak menyalin seluruh database. Tidak adanya gugatan terhadap perusahaan-perusahaan ini menunjukkan bahwa tetap pada data publik yang bukan data pribadi dan mematuhi aturan situs memang berhasil.
Bagaimana Thunderbit Membantu
Peringatan bawaan, rate limit, dan pendekatan berbasis browser dari Thunderbit bisa membantu mencegah banyak kesalahan hukum semacam ini—dengan memberi sinyal pada situs yang berisiko dan secara default menerapkan scraping yang sopan.
Checklist Mandiri Kepatuhan Data Scraping untuk Skenario Bisnis
Berikut checklist audit mandiri yang praktis untuk proyek scraping Anda berikutnya:
- Apakah datanya publik? (Tidak perlu login)
- Apa kata syarat situs? (Ada klausul anti-scraping?)
- Sudah cek robots.txt? (Apakah bagian target Anda dilarang?)
- Apakah Anda mengambil data pribadi? (Kalau ya, apakah ada rencana privasi?)
- Apakah Anda mengambil sebagian besar situs? (Hindari menyalin seluruh database)
- Apa tujuan Anda? (Internal use = lebih aman; reuse publik = lebih berisiko)
- Apakah scraping dilakukan dengan lembut? (Kecepatan seperti manusia, tanpa trik menghindari proteksi)
- Sudah cek apakah ada API? (Gunakan jika tersedia)
- Apakah Anda siap berhenti kalau diminta? (Punya rencana untuk cease-and-desist)
- Bagaimana data akan disimpan dan diamankan? (Batasi akses, jaga privasi)
- Apakah prosesnya didokumentasikan? (Simpan catatan untuk kepatuhan)
Kalau Anda menjawab “tidak” atau masih ragu pada salah satu poin di atas, berhenti dulu dan pastikan semuanya jelas sebelum lanjut (Thunderbit Blog).
Contoh Alur Kerja Data Scraping yang Patuh Aturan dengan Thunderbit
 Mari kita lihat alur kerja Thunderbit yang umum dan ramah kepatuhan:
- Pengecekan awal: Buka robots.txt dan terms of service situs. Tidak ada bahasa anti-scraping? Lanjutkan.
- Buka Thunderbit: Kunjungi halaman target dan jalankan Thunderbit Chrome Extension.
- Ekstrak Satu Klik: Biarkan AI Thunderbit merekomendasikan field yang relevan dan tidak sensitif. Pastikan tidak ada data pribadi kecuali Anda punya dasar hukum.
- Sesuaikan field: Atur kolom dan tipe data sesuai kebutuhan—ambil hanya yang benar-benar diperlukan.
- Scrape: Klik “Scrape.” Thunderbit mengekstrak data dengan tempo seperti manusia, mengikuti struktur situs.
- Scraping subpage: Kalau perlu, gunakan fitur subpage Thunderbit untuk memperkaya data—tetap hanya untuk informasi publik.
- Ekspor: Kirim data langsung ke Google Sheets, Excel, Airtable, atau Notion untuk analisis internal.
- Jadwalkan (opsional): Atur scraping terjadwal dengan interval yang wajar—jangan terlalu sering.
- Dokumentasikan: Simpan catatan tentang data yang diambil, kapan, dan untuk apa.
Antarmuka Thunderbit akan memberi prompt di setiap langkah kalau ada pertimbangan kepatuhan—jadi Anda tidak berjalan dalam gelap.
Pelajari Lebih Lanjut Fitur Kepatuhan Thunderbit Paket gratis mencakup 6 halaman per bulan, tanpa kartu kredit — cara berisiko rendah untuk mencoba ekstraksi di halaman publik. Get Started Free
Kesimpulan & Rekomendasi Utama: Mengoptimalkan Nilai Data dengan Aman dan Patuh Aturan
Web scraping adalah alat yang sangat kuat untuk pertumbuhan bisnis—tetapi bukan berarti bebas tanpa batas. Lanskap hukumnya kompleks, namun prinsip utamanya cukup jelas:
- Ambil data publik yang bukan data pribadi untuk penggunaan internal kalau memungkinkan.
- Selalu cek syarat situs, robots.txt, dan hukum yang relevan sebelum mulai.
- Hindari scraping data pribadi atau konten kreatif kecuali Anda punya dasar hukum dan rencana privasi.
- Gunakan alat yang ramah kepatuhan seperti Thunderbit untuk memandu workflow Anda dan meminimalkan risiko.
- Dokumentasikan proses Anda dan siap berhenti kalau diminta.
Dengan membiasakan kepatuhan, Anda bisa memaksimalkan nilai data web—tanpa repot masalah hukum. Dan kalau Anda ingin melihat betapa mudahnya scraping yang patuh aturan, coba Thunderbit. Tim legal Anda (dan diri Anda di masa depan) pasti berterima kasih.
Untuk pembahasan lebih mendalam tentang web scraping, kepatuhan, dan otomatisasi, kunjungi Thunderbit Blog.
Coba Agentic Web Scraper untuk Ekstraksi Data yang Patuh Aturan Get Started Free
FAQ
1. Apakah legal mengambil data dari semua website?
Tidak selalu. Mengambil data publik yang bukan data pribadi untuk penggunaan internal umumnya legal di banyak wilayah, tetapi scraping data pribadi, konten berhak cipta, atau data yang berada di balik login bisa berisiko atau bahkan jelas ilegal. Selalu periksa syarat situs dan hukum setempat sebelum scraping (Thunderbit Blog).
2. Apa perbedaan antara scraping dan menggunakan ulang data?
Scraping adalah proses mengumpulkan data; menggunakan ulang berarti memublikasikan, menjual, atau mendistribusikan data tersebut. Penggunaan internal jauh lebih aman. Memublikasikan ulang atau menjual data hasil scraping dapat memicu klaim hak cipta, hak database, atau pelanggaran kontrak (Thunderbit Blog).
3. Bagaimana Thunderbit membantu memastikan kepatuhan?
Thunderbit hanya mengambil apa yang terlihat di browser Anda, memberi peringatan tentang situs berisiko, menyarankan field yang relevan dan tidak sensitif, serta mengatur permintaan agar tidak membebani server. Data Anda juga tidak disimpan, dan opsi ekspornya dirancang untuk penggunaan internal (Thunderbit Blog).
4. Apa yang harus saya lakukan kalau menerima surat cease-and-desist?
Segera hentikan scraping dan evaluasi ulang proyek Anda. Melanjutkan setelah ada permintaan langsung untuk berhenti bisa mengubah area abu-abu hukum menjadi pelanggaran nyata terhadap undang-undang anti-hacking atau ketentuan kontrak (Thunderbit Blog).
5. Apakah saya boleh mengambil data pribadi kalau datanya publik?
Tidak tanpa dasar hukum yang sah. Hukum privasi seperti GDPR dan CCPA tetap berlaku meskipun data pribadi itu publik. Anda memerlukan persetujuan atau legitimate interest yang kuat, dan Anda harus menangani datanya secara bertanggung jawab (Thunderbit Blog).
Panduan ini hanya untuk tujuan informasi dan bukan merupakan nasihat hukum. Untuk proyek yang kompleks atau bernilai tinggi, konsultasikan dengan pengacara yang memahami hukum data dan privasi di wilayah Anda.
Baca Selengkapnya




