
Saat pertama kali saya mulai membangun alat otomasi, saya tak pernah membayangkan akan menghabiskan begitu banyak waktu mengintip isi website, mengutak-atik HTML mereka seperti arkeolog digital. Tapi inilah kenyataannya di tahun 2026: web masih jadi gudang data terbesar dan paling berantakan di dunia — hanya saja sekarang separuhnya tersembunyi di balik JavaScript, pemuatan dinamis, dan pertahanan bot yang makin agresif. Entah Anda seorang profesional sales, operator ecommerce, atau sekadar coder yang penasaran, web scraping sudah jadi senjata rahasia untuk mengubah halaman web publik menjadi emas bisnis yang bisa langsung dipakai. Dan kalau Anda seperti saya, Anda mungkin pernah bertanya: “Apa benar saya bisa membangun web scraper sendiri hanya dengan JavaScript?” Jawabannya: ya, bisa. Tapi apakah sebaiknya? Mari kita bahas bersama.
Di panduan ini, saya akan menunjukkan cara beralih dari nol hingga punya web scraper bertenaga JavaScript sendiri—mulai dari parsing HTML statis sampai menangani situs dinamis yang penuh JavaScript. Dan karena saya sudah melihat dua sisi medan ini, saya juga akan berbagi kapan masuk akal untuk meninggalkan coding dan membiarkan alat berbasis AI seperti Thunderbit mengerjakan beban beratnya. Siap turun langsung ke lapangan (secara digital)? Yuk, mulai.
Apa itu Web Scraping Menggunakan JavaScript?
Mari mulai dari dasar. Web scraping adalah proses otomatis untuk mengekstrak informasi dari website. Alih-alih menyalin dan menempel data secara manual (jujur saja, itu hampir semenyenangkan menonton cat mengering), Anda menulis program—disebut “scraper”—yang mengambil halaman web dan menarik data yang Anda butuhkan.
Lalu di mana peran JavaScript? Nah, JavaScript adalah bahasa web. Bahasa ini berjalan di browser, menggerakkan situs interaktif, dan berkat Node.js, juga bisa dijalankan di laptop atau server Anda. Saat kita membahas web scraping menggunakan JavaScript, biasanya yang dimaksud adalah menulis script di Node.js yang:
- Mengambil halaman web (menggunakan HTTP request)
- Mem-parsing HTML untuk menemukan data yang diinginkan
- Terkadang, mengotomatisasi browser sungguhan untuk menangani situs yang memuat konten secara dinamis
Ada dua jenis utama halaman web dalam konteks ini:
- Halaman statis: Datanya sudah langsung ada di HTML. Bayangkan halaman daftar produk sederhana.
- Halaman dinamis: Datanya baru muncul setelah halaman menjalankan JavaScript-nya sendiri—misalnya feed infinite scroll atau dashboard yang memuat data lewat AJAX.
JavaScript, dengan ekosistem library yang luas, bisa menangani keduanya. Untuk halaman statis, Anda bisa langsung mengambil dan mem-parsing HTML. Untuk halaman dinamis, Anda perlu mengotomatisasi browser agar bisa “melihat” apa yang dilihat pengguna sungguhan.
Mengapa Web Scraping Menggunakan JavaScript Penting untuk Bisnis
Alat Web Scraping Otomatis Terbaik Get Started Free
Kalau jujur, tidak ada yang melakukan scraping website hanya demi sensasi semata (kecuali mungkin saya pada Sabtu malam). Bisnis melakukan scraping karena ini jalan pintas menuju insight, leads, dan keunggulan kompetitif. Inilah alasannya penting:
- Hemat Waktu: Scraper otomatis bisa mengumpulkan ribuan titik data dalam hitungan menit, menghemat ratusan jam kerja tim dibanding copy-paste manual (BrowserCat).
- Keputusan Lebih Baik: Data real-time memungkinkan Anda merespons perubahan pasar, menyesuaikan harga, atau menangkap tren sebelum pesaing Anda (BrowserCat).
- Akurasi: Ekstraksi otomatis mengurangi kesalahan manusia, sehingga dataset Anda lebih bersih dan andal (Thunderbit Blog).
- Wawasan Kompetitif: Lacak harga pesaing, pantau ulasan, atau analisis tren pasar—scraping mengubah web terbuka menjadi laboratorium riset pribadi Anda.
- Lead Generation: Bangun daftar prospek, perkaya data CRM, atau temukan peluang sales baru—semua berjalan otomatis.
Berikut tabel ringkas untuk merangkum dampak bisnisnya:
| Use Case | Dampak Bisnis (Contoh) |
|---|---|
| Pelacakan Harga Kompetitor | Pendapatan meningkat lewat optimasi harga. John Lewis melihat kenaikan penjualan 4% setelah memakai scraping untuk memantau harga pesaing. |
| Riset Ekspansi Pasar | Strategi yang lebih tepat sasaran untuk tiap pasar, sehingga mendorong pertumbuhan. ASOS melipatgandakan penjualan internasional dengan memanfaatkan data pasar lokal hasil scraping. |
| Otomasi Proses | Mengurangi beban kerja manual secara drastis. Sebuah scraper otomatis menangani 12.000+ entri dalam satu minggu, menghemat ratusan jam kerja. |
Dan ini statistik yang selalu membuat saya takjub: 82% perusahaan ecommerce menggunakan web scraping untuk pengumpulan data publik, dan 36% firma investasi menggunakannya untuk riset. Ini bukan hobi niche—ini sudah arus utama bisnis.
Menyiapkan Lingkungan Web Scraping Anda dengan JavaScript
Oke, mari praktis. Kalau Anda ingin membangun scraper sendiri, Anda perlu menyiapkan lingkungan kerja. Begini cara saya melakukannya:
-
Install Node.js (dan npm)
Buka situs resmi Node.js dan ambil versi LTS. Ini memberi Anda Node.js (runtime) dan npm (package manager).
-
Cek instalasi Anda:
node -v
npm -v
-
-
Buat Folder Proyek
Buat direktori baru untuk proyek Anda (misalnya,
web-scraper-demo), buka terminal di sana, lalu jalankan:npm init -yIni akan membuat file
package.jsonuntuk mengelola dependency Anda. -
Install Library Esensial
Berikut paket awal Anda:
- Axios: HTTP client untuk mengambil halaman web
npm install axios - Cheerio: parser HTML mirip jQuery
npm install cheerio - Puppeteer: otomasi Chrome tanpa antarmuka (untuk situs dinamis)
npm install puppeteer - Playwright: otomasi multi-browser (Chromium, Firefox, WebKit)
npm install playwrightLalu jalankan:
npx playwright install(mengunduh binary browser)
- Axios: HTTP client untuk mengambil halaman web
Berikut perbandingan singkat alat-alat ini:
| Library | Tujuan & Kelebihan | Contoh Use Case |
|---|---|---|
| Axios | HTTP client untuk membuat request. Ringan. Hanya untuk halaman statis. | Mengambil HTML mentah dari artikel berita atau halaman produk. |
| Cheerio | Parser DOM, dengan selector mirip jQuery. Cepat untuk konten statis. | Mengekstrak semua judul atau link dari HTML statis. |
| Puppeteer | Otomasi Chrome tanpa antarmuka. Menjalankan JavaScript halaman, bisa mengotomatisasi klik dan screenshot. | Scrape aplikasi web modern, situs yang dilindungi login. |
| Playwright | Otomasi multi-browser, fitur auto-wait, tangguh untuk skenario kompleks. | Scrape situs di engine Chrome, Firefox, dan Safari. |
Untuk halaman statis, Axios + Cheerio adalah pilihan utama. Untuk apa pun yang dinamis atau interaktif, Puppeteer atau Playwright adalah jalan yang tepat (ZenRows).
Membangun Web Scraper Sederhana Menggunakan JavaScript
Ayo kita mulai dan membangun scraper dasar. Misalnya, Anda ingin mengambil judul dan harga buku dari situs statis seperti “Books to Scrape” (sandbox yang bagus untuk belajar).
Langkah 1: Periksa halaman di browser Anda. Anda akan melihat setiap buku berada di dalam <article class="product_pod">, dengan judul di <h3> dan harga di <p class="price_color">.
Langkah 2: Berikut kodenya:
const axios = require('axios');
const cheerio = require('cheerio');

(async function scrapeBooks() {
  try {
    // 1. Ambil HTML halaman
    const { data: html } = await axios.get('http://books.toscrape.com/');
    // 2. Muat HTML ke Cheerio
    const $ = cheerio.load(html);
    // 3. Pilih dan ekstrak data yang diinginkan
    const books = [];
    $('.product_pod').each((_, element) => {
      const title = $(element).find('h3 a').attr('title');
      const price = $(element).find('.price_color').text();
      books.push({ title, price });
    });
    // 4. Tampilkan hasil
    console.log(books);
  } catch (error) {
    console.error('Scraping gagal:', error);
  }
})();
Apa yang terjadi di sini?
- Ambil: Gunakan Axios untuk mendapatkan HTML.
- Parse: Cheerio memuat HTML dan memungkinkan Anda memakai selector CSS.
- Ekstrak: Untuk setiap
.product_pod, ambil judul dan harga. - Output: Cetak array objek buku.
Tips untuk Selector:
Gunakan DevTools browser Anda (klik kanan → Inspect) untuk menemukan class atau tag yang unik. Cheerio mendukung sebagian besar selector CSS, jadi Anda bisa menarget elemen secara presisi.
Parsing dan Mengekstrak Data
Beberapa tips pro dari petualangan scraping saya sendiri:
- Teks vs Atribut: Gunakan
.text()untuk teks di dalam elemen,.attr('attributeName')untuk atribut (sepertititleatauhref). - Tipe Data: Bersihkan data saat mengekstraknya. Hapus simbol mata uang, parse angka, format tanggal.
- Data Hilang: Selalu cek apakah elemen ada sebelum mengekstrak, agar terhindar dari error.
- Mapping: Gunakan
.each()atau.map()untuk mengiterasi elemen dan membangun array hasil Anda.
Begitu data sudah didapat, Anda bisa menuliskannya ke CSV, JSON, atau bahkan database. Dunia ada di tangan Anda (atau setidaknya spreadsheet Anda).
Scraping Website Dinamis dengan JavaScript: Puppeteer & Playwright
Sekarang, mari tangani bagian yang lebih sulit: website dinamis. Ini adalah halaman yang datanya baru muncul setelah JavaScript milik situs itu sendiri dijalankan. Bayangkan feed sosial, dashboard, atau situs dengan tombol “Load More”.
Mengapa memakai browser tanpa antarmuka?
HTTP request biasa tidak cukup—Anda hanya akan mendapat HTML kerangka. Browser tanpa antarmuka seperti Puppeteer dan Playwright memungkinkan Anda:
- Menjalankan browser sungguhan (tanpa GUI)
- Menjalankan JavaScript milik situs
- Menunggu konten selesai dimuat
- Mengekstrak data yang sudah dirender
Contoh dengan Puppeteer:
const puppeteer = require('puppeteer');

(async function scrapeQuotes() {
  const browser = await puppeteer.launch({ headless: true });
  const page = await browser.newPage();

  await page.goto('https://quotes.toscrape.com/js/', { waitUntil: 'networkidle0' });
  await page.waitForSelector('.quote');  // tunggu sampai kutipan muncul

  const quotesData = await page.$$eval('.quote', quoteElements => {
    return quoteElements.map(q => {
      const text = q.querySelector('.text')?.innerText;
      const author = q.querySelector('.author')?.innerText;
      return { text, author };
    });
  });

  console.log(quotesData);
  await browser.close();
})();
Apa yang terjadi?
- Menjalankan Chrome tanpa antarmuka
- Buka halaman dan tunggu aktivitas jaringan stabil
- Tunggu selector
.quotemuncul - Ekstrak kutipan dan penulis dari DOM
Playwright bekerja hampir sama, tetapi mendukung banyak browser (Chromium, Firefox, WebKit) dan memiliki beberapa fitur auto-wait yang praktis (Apify Blog).
Memilih Alat yang Tepat: Puppeteer vs Playwright
Puppeteer dan Playwright sama-sama sangat bagus untuk scraping dinamis, tetapi begini cara saya melihat pilihannya:
- Puppeteer:
- Hanya Chrome/Chromium (dengan sedikit dukungan Firefox)
- Sederhana, plug-and-play untuk scraping berbasis Chrome
- Komunitas besar, banyak plugin (seperti mode stealth)
- Playwright:
- Multi-browser (Chromium, Firefox, WebKit/Safari)
- Dukungan resmi untuk beberapa bahasa (JS, Python, .NET, Java)
- Auto-wait untuk elemen, mudah menangani banyak halaman/konteks
- Sangat bagus untuk skenario kompleks atau lintas browser
Kalau Anda hanya perlu scrape satu situs dan Chrome sudah cukup, Puppeteer cepat dan mudah. Kalau Anda butuh cakupan lintas browser, auto-wait, atau Anda sedang menghubungkan scraping ke sebuah AI agent (Playwright kini membawa server MCP resmi, jadi agent bisa mengendalikannya langsung), Playwright adalah default yang lebih aman untuk proyek baru di 2026 (Apify Blog).
Mengatasi Tantangan Umum dalam Web Scraping Menggunakan JavaScript
Scrape data dari website apa pun dengan AI Get Started Free
Nah, di sinilah bagian serunya dimulai (dan dengan seru, maksud saya “kenapa scraper saya tiba-tiba rusak jam 2 pagi?”). Web scraping bukan cuma soal kode—tetapi juga tentang menavigasi rintangan:
- Pemblokiran IP & Rate Limiting: Terlalu banyak request dari satu IP? Anda bisa diblokir. Gunakan proxy dan rotasi (Apify Blog).
- CAPTCHA & Deteksi Bot: Situs memakai CAPTCHA, fingerprinting, dan honeypot. Perlambat request Anda, gunakan stealth plugin, atau pemecah CAPTCHA pihak ketiga.
- Konten Dinamis & AJAX: Kadang, Anda bisa melewati browser dan langsung memanggil API latar belakang situs tersebut (jika bisa menemukannya di log jaringan).
- Perubahan Struktur Halaman: Situs sering memperbarui HTML mereka. Jaga selector tetap modular dan siap untuk diubah.
- Bottleneck Performa: Scraping ribuan halaman? Gunakan concurrency, tapi jangan membanjiri mesin Anda (atau situs target).
Best Practice:
- Batasi request Anda (tambahkan jeda)
- Gunakan header user-agent yang realistis
- Pakai proxy untuk scraping skala besar
- Catat semua log (supaya Anda tahu kapan dan mengapa sesuatu rusak)
- Patuhi robots.txt dan ketentuan layanan
Dan ingat: scraping adalah target yang terus bergerak. Situs berkembang, teknologi anti-bot makin pintar, dan Anda perlu menjaga script tetap terbaru (Thunderbit Blog).
Tips Troubleshooting dan Pemeliharaan
- Modularkan selector: Simpan selector CSS Anda di satu tempat agar mudah diperbarui.
- Logging yang deskriptif: Catat progres dan error agar masalah cepat terlihat.
- Debug dalam mode headful: Jalankan otomasi browser Anda dengan GUI agar bisa melihat apa yang terjadi.
- Penanganan error: Gunakan try/catch dan retry untuk ketahanan.
- Uji secara rutin: Pasang alert jika scraper tiba-tiba mengembalikan nol hasil.
- Kontrol versi: Gunakan Git untuk melacak perubahan dan rollback jika perlu.
Bahkan dengan semua ini, memelihara puluhan scraper kustom bisa menjadi pekerjaan yang melelahkan. Itulah sebabnya semakin banyak tim yang melirik solusi AI tanpa coding.
Kapan Mempertimbangkan Alternatif No-Code: Thunderbit vs Scraping JavaScript
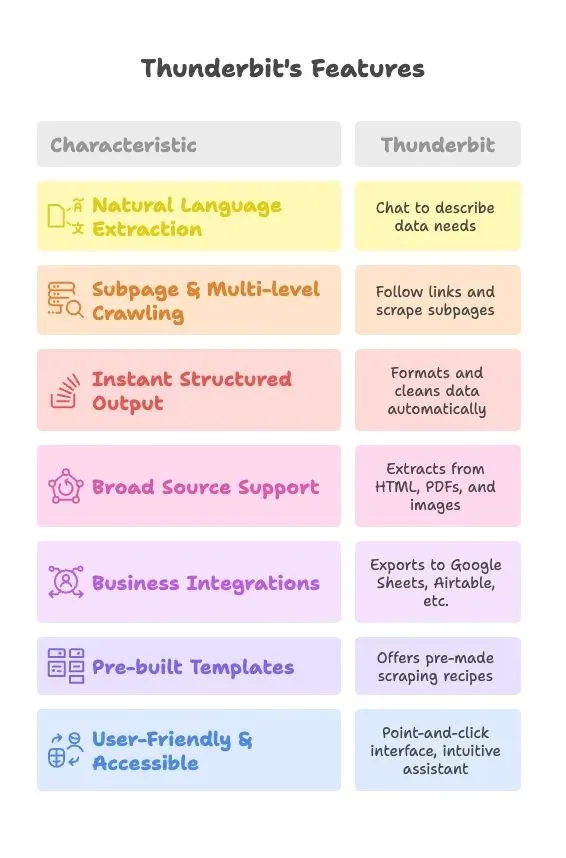
Mari jujur: tidak semua orang ingin menghabiskan akhir pekan untuk debugging selector atau berantem dengan proxy. Di sinilah Thunderbit hadir, ekstensi Chrome web scraper bertenaga AI kami.
Bagaimana cara kerja Thunderbit?
- Install ekstensi Chrome
- Buka halaman apa pun, klik “AI Suggest Fields”
- AI Thunderbit membaca halaman, menyarankan kolom, dan mengekstrak data
- Menangani halaman dinamis, subpage, dokumen, PDF, dan lainnya
- Ekspor langsung ke Google Sheets, Airtable, Notion, atau CSV—tanpa perlu coding
Berikut perbandingan berdampingan:
| Aspek | Scraping JavaScript (Kode Sendiri) | Thunderbit (Alat AI No-Code) |
|---|---|---|
| Waktu Setup | Beberapa jam per scraper (coding, debugging, setup environment) | Beberapa menit per situs—install ekstensi, klik, lalu jalan |
| Kurva Belajar | Butuh JS/Node, HTML/CSS, library scraping, debugging | Tidak perlu coding, antarmuka point-and-click, AI membimbing Anda |
| Pemeliharaan | Anda memperbaiki script saat situs berubah (upaya engineering berkelanjutan) | AI menyesuaikan perubahan layout, pemeliharaan minimal bagi pengguna |
| Kolaborasi/Sharing | Berbagi kode atau CSV, non-dev mungkin kesulitan menggunakannya | Ekspor ke Google Sheets, Airtable, Notion; mudah dibagikan ke tim |
AI Thunderbit bahkan bisa meringkas, mengkategorikan, atau menerjemahkan data saat scraping—sesuatu yang akan memerlukan coding ekstra jika Anda membuatnya sendiri (Thunderbit Docs).
Skenario Nyata: Pendekatan Mana yang Cocok untuk Tim Anda?
-
Skenario 1: Developer, Proyek Kompleks
Anda sedang membangun produk yang mengumpulkan postingan lowongan kerja dari lima situs berbeda, membutuhkan logika khusus, dan berjalan di server Anda sendiri. Menulis scraper sendiri masuk akal—Anda mendapat kontrol penuh, bisa mengoptimalkan skala, dan mengintegrasikannya langsung dengan backend.
-
Skenario 2: Tim Bisnis, Butuh Data Cepat
Anda seorang marketing manager yang butuh daftar leads dari beberapa direktori—hari ini juga. Tidak punya skill coding, dan tidak ada waktu untuk siklus dev. Thunderbit sangat cocok: klik, ekspor ke Google Sheets, selesai dalam satu jam (Thunderbit Blog).
-
Skenario 3: Pendekatan Hibrida
Kadang, tim memakai Thunderbit untuk prototipe atau menangani tugas cepat, lalu berinvestasi di kode kustom jika ternyata menjadi kebutuhan jangka panjang. Atau, developer membangun scraper awal, lalu menyerahkan scraping lanjutan ke non-dev lewat template Thunderbit.
Bagaimana memilih?
- Jika Anda butuh kustomisasi mendalam, punya skill teknis, atau ingin kontrol penuh—bangun dengan kode.
- Jika Anda menginginkan kecepatan, kemudahan, dan kolaborasi tim—Thunderbit sulit dikalahkan.
- Banyak tim memakai keduanya: kode untuk sistem inti, Thunderbit untuk scraping ad hoc atau yang dipimpin tim bisnis.
Jalur Ketiga: AI Coding Agent dan Browser Agent
Ada titik tengah yang sebenarnya belum ada saat sebagian besar tutorial scraping JavaScript ditulis. Ada dua jenis yang layak diketahui:
- AI coding agent (Claude Code, OpenAI Codex CLI, Cursor) — Anda menjelaskan halaman dan data yang Anda inginkan dengan bahasa sehari-hari, lalu mereka menulis script Axios/Cheerio/Playwright untuk Anda. Kode tetap milik Anda, batas anti-bot tetap harus Anda hadapi, tetapi bagian menulis menyusut dari jam menjadi beberapa menit. Berguna saat Anda ingin script sungguhan di repo Anda, bukan alat black-box.
- Browser-driving agents (Browser Use, Playwright MCP, Skyvern) — alih-alih menghasilkan script, agent itu sendiri yang menavigasi halaman. Anda menulis prompt seperti "log in, buka orders, export 30 hari terakhir sebagai CSV" dan agent mencari tahu klik yang diperlukan. Lebih cocok untuk alur yang melibatkan login, navigasi multi-langkah, atau halaman yang sering berubah layout, karena agent menalar apa yang dilihatnya alih-alih bergantung pada selector tetap.
Tidak satu pun menghapus batasan yang membosankan — rate limit, ketentuan layanan, CAPTCHA, dan blok IP tetap jadi masalah Anda. Tapi untuk kasus "saya cuma butuh data ini sekali" atau "selector-nya terus rusak", pendekatan ini layak dicoba sebelum Anda berkomitmen memelihara satu lagi script puppeteer.launch().
Kalau Anda lebih suka melewati lapisan agent sepenuhnya dan langsung klik-klik, di situlah Thunderbit berperan — lihat perbandingan di atas.
Coba Ekstensi Chrome Thunderbit untuk Scraping Tanpa Kode
Ekspor Data, Otomasi, dan Kolaborasi: Melangkah Lebih Jauh dari Scraping Dasar
Mengumpulkan data hanyalah awal. Apa yang Anda lakukan setelahnya justru yang penting.
Dengan scraper JavaScript:
- Tulis data ke CSV/JSON menggunakan modul
fsmilik Node - Masukkan ke database atau panggil API (seperti Google Sheets API)
- Jadwalkan dengan cron job atau cloud function
- Berbagi memerlukan pengiriman file atau membangun dashboard
Dengan Thunderbit:
- Ekspor satu klik ke Google Sheets, Airtable, Notion, atau CSV (Thunderbit Docs)
- Penjadwalan bawaan—atur sekali lalu biarkan, data diperbarui otomatis
- Anggota tim dapat memakai template bersama, hasilnya langsung kolaboratif
- Post-processing berbasis AI (meringkas, mengkategorikan, menerjemahkan) sudah tersedia bawaan
Bayangkan scraping harga kompetitor setiap hari dan Google Sheet Anda diperbarui setiap pagi—tanpa coding, tanpa langkah manual. Itulah alur kerja yang dibuka oleh Thunderbit.
Poin Penting: Web Scraping Menggunakan JavaScript untuk Kesuksesan Bisnis
Mari tutup dengan pelajaran besarnya:
- JavaScript adalah alat scraping yang kuat: Dengan Node.js, Axios, Cheerio, Puppeteer, dan Playwright, Anda bisa scrape hampir semua situs (Apify Blog).
- Nilai bisnis adalah tujuan utamanya: Scraping tentang keputusan yang lebih baik, workflow yang lebih cepat, dan keunggulan kompetitif (Keboola).
- Pilih pendekatan yang tepat: Gunakan alat ringan untuk halaman statis, browser tanpa antarmuka untuk halaman dinamis.
- Antisipasi tantangan: Ban IP, CAPTCHA, dan perubahan situs adalah bagian dari permainan—gunakan proxy, taktik stealth, dan jaga kode tetap modular.
- Pemeliharaan itu nyata: Siap untuk memperbarui script, atau pertimbangkan alat berbasis AI yang beradaptasi otomatis (Thunderbit Blog).
- Alat no-code seperti Thunderbit mempercepat hasil: Untuk non-dev atau kebutuhan bisnis yang cepat, AI Thunderbit, scraping subpage, dan ekspor satu klik membuat scraping mudah diakses semua orang.
- Integrasi dan kolaborasi itu penting: Pastikan data Anda mengalir ke alat yang dipakai tim—Google Sheets, Airtable, Notion, atau CRM Anda.
Pemikiran terakhir:
Web penuh dengan data—kalau Anda tahu cara mengambilnya, Anda sudah selangkah lebih depan. Entah Anda membangun scraper sendiri di JavaScript atau membiarkan AI Thunderbit mengerjakan beban beratnya, kuncinya adalah mengubah data mentah itu menjadi nilai bisnis. Coba kedua pendekatan, lihat mana yang cocok dengan alur kerja Anda, dan ingat: scraper terbaik adalah yang memberi Anda jawaban yang Anda butuhkan, saat Anda membutuhkannya.
Penasaran ingin mencoba Thunderbit? Unduh ekstensi Chrome di sini dan lihat betapa mudahnya web scraping. Ingin mendalami lebih jauh? Lihat Thunderbit Blog untuk panduan, tips, dan cerita lain dari garis depan otomasi data.
Jelajahi AI Web Scraper Thunderbit
FAQ
1. Apa itu web scraping JavaScript dan bagaimana cara kerjanya?
Web scraping JavaScript melibatkan penggunaan alat seperti Node.js, Axios, Cheerio, Puppeteer, atau Playwright untuk mengambil dan mengekstrak data dari website secara terprogram. Halaman statis bisa di-scrape menggunakan HTTP request dan parser HTML, sedangkan halaman dinamis memerlukan browser tanpa antarmuka untuk mensimulasikan interaksi pengguna sungguhan.
2. Mengapa bisnis perlu peduli pada web scraping dengan JavaScript?
Web scraping membantu bisnis menghemat waktu, mengurangi kerja manual, meningkatkan akurasi data, dan mendapatkan insight kompetitif secara real-time. Ini mendukung use case seperti lead generation, pelacakan harga, riset pasar, dan otomasi sales—menjadikannya alat yang berharga untuk pengambilan keputusan berbasis data.
3. Apa saja alat dan library utama yang digunakan dalam scraping JavaScript?
- Axios: Untuk HTTP request ke halaman statis.
- Cheerio: Untuk mem-parsing dan meng-query HTML statis.
- Puppeteer: Untuk mengotomatisasi Chrome dan mengekstrak konten dinamis.
- Playwright: Alat otomasi multi-browser dengan kemampuan scraping yang tangguh.
4. Kapan saya sebaiknya menggunakan Thunderbit daripada membangun scraper dengan JavaScript?
Gunakan Thunderbit saat Anda menginginkan scraping cepat tanpa kode, tanpa menulis atau memelihara script. Ini ideal untuk tim bisnis, proyek cepat, dan workflow kolaboratif. Thunderbit menangani konten dinamis, subpage, dan ekspor langsung ke alat seperti Google Sheets dan Airtable.
5. Apa tantangan terbesar dalam web scraping JavaScript dan bagaimana cara mengatasinya?
Tantangan umum meliputi ban IP, CAPTCHA, perubahan struktur halaman, dan batas performa. Anda bisa menguranginya dengan memakai proxy, stealth plugin, otomasi browser, kode modular, dan logika retry. Sebagai alternatif, alat seperti Thunderbit dapat melewati banyak hambatan ini secara otomatis.
6. Bagaimana dengan AI coding agent seperti Claude Code atau browser agent seperti Browser Use — apakah mereka menggantikan scraper JavaScript?
Tidak sepenuhnya, tetapi mereka mengubah alur kerja. AI coding agent (Claude Code, Codex CLI, Cursor) dapat menghasilkan script Axios/Cheerio/Playwright dari deskripsi bahasa sehari-hari — Anda tetap menjalankan kodenya, dan Anda tetap harus menangani anti-bot serta rate limit sendiri. Browser agent (Browser Use, Playwright MCP) melangkah lebih jauh dengan benar-benar mengendalikan browser lewat instruksi bahasa alami, yang berguna untuk alur login atau multi-langkah ketika selector sering rusak. Untuk pekerjaan satu kali, mereka menghemat banyak waktu; untuk scraping produksi, Anda tetap ingin punya script sendiri (atau alat terkelola seperti Thunderbit) agar bisa diperbaiki saat ada perubahan.
Coba AI Web Scraper Get Started Free




