
Data web terus meledak, dan tekanan untuk mengikutinya juga makin besar. Saya melihat langsung bagaimana tim sales dan operasional menghabiskan lebih banyak waktu untuk ngoprek spreadsheet dan copy-paste dari website daripada benar-benar bikin keputusan. Menurut Salesforce, sekarang sales rep menghabiskan hingga 70% waktunya untuk tugas non-penjualan, dan Asana melaporkan bahwa 60% pekerjaan hanyalah “kerja tentang kerja”. Artinya, ada banyak jam yang terbuang buat pengumpulan data manual—padahal jam itu mestinya bisa dipakai untuk closing deal atau meluncurkan kampanye.
Kabar baiknya: web scraping sekarang sudah jadi arus utama, dan kamu tidak harus jadi developer untuk memanfaatkannya. Ruby sudah lama jadi favorit untuk otomatisasi ekstraksi data web, tetapi kalau dipadukan dengan AI web scraper modern seperti Thunderbit, kamu bisa dapat dua keuntungan sekaligus—fleksibilitas untuk yang bisa coding, dan kemudahan web scraper tanpa kode untuk semua orang. Baik kamu marketer, manajer ecommerce, atau cuma capek dengan copy-paste yang nggak ada habisnya, panduan ini akan menunjukkan cara menguasai web scraping dengan Ruby dan AI—tanpa perlu coding.
Coba Thunderbit untuk Web Scraping Tanpa Kode
Apa Itu Web Scraping dengan Ruby? Gerbang Anda ke Otomatisasi Data
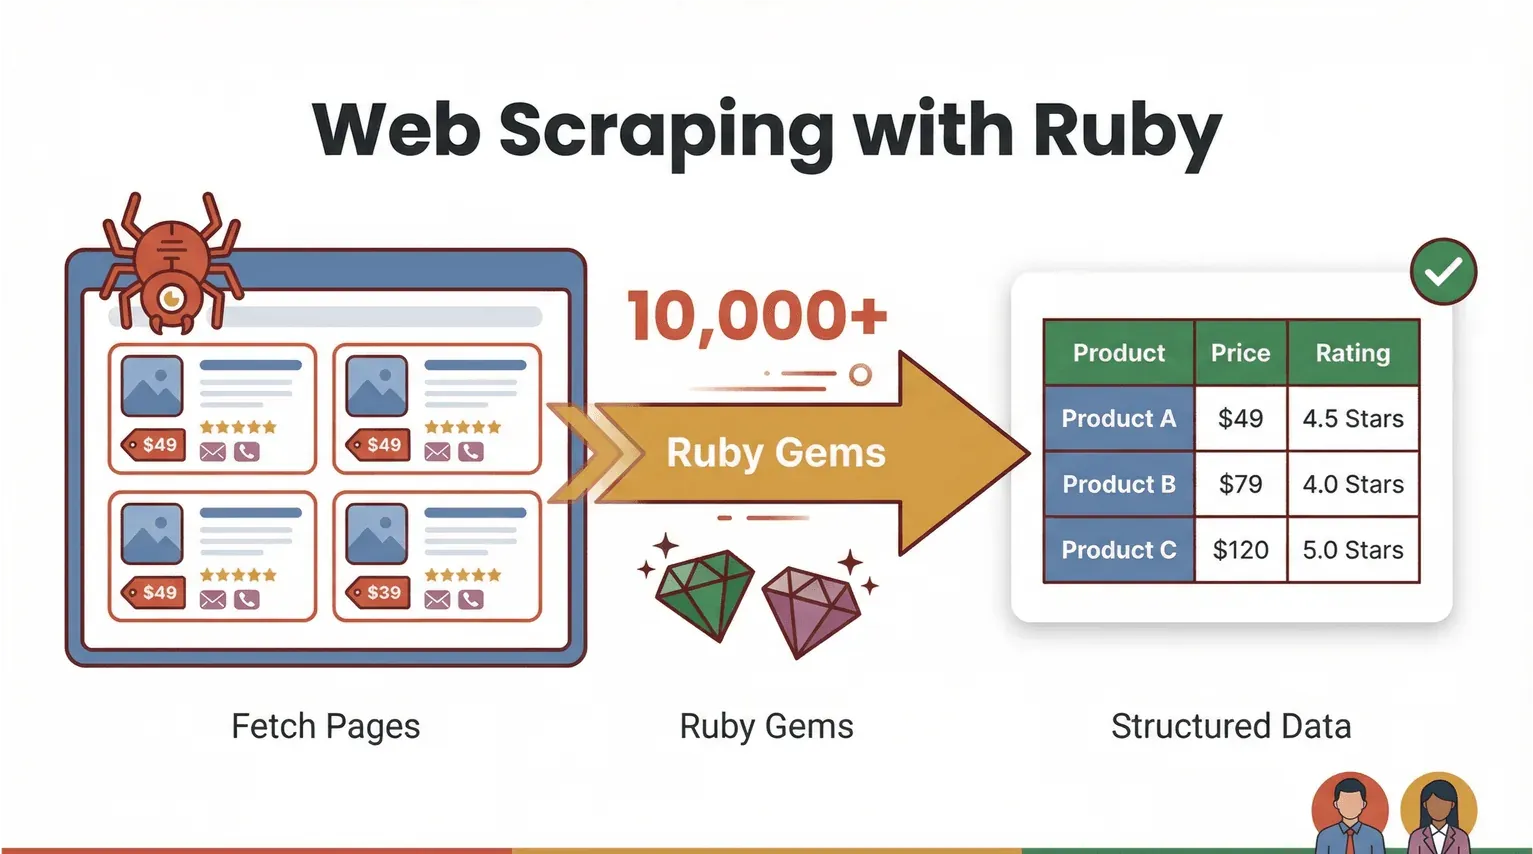
Mari mulai dari dasar. Web scraping adalah proses memakai software untuk mengambil halaman web dan mengekstrak informasi tertentu—seperti harga produk, kontak, atau ulasan—ke format yang terstruktur (misalnya CSV atau Excel). Dengan Ruby, web scraping terasa kuat sekaligus mudah dipelajari. Bahasa ini terkenal punya sintaks yang gampang dibaca dan ekosistem “gem” yang sangat luas (library), jadi otomatisasi jadi jauh lebih simpel (Ruby Programming Language).
Jadi, sebenarnya seperti apa “web scraping dengan Ruby” itu? Bayangkan kamu ingin mengambil semua nama produk dan harga dari sebuah situs ecommerce. Dengan Ruby, kamu bisa menulis script yang:
- Mengunduh halaman web (menggunakan library seperti HTTParty)
- Mem-parsing HTML untuk menemukan data yang kamu butuhkan (dengan Nokogiri)
- Mengekspor hasilnya ke spreadsheet atau database
Tapi di sinilah bagian menariknya: kamu tidak selalu perlu menulis kode. AI web scraper tanpa kode seperti Thunderbit sekarang bisa menangani pekerjaan berat—membaca halaman web, mendeteksi field, dan mengekspor tabel data yang rapi hanya dalam beberapa klik. Ruby tetap sangat berguna sebagai “lem otomasi” untuk workflow yang dibuat khusus, tetapi AI web scraper membuka pintu bagi pengguna bisnis untuk ikut memanfaatkannya.
Apa Itu Data Scraping? Get Started Free
Mengapa Web Scraping dengan Ruby Penting untuk Tim Bisnis
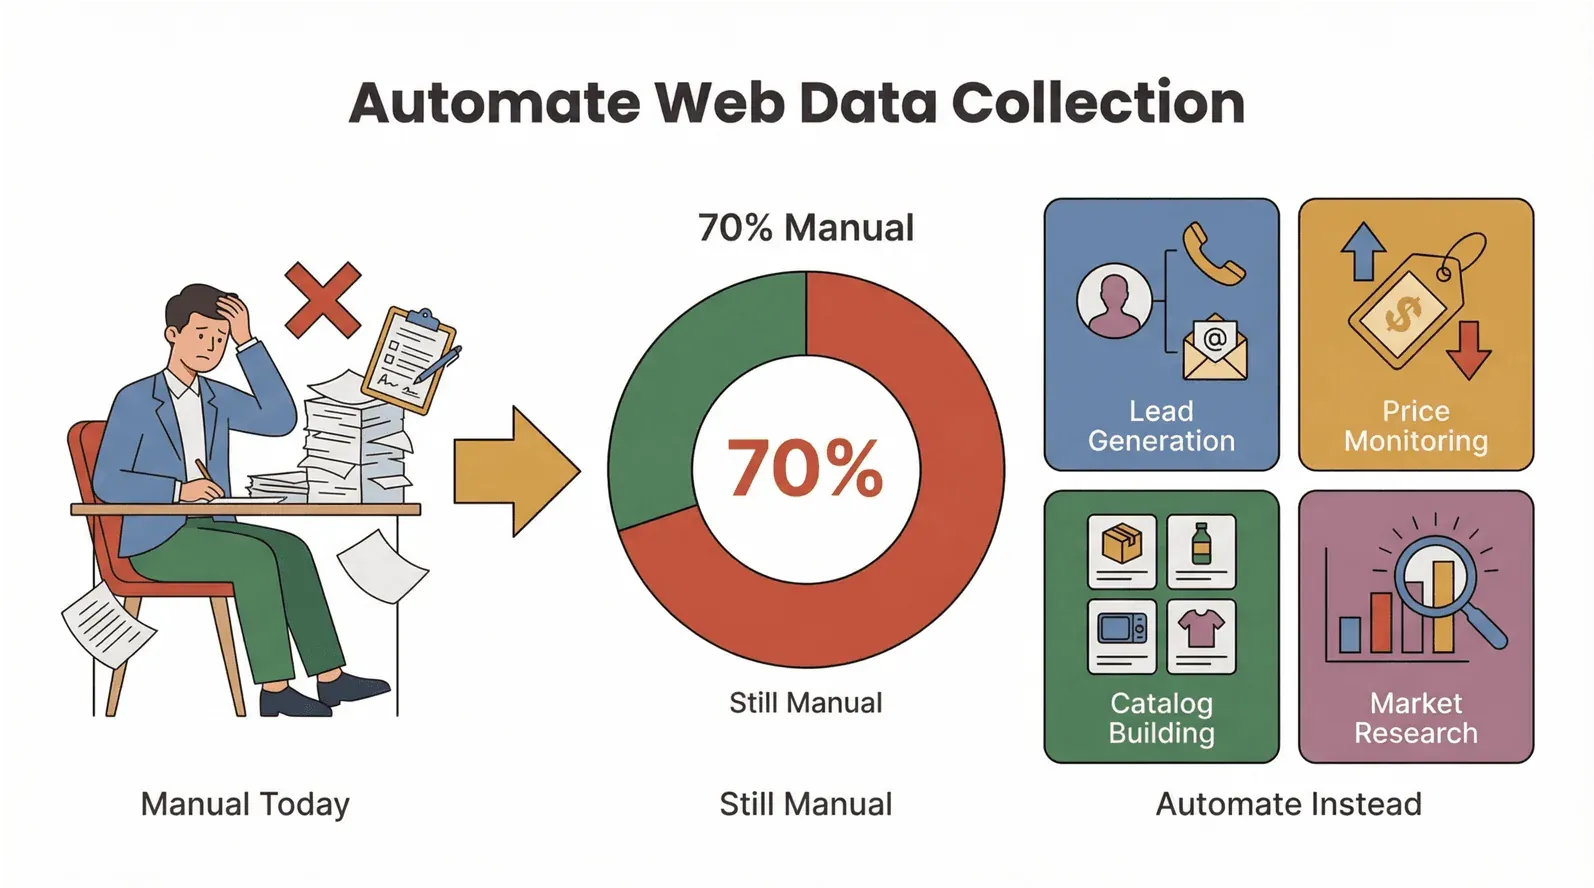
Jujur saja: nggak ada yang mau habis seharian buat copy-paste data. Permintaan untuk ekstraksi data web otomatis sedang naik tajam, dan alasannya jelas. Berikut cara web scraping dengan Ruby (dan tools AI) mengubah operasional bisnis:
- Lead Generation: Ambil info kontak dari direktori atau LinkedIn untuk pipeline sales kamu.
- Pemantauan Harga Kompetitor: Lacak perubahan harga di ratusan SKU ecommerce—tanpa cek manual.
- Membangun Katalog Produk: Kumpulkan detail produk dan gambar untuk toko atau marketplace kamu.
- Riset Pasar: Ambil ulasan, rating, atau artikel berita untuk analisis tren.
ROI-nya jelas: tim yang mengotomatiskan pengumpulan data web bisa menghemat jam kerja setiap minggu, mengurangi kesalahan, dan dapat data yang lebih segar serta lebih andal. Di manufaktur, misalnya, 70% perusahaan masih mengumpulkan data secara manual, padahal volume data sudah dua kali lipat hanya dalam dua tahun. Itu peluang besar untuk otomatisasi.
Berikut ringkasan singkat bagaimana web scraping dengan Ruby dan tools AI memberi nilai tambah:
| Use Case | Masalah Manual | Manfaat Otomatisasi | Hasil Umum |
|---|---|---|---|
| Lead Generation | Copy email satu per satu | Ambil ribuan data dalam hitungan menit | 10x lebih banyak lead, kerja lebih ringan |
| Pemantauan Harga | Cek situs setiap hari | Tarik harga otomatis sesuai jadwal | Intel harga real-time |
| Pembuatan Katalog | Input data manual | Ekstraksi massal & pemformatan | Peluncuran lebih cepat, minim error |
| Riset Pasar | Membaca ulasan secara manual | Scrape dan analisis skala besar | Insight lebih dalam dan lebih segar |
Dan ini bukan cuma soal kecepatan—otomatisasi juga berarti lebih sedikit kesalahan dan data yang lebih konsisten, yang penting banget ketika 58% pemimpin bilang keputusan mereka bergantung pada data yang tidak akurat atau tidak konsisten.
Menjelajahi Solusi Web Scraping: Ruby Script vs. AI Web Scraper
Jadi, lebih baik menulis Ruby script sendiri atau pakai AI web scraper tanpa kode? Mari kita bedah pilihannya.
Ruby Scripting: Kontrol Penuh, Tapi Perlu Perawatan Lebih
Ekosistem Ruby penuh dengan gem untuk berbagai kebutuhan scraping:
- Nokogiri: Andalan untuk parsing HTML dan XML.
- HTTParty: Untuk mengambil halaman web dan API.
- Mechanize: Untuk situs yang butuh cookie, form, dan navigasi.
- Selenium / Watir: Untuk mengotomatiskan browser asli (sangat cocok untuk situs yang berat JavaScript).
Dengan Ruby script, kamu dapat fleksibilitas penuh—logika khusus, pembersihan data, dan integrasi dengan sistem sendiri. Tapi ada biaya perawatannya juga: saat layout website berubah, script kamu bisa rusak. Dan kalau kamu belum nyaman coding, ada kurva belajar yang harus dilewati.
AI Web Scraper & Tool Tanpa Kode: Cepat, Mudah Dipakai, dan Adaptif
AI web scraper modern tanpa kode seperti Thunderbit mengubah cara kerja. Alih-alih nulis kode, kamu cukup:
- Buka extension Chrome
- Klik “AI Suggest Fields” agar AI mendeteksi data apa yang perlu diambil
- Tekan “Scrape” lalu ekspor data kamu
AI Thunderbit bisa beradaptasi dengan perubahan layout website, menangani subpage (seperti detail produk), dan mengekspor langsung ke Excel, Google Sheets, Airtable, atau Notion. Ini cocok banget buat pengguna bisnis yang ingin hasil tanpa ribet.
Berikut perbandingan langsungnya:
| Pendekatan | Kelebihan | Kekurangan | Cocok Untuk |
|---|---|---|---|
| Ruby Scripting | Kontrol penuh, logika khusus, fleksibel | Kurva belajar lebih tinggi, perlu maintenance | Developer, pengguna tingkat lanjut |
| AI Web Scraper | Tanpa kode, setup cepat, adaptif terhadap perubahan | Kontrol lebih granular lebih terbatas, ada batasan tertentu | Pengguna bisnis, tim operasional |
Trennya jelas: saat website makin kompleks dan makin defensif, AI web scraper makin jadi pilihan utama untuk sebagian besar workflow bisnis.
Memulai: Menyiapkan Lingkungan Web Scraping Ruby Anda
Kalau kamu siap coba Ruby scripting, mari siapkan environment-nya. Kabar baiknya? Ruby gampang diinstal dan bisa dipakai di Windows, macOS, dan Linux.
Langkah 1: Instal Ruby
- Windows: Unduh RubyInstaller dan ikuti petunjuknya. Pastikan ikut memasang MSYS2 untuk membangun native extension (dibutuhkan oleh gem seperti Nokogiri).
- macOS/Linux: Gunakan rbenv untuk manajemen versi. Di Terminal:
brew install rbenv ruby-build
rbenv install 4.0.4
rbenv global 4.0.4
(Cek halaman download Ruby untuk versi stabil terbaru.)
Langkah 2: Instal Bundler dan Gem Penting
Bundler membantu mengelola dependency:
gem install bundler
Buat Gemfile untuk project kamu:
source 'https://rubygems.org'
gem 'nokogiri'
gem 'httparty'
Lalu jalankan:
bundle install
Ini memastikan environment kamu konsisten dan siap untuk scraping.
Langkah 3: Uji Setup Anda
Coba ini di IRB (shell interaktif Ruby):
require 'nokogiri'
require 'httparty'
puts Nokogiri::VERSION
Kalau muncul nomor versi, berarti semuanya sudah siap!
Langkah demi Langkah: Membuat Ruby Web Scraper Pertama Anda
Mari lihat contoh nyata—mengambil data produk dari Books to Scrape, situs yang memang dibuat untuk latihan scraping.
Berikut Ruby script sederhana untuk mengekstrak judul buku, harga, dan status stok:
require "net/http"
require "uri"
require "nokogiri"
require "csv"

BASE_URL = "https://books.toscrape.com/"

def fetch_html(url)
  uri = URI.parse(url)
  res = Net::HTTP.get_response(uri)
  raise "HTTP #{res.code} for #{url}" unless res.is_a?(Net::HTTPSuccess)
  res.body
end

def scrape_list_page(list_url)
  html = fetch_html(list_url)
  doc  = Nokogiri::HTML(html)
  products = doc.css("article.product_pod").map do |pod|
    title = pod.css("h3 a").first["title"]
    price = pod.css(".price_color").text.strip
    stock = pod.css(".availability").text.strip.gsub(/\s+/, " ")
    { title: title, price: price, stock: stock }
  end
  next_rel = doc.css("li.next a").first&.[]("href")
  next_url = next_rel ? URI.join(list_url, next_rel).to_s : nil
  [products, next_url]
end

rows = []
url  = "#{BASE_URL}catalogue/page-1.html"
while url
  products, url = scrape_list_page(url)
  rows.concat(products)
end

CSV.open("books.csv", "w", write_headers: true, headers: %w[title price stock]) do |csv|
  rows.each { |r| csv << [r[:title], r[:price], r[:stock]] }
end

puts "Wrote #{rows.length} rows to books.csv"
Script ini mengambil tiap halaman, mem-parsing HTML, mengekstrak data, lalu menulisnya ke file CSV. Kamu bisa buka books.csv di Excel atau Google Sheets.
Kendala yang sering muncul:
- Kalau muncul error soal gem yang belum ada, cek lagi Gemfile dan jalankan
bundle install. - Untuk situs yang memakai JavaScript untuk memuat data, kamu perlu tool automasi browser seperti Selenium atau Watir.
Meningkatkan Web Scraping Ruby dengan Thunderbit: AI Web Scraper dalam Aksi
Sekarang, mari bahas bagaimana Thunderbit bisa membawa scraping kamu ke level berikutnya—tanpa perlu coding.
Thunderbit adalah AI web scraper Chrome extension yang memungkinkan kamu mengekstrak data terstruktur dari website apa pun hanya dalam dua klik. Begini cara kerjanya:
- Buka extension Thunderbit pada halaman yang ingin kamu scrape.
- Klik “AI Suggest Fields.” AI Thunderbit memindai halaman dan menyarankan kolom terbaik untuk diambil (misalnya “Product Name,” “Price,” “Stock”).
- Klik “Scrape.” Thunderbit mengambil data, menangani pagination, dan bahkan mengikuti subpage kalau kamu butuh detail tambahan.
- Ekspor data langsung ke Excel, Google Sheets, Airtable, atau Notion.
Yang bikin Thunderbit beda adalah kemampuannya menangani halaman web yang kompleks dan dinamis—tanpa selector yang rapuh atau kode sama sekali. Dan kalau kamu ingin menggabungkan workflow, kamu bisa pakai Thunderbit untuk mengekstrak data, lalu memproses atau memperkayanya lagi dengan Ruby script.
Tips pro: Fitur scraping subpage Thunderbit sangat membantu untuk tim ecommerce dan properti. Ambil daftar tautan produk, lalu biarkan Thunderbit membuka tiap halaman untuk mengambil spesifikasi detail, gambar, atau ulasan—secara otomatis memperkaya dataset kamu.
Cara Scrape Website Apa Pun dengan AI Get Started Free
Contoh Nyata: Scraping Data Produk & Harga Ecommerce dengan Ruby dan Thunderbit
Mari satukan semuanya dengan alur kerja praktis untuk tim ecommerce.
Skenario: Kamu ingin memantau harga kompetitor dan detail produk di ratusan SKU.
Langkah 1: Gunakan Thunderbit untuk Scrape Daftar Produk Utama
- Buka halaman listing produk milik kompetitor.
- Jalankan Thunderbit, klik “AI Suggest Fields” (misalnya Product Name, Price, URL).
- Klik “Scrape” dan ekspor hasilnya ke CSV.
Langkah 2: Perkaya Data dengan Scraping Subpage
- Di Thunderbit, pakai fitur “Scrape Subpages” untuk mengunjungi setiap halaman detail produk dan mengekstrak field tambahan (seperti deskripsi, stok, atau gambar).
- Ekspor tabel yang sudah diperkaya.
Langkah 3: Proses atau Analisis dengan Ruby
- Gunakan Ruby script untuk membersihkan, mengubah, atau menganalisis data lebih lanjut. Misalnya, kamu mungkin ingin:
- Mengonversi harga ke mata uang standar
- Menyaring item yang stoknya habis
- Membuat statistik ringkasan
Berikut snippet Ruby sederhana untuk memfilter produk yang masih tersedia:
require 'csv'

rows = CSV.read('products.csv', headers: true)
in_stock = rows.select { |row| row['stock'].include?('In stock') }

CSV.open('in_stock_products.csv', 'w', write_headers: true, headers: rows.headers) do |csv|
  in_stock.each { |row| csv << row }
end
Hasil:
Kamu berpindah dari halaman web mentah ke tabel data yang bersih dan siap dipakai—siap untuk analisis harga, perencanaan stok, atau kampanye marketing. Dan semuanya dilakukan tanpa menulis satu baris pun kode scraping.
Tanpa Kode, Tanpa Ribet: Mengotomatiskan Ekstraksi Data Web untuk Semua Orang
Salah satu hal yang paling saya suka dari Thunderbit adalah bagaimana tool ini memberdayakan pengguna non-teknis. Kamu tidak perlu paham Ruby, HTML, atau CSS—cukup buka extension, biarkan AI bekerja, lalu ekspor data kamu.
Kurva belajar: Dengan Ruby script, kamu perlu belajar dasar pemrograman dan struktur web. Dengan Thunderbit, waktu setup dihitung dalam menit, bukan hari.
Integrasi: Thunderbit mengekspor langsung ke tool yang sudah dipakai tim bisnis—Excel, Google Sheets, Airtable, Notion. Kamu bahkan bisa menjadwalkan scraping berulang untuk pemantauan rutin.
Feedback pengguna: Saya pernah melihat tim marketing, sales ops, dan manajer ecommerce memakai Thunderbit untuk mengotomatiskan semuanya, dari membangun daftar lead sampai pelacakan harga—tanpa pernah menghubungi IT.
Best Practices: Menggabungkan Ruby dan AI Web Scraper untuk Otomatisasi Skala Besar
Ingin membangun workflow scraping yang tangguh dan bisa diskalakan? Berikut tips terbaik saya:
- Siap menghadapi perubahan website: AI web scraper seperti Thunderbit beradaptasi otomatis, tetapi kalau kamu memakai Ruby script, siaplah memperbarui selector saat situs berubah.
- Jadwalkan scraping kamu: Gunakan fitur scheduling Thunderbit untuk pengambilan data rutin. Untuk Ruby, buat cron job atau gunakan task scheduler.
- Pemrosesan batch: Untuk dataset besar, pecah scraping ke beberapa batch agar tidak diblokir atau membebani sistem.
- Format data: Selalu bersihkan dan validasi data sebelum dianalisis—hasil ekspor Thunderbit sudah terstruktur, tetapi Ruby script kustom mungkin butuh pemeriksaan tambahan.
- Kepatuhan: Hanya scrape data yang tersedia secara publik, patuhi
robots.txt, dan perhatikan hukum privasi (terutama di Uni Eropa—GDPR berlaku untuk data pribadi yang di-scrape). - Strategi cadangan: Kalau sebuah situs jadi terlalu kompleks atau memblokir scraping, cari API resmi atau sumber data alternatif.
Kapan pakai yang mana?
- Pakai Ruby script saat kamu butuh kontrol penuh, logika khusus, atau integrasi dengan sistem internal.
- Pakai Thunderbit saat kamu menginginkan kecepatan, kemudahan penggunaan, dan adaptabilitas—terutama untuk tugas bisnis sekali pakai atau berulang.
- Gabungkan keduanya untuk workflow tingkat lanjut: biarkan Thunderbit menangani ekstraksi, lalu pakai Ruby untuk enrichment, QA, atau integrasi.
Penutup & Poin Utama
Web scraping dengan Ruby sejak lama jadi senjata ampuh untuk mengotomatiskan pengumpulan data—tetapi sekarang, dengan AI web scraper seperti Thunderbit, kemampuan itu bisa diakses semua orang. Baik kamu developer yang cari fleksibilitas atau pengguna bisnis yang cuma ingin hasil, kamu bisa mengotomatiskan ekstraksi data web, menghemat jam kerja manual, dan membuat keputusan yang lebih baik serta lebih cepat.
Berikut hal-hal utama yang semoga kamu bawa pulang:
- Ruby adalah tool yang sangat kuat untuk web scraping dan otomatisasi—terutama dengan gem seperti Nokogiri dan HTTParty.
- AI web scraper seperti Thunderbit membuat ekstraksi data mudah diakses oleh non-coder, dengan fitur seperti “AI Suggest Fields” dan scraping subpage.
- Menggabungkan Ruby dan Thunderbit memberi kamu yang terbaik dari dua dunia: ekstraksi cepat tanpa kode plus otomatisasi dan analisis kustom.
- Mengotomatiskan pengumpulan data web adalah strategi penting untuk tim sales, marketing, dan ecommerce—mengurangi kerja manual, meningkatkan akurasi, dan membuka insight baru.
Siap mulai? Download Thunderbit, coba Ruby script sederhana, dan lihat berapa banyak waktu yang bisa kamu hemat. Dan kalau ingin menggali lebih dalam, cek Thunderbit Blog untuk panduan, tips, dan contoh nyata lainnya.
Unduh Thunderbit Chrome Extension
FAQ
1. Apakah saya perlu bisa coding untuk memakai Thunderbit dalam web scraping?
Tidak. Thunderbit dirancang untuk pengguna non-teknis. Cukup buka extension, klik “AI Suggest Fields,” dan biarkan AI mengerjakan sisanya. Kamu bisa mengekspor data ke Excel, Google Sheets, Airtable, atau Notion—tanpa coding.
2. Apa keunggulan utama memakai Ruby untuk web scraping?
Ruby menawarkan library yang kuat seperti Nokogiri dan HTTParty untuk workflow scraping yang fleksibel dan kustom. Ini sangat cocok untuk developer yang ingin kontrol penuh, logika khusus, dan integrasi dengan sistem lain.
3. Bagaimana cara kerja fitur “AI Suggest Fields” milik Thunderbit?
AI Thunderbit memindai halaman web, mendeteksi field data yang paling relevan (seperti nama produk, harga, email), lalu menyarankan tabel terstruktur untuk kamu. Kamu bisa menyesuaikan kolomnya sebelum scraping.
4. Bisakah Thunderbit digabung dengan Ruby script untuk workflow tingkat lanjut?
Tentu saja. Banyak tim memakai Thunderbit untuk mengekstrak data (terutama dari situs yang kompleks atau dinamis), lalu memproses atau menganalisisnya lebih lanjut dengan Ruby script. Pendekatan hybrid ini sangat cocok untuk reporting kustom atau enrichment data.
5. Apakah web scraping legal dan aman untuk penggunaan bisnis?
Web scraping legal kalau kamu mengambil data yang tersedia secara publik dan mematuhi ketentuan situs serta hukum privasi. Selalu cek robots.txt dan hindari scraping data pribadi tanpa persetujuan yang tepat—terutama untuk pengguna di Uni Eropa di bawah GDPR.
Penasaran melihat bagaimana web scraping bisa mengubah workflow kamu? Coba paket gratis Thunderbit atau bereksperimen dengan Ruby script hari ini. Dan kalau kamu menemui hambatan, Thunderbit Blog dan Thunderbit YouTube Channel penuh dengan tutorial dan tips untuk membantu kamu menguasai otomatisasi data web—tanpa perlu coding.
Coba Thunderbit AI Web Scraper Get Started Free
Pelajari Lebih Lanjut



