
Lalu lintas otomatis kini menyumbang 53% dari web, bahkan lebih besar daripada trafik manusia, dan sistem anti-bot pun makin galak dalam melawan.
Saya pernah merasakan sendiri bagaimana satu kesalahan kecil — seperti memakai user agent yang salah — bisa mengubah proyek data Anda jadi tembok error 403. Buat tim sales, ecommerce, dan operasional, kalau diblok berarti lead hilang, harga tidak ter-update, atau pendapatan ikut melayang.
Berikut yang saya pelajari tentang user agent untuk scraping — praktik penting, kesalahan umum, dan bagaimana alat seperti Thunderbit menanganinya secara otomatis.

Mengapa Memilih User Agent Terbaik untuk Scraping Itu Penting
Mari mulai dari dasar: apa itu user agent? Bayangkan ini sebagai “kartu identitas” browser Anda. Setiap kali Anda membuka website—baik sebagai manusia maupun bot—browser akan mengirim string User-Agent di header permintaan. Isinya semacam perkenalan singkat: “Hai, saya Chrome di Windows,” atau “Saya Safari di iPhone” (ScraperAPI). Contoh user agent Chrome yang umum seperti ini:
Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36
Website memakai informasi ini untuk dua hal utama:
- Menampilkan konten yang sesuai (misalnya tampilan mobile vs desktop).
- Mendeteksi bot dan scraper.
Kalau user agent Anda berbunyi “python-requests/2.28.1” atau “Scrapy/2.9.0,” itu sama saja seperti membawa kartu nama bertuliskan, “Halo, saya bot!” Situs biasanya punya daftar blokir untuk identitas yang terlalu terang-terangan seperti ini, dan mereka bisa menutup akses Anda lebih cepat daripada Anda sempat bilang “403 Forbidden.” Sebaliknya, memakai user agent browser yang umum dan versi terbaru membantu Anda menyatu dengan trafik normal.
Singkatnya: user agent adalah penyamaran Anda. Semakin meyakinkan penyamarannya, semakin besar peluang Anda mendapatkan data yang Anda butuhkan.
Peran User Agent dalam Keberhasilan Web Scraping
Kenapa pemilihan user agent punya dampak sebesar itu? Karena inilah garis pertahanan pertama bagi sebagian besar sistem anti-bot. Berikut yang bisa terjadi kalau Anda salah langkah:
- Langsung diblokir (error 403/429): Pakai UA default dari library scraping, dan Anda bisa diblokir bahkan sebelum sempat melihat halaman beranda (Webmasters StackExchange).
- Data kosong atau palsu: Beberapa situs menampilkan halaman kosong atau “dummy” untuk user agent yang mencurigakan.
- CAPTCHA atau redirect: UA yang terlihat seperti bot bisa memicu tantangan “Apakah Anda manusia?” atau loop login yang tidak ada habisnya.
- Pembatasan dan banned: Kalau situs menerima UA yang sama berulang-ulang, Anda bisa kena throttling atau IP diblokir.
Lihat seperti apa hasilnya pada beberapa user agent berikut:
| String User Agent | Hasil di Sebagian Besar Situs (2026) |
|---|---|
python-requests/2.28.1 | Langsung diblokir, ditandai sebagai bot |
Scrapy/2.9.0 (+https://scrapy.org) | Diblokir atau diberi konten palsu |
Mozilla/5.0 (Windows NT 10.0; Win64; x64)... | Dianggap pengguna asli, akses diizinkan |
AhrefsBot/7.0 (+http://ahrefs.com/robot/) | Diblokir, crawler yang sudah dikenal |
| UA kosong atau acak | Kadang lolos, tapi sering dianggap mencurigakan |
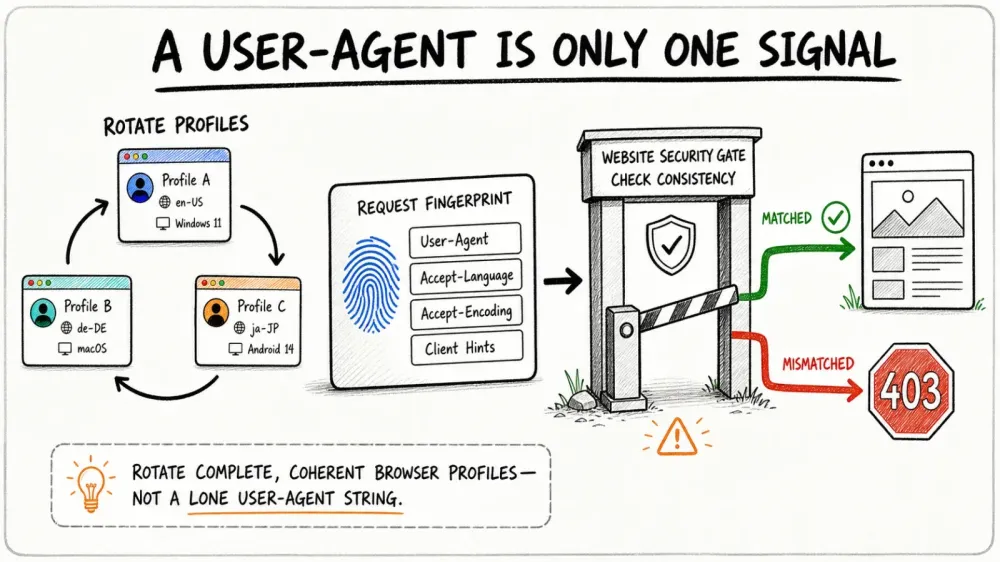
Pelajarannya? Pilih penyamaran Anda dengan hati-hati. Dan jangan lupa—sistem anti-bot modern tidak cuma melihat user agent. Mereka juga memeriksa apakah header lain (seperti Accept-Language atau Referer) ikut selaras. Kalau Anda mengaku sebagai Chrome tetapi tidak mengirim header yang cocok, Anda tetap bisa ketahuan (ScraperAPI).
Ekstrak data dari situs mana pun menggunakan AI Agentic web scraper dari Thunderbit menangani rendering dan struktur halaman secara otomatis, jadi Anda tidak perlu mengelola user agent secara manual. Get Started Free
Di sinilah Thunderbit masuk. Saya sering ngobrol dengan banyak pengguna bisnis—sales, manajer ecommerce, agen properti—yang cuma butuh datanya, bukan kursus kilat soal header HTTP. Karena itu kami membangun Thunderbit supaya pengelolaan user agent menjadi tak terlihat dan berjalan otomatis.
Thunderbit: Menyederhanakan Pengelolaan User Agent untuk Semua Orang
Dengan one-click scraping dari Thunderbit, Anda tidak perlu memilih user agent sama sekali. Mesin AI kami yang akan mengerjakannya, dengan memilih signature browser yang paling realistis dan paling mutakhir untuk setiap situs. Entah Anda memakai Thunderbit Chrome Extension (yang benar-benar memakai UA asli Chrome) atau cloud scraping (di mana AI kami merotasi kumpulan UA browser terkini), trafik Anda akan selalu terlihat seperti trafik normal.
Dan ini bukan cuma soal user agent. Thunderbit mengirim rangkaian header lengkap dan konsisten—Accept-Language, Accept-Encoding, Client Hints, dan lainnya—supaya request Anda tampak dan berperilaku seperti browser asli. Tidak ada lagi header yang tidak sinkron, tidak ada lagi tanda merah “bot”.
Bagian terbaiknya? Anda tidak perlu mengatur apa pun. AI Thunderbit menangani semua detail teknis di belakang layar, jadi Anda bisa fokus ke hal yang benar-benar penting: mendapatkan data yang andal dan berkualitas tinggi.
Coba Thunderbit Agentic Web Scraper Gratis Pasang ekstensi Chrome gratis dan ekstrak data terstruktur dari halaman mana pun dalam satu klik, tanpa perlu spoofing header. Get Started Free
Mengapa Rotasi User Agent Dinamis Wajib Dipakai
Misalnya Anda menemukan user agent yang sempurna. Apakah lalu dipakai terus untuk semua request? Belum tentu. Di 2026, memakai UA yang sama berulang-ulang justru sangat mudah dikenali. Pengguna asli memakai browser, versi, dan perangkat yang berbeda-beda. Kalau scraper Anda mengakses situs 500 kali berturut-turut dengan UA yang sama, itu seperti mengirim parade anak kembar identik—tidak ada yang bakal tertipu.
Itulah sebabnya rotasi user agent dinamis sekarang jadi standar industri. Konsepnya sederhana: rotasikan daftar user agent yang realistis dan terbaru untuk setiap request atau sesi. Dengan begitu scraper Anda terlihat seperti kumpulan pengunjung asli yang beragam, bukan satu skrip otomatis (Capsolver).
Rotasi berbasis AI dari Thunderbit melangkah lebih jauh. Untuk crawl multi-halaman atau tugas terjadwal, Thunderbit otomatis merotasi user agent dan bahkan memasangkannya dengan IP proxy yang berbeda. Kalau sebuah situs mulai curiga, Thunderbit akan menyesuaikan diri secara real time—mengganti UA, menyesuaikan header, atau memperlambat request bila perlu. Semua ini terjadi di belakang layar, sehingga scraping tetap tidak terdeteksi dan data terus mengalir.
User Agent dan Header Request: Kekuatan Konsistensi
Ini tips pro: user agent hanyalah satu bagian dari “sidik jari” request Anda. Sistem anti-bot modern memeriksa apakah UA Anda cocok dengan header lain seperti Accept-Language, Accept-Encoding, dan Referer. Kalau Anda mengaku sebagai Chrome di Windows tetapi mengirim Accept-Language Prancis dari IP New York, itu sudah jadi tanda mencurigakan (ScraperAPI).
Praktik terbaik:
- Selalu kirim rangkaian header lengkap yang sesuai dengan user agent Anda.
- Jaga agar Accept-Language dan Accept-Encoding tetap konsisten dengan UA dan, kalau bisa, dengan lokasi IP Anda.
- Gunakan developer tools browser untuk melihat request asli dan menyalin set header lengkap untuk UA pilihan Anda.
Thunderbit menangani semua ini untuk Anda. AI kami memastikan setiap request selalu cocok—user agent, header, bahkan browser fingerprinting. Anda dapat profil request yang terasa seperti manusia tanpa perlu ribet.
Menghindari Kesalahan Umum: Apa yang Jangan Dilakukan dengan User Agent
Saya sudah melihat banyak proyek scraping gagal karena alasan yang sama. Berikut kesalahan terbesar yang perlu dihindari:
- Memakai UA default dari library scraping: String seperti
python-requests/2.x,Scrapy/2.9.0, atauJava/1.8adalah pemicu blokir instan. - Versi browser yang sudah usang: Mengaku masih Chrome 120 di 2026? Mencurigakan — build itu sudah lebih dari dua tahun umurnya. Selalu gunakan UA dari channel stabil terbaru (Chrome 147 pada saat penulisan); daftar yang sudah basi selama dua belas bulan pun sudah cukup untuk ketahuan sebagai bot.
- Header yang tidak selaras: Jangan kirim UA Chrome tetapi Accept-Language, Accept-Encoding, atau Client Hints yang hilang atau tidak cocok.
- UA crawler yang sudah dikenal: Apa pun yang mengandung kata “bot,” “crawler,” “spider,” atau nama tool seperti AhrefsBot adalah tanda merah.
- UA kosong atau acak: Kadang bisa lolos, tapi sering mencurigakan dan tidak andal.
Checklist singkat untuk user agent yang aman:
- Gunakan UA browser yang asli dan terbaru (Chrome, Firefox, Safari).
- Rotasikan melalui beberapa UA.
- Jaga header tetap konsisten dengan UA.
- Perbarui daftar UA setiap bulan (browser cepat sekali update).
- Hindari apa pun yang terasa seperti “otomatisasi”.
Thunderbit dalam Praktik: Skenario Nyata untuk Sales dan Operasional
Mari kita bahas secara praktis. Berikut cara pengelolaan user agent Thunderbit membantu tim nyata:
| Use Case | Cara Lama: Scraping Manual | Dengan Thunderbit | Hasil |
|---|---|---|---|
| Lead Gen Sales | Sering diblokir, data hilang | AI memilih UA terbaik, merotasi, meniru browsing asli | Lead lebih banyak, kualitas lebih tinggi, bounce lebih rendah |
| Monitoring Ecommerce | Script rusak, IP diblokir | Cloud scraping dengan rotasi UA & proxy dinamis | Pelacakan harga/stok lebih andal |
| Daftar Properti | Perlu banyak penyesuaian, sering diblokir | AI menyesuaikan UA/header, menangani subpage otomatis | Daftar properti lengkap dan selalu terbaru |

Salah satu tim sales yang memakai Thunderbit melakukan scraping ribuan website untuk mencari lead dan hanya mengalami ~8% email bounce rate—dibandingkan 15–20% dari daftar yang dibeli (Reddit). Itulah kekuatan scraping yang segar dan menyerupai perilaku manusia.
Langkah Demi Langkah: Cara Scrape dengan User Agent Terbaik Menggunakan Thunderbit
Berikut cara memulai dengan Thunderbit—tanpa perlu skill teknis:
- Pasang Thunderbit Chrome Extension.
- Buka website target Anda. Login jika perlu—Thunderbit juga bisa bekerja di halaman yang sudah login.
- Klik “One Click Extract.” AI Thunderbit akan memindai halaman dan menyarankan kolom terbaik untuk di-scrape.
- Tinjau dan sesuaikan field jika perlu. Ubah nama, tambahkan, atau hapus kolom sesuai kebutuhan.
- Klik “Scrape.” Thunderbit mengekstrak data sambil merotasi user agent dan header di belakang layar.
- Ekspor data Anda. Kirim langsung ke Excel, Google Sheets, Airtable, Notion, atau unduh sebagai CSV/JSON.
Tidak perlu memilih atau memperbarui user agent—AI Thunderbit yang menangani semuanya, sambil menyesuaikan diri dengan tiap situs untuk hasil maksimal.
Scrape dengan Rotasi User Agent Bertenaga AI Thunderbit menjalankan tugas scraping melalui infrastrukturnya sendiri, sehingga satu klik menggantikan skrip rotasi user-agent manual. Get Started Free
Membandingkan Thunderbit dengan Pengelolaan User Agent Tradisional
Mari lihat bagaimana Thunderbit dibandingkan dengan pendekatan manual klasik:
| Fitur/Tugas | Pendekatan Scraping Manual | Pendekatan Thunderbit |
|---|---|---|
| Pengaturan User Agent | Diteliti & diatur di kode | Otomatis, dipilih AI per situs |
| Menjaga UA Tetap Update | Manual, mudah terlupakan | AI auto-update mengikuti tren browser |
| Rotasi UA | Menulis logika rotasi sendiri | Rotasi bawaan yang cerdas |
| Konsistensi Header | Menyamakan header dengan UA secara manual | AI memastikan set header lengkap dan konsisten |
| Menangani Blokir/CAPTCHA | Ganti manual, perawatan tinggi | AI beradaptasi, retry, dan rotasi sesuai kebutuhan |
| Skill Teknis yang Dibutuhkan | Tinggi (coding, pengetahuan HTTP) | Tidak ada—dirancang untuk pengguna bisnis |
| Waktu untuk Troubleshooting | Sering dan melelahkan | Minimal—fokus ke data, bukan pusing scraping |
Thunderbit dibuat untuk siapa pun yang ingin scraping andal dan skalabel—tanpa beban teknis.
Lihat Cara Kerja Agentic Web Scraping AI Thunderbit membaca halaman seperti manusia dan mengekstrak data dalam satu klik, sehingga Anda tidak perlu tuning scraper secara manual. Get Started Free
Poin Penting: Membangun Strategi User Agent yang Tahan Masa Depan
Inilah yang saya pelajari (kadang dengan cara yang cukup menyakitkan) tentang pengelolaan user agent di 2026:
- Jangan pernah gunakan user agent default atau yang sudah usang. Itu penyebab nomor satu scraper diblokir.
- Rotasikan user agent secara dinamis. Variasi adalah teman Anda—jangan biarkan scraper terlihat seperti parade robot.
- Jaga header tetap konsisten dan realistis. Kualitas user agent Anda ditentukan oleh header yang menyertainya.
- Tetap update. Versi browser berubah cepat; daftar UA Anda juga harus ikut bergerak.
- Biarkan AI menangani bagian tersulit. Tools seperti Thunderbit sudah menanamkan praktik terbaik, jadi Anda bisa fokus pada hasil, bukan request.
Kalau Anda bosan diblokir, capek memperbaiki script, atau cuma ingin scraping seperti profesional tanpa ribet, coba Thunderbit. Agentic web scraper kami dipercaya oleh ribuan pengguna di seluruh dunia dan dirancang agar data web bisa diakses semua orang—tanpa drama teknis.
Untuk tips, tutorial, dan pembahasan mendalam soal web scraping, kunjungi Thunderbit Blog.
FAQ
1. Apa itu user agent, dan mengapa penting untuk web scraping?
User agent adalah string yang dikirim bersama setiap permintaan web untuk mengidentifikasi browser dan sistem operasi Anda. Website memakainya untuk menampilkan konten yang tepat dan mendeteksi bot. Memakai user agent yang sesuai membantu scraper Anda menyatu dengan trafik normal dan menghindari blokir.
2. Kenapa saya tidak boleh memakai user agent default dari library scraping?
User agent default seperti python-requests/2.x adalah signature bot yang sudah sangat dikenal dan sering langsung diblokir. Selalu gunakan user agent browser yang realistis dan terbaru.
3. Bagaimana Thunderbit menangani rotasi user agent?
AI Thunderbit otomatis merotasi kumpulan user agent browser yang terbaru dan realistis untuk setiap request atau sesi. Ini membuat scraping Anda terlihat seperti trafik pengguna asli yang beragam.
4. Apakah saya perlu mengatur header seperti Accept-Language atau Referer secara manual di Thunderbit?
Tidak perlu! AI Thunderbit memastikan semua header konsisten dan cocok dengan user agent Anda, sehingga request terlihat dan berperilaku seperti browser asli.
5. Apa yang terjadi kalau sebuah situs tetap memblokir request saya?
Thunderbit mendeteksi blokir atau CAPTCHA dan beradaptasi secara real time—mengganti user agent, menyesuaikan header, atau mencoba ulang sesuai kebutuhan. Anda mendapatkan data yang andal tanpa perlu troubleshooting manual.
Siap scraping dengan lebih cerdas? Unduh Thunderbit dan biarkan AI kami menangani permainan kucing-dan-tikus soal user agent untuk Anda. Selamat scraping!
Pelajari Lebih Lanjut
- Apa itu AI Agent? Cara Kerja dan Cara Menggunakannya
- Apa Itu Manus AI Agent? Cara Kerja dan Cara Menggunakannya
- Panduan Pemula: Cara Membangun AI Agent Langkah demi Langkah
- Panduan Vertical AI Agents: Konsep & Contoh Penggunaan Nyata
- Memahami Statistik AI Agent: Dari Akurasi hingga Skalabilitas
Coba Agentic Web Scraper Get Started Free



