
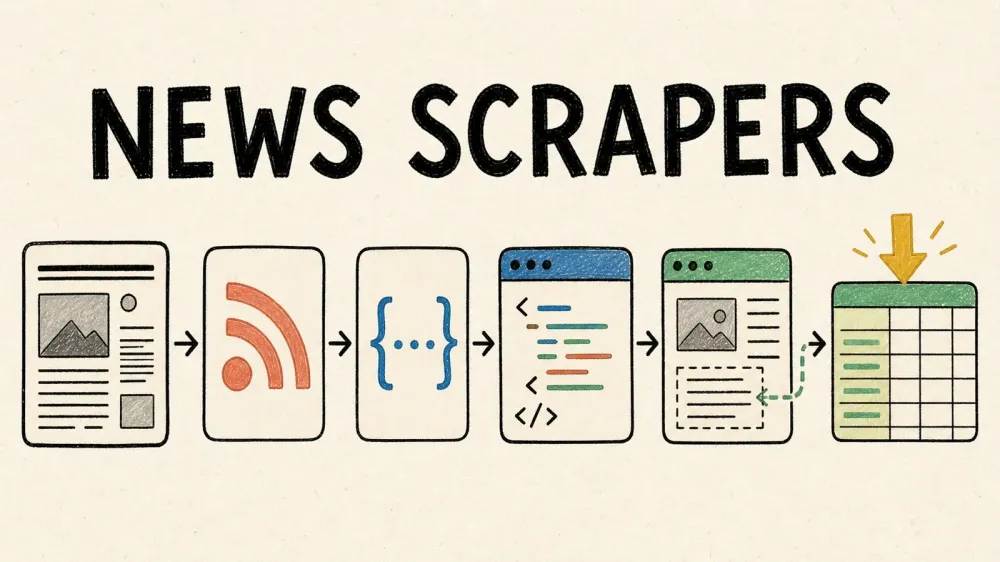
Sebuah newsroom di suatu tempat menerbitkan cerita tiap beberapa detik, kompetitor merilis siaran pers tengah malam, dan filing regulasi yang benar-benar Anda butuhkan justru tenggelam di halaman empat situs lembaga pemerintah daerah. Tidak ada pekerjaan manusia yang mengharuskan Anda menjaga puluhan tab browser seperti ini. Itulah sebabnya istilah "news scraper" akhirnya jadi kategori produk yang nyata — dan juga alasan kenapa kebanyakan panduan pembeli untuk kategori ini terasa kurang berguna.
Masalah yang terus saya temui saat riset adalah ini: sebagian besar roundup "best news scraper" memilih satu jalur lalu bertahan di sana. Satu artikel hanya memberi peringkat alat SaaS no-code. Artikel lain cuma membahas library Python, seolah semua orang di dunia tahu cara menulis spider Scrapy. Dua pendekatan itu sama-sama tidak membantu orang yang sedang mencoba menentukan apakah mereka butuh ekstensi browser, API key, atau weekend buat pip install. Jadi, daftar ini mengelompokkan sepuluh alat ke dalam tiga jalur — no-code/agentic, managed API, dan coding library — lalu membiarkan Anda memilih berdasarkan kemampuan nyata dan jumlah sumber yang perlu dipantau, bukan berdasarkan siapa yang bayar posisi teratas.
Apa yang Membuat News Scraper Terbaik di 2026?
Ada enam hal yang benar-benar penting di sini, dan saya memakai enam hal itu sebagai lensa untuk setiap entri di bawah ini:
- Kecocokan kategori — apakah ini alat klik-klik, API terkelola yang menangani infrastruktur, atau library coding yang Anda bangun sendiri?
- Kemudahan pakai untuk non-engineer — ini sering muncul di thread forum yang mencari "web data scraper yang benar-benar bisa dipakai non-engineer," dan ini bukan ceruk kecil.
- Kemampuan scale — apakah alat ini sanggup menangani 20, 100, atau 1.000 sumber berita tanpa seseorang harus menulis ulang aturan secara manual untuk tiap situs?
- Penanganan anti-bot dan rendering JS yang jujur — bukan klaim marketing "pasti tembus", melainkan apa yang benar-benar terjadi saat sebuah situs mengandalkan JavaScript, CAPTCHA, atau paywall.
- Model harga — subscription, berbasis kredit, atau bayar per request, dan apakah ekonomi unitnya masuk akal untuk volume sebesar news monitoring.
- Opsi ekspor — CSV, JSON, Sheets, Airtable, webhook, atau apa pun yang bisa mengantar data ke tempat yang dibutuhkan.
Kalau sebuah alat tidak bisa lolos sebagian besar poin ini untuk use case pemantauan berita, seberapa bagus pun bintang GitHub-nya, itu tidak terlalu relevan.
No-Code vs API vs Code: Jalur News Scraper Mana yang Cocok untuk Anda?
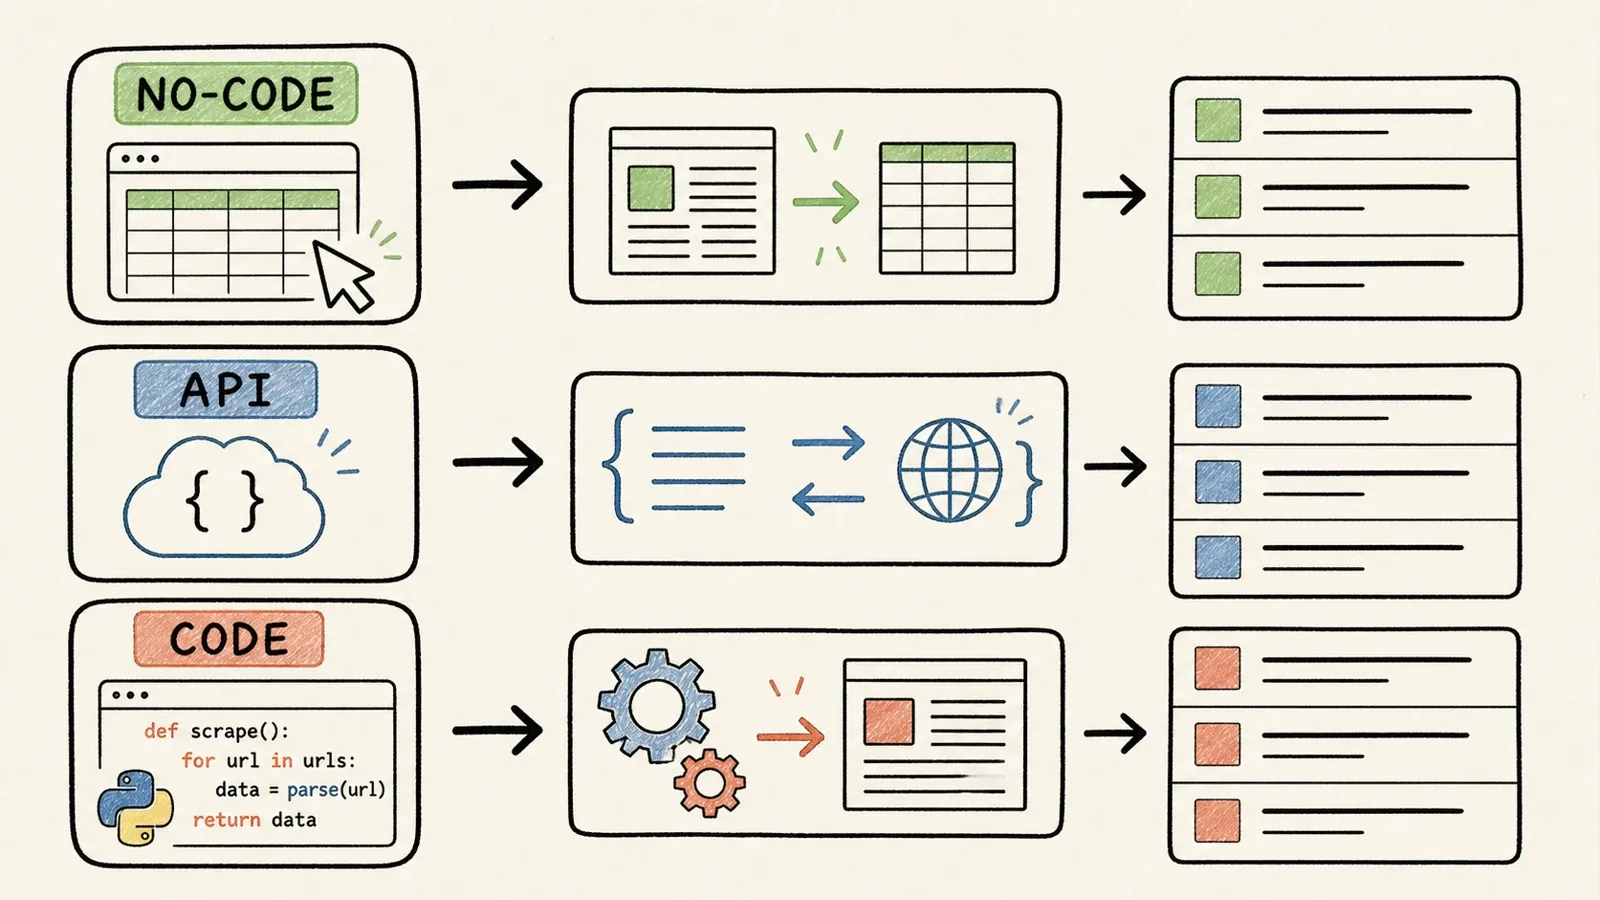
Kebanyakan daftar "top 10" mencampur tiga kategori ini seolah-olah mereka bersaing untuk pekerjaan yang sama. Padahal tidak.
Alat no-code/agentic ditujukan untuk pengguna bisnis — sales, ops, riset, marketing — yang butuh tabel berisi headline dan link tanpa menyentuh satu baris kode pun. Managed API cocok untuk developer yang tidak ingin mengelola proxy infrastructure atau headless browser sendiri; mereka cukup mengirim URL, menerima HTML atau JSON, lalu membangun pipeline sisanya di atasnya. Coding library dan framework diperuntukkan bagi engineer yang menginginkan kontrol penuh atas crawling, parsing, retry, dan semuanya yang lain — dengan konsekuensi mereka juga memikul semua maintenance.
Thunderbit adalah contoh yang cukup baik dari seperti apa jalur no-code dalam praktik sehari-hari. Ekstensi Chrome Thunderbit bekerja lewat workflow bernama One Click Extract — Anda klik, alat ini membaca halaman dan memahami isinya, lalu menampilkan Run Now. Kalau Anda klik, ekstraksi langsung dimulai. Kalau tidak melakukan apa-apa, prosesnya tetap berjalan sendiri setelah beberapa detik. Tidak ada selector yang perlu ditulis, tidak ada schema yang harus didefinisikan dulu. Ini jawaban langsung untuk keluhan "scraper untuk non-engineer" yang terus muncul di forum — meskipun, seperti semua alat di daftar ini, alat ini hanya bekerja pada halaman yang memang Anda berwenang akses, dan bukan alat untuk menembus paywall.
Untuk melihat gambaran lebih luas tentang bagaimana kategori ini berkembang, saya sarankan membaca penjelasan kami tentang AI web scraping dan apa arti "no-code" yang sebenarnya ketika sebuah scraper mengklaim dirinya demikian.
Cek Ini Dulu: Apakah RSS Feed atau News API Sudah Tersedia?
Sebelum membangun atau membayar apa pun, periksa dulu apakah penerbitnya memang sudah menyediakan datanya secara gratis. Kedengarannya jelas. Tapi orang sering melewatinya.
Sebagian besar situs berita masih mendukung RSS atau Atom feed, yang bisa ditemukan lewat tag standar <link rel="alternate"> yang didefinisikan dalam spesifikasi WHATWG HTML — dan spesifikasi RSS 2.0 sendiri sudah cukup tua untuk boleh minum alkohol di banyak negara. sitemap.xml milik publisher, yang mengikuti protokol Sitemaps, juga bisa memberi Anda daftar URL artikel yang rapi tanpa perlu menyentuh menu navigasi sama sekali.
Di luar publisher individual, ada beberapa opsi agregator:
- NewsAPI — API agregasi berita komersial dengan free tier untuk developer dan paket berbayar untuk production; cek ketentuannya sebelum membangun sesuatu di atas free tier.
- GDELT — dataset berita dan peristiwa global yang sangat besar, gratis, dan bersumber pertama, dengan DOC 2.0 API. Sangat berguna untuk discovery dan analisis tren, meskipun proyeknya sendiri menerbitkan panduan rate limiting, jadi jangan anggap ini aliran data tanpa batas.
Scraping tetap menjadi pilihan yang tepat ketika sebuah sumber tidak punya feed, feed-nya tidak memuat field yang Anda butuhkan (misalnya teks lengkap artikel), atau Anda memantau terlalu banyak sumber sehingga perlu satu pipeline terpadu alih-alih sepuluh format berbeda. Cek dulu saja. Itu sepuluh menit termurah yang akan Anda habiskan untuk proyek ini.
Sekilas Tentang News Scraper Terbaik
Satuan harga di sini tidak bisa dibandingkan langsung — kredit, "successful requests", compute units, dan subscription flat semuanya mengukur hal yang berbeda. Pastikan angka terbaru sebelum Anda mengunci budget.
| Alat | Kategori | Cocok Untuk | Penanganan JS/Anti-Bot | Perlu Coding | Model Harga |
|---|---|---|---|---|---|
| Thunderbit | No-code / agentic | Non-engineer yang butuh ekstraksi cepat dari halaman berita publik | Didukung pada halaman yang kompatibel dan berwenang; tidak ada jaminan untuk paywall berat | Tidak ada | Free tier + paket berbayar berbasis kredit, lihat harga terbaru |
| Octoparse | Visual scraper no-code | Workflow klik-klik dengan template | Built-in browser, konfigurasi AJAX manual | Tidak ada–rendah | Free tier + paket subscription |
| Apify | Platform Actor | Developer yang ingin scraper siap pakai + custom pada skala besar | Tergantung Actor tertentu | Rendah–sedang | Free usage credit + paket subscription |
| Bright Data | Managed API/proxy | Scraping skala enterprise lintas wilayah | Web Unlocker + Browser API terpisah | Sedang | Bayar sesuai pemakaian + tier volume |
| ScraperAPI | Managed API | Pemanggilan API sederhana untuk HTML/JS rendering | Rendering opsional, rotasi proxy | Rendah (panggilan API) | Tier subscription berbasis kredit |
| Oxylabs | Managed API/proxy | Kebutuhan proxy enterprise volume tinggi | Rendering + instruksi browser | Sedang | Tier harga per hasil |
| Crawlbase | Managed API | Situs berat JS, ekstraksi berorientasi artikel | Rendering token JS + proxy | Rendah (panggilan API) | Alokasi gratis + harga dinamis per domain |
| Scrapy | Framework coding | Crawler Python kustom dengan kontrol tinggi | Manual (butuh middleware/integrasi browser) | Tinggi | Gratis, open-source |
| Beautiful Soup | Library coding | Parsing HTML ringan untuk halaman statis | Tidak ada (dipasangkan dengan Requests) | Tinggi | Gratis, open-source |
| Selenium | Library otomasi browser | Halaman yang dirender JS atau dibatasi login | Eksekusi browser sungguhan; tidak bisa bypass CAPTCHA | Tinggi | Gratis, open-source |
1. Thunderbit: News Scraper No-Code Terbaik untuk Non-Engineer

Thunderbit adalah tool ekstraksi berbasis browser dan agentic yang dibuat untuk pengguna bisnis — tim sales, riset, dan ops — bukan untuk developer yang sedang membangun pipeline kustom. Workflow-nya sengaja dibuat minimal: klik One Click Extract, biarkan alat ini membaca halaman, lalu tekan Run Now (atau tidak perlu — prosesnya akan mulai sendiri setelah beberapa detik).
Fitur utama:
- Tidak perlu selector, schema, atau pemetaan field sebelum menjalankan ekstraksi
- Pagination dan enrichment subpage didukung pada halaman yang kompatibel, berguna untuk pola dari halaman kategori ke artikel
- Ekspor ke Excel, Google Sheets, Airtable, atau Notion
- Open API terpisah untuk tim yang nanti sudah melampaui workflow browser
Harganya terdiri dari free tier plus paket berbayar berbasis kredit — cek halaman harga terbaru karena alokasi kredit dan batas halaman bisa berubah dari waktu ke waktu. API terpisahnya punya struktur harga sendiri, jadi jangan menganggap kredit ekstensi dan unit API bisa saling dipertukarkan.
Cocok untuk: peneliti atau analis yang butuh tabel data berita yang rapi hari ini, bukan pipeline ingestion yang terkelola enam minggu lagi.
Kelebihan dan Kekurangan
Kelebihan: tidak perlu coding, cepat dipasang, menyesuaikan layout halaman tanpa perlu mengutak-atik selector manual, dan ekspor langsung ke tools yang sudah dipakai tim.
Kekurangan: tidak dirancang untuk developer yang ingin kontrol request yang sangat granular atau logika crawl kustom. Seperti semua alat di daftar ini, tool ini juga mentok pada paywall berat dan halaman yang dilindungi CAPTCHA — tidak ada jalan pintas ajaib, dan memang seharusnya tidak ada. Untuk tim yang membandingkan ini dengan setup manual penuh, tulisan kami tentang web scraping tanpa coding membahas tradeoff-nya lebih dalam.
2. Octoparse: News Scraper Visual Click-and-Point Terbaik

Octoparse memberi non-coder kanvas visual untuk membangun workflow scraping — klik, loop, aturan pagination, dan kondisi tunggu — di dalam built-in browser. Posisinya satu tingkat di atas alat agentic dari sisi kontrol manual, dan satu tingkat di bawah framework coding dari sisi kompleksitas.
Fitur utama:
- Built-in browser menjalankan JavaScript dan menangani konten yang dimuat lewat AJAX, meski timing sering perlu konfigurasi manual
- Pustaka template yang mencakup kategori News & Media serta template khusus CNN
- Run lokal untuk pengujian, plus penjadwalan cloud untuk job berulang
- Free tier mendukung penggunaan lokal dengan hingga 50.000 baris ekspor per bulan pada tugas kustom yang memenuhi syarat
Tradeoff-nya ada di maintenance: karena workflow menyimpan klik dan selector yang spesifik, redesign dari publisher bisa merusak loop atau field, sama seperti aturan Scrapy buatan tangan. Harga dimulai dari free local tier, Standard $83/bulan (atau $69/bulan jika ditagih tahunan) dengan tiga concurrent cloud process, dan Pro $299/bulan (atau $249/bulan tahunan) dengan 20 concurrent cloud process.
Cocok untuk: non-coder yang ingin kontrol interaksi halaman lebih eksplisit daripada alat otomatis penuh, dan tidak keberatan menjaga template sesekali.
3. Apify: Platform Scraping Berbasis Actor Terbaik untuk Developer

Apify beroperasi dengan yang mereka sebut Actors — program scraping terkemas dan di-host dengan input dan output yang jelas. Sebagiannya dikelola oleh Apify sendiri, sebagian lagi oleh komunitas, dan Anda juga bisa membangun milik Anda sendiri. Jadi ini bukan satu produk tunggal, melainkan lebih seperti marketplace — dengan kelebihan dan kekurangannya.
Fitur utama:
- Website Content Crawler yang dikelola menghasilkan output teks/Markdown bersih yang cocok untuk search atau pipeline LLM
- Ada Google News Actor buatan komunitas untuk discovery, tetapi reliabilitas dan harganya bergantung pada pengelolanya — cek Actor yang tepat sebelum Anda membangun di atasnya
- Scheduling, webhook, dan API trigger untuk job berulang
- Ekspor dataset dalam JSON, CSV, XML, Excel, HTML, RSS, dan JSONL
Harga dimulai gratis dengan kredit penggunaan bulanan senilai $5, lalu Starter $29/bulan, Scale $199, dan Business $999 — ditambah biaya compute berbasis pemakaian dan biaya khusus Actor. Total pengeluaran sangat bergantung pada Actor mana yang dipakai dan apakah mereka menjalankan full browser di balik layar.
Cocok untuk: tim teknis yang nyaman mengevaluasi dan mengganti komponen daripada membeli satu endpoint tetap.
4. Bright Data: Infrastruktur Proxy Enterprise Terbaik untuk News Scraping
Bright Data lebih tepat dipahami sebagai sebuah stack daripada satu produk. Discovery dataset menangani pencarian, Web Unlocker menangani pengambilan halaman publik dengan routing dan access management, dan Browser API menyediakan browser jarak jauh untuk halaman berat JavaScript. Tidak ada satu "News Scraper API" universal — Anda menggabungkan beberapa komponen.
Fitur utama:
- Geo-targeting luas untuk mengakses edisi regional
- Produk retrieval terpisah dan full-browser terpisah, sehingga tim bisa menaikkan biaya hanya di tempat yang memang diperlukan
- Pengiriman lewat API dan webhook untuk integrasi pipeline
Harga Web Unlocker mencakup 5.000 request gratis per bulan, lalu bayar sesuai pemakaian sebesar $1.50 per 1.000 successful requests (tier $499/bulan menurunkannya menjadi $1.30/1.000 dengan 383.000 sudah termasuk). Browser API dihitung berdasarkan bandwidth — mulai dari $8/GB pay-as-you-go. Perlu dicatat: ketentuan Bright Data sendiri mendefinisikan "successful" berdasarkan status respons, bukan validitas artikel, jadi budget harus disesuaikan.
Cocok untuk: tim enterprise yang sudah memiliki logika ekstraksi dan validasi sendiri dan membutuhkan infrastruktur routing berat di bawahnya.
5. ScraperAPI: API Sederhana Terbaik untuk Men-scale Request Berita
ScraperAPI adalah managed-fetch API paling lugas dalam daftar ini. Kirim URL, lalu dapatkan HTML, teks, atau Markdown, dengan rendering JavaScript opsional dan routing geografis di sepanjang proses.
Fitur utama:
render=truememicu headless Chrome untuk halaman yang dirender di sisi klien- Ada parser bawaan untuk target tertentu (misalnya hasil pencarian Google News), meski tidak ada parser universal untuk artikel publisher
- DataPipeline mendukung job low-code terjadwal yang menerima hingga 10.000 URL per run
- Batch requests menangani hingga 50.000 URL secara asinkron
Harga dimulai gratis dengan 1.000 kredit, lalu Hobby $49/bulan (100.000 kredit, 20 concurrency, hanya US/EU), dan naik hingga Business $299/bulan (3 juta kredit, routing global). Yang perlu diperhatikan: biaya kredit berbeda حسب jenis request — halaman standar 1 kredit, tetapi rendering JavaScript 10 kredit, dan request premium-plus-render 25 kredit. Tumpukan 404 yang gagal bisa diam-diam menghabiskan jatah bulanan Anda.
Cocok untuk: developer yang ingin pengganti langsung untuk HTTP request biasa tanpa harus mengelola proxy atau browser infrastructure sendiri.
6. Oxylabs: Layanan Proxy Enterprise Volume Tinggi Terbaik
Oxylabs menawarkan salah satu surface workflow terluas di antara managed API di daftar ini: retrieval URL universal, rendering opsional, browser instructions untuk klik dan tunggu, parsing kustom, serta scheduler bawaan dengan sintaks cron.
Fitur utama:
- Target sumber universal untuk URL publik arbitrer, plus parser pencarian Google News khusus untuk discovery
- Response code yang detail, membedakan sukses penuh dari konten parsial atau hilang — jauh lebih berguna daripada status HTTP polos
- Delivery ke S3, GCS, dan object storage lainnya
- Scheduler miliknya sendiri secara eksplisit memperingatkan bahwa schedule yang belum diuji bisa membuat biaya membengkak cepat, yang terasa jujur untuk sebuah halaman harga
Harga dimulai dari free trial (hingga 2.000 hasil), lalu Micro $49/bulan, Starter $99/bulan, dan Business $999/bulan dengan tarif per hasil yang turun seiring volume naik. Satu catatan penting: saat ini Oxylabs menghitung respons 4xx sebagai hasil "sukses" yang tetap ditagihkan, jadi halaman yang tidak menghasilkan konten berguna tetap bisa memakan biaya.
Cocok untuk: enterprise yang butuh retrieval berthroughput tinggi dan fleksibel secara geografis, dan siap mengelola surface API yang lebih kompleks.
7. Crawlbase: API Terbaik untuk Parsing Situs Berita yang Berat JS
Crawlbase lebih menekankan output yang ramah artikel dibanding kebanyakan managed API lain di daftar ini. Crawling API menyediakan token biasa untuk konten statis dan token JavaScript untuk full browser rendering, plus mode readability.
Fitur utama:
md_readability=truemengembalikan Markdown yang menghapus navigasi umum, sidebar, dan gangguan iklan sambil mencoba mempertahankan artikel utama- Generic Extractor untuk penarikan konten, judul, dan metadata yang agnostik terhadap situs
- Click selector, scroll, dan kontrol tunggu untuk halaman JS interaktif
- Enterprise Crawler menambah antrean async dengan retry hingga 48 jam — bagus untuk backfill, kurang ideal untuk alert berita cepat
Harga mencakup hingga 20.000 request gratis, setelah itu biaya bergantung pada kompleksitas domain target alih-alih satu tarif tetap — cek kalkulatornya dengan sumber berita Anda yang sebenarnya sebelum menetapkan budget. Dukungan async langsung saat ini didokumentasikan khusus untuk LinkedIn kecuali support mengaktifkannya di tempat lain, jadi jangan menganggapnya berlaku untuk domain publisher sembarang.
Cocok untuk: tim yang menginginkan output artikel yang sudah dirender tanpa harus membangun parser readability sendiri dari nol.
8. Scrapy: Framework Coding Terbaik untuk News Crawler Kustom
Scrapy adalah pilihan terkuat di daftar ini bagi engineer yang benar-benar ingin memiliki crawler mereka sendiri. Ini adalah framework Python, saat ini di versi 2.17.0, yang menangani scheduling request, deduplikasi, retry, cookie, dan pipeline secara bawaan.
Fitur utama:
- Selector CSS dan XPath via Parsel untuk ekstraksi presisi
- AutoThrottle dan kontrol concurrency per domain untuk crawling yang lebih sopan
- Middleware hook untuk proxy, header, dan logika retry kustom
- Panduan dynamic content sendiri menyarankan untuk memeriksa JSON tersemat atau structured data sebelum beralih ke integrasi browser penuh
Harga: gratis, open-source, tanpa biaya per request. Biaya nyatanya ada pada compute, deployment, dan jadwal on-call seseorang. Request Scrapy biasa tidak mengeksekusi JavaScript, jadi situs berat JS butuh add-on seperti scrapy-playwright — dan penting juga dicatat bahwa dokumentasi Scrapy sendiri memperingatkan agar tidak menjalankan headless browser langsung di dalam spider, karena itu bisa melewati middleware dan deduplication.
Cocok untuk: tim engineering yang membangun crawler multi-domain jangka panjang yang memang ingin mereka miliki dan rawat sendiri.
9. Beautiful Soup: Library Ringan Terbaik untuk Halaman Berita Statis
Beautiful Soup adalah parser, bukan crawler — sebuah perbedaan yang sering dihapus dalam banyak daftar "best scraper". Ia mengambil HTML atau XML yang sudah diambil tool lain, lalu membangunnya menjadi tree yang bisa dinavigasi. Saat ini versinya 4.15.0 di PyPI.
Fitur utama:
- Mendukung beberapa parser (
html.parser,lxml,html5lib) dengan tradeoff kecepatan/kelonggaran yang berbeda, menurut dokumentasi resmi - Dukungan CSS selector melalui Soup Sieve untuk sintaks yang familiar
- Biasanya dipasangkan dengan library Requests untuk fetch HTTP yang sebenarnya
- Sangat cocok untuk parsing JSON-LD atau metadata Open Graph yang sudah ada di HTML awal halaman
Harga: gratis, open-source. Namun, ia tidak membawa networking, retry, rotasi proxy, atau eksekusi JavaScript — memang bukan tugasnya. Ini alat yang tepat ketika sebuah tim sudah memiliki markup yang diizinkan dan hanya perlu mengambil field terstruktur darinya.
Cocok untuk: engineer yang membangun pipeline kecil hingga menengah, di mana komponen lain sudah menangani proses fetch.
10. Selenium: Otomasi Browser Terbaik untuk News yang Dirender JS atau Dilindungi Login
Selenium menggerakkan browser sungguhan, sehingga ini menjadi pilihan yang tepat ketika konten benar-benar baru ada setelah JavaScript berjalan, atau ketika tugas memerlukan sesi login yang sah dan berwenang. Saat ini versinya 4.47.0.
Fitur utama:
- Selenium Manager otomatis menemukan dan menyimpan browser driver yang kompatibel, sehingga setup jadi lebih ringan
- Strategi explicit wait yang terikat pada kondisi halaman, bukan sekadar sleep tetap — ini sangat penting di situs berita modern yang terus menyuntikkan konten setelah load awal
- Mendukung headless Chrome via
--headless=newuntuk run di server - Dapat beroperasi dalam sesi login yang sah jika ketentuan publisher mengizinkan otomatisasi
Harga: gratis, open-source — tetapi biaya compute browser, container, dan maintenance driver tetap nyata, dan menjalankan satu instance browser per artikel adalah arsitektur yang salah untuk apa pun selain antrean pengecualian kecil. Panduan testing Selenium sendiri secara eksplisit tidak menyarankan automasi CAPTCHA, yang justru terasa sangat jujur dari alat yang sering diasumsikan bisa memaksa jalan melalui apa pun.
Cocok untuk: lapisan eskalasi yang sempit untuk halaman yang bergantung pada JS atau sesi berwenang — bukan transport default untuk ratusan artikel biasa.
Skala ke 100–1.000+ Sumber Berita: Mengapa Selector Tetap Sering Rusak
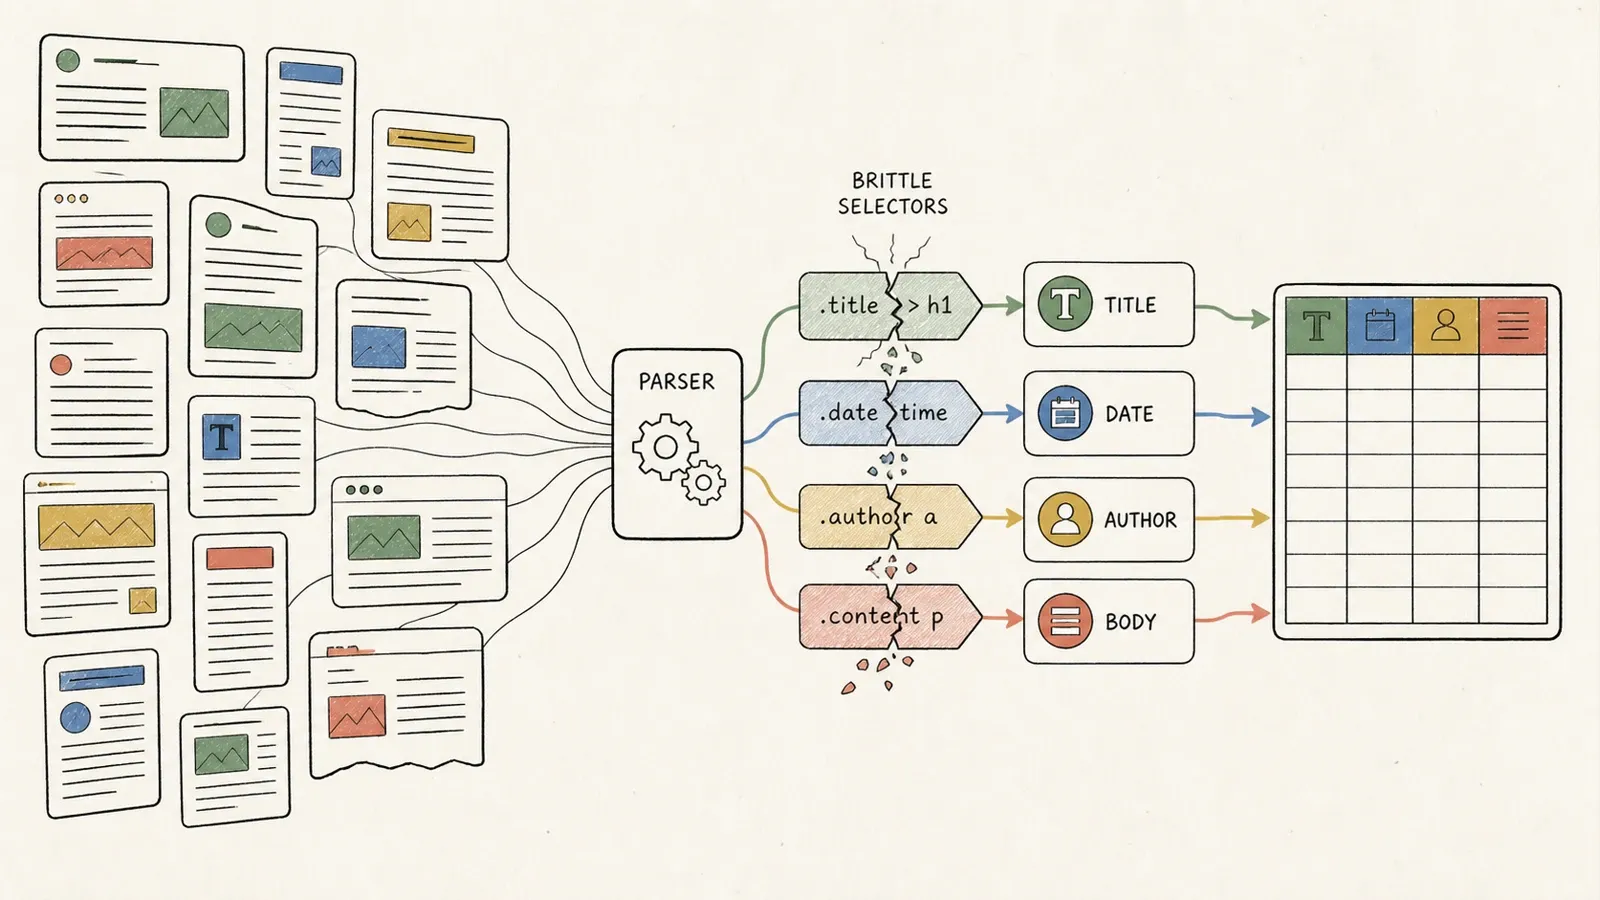
Aturan CSS dan XPath mengandung satu asumsi: "headline ada di class ini." Asumsi itu bertahan sampai publisher melakukan redesign, A/B testing pada layout, atau migrasi content management system — lalu aturan tersebut diam-diam rusak, atau lebih buruk lagi, diam-diam mengembalikan data yang salah. Sebuah scraper bisa melaporkan sukses padahal yang diambilnya adalah teaser artikel terkait, bukan isi artikel sebenarnya, atau timestamp update, bukan tanggal publikasi asli. Itu mode kegagalan yang jauh lebih berbahaya daripada hasil kosong, karena tidak ada yang sadar sampai seseorang mengambil keputusan berdasarkan data yang salah.
Tool berbasis selector statis — Scrapy, Beautiful Soup, platform no-code berbasis template — semuanya mewarisi masalah ini. Deteksi field berbasis AI atau agentic, seperti yang dipakai Thunderbit dan tool serupa, mengurangi ketergantungan pada nama class yang persis dengan menganalisis ulang struktur halaman setiap kali run, alih-alih mengandalkan aturan hardcoded. Itu benar-benar keuntungan pada skala besar. Namun ini bukan jaminan bebas maintenance — ia menukar penilaian deterministik dengan penilaian probabilistik, yang berarti satu jenis error diganti dengan jenis error lainnya.
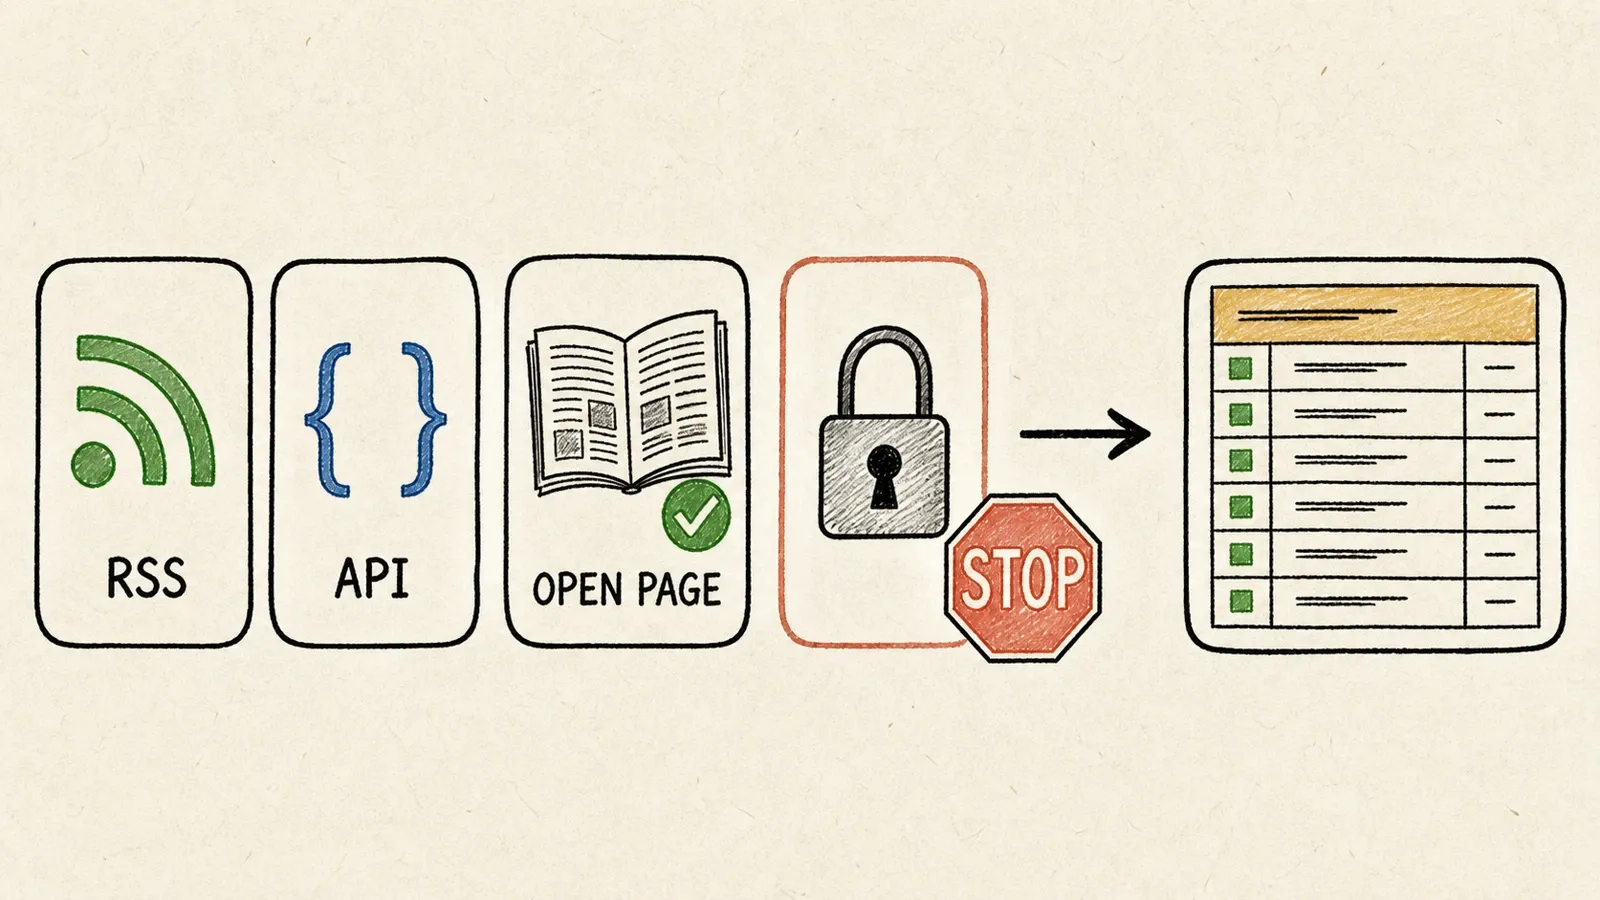
Pada skala nyata (100 hingga 1.000+ sumber), solusinya bukan memilih satu alat ajaib. Solusinya adalah membangun source registry: situs mana yang punya feed, mana yang perlu HTML scraping, field apa yang diharapkan, rate limit per domain, dan jalur karantina untuk apa pun yang mengembalikan challenge page alih-alih artikel. Feed dulu, metadata terstruktur kedua, ekstraksi generik atau AI ketiga, aturan spesifik sumber hanya untuk pengecualian bernilai paling tinggi, dan browser rendering disimpan untuk halaman yang memang benar-benar membutuhkannya. Dokumentasi dynamic content milik Scrapy pada dasarnya mengatakan hal yang sama — cek structured data sebelum beralih ke browser.
Anti-Bot dan Rendering JS: Apa yang Bisa dan Tidak Bisa Dilakukan Tiap Pendekatan
Copy marketing di area ini sering mencampur lima masalah yang sama sekali berbeda menjadi satu: client-side rendering, interaction states (klik, scroll, consent banner), kontrol laju traffic, kebutuhan autentikasi, dan hak lisensi konten. Hanya dua yang pertama benar-benar masalah rendering. Sisanya tidak ada hubungannya dengan JavaScript.
Berikut ringkasan jujurnya, alat demi alat: proxy rotation (Bright Data, Oxylabs) mengubah routing dan bisa mengurangi gesekan rate limiting, tetapi tidak menciptakan izin jika izin itu memang tidak ada. Managed rendering (Crawlbase, ScraperAPI) mengeksekusi JavaScript agar konten yang dirender di sisi klien muncul, tetapi halaman yang sudah dirender tetap bisa menampilkan login wall atau prompt berlangganan — rendering hanya membuat tantangannya terlihat, bukan melewatinya. Headless browser automation (Selenium) bisa menggerakkan interaksi sungguhan, tetapi dokumentasi Selenium sendiri tegas bahwa alat ini bukan dibuat untuk mengotomatisasi CAPTCHA. Penanganan rendering dan access oleh Thunderbit juga berlaku dengan prinsip yang sama — hanya untuk halaman yang kompatibel dan berwenang, tanpa pretensi bisa membobol paywall berat seperti yang dipakai outlet berlangganan besar.
Tidak satu pun dari sepuluh alat di artikel ini menjamin akses melalui CAPTCHA, login wall, atau paywall. Siapa pun yang bilang sebaliknya sedang menjual sesuatu yang tidak ada. Kalau Anda terus mentok, langkah yang tepat adalah mencari feed resmi, API, atau perjanjian lisensi — bukan menaikkan agresivitas taktik scraping.
Apakah Legal Meng-scrape Konten Berita? Hak Cipta dan Terms of Service
Ini bukan nasihat hukum, dan hasilnya memang bisa beda tergantung yurisdiksi dan use case — tetapi ada beberapa batas yang layak diketahui sebelum Anda membangun apa pun.
Fakta biasanya tidak dilindungi hak cipta; ekspresinya yang biasanya dilindungi. U.S. Copyright Office Circular 33 dan 17 U.S.C. §102 menjelaskan batas itu dengan jelas. Fakta yang diberitakan dalam artikel tidak otomatis terlindungi hanya karena publisher yang pertama kali memberitakannya — tetapi kata-kata, struktur, dan fotografi asli publisher biasanya terlindungi. Ini perbedaan yang sangat penting untuk news scraping, karena konten berita (tidak seperti dataset terbuka atau direktori bisnis) hampir selalu berhak cipta dalam bentuk ekspresinya.
Fair use adalah tes faktor, bukan ambang batas jumlah kata, menurut 17 U.S.C. §107. Ringkasan Copyright Office tentang Associated Press v. Meltwater layak jadi peringatan: layanan pemantauan berita komersial yang menyalin cuplikan artikel dinilai bukan fair use berdasarkan fakta kasus tersebut. Itu bukan aturan umum yang melarang monitoring — itu pengingat bahwa klaim "kami cuma mengindeksnya" tidak otomatis menang.
Pada sisi hukum akses, opini Ninth Circuit dalam hiQ Labs v. LinkedIn dan putusan Mahkamah Agung dalam Van Buren sama-sama mempersempit sejauh mana Computer Fraud and Abuse Act menjangkau — tetapi keduanya tidak memberi lisensi umum untuk mengabaikan terms of service publisher atau merusak kontrol akses teknis. Dan robots.txt, yang distandarkan dalam RFC 9309, secara eksplisit dijelaskan sebagai protokol, bukan mekanisme keamanan — mematuhinya adalah praktik yang baik, tetapi itu juga bukan lampu hijau hukum secara otomatis.
Praktik terbaik yang aman: fokus pada data yang bisa diakses publik, hindari memublikasikan ulang teks artikel penuh, pertahankan atribusi sumber dan canonical link, dan libatkan pengacara sebelum meng-scrape apa pun di balik subscription wall atau membangun produk yang mendistribusikan ulang artikel penuh dalam skala besar.
News Scraper Mana yang Sebaiknya Anda Pilih?
Kalau Anda non-engineer yang besok sudah butuh tabel headline, mulailah
Pelajari Lebih Lanjut




