
Link rusak. Halaman yatim. Ada halaman “uji coba” dari tahun 2019 yang entah bagaimana malah terindeks Google. Kalau kamu mengelola website, pasti paham betapa nyebelinnya hal seperti ini.
Crawler yang bagus bisa menangkap semua itu — lalu memetakan seluruh situs kamu supaya kamu benar-benar bisa memperbaikinya. Tapi banyak orang masih suka mencampuradukkan “web crawler” dan “web scraper”. Padahal keduanya beda.
Saya sudah menguji 10 crawler gratis di website sungguhan. Ada yang memang jago buat audit SEO. Ada juga yang lebih pas untuk ekstraksi data. Ini hasilnya — mana yang berhasil, dan mana yang tidak.
Apa Itu Website Crawler? Pahami Dasarnya Dulu
Mari diluruskan dulu: website crawler itu bukan hal yang sama dengan web scraper. Saya tahu, dua istilah ini sering dilempar ke sana-sini kayak adonan pizza, padahal inti kerjanya berbeda. Bayangkan crawler sebagai kartografer untuk situs kamu—dia menjelajahi setiap sudut, mengikuti setiap tautan, dan membuat peta dari semua halaman. Tugasnya adalah menemukan: mencari URL, memetakan struktur situs, dan mengindeks konten. Inilah yang dilakukan mesin pencari seperti Google lewat bot mereka, dan yang dipakai tool SEO untuk mengaudit kesehatan situs kamu (Thunderbit Blog: What Is a Web Crawler?).
Sementara itu, web scraper adalah penambang datanya. Dia nggak peduli dengan peta secara keseluruhan—dia cuma mau mengambil “emasnya”: harga produk, nama perusahaan, ulasan, email, dan apa pun yang kamu butuhkan. Scraper mengekstrak field tertentu dari halaman yang ditemukan crawler (Thunderbit Blog: How to Web Crawl a Site?).
Analogi singkat:
- Crawler: Orang yang jalan ke semua lorong supermarket dan mencatat seluruh produk.
- Scraper: Orang yang langsung menuju rak kopi dan menulis harga tiap varian organic blend.
Kenapa ini penting? Karena kalau tujuan kamu cuma mencari semua halaman di situs sendiri, misalnya buat audit SEO, kamu butuh crawler. Kalau kamu mau menarik semua harga produk dari situs kompetitor, kamu butuh scraper—atau idealnya, tool yang bisa melakukan keduanya.
Kenapa Memakai Web Crawler Online? Manfaat Utama untuk Bisnis
Jadi, kenapa perlu repot pakai web crawler? Karena web itu nggak makin kecil. Faktanya, lebih dari 54% brand enterprise memakai platform crawling khusus untuk mengoptimalkan situs mereka, dan beberapa tool SEO bahkan merayapi 7 miliar halaman per hari.
Berikut hal-hal yang bisa dilakukan crawler buat kamu:
- Audit SEO: Menemukan link rusak, judul yang hilang, konten duplikat, halaman yatim, dan lainnya (SEO.ai).
- Pemeriksaan Link & QA: Mendeteksi 404 dan redirect loop sebelum pengguna kamu menemukannya (Screaming Frog).
- Pembuatan Sitemap: Membuat XML sitemap secara otomatis untuk mesin pencari dan perencanaan situs (PowerMapper).
- Inventaris Konten: Menyusun daftar semua halaman, hierarki, dan metadata kamu.
- Kepatuhan & Aksesibilitas: Mengecek setiap halaman supaya sesuai dengan WCAG, SEO, dan regulasi hukum (SiteOne Crawler).
- Performa & Keamanan: Menandai halaman lambat, gambar terlalu besar, atau masalah keamanan (SiteOne Crawler).
- Data untuk AI & Analisis: Menyalurkan data hasil crawling ke tools analitik atau AI (Thunderbit Blog: Crawl4AI Review).
Berikut tabel ringkas yang memetakan use case ke peran bisnis:
| Use Case | Ideal Untuk | Manfaat / Hasil |
|---|---|---|
| Audit SEO & Situs | Tim marketing, SEO, pemilik bisnis kecil | Menemukan masalah teknis, memperbaiki struktur, meningkatkan peringkat |
| Inventaris Konten & QA | Content manager, webmaster | Audit atau migrasi konten, menangkap link/gambar yang rusak |
| Lead Generation (Scraping) | Sales, business development | Otomatisasi prospecting, mengisi CRM dengan lead terbaru |
| Competitive Intelligence | E-commerce, product manager | Memantau harga kompetitor, produk baru, perubahan stok |
| Kloning Sitemap & Struktur | Developer, DevOps, konsultan | Menyalin struktur situs untuk redesign atau backup |
| Agregasi Konten | Peneliti, media, analis | Mengumpulkan data dari banyak situs untuk analisis atau pemantauan tren |
| Riset Pasar | Analis, tim pelatihan AI | Mengumpulkan dataset besar untuk analisis atau pelatihan model AI |
(Thunderbit Blog: How to Web Crawl a Site?)
Cara Kami Memilih Tool Website Crawler Gratis Terbaik
Saya habiskan banyak malam larut, dan kopi lebih banyak dari yang ingin saya akui, buat ngulik berbagai tool crawler, baca dokumentasi, dan menjalankan test crawl. Ini kriteria yang saya pakai:
- Kemampuan Teknis: Bisa menangani website modern (JavaScript, login, konten dinamis)?
- Kemudahan Pakai: Ramah untuk non-teknis, atau butuh keahlian command-line?
- Batas Paket Gratis: Benar-benar gratis, atau cuma umpan?
- Akses Online: Berbasis cloud, aplikasi desktop, atau library kode?
- Fitur Unik: Ada sesuatu yang spesial—seperti ekstraksi AI, sitemap visual, atau crawling berbasis event?
Saya menguji tiap tool, membaca feedback pengguna, dan membandingkan fiturnya berdampingan. Kalau sebuah tool bikin saya pengin lempar laptop ke jendela, itu nggak masuk daftar.
Tabel Perbandingan Singkat: 10 Website Crawler Gratis Terbaik
| Tool & Tipe | Fitur Utama | Cocok Untuk | Kebutuhan Teknis | Detail Paket Gratis |
|---|---|---|---|---|
| Bright Data (Cloud/API) | Crawling enterprise, proxy, rendering JS, pemecahan CAPTCHA | Pengumpulan data skala besar | Skill teknis sedikit membantu | Tier gratis: 5.000 record/bulan di Web Scraper API, tanpa kartu kredit |
| Crawlbase (Cloud/API) | Crawling via API, anti-bot, proxy, rendering JS | Developer yang butuh infrastruktur crawl backend | Integrasi API | Gratis: hingga 20.000 request untuk mulai, tanpa kartu kredit; setelah itu bayar per request |
| ScraperAPI (Cloud/API) | Rotasi proxy, rendering JS, async crawl, endpoint siap pakai | Developer, monitoring harga, data SEO | Setup minimal | Gratis: 5.000 API call selama 7 hari, lalu 1.000/bulan |
| Diffbot Crawlbot (Cloud) | Crawl + ekstraksi AI, knowledge graph, rendering JS | Data terstruktur skala besar, AI/ML | Integrasi API | Gratis: 10.000 credit/bulan untuk API ekstraksi; Crawl memerlukan paket Plus |
| Screaming Frog (Desktop) | Audit SEO, analisis link/meta, sitemap, ekstraksi kustom | Audit SEO, pengelola situs | Aplikasi desktop, GUI | Gratis: 500 URL per crawl, hanya fitur inti |
| SiteOne Crawler (Desktop) | SEO, performa, aksesibilitas, keamanan, ekspor offline, Markdown | Developer, QA, migrasi, dokumentasi | Desktop/CLI, GUI | Gratis & open-source, 1.000 URL dalam laporan GUI (bisa dikonfigurasi) |
| Crawljax (Java, OpenSrc) | Crawl berbasis event untuk situs berat JS, ekspor statis | Developer, QA untuk aplikasi web dinamis | Java, CLI/config | Gratis & open-source, tanpa batas |
| Apache Nutch (Java, OpenSrc) | Terdistribusi, berbasis plugin, integrasi Hadoop, pencarian kustom | Search engine kustom, crawl skala besar | Java, command-line | Gratis & open-source, hanya biaya infrastruktur |
| YaCy (Java, OpenSrc) | Crawl & search peer-to-peer, privasi, indexing web/intranet | Pencarian privat, desentralisasi | Java, browser UI | Gratis & open-source, tanpa batas |
| PowerMapper (Desktop/SaaS) | Sitemap visual, aksesibilitas, QA, kompatibilitas browser | Agency, QA, pemetaan visual | GUI, mudah digunakan | Trial gratis: 30 hari, 100 halaman (desktop) atau 10 halaman (online) per scan |
Satu catatan penting sebelum kamu lanjut scroll: arti “gratis” di kolom terakhir itu beda-beda. SiteOne, Crawljax, Nutch, dan YaCy adalah open source—gratis tanpa batas selain kemampuan perangkat kamu sendiri. Screaming Frog gratis selamanya, tapi dibatasi 500 URL per crawl. Bright Data, ScraperAPI, dan Diffbot punya tier gratis yang nyata, tapi kecil, dan dalam kasus Diffbot, bagian crawler-nya tidak termasuk dalam paket gratis. Crawlbase memberi kamu satu blok request gratis di awal lalu menagih per request. PowerMapper adalah satu-satunya yang benar-benar trial murni di daftar ini—setelah 30 hari habis, kamu harus bayar.
Bright Data: Website Crawler Cloud Kelas Enterprise
Bright Data adalah “mesin berat” di dunia web crawling. Ini platform cloud dengan jaringan proxy masif, rendering JavaScript, pemecahan CAPTCHA, dan IDE untuk crawl kustom. Kalau kamu menjalankan pengumpulan data skala besar—misalnya memantau ratusan situs e-commerce untuk harga—infrastruktur Bright Data sulit ditandingi (aimultiple.com).
Kelebihan:
- Mampu menangani situs sulit dengan proteksi anti-bot
- Skalabel untuk kebutuhan enterprise
- Template siap pakai untuk situs populer
Kekurangan:
- Paket gratis memang nyata, tapi kecil: 5.000 record per bulan di Web Scraper API
- Bisa terlalu berlebihan untuk audit sederhana
- Ada kurva belajar untuk pengguna non-teknis
Kalau kamu perlu crawling web dalam skala besar, Bright Data rasanya seperti nyewa mobil Formula 1. Kuota gratis 5.000 record per bulan cukup buat coba-coba keliling blok; setelah itu, biayanya dihitung per pemakaian (Bright Data Pricing).
Crawlbase: Website Crawler Berbasis API untuk Developer
Crawlbase (dulu ProxyCrawl) fokus pada crawling yang bisa diprogram. Kamu panggil API mereka dengan sebuah URL, lalu mereka mengembalikan HTML—sambil mengurus proxy, geotargeting, dan CAPTCHA di belakang layar (Capterra).
Kelebihan:
- Tingkat keberhasilan tinggi (99%+)
- Menangani situs dengan JavaScript berat
- Cocok untuk diintegrasikan ke aplikasi atau workflow kamu sendiri
Kekurangan:
- Butuh integrasi API atau SDK
- Paket gratis: hingga 20.000 request untuk mulai (tanpa kartu kredit), lalu bayar per request
Kalau kamu developer yang ingin crawling, dan mungkin juga scraping, dalam skala besar tanpa repot ngurus proxy sendiri, Crawlbase pilihan yang solid (Crawlbase Pricing).
ScraperAPI: Menyederhanakan Dynamic Web Crawling
ScraperAPI adalah API model “tinggal ambilkan buat saya”. Kamu kasih URL, mereka yang ngurus proxy, headless browser, dan proteksi anti-bot, lalu mengembalikan HTML, atau data terstruktur untuk beberapa situs. Ini sangat bagus untuk halaman dinamis, walau bagian “gratis”-nya cukup terbatas: 5.000 credit API untuk 7 hari pertama, tanpa kartu, lalu 1.000 credit per bulan pada paket gratis berkelanjutan (ScraperAPI Pricing).
Kelebihan:
- Sangat mudah untuk developer (cukup satu panggilan API)
- Menangani CAPTCHA, IP ban, JavaScript
- Gratis: 5.000 API call selama 7 hari, lalu 1.000/bulan
Kekurangan:
- Tidak ada laporan crawl visual
- Kamu perlu menulis logika crawl sendiri kalau mau mengikuti tautan
Kalau kamu ingin memasukkan web crawling ke codebase dalam hitungan menit, ScraperAPI adalah pilihan yang sangat praktis.
Diffbot Crawlbot: Penemuan Struktur Website Otomatis
Diffbot Crawlbot membawa crawling ke level yang lebih cerdas. Dia bukan cuma merayapi situs—dia memakai AI untuk mengklasifikasikan halaman dan mengekstrak data terstruktur seperti artikel, produk, event, dan sebagainya ke dalam JSON. Rasanya seperti punya robot magang yang benar-benar paham isi yang dibacanya (Diffbot Free Plan).
Kelebihan:
- Ekstraksi berbasis AI, bukan sekadar crawling
- Menangani JavaScript dan konten dinamis
- Gratis: 10.000 credit/bulan, tanpa kartu kredit, mencakup Extract, Natural Language, Knowledge Graph, dan Search
Kekurangan:
- Berorientasi developer, jadi perlu integrasi API
- Bukan tool SEO visual—lebih cocok untuk proyek data
- Crawlbot itu sendiri—bagian yang merayapi seluruh situs—ada di paket Plus ke atas; credit gratis hanya mencakup API ekstraksi (Diffbot Pricing)
Kalau kamu butuh data terstruktur dalam skala besar, terutama untuk AI atau analitik, Diffbot adalah mesin yang sangat kuat.
Screaming Frog: Crawler SEO Desktop Gratis
Screaming Frog adalah crawler desktop klasik untuk audit SEO. Versi gratisnya bisa merayapi sampai 500 URL per scan dan ngasih kamu semuanya: link rusak, meta tag, konten duplikat, sitemap, dan lain-lain (Screaming Frog User Guide).
Kelebihan:
- Cepat, lengkap, dan dipercaya di dunia SEO
- Tidak perlu coding—cukup masukkan URL dan mulai
- Gratis untuk hingga 500 URL per crawl
Kekurangan:
- Hanya desktop, tidak ada versi cloud
- Fitur lanjutan seperti rendering JS dan penjadwalan butuh lisensi berbayar
Kalau kamu serius soal SEO, Screaming Frog hampir wajib dimiliki—cuma jangan berharap situs 10.000 halaman bisa dirayapi gratis.
SiteOne Crawler: Ekspor Situs Statis dan Dokumentasi
SiteOne Crawler adalah pisau Swiss Army untuk audit teknis. Ini open-source, lintas platform, dan bisa crawl, audit, bahkan mengekspor situs kamu ke Markdown untuk dokumentasi atau penggunaan offline (SiteOne Crawler).
Kelebihan:
- Mencakup SEO, performa, aksesibilitas, keamanan
- Bisa mengekspor situs untuk arsip atau migrasi
- Gratis & open-source, tanpa batas penggunaan
Kekurangan:
- Lebih teknis dibanding beberapa tool GUI lainnya
- Laporan audit di GUI dibatasi 1.000 URL secara default, tapi bisa dikonfigurasi
Kalau kamu developer, QA, atau konsultan yang pengin insight mendalam dan suka open source, SiteOne adalah permata tersembunyi.
Crawljax: Web Crawler Java Open Source untuk Halaman Dinamis
Crawljax adalah tool spesialis: dia dibuat untuk merayapi aplikasi web modern yang berat JavaScript dengan mensimulasikan interaksi pengguna, seperti klik, isi formulir, dan sebagainya. Dia berbasis event dan bahkan bisa menghasilkan versi statis dari situs yang dinamis (Wikipedia: Crawljax).
Kelebihan:
- Sangat unggul untuk crawling SPA dan situs AJAX-heavy
- Open-source dan bisa dikembangkan lebih lanjut
- Tanpa batas penggunaan
Kekurangan:
- Butuh Java dan sedikit pemrograman atau konfigurasi
- Tidak cocok untuk pengguna non-teknis
Kalau kamu perlu merayapi aplikasi React atau Angular seperti pengguna asli, Crawljax cocok banget.
Apache Nutch: Website Crawler Terdistribusi yang Skalabel
Apache Nutch adalah “bapak” dari crawler open-source. Tool ini dirancang untuk crawling masif dan terdistribusi—bayangkan membangun search engine sendiri atau mengindeks jutaan halaman (Martechvibe).
Kelebihan:
- Bisa diskalakan sampai miliaran halaman dengan Hadoop
- Sangat bisa dikustomisasi dan diperluas
- Gratis & open-source
Kekurangan:
- Kurva belajar tinggi, karena butuh Java, command-line, dan konfigurasi
- Tidak cocok untuk situs kecil atau pengguna kasual
Kalau kamu ingin crawling web dalam skala besar dan nggak takut sama command-line, Nutch adalah tool kamu.
YaCy: Web Crawler dan Search Engine Peer-to-Peer
YaCy adalah crawler dan search engine yang unik dan terdesentralisasi. Setiap instance merayapi dan mengindeks situs, lalu kamu bisa bergabung ke jaringan peer-to-peer untuk berbagi indeks dengan pengguna lain (TechRadar: YaCy).
Kelebihan:
- Fokus pada privasi, tanpa server pusat
- Bagus untuk membangun pencarian privat atau intranet
- Gratis & open-source
Kekurangan:
- Hasil bergantung pada cakupan jaringan
- Perlu sedikit setup, termasuk Java dan browser UI
Kalau kamu tertarik pada desentralisasi atau ingin punya search engine sendiri, YaCy adalah opsi yang sangat menarik.
PowerMapper: Generator Sitemap Visual untuk UX dan QA
PowerMapper fokus pada visualisasi struktur situs kamu. Tool ini merayapi situs dan menghasilkan sitemap interaktif, sekaligus memeriksa aksesibilitas, kompatibilitas browser, dan dasar-dasar SEO (Slickplan Review).
Kelebihan:
- Sitemap visual sangat berguna untuk agency dan desainer
- Mengecek aksesibilitas dan kepatuhan
- GUI mudah, tidak perlu skill teknis
Kekurangan:
- Hanya trial gratis: 30 hari, 100 halaman (desktop) atau 10 halaman (online) per scan
- Versi penuh berbayar
Kalau kamu perlu mempresentasikan sitemap ke klien atau memeriksa kepatuhan, PowerMapper adalah tool yang sangat membantu.
Memilih Web Crawler Gratis yang Tepat untuk Kebutuhan Anda
Dengan begitu banyak pilihan, gimana cara memilihnya? Ini panduan singkat saya:
- Untuk audit SEO: Screaming Frog (situs kecil), PowerMapper (visual), SiteOne (audit mendalam)
- Untuk aplikasi web dinamis: Crawljax
- Untuk skala besar atau search kustom: Apache Nutch, YaCy
- Untuk developer yang butuh akses API: Crawlbase, ScraperAPI, Diffbot
- Untuk dokumentasi atau arsip: SiteOne Crawler
- Untuk skala enterprise dengan tier gratis kecil: Bright Data, Diffbot
Faktor utama yang perlu dipertimbangkan:
- Skalabilitas: Seberapa besar situs atau job crawling kamu?
- Kemudahan pakai: Apakah kamu nyaman dengan kode, atau pengin klik sana-sini?
- Ekspor data: Apakah kamu butuh CSV, JSON, atau integrasi ke tool lain?
- Dukungan: Ada komunitas atau dokumentasi bantuan kalau kamu mentok?
Saat Web Crawling Bertemu Web Scraping: Kenapa Thunderbit Lebih Cerdas
Ekstrak data dari website mana pun menggunakan AI Agentic web scraper Thunderbit membaca website apa pun yang perlu kamu crawl dan mengekstrak data terstruktur dalam satu klik — gratis untuk 6 halaman per bulan. Get Started Free
Ini kenyataannya: kebanyakan orang tidak melakukan crawl website cuma untuk bikin peta yang cantik. Tujuan sebenarnya biasanya untuk mendapatkan data terstruktur—baik itu daftar produk, info kontak, atau inventaris konten. Di situlah Thunderbit berperan.
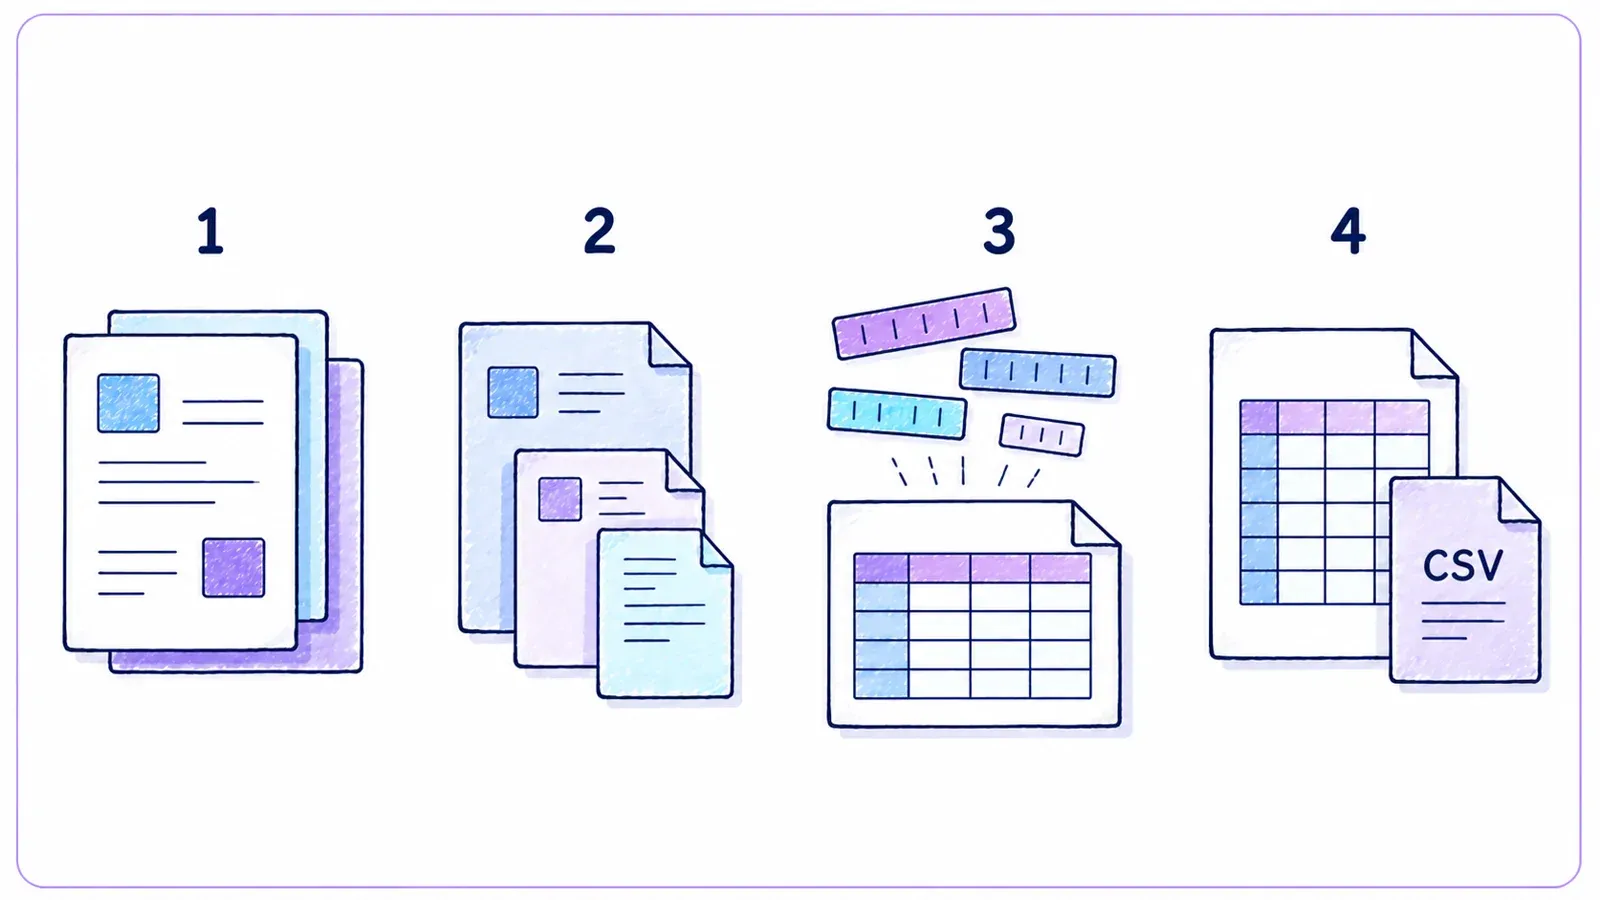
Thunderbit bukan sekadar crawler atau scraper—ini ekstensi Chrome bertenaga AI yang menggabungkan keduanya. Begini cara kerjanya:
- AI Crawler: Thunderbit menjelajahi situs, seperti crawler pada umumnya.
- Waterfall Crawling: Kalau mesin Thunderbit sendiri tidak bisa mengambil halaman, misalnya karena proteksi anti-bot yang kuat, dia otomatis beralih ke layanan crawling pihak ketiga—tanpa setup manual.
- AI Data Structuring: Setelah HTML didapat, AI Thunderbit akan menyarankan kolom yang tepat dan mengekstrak data terstruktur, seperti nama, harga, email, dan lain-lain, tanpa kamu perlu menulis selector satu pun.
- Subpage Scraping: Perlu detail dari tiap halaman produk? Thunderbit bisa otomatis mengunjungi tiap subpage dan memperkaya tabel kamu.
- Pembersihan & Ekspor Data: Bisa merangkum, mengelompokkan, menerjemahkan, dan mengekspor data ke Excel, Google Sheets, Airtable, atau Notion dalam satu klik.
- Simpel Tanpa Kode: Kalau kamu bisa memakai browser, kamu bisa pakai Thunderbit. Tanpa coding, tanpa proxy, tanpa ribet.
Kapan sebaiknya memakai Thunderbit вместо crawler tradisional?
- Saat tujuan akhir kamu adalah spreadsheet yang rapi dan siap pakai—not sekadar daftar URL.
- Saat kamu ingin mengotomatiskan seluruh proses, dari crawl, ekstrak, bersihkan, sampai ekspor, di satu tempat.
- Saat kamu menghargai waktu dan kewarasan kamu.
Kamu bisa mengunduh ekstensi Chrome Thunderbit di sini dan lihat sendiri kenapa banyak pengguna bisnis mulai beralih.
Coba Thunderbit Gratis – Agentic Web Scraper Pasang ekstensi Chrome gratis dan mulai crawling website mana pun dalam satu klik, tanpa perlu kode. Get Started Free
Kesimpulan: Memaksimalkan Website Crawler Gratis
Lihat Cara Kerja Agentic Web Scraping AI Thunderbit membaca halaman seperti manusia dan memutuskan apa yang perlu diekstrak, menggantikan konfigurasi crawler manual. Get Started Free
Website crawler sudah berkembang jauh. Baik kamu marketer, developer, atau sekadar ingin menjaga kesehatan situs, ada tool gratis—atau setidaknya gratis untuk dicoba—yang cocok untuk kamu. Dari platform enterprise seperti Bright Data dan Diffbot, sampai permata open-source seperti SiteOne dan Crawljax, hingga pemeta visual seperti PowerMapper, pilihannya sekarang jauh lebih beragam.
Namun kalau kamu mencari cara yang lebih cerdas dan terintegrasi untuk berpindah dari “saya butuh data ini” menjadi “ini spreadsheet saya”, cobalah Thunderbit. Ini dibuat untuk pengguna bisnis yang menginginkan hasil, bukan sekadar laporan.
Siap mulai crawling? Unduh salah satu tool, jalankan scan, dan lihat apa yang selama ini kamu lewatkan. Dan kalau kamu ingin berpindah dari crawling ke data yang bisa langsung dipakai hanya dalam satu klik, coba Thunderbit.
Untuk ulasan mendalam dan panduan praktis lainnya, kunjungi Thunderbit Blog.
Ekstrak Data Website dengan AI dalam Satu Klik Atur Thunderbit supaya mengikuti subpage dan berjalan terjadwal, sehingga crawl kamu tetap terbaru tanpa perlu menjalankan ulang secara manual. Get Started Free
Coba Agentic Web Scraper Get Started Free
FAQ
Apa perbedaan website crawler dan web scraper?
Crawler menemukan dan memetakan semua halaman di sebuah situs, ibarat membuat daftar isi. Scraper mengekstrak field data tertentu, seperti harga, email, atau ulasan, dari halaman itu. Crawler mencari, scraper mengambil (Thunderbit Blog: What Is a Web Crawler?).
Website crawler gratis mana yang paling cocok untuk pengguna non-teknis?
Untuk situs kecil dan audit SEO, Screaming Frog cukup ramah pengguna. Untuk pemetaan visual, PowerMapper sangat bagus selama masa trial. Thunderbit paling mudah kalau tujuan kamu adalah data terstruktur dan kamu menginginkan pengalaman tanpa kode berbasis browser.
Apakah ada website yang memblokir web crawler?
Ya—beberapa situs memakai file robots.txt atau proteksi anti-bot, seperti CAPTCHA atau IP ban, untuk memblokir crawler. Tool seperti ScraperAPI, Crawlbase, dan Thunderbit dengan waterfall crawling sering kali bisa melewatinya, tapi tetap crawl dengan bertanggung jawab dan patuhi aturan situs (Bright Data Pricing).
Apakah website crawler gratis punya batas halaman atau fitur?
Kebanyakan iya. Contohnya, Screaming Frog versi gratis dibatasi 500 URL per crawl; trial PowerMapper dibatasi 100 halaman. Tool berbasis API sering punya batas credit bulanan. Tool open-source seperti SiteOne atau Crawljax umumnya tidak punya batas keras, tapi kamu tetap dibatasi oleh perangkat kamu.
Apakah menggunakan web crawler legal dan sesuai privasi?
Secara umum, crawling halaman publik itu legal, tapi selalu cek syarat layanan situs dan robots.txt. Jangan pernah merayapi data pribadi yang sifatnya privat atau dilindungi kata sandi tanpa izin, dan perhatikan undang-undang privasi kalau kamu mengekstrak data pribadi (Crawlbase Guide).



