
Setiap AI web scraper terlihat keren banget pas demo produknya. Tapi, begitu kamu coba pakai di situs beneran yang dilindungi Cloudflare, eh, malah muncul halaman tantangan sambil dengan pede bilang kalau dia nemu 47 daftar produk. Kan sebel!
Beberapa bulan terakhir ini, saya udah ngabisin waktu buat ngevaluasi berbagai alat scraping buat tim kami di Thunderbit. Jujur aja, perbedaan antara performa demo sama keandalan di produksi itu sering banget bikin frustrasi di komunitas. Ada user Reddit yang bilang gini, "Apa yang bisa bertahan di produksi dan apa yang cuma berfungsi buat demo sebelum mati dua minggu kemudian?" Dengan 31 produk yang terdaftar di Capterra di kategori web scraping doang, ditambah puluhan ekstensi Chrome, vendor API, dan pemain lain, pilihan yang banyak ini malah bikin bingung. Makanya, saya coba 12 di antaranya.
Artikel ini bakal ngevaluasi 12 alat AI web scraper berdasarkan kriteria produksi: gimana mereka ngatasin anti-bot, skalabilitas, kualitas output terstruktur, efisiensi biaya, dukungan situs dinamis, sama fleksibilitas buat developer. Nggak ada daftar fitur muluk-muluk. Nggak ada screenshot marketing. Cuma yang bener-bener berfungsi setelah demo selesai.
Lihat Seperti Apa AI Web Scraper yang Siap Produksi
Kenapa Kebanyakan AI Web Scraper Gagal Setelah Demo
Polanya udah bisa ditebak. Situs marketing alatnya nunjukkin kalau dia bisa ngekstrak kolom bersih dari halaman daftar produk yang simpel. Kamu install, coba di situs e-commerce yang dilindungi, eh, malah dapet salah satu dari ini:
- Respon
200 OKyang isinya halaman tantangan Cloudflare, bukan data aslinya. - Hasil bersih buat 5 halaman pertama, terus tiba-tiba error atau datanya ngaco.
- Ekstraksi sempurna hari ini, tapi minggu depan selektornya rusak gara-gara ada update kecil di layout.
Ini bukan kasus langka, lho. Ini udah jadi hal biasa.
Kayak yang dibilang salah satu praktisi di Reddit: "Scraper ngembaliin 200 dengan halaman tantangan Cloudflare, agen kamu coba nalarin, halusinasi, dan kamu nggak tahu kenapa."
Masalah utamanya ada di arsitekturnya. Kebanyakan demo cuma nunjukkin lapisan parsing di halaman publik yang bersih, padahal kerjaan aslinya sering gagal di lapisan pengambilan. Situs produksi itu punya perlindungan bot, rendering dinamis, halaman detail yang bersarang, infinite scroll, status login, variasi lokal, dan layout yang bisa berubah-ubah.
Sebuah alat bisa kelihatan hebat pas demo, tapi langsung ambruk pas pertama kali dipakai sama customer yang serius.
Makanya, artikel ini ngevaluasi setiap alat dari sudut pandang kesiapan produksi, bukan cuma daftar fitur. Enam kriteria yang saya pakai:
| Kriteria | Mengapa Penting |
|---|---|
| Penanganan Anti-bot/CAPTCHA | Situs yang dilindungi bakal gagal sebelum kualitas ekstraksi jadi penting |
| Skalabilitas setelah demo | Pekerjaan batch dan eksekusi paralel nunjukkin batas operasional |
| Kualitas output terstruktur | Pengguna butuh JSON/CSV yang bersih, bukan HTML mentah yang perlu dibersihin manual |
| Efisiensi token/biaya | Ekstraksi AI bisa lebih mahal daripada scraping itu sendiri |
| Dukungan situs dinamis/berat JS | Halaman modern butuh DOM yang dirender, bukan HTML statis |
| Fleksibilitas tanpa kode vs. API | Tim penjualan dan insinyur data punya kebutuhan yang beda |
Kalau kamu pengen gambaran umum singkat tentang gimana web scraping berubah dalam dua tahun terakhir, obrolan Browserless ini bisa jadi pengantar yang bagus sebelum kamu bandingin alat satu per satu.
Di Mana AI Beneran Membantu dalam Pipeline Scraping (dan Di Mana Nggak)
Mitos yang sering beredar di pasar ini adalah "AI web scraper" itu berarti AI ngurusin semuanya dari awal sampai akhir. Padahal, konsensus komunitas udah jelas banget: scraper dulu, LLM kedua. Ada user yang blak-blakan bilang: "Kamu pakai AI buat baca screenshot halaman web. Kamu nggak pakai AI buat bikin scraper itu sendiri."
Pipeline scraping itu punya tiga lapisan yang beda, dan nilai AI itu beda-beda banget di antara ketiganya:
Crawling dan Fetching: Lapisan Infrastruktur
Di sinilah permintaan terjadi: proxy, browser headless, manajemen sesi, pemecahan CAPTCHA, percobaan ulang. AI hampir nggak ngelakuin apa-apa yang berguna di sini. Kamu tetep butuh kumpulan proxy, fingerprint browser, sama infrastruktur buat ngebuka blokir. Di sinilah kebanyakan alat gagal pertama kali di produksi.
Parsing dan Ekstraksi: Di Mana AI Bersinar
Setelah kamu punya konten halaman yang bersih, AI jago banget ngubah HTML yang nggak terstruktur jadi bidang yang terstruktur. Ekstraksi berbasis skema, deteksi bidang adaptif, sama penanganan variasi layout tanpa selektor XPath yang gampang rusak itu adalah keunggulan AI dalam scraping.
Pasca-pemrosesan: Pelabelan, Penerjemahan, Kategorisasi
Setelah ekstraksi, AI nambahin nilai dengan ngategorisasi produk, nerjemahin teks, normalisasi nomor telepon, atau ngeringkas deskripsi. Cocok banget, tapi cuma kalau data yang diekstrak udah bener.
Ini dia gimana 12 alat ini dipetakan di seluruh lapisan ini:
| Alat | Crawling/Fetching | Parsing/Ekstraksi | Pasca-pemrosesan | Deskripsi Terbaik |
|---|---|---|---|---|
| Thunderbit | Kuat | Kuat | Kuat | Scraper AI tanpa kode full-stack |
| Octoparse | Kuat | Sedang | Rendah | Scraper visual berbasis aturan dengan infrastruktur cloud |
| Browse AI | Sedang | Sedang | Sedang | Platform robot cloud yang ngutamain pemantauan |
| Firecrawl | Sedang | Kuat | Sedang-Rendah | API ekstraksi developer |
| Apify | Kuat | Sedang-Kuat | Sedang | Pasar aktor dan orkestrasi |
| Gumloop | Sedang | Sedang | Kuat | Otomatisasi alur kerja dengan node scraper |
| Bright Data | Sangat Kuat | Sedang | Sedang-Rendah | Tumpukan infrastruktur perusahaan |
| Bardeen | Sedang | Sedang | Kuat | Otomatisasi browser buat alur kerja GTM |
| Diffbot | Rendah-Sedang | Sangat Kuat | Sedang | Ekstraksi terlatih ditambah grafik pengetahuan |
| ScrapingBee | Kuat | Sedang-Rendah | Rendah | API pengambilan dan pembuka blokir |
| Instant Data Scraper | Rendah | Sedang (halaman sederhana) | Rendah | Scraper cepat sisi browser heuristik |
| ParseHub | Sedang | Sedang | Rendah | Scraper visual desktop buat interaksi kompleks |
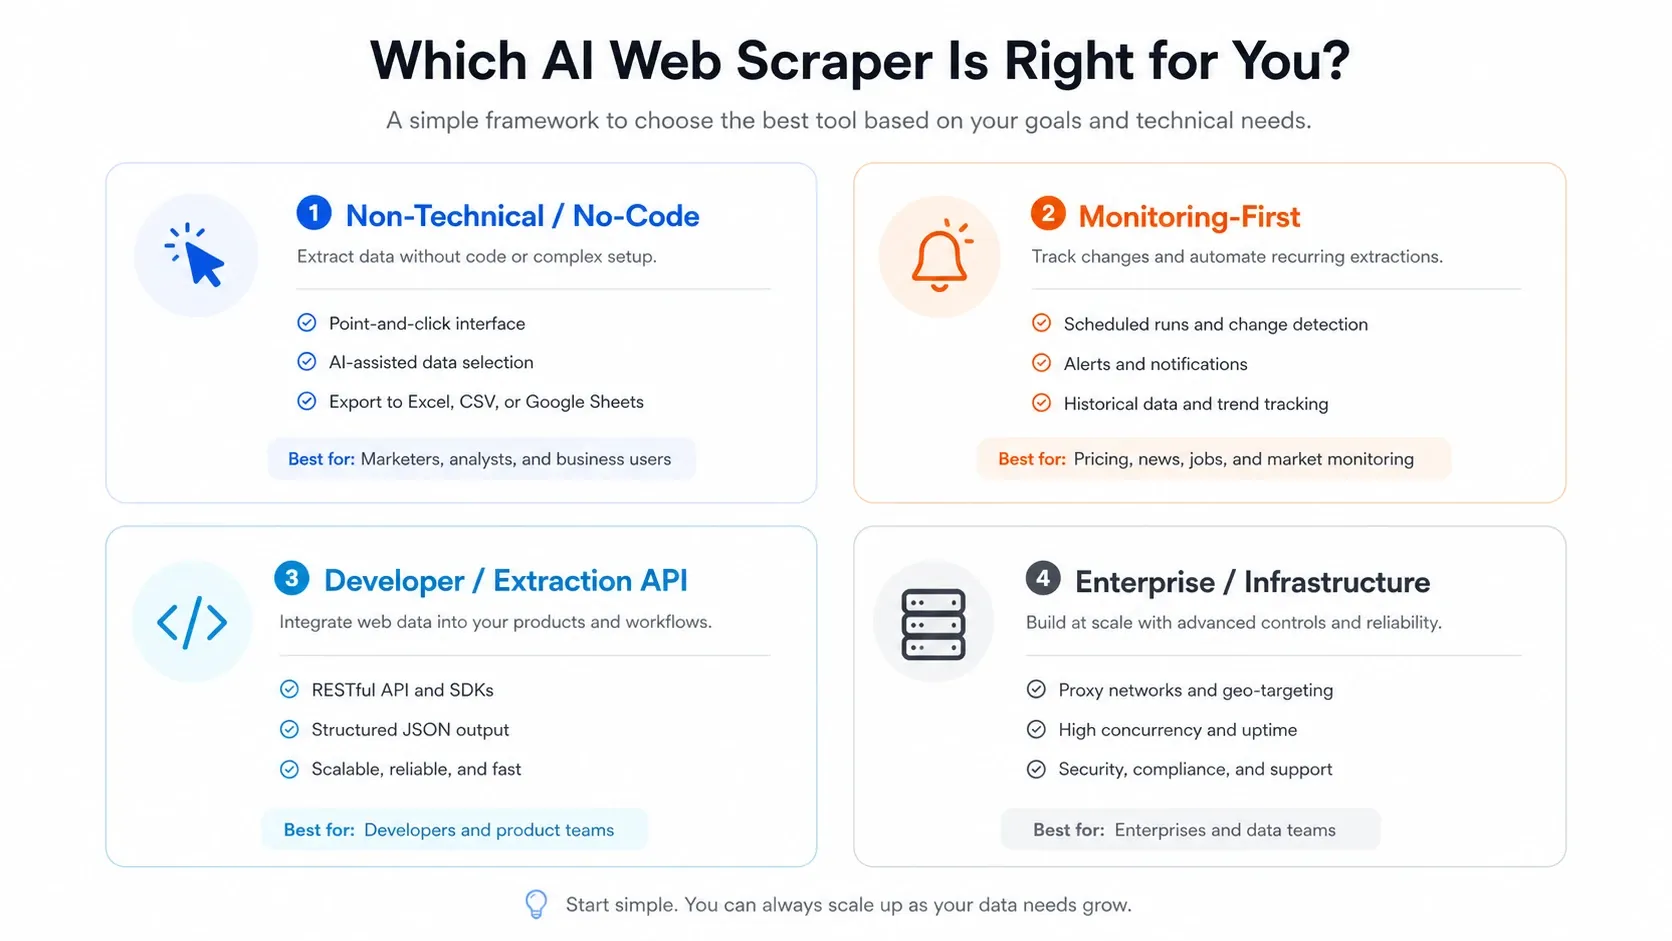
Cloud Scraping vs. Browser Scraping: Pilihan yang Nggak Ada yang Ngejelasin
Ini adalah keputusan arsitektur yang kebanyakan artikel ringkasan abaikan sepenuhnya, padahal seringkali lebih penting daripada alat mana yang kamu pilih.
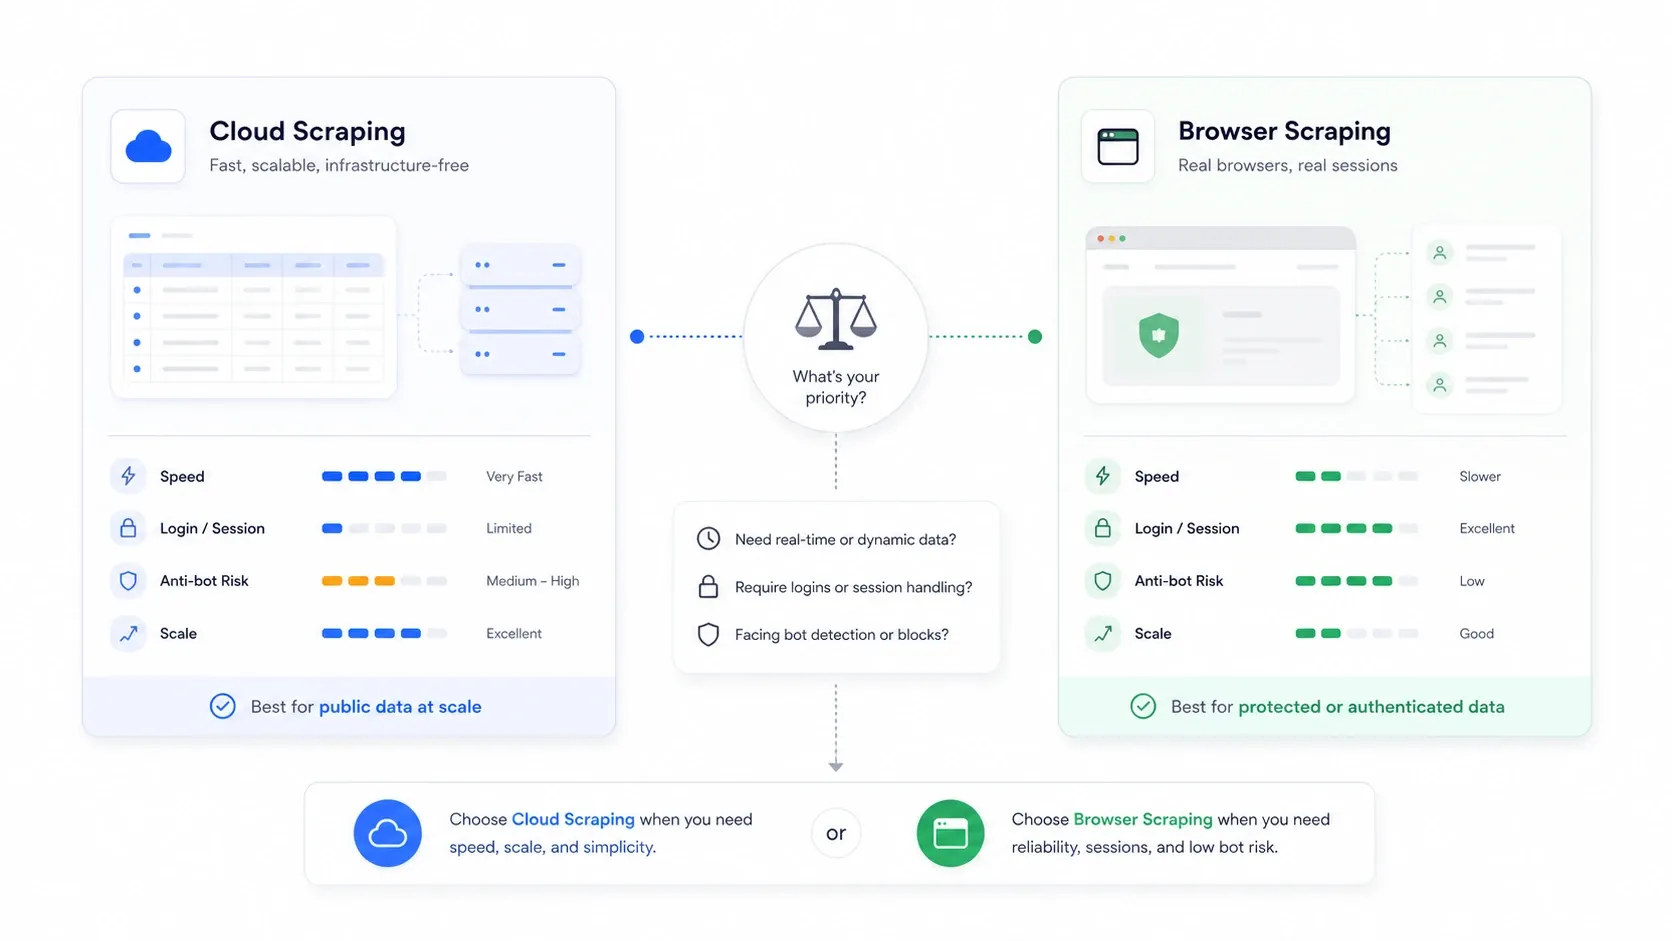
Cloud scraping itu artinya server jarak jauh ngambil halaman atas nama kamu. Browser scraping itu artinya ekstraksi terjadi di sesi browser kamu sendiri, pakai cookie kamu, IP kamu, sama status terautentikasi kamu.
| Skenario | Mode Lebih Baik | Mengapa |
|---|---|---|
| Situs e-commerce dan daftar publik dalam volume | Cloud | Paralelisme lebih cepat dan nggak ada hambatan mesin lokal |
| Situs yang butuh login atau autentikasi | Browser | Pakai ulang cookie sesi kamu yang asli |
| Situs yang ngehukum IP pusat data | Browser | Muncul sebagai lalu lintas pengguna normal |
| Pekerjaan pemantauan berulang yang besar | Cloud | Penjadwalan dan kontinuitas yang lebih mudah |
| Pekerjaan satu kali, rapuh, sensitif anti-bot | Browser | Lebih gampang buat ngecek apa yang beneran dirender situs |
Ini juga penting secara ekonomi. Laporan State of Web Scraping 2026 dari Apify nemuin kalau 65,8% praktisi ningkatin penggunaan proxy dari tahun ke tahun, dan 62%+ ngelaporin pengeluaran infrastruktur yang lebih tinggi. Anti-bot itu bukan cuma masalah teknis. Itu masalah anggaran.
Kebanyakan alat cuma nawarin satu mode. Ini dia rinciannya:
| Alat | Cloud | Browser | Keduanya |
|---|---|---|---|
| Thunderbit | ✅ | ✅ | ✅ |
| Octoparse | ✅ | ✅ (lokal) | ✅ |
| Browse AI | ✅ | Hanya pengaturan | — |
| Firecrawl | ✅ | API buat interaktif | — |
| Apify | ✅ | ✅ (lewat aktor) | ✅ |
| Gumloop | ✅ | ✅ (Agen Web) | ✅ |
| Bright Data | ✅ | ✅ | ✅ |
| Bardeen | Terbatas (halaman publik) | ✅ | Sebagian |
| Diffbot | ✅ | — | — |
| ScrapingBee | ✅ | — | — |
| Instant Data Scraper | — | ✅ | — |
| ParseHub | ✅ (berbayar) | ✅ (desktop) | ✅ |
12 AI Web Scraper Sekilas
Ini dia perbandingan utama di antara 12 alat:
| Alat | Terbaik Untuk | Tingkat Gratis | Cloud/Browser | Akses API | Penjadwalan Scraping | Penanganan Anti-Bot |
|---|---|---|---|---|---|---|
| Thunderbit | Tim non-teknis | ✅ (6 halaman) | Keduanya | ✅ | ✅ | Kuat |
| Octoparse | Scraping berbasis template | ✅ (terbatas) | Keduanya | ✅ | ✅ | Sedang-Kuat |
| Browse AI | Memantau perubahan | ✅ (terbatas) | Terutama cloud | ✅ | ✅ | Sedang |
| Firecrawl | Pipeline ekstraksi developer | ✅ (1.000 kredit/bulan) | Cloud plus browser API | ✅ | Tidak | Sedang |
| Apify | Tim developer plus pasar | ✅ ($5 penggunaan gratis) | Keduanya | ✅ | ✅ | Kuat dengan add-on |
| Gumloop | Otomatisasi alur kerja | Uji coba (14 hari) | Keduanya | ✅ | ✅ | Sedang |
| Bright Data | Akses data perusahaan | ✅ (5.000 kredit/bulan) | Keduanya | ✅ | Eksternal | Sangat Kuat |
| Bardeen | Otomatisasi browser penjualan dan operasi | ✅ (100 kredit) | Ngutamain browser | Terbatas | ✅ | Sedang-Rendah |
| Diffbot | API ekstraksi terstruktur | ✅ (10.000 kredit) | Cloud | ✅ | Tidak | Rendah pada pengambilan / tinggi pada ekstraksi |
| ScrapingBee | Pengambilan dan pembuka blokir developer | ✅ (1.000 kredit) | Cloud | ✅ | Tidak | Kuat |
| Instant Data Scraper | Scraping satu kali gratis | ✅ (sepenuhnya gratis) | Hanya browser | Tidak | Tidak | Rendah |
| ParseHub | Alur kerja visual kompleks | ✅ (5 proyek) | Desktop plus cloud | ✅ | ✅ (berbayar) | Sedang |
Pahami Bagaimana Ekstraksi AI Cocok dalam Pipeline Scraping Nyata
1. Thunderbit
Thunderbit itu AI web scraper yang kami bikin khusus buat tim non-teknis yang butuh data berkualitas produksi tanpa harus nulis kode atau ngurusin infrastruktur. Alur kerja intinya bener-bener cuma dua klik: AI Suggest Fields ngebaca halaman dan ngusulin kolom, terus Scrape ngejalanin ekstraksi dalam mode cloud atau browser.
Yang bikin beda dari scraper tanpa kode lainnya itu arsitekturnya. Thunderbit misahin masalah crawling kayak infrastruktur cloud, rotasi proxy, penanganan anti-bot, sama rendering JavaScript dari ekstraksi AI yang ngebaca HTML dan ngasilin kolom terstruktur. Ini sesuai sama pola "scraper dulu, LLM kedua" yang direkomendasiin ahli, tapi dikemas dalam alur kerja ekstensi Chrome yang bener-bener bisa dipakai sama sales representative dan manajer operasi.
Kekuatan Utama
- Scraping cloud dan browser dalam satu antarmuka. Bisa ganti mode tergantung situs targetnya publik atau butuh sesi terautentikasi kamu. Mode cloud bisa ngatasin sampai 50 halaman secara paralel.
- AI ngebaca ulang struktur halaman setiap saat. Nggak perlu maintenance XPath. Kalau situsnya update layout, Thunderbit otomatis adaptasi di eksekusi berikutnya.
- Scraping subhalaman. AI ngunjungin halaman detail yang terhubung dan nambahin data ke tabel utama tanpa konfigurasi manual.
- Prompt AI Bidang. Pelabelan, terjemahan, sama kategorisasi kustom selama ekstraksi, bukan sebagai langkah pasca-pemrosesan terpisah.
- Ekspor gratis ke Google Sheets, Excel, Airtable, sama Notion.
- Template scraper instan buat situs populer kayak Amazon, Zillow, sama LinkedIn.
- Penjadwalan bahasa alami. Tinggal bilang "scrape setiap Senin jam 9 pagi" dan itu bakal diubah jadi jadwal berulang.
- API Terbuka dengan endpoint Distill dan Extract, pemrosesan batch sampai 100 URL, sama konkurensi yang dipublikasiin dari 2 di gratis sampai 50 di Pro 1.
Di Mana Bisa Ditingkatkan
- Tingkat gratisnya sengaja kecil.
- Fokusnya di ekstensi Chrome buat pengalaman tanpa kode. Developer yang pengen alur kerja khusus API perlu pakai Open API secara terpisah.
- Bukan alat yang tepat kalau kebutuhan utama kamu itu infrastruktur proxy mentah tanpa ekstraksi.
Harga
Tingkat gratis tersedia. Paket tanpa kode mulai dari $9/bulan ditagih setiap tahun atau $15/bulan bulanan buat Starter. Harga API terpisah: 600 unit satu kali gratis, terus $16/bulan setiap tahun buat Starter API dan $40/bulan setiap tahun buat Pro 1 API. Cek Harga Thunderbit dan Harga API.
Terbaik untuk: Tim penjualan, e-commerce, dan operasi yang butuh data web terstruktur tanpa dukungan rekayasa.
2. Octoparse
Octoparse itu pembangun alur kerja visual buat web scraping dengan perpustakaan template siap pakai yang gede banget. Udah ada lumayan lama jadi punya infrastruktur cloud yang matang, dan dia ngatasin paginasi dengan baik di situs web yang terstruktur dan bisa diprediksi.
Kekuatan Utama
- Template scraping pra-bangun yang banyak buat situs populer
- Ekstraksi cloud dengan eksekusi terjadwal
- Rotasi IP dan pemecahan CAPTCHA sebagai add-on berbayar
- Akses API di paket yang lebih tinggi
Di Mana Bisa Ditingkatkan
- Kemampuan AI-nya lebih ringan daripada alat asli LLM. Saran bidangnya masih lebih ngandelin template daripada pembacaan adaptif.
- Layout yang kompleks atau nggak biasa butuh penyesuaian manual yang signifikan di editor visual.
- Kurva belajarnya jadi lebih curam setelah kamu butuh logika kondisional atau solusi anti-pemblokiran.
Harga
Paket gratis selamanya tersedia. Harga pusat bantuan resmi saat ini nunjukkin Standard mulai dari $58.44/bulan setiap tahun dan Professional mulai dari $209.16/bulan setiap tahun, sementara beberapa halaman lokal dan jalur peningkatan nunjukkin ekuivalen bulanan yang lebih tinggi. Poin pentingnya adalah harga Octoparse sekarang nyampur tingkatan langganan dengan add-on berbayar kayak proxy residensial dan pemecahan CAPTCHA.
Terbaik untuk: Analis dan tim operasi yang ngelakuin scraping situs terstruktur dan ramah template dalam skala sedang.
3. Browse AI
Browse AI itu platform tanpa kode berbasis cloud yang dibangun terutama buat mantau perubahan situs web dari waktu ke waktu, kayak harga pesaing, ketersediaan stok, sama update konten. Scraping itu bagian dari produknya, tapi pembeda aslinya adalah sistem pemantauan dan peringatan berulang.
Kekuatan Utama
- Deteksi perubahan dan peringatan bawaan
- Perekam robot tanpa kode dengan pengaturan point-and-click
- Robot pra-bangun buat situs populer
- Dukungan proxy premium di paket yang lebih tinggi
Di Mana Bisa Ditingkatkan
- Harga berbasis kredit jadi mahal dengan cepat pas mantau halaman detail dalam skala besar
- Kurang menarik buat ekstraksi satu kali berskala besar daripada alat yang ngutamain API
- Penanganan anti-bot sedang; beberapa situs masih butuh proxy premium atau solusi
Harga
Akun gratis tersedia. Paket berbayar mulai sekitar $19/bulan ditagih setiap tahun buat Personal, dengan tingkatan kredit dan pemantauan yang lebih tinggi di atas itu.
Terbaik untuk: Tim yang butuh pemantauan berkelanjutan terhadap harga pesaing, perubahan konten, atau tingkat stok daripada ekstraksi massal satu kali.
4. Firecrawl
Firecrawl itu API yang ngutamain developer yang ngubah halaman web jadi Markdown bersih atau JSON terstruktur. Ini terutama ada di lapisan ekstraksi dan bagus banget buat tim yang bikin pipeline RAG atau masukin konten web ke dalam LLM.
Kekuatan Utama
- Kualitas output Markdown yang sangat baik buat alur kerja LLM hilir
- API bersih dengan tindakan scrape, crawl, map, search, extract, dan browser
- Dukungan pemrosesan batch
- Konkurensi dari 2 di gratis sampai 100 di Growth
Di Mana Bisa Ditingkatkan
- Nggak ada antarmuka tanpa kode dan butuh skill developer
- Bantuan proxy dan anti-bot bawaan ada, tapi Firecrawl nggak diposisikan kayak vendor pembuka blokir khusus
- Nggak ada penjadwal pihak pertama buat pekerjaan berulang
- Nggak hemat biaya buat non-developer yang cuma pengen spreadsheet data
Harga
Paket gratis mencakup 1.000 kredit per bulan. Paket berbayar mulai dari $16/bulan setiap tahun buat Hobby dan meningkat dengan lebih banyak kredit, konkurensi, dan penggunaan browser. Sesi browser ditagih secara terpisah dalam kredit.
Terbaik untuk: Developer yang bikin pipeline LLM, sistem RAG, atau alur kerja ekstraksi kustom yang butuh Markdown bersih atau JSON dari halaman web.
5. Apify
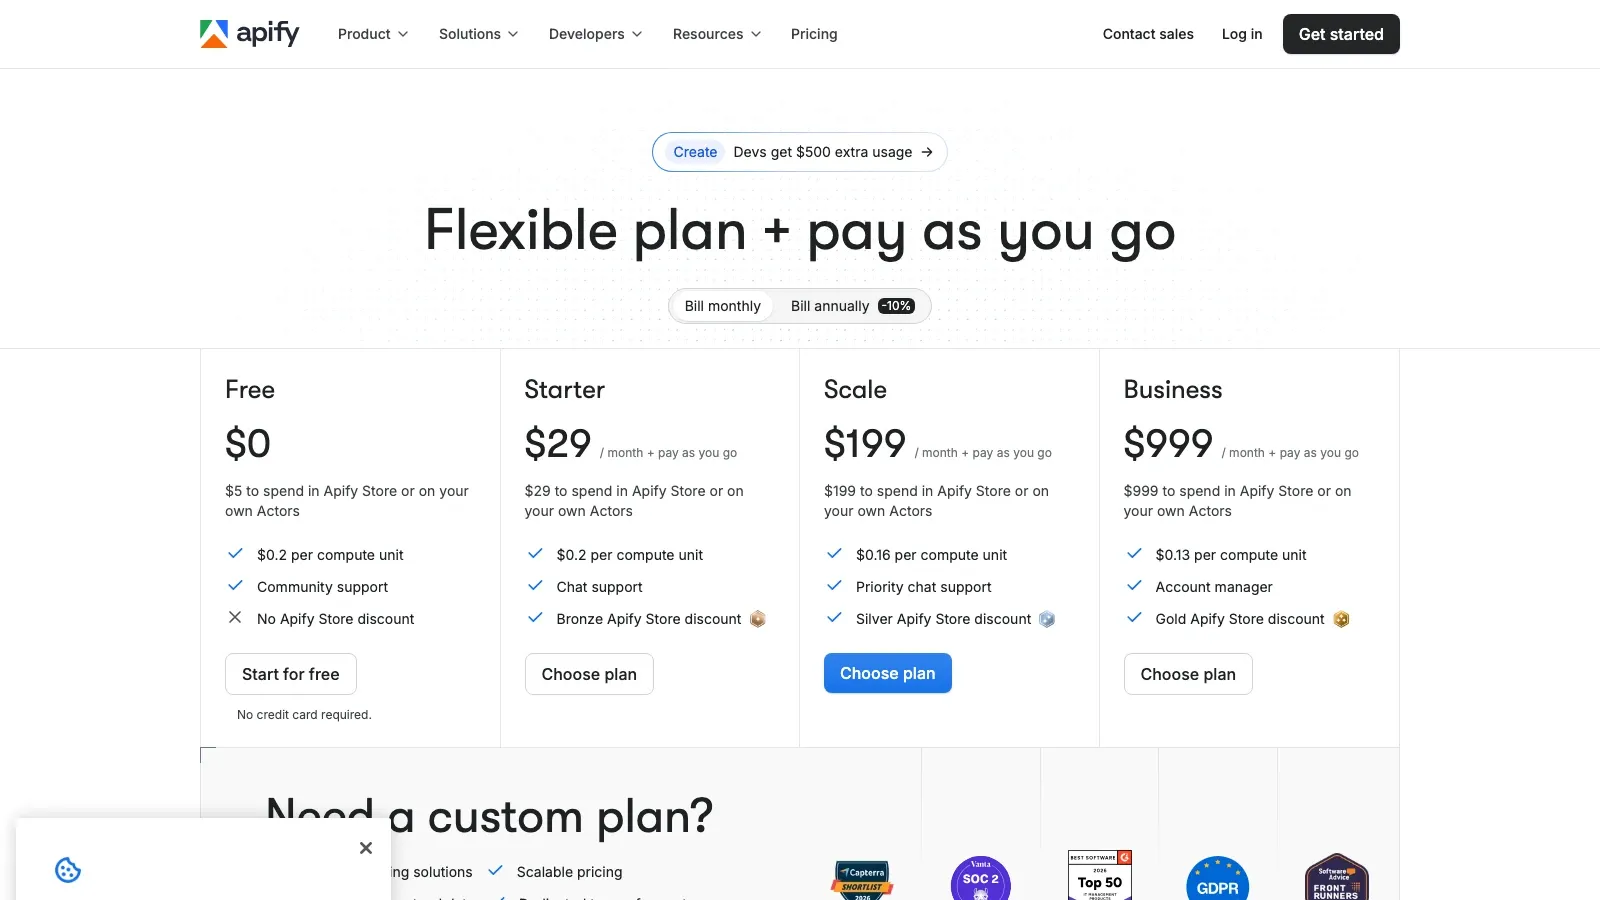
Apify itu platform dengan pasar aktor scraping pra-bangun ditambah alat buat bikin yang kustom. Anggap aja sebagai lapisan orkestrasi di mana kamu milih atau bikin scraper khusus buat situs tertentu, terus jadwalkan dan kelola lewat API terpadu.
Kekuatan Utama
- Pasar aktor gede dengan scraper yang dibangun komunitas buat ratusan situs
- API dan SDK yang kuat buat developer
- Manajemen proxy dan penjadwalan bawaan
- Terintegrasi dengan banyak alat hilir
Di Mana Bisa Ditingkatkan
- "Tanpa kode" cuma sebagian bener setelah kamu ninggalin pasar dan butuh logika kustom
- Keandalan aktor tergantung sama maintenance komunitas
- Harga bisa naik karena biaya komputasi, aktor, dan proxy numpuk
Harga
Tingkat gratis mencakup $5 dalam kredit platform bulanan. Paket berbayar mulai dari $29/bulan buat Starter, dengan tingkatan yang berorientasi skala di atas itu.
Terbaik untuk: Tim developer yang pengen alur kerja scraping yang bisa dipakai ulang dan bisa dijadwalkan dengan ekosistem solusi pra-bangun yang gede.
6. Gumloop
Gumloop itu platform otomatisasi alur kerja tanpa kode yang nyakup node web scraping. Nilai aslinya bukan cuma scraping. Ini ngehubungin ekstraksi ke LLM, Google Sheets, CRM, sama alat lain dalam satu kanvas visual.
Kekuatan Utama
- Pembangun alur kerja drag-and-drop visual
- Ngintegrasiin scraping dengan LLM dan alat bisnis hilir dalam satu alur
- Cuma uji coba gratis 14 hari dari paket Pro (20.000 kredit/bulan), nggak ada tingkat gratis permanen
- Penjadwalan berbasis waktu buat alur kerja berulang
- Mode scraping dasar dan Agen Web interaktif nyakup alur sederhana dan lebih kaya
Di Mana Bisa Ditingkatkan
- Mesin scraping kurang kuat daripada alat AI web scraper khusus
- Kedalaman anti-bot dan proxy terbatas dibandingin sama vendor spesialis
- Batas konkurensi dan pemicu lebih ketat di paket gratis
- Nggak ideal buat scraping berskala besar dan bervolume tinggi sebagai kasus penggunaan utama
Harga
Nggak ada paket gratis permanen. Gumloop ngegabungin struktur Solo dan Tim lamanya jadi satu paket Pro di akhir 2025, sekarang dihargai $37/bulan (20.000 kredit/bulan) dengan uji coba gratis 14 hari, ditambah tingkat Enterprise dengan harga kustom terpisah buat tim yang lebih gede.
Terbaik untuk: Tim yang pengen scraping sebagai salah satu langkah dalam alur kerja otomatis yang lebih luas: scrape, analisis, dan dorong ke alat bisnis.
Kalau kamu pengen liat gimana alur kerja ekstraksi asli AI terasa dalam praktik sebelum baca sisa daftar, panduan Thunderbit ini adalah demo produk yang paling relevan buat tim non-teknis.
7. Bright Data
Bright Data itu tumpukan infrastruktur tingkat perusahaan di daftar ini. Kalau masalah kamu itu "Saya nggak bisa ngelewatin perlindungan bot di situs ini nggak peduli apa yang saya coba," Bright Data mungkin jawabannya, tapi itu dateng dengan kompleksitas dan harga perusahaan yang sesuai.
Kekuatan Utama
- Jaringan proxy terkemuka di industri di seluruh IP residensial, pusat data, dan seluler
- Web Unlocker buat bypass anti-bot dan CAPTCHA
- Scraping Browser dengan pembuka blokir bawaan
- Kumpulan data pra-koleksi tersedia buat dibeli
- Kontrol terprogram penuh lewat API dan SDK
Di Mana Bisa Ditingkatkan
- Nggak dirancang buat pengguna non-teknis
- Harga ngerefleksiin posisi perusahaan
- Ekstraksi AI bukan alasan utama buat beli platform
Harga
Browser API mulai dari $8/GB bayar sesuai penggunaan, dengan tarif per GB yang lebih rendah di komitmen bulanan yang lebih besar. Web Unlocker, SERP API, dan Web Scraper API sekarang nyertai tingkat gratis 5.000 kredit/bulan, ditambah paket Pay As You Go dan Scale. Kumpulan data dan kumpulan proxy pakai unit harga yang beda.
Terbaik untuk: Tim data perusahaan yang perlu ngelakuin scraping situs yang sangat dilindungi dalam skala besar dan punya staf teknis buat ngelola infrastruktur.
8. Bardeen
Bardeen itu alat otomatisasi browser yang fokus di klik, pengisian formulir, sama scraping dengan ekstraksi data bertenaga AI yang berlapis di atasnya. Ini paling baik dipahami sebagai alat alur kerja GTM yang kebetulan ngelakuin scraping, bukan alat scraping yang kebetulan ngelakuin GTM.
Kekuatan Utama
- Otomatisasi gaya playbook yang intuitif dengan scraping sebagai salah satu langkah
- Scraper resmi yang dikelola sama tim Bardeen buat situs populer
- Integrasi yang kuat dengan CRM, Google Sheets, Slack, sama alat bisnis lainnya
- Bagus buat scraping prospek, pengayaan, sama alur kerja ekspor CRM
Di Mana Bisa Ditingkatkan
- Arsitektur yang ngutamain browser ngebatesin scraping tanpa pengawasan bervolume tinggi
- Cloud scraping cuma berfungsi di halaman publik, bukan halaman yang dibatesin
- Penanganan anti-bot sebagian besar adalah apa pun yang udah disediain sesi browser kamu
- Ekstraksi AI bisa kesulitan dengan layout halaman yang kompleks atau nggak standar
Harga
Paket gratis mencakup 100 kredit bulanan. Dokumentasi dukungan publik ngereferensiin harga Pro $15/bulan lama buat pengguna yang udah ada, sementara kemasan komersial Bardeen saat ini lebih berorientasi perusahaan dan alur kerja daripada harga scraper kelas bawah klasik.
Terbaik untuk: Tim penjualan dan operasi yang butuh scraping sebagai bagian dari alur kerja otomatisasi browser yang lebih luas.
9. Diffbot
Diffbot pakai visi komputer dan NLP buat ngebaca halaman web kayak manusia, ngasilin data terstruktur buat artikel, produk, diskusi, sama organisasi. Ini salah satu API ekstraksi berkualitas tertinggi yang tersedia kalau halaman kamu sesuai sama model pra-terlatihnya.
Kekuatan Utama
- Model ekstraksi pra-terlatih buat artikel, produk, diskusi, dan lainnya
- Knowledge Graph dengan miliaran entitas buat pengayaan data
- Kualitas output terstruktur yang kuat di jenis halaman yang didukung
- API developer yang jelas dengan batas tarif yang dipublikasiin
Di Mana Bisa Ditingkatkan
- Nggak ada antarmuka tanpa kode
- Nggak ada crawling bawaan, manajemen proxy, atau penanganan anti-bot
- Mahal buat tim kecil
- Kurang fleksibel di jenis halaman non-standar daripada ekstraktor prompt skema
Harga
Paket gratis mencakup 10.000 kredit. Startup adalah $299/bulan buat 250.000 kredit, dan Plus adalah $899/bulan buat 1.000.000 kredit.
Terbaik untuk: Tim developer yang butuh ekstraksi terstruktur akurasi tinggi dari jenis halaman standar dan bersedia nangani pengambilan secara terpisah.
10. ScrapingBee
ScrapingBee itu API web scraping yang fokus di lapisan pengambilan dan pembuka blokir. Kamu ngirim URL, dia nangani proxy, rendering browser headless, sama pertahanan anti-bot, dan dia ngembaliin HTML atau data yang diekstrak secara opsional.
Kekuatan Utama
- Rotasi proxy dan penanganan anti-bot bawaan
- Dukungan rendering JavaScript
- API REST sederhana
- Endpoint scraping Google Search
- Konkurensi yang dipublikasiin berdasarkan paket
Di Mana Bisa Ditingkatkan
- Fitur ekstraksi AI terbatas
- Nggak ada antarmuka tanpa kode
- Nggak ada penjadwalan atau pemantauan bawaan
- Respon
200dengan halaman blokir masih bisa dihitung sebagai permintaan yang berhasil
Harga
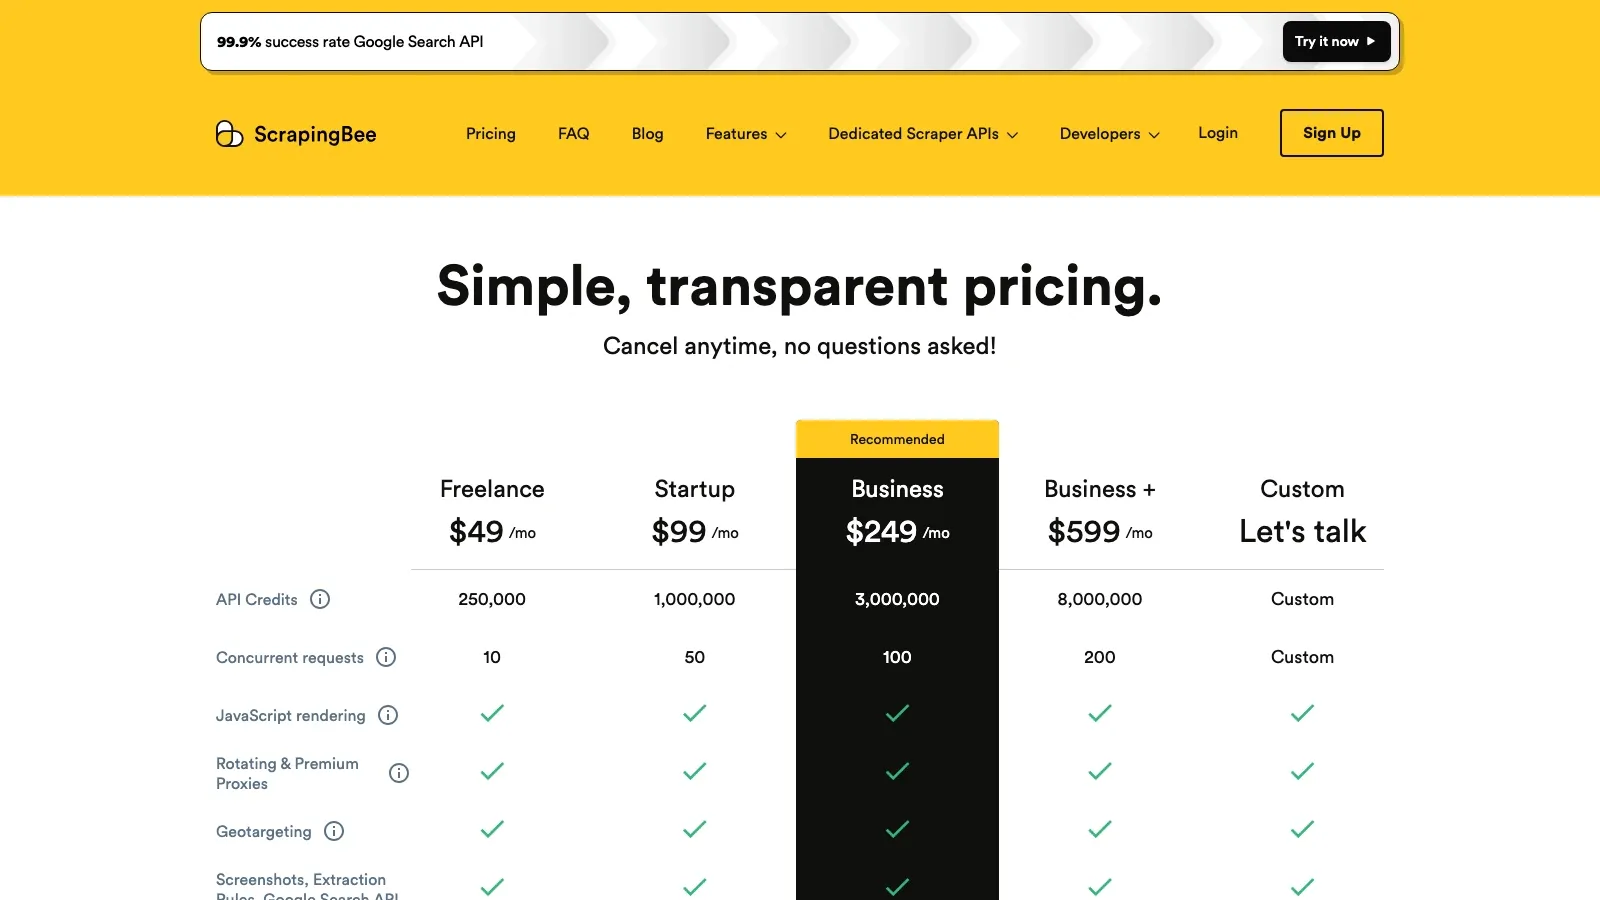
Paket gratis mencakup 1.000 kredit API. Paket berbayar mulai dari $49/bulan dan meningkat dengan konkurensi dan volume permintaan yang lebih tinggi.
Terbaik untuk: Developer yang terutama butuh pengambilan halaman yang andal ngelewatin pertahanan anti-bot dan bakal nangani ekstraksi dengan kode mereka sendiri atau alat terpisah.
11. Instant Data Scraper

Instant Data Scraper itu ekstensi Chrome gratis dengan lebih dari 1.000.000 pengguna yang otomatis ngedeteksi pola data di halaman dan ngizinin kamu ngekspor ke CSV atau Excel. Nggak ada saran bidang AI dalam arti LLM. Ini pakai deteksi pola heuristik.
Kekuatan Utama
- Sepenuhnya gratis, nggak perlu akun
- Deteksi data satu klik di banyak halaman daftar dan tabel
- Nangani paginasi di beberapa situs
- Hambatan masuk yang sangat rendah
- Masih dipelihara, dengan update Chrome Web Store di tahun 2026
Di Mana Bisa Ditingkatkan
- Nggak ada saran bidang atau pelabelan data bertenaga AI
- Nggak ada cloud scraping, penjadwalan, atau API
- Kesulitan dengan layout yang kompleks, konten dinamis, dan situs yang berat JS
- Nggak ada penanganan anti-bot di luar apa yang udah bisa dimuat sama browser kamu
- Ekspor terbatas di CSV dan Excel
Harga
Gratis. Selamanya.
Terbaik untuk: Siapa pun yang butuh scraping cepat, satu kali dari halaman daftar sederhana dan nggak pengen bikin akun atau bayar apa pun.
12. ParseHub
ParseHub itu aplikasi desktop dengan antarmuka visual, point-and-click buat bikin proyek scraping. Ini bisa nangani data bersarang yang kompleks, konten yang dimuat AJAX, infinite scroll, sama interaksi dropdown yang sering dilewatin sama ekstensi yang lebih sederhana.
Kekuatan Utama
- Antarmuka selektor visual buat ngedefinisiin aturan ekstraksi
- Nangani data bersarang, dropdown, infinite scroll, sama konten AJAX
- Tingkat gratis dengan sampai 5 proyek
- Ekspor ke JSON, CSV, sama Excel
- Penjadwalan cloud dan rotasi IP di paket berbayar
Di Mana Bisa Ditingkatkan
- Alur kerja khusus desktop, nggak ada kenyamanan ekstensi browser
- Kecepatan eksekusi lebih lambat dibandingin sama alat asli cloud
- Proyek rusak kalau layout situs berubah karena nggak ada lapisan pembacaan ulang AI
- Kemampuan AI terbatas dan nuansa scraper visual yang lebih lama
Harga
Paket gratis tersedia dengan 5 proyek dan 200 halaman per eksekusi. Paket berbayar mulai dari $189/bulan dengan penjadwalan, rotasi IP, dan batas yang lebih tinggi.
Terbaik untuk: Pengguna non-teknis yang perlu ngelakuin scraping situs interaktif yang kompleks dan bersedia nginvestasiin waktu dalam pengaturan alur kerja visual.
Cara Memulai dengan AI Web Scraper dalam 5 Langkah
Setiap alat di daftar ini punya alur orientasi yang beda. Saya bakal pakai Thunderbit sebagai contoh konkret karena paling sesuai sama niat pencarian "Saya cuma perlu ini berfungsi di halaman nyata".
Langkah 1: Instal dan Navigasi
Instal Ekstensi Chrome Thunderbit dan navigasi ke halaman yang pengen kamu scrape: daftar produk, direktori, atau portal real estat.
Langkah 2: Biarin AI Ngesaranin Bidang Data Kamu
Klik AI Suggest Fields. AI ngebaca halaman saat ini dan ngusulin nama kolom dan jenis data. Di halaman produk, dia mungkin nyaranin Nama Produk, Harga, Peringkat, URL Gambar, sama Deskripsi.
Langkah 3: Sesuaikan Bidang dengan Prompt AI
Sesuaikan kolom kalau default-nya nggak sepenuhnya bener. Tambahin Prompt AI Bidang buat transformasi kustom kayak "terjemahin deskripsi ke bahasa Spanyol," "kategorisasi sebagai Elektronik, Rumah, atau Mode," atau "ekstrak cuma harga numerik."
Langkah 4: Pilih Mode Cloud atau Browser dan Scrape
Pilih cloud scraping buat situs publik atau browser scraping buat target yang diautentikasi atau sangat dilindungi. Terus klik Scrape.
Langkah 5: Ekspor Data Kamu ke Mana Aja
Ekspor hasil ke Google Sheets, Excel, Airtable, atau Notion. Ekspor gratis.
Gimana Kalau Layout Situs Berubah?
Ini keuntungan produksi utama dari ekstraktor asli AI dibandingin alat berbasis aturan. Scraper tradisional kayak ParseHub dan alur kerja Octoparse yang lebih lama ngandelin selektor XPath atau jalur CSS. Kalau situsnya update struktur HTML-nya, selektor itu rusak dan kamu harus balik lagi ke konfigurasi manual.
Ekstraktor bertenaga AI kayak Thunderbit ngebaca ulang struktur halaman setiap saat. Itu artinya nggak ada maintenance XPath dan nggak ada selektor yang gampang rusak. AI adaptasi sama perubahan layout secara otomatis di eksekusi berikutnya.
Penjadwalan Scraping dan Akses API: Fitur Pengguna Tingkat Lanjut yang Nggak Ada yang Ngereview
Scraping satu kali bagus buat penelitian. Kasus penggunaan produksi kayak pemantauan harga, penyegaran daftar prospek, sama pelacakan stok butuh ekstraksi berulang dan akses terprogram. Fitur-fitur ini misahin mainan dari alat.
Dukungan Penjadwalan
| Alat | Penjadwalan Asli | Catatan |
|---|---|---|
| Thunderbit | ✅ | Pengaturan bahasa alami |
| Octoparse | ✅ | Eksekusi terjadwal cloud |
| Browse AI | ✅ | Fitur produk inti |
| Firecrawl | ❌ | Pakai cron eksternal |
| Apify | ✅ | Ekspresi cron penuh |
| Gumloop | ✅ | Pemicu alur kerja berbasis waktu |
| Bright Data | Eksternal | Biasanya diatur lewat sistem pelanggan |
| Bardeen | ✅ | Penjadwalan playbook |
| Diffbot | ❌ | Ngutamain API, orkestrasi eksternal |
| ScrapingBee | ❌ | Cuma API |
| Instant Data Scraper | ❌ | Alat browser manual |
| ParseHub | ✅ (berbayar) | Fitur premium |
Perbandingan API Developer
| Alat | Konkurensi atau Sinyal Tarif | Model Harga |
|---|---|---|
| Thunderbit | 2 → 50 konkurensi | Berbasis kredit |
| Firecrawl | 2 → 100 konkurensi | Berbasis kredit |
| Apify | Tergantung paket | Unit komputasi |
| Gumloop | Konkurensi alur kerja terbatas paket | Berbasis kredit |
| Diffbot | 5 panggilan/menit → 25 panggilan/detik | Berbasis kredit |
| ScrapingBee | 10 → 200 konkurensi | Berbasis kredit API |
| Bright Data | Browser API ngiklanin permintaan konkurensi tak terbatas | Berbasis GB |
Kalau kasus penggunaan kamu lebih teknis dan kamu lagi nyoba mutusin seberapa banyak infrastruktur yang pengen kamu punya, panduan Firecrawl ini adalah pelengkap berorientasi eksekusi yang berguna buat perbandingan produk di atas.
Cara Milih AI Web Scraper yang Tepat
Setelah nyoba semua 12 alat, ini dia cara saya bakal mutusin:
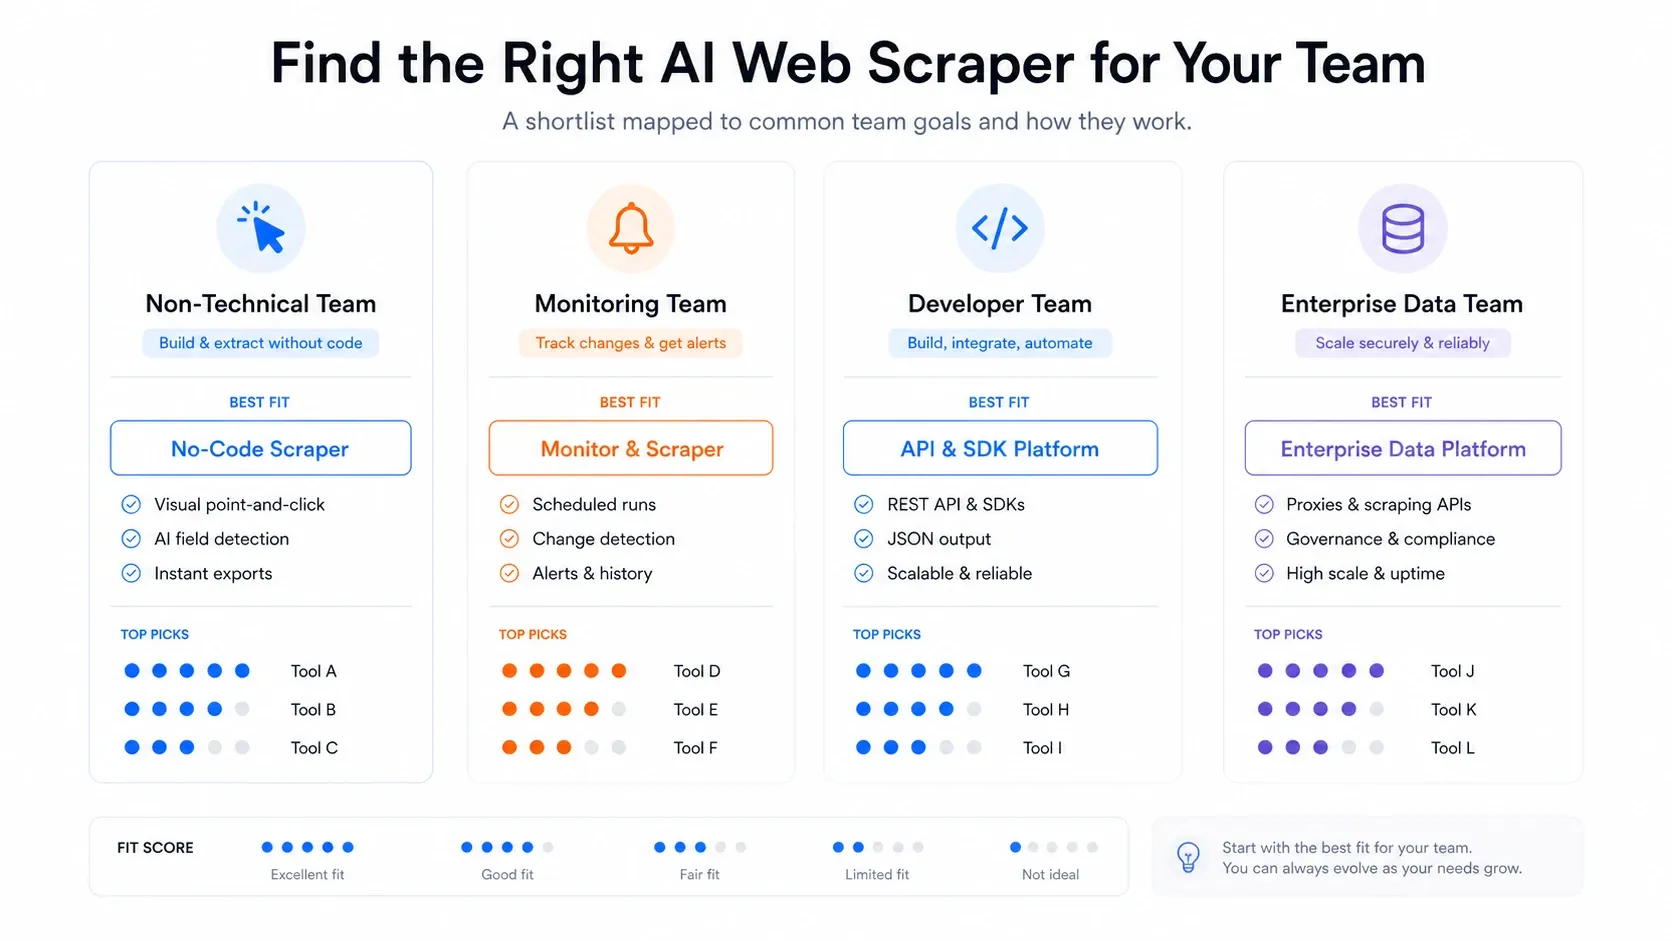
- Tim non-teknis yang butuh data cepat: Mulai aja sama Thunderbit. Alur kerja dua klik, ekspor gratis, sama tombol browser-cloud nyakup sebagian besar kebutuhan scraping bisnis tanpa dukungan rekayasa.
- Butuh pemantauan dan peringatan berkelanjutan: Browse AI dibangun khusus buat ini. Ini bukan ekstraktor satu kali terkuat, tapi deteksi perubahannya itu fitur kelas satu.
- Developer yang bikin pipeline LLM: Firecrawl buat ekstraksi Markdown atau JSON, atau Diffbot buat ekstraksi terstruktur pra-terlatih. Pasangin salah satunya sama ScrapingBee atau Bright Data kalau kamu butuh penanganan anti-bot yang serius di lapisan pengambilan.
- Butuh pasar scraper pra-bangun: Apify punya ekosistem aktor terbesar. Siap-siap aja buat maintenance kalau aktornya rusak.
- Target berskala perusahaan, sangat dilindungi: Bright Data. Nggak ada yang lain yang cocok sama infrastruktur proxynya, tapi anggarin dan staf teknis sesuai.
- Pengen scraping sebagai bagian dari otomatisasi yang lebih gede: Gumloop atau Bardeen, tergantung kamu ngotomatisasi alur kerja atau tugas GTM berbasis browser.
- Cuma butuh scraping gratis cepat: Instant Data Scraper. Nol pengaturan, nol biaya, nol kompleksitas, tapi juga nol penjadwalan, nol AI, dan nol cloud.
- Situs interaktif kompleks dengan dropdown dan AJAX: ParseHub masih nangani ini lebih baik daripada kebanyakan ekstensi, meskipun beban maintenance itu nyata.
Uji Thunderbit di Halaman Nyata Sebelum Anda Berkomitmen pada Tumpukan yang Lebih Besar
Kesimpulan
Pasar AI web scraper di tahun 2026 itu rame banget sama alat yang kelihatan mengesankan di demo tapi ngecewain di produksi. Perbedaan antara "berfungsi di screenshot marketing" dan "berfungsi di situs e-commerce yang dilindungi jam 3 pagi sesuai jadwal" itu di mana kebanyakan pembeli buang-buang waktu dan uang.
Wawasan utama dari ngevaluasi semua 12 alat itu simpel: lapisan pengambilan masih jadi bagian yang susah. AI jago di ekstraksi dan pasca-pemrosesan, tapi nggak ngegantiin infrastruktur proxy, penanganan anti-bot, atau manajemen sesi. Alat terbaik itu yang nyelesaiin kedua lapisan, kayak Thunderbit dan Bright Data, atau jujur tentang lapisan mana yang mereka cakup, kayak Firecrawl buat ekstraksi dan ScrapingBee buat pengambilan.
Kalau kamu pengen liat kayak apa AI web scraper yang siap produksi tanpa nulis kode, coba Thunderbit. Tingkat gratisnya cukup buat nguji alur kerja penuh di halaman nyata. Kalau kebutuhan kamu lebih berorientasi developer, pasangin API ekstraksi sama layanan pengambilan khusus dan hindarin frustrasi ngarepin satu alat ngelakuin semuanya.
Coba Thunderbit AI Web Scraper Gratis Get Started Free
FAQ
Kenapa kebanyakan AI web scraper gagal di situs web nyata setelah berfungsi dengan baik dalam demo?
Demo biasanya nunjukkin ekstraksi di halaman yang bersih dan nggak dilindungi. Situs nyata itu punya perlindungan Cloudflare, rendering JavaScript dinamis, paginasi, persyaratan login, sama layout yang sering berubah. Kebanyakan alat nangani lapisan parsing dan ekstraksi dengan baik tapi nggak punya infrastruktur yang kuat buat lapisan pengambilan.
Apa perbedaan antara cloud scraping dan browser scraping, dan kapan saya harus pakai masing-masing?
Cloud scraping pakai server jarak jauh buat ngambil halaman, yang lebih cepat, paralel, dan skalabel. Browser scraping jalan di sesi browser kamu sendiri dan lebih bagus buat situs yang diautentikasi atau situs dengan deteksi bot yang agresif. Thunderbit itu salah satu dari sedikit alat yang nawarin kedua mode dalam antarmuka yang sama.
Bisakah saya pakai AI web scraper buat tugas berulang kayak pemantauan harga?
Bisa, tapi cuma kalau alat itu ngedukung penjadwalan scraping. Thunderbit, Octoparse, Browse AI, Apify, Gumloop, Bardeen, sama ParseHub di paket berbayar semuanya nawarin penjadwalan.
AI web scraper mana yang terbaik kalau saya nggak punya skill coding?
Thunderbit nawarin jalur tercepat buat data yang bisa dipakai buat pengguna non-teknis. Instant Data Scraper sepenuhnya gratis tapi terbatas di halaman sederhana. Browse AI dan Octoparse nawarin antarmuka visual dengan lebih banyak pengaturan. ParseHub kuat buat situs interaktif yang kompleks tapi punya kurva belajar yang lebih curam.
Berapa biaya aslinya dari AI web scraping tingkat produksi?
Rentangnya luas. Instant Data Scraper gratis. Thunderbit, Firecrawl, sama Browse AI nawarin titik masuk gratis dengan paket berbayar berbiaya rendah. Alat kelas menengah kayak Octoparse, ParseHub, sama ScrapingBee bisa berkisar dari sekitar $49 sampai $189 per bulan. Solusi perusahaan kayak Bright Data dan Diffbot mulai jauh lebih tinggi.




