
Dva lidé vyhledají „Thunderbit vs ZenRows“ ve stejném odpoledni, ale hledají úplně jiné odpovědi. Jeden je manažer sales ops, který potřebuje do tří odpoledne vytáhnout seznam leadů z adresáře a v životě neotevřel terminál. Druhý je backendový inženýr, který se snaží stáhnout 40 000 produktových stránek ze сайта chráněného Cloudflare, aniž by skončil s IP banem až do zapomnění. Google jim oběma — s dovolením řečeno — nabídne stejný žebříček sedmi nástrojů, kde se Thunderbit sotva mihne a ZenRows je zmíněný jednou větou v tabulce.
Thunderbit vedu já, takže je jasné, že v tomhle zápase mám své preference. Ale po letech v SaaS a automatizaci (zdravím éru Automation Anywhere, kde jsem se naučil, že „no-code“ a „opravdu použitelné i pro neprogramátora“ jsou dvě hodně odlišné sliby) vím, že většinu srovnávacích článků píše někdo, kdo ani jeden produkt nepoužil na skutečnou práci. Tohle je tedy můj pokus o poctivé srovnání: kompletní tabulka funkcí, doporučení podle typu práce a úrovně dovedností místo falešného „vítěze“, ukázka cenového výpočtu podle skutečných kreditních multiplikátorů ZenRows a upřímné vysvětlení, proč je srovnávání „úspěšnosti“ těchto dvou nástrojů trochu jako porovnávat švýcarák s odtahovkou.
Co jsou Thunderbit a ZenRows? (Rychlé vysvětlení)
Než se pustíme do funkcí, je dobré vědět, že tyhle dva nástroje ve skutečnosti většinou nesoutěží o stejnou práci. Jen se pořád objevují ve stejných výsledcích vyhledávání, protože lidé předpokládají, že „web scraper“ je jedna kategorie produktu. Není.
Thunderbit: AI web scraper bez kódu pro business týmy
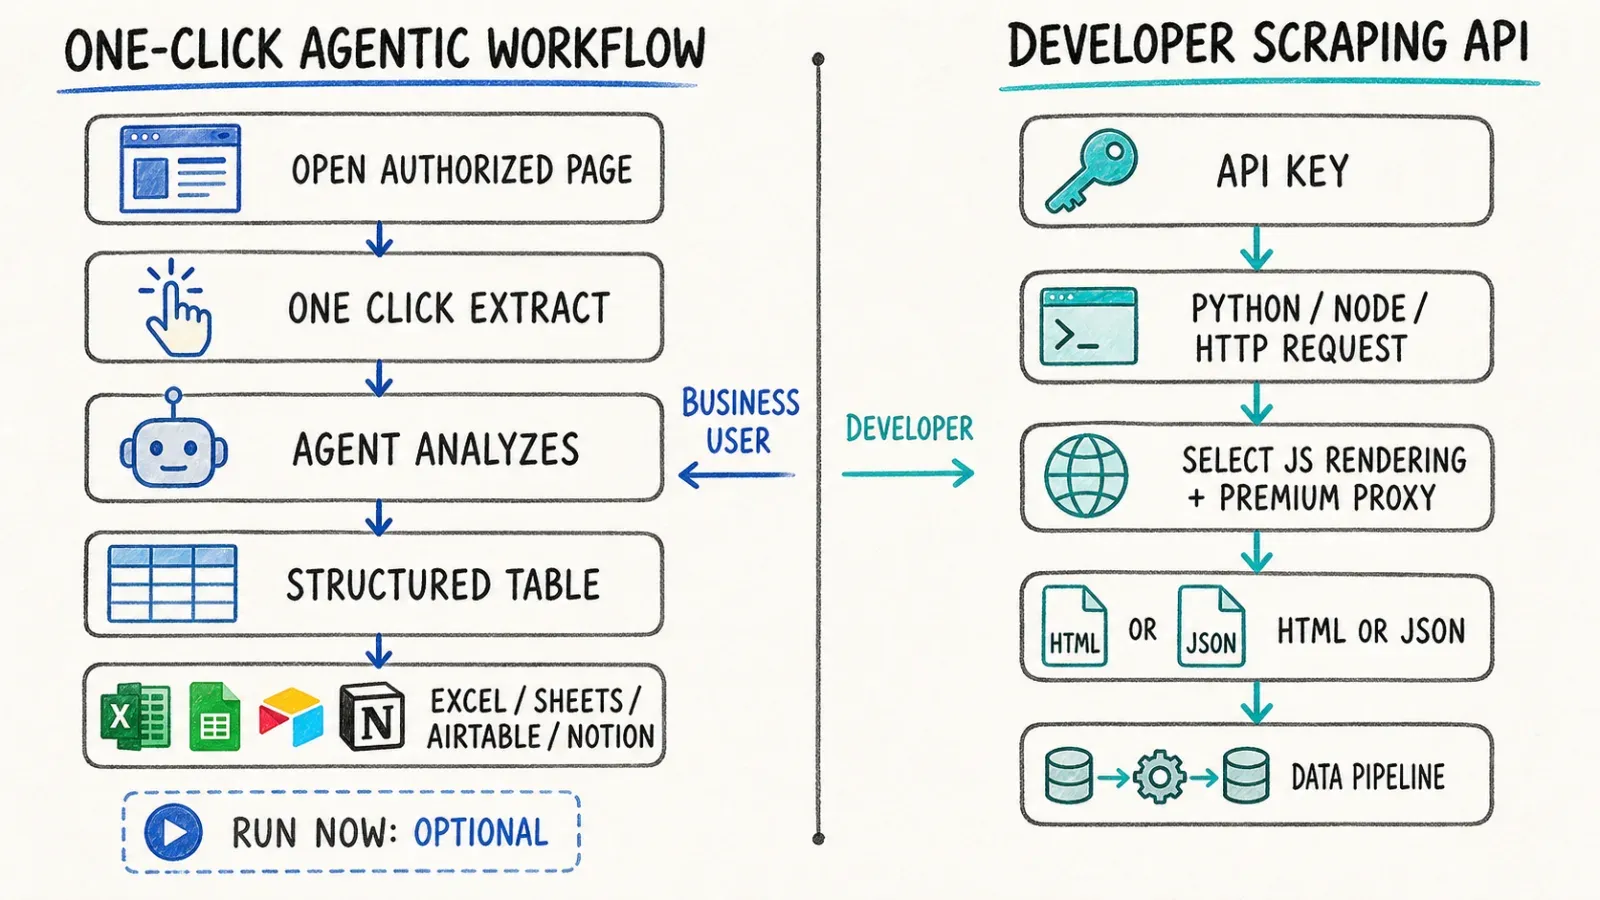
Thunderbit začal jako rozšíření do prohlížeče pro lidi, kteří potřebují data z webové stránky a nemají sebemenší zájem psát parser. Základní zkušenost běží v rozšíření Thunderbit pro Chrome: otevřete stránku, kliknete na One Click Extract a agent sám přečte stránku, rozpozná, jaká data dávají smysl vytáhnout, a připraví pole automaticky. K dispozici je tlačítko Run Now, pokud chcete proces spustit hned, ale když jen chvíli počkáte u kávy, začne se to stejně samo. Jedno kliknutí, žádné stavění schématu, žádné CSS selektory.

Tohle je ta podoba, kterou si většina lidí vybaví, když slyší „Thunderbit“. Ale můj tým vytvořil také Open API, MCP Server a CLI pro vývojáře, kteří chtějí stejnou inteligenci pro extrakci napojit do backendového pipeline nebo AI agenta místo do záložky v prohlížeči. Chci být hned na začátku upřímný: rozšíření a API nejsou ten samý produkt jen v jiném kabátu. Jsou to různé způsoby použití pro různé úlohy, a k tomu se ještě vrátím, protože to hodně souvisí s otázkou „co vlastně potřebuji“.
ZenRows: web scraping API navržené primárně pro vývojáře
ZenRows je infrastruktura. Není to nástroj, na který kliknete a rovnou exportujete tabulku — je to API, které voláte z Pythonu nebo Node, a zpět dostanete HTML, Markdown nebo strukturovaná data podle toho, jak request nastavíte. Produktová rodina zahrnuje Universal Scraper API, Scraping Browser pro interaktivní automatizaci (klikání, psaní, navigaci), Residential Proxies pro geotargeting a vlastní MCP Server pro agentní workflow.
Jejich nabídka je jednoduchá: pošlete URL, řekněte, jestli potřebujete vykreslování JavaScriptu nebo prémiové proxy, a ZenRows se postará o hru na kočku a myš proti anti-bot ochranám — fingerprinting, rotaci hlaviček, Cloudflare challenge, zkrátka celý ten nepořádek — aby váš scraper neskončil označený jako podezřelý. To je opravdu těžká technická disciplína a přesně proto ZenRows existuje. Jenže vyžaduje kód. Každý request jde přes API klíč a sadu parametrů. Pro někoho z marketingu, kdo chce jen CSV, tam není žádné „klikněte sem“.
Thunderbit vs ZenRows: Kompletní srovnávací tabulka
Před psaním jsem se podíval na stránky, které se na „Thunderbit vs ZenRows“ umisťují nejvýš, a je to docela divoké. Vlastní článek ZenRows schovává Thunderbit jen jako jednu položku v přehledu sedmi nástrojů. Stránka na Slashdotu ukazuje u obou produktů prázdný rating widget, což vám neřekne vůbec nic. Benchmarkový článek na Scrapeway Thunderbit vůbec neuvádí. Nikdo zjevně neudělal přímou tabulku funkcí pro tyto dva konkrétní produkty, takže tady je moje verze.
| Kategorie | ZenRows | Thunderbit |
|---|---|---|
| Hlavní workflow | API request + kód (Python/Node) | One Click Extract v rozšíření prohlížeče — agentní rozpoznání, Run Now volitelné |
| Nejlepší pro | Vývojáře stavějící scrapingové pipeline | Business uživatele / jednorázové nebo opakované extrakční úlohy |
| Anti-bot / CAPTCHA / Cloudflare | Účelově navržená rotace proxy + headless infrastruktura | Extrakce v autorizované relaci v prohlížeči na kompatibilních stránkách; není prezentováno jako API pro obcházení anti-bot ochran |
| Stránky vykreslené přes JS | Ano, přes headless rendering | Ano, na podporovaných/kompatibilních stránkách |
| Cíle exportu | JSON/CSV přes API odpověď | Export do Excelu, Google Sheets, Airtable, Notion (ověřte aktuální seznam) |
| Doba nastavení | Vyžaduje kód + konfiguraci API klíče | Pro základní workflow v prohlížeči není potřeba nastavovat schéma |
| Cenový model | Kreditový model, multiplikátor podle typu requestu | Před nákupem ověřte aktuální plán a strukturu kreditů |
Rychlé upozornění, protože už mě jednou zastaralá cenová tabulka spálila: tyto údaje jsou ověřené k srpnu 2026. Ceny, kreditní jednotky i seznam exportních integrací se na obou stranách mění častěji, než by obě firmy asi chtěly přiznat. Než se rozhodnete podle čísel, podívejte se na aktuální ceník ZenRows a ceník Thunderbit.
Jak funguje workflow One Click Extract v Thunderbitu
Celá pointa browserového rozšíření je v tom, že se prakticky není co učit. Otevřete stránku, ze které chcete data — adresář, katalog produktů, pracovní portál, cokoli — a kliknete na One Click Extract. Agent se podívá na strukturu stránky, zjistí, jaká pole dávají smysl (jména, ceny, e-maily, prostě to, co tam opravdu je), a připraví je bez toho, abyste mu řekli, co přesně hledat.
Run Now se sice zobrazí jako možnost, ale je skutečně volitelná. Když nic neuděláte, extrakce začne sama. Mluvil jsem s uživateli, kteří si toho nevšimli a prostě předpokládali, že musí kliknout dvakrát — což dává smysl, protože většina softwaru vás naučí čekat na potvrzení. Po dokončení můžete pole upravit pomocí pokynů v přirozeném jazyce (formátování telefonního čísla, překlad sloupce, kategorizace záznamů) a výsledky poslat do Excelu, Google Sheets, Airtable nebo Notion.
Co tenhle workflow není: backendové pipeline. Pokud potřebujete extrakci napojit na naplánovanou úlohu, RAG systém nebo agenta, který běží bez člověka sledujícího záložku v prohlížeči, k tomu slouží Open API a MCP Server. Zmiňuji to proto, že jsem viděl lidi, jak se snaží násilím vtlačit browserové rozšíření do role, pro kterou nebylo navrženo — a to je jako zkoušet řídit výrobní linku kuchyňskými nůžkami. Správný nástroj, špatná práce.
Jak funguje scraping API workflow v ZenRows
Typický postup v ZenRows začíná vygenerováním API klíče a napsáním requestu — obvykle přes jejich Python nebo Node SDK, i když fungují i čisté HTTP volání. Pošlete cílovou URL a sadu parametrů: potřebujete JavaScript rendering, prémiové (residential) proxy, chcete výstup jako syrové HTML, nebo převedený do Markdownu či prostého textu. API request provede přes svou infrastrukturu a vrátí, co jste požadovali.
Tady začíná být důležitý kreditový systém, a stojí za to na něj upozornit hned, protože se k němu vrátíme ještě v části o cenách: základní statická stránka stojí 1× kredit, ale když přidáte JavaScript rendering nebo prémiové proxy, multiplikátor roste. Konkrétní čísla projdu hned za chvíli.
Týmům, které kolem toho nechtějí stavět celý backend, se ZenRows umí napojit i na low-code automatizační platformy jako Zapier, Make a n8n, takže se data ze scrapingu mohou poslat tam, kde dávají smysl, aniž by dedikovaný inženýr musel věčně udržovat lepicí kód. Je to rozumný kompromis, i když pořád pracujete v prostředí API a parametrů, ne v point-and-click rozhraní.
Thunderbit vs ZenRows: Který nástroj sedí vaší práci a úrovni dovedností
Každý srovnávací článek, který jsem četl, to bere jako soutěž v checklistu — víc fajfek znamená vítězství. Jenže tak si scraper vybírá málokdo. Skutečná otázka je, kdo jste a co scrapujete, takže tady je moje verze, kdyby se mě na to kamarád zeptal u oběda.
Zvolte ZenRows, pokud:
- Jste vývojář a scrapujete tisíce stránek chráněných Cloudflare nebo CAPTCHA v rámci kódovaného pipeline
- Váš tým už má infrastrukturu pro parsování, retry logiku a ukládání dat a vy jen potřebujete spolehlivý přístup ke stránce
- Na concurrency a detailní kontrolu proxy/renderingu vám záleží víc než na rychlosti nastavení
Zvolte Thunderbit, pokud:
- Jste netechnický člověk v sales, operations nebo research a potřebujete vytáhnout lead list, katalog produktů nebo data z veřejně dostupné stránky
- Chcete přeskočit psaní kódu a dostat se rovnou od „otevři stránku“ k „data v tabulce“
- Workflow One Click Extract v rozšíření prohlížeče sedí vaší každodenní práci líp než editor kódu
Zvolte Thunderbit Open API nebo MCP Server, pokud:
- Chcete backendový, RAG nebo automatizovaný přístup do pipeline, ale nechcete sami stavět infrastrukturu na úrovni ZenRows
- Už pracujete v Claude, Cursor nebo jiném AI agentovi kompatibilním s MCP a chcete mít extrakci jako volatelný nástroj
Všimněte si, že se „Thunderbit“ objevuje dvakrát v různých podobách — to je záměr. Je totiž zásadně jiné rozhodnutí, jestli vybíráte rozšíření, nebo API, a předstírat, že je to jedno a totéž, by čtenáře poškozovalo.
Cenové srovnání: Co vlastně znamená „levnější“ ve velkém měřítku
Tady to začíná být opravdu záludné a myslím, že většina srovnávacích článků buď přeskakuje matematiku úplně, nebo ji spočítá špatně. ZenRows neúčtuje pevnou cenu za request — používá sdílený kreditový balíček s multiplikátory podle toho, jaký typ stránky cílíte. Plán, který slibuje „250 000 requestů“, zní velkoryse, dokud si neuvědomíte, že to číslo předpokládá, že každá stránka je jen jednoduchý statický request, což se v reálném světě skoro nestává.
Jak funguje cenový model ZenRows s kreditními multiplikátory
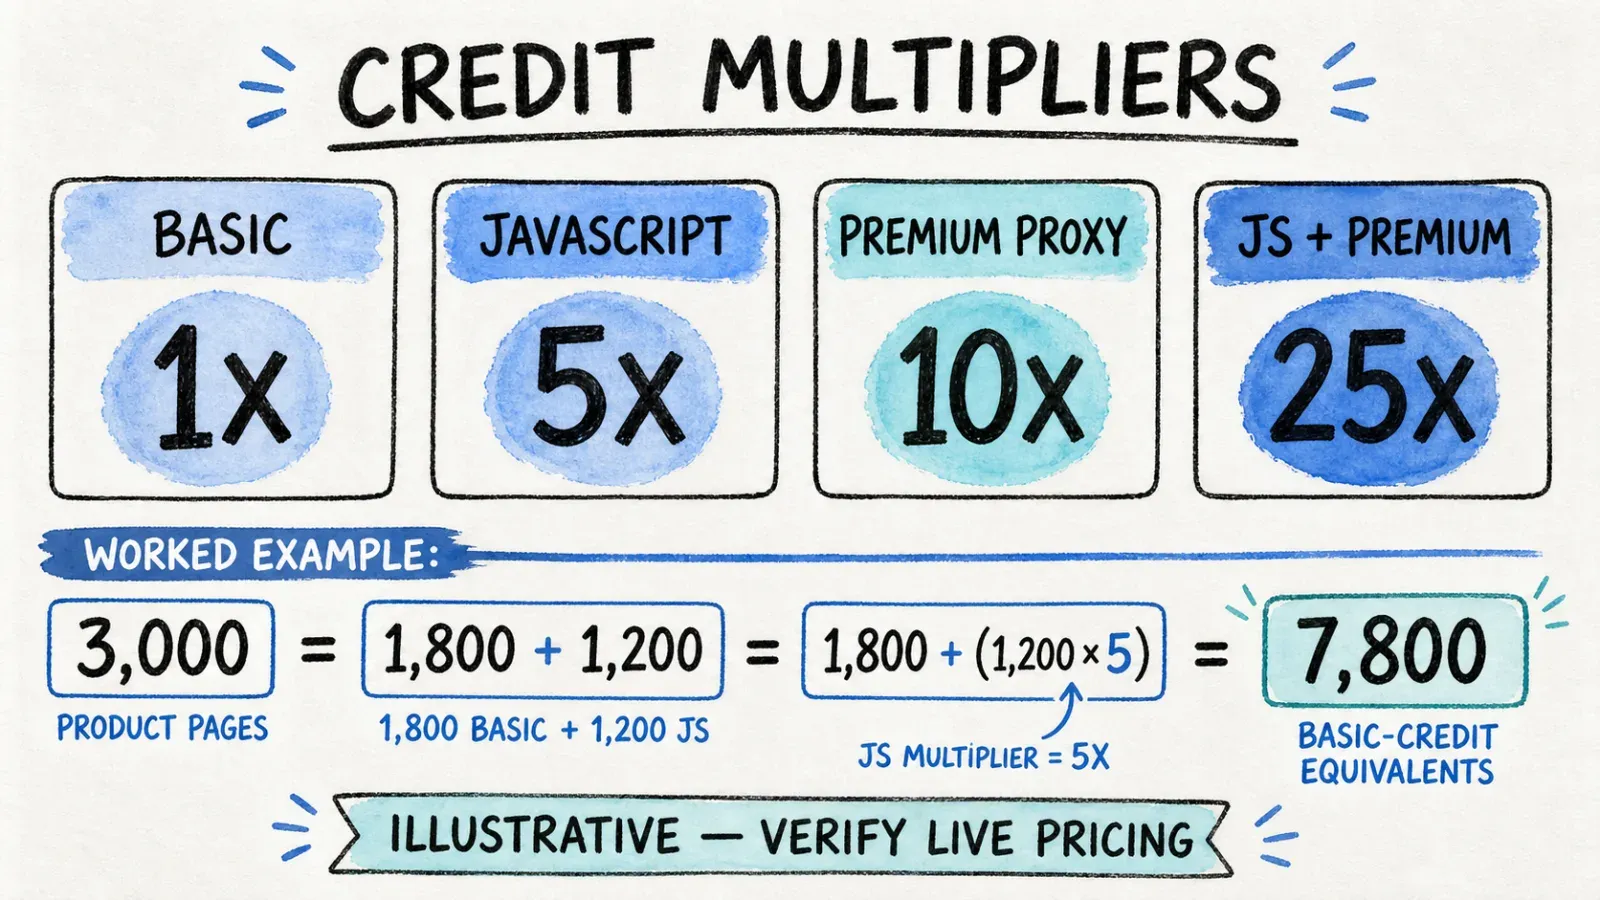
Podle oficiální cenové dokumentace ZenRows dnes multiplikátory Universal Scraper API vypadají takto: základní request stojí 1× kredit, JavaScript rendering 5×, prémiové proxy 10× a kombinace JavaScript renderingu s prémiovými proxy 25×. To není malý rozdíl — stránka, která potřebuje obojí, stojí 25× víc než obyčejná statická stránka.
Ještě jeden detail, který lidi často mate: neúspěšné nebo opakované requesty se neúčtují, což je fér, ale odpovědi HTTP 404 a 410 se stále považují za úspěšné a účtují se. Takže pokud je ve vašem seznamu i hodně mrtvých odkazů, platíte i za ně.
Aktuální standardní tarify podle stejné dokumentace: Trial dává $1 ze sdílené alokace (zhruba 1 000 základních requestů, 200 jen s JS, 100 jen s prémiovými proxy nebo 40 plně chráněných výsledků). Developer stojí $69.99/měsíc za 250 000 základních requestů nebo 10 000 chráněných výsledků při 20 souběžných připojeních. Startup je $129.99/měsíc za 1 milion základních nebo 40 000 chráněných, při 50 concurrent. Business začíná na $299.99/měsíc za 3 miliony základních nebo 120 000 chráněných requestů, se 100 concurrency, a vyšší Business tarify jdou od $499.99 až do $2 999.99 měsíčně, než se dostanete ke custom Enterprise cenám.
Cenový model Thunderbitu
Thunderbit funguje jinak — staví na plánových tarifech navázaných na workflow v prohlížeči, ne na multiplikátorech za jednotlivé requesty, protože většina uživatelů spouští extrakce na konkrétních stránkách, ne tisíce programových API volání. Nerad bych tu uváděl konkrétní kreditová čísla, protože struktury plánů se mění a nerad bych, aby zastaralé hodnoty někomu zkazily rozpočet. Před nákupem se raději podívejte přímo na aktuální ceník Thunderbitu.
Co ale můžu říct s jistotou: v browserovém workflow tu není žádný skrytý 25× multiplikátor. Neplatíte dramaticky víc jen proto, že se stránka načetla přes JavaScript. Právě ta jednoduchost je podstatou nástroje založeného na prohlížeči — extrakce probíhá v reálné relaci v prohlížeči, takže otázka „je ta stránka vykreslená přes JS“ není cenové téma jako u API, které musí podle potřeby spouštět headless rendering.
Praktický příklad: scraping 1 000–5 000 produktových stránek
Představme si, že potřebujete produktová data z 3 000 e-commerce stránek a asi 40 % z nich vyžaduje JavaScript rendering, aby se načetly ceny (což je u moderních obchodů běžné). V ZenRows to znamená asi 1 800 stránek za základní sazbu a 1 200 stránek s 5× multiplikátorem za JS rendering — tedy že vaše „3 000 stránek“ ve skutečnosti spotřebuje kreditovou hodnotu zhruba 7 800 základních requestů (1 800 + 1 200×5). Pokud některé z těch stránek zároveň sedí za anti-bot ochranou vyžadující prémiové proxy, číslo rychle roste, protože multiplikátor pro JS + prémiové proxy je 25×.
V browserovém rozšíření Thunderbitu byste spouštěli One Click Extract stránku po stránce (nebo použili stránkování / obohacování podstránek u kompatibilních list-to-detail workflow) a cenový model by tolik neskákal podle toho, jestli stránka používala JavaScript — je navázaný na plán, ne na multiplikátor za jednotlivou stránku. U úlohy takového rozsahu je to výrazně jiný cenový rozhovor.
Chci ale zdůraznit, že tohle je ilustrativní matematika, ne nabídka. Skutečné náklady závisí na úrovni ochrany cílového webu, vašem tarifu a na tom, co říkají aktuální cenové stránky v den, kdy je kontrolujete. Berte ten příklad jako způsob, jak přemýšlet o problému s multiplikátory, ne jako částku, podle které byste měli stavět rozpočet.
Úspěšnost a anti-bot handling: Proč to není srovnání typu jablka versus jablka
Několik benchmarkových webů (mimo jiné Scrapeway a numerous.ai) publikuje procenta úspěšnosti ZenRows proti notoricky těžkým cílům jako Amazon, Zillow a Walmart. Ta čísla jsou užitečná, pokud porovnáváte anti-bot bypass API mezi sebou. O Thunderbit vám ale neřeknou skoro nic, protože Thunderbit nebyl navržen, aby řešil stejný problém.
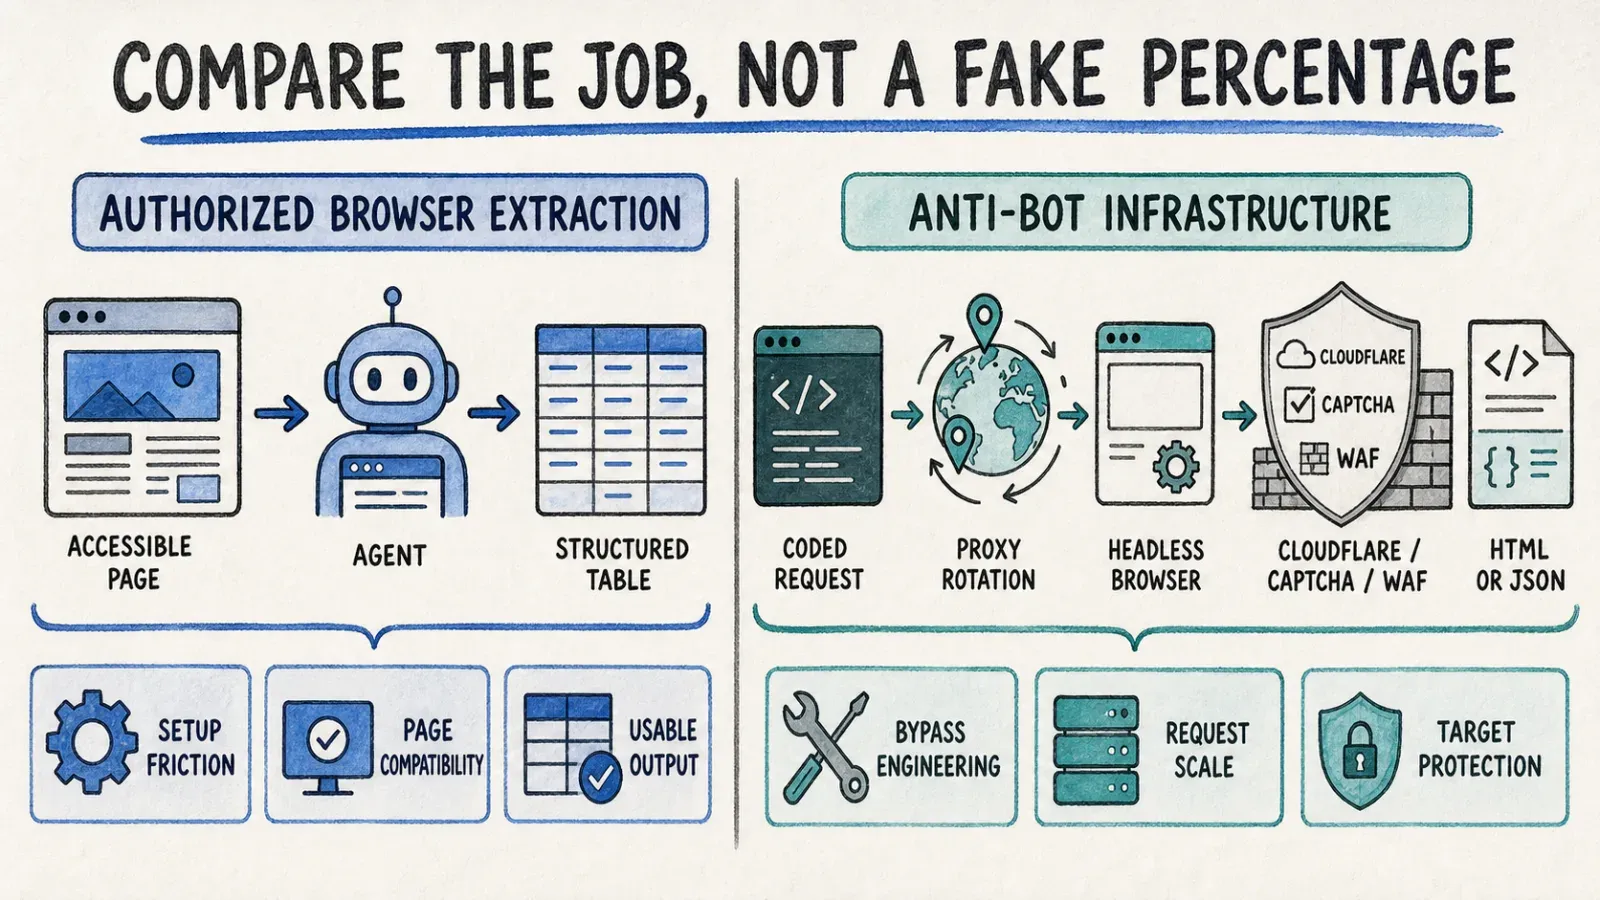
ZenRows existuje právě proto, aby ve velkém měřítku porážel CAPTCHA, Cloudflare challenge a web application firewally, pomocí rotace proxy a headless infrastruktury navržené přesně pro tenhle boj. Thunderbit provádí extrakci v autorizované relaci v prohlížeči na stránkách, které už máte přístupné — je to agentní scraper na získání strukturovaných dat ze stránky, ne služba, která se snaží prorazit přes obranu webů, které aktivně blokují boty. Publikovat falešnou „úspěšnost Thunderbitu proti anti-bot systému Amazonu“ by bylo nepoctivé, protože to prostě není práce, pro kterou byl nástroj postaven.
Poctivější srovnání je tedy tření při nastavení, model autorizace a kompatibilita s cílovou stránkou. Thunderbitovo „jedno kliknutí“ je skutečně jedno kliknutí — ale to platí pro kompatibilní, autorizované stránky, ne jako záruka fungování na každém webu nebo v každém anti-bot prostředí na internetu. Pokud se snažíte scrapovat web, který se aktivně brání automatizovanému přístupu pomocí enterprise-grade WAF pravidel, jste jasně v teritoriu ZenRows. Předstírat opak by čtenářům neprospělo.
Export, integrace a kam vaše data nakonec putují
ZenRows vrací JSON nebo HTML přes API odpověď, což znamená, že vy (nebo napojený automatizační nástroj) musíte data poslat dál tam, kde budou užitečná — do databáze, tabulky nebo datového skladu. To není nevýhoda ZenRows; to je prostě to, co dělá infrastrukturové API. Dá vám surovinu a čeká, že zbytek postavíte sami.
Thunderbit exportuje přímo do míst, kde business týmy už běžně pracují: Excel, Google Sheets, Airtable a Notion, a to bez psaní jediného řádku kódu. Pro kohokoli, kdo dělá lead generation nebo tahá e-commerce produktová data, je to rozdíl mezi „mám teď JSON soubor“ a „mám tabulku, kterou můžu poslat nadřízenému“.
Oba nástroje se navíc dají napojit na širší automatizační platformy jako Zapier, Make nebo n8n pro složitější routing, takže ani jeden není uzamčený jen do své výchozí exportní cesty, pokud váš workflow potřebuje něco propracovanějšího.
Právní a compliance aspekty při výběru scraperu
Budu stručný, protože to stojí za zmínku, ne za disertaci. Oba nástroje by se měly používat k získávání veřejně dostupných nebo jinak autorizovaných dat, s respektem k podmínkám použití webu, robots pravidlům a platným zákonům o ochraně soukromí, jako je GDPR nebo CCPA, podle toho, kde jsou vaše data a uživatelé. Ani Thunderbit, ani ZenRows — upřímně řečeno žádný scrapingový nástroj — automaticky negarantují právní soulad. Odpovědnost nese člověk, který úlohu spouští, ne software.
Závěr: Thunderbit nebo ZenRows — co si vybrat?
Upřímná odpověď je, že tyto dva nástroje byly postavené na řešení různých problémů, a vyhlásit jednoho vítěze by bylo trochu jako se ptát, jestli je lepší kolo, nebo dodávka. Thunderbit je no-code, browser-based cesta pro business uživatele, kteří potřebují rychlou a autorizovanou extrakci bez sahání do editoru kódu — a pokud potřebujete stejnou inteligenci v backendu, Open API nebo MCP Server to pokryjí, aniž byste museli stavět infrastrukturu na úrovni ZenRows. ZenRows je API pro vývojáře, kteří staví kódované pipeline proti chráněným cílům ve vysokém objemu, kde je anti-bot bypass skutečný technický problém, který řešíte.
Vyberte nástroj podle práce, která je před vámi, ne podle obecného feature checklistu. Pokud si pořád nejste jistí, do které skupiny patříte, je to většinou dobré znamení, že zatím nepotřebujete těžší infrastrukturu — a můj tým vytvořil rozšíření Thunderbit pro Chrome právě pro lidi, kteří raději kliknou na tlačítko, než aby psali scraper od nuly.
Často kladené otázky
Je Thunderbit vhodný pro lidi bez programování? Ano — to je celý jeho základní princip. Workflow One Click Extract v rozšíření znamená, že agent přečte stránku a sám připraví pole; nemusíte psát selektory, stavět schéma ani sahat na kód. Run Now je volitelné, protože extrakce se spustí sama, když nic nekliknete. Právě proto se hodí pro sales, ops a výzkumné týmy, které potřebují data bez psaní kódu.
Umí ZenRows obejít Cloudflare a CAPTCHA? Ano, to je součást jeho základního návrhu. ZenRows používá rotaci proxy, správu hlaviček a fingerprintů a Adaptive Stealth Mode speciálně k průchodu anti-bot systémy jako Cloudflare a CAPTCHA. Pro aktuální detaily, jak si poradí s konkrétní vrstvou ochrany, se podívejte přímo do dokumentace ZenRows Universal Scraper API, protože anti-bot taktiky na obou stranách se neustále vyvíjejí.
Co je levnější, Thunderbit nebo ZenRows? Hodně záleží na typu práce a objemu. Kreditové multiplikátory ZenRows znamenají, že stránky vykreslené přes JavaScript nebo chráněné proxy mohou stát až 25× víc než základní statické requesty, což může nenápadně nafouknout skutečnou kapacitu zdánlivě levného plánu. Browserové tarify Thunderbitu takový per-page multiplikátor nemají. Spočítej si vlastní čísla podle praktického příkladu výše a před rozhodnutím vždy ověř aktuální ceny na ceníku ZenRows a ceníku Thunderbitu.
Může Thunderbit nahradit API pro backendové datové pipeline? Samotné browserové rozšíření k tomu navržené není — je postavené pro no-code extrakci z aktuálně otevřené stránky, kterou spustí člověk kliknutím. Pro backendové, plánované nebo agentní pipeline je relevantní Open API nebo MCP Server, které vývojářům dávají programový přístup bez nutnosti stavět infrastrukturu ve stylu ZenRows od nuly.
Můžu Thunderbit a ZenRows používat společně? Ano, a není to vůbec divná kombinace. Některé týmy používají ZenRows pro surový přístup k silně chráněným cílům ve velkém objemu v rámci vlastního pipeline a Thunderbit pak pro ad hoc business extrakci, rychlé lead listy nebo úkoly pro agenty, které nepotřebují tak vysokou úroveň anti-bot inženýrství. Řeší různé vrstvy stejného širšího problému, takže není žádný důvod, proč byste nemohli používat oba podle toho, jaká práce je zrovna před vámi.




