
Každých pár měsíců se někdo z našeho týmu na Slacku zeptá na stejnou věc: „Neměli bychom na to prostě napsat Scrapy spider?“ A pokaždé moje odpověď závisí výhradně na tom, kdo se ptá a co se vlastně snaží udělat. Tím bych v podstatě mohl článek uzavřít, ale zkusím si výplatu opravdu zasloužit a vysvětlit proč.
V SaaS a automatizaci jsem strávil skoro deset let — nejdřív v Automation Anywhere, kde jsem sledoval firmy automatizovat všechno kromě chvíle, kdy někdo pořád musel z webu ručně kopírovat data, a teď stavím Thunderbit, kde je právě tohle „kopírování z webu“ problém, který se snažíme definitivně zlikvidovat. Scrapy mezitím tiše pohání datové pipeline internetu už dávno předtím, než někdo vůbec používal výraz „agentic AI“ u večeře. Srovnávat ty dva ve skutečnosti neznamená vybírat jednoho vítěze. Je to spíš jako porovnávat švýcarák s plně vybavenou strojní dílnou — v obou případech dostanete uříznutý kus kovu, ale proces, potřebná zručnost i nepořádek po práci jsou úplně jiné.
Rychlá odpověď
Pokud chcete krátkou verzi předtím, než se ponořím do detailů: Thunderbit je spravovaný agentic web scraper — otevřete stránku, kliknete jednou a nástroj si strukturu odvodí za vás, ať už pracujete v prohlížeči, v Web App, přes Open API, MCP Server nebo přes CLI. Scrapy je zralý open-source Python framework — napíšete spider, definujete selektory, postavíte pipeline a nesete odpovědnost za každý řádek kódu, který sahá na vaše data.
Ani jeden není univerzálně „lepší“. Jsou navržené pro jiné lidi a jiné problémy a upřímně, právě to, že to srovnávací články pořád zjednodušují na jedno rozhodnutí, bylo jedním z důvodů, proč jsem tenhle text chtěl napsat pořádně.
Přehledně
Tady je tabulka, kterou bych si přál mít poprvé, když jsem ji hledal. Každý článek typu „Thunderbit vs Scrapy“ co jsem našel, buď schoval oba nástroje do většího přehledu Scrapy vs. BeautifulSoup, nebo vám nabídl jen tenký, nehodnotící widget. Tak jsme dali dohromady něco skutečného.
| Oblast | Scrapy | Thunderbit |
|---|---|---|
| Co to je | Open-source Python framework (spiders, pipelines, middleware, asynchronní engine) | Agentic web scraper bez kódu — rozšíření do prohlížeče, Web App, Open API, MCP Server, CLI |
| Nastavení | Nainstalovat Python prostředí, napsat spider, definovat selektory, nastavit pipeline | Otevřít cílovou stránku, kliknout na One Click Extract — extrakce se na kompatibilních a autorizovaných stránkách spustí automaticky (volitelně Run Now) |
| Potřebné znalosti | Python, XPath/CSS selektory, asynchronní koncepty | Pro workflow v prohlížeči není potřeba kód; API/CLI/MCP vyžadují standardní vývojářské nastavení |
| JS/dynamický obsah | Potřebuje scrapy-playwright nebo podobnou Selenium integraci | Pracuje s vykreslenou stránkou, kterou má uživatel otevřenou, včetně některých podporovaných přihlášených relací — nefunguje spolehlivě na každém webu |
| Práce proti anti-bot ochraně | Ruční middleware (rotace proxy, detekce blokace), bez zaručeného obejití | Spravované vykreslování na podporovaných, autorizovaných stránkách, také bez zaručeného obejití |
| Měřítko / opakované úlohy | Navržené pro velké, skriptovatelné a plánované crawly | Plánování je dostupné tam, kde ho podporuje tarif / rozhraní; vhodnější pro cílené nebo středně objemné úlohy |
| Export | Vlastní kódování (JSON, CSV, databáze, pipeline) | Export do podporovaných cílů jako Excel, Google Sheets, Airtable nebo Notion, plus formáty ke stažení |
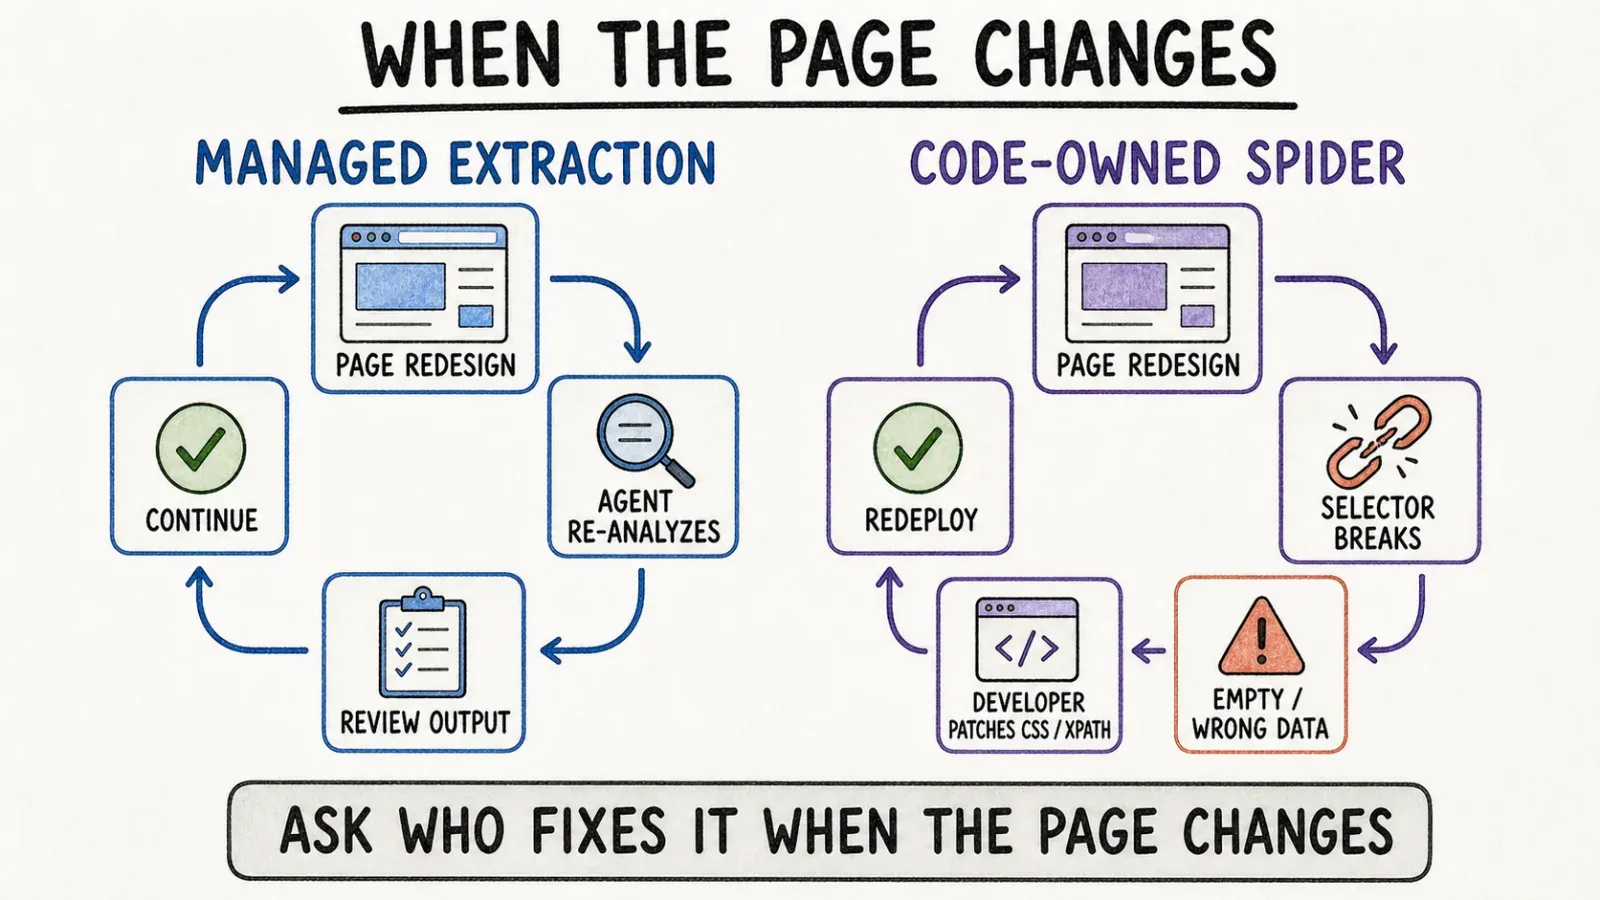
| Údržba | Spiders se rozbíjejí při změnách layoutu; opravy vyžadují čas vývojáře | Extrace s podporou AI se dokáže přizpůsobit některým změnám layoutu, ale není imunní vůči strukturálním změnám |
| Cenový model | Zdarma / open-source + čas vývojáře + hosting + proxy náklady | Předplatné / kreditní model — než budete uvádět čísla, podívejte se na cenovou stránku |
Co je Thunderbit?
Thunderbit vznikl z docela nepříjemného zjištění: většina lidí, kteří potřebují data z webu, nejsou vývojáři, zatímco většina nástrojů na web scraping předpokládá, že vývojáři jste. A právě tahle mezera je v podstatě důvod, proč existujeme.
Základní workflow v prohlížeči je záměrně co nejjednodušší. Otevřete stránku, ze které chcete data, kliknete na One Click Extract a agent se postará o zbytek — přečte stránku, odhadne, co lze vytěžit (produkty, pracovní nabídky, kontaktní údaje, cokoli je na obrazovce) a připraví pole automaticky. Je tu i tlačítko Run Now, pokud to chcete spustit hned, ale když si prostě jen sedíte s kávou, extrakce se stejně rozjede sama. Žádné selektory, žádné psaní schémat, žádné „inspect element“ archeologické vykopávky.

Kromě jednorázového flow v prohlížeči Thunderbit funguje i v dalších scénářích podle toho, co stavíte:
- Chrome Extension řeší situaci „právě koukám na tuhle stránku a chci z ní tahat data“.
- Web App pokrývá cloudové a opakované sběry pro business uživatele, kteří nechtějí sahat na kód.
- Open API zpřístupňuje Distill a strukturované Extract endpointy pro backendové a aplikační workflow.
- MCP Server umožňuje AI agentům v Claude, Cursor nebo Windsurf volat Thunderbit přímo jako nástroj.
- CLI je pro vývojáře a coding agenty, kteří žijí v terminálu.
Umí také stránkování a obohacování podstránek na kompatibilních webech a pole můžete zpřesňovat pomocí instrukcí v běžné řeči místo regulárních výrazů. Nic z toho nezaručuje, že to bude bezchybně fungovat na každém webu na světě — k tomu se dostanu později — ale je to navržené tak, aby obchodní analytik nebo realitní specialista nikdy nemusel otevírat editor kódu.
Co je Scrapy v roce 2026?
Scrapy není žádný zastaralý nástroj, který by zapadal prachem. Oficiální web Scrapy uvádí jako aktuální stabilní verzi 2.17.0 a projekt dál vychází — nejnovější release dokonce přidal do své download handler cesty podporu HTTP/2 a SOCKS proxy. To není příběh o tom, že „AI zabila starý framework“. Scrapy je pořád velmi živý a upřímně pořád opravdu dobrý v tom, co dělá.
V jádru je Scrapy Python framework postavený na asynchronním crawling enginu. Napíšete třídu Spider, definujete startovací URL (nebo start metodu) a Scrapy začne posílat Requests s callback funkcemi, které zpracovávají odpověď. Odtud vybíráte data pomocí CSS nebo XPath selektorů (nebo klidně prostým regexem, pokud jste stará škola), balíte je do Items a posíláte přes pipelines na čištění, validaci a ukládání. Oficiální přehledová dokumentace tenhle celý cyklus pěkně vysvětluje a když ho jednou pochopíte, je to opravdu elegantní systém.
Za tu investici do učení dostanete skutečnou kontrolu: cookies a session, autentizaci, cache, respektování robots.txt, limity hloubky crawlů a AutoThrottle, aby vám rozzuřený správce serveru nezablokoval IP. K tomu obrovský ekosystém middleware a rozšíření — rotace proxy, vlastní download handlery, monitoring a v poslední době i add-ony pro renderování přes Playwright a dokonce nástroje pro AI coding agenty, které vám generují skeleton spiderů.
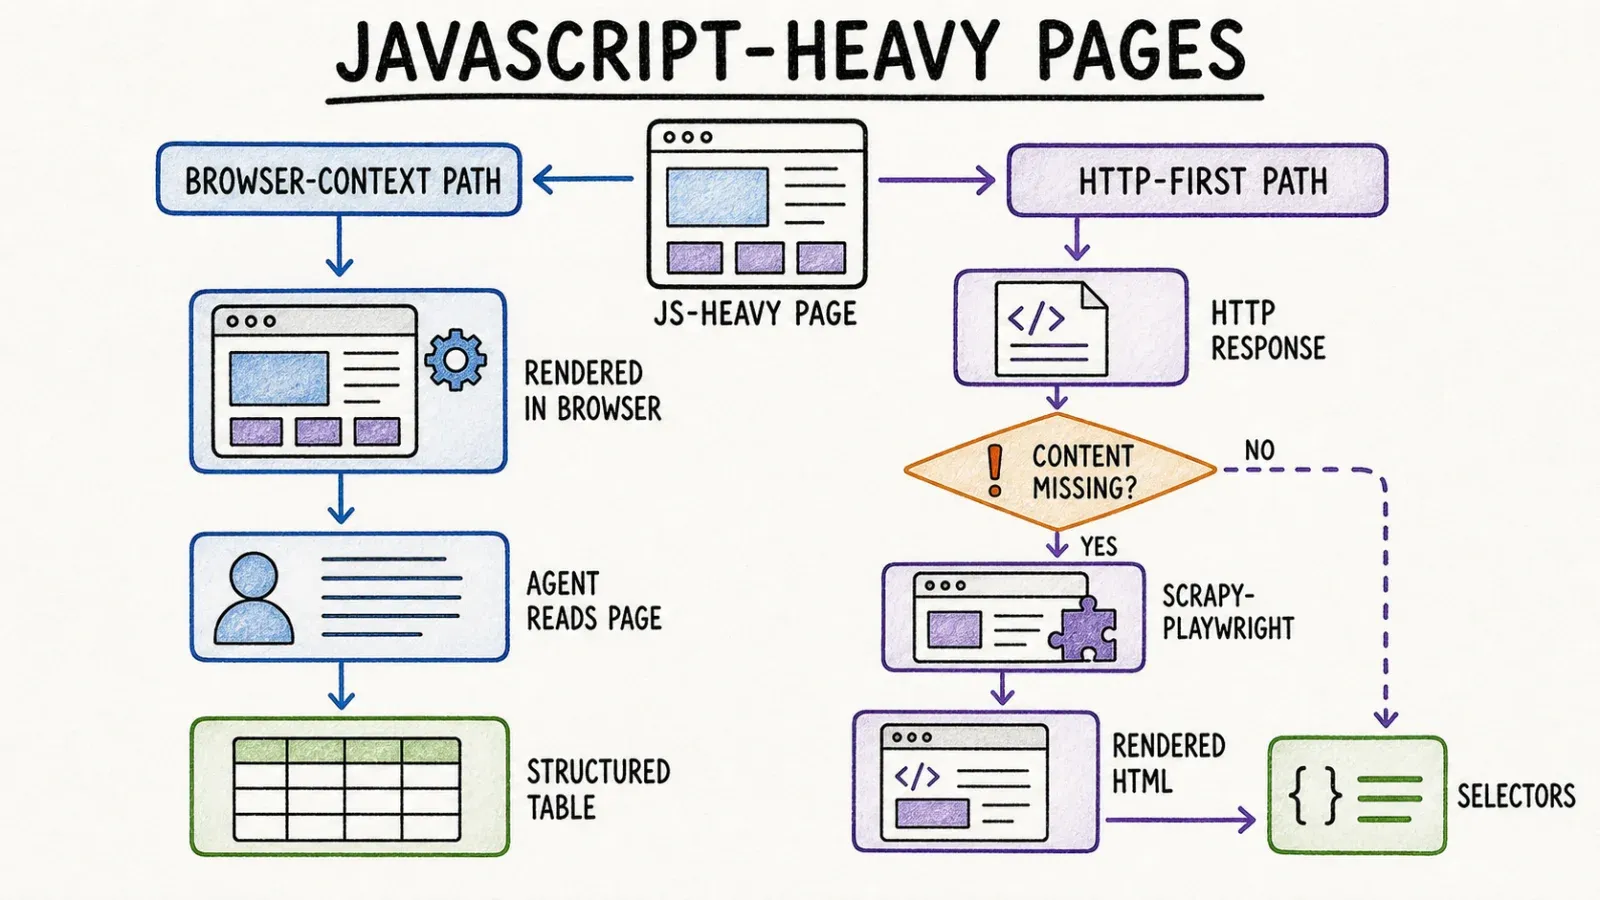
Ještě jedna důležitá věc: jádro Scrapy je HTTP crawler, ne prohlížeč. JavaScript samo o sobě nevykresluje. Pokud to potřebujete, sáhnete po scrapy-playwright, middleware ve stylu Selenium nebo externí renderovací službě. Není to vyloženě chyba — je to záměrné rozhodnutí, které drží framework lehký a rychlý — ale znamená to, že „pracovat s webem plným JS“ je projektové rozhodnutí, ne výchozí chování.
Hlavní rozdíl: spravovaný agentic workflow vs framework, který vlastníte v kódu
Čas do prvního datasetu
Nebudu si tu vymýšlet stopky — viděl jsem už příliš mnoho článků, které tvrdí, že Scrapy má „strmou křivku učení“, aniž by ukázaly, jak k tomu dospěly. Radši si prostě spočítejme skutečné kroky.
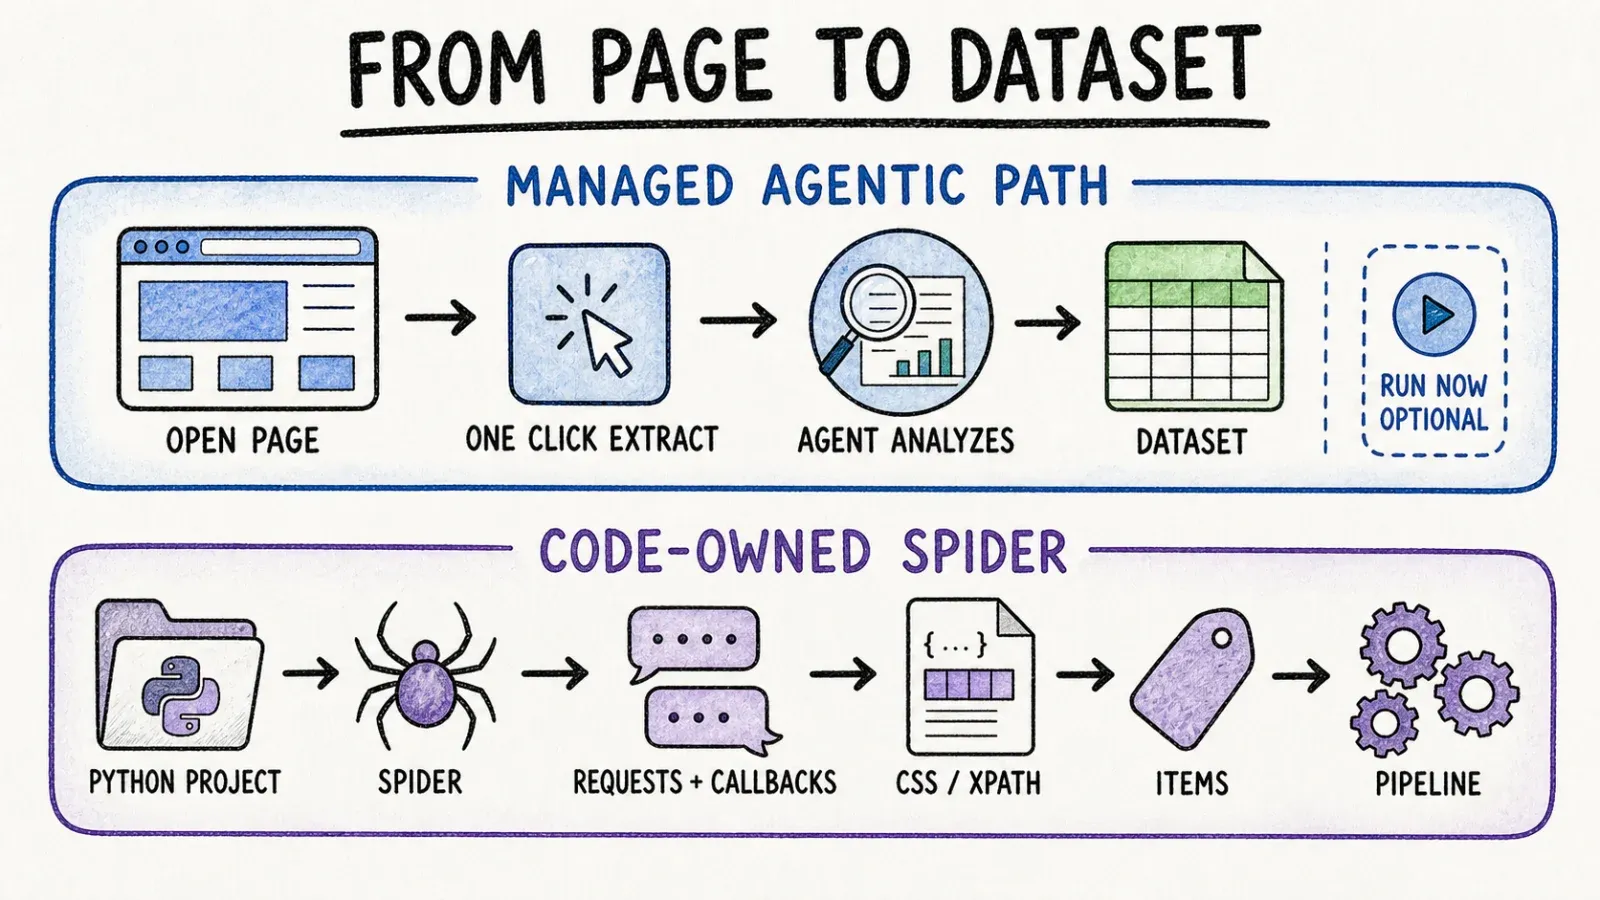
Scrapy cesta například pro scrapování stránky s produktovým listingem:
- Nastavit Python virtuální prostředí a nainstalovat Scrapy.
- Vygenerovat spider z šablony.
- Prohlédnout HTML stránky a napsat XPath/CSS selektory pro každé pole.
- Nastavit item pipeline pro čištění a export.
- Spustit spider, ladit nesoulady selektorů, spustit znovu.
Thunderbit cesta pro stejný úkol:
- Otevřít stránku v prohlížeči.
- Kliknout na One Click Extract.
- Agent rozpozná extrahovatelná pole a začne pracovat (nebo stisknete Run Now).
To je pět kroků s Python prostředím oproti třem krokům bez jakéhokoli nastavování prostředí. Neříkám, že počet kroků je jediné důležité měřítko — Scrapy vám v pěti krocích dává mnohem větší kontrolu nad tím, co přesně se děje — ale pokud je váš cíl doslova „dostat tu tabulku dnes do spreadsheetu“, rozdíl v počtu kroků je celé jádro věci.
Kontrola a rozšiřitelnost
Tady Scrapy vede a dělal bych vám medvědí službu, kdybych tvrdil opak. Protože vlastníte zdrojový kód, můžete postavit prakticky cokoliv: vlastní retry logiku, zvláštní vzory stránkování, vícekrokové autentizační flow, integraci s vaším datovým warehouse, cokoli vyžaduje vaše architektura. Agentic přístup Thunderbitu optimalizuje na „získat strukturovaná data rychle bez psaní kódu“, což ze své podstaty znamená, že za vás některá rozhodnutí dělá místo toho, aby vystavil každý páčkový ovladač. Pro 80 % firemních úloh je to skvělý trade-off. Pro zbývajících 20 % — tedy opravdu zvláštní, na míru šité crawling logiky — chcete framework, který si můžete ohnout podle sebe.
Odpovědnost za údržbu a provoz
Spidery se rozbíjejí. Není to výtka vůči Scrapy — každý scraper, ať už agentic nebo ručně napsaný, je závislý na webu, na který míří. Ale když se Scrapy spider rozbije kvůli tomu, že web změnil HTML, někdo z vašeho týmu si toho musí všimnout, diagnostikovat to a opravit. To je pokaždé reálný čas vývojáře.
Thunderbit s AI podporovanou extrakcí dokáže u některých změn layoutu reagovat automaticky, protože uvažuje nad strukturou stránky místo toho, aby slepě porovnával pevně zakódovanou cestu selektoru. Ale chci být fér: neznamená to imunitu. Dostatečně velké strukturální změny ho pořád mohou zmást. Rozdíl je hlavně v tom, kdo se přizpůsobuje — algoritmus, který se snaží udělat nejlepší odhad, nebo vývojář, který v 11 večer ručně přepisuje XPath.
Praktické scénáře
Jednorázový adresář nebo tabulka produktů
Pokud potřebujete tabulku restaurací, ceny produktů nebo detaily eventů z jedné stránky nebo z krátkého seznamu stránek, spouštět kvůli tomu Scrapy projekt je upřímně zbytečně moc — psali byste spider, který použijete jednou a už se k němu nikdy nevrátíte. To je přesně teritorium Thunderbitu jako rozšíření do prohlížeče: otevřít, kliknout, vytáhnout, exportovat do Google Sheets, hotovo.
Velký custom crawl s byznys pravidly
Teď si představte, že potřebujete prolézt 50 000 produktových stránek napříč dvanácti doménami, aplikovat vlastní deduplikaci a všechno posílat do proprietárního cenového modelu. To je domácí hřiště Scrapy. Architektura pipeline, řízení concurrency, middleware ekosystém — všechno to existuje právě pro úlohy v tomhle měřítku a s tolika vlastní logikou.
Dynamický web s hodně JavaScriptem
Oba nástroje tady potřebují pomoc, jen každý jinou. Scrapy potřebuje explicitní renderovací integraci jako scrapy-playwright, což přidává závislost i další údržbovou vrstvu. Thunderbit v prohlížeči pracuje s už vykreslenou stránkou — včetně některých podporovaných přihlášených relací — takže odpadá velká část nastavování. Ale chci to říct úplně jasně: ani jeden přístup nezaručuje výhru proti agresivním anti-bot systémům nebo nezvyklým patternům dynamického obsahu. Kdokoli vám tvrdí opak, něco prodává.
Integrace pro AI agenta nebo aplikaci
Pokud stavíte workflow AI agenta v Claude nebo Cursor a chcete, aby si v rámci svého uvažování tahal živá webová data, napsat vlastní integrační kód pro Scrapy je docela zásah. Thunderbit MCP Server je postavený přesně na tohle — zpřístupňuje extrakci jako nástroj, který si agent může zavolat přímo.
Přesnost, škálování a údržba
Přesnost Scrapy je deterministická v tom nejlepším smyslu — dobře napsaný selektor vytáhne přesně to pole, které jste mu řekli, pokaždé, dokud se nezmění podkladové HTML. Tahle předvídatelnost je opravdu cenná v produkčních pipeline, kde potřebujete přesně vědět, proč něco selhalo.
Agentic detekce v Thunderbitu funguje jinak. Interpretuje stránku podobně, jako by ji četl člověk, a rozhoduje, co je pravděpodobně cena, název nebo popis. Je to skvělé pro rychlost a flexibilitu, ale je to jiný model přesnosti — spíš „většinou správně, občas je potřeba drobný zásah“ než „vždy přesně to, co říká selektor“. Radši to říkám otevřeně, než abych předstíral, že AI extrakce je bezchybná.
Co se týče čistého průtoku, asynchronní engine Scrapy je stavěný na to, aby efektivně zvládal obrovské objemy requestů — to je opravdu součást jeho DNA. Thunderbit je laděný spíš na cílené, středně objemné úlohy, kde je důležitější rychle dostat čistý strukturovaný výsledek než přes noc prolézt milion stránek. Pokud plánujete opravdu masivní crawl, podívejte se na aktuální limity tarifu, než budete předpokládat, že se kterýkoli z nástrojů škáluje přesně tak, jak potřebujete.
Ještě jedna věc platí pro oba: zásadní je oprávněné použití. Ať už zvolíte kterýkoli nástroj, respektování robots.txt, podmínek webu a platné legislativy není volitelné — je to prostě součást zodpovědné práce.
Cena, licence a celkové náklady
Tady lidé často narážejí na past: považují „zdarma“ a „bez nákladů“ za totéž. Scrapy nemá licenční poplatek — je to open source, tečka. Ale „zdarma“ software pořád potřebuje, kde běžet, a to místo stojí peníze: hosting, proxy služby, pokud jedete ve větším objemu, nástroje pro browser automation, když potřebujete renderovat JS, monitoring, abyste poznali, že spider tiše umřel, a — to hlavní — čas vývojáře na stavbu, testování a opravy.
Thunderbit funguje na modelu předplatného / kreditů a raději bych vás odkázal na oficiální cenovou stránku, než abych tu citoval číslo, protože cenové struktury se mění a já chci, abyste viděli aktuální podmínky přímo. Co si tím předplatným kupujete, je odstranění většiny toho nastavování a údržby — alespoň u podporovaných workflow.
Skutečná otázka nezní „co je na papíře levnější“. Zní: „čeho má váš tým víc — vývojářských hodin, nebo rozpočtu na předplatné?“ Pětičlenný data engineering tým s volnou kapacitou může zjistit, že celkové náklady na Scrapy jsou po započtení jejich dovedností nižší. Tříčlenný ops tým bez vlastních inženýrů zjistí, že ten „zdarma“ framework je vyjde na fakturu od kontraktora a tři týdny zpoždění, než uvidí jediný řádek dat.
Kdo by měl zvolit Thunderbit?
Thunderbit dává největší smysl, pokud jste netechnický uživatel v sales, marketingu, ecommerce, realitách nebo recruitingu a potřebujete strukturovaná data hned, bez toho, abyste kvůli nim otevírali ticket vývojářům. Je to také dobrá volba pro vývojáře, kteří chtějí programový přístup bez psaní extrakční logiky od nuly, protože Open API a CLI tu vrstvu řeší za vás. Pokud vaše workflow zahrnuje lead generation, monitoring ecommerce nebo scraping LinkedIn profilů pro recruiting research, bývá to obvykle rychlejší cesta.
Kdo by měl zvolit Scrapy?
Scrapy je správná volba, pokud máte v týmu Python vývojáře, budujete crawling infrastrukturu, která má žít roky, a potřebujete plnou kontrolu nad logikou requestů, retry chováním a datovými pipeline. Je to také lepší volba, pokud compliance nebo architektura vyžadují, aby byl celý kód jen váš — auditovatelný, self-hosted a bez externí závislosti.
Mohou týmy používat oba nástroje?
Mnoho týmů to tak dělá a nepovažuju to za vyhýbavou odpověď. Vývojáři mohou provozovat odolné, velkoobjemové Scrapy spidery pro infrastrukturu, která má existovat dlouhodobě, zatímco zbytek firmy používá Thunderbit pro ad hoc průzkum, jednorázové tahání dat a explorativní práci, která si nezaslouží plnohodnotný engineering sprint. Mezi těmi dvěma nástroji neexistuje žádná oficiální integrace — chci to říct jasně — ale z provozního hlediska vám nic nebrání používat je vedle sebe podle toho, který úkol se hodí pro který nástroj.
Verdikt
Kdybych to měl shrnout do jedné otázky na intuici: optimalizujete spíš pro kontrolu, nebo pro rychlost? Scrapy vám dá úplnou kontrolu za cenu času na nastavení a průběžnou údržbu. Thunderbit vám dá rychlost a dostupnost za cenu menší flexibility. Ani jedno není objektivně správná odpověď — záleží na tom, jestli ten, kdo scraping dělá, umí Python, nebo zná svůj obchodní pipeline. Více o tom, jak si AI-based extrakce vede oproti tradičním metodám obecně, najdete v našem rozboru AI web scrapingu a web scrapingu bez kódování, kde pokrýváme širší kontext za hranicí tohohle jednoho srovnání.
FAQ
Je Scrapy zdarma? Samotný framework Scrapy je open source a nemá licenční poplatek, jak uvádí oficiální web Scrapy. Skutečné náklady ale přicházejí s hostingem, proxy, nástroji na renderování, pokud potřebujete podporu JS, a s časem vývojáře na tvorbu a údržbu spiderů.
Vykresluje Scrapy JavaScript samo? Ne. Jádro Scrapy je HTTP crawler, ne prohlížeč, takže JavaScript nespouští automaticky. Týmy obvykle přidávají scrapy-playwright nebo middleware ve stylu Selenium, když potřebují scrapovat weby plné JS, jak popisuje oficiální dokumentace Scrapy.
Podporuje Thunderbit API a MCP přístup? Ano. Thunderbit nabízí Open API s endpointy Distill a strukturovaným Extract pro programové použití a MCP Server, který umožňuje AI agentům v nástrojích jako Claude a Cursor volat Thunderbit přímo.
Co je rychlejší pro business uživatele? Thunderbit, záměrně. Flow One Click Extract v rozšíření do prohlížeče spustí extrakci automaticky po analýze stránky, bez selektorů a bez nastavování schématu — je to mnohem kratší cesta než instalovat Python a psát spider.
Co je lepší pro hluboce přizpůsobené crawly? Scrapy. Jeho middleware, pipeline architektura a plný přístup ke zdrojovému kódu dávají vývojářům kontrolu potřebnou pro vysoce specifickou crawling logiku, velké plánované úlohy a vlastní datové pipeline, které agentic nástroj není určený nahradit.




