
Tuhle otázku mi do schránky dorazilo už tolikrát, že bych to nespočítal: „Měli bychom pro získávání dat použít Thunderbit, nebo ScrapeStorm?“ A upřímně? Je to naprosto fér otázka — oba nástroje slibují, že z webů vytáhnou strukturovaná data, aniž byste museli najímat vývojáře. Jenže každý k tomu přistupuje úplně jinak. Když sáhnete po špatném nástroji pro svůj workflow, buď promrháte hodiny nastavováním pravidel, která vlastně nepotřebujete, nebo narazíte ve chvíli, kdy byste naopak potřebovali jemnější kontrolu.
Prošel jsem tedy oba produkty do hloubky, přečetl oficiální dokumentaci a zmapoval, kde který nástroj opravdu vyniká. Tady je upřímné srovnání — bez marketingových frází, jen to, co jednotlivé nástroje skutečně umí a pro koho dávají smysl.
Rychlá odpověď
Ve zkratce: Thunderbit je postavený pro lidi, kteří raději nechají agenta, aby se podíval na stránku a sám pochopil data, než aby si sami navrhovali logiku extrakce. Kliknete na One Click Extract, nástroj stránku přečte a začne tahat strukturovaná data — Run Now je k dispozici, pokud chcete spustit akci hned, ale je to volitelné, protože úloha se stejně spustí automaticky.
ScrapeStorm naopak nabízí Smart Mode pro automatické rozpoznání na běžných seznamových a obsahových stránkách a také Flowchart Mode, kde můžete vytvářet přesnou logiku typu klikni–posuň–čekej–opakuj, když stránka potřebuje víc než jen rozpoznání vzorů.
Ani jeden nástroj není „ten ruční“ a ani jeden není „ten stoprocentně automatický“. A právě tohle je podle mě největší omyl, který v porovnávacích článcích pořád vídám — ScrapeStorm bývá vykreslovaný jako čistě pravidlový a pracný, čímž se podceňuje Smart Mode, zatímco Thunderbit je často popisovaný, jako by fungoval kouzelně na každém webu, což také není realita. U obou pořád záleží na kompatibilitě stránky a na tom, jestli k ní máte oprávněný přístup.
Thunderbit vs ScrapeStorm přehledně
Než se ponoříme do detailů, tady je tabulka, kterou bych si přál mít, když jsem je srovnával poprvé:
| Vlastnost | Thunderbit | ScrapeStorm |
|---|---|---|
| Nasazení | Rozšíření pro Chrome/Edge, webová aplikace, Open API, MCP Server, CLI | Desktopová aplikace (Windows/macOS/Linux) |
| Způsob nastavení | Agentní přístup — kliknete na One Click Extract, stránka se automaticky analyzuje, Run Now je volitelné | Smart Mode (automatický) nebo Flowchart Mode (vizuální, ruční logika) |
| Nejvhodnější pro | Uživatelé bez kódu, obchodní a provozní týmy, rychlé tahání dat v prohlížeči | Uživatelé, kteří umí stavět pravidlové workflow pro složitější weby |
| Práce s paginací | Kompatibilní paginace a obohacení z podstránek na podporovaných stránkách | Smart Mode ji umí automaticky rozpoznat; Flowchart Mode nabízí explicitní smyčky |
| Podpora interakcí (klikání, formuláře, scrollování) | Na základě browser session, funguje v rámci autorizovaných relací tam, kde je to podporováno | Explicitní komponenty Flowchart: click, hover, dropdown, input, wait, condition |
| Plánování | Cloudové, podle tarifu (ověřte aktuální plán) | Plánovač v desktopu od tarifu Premium |
| Export | Excel, Google Sheets, Airtable, Notion a další podporované formáty | Excel, TXT, CSV, HTML, MySQL, PostgreSQL, SQL Server, MongoDB, Google Sheets (Premium+) |
| Přístup pro vývojáře | Open API, MCP Server, CLI | RESTful API pro lokální řízení úloh (tarif Business) |
| Cenový model | Kredity / plány — viz aktuální ceny | Úrovňové předplatné, oficiální ceny |
Záměrně tu neporovnávám rychlost ani přesnost. Neviděl jsem žádný nezávislý a kontrolovaný benchmark, který by je porovnával přímo proti sobě, a tvrzení výrobců o rychlosti (například ScrapeStorm uváděný jako „3–10ד rychlejší) hodně závisí na rychlosti načtení stránky a na tom, jak je úloha navržená. Nebudu proto předstírat, že mám data, která ve skutečnosti nemám.
Co je Thunderbit?
Thunderbit je nástroj, který jsme vyvinuli u nás ve firmě — agentický web scraper, určený pro lidi, kteří nemají chuť učit se XPath nebo CSS selektory, ale potřebují mít do konce dne v ruce tabulku s daty.

Takhle dnes ve skutečnosti funguje, protože jsem už viděl starší recenze popisovat rozhraní, které už dávno neexistuje (k tomu „0 Ratings“ se ještě dostanu): v rozšíření v prohlížeči kliknete na One Click Extract a agent Thunderbitu stránku detekuje, přečte a analyzuje. Rozpozná, jaká pole dávají smysl — názvy produktů, ceny, kontaktní údaje, cokoli, co naznačuje struktura stránky — a pak prostě spustí extrakci. Run Now je k dispozici, pokud ji chcete spustit okamžitě, ale když na nic nekliknete, proces se stejně rozběhne sám.
A právě to lidi překvapí. Není tu žádný krok „zkontrolujte selektory“, žádná fáze ručního skládání schématu. Zpětně můžete výstup doladit běžnou řečí — třeba požádat o přeformátování data nebo rozdělení sloupce se jmény — a na kompatibilních stránkách nástroj zvládá paginaci i obohacení z podstránek (například vytáhne seznamovou stránku a pak automaticky načte další detaily z každé navázané detailní stránky).
Kromě rozšíření do prohlížeče má Thunderbit také webovou aplikaci, Open API pro vývojáře, kteří chtějí extrakci spouštět programově, MCP Server, aby AI agenti jako Claude nebo Cursor mohli Thunderbit používat jako nástroj, a také CLI pro terminálové workflow. Exportovat můžete do Excelu, Google Sheets, Airtable, Notionu a dalších podporovaných formátů.
Řeknu to napřímo: funguje to dobře jen na stránkách, které jsou kompatibilní a ke kterým máte oprávnění přistupovat. Není to univerzální klíč, který otevře všechny zamčené dveře na internetu.
Co je ScrapeStorm?
ScrapeStorm jde na architekturu úplně jinak. Je to aplikace ke stažení — pro Windows, macOS nebo Linux — a existuje dost dlouho na to, aby si vybudovala opravdu rozsáhlou sadu funkcí.
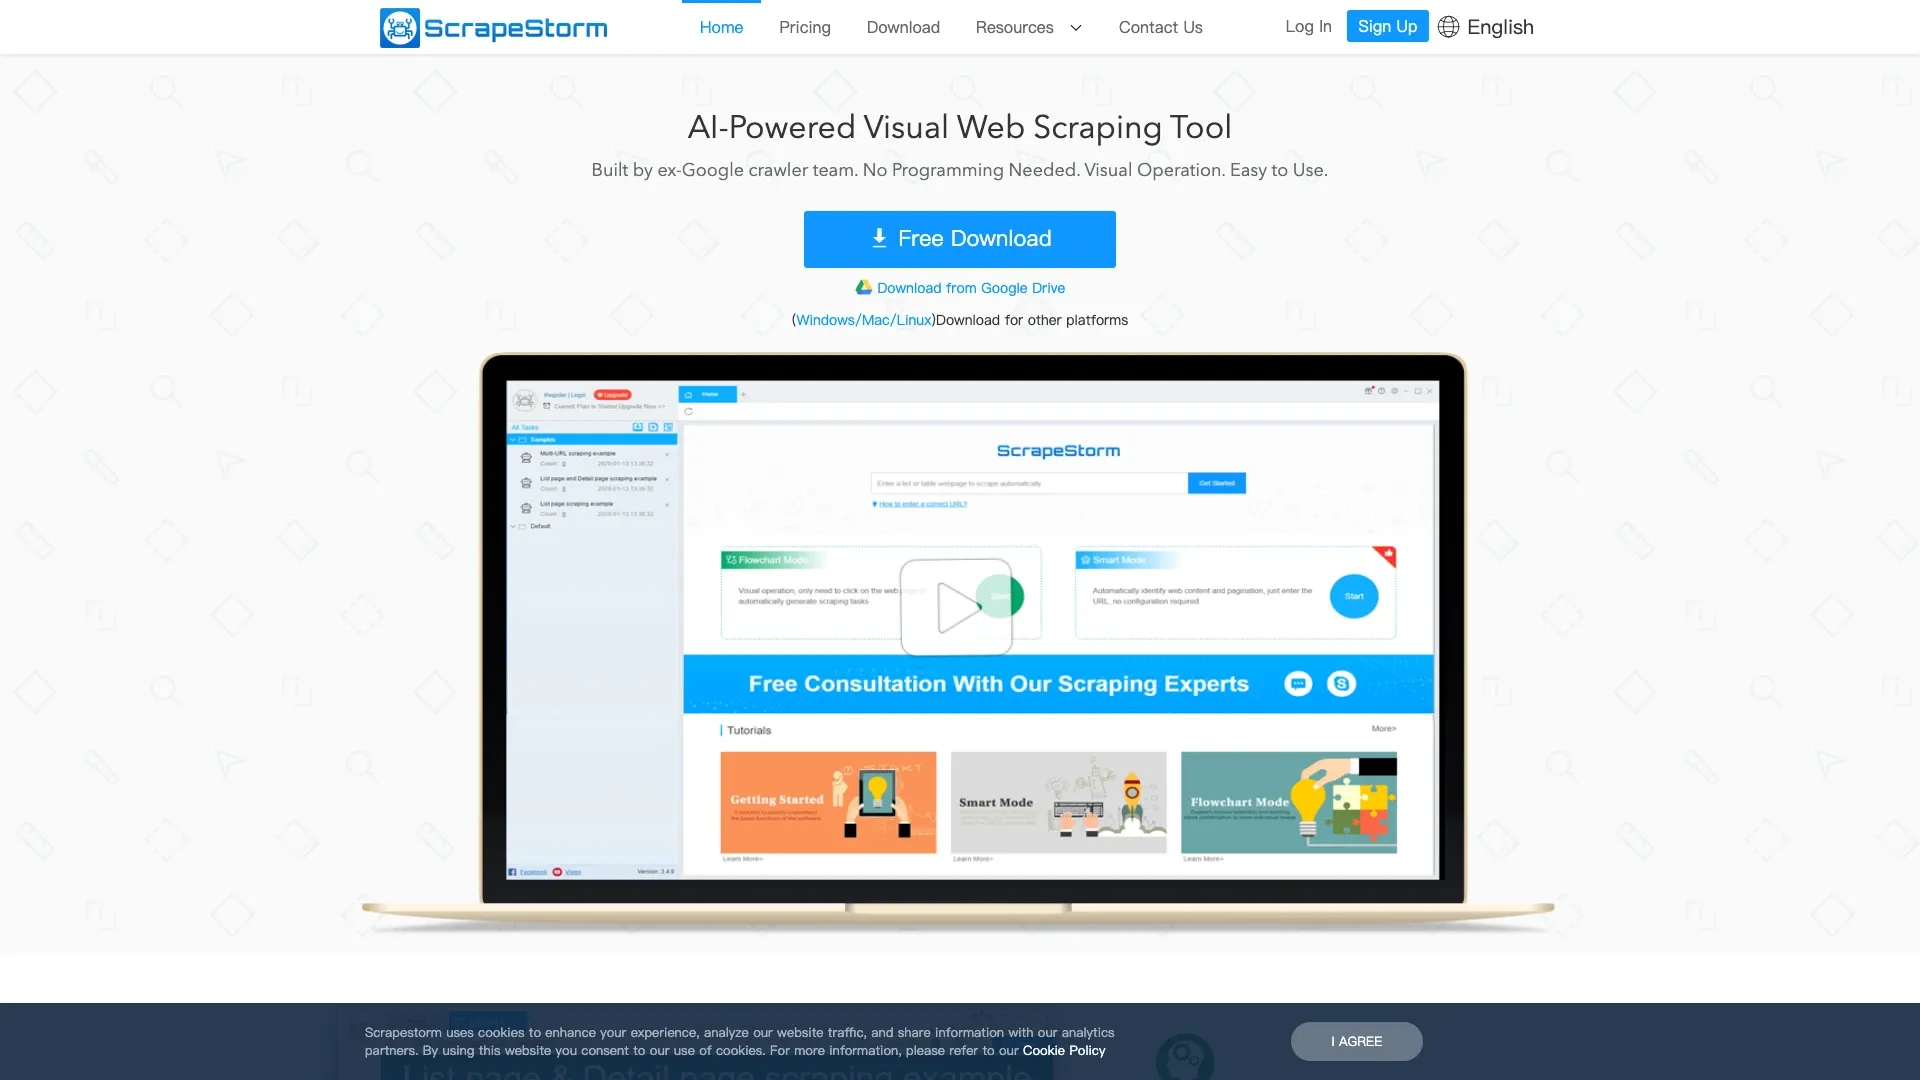
Jádrem ScrapeStormu jsou dva provozní režimy a jejich pochopení je zásadní, pokud chcete rozhodnout, jestli vám bude sedět.
Smart Mode se snaží automaticky identifikovat obsah a strukturu stránkování na seznamových a obsahových stránkách. Podle vlastního návodu ScrapeStormu k volbě správného režimu to funguje dobře tehdy, když stránka odpovídá rozpoznatelným vzorům — typicky produktové katalogy, feedy článků a podobně.
Flowchart Mode je místo, kde ScrapeStorm získává skutečnou sílu na složitých webech. Skládáte si vizuální flowchart z komponent popsaných v jejich referenci Flowchart komponent: otevřít URL, něco kliknout, počkat na načtení, posunout stránku dolů, vyplnit pole, najet myší, aby se zobrazil dropdown, nastavit podmínky, opakovat stránkované výsledky nebo varianty SKU, vrátit se zpět, zkopírovat hodnotu, a dokonce zvládnout i kroky s CAPTCHA.
To je opravdu hodně jemné kontroly. Pokud se musíte přihlásit, filtrovat přes dropdown a pak projít pět záložek, než se vůbec zobrazí požadovaná data, Flowchart Mode vám dá nástroje, jak přesně tenhle postup namodelovat.
ScrapeStorm také podporuje lokální běh na vašem počítači nebo cloud/server režimy, přímý export do databází jako MySQL, PostgreSQL, SQL Server a MongoDB a na vyšších tarifech i automatické plánování a integraci s Google Sheets.
Hlavní rozdíl: delegování na agenta vs. hybridní vizuální kontrola
Tady se na chvíli pustím do filozofie, protože právě tohle podle mě rozhoduje víc než jakýkoli seznam funkcí.
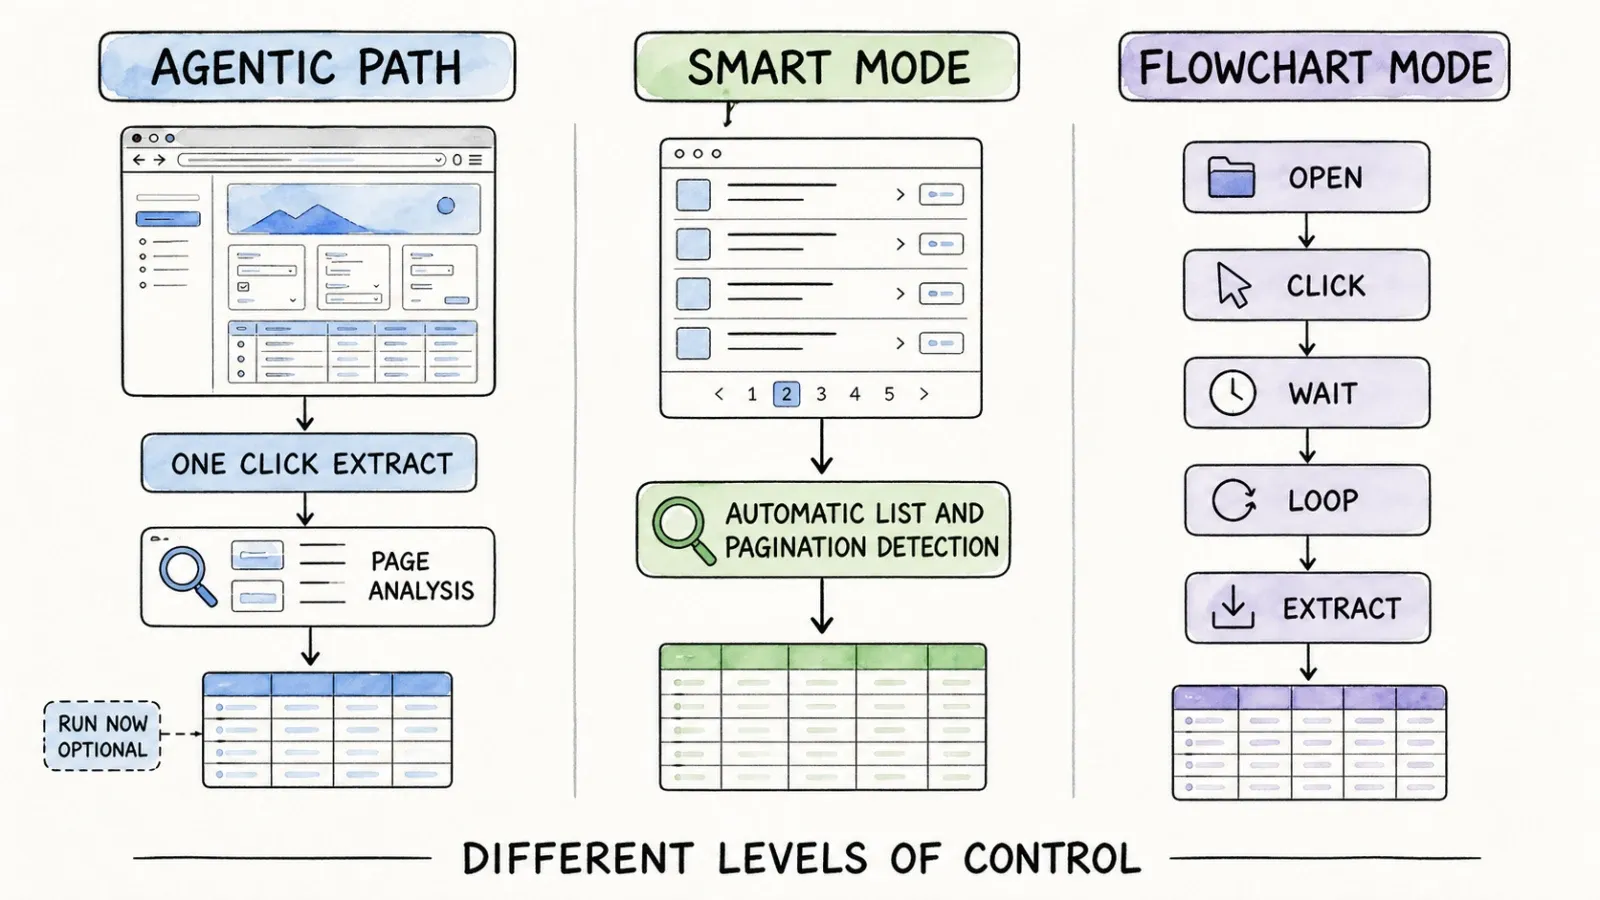
Thunderbit: jedním klikem, agentně
Celá myšlenka Thunderbitu stojí na delegování. Neříkáte nástroji: „Cena je v tomhle konkrétním divu a název v tomhle span.“ Spíš říkáte v podstatě: „Zjisti to sám“ — a agent to udělá. Je to opravdu rychlejší na rozjezd, protože mezi „mám otevřenou stránku“ a „mám strukturovaná data“ není žádný konfigurační mezikrok.
Nevýhodou je, že spoléháte na interpretaci agenta. U většiny běžných stránek — produktové seznamy, adresáře, recenzní stránky — to funguje skvěle. U stránek s neobvyklou strukturou nebo nejasnými daty ho možná budete muset směrovat pomocí instrukce v přirozeném jazyce.
ScrapeStorm Smart Mode
Smart Mode je odpověď ScrapeStormu na stejný problém. Nemyslím si, že je fér nazývat ho „ručním“ — je to automatické rozpoznávání vzorů, jen postavené kolem identifikace konkrétních typů stránek, ne kolem obecného agentního uvažování. Když funguje, je opravdu nenáročný na nastavení. Když stránka neodpovídá vzorům, které umí rozpoznat, přesměruje vás to spíš do Flowchart Mode.
ScrapeStorm Flowchart Mode
Tohle je režim, kde už opravdu stavíte workflow. Sestavujete sekvenci kroků, testujete ji a ladíte, když se kliknutí nechytí nebo je čekání moc krátké. Je to výkonné, ale je to úplně jiný typ práce — spíš lehké programování pomocí vizuálních bloků než styl „ukázat na stránku a dostat data“.
Ten kontrast se mi pořád vrací: Thunderbit vám na kompatibilních stránkách dá tabulku prakticky hned. ScrapeStorm Flowchart Mode vám dá workflow, které jste si sami postavili, otestovali a teď mu můžete důvěřovat, že poběží stejně pokaždé — ale tu důvěru jste zaplatili časem na nastavení.
Porovnání v praxi
Pojďme si projít pár realistických scénářů, protože abstraktní porovnávání funkcí vás dostane jen do určitého bodu.
Jednoduchý seznam nebo tabulka
Pokud taháte obyčejnou tabulku — třeba adresář firem s názvem, adresou a telefonem — Thunderbit s jedním klikem funguje extrémně rychle. ScrapeStormův Smart Mode by to měl zvládnout taky, pokud stránka odpovídá rozpoznatelným seznamovým vzorům.
Paginace a nekonečný scroll
Tohle je jeden z nejčastějších problémů, který vidím v uživatelské zpětné vazbě — nikdo nechce padesátkrát ručně kliknout na „další stránka“. Thunderbit na podporovaných stránkách zvládá kompatibilní paginaci i obohacení z podstránek automaticky v rámci svého agentního toku, pokud to struktura stránky umožňuje. ScrapeStorm Smart Mode také umí na podporovaných typech stránek paginaci automaticky rozpoznat, a když to nestačí, Flowchart Mode má přímo komponenty pro smyčky — ať už přes stránky, nebo pro scrollování nekonečného feedu.
Ani jeden nástroj nezaručí úspěch na každém typu stránkování. Některé weby používají opravdu záludnou logiku (například JavaScriptem renderovaná tlačítka „načíst další“ s divným načasováním) a oba nástroje jsou závislé na skutečném chování cílové stránky.
Detailní stránky a vícekroková navigace
Tady se rozdíly prohlubují. Pokud potřebujete ze seznamové stránky přejít na jednotlivé detailní stránky a z každé vytáhnout další pole, Thunderbit to na kompatibilních stránkách zvládá pomocí subpage enrichment jako součást stejného agentního workflow — bez samostatné konfigurace. ScrapeStorm to samozřejmě zvládne také, ale obvykle vyžaduje Flowchart Mode, kde přesně namodelujete sekvenci kliknutí na detail a extrakce.
Přihlašování, formuláře a úlohy náročné na interakci
Tohle je legitimní otázka, která padá pořád: „Funguje to za přihlášením?“ Thunderbit umí pracovat v autorizované, přihlášené relaci v prohlížeči tam, kde je to podporováno — tedy pokud jste už ve svém prohlížeči přihlášení na web, rozšíření může v této relaci fungovat. Není to ale záruka pro každý autentizační mechanismus nebo každý anti-bot systém.
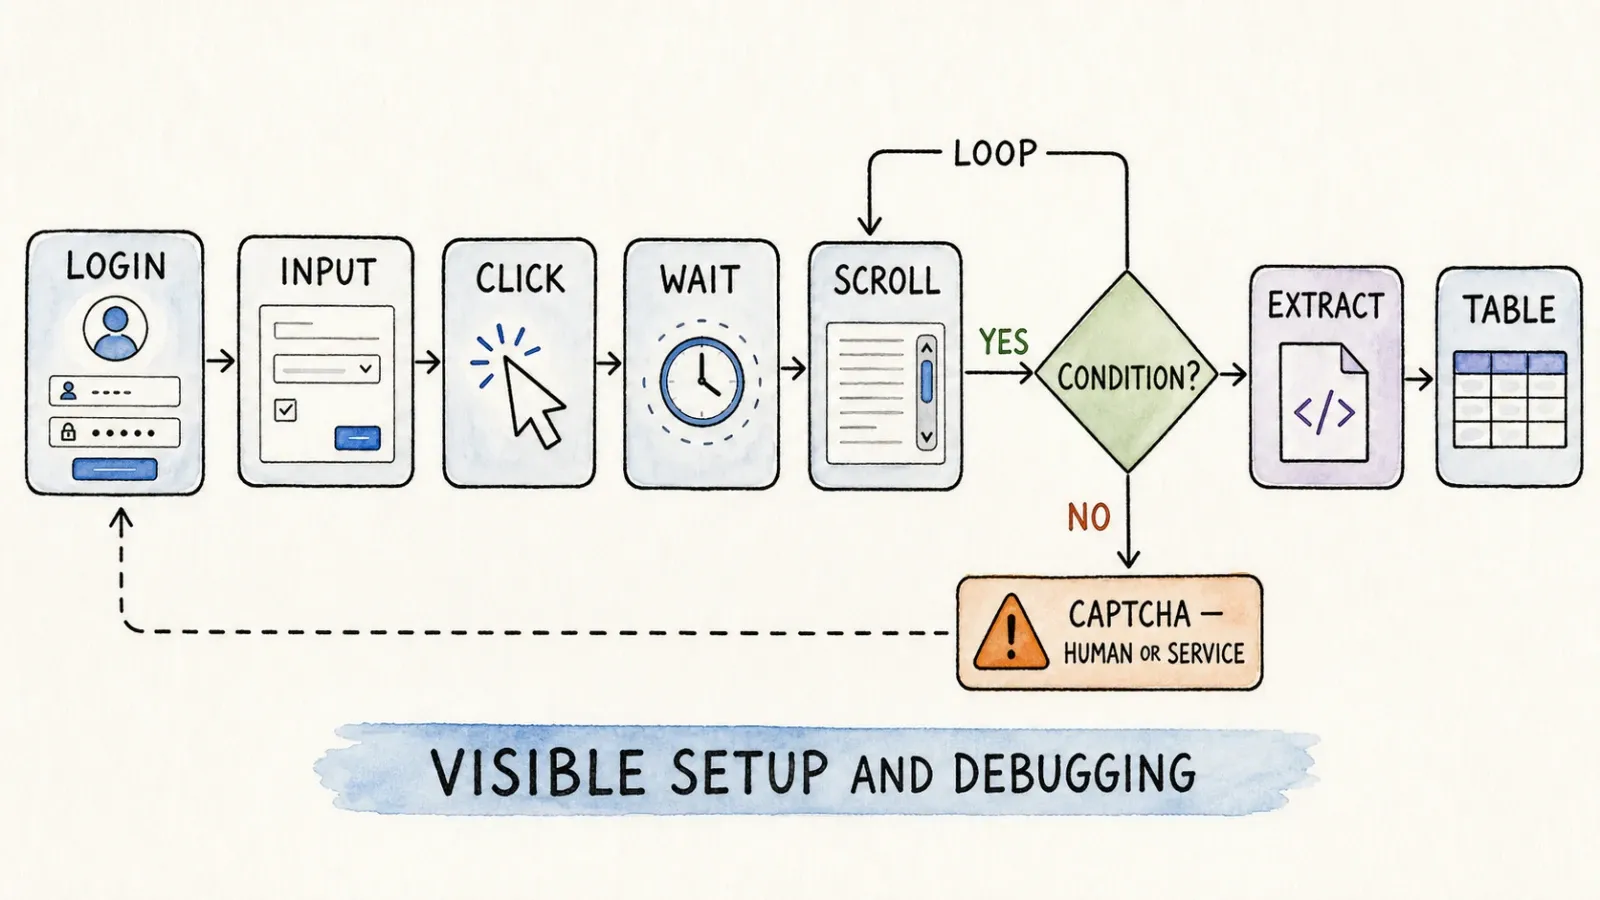
ScrapeStorm Flowchart Mode vám dává explicitní komponenty pro zadávání a klikání, takže můžete krok za krokem namodelovat i přihlašovací sekvenci — zadat uživatelské jméno, heslo, kliknout na odeslání, počkat na přesměrování. Je to víc manuální, ale zároveň mnohem transparentnější, protože přesně vidíte, co se v každém kroku děje.
Pokud jde o CAPTCHA: ScrapeStorm v tarifu Business obsahuje funkce pro práci s CAPTCHA. Ani jeden nástroj by se neměl popisovat jako prostředek, který obejde každý anti-bot systém — to je prostě nereálné tvrzení pro jakýkoli scraping nástroj.
Opakovaný plánovaný sběr
Pokud potřebujete tahat data týdně nebo denně, oba nástroje podporují plánování — Thunderbit přes cloudové plány (konkrétní možnosti závisí na vašem aktuálním tarifu), ScrapeStorm od tarifu Premium s možnostmi každou hodinu / denně / týdně a s automatickým exportem.
Automatizace a přístup pro vývojáře
Pro týmy, které chtějí jít dál než jen klikání v rozhraní, mají oba nástroje vývojářskou vrstvu, ale je postavená dost jinak.
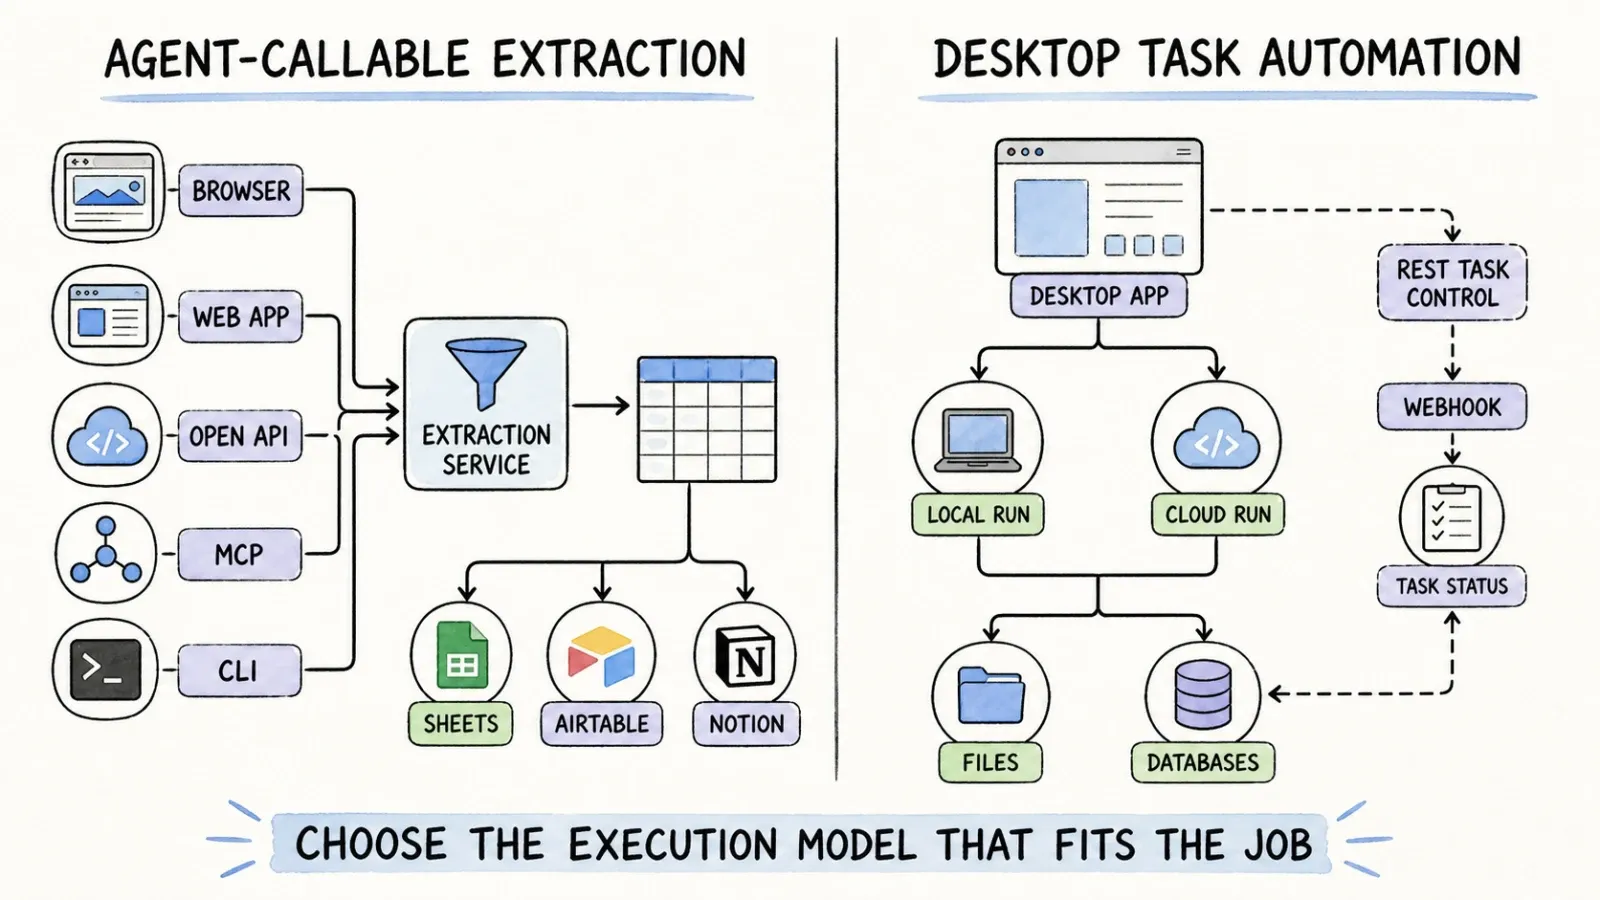
V tarifu Business nabízí ScrapeStorm RESTful API, které umožňuje řídit úlohy běžící v lokálně nainstalované aplikaci ScrapeStorm — načíst úlohu, zkontrolovat stav, spustit ji, zastavit ji, vymazat data a podobně. Přidává také webhooky a skupiny úloh. Chci to upřesnit: jde o automatizaci řízení úloh pro lokálně běžící desktopovou aplikaci, ne o hostované extrakční API, které by na serveru samo stáhlo a vrátilo data. To je důležitý rozdíl, pokud na tom stavíte celý systém.
Open API v Thunderbitu je navržené spíš jako klasické API rozhraní — můžete spustit extrakci a získat strukturovaná data programově, bez potřeby mít lokálně spuštěnou desktopovou aplikaci. MCP Server je hodně zajímavý pro každého, kdo teď staví s AI agenty — zpřístupňuje extrakční schopnosti Thunderbitu jako nástroj, který mohou agenti v Claude, Cursoru nebo podobném prostředí přímo volat. A CLI dává uživatelům zvyklým na terminál možnost skriptovat si scrapingové úlohy.
Pokud stavíte agentní workflow nebo chcete extrakci jako jeden krok v širším automatizovaném pipeline, myslím, že právě kombinace API a MCP je místo, kde má Thunderbit architektonicky navrch pro vývojářské použití.
Export a nasazení
Exportní možnosti ScrapeStormu jsou hodně orientované na lokální soubory a databázové workflow: Excel, TXT, CSV, HTML lokálně a také přímé připojení k MySQL, PostgreSQL, SQL Serveru a MongoDB. Integrace s Google Sheets a automatický export se objevují od tarifu Premium.
Thunderbit má export nastavený podle nástrojů, ve kterých obchodní týmy běžně pracují — Excel, Google Sheets, Airtable, Notion — plus další aktuálně podporované formáty (viz aktuální nabídka na webu Thunderbitu).
Hlubší provozní rozdíl je v tom, že desktop-first model ScrapeStormu znamená, že spravujete soubory úloh a spouštíte aplikaci na konkrétním počítači (nebo až na třech současných strojích v tarifu Business). Thunderbit s browserovým a cloudovým spuštěním znamená menší režii na správu strojů, ale také menší kontrolu ve stylu „všechno běží jen u mě na počítači“, kterou některé týmy citlivé na data preferují.
Ceny
Vždy lidem říkám, ať se před rozhodnutím podívají na aktuální ceník, protože předplatné se mění častěji, než bychom si přáli. Přesto tady je to, co ukazovala oficiální cenová stránka ScrapeStormu v době mého průzkumu:
- Starter (Free): 10 úloh, jedno souběžné lokální spuštění, neomezený počet URL / stránek na úlohu, ale limit 100 exportovaných řádků denně
- Professional (45 USD/měsíc, nebo 39 USD/měsíc při roční fakturaci): 100 úloh, dvě souběžná lokální spuštění, limit exportu 10 000 řádků denně, rotace IP
- Premium (89 USD/měsíc, nebo 79 USD/měsíc ročně): neomezené úlohy, neomezené souběžné lokální běhy, neomezený export dat, plánování, integrace s Google Sheets, stahování obrázků
- Business (179 USD/měsíc, nebo 158 USD/měsíc ročně): vše z Premium plus REST API, webhooky, skupiny úloh, stahování souborů, funkce pro CAPTCHA a až tři souběžné počítače
- Customized: cena na dotaz
Chci upozornit na jednu důležitou věc u formulace „neomezený počet URL / stránek na úlohu“ u free tarifu — neomezené procházení stránek neznamená neomezený použitelný výstup, protože pořád máte limit 100 exportovaných řádků denně. Do toho navíc vstupuje výkon lokálního počítače, chování cílového webu, limity souběžnosti a náklady na proxy (které mohou být prodávány zvlášť). To všechno určuje, jak „neomezené“ to ve skutečnosti je.
Aktuální ceny Thunderbitu si zkontrolujte přímo na oficiální cenové stránce — struktura plánů i kreditový systém se mohou měnit a raději vás odkazuji na zdroj pravdy, než abych tu uváděl čísla, která už za pár dní nemusí platit.
Který si vybrat?
Zvolte Thunderbit, pokud...
Jste business uživatel — obchod, provoz, marketing, výzkum — a potřebujete data rychle, aniž byste celé odpoledne studovali logiku nového nástroje. Pracujete hlavně v prohlížeči, chcete, aby paginace a obohacení z podstránek fungovaly bez další konfigurace, a raději výstup doladíte v běžném jazyce než laděním flowchartu.
Zvolte ScrapeStorm, pokud...
Vyhovuje vám nebo přímo chcete jemnou kontrolu nad logikou interakce v prohlížeči. Pracujete se stránkami, které vyžadují složitou vícekrokovou navigaci — přihlašovací sekvence, dropdown filtry, podmíněné větvení — a chcete to celé modelovat a ladit vizuálně. Navíc potřebujete exporty do lokálních databází a nevadí vám spravovat desktopovou aplikaci na počítačích vašeho týmu.
Použijte oba, pokud...
Upřímně? Děje se to častěji, než by lidé přiznali. Mluvil jsem s týmy, které používají Thunderbit na rychlé jednorázové browserové tahy dat a ad hoc výzkum, zatímco ScrapeStorm nechávají běžet na plánovaných Flowchart úlohách proti několika složitým webům za přihlášením, kde je potřeba přesná kroková kontrola. Nikde není napsáno, že musíte pro každou scrapingovou úlohu ve firmě zvolit jen jeden nástroj.
Konečný verdikt
Kdybych to měl shrnout do jedné věty: Thunderbit vás nejkratší cestou dostane z „otevřené stránky“ ke „strukturovaným datům“ díky delegování na agenta, zatímco ScrapeStorm nabízí kombinaci automatické detekce a praktické vizuální kontroly pro případy, kdy stránka opravdu vyžaduje krokovou logiku.
Ani jeden z nich není v prázdnu objektivně „lepší“ — tohle zjednodušení je upřímně trochu líné. Co bych tedy skutečně doporučil: vyberte si jednu reálnou cílovou stránku, ke které máte oprávnění přistupovat, ideálně takovou, která je důležitá pro váš skutečný workflow, a otestujte oba nástroje přímo na ní. Změřte, jak dlouho trvá nastavení. Podívejte se, jestli je výstup hned použitelný, nebo potřebuje čištění. A přemýšlejte o tom, kdo to bude spravovat za půl roku.
To je skutečné srovnání — ne tabulka funkcí (i když je dobrá, jako ta výše), ale vaše reálná data a trpělivost vašeho týmu s konfigurací. Pokud chcete vidět, jak si agentní přístup poradí s vaší konkrétní stránkou, rozšíření Thunderbit pro Chrome si můžete zdarma vyzkoušet — klikněte na One Click Extract na stránce, která je pro vás důležitá, a podívejte se, co vrátí, než se rozhodnete pro něco složitějšího.
FAQ
Je ScrapeStorm opravdu poháněný AI?
Smart Mode ve ScrapeStormu používá automatické rozpoznávání vzorů k identifikaci seznamových a obsahových struktur i paginace na mnoha typech stránek, což výrobce marketingově označuje jako AI / smart-detection. Je to reálná schopnost, ale je omezená na rozpoznatelné vzory stránek, na rozdíl od otevřenějšího agentního uvažování, které Thunderbit používá k interpretaci libovolné struktury stránky.
Jaký je rozdíl mezi Smart Mode a Flowchart Mode?
Smart Mode se automaticky snaží rozpoznat data a stránkování na seznamových a obsahových stránkách s minimálním nastavením. Flowchart Mode vyžaduje, abyste sestavili explicitní vizuální workflow z komponent jako click, wait, scroll, input, condition a loop — získáte tak větší kontrolu nad stránkami, které Smart Mode neumí zpracovat čistě, ale zaplatíte za to delším nastavením.
Vyžaduje Thunderbit selektory nebo programování?
Ne. Základní workflow v prohlížeči je agentní — kliknete na One Click Extract a nástroj stránku detekuje, přečte a analyzuje, navrhne pole a pak se sám spustí (Run Now jen umožní start okamžitě, místo čekání). Pro standardní postup nepotřebujete XPath, CSS selektory ani ruční návrh schématu.
Umí oba nástroje pracovat s paginací a přihlašovacími stránkami?
Oba mají relevantní schopnosti, ale ani jeden negarantuje univerzální úspěch. Thunderbit podporuje kompatibilní paginaci a obohacení z podstránek na podporovaných stránkách a může pracovat v autorizované přihlášené browser session tam, kde je to podporováno. ScrapeStorm Smart Mode umí na mnoha typech stránek automaticky rozpoznat paginaci a Flowchart Mode má explicitní komponenty pro modelování přihlášení a složité navigace. Výsledky vždy závisí na konkrétní struktuře webu, typu autentizace a případných anti-bot ochranách.
Má ScrapeStorm API?
Ano, v tarifu Business. Jde o RESTful API pro řízení úloh běžících v lokálně nainstalované aplikaci ScrapeStorm — spuštění, zastavení, kontrolu stavu a mazání úloh, plus podporu webhooků. Je to automatizace řízení úloh, ne hostované extrakční API, které běží nezávisle na lokální desktopové instalaci.
Který nástroj je lepší pro plánovanou extrakci?
Oba podporují plánování. ScrapeStorm nabízí desktopové plánování od tarifu Premium s možnostmi každou hodinu / denně / týdně a automatickým exportem. Thunderbit nabízí cloudové plánování podle vašeho aktuálního plánu — přesné možnosti si ověřte na cenové stránce Thunderbitu.
Dokáže některý z nich scrapovat úplně každý web?
Ne, a každý nástroj, který by to tvrdil, by měl vzbuzovat skepsi. Thunderbit i ScrapeStorm závisí na tom, jestli je cílová stránka dostupná, strukturálně kompatibilní a jestli k ní máte oprávnění přistupovat. Silné anti-bot systémy, neobvyklé renderování přes JavaScript a přísná autentizace mohou omezit oba nástroje. Vždy testujte na své skutečné cílové stránce, než se zavážete k nějakému workflow.




