
Každých pár týdnů mi někdo z našeho supportu přepošle od potenciálního zákazníka stejnou otázku: „V čem se Thunderbit liší od ScraperAPI?“ Chápu, proč se na to lidé ptají — oba nástroje se objevují ve stejném výsledku Googlu pro výraz „web scraping tool“, oba mají na domovské stránce velkým písmem „scrape“ nebo „scraper“ a oba slibují, že vám z internetu vytěží data. Ale po letech budování automatizací a AI produktů (a předtím i po poměrně dlouhé době rozmotávání zamotaných datových pipeline v Automation Anywhere) vám můžu říct, že tyto dva nástroje odpovídají na úplně jiné otázky.
Tohle vlastně není srovnání typu „co je lepší“ — spíš je to jako porovnávat stěhovací firmu s osobním asistentem. Oba vám pomůžou něco zařídit, ale nikdy byste jednoho najímali na práci toho druhého. Takže vám ukážu, co přesně je ScraperAPI, co přesně je Thunderbit, kolik každý z nich ve skutečnosti stojí v reálných scénářích (což jsem si všiml, že nikdo nikdy nepoložil vedle sebe), a kdo by měl zvolit který. Bez mlžení, bez vymlouvání typu „záleží na tom“ tam, kde se tomu dá vyhnout.
Thunderbit vs ScraperAPI: Rychlá odpověď na úvod
Tady je verze na jednu větu, protože vím, že někteří z vás to čtou o polední pauze: ScraperAPI je vývojářská infrastruktura pro scraping ve velkém — proxy, řešení CAPTCHA a renderování, dodané přes API. Thunderbit je agentní, bezkódová vrstva pro extrakci, která převádí stránky, na které se právě díváte, do strukturovaných dat, a to pomocí browser extension, Web App, Open API a MCP Serveru.
Tady je přehledová tabulka, kterou bych si přál mít k dispozici, když mi podobné otázky začaly chodit poprvé:
| ScraperAPI | Thunderbit | |
|---|---|---|
| Nejlepší pro | Týmy vývojářů budující scraping pipeline | Obchodní uživatele, marketéry, ops a vývojáře, kteří chtějí rychle strukturovaná data |
| Nutné nastavení | API klíč + parametry požadavku + vlastní logika pro parsování | Na stránce kliknete na One Click Extract (browser extension), nebo pro automatizaci použijete Open API/MCP |
| Výstupní formát | Surové HTML/JSON, strukturované parséry pro podporované weby | Strukturované, exportovatelné tabulky |
| Potřeba programování | Ano, u většiny reálných workflow | Ne u browser flow; ano, pokud používáte API/CLI/MCP |
| Ideální uživatel | Vývojář nebo technický ops tým | Ne-technický uživatel, plus vývojáři, kteří chtějí rychlejší strukturovanou vrstvu |
Jestli už víte, do které skupiny patříte, skočte níže rovnou do odpovídající sekce — jedna podrobněji rozebírá ScraperAPI, druhá Thunderbit a dál najdete i skutečný rozbor cen a rozhodovací rámec, který by měl otázku „který je pro mě“ uzavřít do dvou minut.
Co je ScraperAPI? Nástroj pro vývojáře a scraping infrastrukturu
ScraperAPI je jednoduše řečeno služba, které pošlete URL a ona vám vrátí obsah stránky, přičemž se sama postará o ty nepříjemné části scrapingu — rotaci proxy, opakování neúspěšných požadavků, obcházení CAPTCHA a bot-detection systémů a volitelně i renderování JavaScriptově náročných stránek tak, jak by to udělal skutečný prohlížeč. Kód, který zavolá API a zpracuje výsledky, ale pořád píšete vy.
A to je důležitý rozdíl, který podle mě není dost často zdůrazňovaný. ScraperAPI už dávno není jen „surové HTML“ — jeho aktuální funkce zahrnují automatické parsování do JSON a strukturované datové endpointy pro podporované cíle, plus produkt DataPipeline a plný crawler access pro větší úlohy. Takže to není zaseknuté v roce 2018. Základní předpoklad produktu ale pořád je, že máte kolem něj postavený engineering workflow: něco posílá požadavky, kontroluje odpovědi, řeší retry na úrovni aplikace a ukládá výsledky někam, kde dávají smysl.
Tam, kde ScraperAPI opravdu vyniká, je infrastruktura ve velkém: stovky tisíc nebo miliony požadavků měsíčně na weby, které aktivně bojují proti botům. To je těžký problém a outsourcing správy proxy firmě, jejíž jediná práce je správa proxy, je pro mnoho vývojářských týmů chytrý tah. Řeknu to jasně, protože některé srovnávací články mají tendenci vše přehánět na obě strany: ScraperAPI negarantuje, že projde každým anti-bot systémem na světě, a jeho marketingová tvrzení, jako jsou procenta dostupnosti, jsou údaje od dodavatele, ne nezávisle ověřené benchmarky. Berte je jako výchozí bod, ne jako svaté evangelium.
Kdo by měl vůbec uvažovat o ScraperAPI?
Pravděpodobně je to dobrá volba, pokud:
- umíte psát kód, který posílá API požadavky a parsuje odpovědi
- potřebujete scrapovat ve skutečně velkém měřítku — řádově desítky tisíc až miliony stránek měsíčně
- potřebujete rotaci proxy, geo-targeting a anti-bot handling přímo v request pipeline
- už máte datovou pipeline, nebo ji chcete postavit, a ScraperAPI vám do ní zapadne jako vrstva „access“
Jestli jste si u něčeho z toho přikyvovali, nechte si ScraperAPI v užším výběru. Jestli jste u toho měli prázdný pohled, vydržte — další část bude nejspíš spíš pro vás.
Co je Thunderbit? Agentní bezkódová vrstva pro extrakci dat
Thunderbit začíná úplně jinak: místo toho, aby předpokládal, že si logiku extrakce napíšete sami, ji za vás sám odvodí. Kliknete na One Click Extract a AI Thunderbitu doporučí správná pole i strategii extrakce, a pak stránku převede do strukturovaných dat — názvy produktů, ceny, kontaktní údaje, pracovní nabídky nebo cokoli, o čem ta stránka ve skutečnosti je.

Ta jednoduchost je zásadní hlavně pro netechnické uživatele, pro které je Thunderbit navržený: od webové stránky k použitelné tabulce se dostanete jedním kliknutím, bez selectorů, návrhu schématu nebo scrapingového kódu. Nikdo nechce domácí úkol, než dostane svoji tabulku.
Thunderbit navíc není omezený jen na prohlížeč. Má Web App pro cloudové běhy, Open API pro vývojáře, kteří chtějí extrakci volat programově, MCP Server pro napojení Thunderbitu do AI agentů jako Claude nebo Cursor a CLI pro workflow v terminálu. Takže i když je hlavní zkušenost bezkódová, není to výhradně bezkódový nástroj — přesnější je říkat, že jde o vrstvu pro strukturovanou extrakci s několika vstupy do stejné schopnosti pod povrchem.
A ještě jedna věc, ke které se vrátím později: Thunderbit není nástroj na rotaci proxy ani na obcházení anti-botu. Je postavený na extrakci strukturovaných dat ze stránek, ke kterým už máte přístup, ne na boji přes CAPTCHA zdi ve velkém. Úplně jiný úkol.
Kdo by měl vůbec uvažovat o Thunderbit?
Pravděpodobně je to dobrá volba, pokud:
- jste obchodník, marketér, ops nebo výzkumník a potřebujete data ze stránky hned dnes, ne až po dvoutýdenním engineering sprintu
- chcete, aby data skončila rovnou v Excelu, Google Sheets, Airtable nebo Notion, bez psaní parseru
- raději kliknete na tlačítko, než abyste psali scraper, a není to žádná slabina charakteru, jen efektivita
- jste vývojář, který chce pro interní nástroje rychlejší vrstvu se strukturovaným výstupem, i když umíte programovat
Jak fungují: Architektura a workflow vedle sebe
Nejjednodušší způsob, jak ten rozdíl vysvětlit, je tento: ScraperAPI vám dá surový materiál a věří, že si z něj nábytek postavíte sami. Thunderbit se snaží dodat vám nábytek už smontovaný.
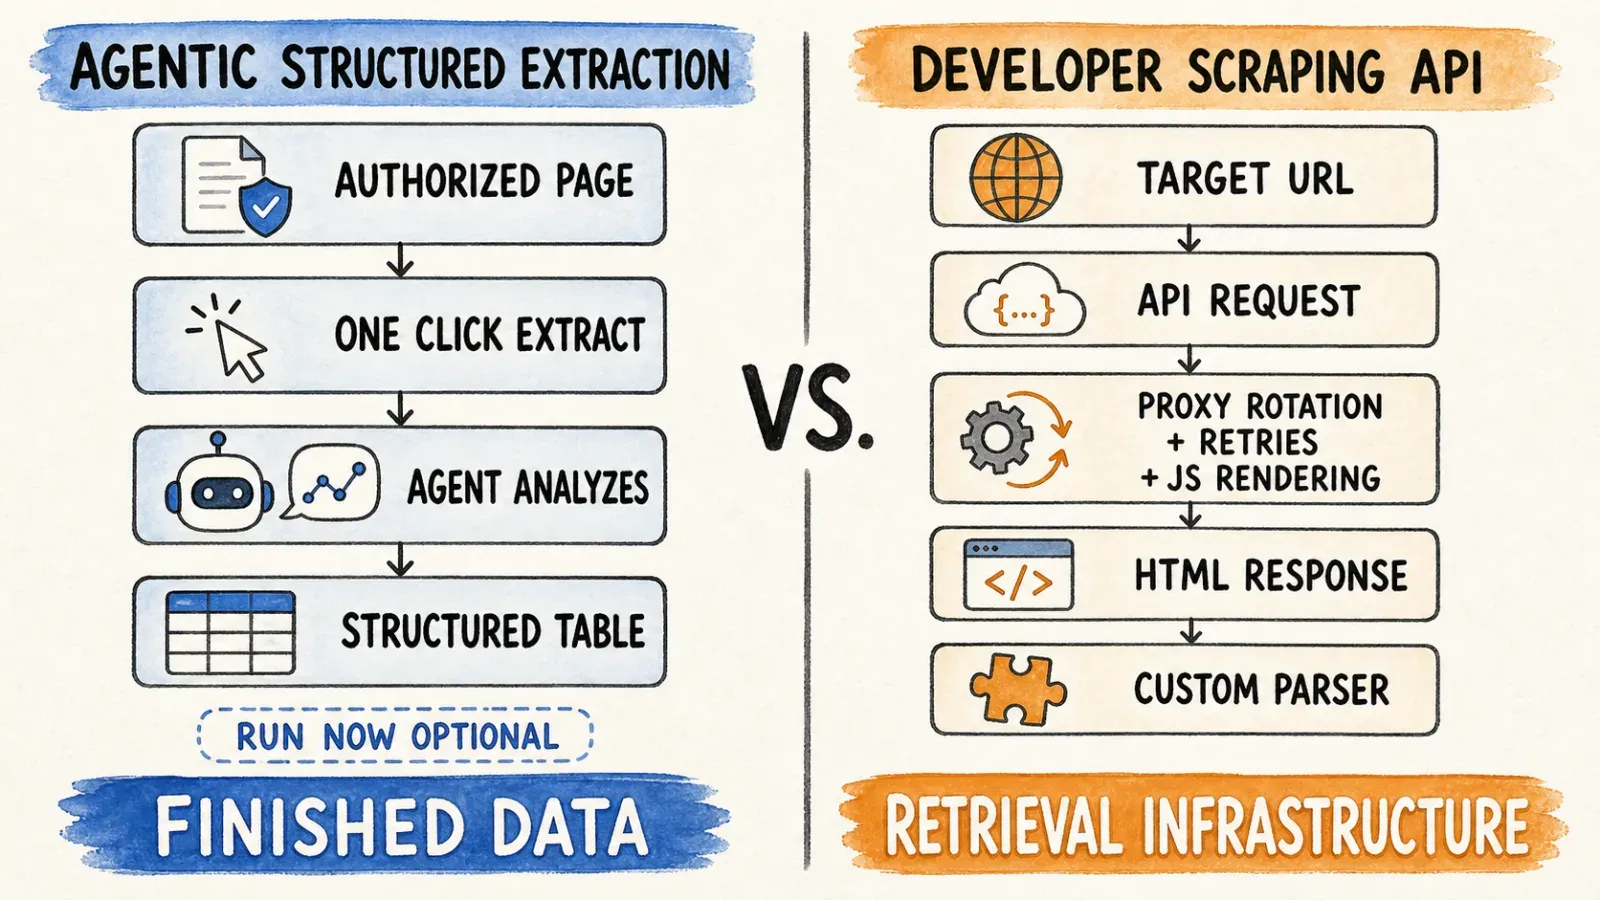
Pod kapotou je architektura ScraperAPI primárně o proxy a renderingu. Váš požadavek projde jeho sítí, podle potřeby se přesměruje přes residential nebo mobile IP, případně se vykreslí v headless prohlížeči, pokud je potřeba spustit JavaScript, a pak se vám vrátí jako HTML, JSON nebo parsovaná struktura pro podporované domény. Všechno navazující — návrh schématu, ukládání, deduplikace, plánování — je na vás, pokud zrovna nepoužíváte DataPipeline nebo crawler produkty, které jsou na to přímo určené.
Architektura Thunderbitu je naopak nejdřív o analýze. Agent si předem přečte strukturu i obsah stránky a teprve potom rozhodne, co extrahovat, což znamená, že krok „schema“, který by vývojář normálně psal ručně, řeší automaticky. Výstup není surovina — je to tabulka, kterou můžete poslat obchodnímu manažerovi, aniž byste se museli omlouvat za formátování.
Srovnávací tabulka: Základní principy
| ScraperAPI | Thunderbit | |
|---|---|---|
| Základní model | Rotace proxy + renderování HTML/JS přes API | Agentní analýza stránky → strukturovaná extrakce přes extension, Web App, API, MCP Server |
| Nastavení | Odeslání požadavku na endpoint s parametry | Kliknutí na One Click Extract; AI doporučí pole i strategii extrakce a pak ji spustí |
| Výstup | Surové HTML/JSON, strukturované parséry pro podporované weby | Strukturovaná, exportovatelná data |
| Nejlepší pro | Extrakční pipeline ve velkém měřítku | Rychlá, strukturovaná, bezkódová extrakce z dostupné stránky |
Ani jeden model není „lepší“ sám o sobě — každý řeší jinou úzkou část procesu. Úzké místo ScraperAPI je přístup, tedy dostat se přes blokace. Úzké místo Thunderbitu je porozumění, tedy přeměnit chaotickou stránku na použitelné řádky.
Thunderbit vs ScraperAPI pricing: Skutečné náklady na 1 000 stránek
Upřímně, tohle je část, kvůli které jsem tenhle článek chtěl napsat. Každý hluboký rozbor cen ScraperAPI vysvětluje jejich systém kreditových násobitelů do úmoru a každá cenová stránka Thunderbitu rozebírá jeho vlastní plány — ale nikdo je vedle sebe nepoloží a neřekne: „dobře, ale kolik to vlastně stojí pro to, co se snažím dělat?“
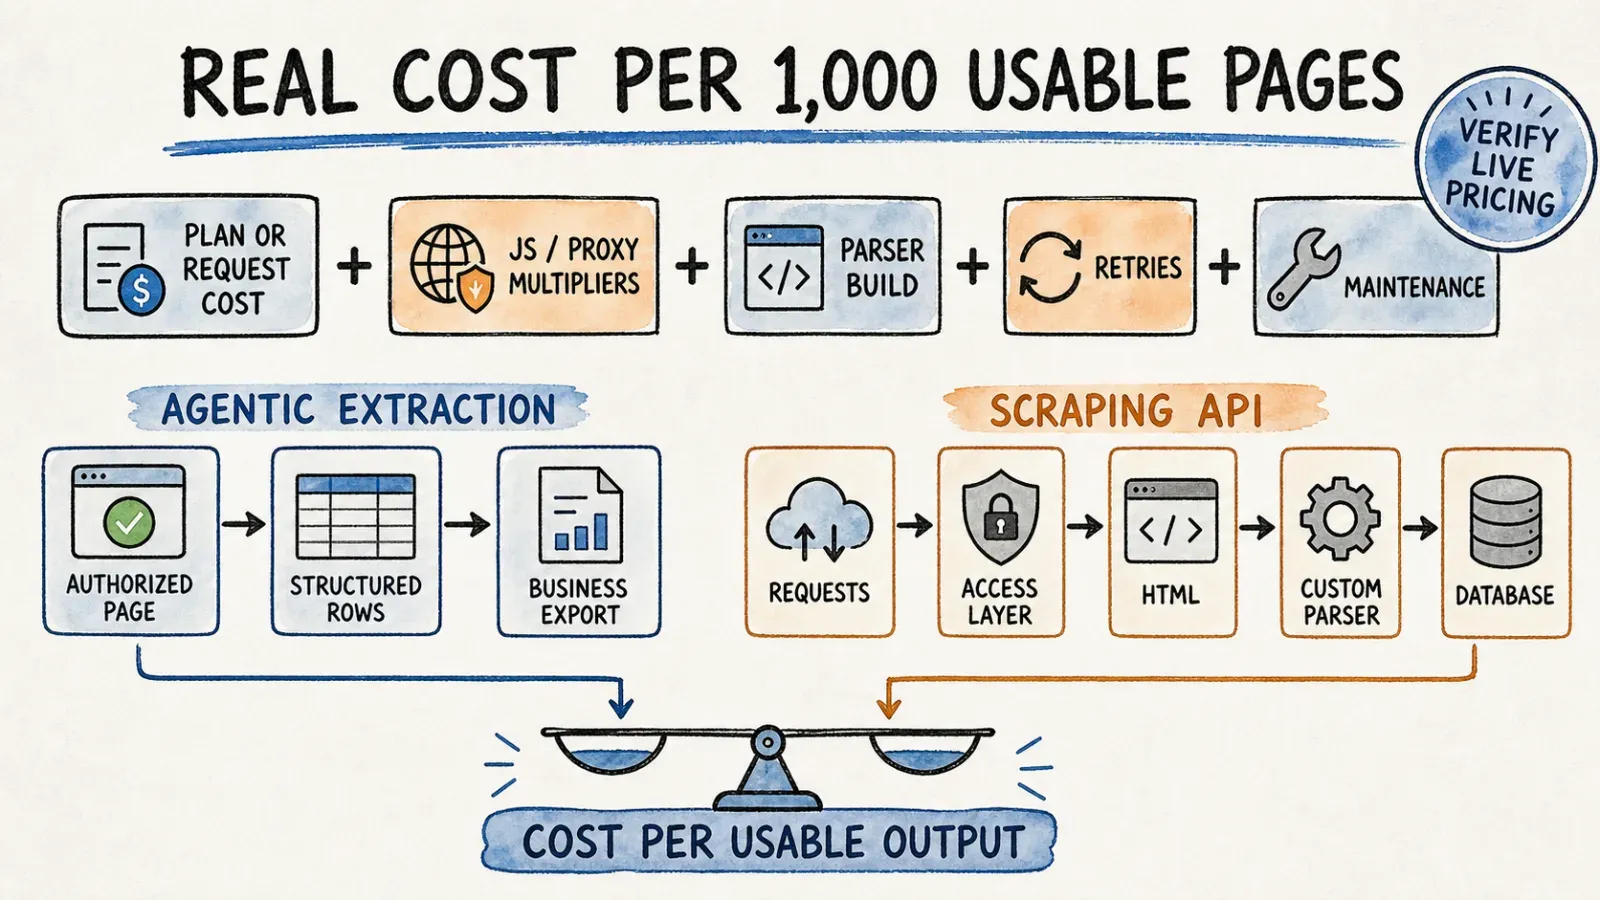
Takže si pojďme spočítat to, co umožňuje oficiální dokumentace ScraperAPI. Jejich kreditový systém účtuje různé základní sazby podle cílové stránky: běžná stránka stojí 1 kredit, Amazon 5 kreditů, výsledky vyhledávání Google nebo Bing 25 kreditů a LinkedIn 30 kreditů. K tomu navíc může obejití bot protection systémů jako Cloudflare nebo DataDome přidat dalších 10 kreditů a renderování JavaScriptu nebo premium proxy funkce mohou přidat ještě víc — přesná částka závisí na cíli, takže jediným spolehlivým zdrojem před závazkem k plánu je odhad přímo v dashboardu ScraperAPI.
Jako základ pro 1 000 stránek použijme Hobby plán ($49 za 100 000 kreditů, což vychází zhruba na $0,00049 za kredit):
| Scénář | Cena ScraperAPI za 1 000 stránek (sazba Hobby plánu) | Cena ScraperAPI za 1 000 stránek (sazba Business plánu) |
|---|---|---|
| Jednoduché statické stránky (1 kredit/stránka) | ~$0,49 | ~$0,10 |
| E-commerce stránky ve stylu Amazonu (5 kreditů/stránka) | ~$2,45 | ~$0,50 |
| Scraping Google/Bing SERP (25 kreditů/stránka) | ~$12,25 | ~$2,49 |
| Stránky LinkedIn (30 kreditů/stránka) | ~$14,70 | ~$2,99 |
To rozpětí se rychle zvětšuje, jakmile započítáte surcharge za JS renderování nebo obcházení bot ochrany, a výrazně se zmenšuje u vyšších objemů, protože cena za kredit klesá při přechodu z Hobby na Business, Scaling nebo Professional tier. A právě tohle většina srovnávacích článků vynechává — efektivní cena za stránku u ScraperAPI silně závisí jak na cílovém webu, tak na úrovni plánu.
Cenový model Thunderbitu funguje strukturálně jinak: místo multiplikátorů podle domény, kde scrapování LinkedIn stojí 30× víc než statického blogu, jsou plány Thunderbitu postavené na měsíčních kreditových balíčcích navázaných na objem řádků nebo stránek, které extrahujete, a škálují se podle úrovně plánu. Nebudu vám tady vymýšlet žádné číslo za kredit, protože ceníky se mění a raději vás pošlu na aktuální cenovou stránku Thunderbitu, než abyste mě za tři měsíce citovali s číslem, které je dávno zastaralé. Co ale můžu říct orientačně: při jednorázovém úkolu — třeba stáhnout 500 leadů z adresáře nebo projít pár set produktových nabídek pro zákaznický audit — nebudete sedět a před spuštěním počítat kreditové multiplikátory. Prostě provedete extrakci a vaše cenová úroveň určí, kolik podobných běhů za měsíc získáte.
Shrnutí: pokud děláte scraping ve velkém přes mnoho typů domén a předem umíte odhadnout své kreditové multiplikátory, cenový model ScraperAPI odměňuje plánování a objem. Pokud děláte strukturovanou, ad hoc nebo business-orientovanou extrakci, kde je hodnota ve výsledné tabulce, ne v počtu requestů, Thunderbit je navržený přesně na tenhle případ použití.
Který z nich byste měli zvolit? Rozhodovací rámec podle typu uživatele
Všiml jsem si, že články, které se v tomhle srovnání umisťují nejvýš, vlastně nikdy neodpoví na otázku, kterou lidé do Googlu skutečně zadávají, tedy nějakou verzi „jsem vývojář, který potřebuje infrastrukturu, nebo jsem business člověk, který prostě potřebuje data?“. Takže to řeknu napřímo.
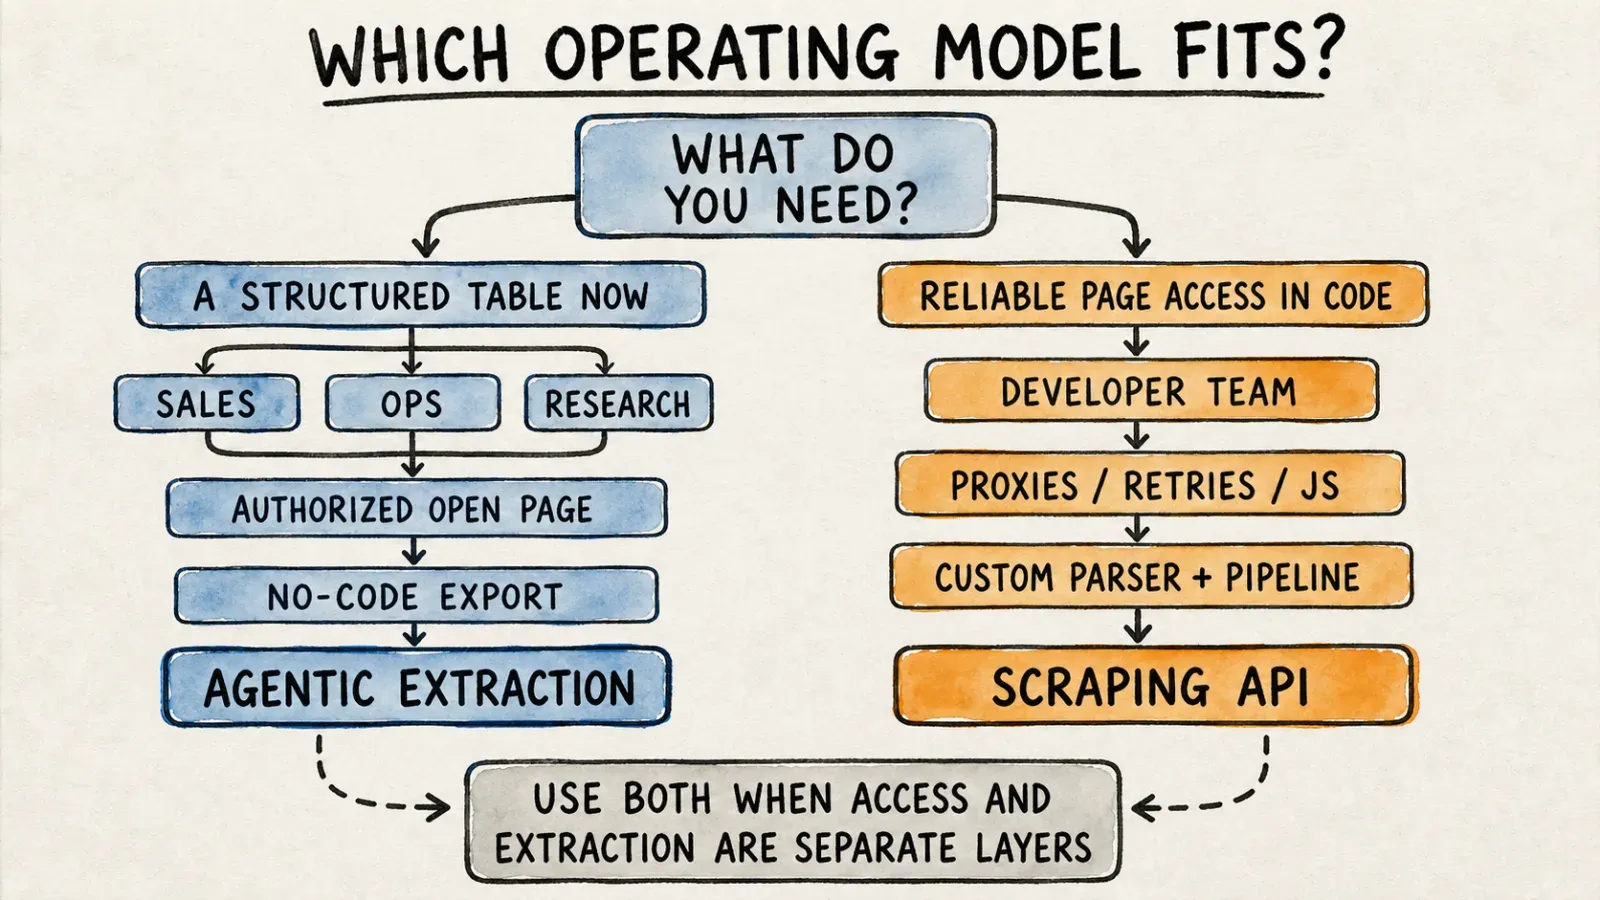
Zvolte ScraperAPI, pokud...
- jste vývojář nebo engineering tým, který staví scraping infrastrukturu ve velkém
- potřebujete rotaci proxy a řešení CAPTCHA přímo zabudované do API volání
- umíte psát logiku požadavků a parsovat surové HTML nebo JSON odpovědi
- váš use case zahrnuje miliony requestů měsíčně napříč mnoha různými doménami
Zvolte Thunderbit, pokud...
- jste obchodník, marketér nebo operátor a potřebujete strukturovaná data ze stránky, kterou už máte otevřenou
- chcete kliknout na One Click Extract a nechat agenta, aby si pole odvodil sám, místo psaní jediného řádku scrapingového kódu
- potřebujete, aby výstup šel rovnou do Excelu, Google Sheets, Airtable nebo Notion
- jste vývojář, který chce rychlejší vrstvu se strukturovaným výstupem pro interní nástroje, aniž by musel stavět extrakční logiku od nuly
Jako první přiznám, že tohle není pro každého binární rozhodnutí. Mluvil jsem s týmy, které používají oba nástroje — engineering spravuje ScraperAPI pipeline pro vysoký objem a infrastrukturu, zatímco sales a marketing používají Thunderbit pro požadavky typu „potřebuju tenhle seznam leadů do čtvrtka“, které by jinak dva týdny ležely v engineering backlogu. Tahle kombinace dává poctivě velký smysl, jakmile přestanete nutit jeden nástroj dělat práci toho druhého.
Nahrazuje Thunderbit ScraperAPI? Vyjasnění zmatku
Tady vidím nejvíc zmatku a chci být úplně přímočarý místo toho, abych to kvůli SEO obcházel. Lidé hledají „AI scraper tool“ a všechny výsledky — včetně Thunderbitu — házejí do stejné mentální přihrádky jako „scraping infrastructure“. Jenže to není stejná přihrádka.
Thunderbit je vrstva pro strukturovanou extrakci. Je postavený tak, aby přeměnil stránku, ke které už máte přístup, na použitelná a exportovatelná data, přičemž AI určí pole místo toho, abyste museli ručně definovat schéma. Není to nástroj na rotaci proxy ani anti-bot bypass infrastruktura jako ScraperAPI. Pokud potřebujete denně projít přes Cloudflare challenge na deseti tisících různých doménách, to je domácí hřiště ScraperAPI, ne Thunderbitu.
Otočte to ale naopak: ScraperAPI nenabízí bezkódové AI rozpoznání polí. Klidně vám vrátí HTML stránky chráněné silnou bot detekcí, ale pořád jste to vy, kdo rozhoduje, co v tom HTML znamená „price“ nebo „job title“, a píše kód, který to vytáhne. Ani jeden nástroj se nesnaží být tím druhým a já bych vám to raději řekl na rovinu, než abyste na to přišli až tři týdny do projektu.
Pro crawling ve velkém, kde je vysoké riziko blokování, zůstávají proxy pool a anti-bot handling u ScraperAPI přímější volbou. Pro rychlou, strukturovanou extrakci ze stránek, ke kterým už vy nebo váš tým máte přístup, je agentní přístup Thunderbitu postavený přesně na tohle. A férově vůči oběma produktům — ani jedno tvrzení bychom neměli přehánět: Thunderbit neslibuje, že obejde každý anti-bot systém na světě, a tvrzení o uptime a úspěšnosti u ScraperAPI jsou self-reported, nikoli nezávisle ověřené.
Srovnávací tabulka funkcí: Thunderbit vs ScraperAPI
Kromě rozdílů v architektuře a ceně je tady i praktický pohled na věci, které tým skutečně řeší každý den.
| Funkce | ScraperAPI | Thunderbit |
|---|---|---|
| Nutnost programování | Ano, u většiny reálných use case | Ne, u flow přes browser extension |
| Formát výstupu | Surové HTML/JSON, strukturované parséry pro podporované weby | Strukturované tabulky připravené k exportu |
| Možnosti exportu | Spravuje vývojář (vlastní storage/delivery) | Export do Excelu, Google Sheets, Airtable, Notion |
| Plánování | Dostupné přes DataPipeline pro podporované workflow | Dostupné na podporovaných plánech a produktových úrovních |
| Proxy / anti-bot handling | Zabudované do každého requestu, klíčová funkce produktu | Není hlavní funkcí; cílí na dostupné/oprávněné stránky |
| Automatizační rozhraní | REST API, DataPipeline, crawler access | Browser extension, Web App, Open API, MCP Server, CLI |
| Nejlepší fit pro tým | Engineering / technický ops | Sales, marketing, ops, research a také vývojářské workflow |
Poslední řádek je vlastně celý příběh v jedné větě. Jestli je váš tým plný inženýrů, ScraperAPI vám pravděpodobně dává smysl už dávno. Jestli je váš tým plný požadavků typu „může někdo stáhnout tenhle seznam do tabulky?“, Thunderbit existuje přesně kvůli tomu.
Přístup k datům, compliance a odpovědné používání
Tuhle část nechám krátkou, protože si nemyslím, že by vám nebo mně měly firmy dávat právní rady. Oba nástroje vyžadují, abyste pracovali s veřejnými nebo jinak autorizovanými daty, respektovali přístupová pravidla webů, ze kterých data získáváte, dodržovali platné zákony o ochraně soukromí a řídili se podmínkami použití cílového webu. Ani proxy síť ScraperAPI, ani AI extrakce Thunderbitu samy o sobě nedělají žádný scraping automaticky legální nebo compliant — odpovědnost je na tom, kdo extrakci spouští, ne na nástroji, který ji provádí. Pokud scrapujete něco, co zahrnuje osobní údaje, přihlášené relace nebo web s výslovným „no scraping“ v podmínkách, to už je téma pro právní tým, ne pro checkbox v produktu.
Časté dotazy: Thunderbit vs ScraperAPI
Má Thunderbit API jako ScraperAPI? Ano. Open API od Thunderbitu podporuje Distill a strukturovanou Extract pro programové, vývojářské workflow. Je to jiný zážitek než bezkódová browser extension a je postavený pro týmy, které chtějí volat extrakci ze svých aplikací nebo backend pipeline.
Zvládne Thunderbit CAPTCHA / blokování IP jako ScraperAPI? Ne. Thunderbit nenabízí infrastrukturu pro rotaci proxy a obcházení CAPTCHA, na které je ScraperAPI postavené. Je navržený pro strukturovanou extrakci z dostupných a oprávněných stránek — ne pro obcházení anti-bot systémů ve velkém.
Co je levnější pro 10 000 nebo 100 000 stránek? Opravdu záleží na scénáři. Jednoduchá úloha na statických stránkách ve velkém měřítku obvykle nahrává cenám ScraperAPI na infrastrukturní úrovni, pokud máte vyšší plán. Strukturovaná, ad hoc extrakce — kde je hodnota ve finální tabulce, ne v počtu requestů — obvykle nahrává Thunderbitu. Než budete předpokládat, že je jeden z nástrojů automaticky levnější, podívejte se na rozbor scénářů výše.
Je Thunderbit dobrá alternativa ke ScraperAPI? Jen pro strukturované bezkódové potřeby extrakce. Není to drop-in náhrada za proxy rotaci nebo anti-bot infrastrukturu ve velkém, a raději vám to řeknu předem, než abyste to zjistili uprostřed projektu.
Můžu Thunderbit a ScraperAPI používat společně? Spousta týmů to dělá přesně takhle — engineering používá ScraperAPI pro infrastrukturu s vysokým objemem, zatímco business týmy používají Thunderbit pro strukturované jednorázové nebo opakované úlohy, které nepotřebují celý engineering sprint. Neexistuje pravidlo, že si musíte vybrat jen jeden.
Rozhodnutí mezi těmito dvěma se ve skutečnosti točí kolem jediné upřímné otázky: stavíte infrastrukturu, nebo jen potřebujete tabulku dat do konce dne? ScraperAPI je scraping infrastruktura pro vývojáře — proxy, CAPTCHA handling a renderování, postavené pro týmy, které umí ve velkém psát request logiku. Thunderbit je agentní bezkódová vrstva pro extrakci, navržená pro business uživatele, marketéry a výzkumníky, kteří chtějí rychle dostat strukturovaná data ze stránky, plus API a MCP vrstvu pro vývojáře, kteří tu samou rychlost chtějí i programově. Vyberte si nástroj, který odpovídá skutečné práci před vámi, ne ten s lesklejší landing page — a pokud patříte mezi ty, kdo by dnes raději klikli na tlačítko než psali scraper, můžete vyzkoušet Thunderbit Chrome extension a uvidíte, kam až vás jedno kliknutí dostane.




