
Někdo na našem Discordu se mě minulý měsíc úplně na rovinu zeptal: „V čem se Thunderbit liší od Nimble?“ Začal jsem pátrat po skutečné odpovědi a moc jsem neuspěl. Každá stránka v žebříčku byla buď tenký automaticky generovaný widget, nebo seznam od konkurenta, který Thunderbit hodil do poznámky typu „lehké/no-code“, případně článek ve stylu Thunderbit-vs-někdo-jiný, který se umístil jen díky podobnosti značek. Nikdo si totiž ve skutečnosti nesedl a neporovnal oba produkty funkci po funkci.
Tak jsem se do toho pustil sám — zčásti proto, že jsem CEO jedné z těchto firem, a zčásti proto, že mě fakt zajímalo, jak si náš produkt vede proti platformě určené pro úplně jiného zákazníka. Tady je, k čemu jsem došel — a spoiler: tyhle dva nástroje ve skutečnosti nebojují o stejného zákazníka, takže je to srovnání spíš zajímavější než jednodušší.
Stručná odpověď
Než se pustím do detailů, tady je krátká verze:
- Thunderbit je navržený pro okamžitou práci z webové stránky do tabulky. Otevřete stránku, kliknete jednou a získáte strukturovaná data — a když vývojáři potřebují zapojení do většího systému, je tu Open API, MCP Server a CLI.
- Nimble je platforma pro webová data pro vývojáře a enterprise týmy, která zahrnuje produkty Search, Extract, Crawl, Map a Agent, plus spravované Data Services pro týmy provozující rozsáhlé datové pipeline.
- Správná volba závisí na tom, kdo workflow opravdu obsluhuje — obchodník, který si dnes odpoledne potřebuje sestavit seznam leadů, nebo datový inženýr, který staví produkční infrastrukturu pro RAG systém.
Na první pohled
Mám rád tabulky, protože nutí ke konkrétnosti — v tabulce se nedá schovávat za vágní popisy jako v souvislém textu. Tady je, jak si oba produkty stojí v oblastech, které jsou při výběru opravdu důležité.
| Oblast | Thunderbit | Nimble |
|---|---|---|
| Hlavní uživatel | Netekničtí business uživatelé (obchod, provoz, marketing) | AI/datoví inženýři, enterprise týmy |
| Vstupní rozhraní | Rozšíření do prohlížeče, webová aplikace | REST API, SDK |
| Náročnost nasazení | Jedno kliknutí, bez schématu a selektorů | API klíč, výběr driveru/tieru, konfigurace schématu |
| Rozsah extrakce | Jedna stránka nebo sada stránek, obohacování podstránek | Produkty Search, Extract, Crawl, Map, Agent |
| Přístup proti botům | Spravované renderování na podporovaných/oprávněných stránkách | Víceúrovňové „drivery“ (VX6/VX8/VX10) s možnostmi stealth |
| Výstup | Tabulka, Excel, Google Sheets, Airtable, Notion | HTML, Markdown, JSON, screenshoty, strukturované parsování |
| Plánování | Plánované běhy podle tarifu | Sync/async úlohy, webhook callbacky |
| Vývojářské rozhraní | Open API, MCP Server, CLI | SDK, MCP integrace ve spravovaných Data Services |
| Přehled a monitoring | Základní historie běhů v aplikaci | Stav úloh, callbacky, integrace s cloudovým úložištěm |
| Cenový model | Kredity, self-serve tarify | Usage-based PAYG plus roční spravované tarify |
| Nejlepší využití | Rychlé jednorázové i opakované potřeby strukturovaných dat | Webová datová infrastruktura v produkčním měřítku |
Co je Thunderbit?
Thunderbit je agentní webový scraper, který primárně funguje jako rozšíření do prohlížeče. Workflow je záměrně jednoduchý v tom nejlepším smyslu: otevřete stránku, ke které máte oprávněný přístup, kliknete na One Click Extract a agent si stránku přečte, pozná, co má vytáhnout, a sám připraví pole. Zobrazí se tlačítko Run Now — klikněte na něj, pokud nechcete čekat, nebo prostě chvíli počkejte, protože extrakce se spustí automaticky, když nic neuděláte. To je celé. Žádné selektory, žádné schéma, žádný Python.
Thunderbit ale není jen nástroj na pár kliknutí. Má Web App pro spouštění a správu extrakcí přímo z prohlížeče bez rozšíření, Open API pro týmy, které chtějí extrakci spouštět ze svých vlastních aplikací, MCP Server pro propojení Thunderbitu s Claude, Cursor, Windsurf a dalšími AI agenty kompatibilními s MCP, a také CLI pro workflow s coding agenty a terminálem. Jakmile máte strukturovaná data, můžete je exportovat do Excelu, Google Sheets, Airtable nebo Notion a dolaďovat pole pomocí běžných vět místo regexů.

Chci být opatrný, protože jsem viděl spoustu marketingových textů o „AI scraperech“, které jejich schopnosti dost přeceňují. Jednokliková extrakce funguje skvěle na podporovaných a oprávněných stránkách — není to univerzální nástroj na obejití každé přihlašovací brány nebo anti-bot ochrany na internetu. Je to ale opravdu rychlý způsob, jak změnit stránku, kterou už vidíte, na tabulku, a to pokrývá překvapivě velkou část toho, co business uživatelé denně potřebují.
Co je Nimble?
Nimble je úplně jiná liga — je to platforma pro webová data určená pro inženýry, ne pro člověka ve firmě, který stále nazývá tabulku „databází“. Podle vlastní dokumentace Nimble zahrnuje produktová rodina Search API, Extract API, Crawl, Map, Web Search Agent a proxy síť, vše propojené jako SDK, které vývojáři zapojují do svých aplikací.
Samotné Extract API umí HTML, Markdown, screenshoty, hlavičky nebo strukturované parsování, renderování JavaScriptu, stealth drivery pro chráněné weby, parsovací schémata založená na CSS selektorech a dokonce i skriptované akce v prohlížeči jako klikání, scrollování a psaní. Požadavky můžete cílit podle země, státu nebo města, posílat vlastní hlavičky a cookies, zachytávat síťový provoz a spouštět úlohy synchronně nebo asynchronně s webhook callbacky. Crawl a Map rozšiřují tyto možnosti na celé domény a Web Search Agents nabízejí šablonové extraktory pro populární weby, kde je potřeba méně ruční konfigurace.
Kromě samotných API prodává Nimble i Managed Data Services — roční smlouvy, které zahrnují custom agent ETL pipeline, retenční okna dat a MCP integraci pro týmy, které chtějí, aby Nimble jejich webové datové operace prakticky provozovalo za ně. Tohle je enterprise infrastruktura, ne browserový nástroj, a je i tak naceněná a prodávaná.
Hlavní rozdíl: extrakce pro business uživatele vs. infrastruktura pro webová data
Okamžitý úkol v prohlížeči
Nejjednodušeji to lze říct takto: Thunderbit je stavěný pro chvíli, kdy máte právě otevřenou stránku a potřebujete z ní dnes data v podobě tabulky, bez ticketu na IT. To je celé poselství browserového rozšíření — nestavíte pipeline, jen se snažíte dostat 200 řádků produktových nabídek do spreadsheetu ještě před začátkem porady.
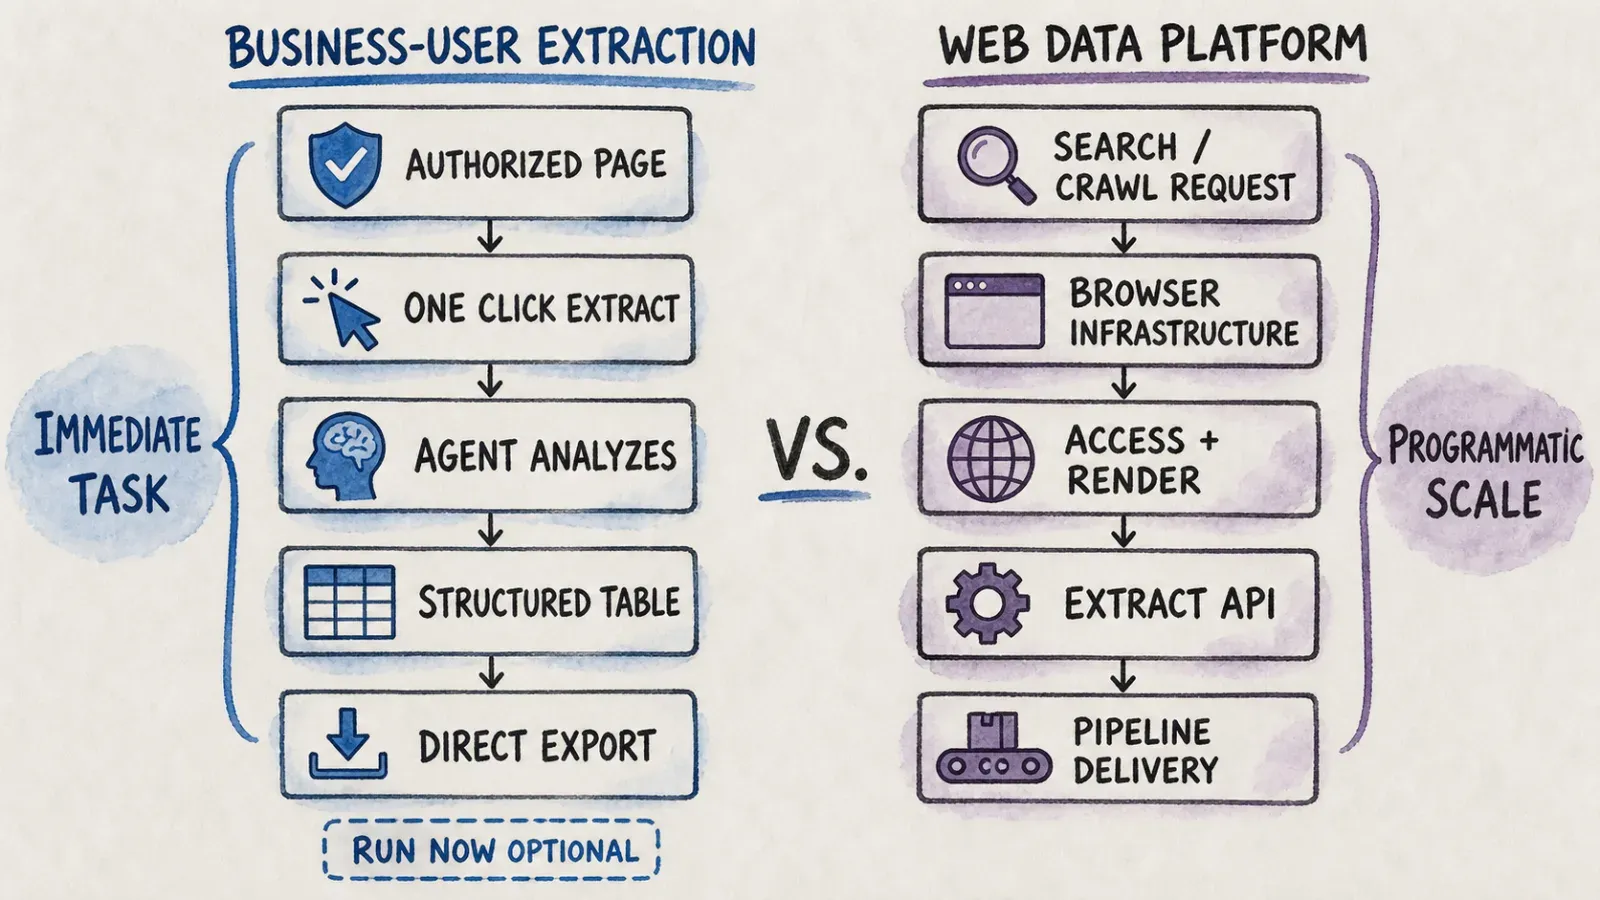
Programatický workflow pro search/crawl/extract
Nimble předpokládá, že nepracujete s jednou stránkou, ale stavíte něco, co běží nepřetržitě, ve velkém měřítku, přes tisíce nebo miliony URL a živí systém, ne tabulku. Výběr driver tieru, psaní parsovacího schématu a napojení webhook callbacků je úplně jiný mentální model než kliknutí na tlačítko v prohlížeči. Je to práce na infrastruktuře — a přesně k tomu je určená.
Podnikové operace a governance
Vrstva Managed Data Services u Nimble existuje proto, že některé firmy nechtějí tuto infrastrukturní práci řešit samy — chtějí SLA, retenční politiku a dodavatele, který ponese odpovědnost za dostupnost. Thunderbit s tímto segmentem prakticky nesoutěží; jeho tarify jsou postavené na self-serve kreditech a business týmech, ne na ročních enterprise smlouvách s garantovanou konkurencí.
Praktické scénáře
Srovnání se rychle stává abstraktním, tak to pojďme zasadit do situací, které jsem opravdu viděl v praxi.
Vytvoření tabulky leadů nebo produktů z otevřené stránky
Představte si, že jste v sales ops a šéf chce seznam všech vystavovatelů na veletrhu, stažený z webu akce, s názvem firmy, číslem stánku a URL webu. Otevřete stránku, kliknete na One Click Extract, necháte agenta, ať si sám určí sloupce, pošlete to do Google Sheets a za pár minut je hotovo. To je přesně oblast pro Thunderbit — podívejte se třeba na náš pohled na AI lead generation, pokud je to pravidelná součást vaší práce.
Napájení RAG nebo monitorovací pipeline
Teď si představte, že stavíte retrieval-augmented generation systém, který každý den potřebuje čerstvý obsah z tisíců URL, se strukturovaným parsováním a webhook notifikacemi po dokončení úloh. To je přesně to, k čemu jsou navržené Extract a Crawl API od Nimble — asynchronní úlohy, cloudové úložiště a schéma, které může downstream služba zpracovat, aniž by člověk někdy viděl surový výstup.
Crawl nebo search ve velkém měřítku
Pokud zadání zní „najdi každou stránku na této doméně“ nebo „prohledej web a shrň, co na něm je“, jste už za hranicí extrakce a jdete do discovery — to jsou produkty Search, Map a Answer od Nimble, které kombinují retrieval s AI generovanými shrnutími místo pouhého vytahování strukturovaných polí z už známé stránky.
Integrace s AI agenty
Oba produkty už dnes mluví s AI agenty, jen z různých stran. Thunderbit MCP Server dovoluje relaci v Claude nebo Cursoru přímo volat extrakční nástroje Thunderbitu, zatímco u spravovaných Data Services od Nimble je MCP integrace součástí enterprise nabídky. Ani jedna firma nemá monopol na „agent-ready“ — rozdíl je v tom, že přístup agenta v Thunderbitu stojí na stejném one-click produktu, který používá obchodník, zatímco u Nimble stojí na širší infrastrukturní vrstvě.
Kvalita dat, blokování a údržba
Tady chci být naprosto upřímný, protože dodavatelé na obou stranách — včetně mě — mají motivaci přikrášlovat spolehlivost. Spravované renderování Thunderbitu zvládá spoustu běžných JavaScriptově náročných stránek automaticky, ale platí to pro podporované a oprávněné stránky — není to garance proti každému anti-bot systému na internetu. Model driverů v Nimble je k tomuto kompromisu otevřený: nabízí tři úrovně — VX6 pro standardní statické HTTP požadavky, VX8 pro JavaScript renderování a VX10 pro stealth renderování na chráněných stránkách — a cena roste s tím, jak je cílový web obtížnější na přístup.
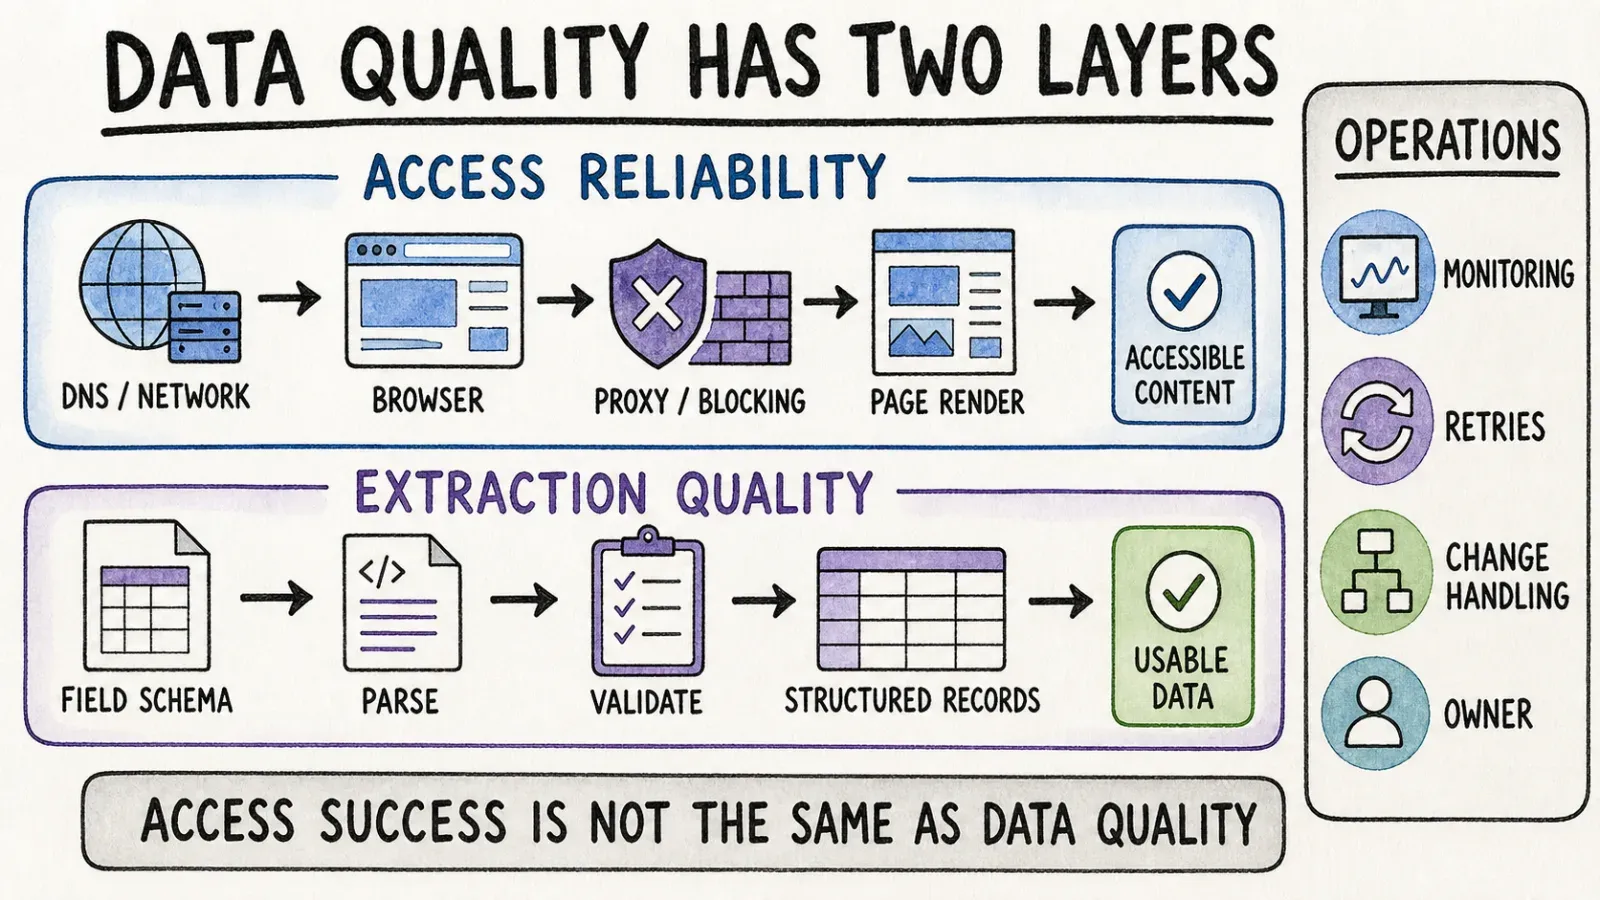
Na Nimble si vlastně cením toho, že je ohledně cenování složitosti otevřený, protože je to férové přiznání něčeho, s čím se potýká každý dodavatel scraperu: čím víc se web brání, tím víc infrastruktury je potřeba a někdo za ni musí zaplatit. Ani jedna firma nemůže slibovat nulové blokování nebo nulovou údržbu na každém webu na internetu, a byl bych skeptický k jakémukoli nástroji, který tvrdí opak.
Rozdíl je v tom, kdo nese průběžnou údržbu. U Thunderbitu náš tým spravuje logiku extrakce i agenta, který stránky interpretuje — nemusíte psát ani udržovat selektory. U Nimble, pokud používáte parsovací schémata založená na CSS selektorech v Extract API, jste to vy, kdo musí selektory upravovat, když cílový web změní rozvržení, pokud nesáhnete po šablonových Web Search Agents.
Cena a celkové náklady
Srovnání cen pro přesně tuto dvojici v podstatě nikde online neexistuje, což mě překvapilo vzhledem k množství obsahu, který porovnává každý z těchto nástrojů s něčím jiným. Tady je, co jsem našel na oficiálních stránkách, s upozorněním, že ceníky se mění a před rozpočtem byste měli vždy zkontrolovat aktuální verzi.
| Položka | Thunderbit | Nimble |
|---|---|---|
| Vstupní bod | Self-serve tarify, kreditový model | Zkušební verze: 5 000 webových stránek, bez nutnosti karty |
| Základní extrakce | Kredity rostou podle tarifu (viz Thunderbit Pricing) | Extract/Crawl/Map na VX6: $0.90 za 1 000 URL |
| JavaScript renderování | Součást agentní extrakce | VX8: $1.30 za 1 000 URL |
| Stealth/chráněné weby | Spravováno automaticky tam, kde je to podporováno | VX10: $1.45 za 1 000 URL |
| Search/Answer | Není to hlavní produktová vrstva | Ceník Nimble a SDK dokumentace si zde odporují — jedna uvádí $5 za 1 000 vstupů, druhá $1 za 1 000, takže před rozpočtem ověřte přímo |
| Extrakce s agentem | Součást tarifu | Od $3 za 1 000 prohlédnutých stránek, plus 10 % za spravované Web Search Agents |
| Rezidenční proxy | Netýká se | $5.30 za GB |
| Enterprise/spravovaná vrstva | Aktuální positioning to není | Managed Data Services od $2 500/měsíc za 350 000 kreditů na stránky až po $15 000/měsíc za 3 miliony stránek, případně custom Enterprise |
Pár poctivých postřehů. Zaprvé, ceník Nimble a jejich SDK dokumentace si protiřečí u ceny Search API — jedna uvádí $5 za 1 000 vstupů, druhá $1 za 1 000. To je přesně ten nesoulad, který bych chtěl před podpisem smlouvy vyjasnit, a proto to zmiňuju místo toho, abych vybral jen tu hezčí částku. Zadruhé, kreditový model Thunderbit se v recenzích na G2 objevuje jako mírná třecí plocha, přičemž někteří uživatelé píší, že by cena mohla být při vyšším objemu dostupnější — férová připomínka, kterou můj tým při vývoji produktu bere vážně. Zatřetí, srovnávat tyhle dva nástroje čistě podle ceny je trochu jako srovnávat cenu taxi a leasing auta — celkové náklady u Nimble zahrnují čas inženýrů na vytvoření a údržbu integrace, což se na ceníku nikdy neukáže, ale reálně to existuje.
Kdo by měl zvolit Thunderbit?
Thunderbit je správná volba, pokud jste netechnický operátor — v obchodě, marketingu, náboru nebo ecommerce provozu — a potřebujete dnes dostat strukturovaná data z webové stránky, bez čekání na vývojáře. Je to také dobrá volba pro menší týmy, které chtějí jeden nástroj pokrývající jak rychlou jednoklikovou extrakci, tak případně i napojení na API nebo na AI agenta kompatibilního s MCP, aniž by musely zaměstnat dedikovaného datového inženýra. Pokud váš tým někdy řekl „prostě potřebujeme tenhle seznam v tabulce“, tohle je ten use case. Pro širší pohled na to, kam zapadá no-code extrakce, pokrývá víc náš článek o web scraping bez programování.
Kdo by měl zvolit Nimble?
Nimble dává smysl ve chvíli, kdy jste engineering nebo data tým a stavíte něco, co musí běžet nepřetržitě a ve skutečném měřítku — search, crawl nebo extrakční úlohy v řádu desítek tisíc až milionů stránek, které napájejí RAG pipeline, monitorovací systém nebo interní datový sklad. Pokud potřebujete kontrolu na úrovni driveru nad JavaScript renderováním a stealth chováním, geotargetované požadavky, zachytávání síťového provozu nebo enterprise SLA s dedikovaným úložištěm a konkurencí, tohle je infrastruktura, o kterou se Thunderbit nesnaží.
Mohou se doplňovat?
Přiznám se, že jsem nad tím během průzkumu přemýšlel — mohl by tým rozumně používat oba nástroje? Teoreticky ano, jako dvě oddělené architektonické vrstvy: Nimble by zajišťovalo velkoškálové vyhledávání a sběr, Thunderbit by řešil poslední míli — tedy lidsky orientovaný úkol převodu konkrétní stránky do čisté tabulky pro netechnického stakeholdera. Chci ale být opatrný, abych nenaznačoval nějaké oficiální partnerství nebo integraci mezi těmito firmami, protože o žádné nevím. Jde jen o to, že produkty sedí v různých vrstvách hypotetického stacku, stejně jako proxy síť a tabulkový nástroj leží v různých vrstvách, aniž by spolu musely přímo komunikovat.
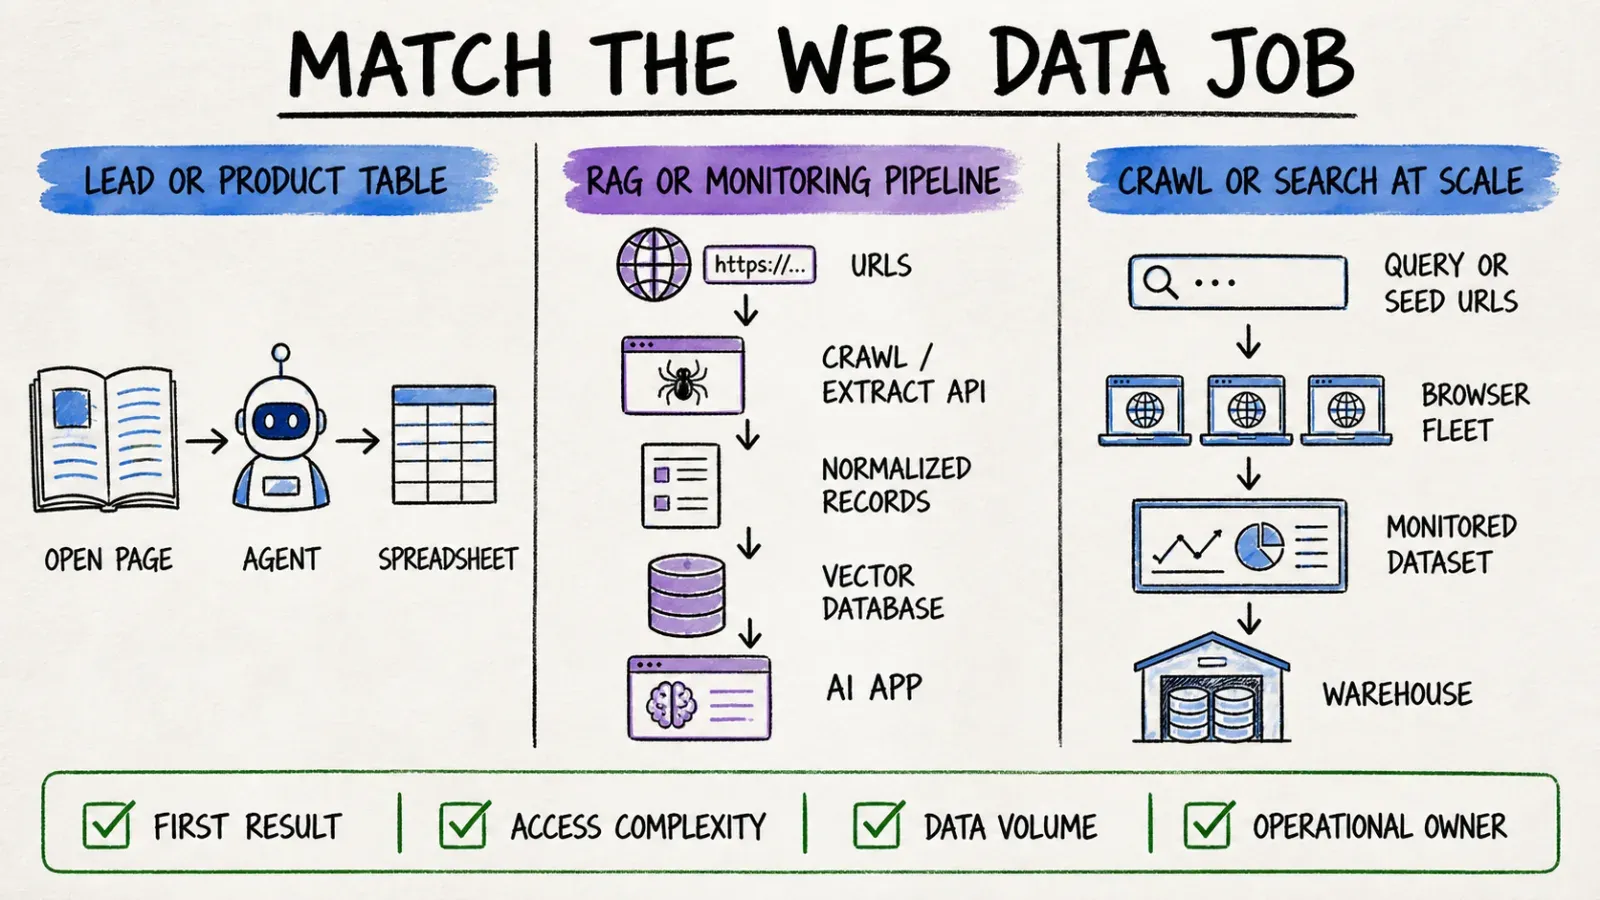
Verdikt
Kdybych to měl shrnout do jedné rady: vybírejte podle toho, kdo workflow obsluhuje, ne podle toho, která firma má efektnější AI marketing. Pětičlenný obchodní tým, který potřebuje sestavit seznam potenciálních klientů, nepotřebuje driver tiers a webhook callbacky — potřebuje kliknout na tlačítko a dostat tabulku, a právě proto jsem posledních pár let budoval Thunderbit tak, jak jsme ho postavili. Datový inženýrský tým, který staví produkční RAG infrastrukturu nad milionem stránek, nechce browserové rozšíření — chce API s odstupňovaným přístupem a enterprise podporou, a přesně proto Nimble existuje.
Dalším rozhodujícím faktorem je objem. U menšího objemu, řekněme do několika tisíc stránek měsíčně, jednokliková extrakce šetří víc času, než stojí. Za tímto bodem už ekonomika začíná nahrávat infrastruktuře, kterou lze automatizovat a monitorovat programově — a právě tady začínají dávat smysl nástroje jako naše Open API nebo platforma typu Nimble Extract API. A co se údržby týče: pokud nikdo v týmu nechce vlastnit logiku selektorů nebo konfiguraci driverů, je to silný signál, že chcete produkt, který to abstrahuje, ne ten, který vám předá ovládací prvky.
FAQ
Je Nimble rozšíření do prohlížeče? Ne. Nimble funguje přes API a SDK — jeho produkty Search, Extract, Crawl, Map a Agent se používají přes vývojářské integrace, ne jako point-and-click nástroj v prohlížeči. Thunderbit naopak nabízí jako hlavní vstupní bod browser extension.
Má Thunderbit API a MCP přístup? Ano. Thunderbit nabízí Open API pro programatickou extrakci, MCP Server pro AI agenty jako Claude, Cursor a Windsurf, a také CLI pro terminálové a coding-agent workflow, vedle no-code rozšíření do prohlížeče.
Který nástroj lépe zvládá rozsáhlé crawlování? Nimble je pro velkoobjemové crawlování a vyhledávání přímo navržené díky API Crawl, Map a Search, s úrovněmi driverů a asynchronním zpracováním úloh pro vysoké objemy. Thunderbit je optimalizovaný spíše pro extrakci na úrovni jednotlivé stránky nebo více stránek s obohacením podstránek, ne pro crawlování napříč celou doménou.
Který je pro business uživatele jednodušší? Thunderbit, a to výrazně. Jeho workflow s jedním kliknutím nevyžaduje selektory, schémata ani kód — otevřete stránku, kliknete a dostanete strukturovaný výstup. Nimble předpokládá, že požadavek nastavuje vývojář, což je pro netechnického uživatele znatelně vyšší náročnost.
Jak se liší současné cenové modely? Thunderbit používá self-serve kreditové tarify (viz Thunderbit Pricing). Nimble používá usage-based pay-as-you-go cenotvorbu navázanou na složitost driverů, plus roční smlouvy Managed Data Services začínající zhruba na $2 500 měsíčně pro enterprise potřeby. Vždy zkontrolujte aktuální ceníky obou firem, protože dokumentace Nimble si sama protiřečí mezi pricing stránkou a SDK dokumentací.




