
Posledních pár týdnů jsem sem tam koukal na web Kadoa, hlavně proto, že jejich červnový rebranding v roce 2026 mě docela vyvedl z míry. Jeden den byli „AI web scraper“ a hned nato se začali prezentovat jako „Web Scraping OS“. To je pořádný skok — a zároveň to dost napovídá o tom, kam se celý tenhle segment posouvá.
Otázka, kterou jsem dostával od čtenářů i od vlastního týmu, byla jasná: je Kadoa pořád srovnatelná s Thunderbit, nebo už úplně opustili kategorii „rychlého nástroje na scrapování“? Krátká odpověď: něco od obojího. Delší odpověď je níže.
Rychlá odpověď
Než se pustím do detailů, tady je stručný tahák:
- Thunderbit je navržený pro chvíli, kdy koukáte na web a říkáte si: „Potřebuju tahle data hned, do tabulky.“ Jedno kliknutí, žádné schéma, žádné čekání na datový tým.
- Kadoa je navržená pro organizace, které potřebují řízené, monitorované a průběžně udržované datasety v produkci — typicky finanční týmy, které každý den tahají alternativní data z desítek zdrojů a potřebují k tomu auditní stopu.
- Ani jeden nástroj není „ten AI scraper“ a druhý „ten manuální scraper“. Oba jsou ve skutečnosti agentní — rozdíl je v tom, pro co ten agent optimalizují.
Právě ten poslední bod je důležitější, než se obvykle připouští. V mnoha srovnávacích článcích se z toho dělá souboj checklistů funkcí, ale ve skutečnosti jde o dva produkty, které se posunuly do různých segmentů kupujících.
Přehled
| Oblast | Thunderbit | Kadoa |
|---|---|---|
| Primární uživatel | Business uživatelé, marketéři, samostatní operátoři, vývojáři | Enterprise a finanční datové týmy, centrální datové organizace |
| Časový horizont | Okamžitý — vytáhnout data z právě otevřené stránky | Životní cyklus v produkci — vytvořit, schválit a udržovat pipeline |
| Nastavení | Klik na One Click Extract → automatický běh | Prompt → návrh schématu → sestavení/test pipeline → schválení → plánovaný live workflow |
| Model běhu | Agentní analýza stránky pro každou relaci | Deterministické generování pipeline s agentní asistencí při údržbě |
| Údržba | Uživatel znovu spustí na kompatibilních stránkách | Automatické monitorování pipeline a self-healing (dle dodavatele) |
| Viditelnost a dohled | Náhled tabulky, doladění | Úspěšnost, MTTR, provenience, SLA dashboardy (dle dodavatele) |
| Přístupové vrstvy | Rozšíření do prohlížeče, Web App, Open API, MCP Server, CLI | Web Scraping OS platforma, enterprise nasazení |
| Ceny | Veřejné self-serve tarify, viz cena | Kontakt na obchod; v době psaní bez veřejného ceníku self-serve |
| Nejlepší použití | Ad hoc, týmové nebo středně opakované úlohy | Řízené, vícezdrojové, průběžně obnovované enterprise datasety |
Upřímně — sestavit tuhle tabulku trvalo déle, než jsem čekal, protože většina existujících textů typu „Thunderbit vs Kadoa“ jen hodí oběma produktům fajfku vedle „AI-powered“ a tím to uzavře. To ale neříká vůbec nic.
Co je Thunderbit?
Takhle dnes vypadá skutečný postup, přesně tak, jak funguje teď (ne starší verze UI, kterou některé recenze pořád popisují):

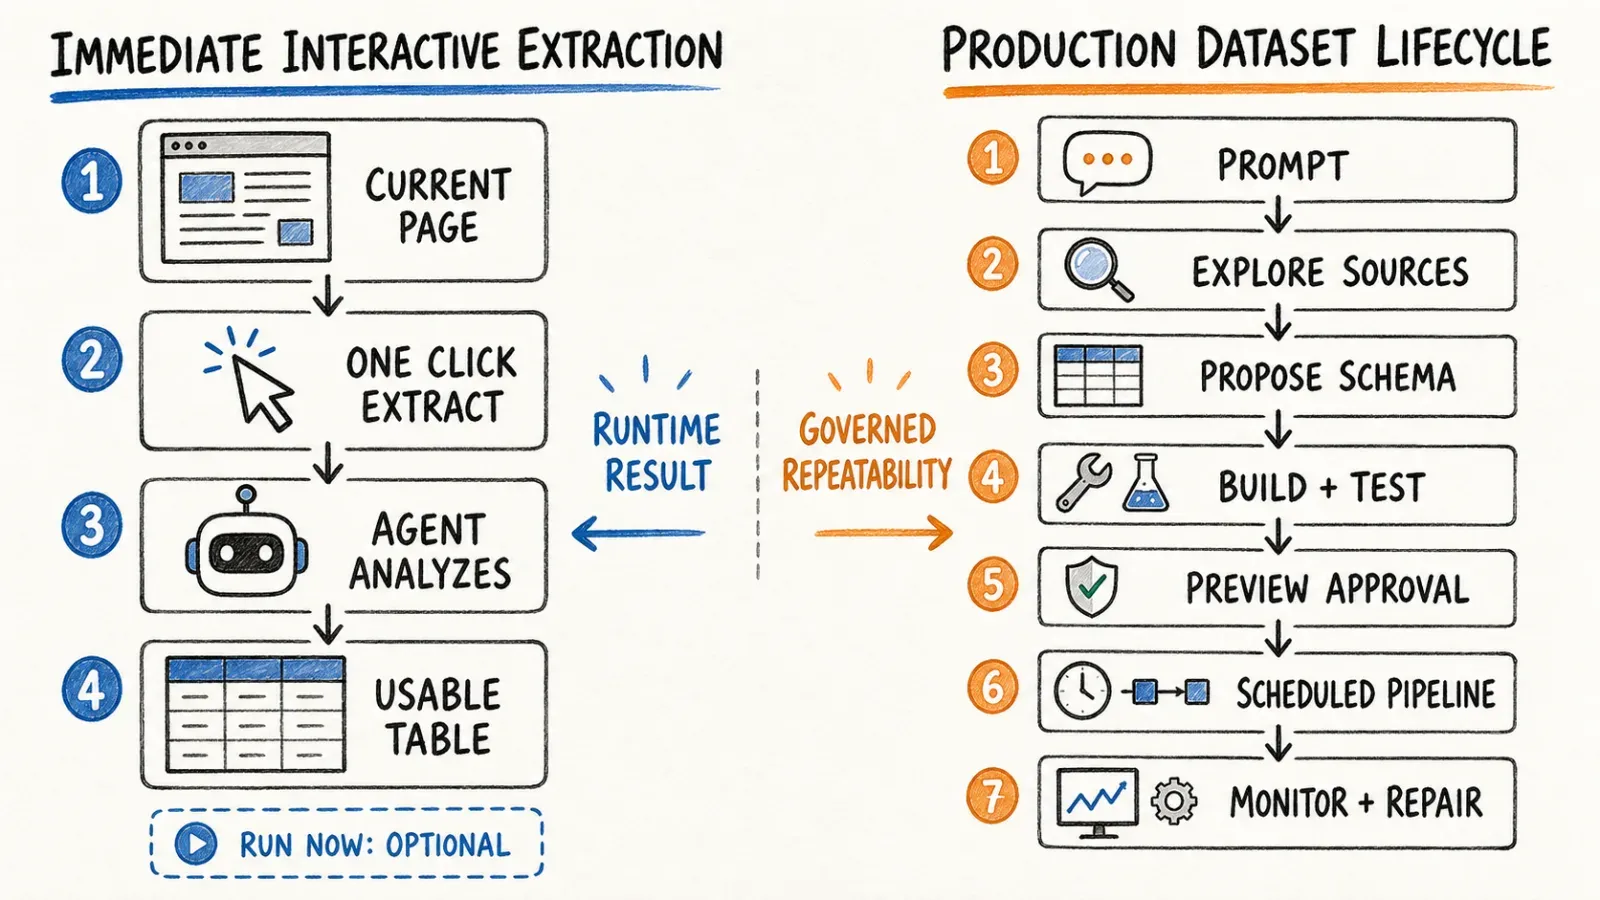
Otevřete webovou stránku, ke které máte oprávnění. Kliknete na One Click Extract. A to je všechno — agent Thunderbitu rozpozná strukturu stránky, přečte obsah, zjistí, která pole jsou důležitá, a začne připravovat extrakci. Uvidíte tlačítko Run Now, ale upřímně ho ani nemusíte stisknout — když nic neuděláte, spustí se to samo. Jedno vědomé kliknutí, žádné nastavování schématu, žádné selektory.
Rád to popisuji jako „nástroj, který se vám neplete do cesty“. Když auto-detekovaná pole nejsou úplně přesná, můžete je doladit přirozeným jazykem a na kompatibilních stránkách za vás nástroj projde i další stránky nebo obohatí podstránky. Kromě rozšíření do prohlížeče je k dispozici Web App, Open API pro vývojáře, MCP Server pro AI agenty jako Claude nebo Cursor a CLI pro terminálové workflow. Export míří do Excelu, Google Sheets, Airtable nebo Notion.
Není to nástroj navržený jako součást datového inženýrského stacku. Je postavený pro člověka, který potřebuje data teď hned a nechce kvůli tomu zakládat ticket.
Co je Kadoa v roce 2026?
Tady se to začíná lámat. Červnové oznámení Kadoa v roce 2026 představilo to, co nazývají Web Scraping OS, poháněné tím, čemu říkají „Kadoa Assistant“. Workflow, které popisují, vypadá takto:
- V přirozeném jazyce napíšete požadavek — „Potřebuju cenová data z těchto 12 konkurenčních webů, denně aktualizovaná“
- Kadoa prozkoumá zdroje a vybere nejspolehlivější metodu extrakce (API endpoint, vložené JSON, stahovatelný soubor, cokoli je nejstabilnější)
- Navrhne datové schéma
- Vytvoří deterministickou pipeline — tedy skutečně vygenerovaný extrakční kód, ne odhad LLM při každém běhu — a otestuje ji
- Dostanete náhled a schvalujete ho
- Workflow se spustí do produkce se zabudovaným plánováním, validací a notifikacemi
Rámování „Web Scraping OS“ přidává automatickou údržbu pipeline, infrastrukturu bez zbytečného blokování, observabilitu v dashboardech (úspěšnost, mean time to repair, sledování SLA), datovou provenienci a governance/compliance workflow. To je jednoznačně jazyk enterprise infrastruktury a jejich současné positioning míří tvrdě na finance a alternativní data — tedy hedge fondy a asset managery, kteří potřebují auditovatelné a průběžně obnovované datasety z desítek zdrojů.
To je opravdu jiná produktová ambice než „pomoz mi scrapnout stránku“. Tady chci Kadoa dát kredit — přechod z nástroje na scrapování na platformu datové infrastruktury je skutečný strategický krok, ne jen marketingový rebranding.
Zásadní rozdíl: okamžitá extrakce vs. životní cyklus produkčního datasetu
Thunderbit: interaktivní úloha na jedno kliknutí
Thunderbit optimalizuje nejkratší možnou cestu mezi „vidím data na stránce“ a „mám ta data v tabulce“. Není tu krok se schválením schématu, protože agent detekuje pole v reálném čase přímo na stránce, kterou už máte otevřenou. Jestli jste sólo founder nebo obchodník, přesně tohle chcete — ve 4 odpoledne v úterý, když potřebujete 200 leadů, opravdu nemáte energii na „schvalování náhledu pipeline“.
Kadoa: schválená deterministická pipeline
Workflow Kadoa záměrně vloží před produkční nasazení krok revize a schválení. Není to chyba, ale záměr — pokud stavíte dataset pro obchodní model nebo compliance report, chcete, aby člověk schválil schéma ještě předtím, než bude šest měsíců běžet bez dozoru.
Runtime interpretace versus agentem generovaný udržovaný kód
Tady je architektonický detail, který stojí za pochopení: Kadoa výslovně rozlišuje mezi agentem, který generuje deterministický extrakční kód (ten pak běží bez nutnosti volání LLM při každém spuštění), a přímou LLM extrakcí při každém načtení stránky. Jejich oficiální vysvětlení AI ve web scrapingu to rozebírá podrobněji. Nebudu spekulovat nad rámec toho, co sami zveřejnili, ale pointa je: Kadoa se snaží získat spolehlivost deterministického kódu spolu s rychlostí nastavení, kterou přináší AI-asistované vytváření pipeline. Thunderbit naproti tomu drží agentní analýzu v každé interaktivní relaci, místo aby dopředu kompiloval dlouhodobý artefakt pipeline.
Praktické scénáře
Pojďme si ukázat, jak bych každý nástroj skutečně použil, protože abstraktní srovnání funkcí nikdy neřekne celý příběh.
Jednorázová tabulka leadů / produktů / research
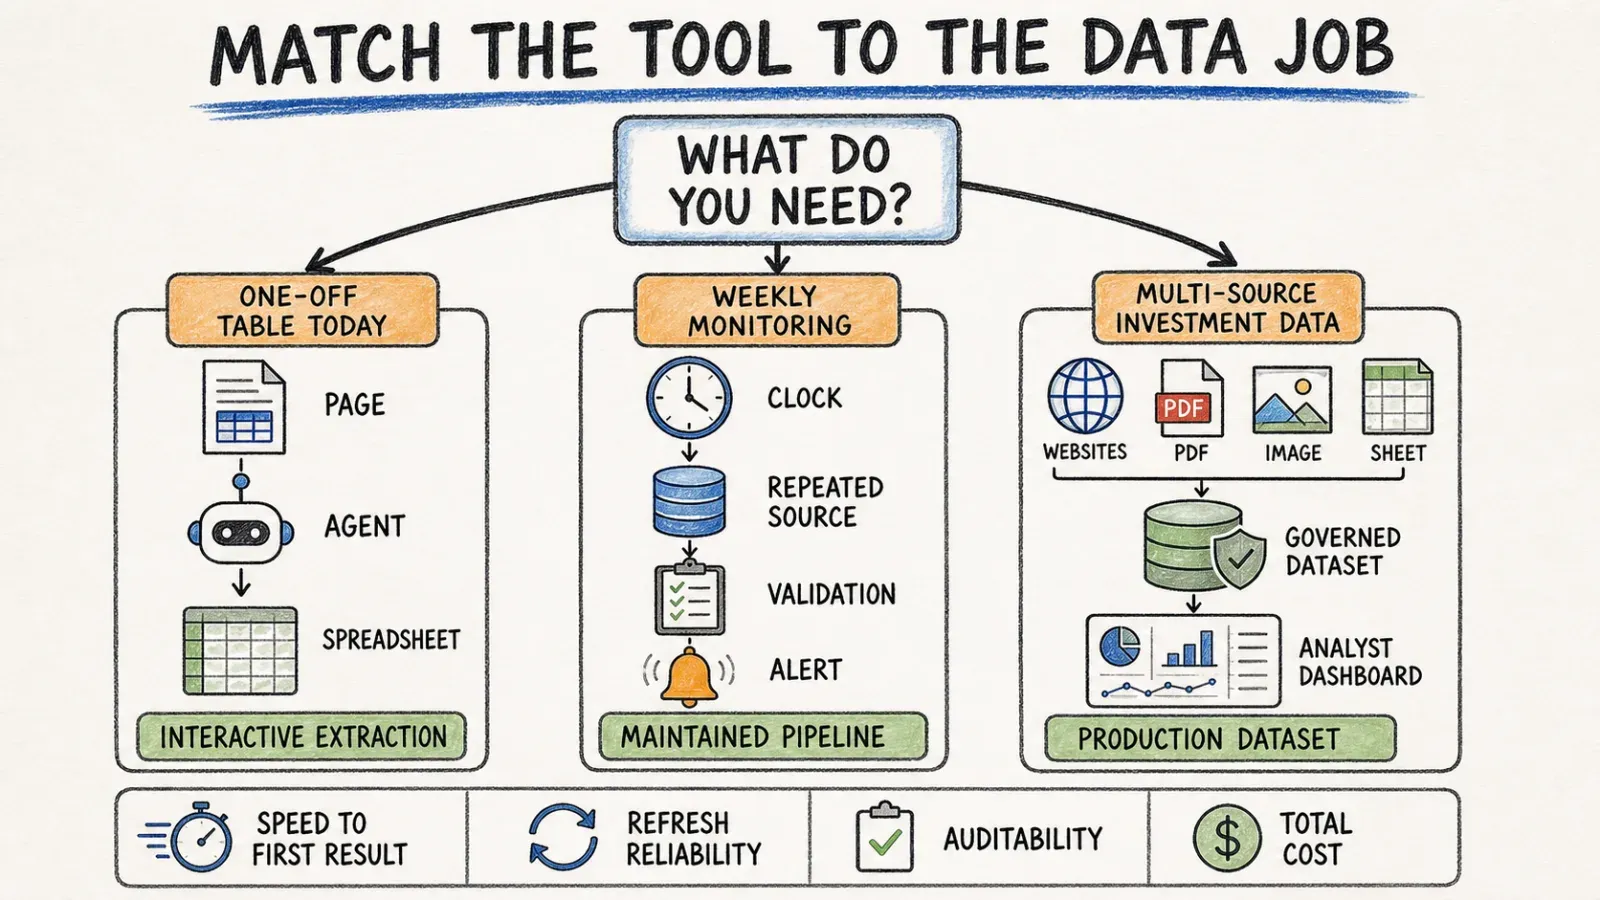
Řekněme, že potřebuji seznam 150 firem z adresáře, včetně názvů, webů a kontaktních e-mailů. Otevřel bych stránku, v Thunderbitu klikl na One Click Extract a do minuty bych měl tabulku. Neexistuje svět, ve kterém bych kvůli jednorázovému seznamu rozjížděl Kadoa pipeline, čekal na schválení schématu a na plánované spuštění. Naprosté přestřelení.
Týdenní dataset pro sledování konkurence
Teď si představme, že chci cenová data z 15 konkurenčních webů, aktualizovaná každé pondělí ráno, a uložená do dashboardu, kterému celý tým věří. Tady už se Kadoa blíží ideálnímu use case — krok schválení, monitoring a příběh o self-healing při změně designu webu konkurenta začínají hrát roli. Thunderbit to technicky umí také, a to na podporovaných tarifech a površích, ale celý pitch Kadoa je postavený přesně na tomto opakovaném vícezdrojovém scénáři.
Workflow pro investice / alternativní data z více zdrojů
To je podle současného positioning Kadoa její domovské hřiště — tahání dat z desítek finančních nebo alternativních zdrojů s trackingem provenience a auditními stopami. Sem bych Thunderbit nenasazoval; prostě to není designové centrum toho produktu.
Integrace AI agenta a doručování dat
Pokud stavím RAG pipeline nebo monitorovacího agenta, který potřebuje programově volat extrakční nástroj, tam přichází ke slovu MCP Server a Open API od Thunderbitu — Claude, Cursor nebo jakýkoli kompatibilní AI host může Thunderbit volat přímo. V době psaní nemám přehled o veřejném self-serve API nebo MCP nabídce od Kadoa, takže pokud je to pro váš stack zásadní požadavek, ověřte si to přímo u Kadoa, než budete předpokládat paritu.
Přesnost, údržba a observabilita
Kadoa popisuje source grounding, confidence scoring a kontroly plausibility/completeness jako součást validace pipeline. Zveřejnili také čísla z early results — tvrzení typu rychlejší nastavení a nižší náklady na údržbu — od zákazníků z early access. Chci být naprosto otevřený: jde o čísla, která uvádí samotný dodavatel, ne o nezávislé benchmarky, a neviděl jsem kontrolovaný head-to-head test Thunderbit vs Kadoa na přesnosti nebo zátěži údržby. Jakékoli konkrétní procento v jejich marketingu berte jako tvrzení k ověření, ne jako hotový fakt.
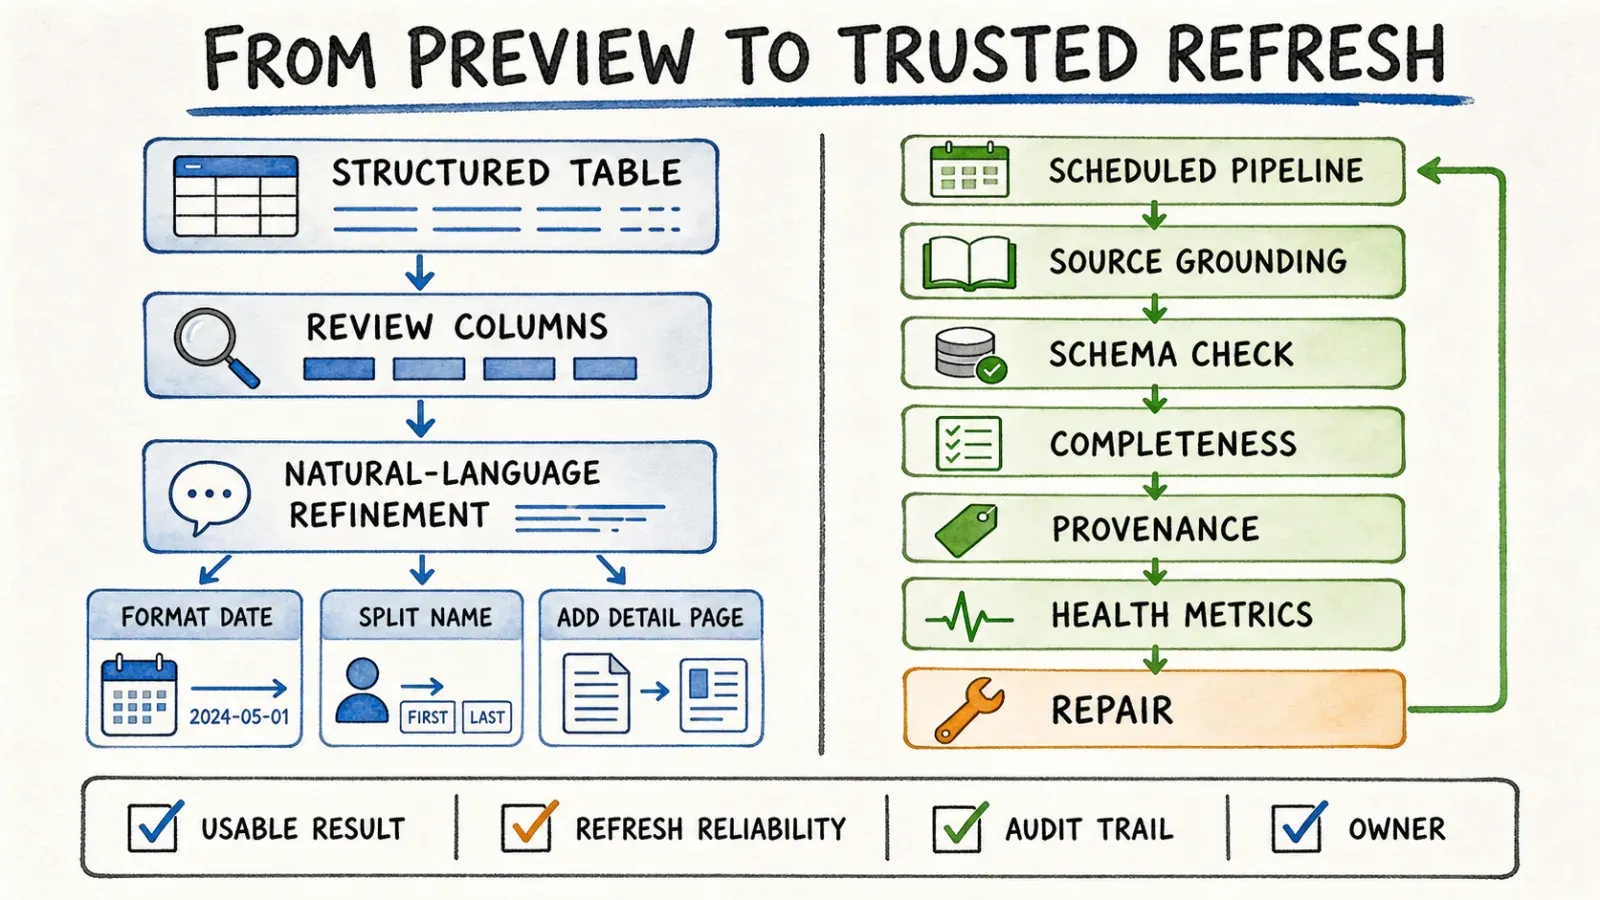
Na straně Thunderbitu je příběh přesnosti jednodušší, protože workflow je jednodušší: dostanete okamžitý náhled tabulky, můžete ho vizuálně zkontrolovat a rovnou upravit instrukce k polím, a nehrozí, že by se vám po šesti měsících tiše rozpadla pipeline kvůli redesignu webu — protože žádná dlouhodobá pipeline v tomhle smyslu vůbec neexistuje. Data taháte pořád čerstvě.
Jeden upřímný caveat platí pro oba nástroje: ani jeden negarantuje úspěch na každém webu. Přihlašovací brány, agresivní anti-bot ochrany a zásadní redesigny rozhraní jsou reálné režimy selhání. Agentní re-analýza Thunderbitu pomáhá na kompatibilních a autorizovaných stránkách, ale „agentní“ není kouzelné slovo, které by odstranilo CAPTCHA.
API, MCP a nasazení
Vývojářské rozhraní Thunderbitu je dobře zdokumentované: Open API pro programový přístup, MCP Server pro integrace AI agentů a CLI pro terminál a coding-agent workflow — navíc možnost běhu v prohlížeči i v cloudu pro interaktivní použití.
Současný model nasazení Kadoa stojí na enterprise platformě Web Scraping OS, s řízenou infrastrukturou pipeline a funkcemi pro governance a security zaměřenými na větší organizace. V době psaní jsem nenašel dokumentaci k veřejnému self-serve API ani MCP integraci pro Kadoa — pokud je to pro vás kritické, ověřte si to přímo s jejich týmem, místo abyste předpokládali stejné možnosti jako u vývojářských nástrojů Thunderbitu.
Ceny a způsob nákupu
Tady musím být upřímný ohledně jednoho omezení: veřejné stránky Kadoa po jejich červnovém spuštění v roce 2026 nezobrazují self-serve ceník. Jejich positioning vede zájemce ke kontaktu s obchodem nebo k žádosti o test. Takže pokud porovnáváte položky typu „$X/měsíc“ mezi oběma produkty, na straně Kadoa narazíte na zeď — ne proto, že bych byl líný ve výzkumu, ale protože to skutečně není veřejně dostupné.
Thunderbit má živou veřejnou stránku s cenami, kde si aktuální tarify můžete zkontrolovat hned teď.
Ve skutečnosti ale při porovnávání nákupního procesu nejde ani tak o cenovku, jako spíš o frikci při procurementu. Thunderbit vám umožní se zaregistrovat a začít extrahovat během několika minut. Enterprise model Kadoa znamená obchodní rozhovor, onboarding a nejspíš i proof-of-concept, než se dostanete do produkce. Pokud už vaše organizace má procurement proces nastavený na enterprise SaaS, není to problém. Pokud jste dvoučlenný tým, je to reálný náklad na tření, který stojí za zvážení.
Který nástroj si vybrat?
Zvolte Thunderbit, pokud...
- Jste sólo marketér, founder nebo obchodník a potřebujete data z pár stránek ještě dnes, bez čekání na kohokoli dalšího
- Váš tým potřebuje opakované exporty do Sheets nebo Airtable, ale nemá datový engineering tým, nebo ho nechce najímat
- Jste vývojář a stavíte AI agenta, RAG pipeline nebo monitorovací skript a chcete programový přístup přes API, MCP nebo CLI
- Dáváte přednost tomu získat použitelnou tabulku jedním kliknutím před formálním schvalováním pipeline
Zvolte Kadoa, pokud...
- Jste enterprise nebo finance datový tým a potřebujete řízené, vícezdrojové, průběžně obnovované datasety s auditní stopou
- Compliance, provenience a dashboardy s observabilitou jsou pro vás nepřekročitelné nákupní podmínky
- Máte nebo budujete procurement proces, který zvládne enterprise produkt s obchodním kontaktem a individuální cenou
- Na údržbě pipeline a self-healing infrastruktuře vám záleží víc než na rychlosti jednoho kliknutí
Použijte oba, pokud...
- Vaši analytici chtějí rychle prozkoumat a ověřit datový nápad v Thunderbitu, než centrální datový tým rozhodne, zda má smysl jej operacionalizovat do udržované enterprise pipeline v Kadoa. Tenhle pattern jsem už viděl u menších firem, které rostou — začnou neformálně a později proces formalizují.
Závěrečný verdikt
Neustále se vracím ke stejnému rámci: Thunderbit je interaktivní agentní scraper postavený na rychlosti a dostupnosti. Kadoa, zvlášť po rebrandingu, je enterprise Web Scraping OS postavený na governanci a škálování. Srovnávat je podle checklistu funkcí míjí podstatu — řeší úplně jiné proměnné.
Pokud se mezi nimi opravdu nemůžete rozhodnout, moje upřímná rada je udělat malý proof of concept, a ne slepě věřit jakémukoli srovnávacímu článku, včetně tohoto. Sledujte: za jak dlouho získáte první použitelný výsledek, jak spolehlivě extrakce přežije změnu webu, jak auditovatelný je výstup pro váš use case a jaké jsou skutečné celkové náklady vlastnictví, když započítáte čas na nastavení i údržbu.
Pro většinu lidí, kteří se na tuhle stránku dostanou — tedy pro někoho, kdo kouká na web a přemýšlí, jak z něj dostat data bez psaní kódu nebo čekání na IT — je browser extension Thunderbitu pravděpodobně rychlejší cesta k odpovědi. Start je zdarma a během pěti minut zjistíte, jestli řeší váš problém.
FAQ
Jsou Thunderbit a Kadoa oba agentní?
Ano. Oba využívají AI agenty k pochopení struktury stránky a extrakci dat bez ručního psaní selektorů. Thunderbit používá agentní analýzu pro každou interaktivní relaci na právě otevřené stránce; Kadoa používá agenty k generování a údržbě deterministických extrakčních pipeline pro produkční datasety.
Jak funguje Kadoa Assistant?
Podle oficiálního oznámení Kadoa v přirozeném jazyce popíšete, jaká data potřebujete, Kadoa prozkoumá zdroje a navrhne schéma, sestaví a otestuje deterministickou pipeline a po vašem schválení ji nasadí jako plánovaný, monitorovaný workflow.
Vyžaduje Thunderbit selektory nebo nastavení schématu?
Ne. Na stránce kliknete na One Click Extract a agent automaticky rozpozná pole; Run Now je volitelné, protože extrakce se spustí sama, když nic nekliknete.
Spouští Kadoa LLM extrakci na každé stránce?
Ne nutně. Kadoa rozlišuje mezi agentem generovaným deterministickým kódem (který při každém běhu nepotřebuje LLM volání) a přímou LLM extrakcí. Jejich architektonické vysvětlení to rozebírá podrobněji.
Který nástroj je lepší pro opakované datasety?
Záleží na rozsahu a na požadavcích na governance. Thunderbit podporuje plánovanou extrakci na podporovaných tarifech pro středně opakované úlohy. Kadoa je stavěná pro velké, vícezdrojové, průběžně udržované datasety s observabilitou a compliance kontrolami — její současné positioning míří hlavně na finance a enterprise datové týmy.
Jsou ceny Kadoa veřejné?
V době psaní ne — současné launch stránky Kadoa vedou zájemce ke kontaktu s obchodem nebo k žádosti o test, místo aby uváděly self-serve cenové tarify. Thunderbit má veřejnou stránku s cenami, kterou si můžete rovnou otevřít.
Zvládne některý z nástrojů úplně každý web?
Ne. Oba nástroje fungují nejlépe na kompatibilních, autorizovaných stránkách. Přihlašovací zdi, agresivní anti-bot systémy a velké redesigny webů zůstávají reálnými příčinami selhání jakéhokoli scrapingového nástroje, ať už je agentní nebo ne — tvrzení typu „zvládne všechno“ berte od každého dodavatele s rezervou.




