
Data Miner se už více než deset let tiše drží v mnoha složkách rozšíření v Chromu a pohání malé armády lidí, kteří si vytvořili vlastní knihovnu scrapingových „receptů“. Pořád na něj narážím ve fórech pokaždé, když se někdo ptá, jak stáhnout tabulku z webu bez psaní kódu. Je to legitimní nástroj. Zároveň ale ukazuje, že i „no-code“ může ve skutečnosti znamenat „bez kódu, ale logiku si navrhujete sami“.
Právě na to se lidé ve skutečnosti ptají, když do Googlu zadávají „Thunderbit vs Data Miner“: chci si sám vytvářet znovupoužitelná pravidla, nebo chci agenta, který si stránku vyhodnotí za mě? Pojďme si to opravdu rozebrat vedle sebe — bez obvyklého postupu, kdy článek nejdřív zrecenzuje Data Miner a pak se nenápadně přepne do promo textu na Thunderbit, aniž by je kdy postavil do stejné tabulky.
Thunderbit vs Data Miner na první pohled
Řeknu to rovnou: Thunderbit vedu já, takže tenhle pohled berte s patřičnou rezervou. Snažil jsem se ale tabulku napsat poctivě podle toho, co který nástroj skutečně dělá, ne podle toho, co by vás měly přesvědčit jejich marketingové stránky.
| Kategorie | Data Miner | Thunderbit |
|---|---|---|
| Způsob extrakce | Ruční „recepty“ postavené z CSS/HTML selektorů | Agentická AI — klikněte na One Click Extract, nástroj stránku rozpozná, přečte a sám spustí extrakci |
| První nastavení | Vytvořit soukromý recept, nebo najít/zkusit veřejný | Žádné selektory ani schéma — stačí jeden záměrný klik na podporovaných stránkách |
| Stránkování | Přidat selektor „Next“ do List Recipe | Podporované stránkování je na kompatibilních stránkách řešeno automaticky |
| Obohacení detailními stránkami | Dvoureceptový postup: List Recipe → uložit URL → Detail Recipe → Crawl | Kompatibilní obohacení z podstránek se slije do stejné tabulky |
| Stránky po přihlášení | Funguje s viditelným obsahem v autorizované relaci prohlížeče | Funguje s viditelným obsahem v autorizované relaci prohlížeče |
| Exporty | CSV, Excel, schránka, Google Sheets (placené tarify) | Export do podporovaných cílů (Sheets, Airtable, Notion) i stažení souborů |
| Automatizace | Automatizace prohlížeče, automatizace další stránky, vlastní JS, automatizované crawly | Běh v prohlížeči i cloudu, plánování tam, kde je podporováno, Open API, MCP Server, CLI |
| Znovupoužitelnost | Recepty lze sdílet a znovu používat — obrovská komunitní knihovna | AI každou stránku vyhodnotí znovu; není nutné spravovat knihovnu receptů |
| Cenový model | Měsíční page kredity, odstupňované podle objemu | Tarifní model, viz aktuální ceny |
| Nejlepší využití | Stabilní, opakovaně cílené weby, pro které už existuje funkční recept | Nové nebo proměnlivé stránky, netechnické týmy, rychlé jednorázové úlohy |
Nikdo jiný tyhle dva nástroje vedle sebe takhle nepředstavil. Hledal jsem. Je to zvláštní mezera, když si uvědomíte, jak často se tenhle dotaz vyhledává.
Co je Thunderbit?
Thunderbit je to, čemu říkám agentický web scraper — a to slovo „agentický“ je důležité, protože nejde jen o automatizaci klikání. Nástroj stránku interpretuje podobně jako člověk a pak se rozhodne, jaká data dávají smysl. Nainstalujete si Chrome extension, otevřete stránku, ke které máte oprávnění, a kliknete na One Click Extract. To je opravdu všechno, co je potřeba. Agent stránku přečte, vyhodnotí užitečná pole a začne pracovat — pokud chcete, můžete stisknout Run Now, aby se spustil hned, ale když necháte stránku běžet, rozjede se i sám.

Tuhle věc jsem postavil hlavně proto, že mě unavovalo sledovat, jak netechnické kolegy v předchozích zaměstnáních zablokuje okamžik, kdy po nich scrapingový nástroj chce definovat „selektor“. Většina lidí neví, co je CSS selektor — a upřímně, ani by to vědět nemusela.
Kromě rozšíření existuje i Web App, Open API pro vývojáře, kteří chtějí programový přístup, MCP Server pro workflow s AI agenty (Claude, Cursor a celý ten ekosystém) a CLI pro automatizaci přes terminál. Na kompatibilních stránkách zvládá stránkování i obohacení řádků z detailních stránek a všechno pak sloučí do jedné tabulky.
Co je Data Miner?
Data Miner je starší, zavedenější a postavený na úplně jiné filozofii: recepty. Recept je uložená sada instrukcí — v podstatě selektory namapované na řádky a sloupce — navázaná na konkrétní HTML strukturu webu. Vlastní nápověda Data Mineru vysvětluje, že recepty existují ve třech variantách: veřejné (sdílené jinými uživateli), generické (navržené tak, aby fungovaly napříč řadou webů) a soukromé (ty, které si vytvoříte sami).
Web uvádí více než 50 000 veřejných receptů pokrývajících přes 15 000 populárních webů — zajímavé ale je, že jinde na jejich vlastním webu je uvedeno „60 000“. Řeknu jen „desítky tisíc“ a nechám na vás, jak přesně si ten počet kdo počítá.
Data Miner podporuje Page Scrape, Next Page Automation, URL Crawl (pro scrapování seznamů URL), automatické vyplňování formulářů a pro pokročilé uživatele i vlastní JavaScript. Běží v prohlížeči, takže má přístup k obsahu, který vidíte po přihlášení, stejně jako při ruční práci, a zákazníci Enterprise dostávají i možnost běhu na serveru.
Skutečný rozdíl: porozumění stránce v reálném čase vs. uložené recepty
Tady si myslím, že většina srovnávacích článků začíná být líná. Napíšou něco jako „Data Miner je založený na receptech, Thunderbit na AI“ a nechají to být — bez příkladu, bez vysvětlení, bez něčeho, co si dokážete představit.
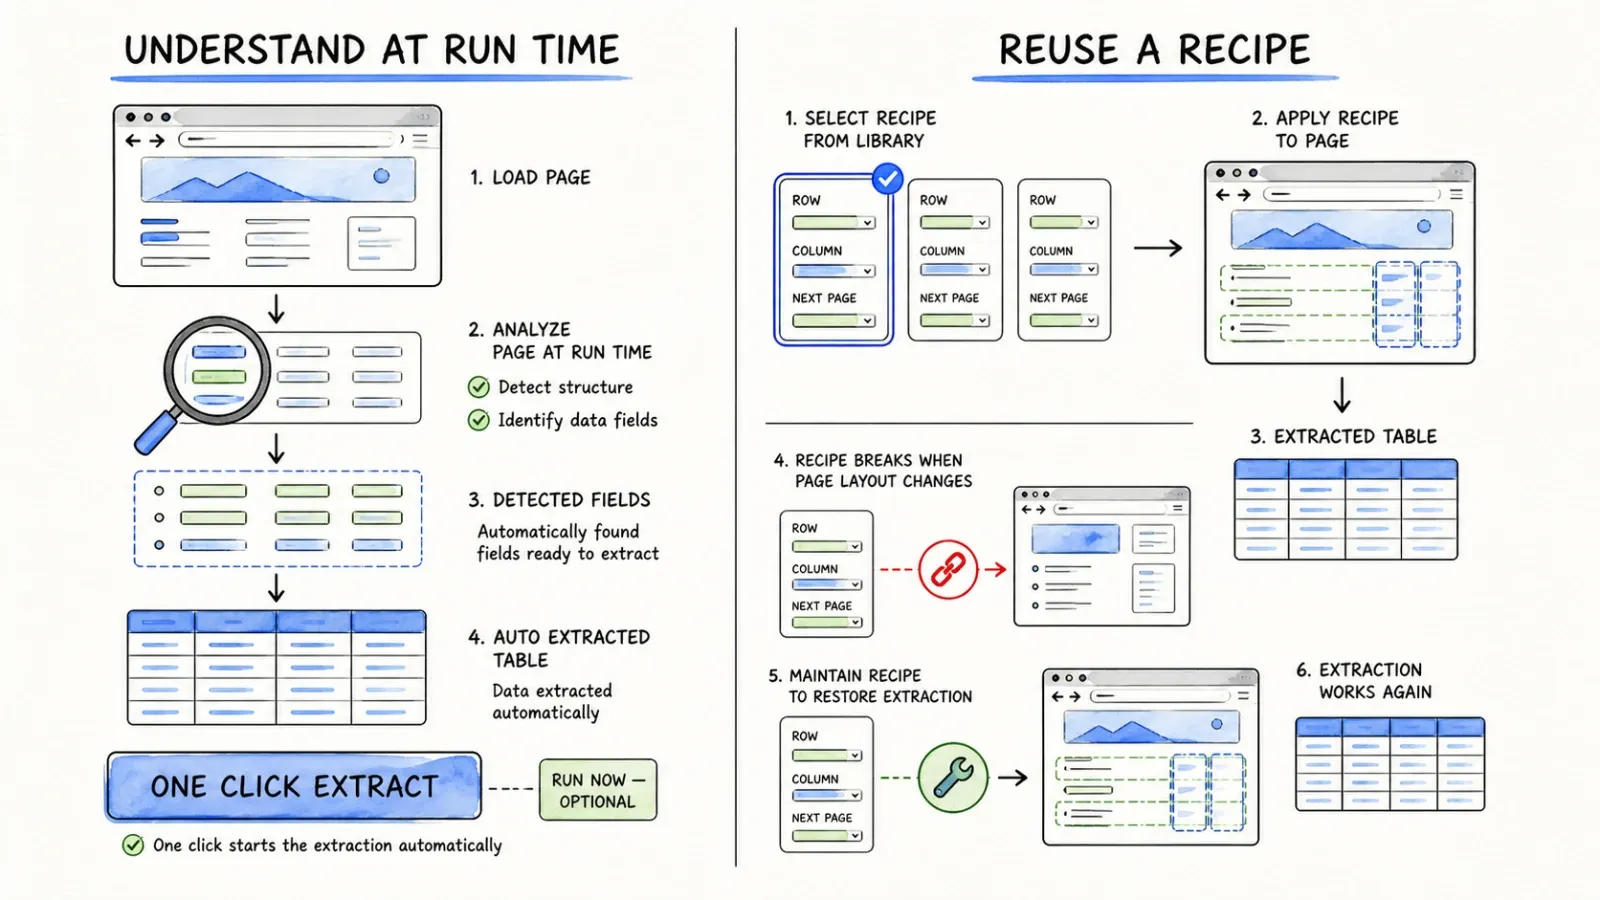
Thunderbit předává interpretaci agentovi. Pokaždé, když otevřete novou stránku, AI se na ni dívá čerstvě. Neprochází uložený manuál pro daný web — čte DOM, chápe strukturu a rozhoduje, která data jsou důležitá. To znamená nulové nastavení na stránce, kterou jste nikdy předtím neviděli, ale zároveň to také znamená, že AI dělá skutečnou práci v reálném čase při každém spuštění, místo aby jen přehrála naučený skript.
Data Miner znovu používá instrukce selektorů. Jakmile recept existuje — ať už jste ho vytvořili vy, nebo někdo jiný — jeho opětovné spuštění je rychlé, protože logika je už pevně daná. Nevýhoda, kterou samy dokumenty Data Mineru přiznávají, je, že když se HTML webu změní, recept se může rozbít. Místo scrapování pak ladíte selektory.
Kdy může být jeden nebo druhý „na jeden klik“: Data Miner může být skutečně na jeden klik — pokud už existuje veřejný recept přesně pro váš cíl a pořád funguje. Jenže to je velké „pokud“. Nárok Thunderbitu na one-click platí pro stránky, které agent dokáže správně interpretovat; také to není záruka pro každý web na internetu, zejména ne pro ty s agresivní ochranou proti botům nebo neobvyklým rozložením.
Ani jeden nástroj nemá monopol na to, co je „jednoduché“. Jen to definují jinak — jeden pomocí komunitou vytvořených zkratek, druhý pomocí interpretace v reálném čase.
Praktické srovnání workflow
Scraping jednoduché tabulky: S Data Minerem zkontrolujete, jestli pro web existuje veřejný recept, zobrazíte si jeho náhled a spustíte extrakci, pokud sedí. Když ne, ručně vytvoříte řádky a sloupce pomocí Easy Finderu. S Thunderbitem kliknete na One Click Extract a necháte nástroj, aby si strukturu tabulky rozpoznal sám.
Stránkování produktového seznamu nebo adresáře: Data Miner vyžaduje, abyste do List Recipe přidali navigační selektor, aby věděl, jak vypadá „Next“. Thunderbit u podporovaných stránek zvládá kompatibilní stránkování automaticky, bez tohoto ručního kroku.
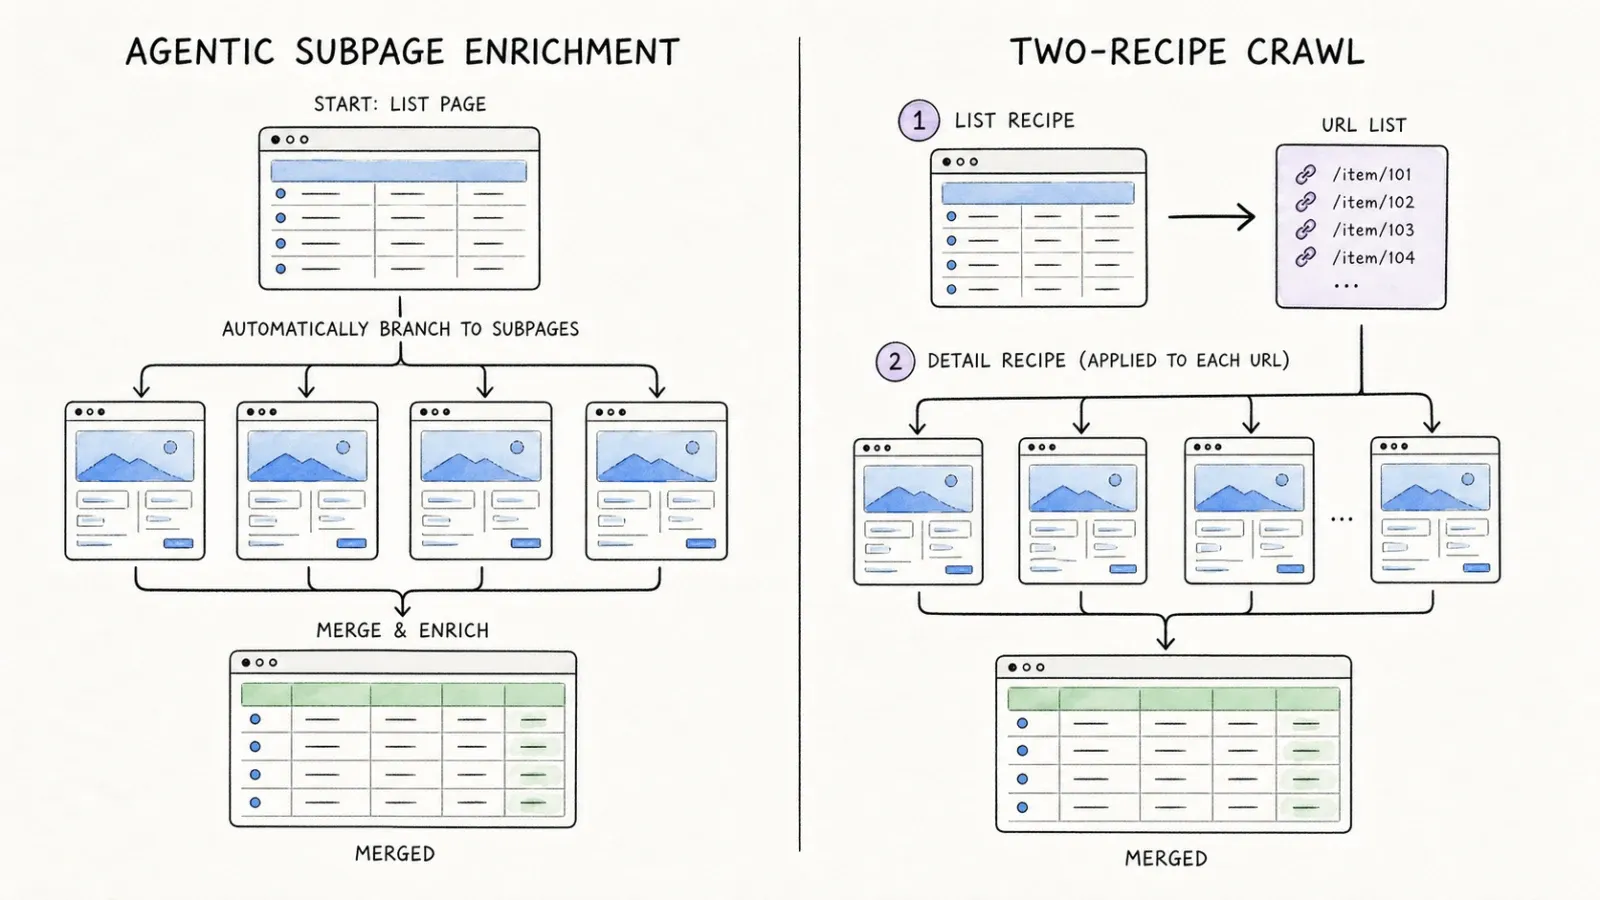
Obohacení řádků ze seznamu o data z detailních stránek: Tady se workflow rozchází nejvíc. Dokumentace Data Mineru k Crawl popisuje opravdu vícekrokový proces: vytvořit List Recipe pro sběr URL detailních stránek, uložit tento seznam URL, vytvořit samostatný Detail Recipe, založit Crawl job propojující obě části, zvalidovat URL, spustit to a pak exportovat. Funguje to, ale je to několik samostatných kroků a dvě oddělené receptury. Kompatibilní obohacení podstránek v Thunderbitu slije data z detailních stránek do stejné tabulky, bez toho tance kolem dvojice receptů — i když férově přiznávám, že to spolehlivě funguje jen na stránkách, které agent umí dobře zpracovat.
Práce za přihlášením: Oba nástroje pracují s obsahem viditelným ve vaší relaci prohlížeče, takže pokud jste přihlášeni do autorizovaného účtu, oba vidí to, co vidíte vy. Ani jeden nějak magicky neobchází autentizaci — oba jen pracují s tím, co je vykreslené na obrazovce.
Automatizace, rozšíření a přístup pro vývojáře
Automatizace Data Mineru žije v prohlížeči: automatizace další stránky, automatizované URL crawly a vlastní JavaScript pro lidi, kteří si umí napsat vlastní skripty. Integrace do Google Sheets je v placených tarifech. Zákazníci Enterprise mohou spouštění přesunout na servery Data Mineru místo toho, aby všechno běželo lokálně na klientovi.
Thunderbit jde širším směrem. Kromě běhu v prohlížeči a cloudu s plánováním tam, kde je to podporováno, nabízí Open API pro backend integrace a MCP Server — což je důležitější, než to na první pohled vypadá. MCP umožňuje AI agentům (Claude Code, Cursor a podobné nástroje) volat Thunderbit přímo jako součást vlastního workflow. Pokud stavíte něco, kde AI agent potřebuje jako jeden krok ve větším pipeline načíst strukturovaná webová data, je to výrazně jiná schopnost než „napsal jsem si v rozšíření pár vlastních JavaScriptů“.
Aby bylo jasno: vlastní JS v Data Mineru je pro power users, kteří chtějí jemné ladění, opravdu užitečný. Jen to není stejná kategorie nástroje jako veřejné API nebo MCP server, který mohou volat agenti.
Export, soukromí a práce s daty
Data Miner exportuje do CSV, Excelu, schránky nebo Google Sheets v placených tarifech. Jejich cenové FAQ uvádí, že scraped data neprodávají ani nesdílí, a dokumentace k browser-run crawl uvádí, že při standardních automatizovaných crawlech se data neukládají na servery Data Mineru — po dokončení úlohy si je máte uložit sami. Server-side úlohy pro Enterprise jsou už jiný model spouštění.
Thunderbit exportuje do podporovaných cílů, jako jsou Google Sheets, Airtable a Notion, a také nabízí běžné stažení souborů. Podle pracovního postupu můžete využít běh v prohlížeči i v cloudu.
Nechci tvrdit, že jedna architektura je univerzálně „soukromější“ než druhá — opravdu záleží na tom, co scrapujete, jak citlivá ta data jsou a jaký režim spouštění zvolíte. Pokud je pro váš případ důležitá citlivost dat, je to téma, které byste měli s vybraným dodavatelem řešit předem, ne něco, co můžete brát jako samozřejmost z článku typu srovnání.
Ceny: limity stránek a náklady na recepty
Tady jsou aktuální ceny Data Mineru k okamžiku psaní:
| Tarif | Cena | Stránek/měsíc |
|---|---|---|
| Free | $0 | 500 (některé domény omezené) |
| Solo | $19.99/měsíc | 500 |
| Small Business | $49/měsíc | 1 000 |
| Business | $99/měsíc | 4 000 |
| Business Plus | $200/měsíc | 9 000 |
| Enterprise | Individuálně | Individuálně |
Kredity se obnovují měsíčně a nepřevádějí se dál — a jejich vlastní FAQ uvádí, že překročení bezplatného limitu 500 stránek může účet zdarma zablokovat, dokud nepřejdete na vyšší tarif. To je dobré vědět dřív, než budete v půlce projektu.
Co při recenzích Data Mineru téměř nikdo nezmiňuje: prodávají také vývoj vlastních receptů jako placenou službu. Jeden vlastní recept vyjde na 150 dolarů jednorázově; vícekrokový recept (typicky pro crawl od seznamu k detailu) stojí 300 dolarů jednorázově; cokoliv složitějšího se naceňuje individuálně. Pokud pro váš cílový web neexistuje funkční veřejný recept a sami ho nechcete stavět, je to reálný náklad navíc k předplatnému.
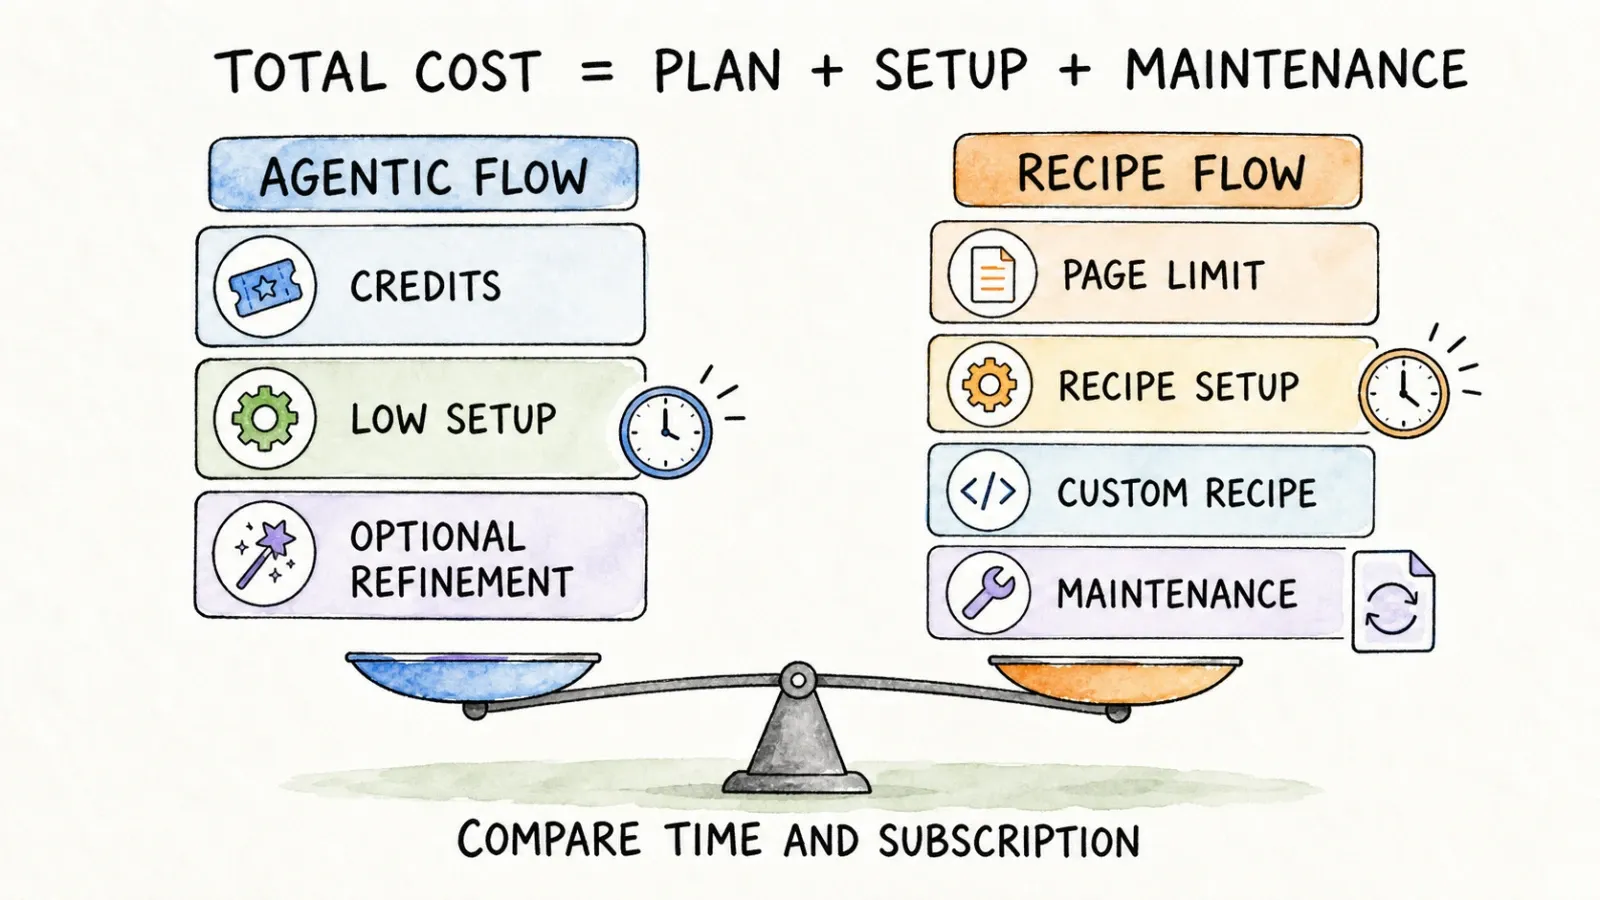
U aktuálních cen Thunderbitu se raději podívejte na živou cenovou stránku, než abyste věřili číslům, která bych tu citoval — plány se mění a raději vás pošlu ke zdroji, než aby čísla zastarala.
Upřímně ale největší náklad není cenovka tarifu. Je to čas. Stavba a údržba receptů stojí hodiny, za které vám nikdo nezaplatí, pokud nepočítáte vlastní mzdu. Agentické opětovné vyhodnocení tento náklad na údržbu eliminuje, ale znamená, že AI při každém běhu znovu pracuje od nuly — což je jiný typ nákladu (výpočetní výkon, ne váš odpolední čas).
Který nástroj si vybrat?
Zvolte Thunderbit, pokud... nejste technický typ, pracujete se stránkou, kterou jste ještě nikdy nescrapovali, nebo nechcete vůbec řešit hledání či tvorbu receptu. Hodí se pro sales ops, kteří tahají lead listy z adresářů, market research týmy sledující jednou týdně ceny konkurence, i pro kohokoliv, kdo prostě chce data hned bez nastavování.
Zvolte Data Miner, pokud... máte opakující se, stabilní cíl, pro který už existuje funkční veřejný recept, nebo pokud patříte mezi lidi, kteří opravdu rádi pracují s detailní kontrolou selektorů a nevadí jim recept přestavět, když web změní design. Sedne i power users, kteří umí a chtějí používat vlastní JavaScript.
Použijte oba, pokud... máte mix situací — některé starší úlohy na webech, kde už máte funkční recepty v Data Mineru (není důvod je přepisovat), a nové, různorodé cíle, u kterých se vám nechce trávit odpoledne definováním selektorů. Mluvil jsem s týmy, které to přesně takhle dělají: staré recepty nechávají běžet a Thunderbit zkoušejí na všechno nové. Není to rozhodnutí „buď, anebo“, i když to mnoho článků typu „vs“ tak prezentuje.
Závěrečný verdikt
Ve skutečnosti jde o rozdíl mezi agentickou interpretací a znovupoužitelnými recepty — a ani jeden přístup není objektivně lepší ve všech situacích. Data Miner odměňuje trpělivost a investici do konkrétního webu opravdu rychlým opakovaným spuštěním. Thunderbit odměňuje rychlost k prvnímu výsledku za cenu toho, že si web nikdy úplně „nepamatuje“ tak, jak to umí recept.
Moje upřímná rada: vyberte si jeden autorizovaný cíl, ze kterého opravdu potřebujete data, a vyzkoušejte oba nástroje. Změřte, jak dlouho trvá nastavení, spočítejte, kolik použitelných řádků projde čistě, podívejte se, co se stane, když web něco změní (recepty se rozbijí, agenti se obvykle přizpůsobí), a sečtěte skutečné náklady včetně případných poplatků za vlastní recepty.
Pokud chcete vidět, jak vypadá varianta na jeden klik v praxi, rozšíření Thunderbit pro Chrome si můžete zdarma vyzkoušet — bez nutnosti cokoliv stavět z receptů.
Často kladené otázky
Je Data Miner opravdu na jeden klik? Může být, pokud už pro váš cílový web existuje funkční veřejný recept. Pokud ne, vytváříte ho od nuly v jejich Recipe Creatoru, což zabere reálný čas na nastavení.
Vyžaduje Data Miner programování? Ne u základních receptů — Easy Finder umožňuje kliknutím vybírat řádky a sloupce. Vlastní JavaScript a pokročilá práce se selektory jsou volitelné pro power users, kteří chtějí větší kontrolu.
Umí Data Miner scrapovat více stránek a detailní stránky? Ano, přes Next Page Automation pro stránkování a dvoureceptový Crawl workflow (List Recipe + Detail Recipe) pro získávání dat z navázaných detailních stránek.
Používá Thunderbit CSS selektory? Ne. Agent vyhodnocuje strukturu stránky za běhu, takže na podporovaných stránkách není nutné ručně definovat selektory.
Který nástroj funguje lépe po přihlášení? Oba pracují s obsahem viditelným ve vaší autorizované relaci prohlížeče, takže výsledky závisí spíš na tom, co je na stránce vykreslené, než na tom, který nástroj používáte.
Jak Data Miner počítá stránky? Každý tarif přiděluje měsíční limit page kreditů — 500 u Free a Solo, až 9 000 u Business Plus. Kredity se obnovují každý měsíc a nepřevádějí se dál.
Nabízí některý z produktů API? Thunderbit má Open API, MCP Server a CLI pro vývojářské a agentní workflow. Automatizace Data Mineru je primárně založená na prohlížeči, přičemž Enterprise zákazníci mají k dispozici i serverové možnosti.
Funguje některý z těchto scraperů na každém webu? Ne. Oba nástroje závisí na kompatibilitě stránky, oprávnění a struktuře webu — ochrana proti botům, neobvyklé rozložení nebo silné JavaScriptové renderování mohou omezit oba.




