
Před pár týdny mi někdo z týmu poslal odkaz na GitHub issue thread, kde jeden vývojář v pátek ve 23:00 ladil už třetí pokus logiky PlaywrightCrawler. Hned pod tím někdo jiný napsal: „prostě na to použij Thunderbit“ a autor vlákna odpověděl: „to není pointa, potřebuju to dostat do pipeline.“ Oba měli pravdu. Přesně v tom se dá shrnout celá debata Thunderbit vs Crawlee v jednom GitHub vlákně.
Strávil jsem dost let střídáním SaaS a automatizačních nástrojů (zdravím dobu u Automation Anywhere), takže vím, že otázka „který scraper je lepší“ je skoro vždycky špatně položená. Správná otázka zní: kdo vlastně data sbírá a co s nimi potřebuje dál? Pojďme na to.
Skutečná otázka není „který nástroj je lepší“ — ale „kdo data sbírá?“
Tady je věc, která lidi mate pokaždé, když si vygooglí „Crawlee vs [cokoliv]“: čekají souboj funkcí krok za krokem, jako když porovnávají dva kávovary. Jenže Crawlee a Thunderbit nesoutěží o stejnou práci. Jsou postavené pro dva úplně odlišné typy lidí, kteří řeší dva úplně odlišné problémy.
Crawlee je open-source knihovna pro crawling od týmu Apify a předpokládá, že jste vývojář, který si rozumí s JavaScriptem, TypeScriptem nebo Pythonem. Nainstalujete ji, napíšete request handlery, definujete selektory a nasadíte kód. Thunderbit předpokládá něco úplně jiného: že jste člověk ze sales, marketingu nebo ops týmu, který potřebuje ze stránky vytáhnout strukturovaná data hned teď a nemá nejmenší chuť sahat do terminálu.
| Faktor | Crawlee | Thunderbit |
|---|---|---|
| Pro koho je určený | Vývojáři budující vlastní crawlery | Netechničtí uživatelé, ops/sales/marketing týmy |
| Co je potřeba k nastavení | Nainstalovat Node.js nebo Python, napsat scraper kód | Nainstalovat rozšíření do prohlížeče, kliknout na One Click Extract |
| Je potřeba kódování | Ano (JS/TS nebo Python) | Ne |
| Nejlepší použití | Produkční pipeline, vlastní logika | Ad hoc nebo opakovaný strukturovaný sběr dat ze stránky |
Zmiňuju to hned na začátku, protože většina srovnávacích článků tenhle rozcestník úplně přeskočí, a přitom právě on rozhoduje, který nástroj má vůbec smysl hodnotit. Pokud jste vývojář, který potřebuje detailní kontrolu nad retry, proxy a browser pooly, žádné jedním klikem pohodlné řešení vás neuspokojí. A pokud nejste vývojář, flexibilita Crawlee vám bude stejně k ničemu — prostě ho nepoužijete.
Co je Thunderbit?
Thunderbit je to, čemu bych řekl agentic web scraper — tedy nástroj, kde AI vrstva udělá interpretační práci: rozpozná, co je na stránce důležité a co se má vytáhnout, místo toho, abyste ručně psali selektory. Základní workflow v Thunderbit Chrome Extension vypadá takto: otevřete stránku, ze které chcete data, kliknete na One Click Extract, agent stránku přečte a analyzuje, vybere užitečná pole a připraví běh. Objeví se tlačítko Run Now, takže to můžete spustit okamžitě, ale není povinné — když nic neuděláte, extrakce se spustí automaticky.

A to je opravdu celé nastavení. Žádné skládání schématu ani ruční mapování polí: agent stránku analyzuje a extrakce se spustí sama.
Kromě rozšíření do prohlížeče má Thunderbit také Web App, Open API pro programový přístup, MCP Server pro použití AI agenty a CLI pro workflow v terminálu. Právě tahle poslední věc je důležitější, než si lidé často myslí — vrátím se k ní později, protože díky ní tenhle článek není jen o tom, že „no-code vyhrává“.
Na kompatibilních stránkách umí Thunderbit také zvládnout stránkování a obohacování podstránek a jakmile data máte, můžete je exportovat do tabulek nebo jiných podporovaných destinací. Jen dodám stejnou výhradu jako u všeho, co říká „AI čte stránku“: funguje to dobře na kompatibilních, autorizovaných stránkách a neznamená to, že se každá JavaScriptová frameworková stránka nebo anti-bot bariéra na internetu podřídí vaší vůli.
Co je Crawlee?
Crawlee je open-source knihovna — ne hostovaný produkt — pro tvorbu web crawlerů a scraperů v JavaScriptu/TypeScriptu nebo Pythonu. Spravuje ji Apify a chci to říct přesně, protože si to hodně lidí plete: Crawlee je knihovna, Apify je samostatná, i když související cloudová platforma, která může projekty postavené na Crawlee hostovat a provozovat. Jsou to příbuzné věci, ne totéž.
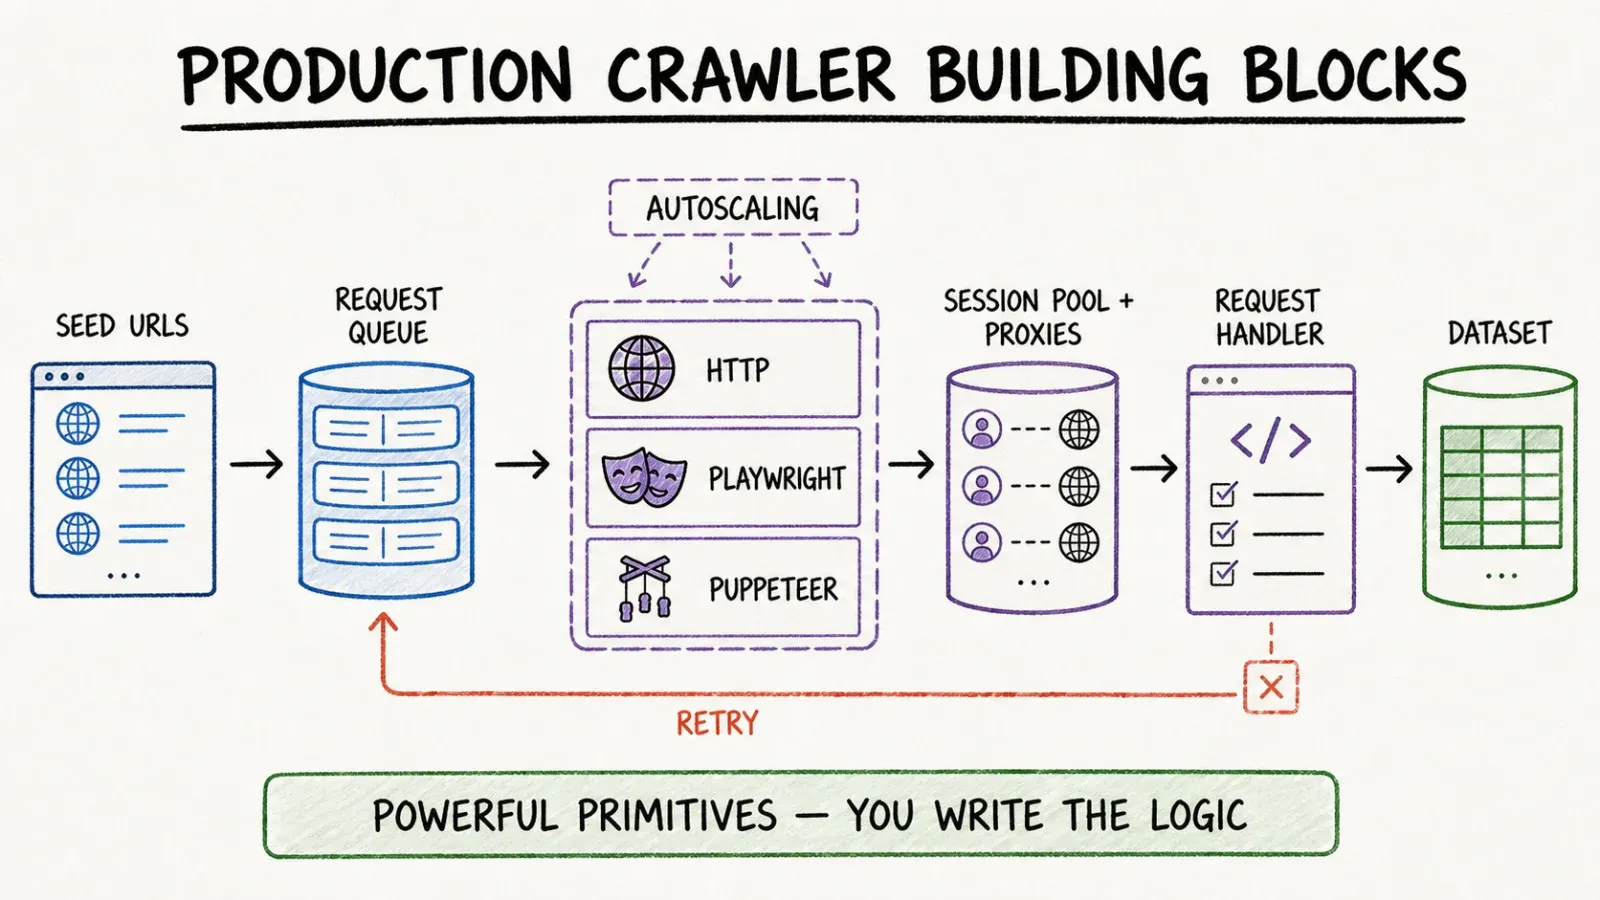
To, co s Crawlee ve skutečnosti dostanete, je sada nástrojů. Nabízí HTTP crawlery pro lehčí scraping bez velkého JavaScriptu a zároveň browser crawlery postavené na Playwrightu a Puppeteeru pro weby, které potřebují skutečné renderování. Umí request queue, takže nemusíte ručně hlídat, které URL už jste navštívili. Spravuje úložiště pro data, která vytahujete. A má zabudované autoscaling i session pooly, takže když crawlíte tisíce stránek, nemusíte znovu vymýšlet logiku pro paralelizaci od nuly.
Nic z toho ale nefunguje tak, že byste jen klikli na tlačítko. Píšete kód — definujete request handlery, nastavíte instanci crawleru a určíte, co má dělat při načtení stránky. Crawlee vám dá konstrukci, ale dům si pořád stavíte sami.
Hlavní rozdíl: spravovaný produkt pro extrakci vs. kódová knihovna
Čas do první strukturované tabulky
Tady je ten rozdíl nejviditelnější. S Thunderbit, od otevření stránky k použitelné datové tabulce, jste na kompatibilní stránce během několika vteřin až minut — klik, agent detekuje a spustí, hotovo.
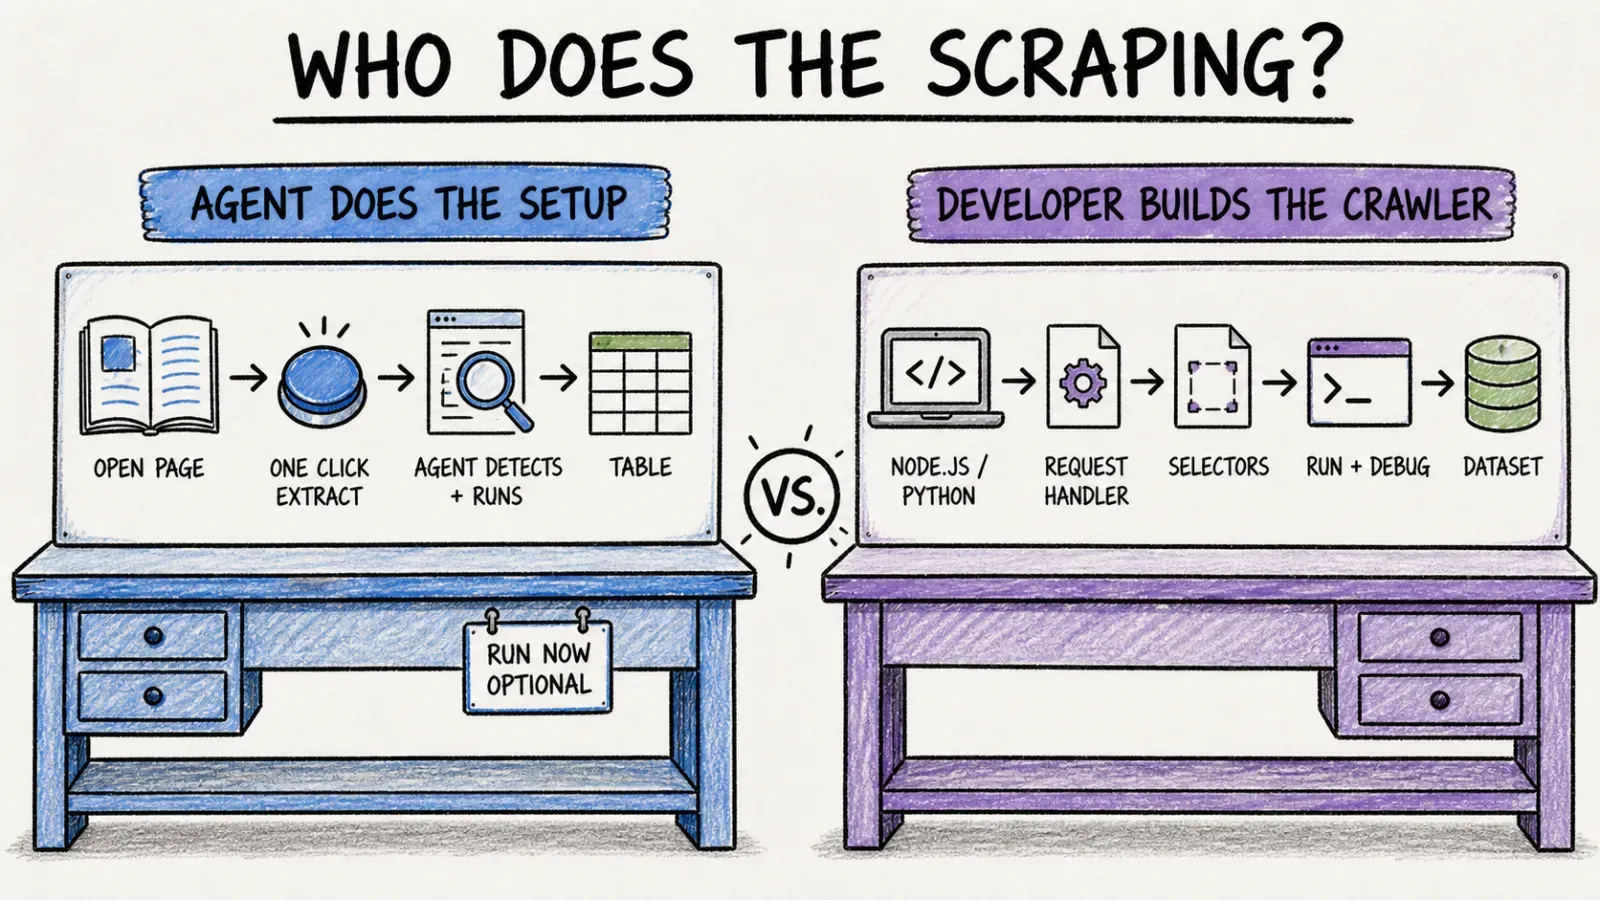
S Crawlee vám i jednoduchý první crawler vezme reálný čas na nastavení. Potřebujete nainstalovaný Node.js nebo Python, přidaný balíček Crawlee, napsaný request handler, vybrané selektory (ručně podle inspekce stránky) a pak to spustit a ladit, co se pokazilo. U někoho, kdo to dělá poprvé, bych odhadl zhruba 30–60 minut jen na to, aby vznikla jedna funkční extrakce — a to za předpokladu, že už umí aspoň trochu JavaScript nebo Python.
Míra kontroly nad logikou browseru/crawleru
Tady Crawlee vyhrává bez debat. Máte pod kontrolou všechno: jaký browser engine použít, jak se mají spravovat session, jak se mají rotovat proxy, co se stane při neúspěšném requestu, jak hluboko má crawler prohledávat odkazy a jak má omezovat concurrency. Pokud vaše crawl úloha potřebuje vlastní logiku — třeba přihlášení přes vícekrokový flow nebo web s divným stránkováním, které rozbíjí běžné vzory — Crawlee vám dává stavební bloky přesně na tohle.
Thunderbit naopak obětuje část téhle granularity ve prospěch rychlosti a dostupnosti. Logiku nepíšete vy; AI ji odvozuje z toho, co na stránce vidí. To je skvělé, když to funguje, a méně užitečné, když potřebujete vynutit velmi specifický a ne zcela zřejmý pattern extrakce.
Nasazení a správa provozu
U Crawlee nesete odpovědnost za nasazení. To znamená hosting (na vlastních serverech, nebo na platformě Apify, nebo kdekoliv jinde), řešení změn HTML struktury, které rozbijí selektory, a aktualizace závislostí. Je to reálná průběžná práce, ale zároveň i reálná průběžná kontrola.
Thunderbit běží na spravované infrastruktuře — rozšíření v prohlížeči pracuje lokálně ve vaší relaci, nebo v cloudu pro plánované úlohy, a aktualizace extrakční logiky řeší Thunderbit na své straně, ne vy.
Praktické scénáře
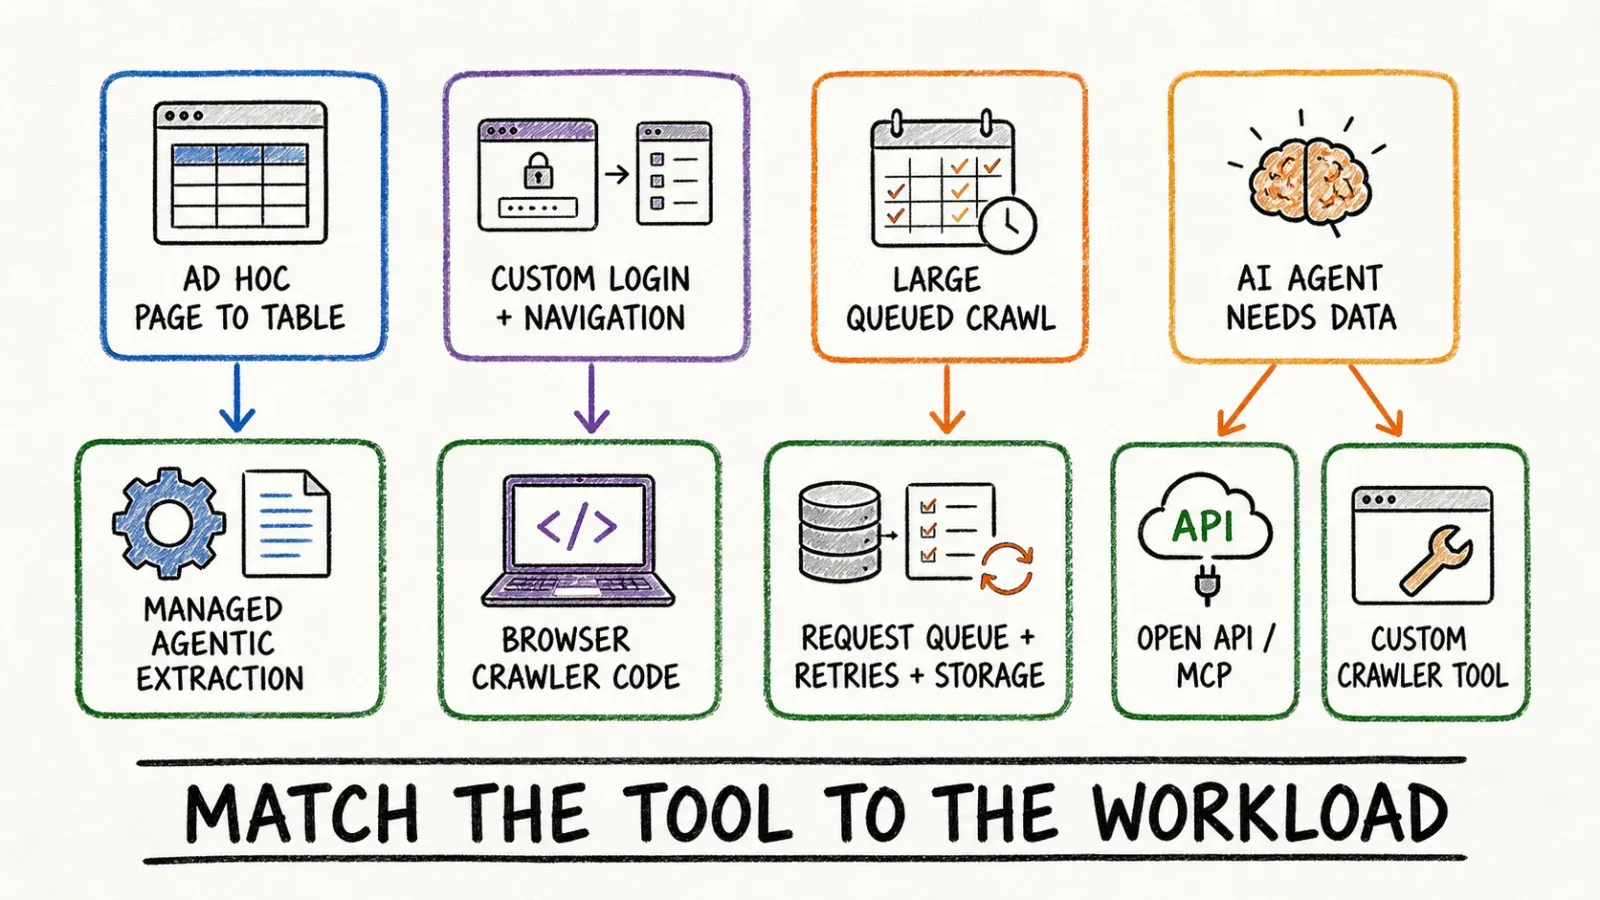
Jednorázová extrakce stránky
Řekněme, že potřebujete dostat listing produktů konkurence do tabulky ještě před dvouhodinovou schůzkou. Thunderbit je na tohle dělaný přesně — otevřít stránku, kliknout na One Click Extract, exportovat. Crawlee je pro skutečně jednorázový úkol zbytečně robustní; strávili byste víc času psaním skriptu, než kolik byste ušetřili.
Vlastní crawl přes Playwright/Puppeteer
A teď si představte, že stavíte monitoring pipeline, která se musí přihlásit do autentizovaného dashboardu, projít tři úrovně hluboko a vytáhnout data ze stránky, kde se všechno renderuje přes JS framework s neobvyklým časováním DOM. Tohle je doména Crawlee. PlaywrightCrawler vám dává browser automation stavební prvky přesně pro takovou vlastní navigační logiku.
Velký frontovaný crawl s retry a úložištěm
Když crawlíte desítky tisíc URL a potřebujete automatické retry, perzistentní request queue a strukturovaný výstup do úložiště, jsou vestavěná request queue a dataset abstrakce v Crawlee navržené přesně pro tenhle rozsah. Tohle už není případ pro Thunderbit v podobě browser extension — to je nástroj na jednu stránku po druhé (nebo kompatibilní podstránky), ne systém na správu fronty.
Volání extrakce z AI agenta
Tohle je scénář, který lidé v těchto srovnáních nejčastěji chápou špatně. Vývojáři, kteří staví AI-agent workflow, někdy předpokládají, že „AI agent potřebuje data“ automaticky znamená „napsat vlastní Crawlee kód a zabalit ho jako nástroj“. To je jedna správná cesta. Ale Thunderbit má MCP Server právě proto, aby hostitel AI — Claude, Cursor a další kompatibilní klienti — mohl Thunderbit extraction capability volat jako nástroj, aniž by kdokoliv psal vlastní crawler. Je to opravdu jiná vrstva než jednorázové browser workflow a vyžaduje konfiguraci, ne jen „klik a hotovo“. Ale pořád to není totéž úsilí jako stavět nástroj na Crawlee od nuly.
Dynamické weby, škálování a spolehlivost
Tady budu opatrný, protože právě v této oblasti marketingové texty (včetně těch mých z minulosti) často přehánějí. Browser crawlery v Crawlee umí spouštět JavaScript, čekat na dynamický obsah a pracovat se stránkami podobně jako skutečný uživatel — to je pro render-heavy weby opravdu užitečné. Thunderbitovo rozšíření v prohlížeči také běží v reálném browserovém kontextu a umí pracovat s JS-renderovanými stránkami, které máte otevřené.
Ale ani jeden nástroj negarantuje úspěch všude. Crawlee dává vývojářům nástroje, aby si sami nastavili rotaci proxy a session pooly — je to ruční, laditelná kontrola, ne automatický bypass. Thunderbit používá spravované renderování a anti-bot handling na podporovaných, autorizovaných stránkách, což opět není univerzální tvrzení „funguje to na všem“. Pokud někde čtete srovnání, které slibuje 100% úspěšnost proti všem anti-bot systémům na internetu, tak vás to srovnání prostě klame.
Cena, licence a celkové náklady
Samotné Crawlee je zdarma a open-source — například Python verze je vydaná pod Apache License 2.0. Jenže „zdarma“ neznamená „bez nákladů“. Platíte časem vývojáře, který crawlery píše a udržuje, hostingem (na vlastních serverech nebo na platformě Apify, což je samostatný placený produkt odlišný od samotné knihovny) a případně i proxy službami, pokud cílové weby vyžadují rotaci IP adres, aby vás neblokovaly.
Thunderbit funguje na předplatném / plánovém modelu s kreditovým využitím — doporučil bych se podívat přímo na stránku Thunderbit Pricing, protože čísla se mohou měnit a nehodlám sem psát konkrétní částku, která může být za pár týdnů zastaralá.
Upřímné srovnání údržby: crawlery v Crawlee se rozbijí, když cílový web změní HTML strukturu, protože selektory byly napsané proti konkrétnímu DOMu. Někdo si toho musí všimnout a opravit kód. Agentic extrakce v Thunderbitu při každém běhu stránku znovu analyzuje, což snižuje, ne však úplně odstraňuje, tento typ rozbití — větší změna layoutu na cílovém webu může stále způsobit problémy, ale neudržujete hardcoded selektory stejným způsobem.
Kdo by měl zvolit Thunderbit?
Pokud nejste vývojář a potřebujete ze stránek dostat strukturovaná data — třeba seznam leadů, ceny konkurence, market research nebo cokoliv podobného — Thunderbit je dělaný přesně pro vás. Totéž platí, pokud jste vývojář, který chce dát self-service extrakční nástroj netechnickému týmu, nebo pokud chcete programový přístup přes Open API bez toho, abyste psali celý crawler od nuly.
Kdo by měl zvolit Crawlee?
Pokud stavíte produkční datovou pipeline, která potřebuje vlastní navigační logiku, jemně řízené retry a proxy chování, a chcete vlastnit zdrojový kód od začátku do konce, Crawlee je správný základ. Je to také lepší volba, pokud váš crawl musí běžet v opravdovém měřítku — desítky tisíc stránek s řízením request queue — což není typ problému, který má browser-extension workflow řešit.
Mohou týmy používat obojí?
Realisticky ano, a nepovažuju to za vyhýbavou odpověď. Tuhle praxi jsem viděl v řadě firem, se kterými jsem pracoval: engineering vlastní Crawlee pipeline pro opakované, velké a strukturované crawl úlohy, které plní datový sklad, zatímco sales, marketing nebo ops týmy používají Thunderbit browser extension nebo Web App pro ad-hoc „potřebuju data z téhle jedné stránky hned teď“ úkoly, které by jinak skončily jako ticket v engineering backlogu. Neexistuje žádná oficiální integrace, která by tyhle dva světy spojovala — nic si nevymýšlím — ale z architektonického hlediska řeší sousedící problémy dost dobře na to, aby v mnoha firmách běžely oba nástroje vedle sebe.
Verdikt
Pokud jste vývojář a stavíte něco, co má žít v kódu, škálovat na tisíce stránek nebo zvládat opravdu vlastní navigační logiku, Crawlee vám dává kontrolu, kterou potřebujete — za cenu vašeho času a průběžné údržby. Pokud jste někdo jiný a potřebujete dostat data z webové stránky bez psaní kódu, nebo vývojář, který chce zpřístupnit extrakci AI agentovi bez stavby crawleru od nuly, Thunderbit je rychlejší cesta. Ani jeden nástroj není „lepší“ obecně. Řeší jiné problémy pro jiné lidi a jediná skutečná chyba je vybrat si špatný nástroj pro vaši situaci.
FAQ
Je Crawlee totéž co Apify? Ne. Crawlee je open-source knihovna pro crawling, kterou spravuje tým Apify. Apify je samostatná cloudová platforma, která umí hostovat a provozovat projekty postavené na Crawlee, a také nabízí další služby jako proxy a plánování. Jsou sice propojené, ale jde o odlišné produkty s různými cenovými modely.
Je Crawlee zdarma? Samotná knihovna je zdarma a open-source (Python verze používá Apache License 2.0). Skutečné náklady přicházejí z času vývojářů, hostingové infrastruktury a případných proxy služeb — ne z licenčního poplatku.
Podporuje Thunderbit API a MCP přístup pro vývojáře? Ano. Kromě browser extension nabízí Thunderbit Open API pro programový přístup a MCP Server, který kompatibilním AI hostům umožňuje volat extrakční nástroje Thunderbitu přímo.
Co je jednodušší pro někoho bez programátorského backgroundu? Thunderbit, bez debat. Workflow One Click Extract v browser extension nevyžaduje žádný kód, žádné psaní selektorů ani nastavování schématu. Crawlee od začátku předpokládá znalost JavaScriptu/TypeScriptu nebo Pythonu.
Který nástroj dává větší kontrolu nad chováním crawleru, třeba nad retry a proxy? Crawlee, a to výrazně. Vystavuje session pooly, rotaci proxy, správu request queue a retry logiku jako konfigurovatelné stavební prvky pro vývojáře. Thunderbit tohle spravuje na své straně a za jednoduchost a rychlost tak obětuje manuální kontrolu.




