
Už jsem byl v dost Slack vláknech mezi inženýry, abych věděl, jak tahle otázka obvykle začíná: někdo pošle odkaz na seznam „nejlepších web scraperů“ a tři vývojáři hned odpoví: „a kde je Colly?“ Není to náhoda. Prošel jsem si čtyři články, které se aktuálně umisťují na „Thunderbit vs Colly“, a všechny porovnávají Thunderbit jen s jinými no-code nástroji — Crawl4AI, Browse AI, rtrvr.ai, Chat4Data. Colly se neobjevil ani jednou.
Což je docela zvláštní, protože Colly má skutečně silnou a věrnou komunitu na r/golang i ve firmách, které staví rychlé crawlery v Go a chtějí mít kód plně pod kontrolou. Tohle je tedy článek, který tu otázku opravdu zodpoví — ne jen recyklované „porovnání AI nástrojů“ s přilepeným názvem Colly.
Rychlá odpověď
Tady je stručná verze, pokud čtete mezi schůzkami: Thunderbit je spravovaný agentický web scraper, který spustíte na kliknutí — bez selectorů, bez kódu, s běháním v prohlížeči nebo v cloudu, navíc s Web App, Open API, MCP Serverem a CLI pro chvíle, kdy vývojáři chtějí programový přístup. Colly je open-source Go framework — crawler si napíšete sami, vlastníte logiku a ručně řídíte concurrency.
Ve skutečnosti to nejsou klasickými konkurenty. Jedno je produkt. Druhé je knihovna. Přímé srovnání dává smysl jen tehdy, když stojíte na rozcestí a řešíte, která cesta sedí vaší situaci — a přesně s tím vám chci pomoct.
Přehled na první pohled
| Oblast | Thunderbit | Colly |
|---|---|---|
| Hlavní uživatel | Obchodní uživatelé, ops týmy, vývojáři, kteří chtějí rychlost | Go vývojáři |
| Nastavení | Na stránce klikněte na One Click Extract | go get github.com/gocolly/colly + napsat Go kód |
| Čas do prvního výsledku | Sekundy až minuty, agent se spustí sám | Záleží na tom, jak rychle napíšete callbacky |
| Jazyk | Pro použití v prohlížeči není potřeba | Go |
| Model crawlování | Agentické vyhodnocení stránky, podporuje stránkování i podstránky | Ruční Collector + OnHTML/OnResponse callbacky |
| Renderování | Spravovaný prohlížeč / cloud execution | Primárně HTTP/HTML; weby s hodně JS často potřebují další nástroje |
| Pravidla extrakce | Agent navrhne pole, uživatel je může upravit | Vývojář píše CSS selektory ručně |
| Concurrency | Řídí platforma | Plná ruční kontrola přes gorutiny |
| Ukládání/export | Export do tabulek, Sheets a dalších podporovaných cílů | Dle vlastního řešení vývojáře (soubory, databáze, Redis atd.) |
| Nasazení | Rozšíření do prohlížeče, Web App, API, MCP, CLI | Vlastní Go binary/script |
| Údržba | Spravovaná extrakční logika; stále závisí na kompatibilitě webu | Vývojář opravuje selektory, když se web změní |
| Licence/náklady | Plány založené na kreditech (aktuální tarify ověřte na cenách) | Apache-2.0, zdarma — ale infrastruktura i čas vývojářů zdarma nejsou |
Co je Thunderbit?
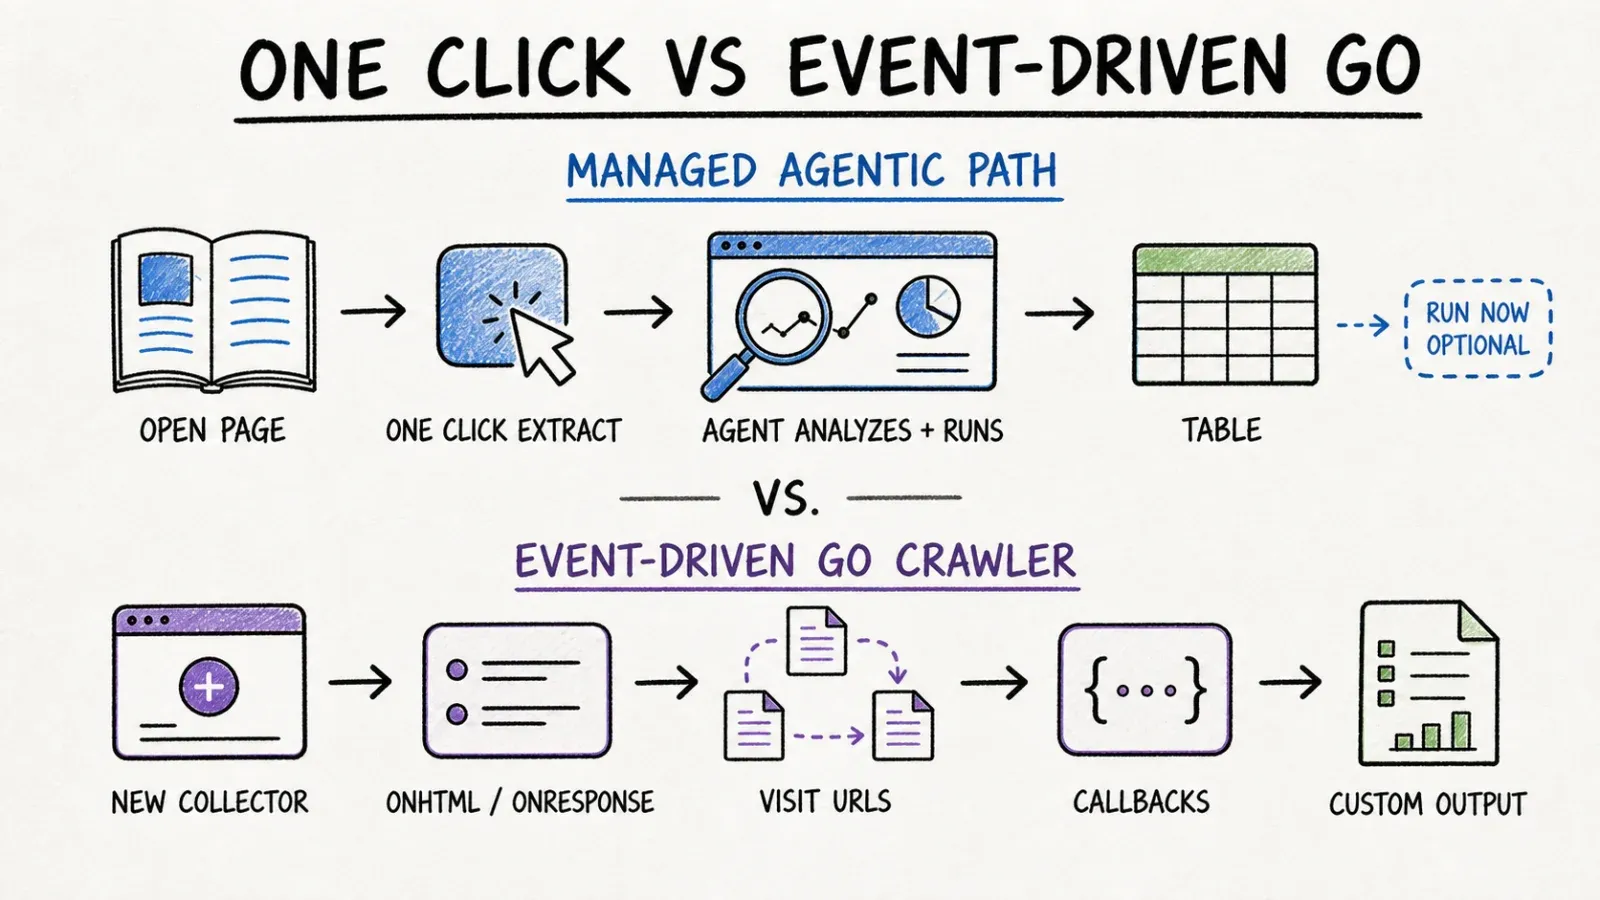
Výchozí workflow v Thunderbit je opravdu jen na jedno kliknutí. Otevřete stránku, ke které máte oprávnění, stisknete One Click Extract a agent si přečte stránku, vyhodnotí, co má smysl vytáhnout, a navrhne pole. Tlačítko Run Now tam sice je, ale upřímně hlavně jako pojistka — když na nic nesáhnete, extrakce začne sama. Žádné psaní selectorů, žádné nastavování schématu, na stránkách, které agent podporuje.
Odtud můžete pole doladit, pokud je agent netrefil přesně, a na kompatibilních webech projde stránkování nebo zajde na podstránky pro doplnění dat — třeba když chcete z každé produktové stránky v seznamu vytáhnout další detaily. Jakmile data máte, exportujete je do obvyklých nástrojů: Excelu, Google Sheets a několika dalších podporovaných cílů.

Ale rozšíření do prohlížeče je jen vstupní brána. Pokud jste vývojář, máte k dispozici Open API pro spouštění extrakce z vlastního kódu, MCP Server pro zapojení extrakce do Claude, Cursor nebo Windsurf jako volatelného nástroje a CLI pro terminál a coding-agent workflow. Zmiňuju to proto, že hodně zjednodušené dělení na „no-code vs code“ bere Thunderbit jako čistě hračku pro business uživatele, a to už dávno není přesné.
Co je Colly?
Colly je Go knihovna — tečka. Není tam dashboard, žádná hostovaná služba ani AI vrstva, která by rozhodovala, co se má scrapovat. Píšete Go, vytvoříte Collector a připojíte callbacky jako OnHTML a OnResponse, které přesně určují, co se má stát, když crawler narazí na stránku.
Přibližně to vypadá takto:
c := colly.NewCollector()

c.OnHTML("a[href]", func(e *colly.HTMLElement) {
    link := e.Attr("href")
    c.Visit(e.Request.AbsoluteURL(link))
})

c.OnResponse(func(r *colly.Response) {
    fmt.Println("Visited", r.Request.URL)
})

c.Visit("https://example.com")
To je celý mentální model: určíte, co hledat, určíte, co se má dít, když to najde, a necháte collector crawlovat. Pod kapotou dostanete synchronní, asynchronní a paralelní crawling, rate limiting po doménách, automatickou práci s cookies/session, cache requestů, respektování robots.txt, rotaci proxy a rozšiřitelné storage backendy včetně Redis pro distribuovaná nasazení.
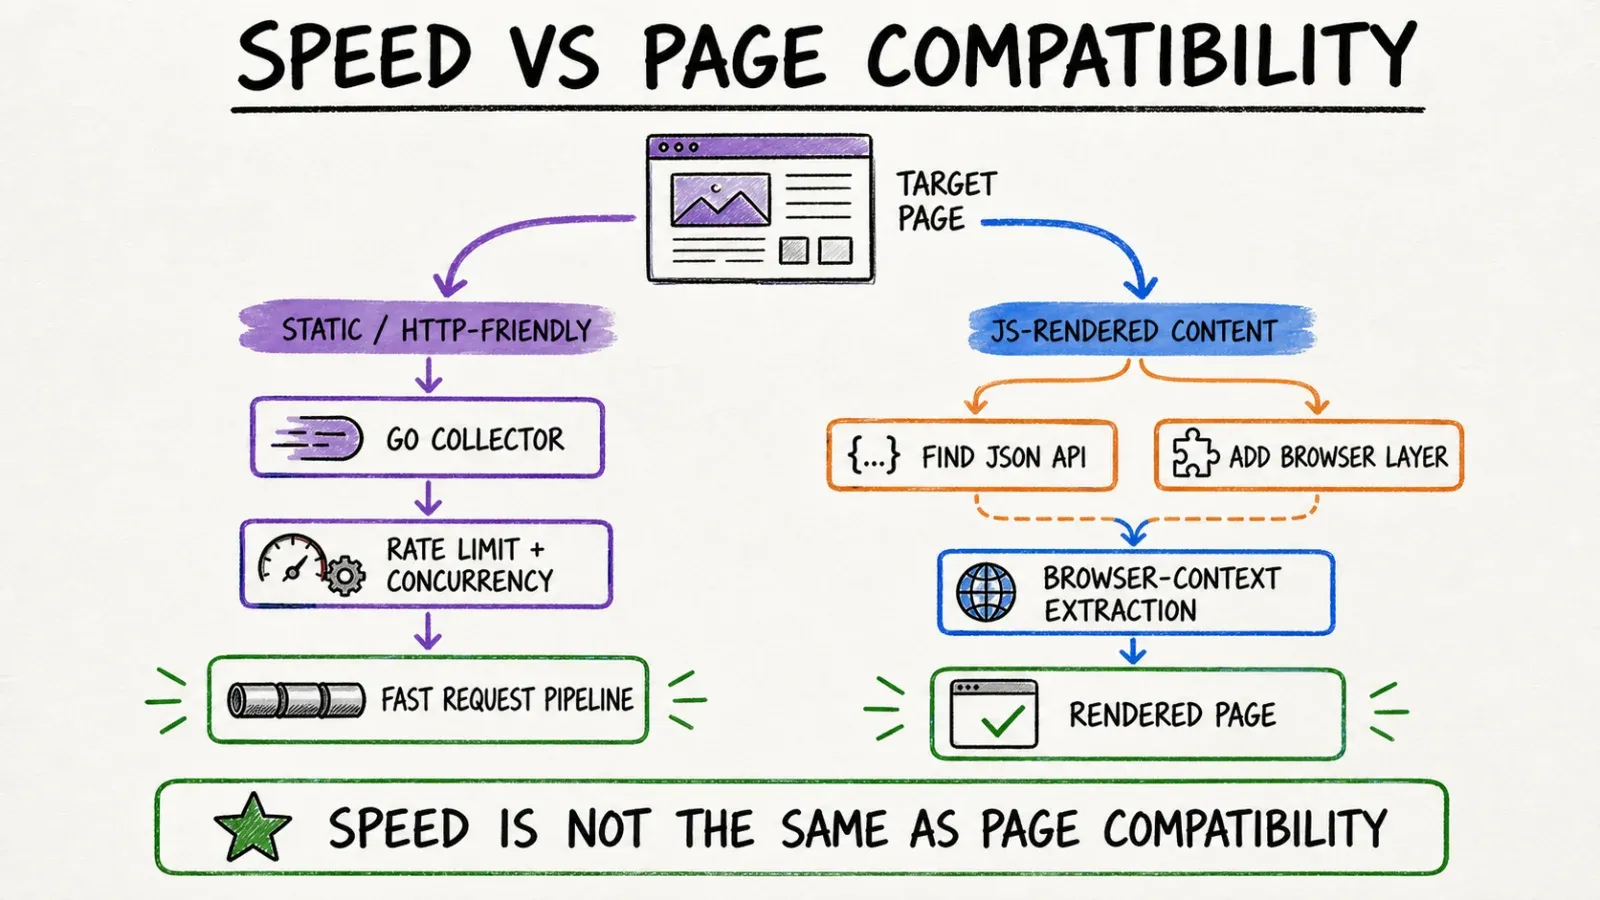
Je fér říct ještě jednu věc: Colly je především HTTP/HTML framework. Nespouští plnohodnotný prohlížeč jako Playwright. Pokud váš cílový web silně spoléhá na JavaScriptové renderování, budete buď hledat jeho podkladové JSON API, nebo Colly spojíte s jiným nástrojem pro browser automation. To není slabina Colly — jen jiná filozofie návrhu než u plně agentického, na prohlížeč orientovaného produktu.
Hlavní rozdíl: spravovaná agentická extrakce vs Go framework
Čas do první tabulky
Tady je rozdíl nejviditelnější. S Thunderbit se „čas do prvního výsledku“ měří časem potřebným na kliknutí na tlačítko a čekání, než agent dočte stránku — tedy sekundy až pár minut podle složitosti stránky. U Colly do toho vstupuje napsání collectoru, nalezení správných selectorů (což obvykle znamená pár pokusů a omylů v dev tools), vlastní řešení stránkování a samotné spuštění. Pro jednorázový úkol je to reálná časová investice, i když jste slušný Go vývojář.
Výkon a kontrola
V surové kontrole vyhrává Colly, o tom není sporu. Protože logiku píšete vy, rozhodujete, kolik gorutin poběží souběžně, jak agresivní bude rate limiting, co se bude cachovat a jak se budou retryovat chyby. Vlastní dokumentace projektu uvádí více než 1 000 requestů za sekundu na jednom jádře pro vhodné statické cíle — to je benchmark Colly, ne přímé srovnání s Thunderbit, a nebudu předstírat opak. Ale něco to říká: pro HTTP-friendly cíle bude ručně laděná Go concurrency velmi těžko k překonání.
Thunderbit tuhle granulární kontrolu vyměňuje za spravované běhy. Neladíte goroutine pooly — spoléháte na prohlížeč a cloud execution platformy, plus na plánované spouštění, pokud to váš tarif podporuje. To je správná volba, pokud nechcete řešit infrastrukturu, a špatná, pokud je vaše práce doslova vytěžit z crawleru maximum výkonu.
Vlastnictví nasazení a údržby
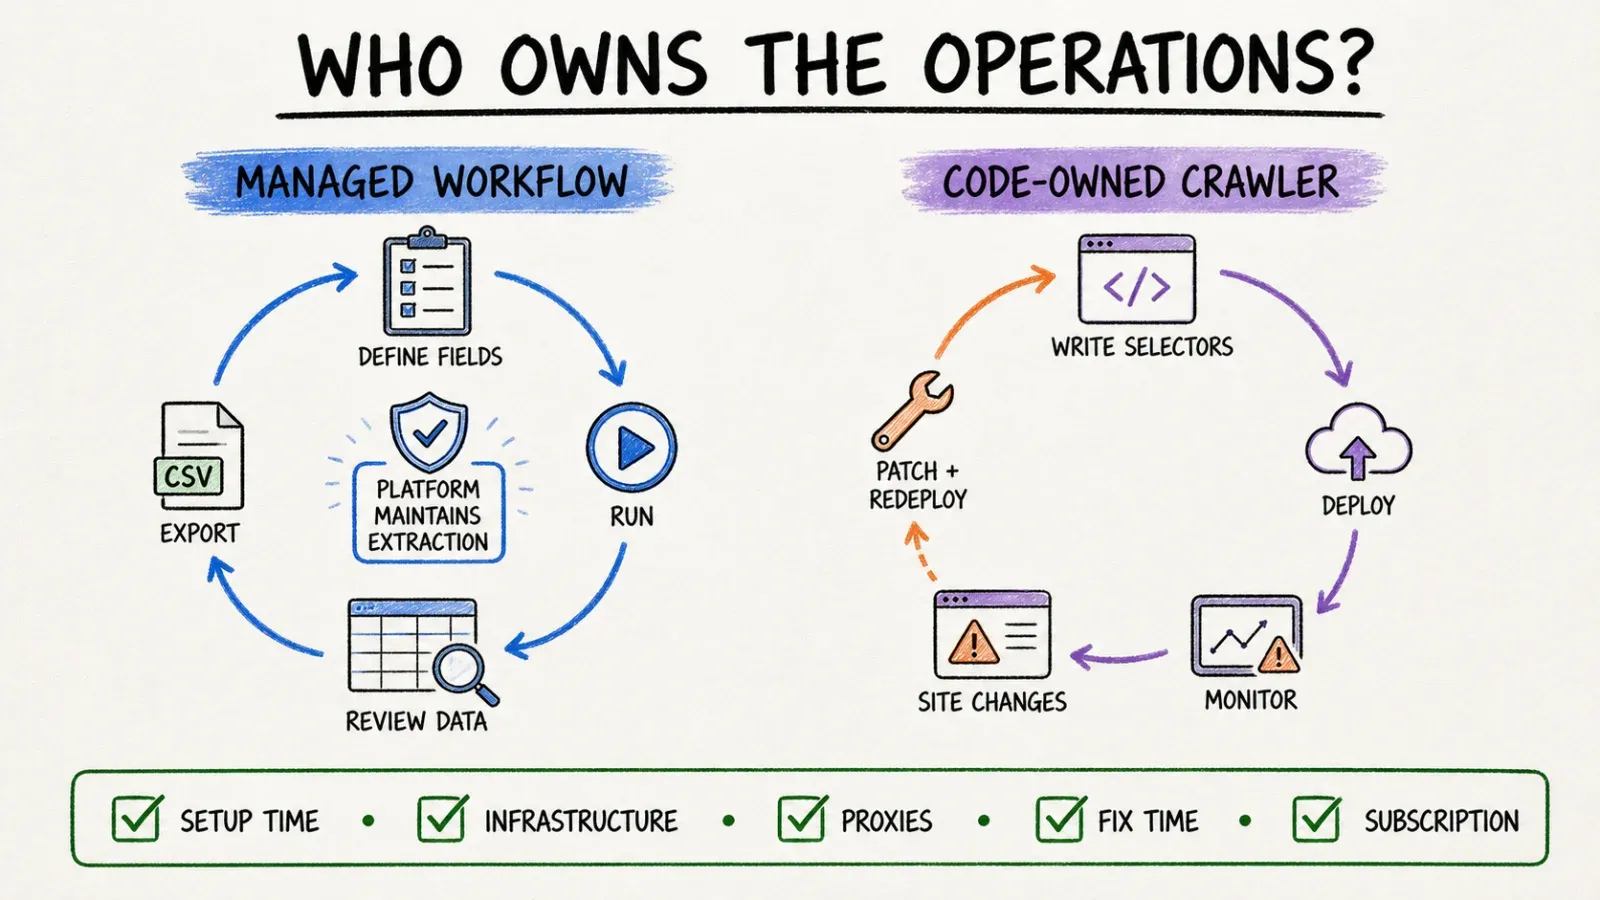
Tady je část, o které se nemluví dost často. Colly je „zdarma“ v tom smyslu, že licence Apache-2.0 nestojí nic. Ale někdo ho musí napsat, hostovat, monitorovat a — to je ta důležitá část — opravit ve chvíli, kdy cílový web změní HTML. Selektory se rozbijí tiše. Nikdo vám nepošle upozornění ve stylu „hej, tenhle web přepracoval produktovou stránku“. Vývojář si všimne až ve chvíli, kdy pipeline utichne nebo začne vracet nesmysly, a pak to musí opravit.
U Thunderbit je extrakční logika spravovaná platformou a jeho agentické vyhodnocování stránek je navržené tak, aby se přizpůsobovalo změnám layoutu na podporovaných a autorizovaných stránkách. Tady ale chci být opatrný — není to žádná univerzální záruka. Silně anti-bot chráněné stránky, obsah za přihlášením mimo to, k čemu máte oprávnění, nebo weby, které agent prostě nezvládá dobře, jsou skutečná omezení. Poctivé shrnutí tedy zní: u Colly je oprava vždy na vás. U Thunderbit je zátěž menší, ale „menší“ neznamená „nulová“ — úspěch pořád závisí na tom, jestli je cílová stránka něčím, co Thunderbit umí dobře.
Praktické scénáře
Jednorázová extrakce katalogu / produktů
Řekněme, že do konce dne potřebujete tabulku se 200 produkty z katalogové stránky konkurence, a nejste vývojář (nebo jste, ale máte lepší věci na práci). To je přesně teritorium Thunderbit — kliknout, nechat agenta navrhnout pole, případně je upravit a exportovat do Sheets. Napsat Colly skript pro jednorázovou extrakci je technicky možné, ale působí to trochu jako sekat bonsaj motorovou pilou.
Vysokoprůchodový vlastní Go crawler
A teď otočme scénář: stavíte monitorovací pipeline, která denně trefuje tisíce URL, už máte Go stack a potřebujete naprostou kontrolu nad retry logikou, distribuovaným úložištěm přes Redis a limity na úrovni domén, aby vás nikde nezablokovali. Tady je Colly doma. Neplatíte subscription, vlastníte každý řádek logiky a můžete optimalizovat podle vlastního provozu způsobem, jaký spravovaný produkt prostě nenabízí.
Cílový web náročný na JavaScript
Pokud se všechno rendruje na klientovi přes těžký JavaScript, Colly samotný asi nebude odpověď — museli byste sáhnout po jeho metodách, jak najít podkladové JSON API, nebo přidat další vrstvu pro browser automation. Thunderbit má spravované browser/cloud execution cesty navržené právě s tímhle typem stránek na mysli, ale i tak platí: předpokládejte kompatibilitu až po testu na konkrétním cíli, ne předem.
Integrace do API nebo AI agenta
Stavíte interní nástroj, kde AI agent — třeba něco běžícího v Claude nebo Cursor — potřebuje v rámci většího workflow vytáhnout strukturovaná data? Tady je MCP Server od Thunderbit opravdu užitečný — zpřístupňuje extrakci jako volatelný nástroj uvnitř agentních workflow, což je use case, který Colly nativně prostě neslouží, protože je to samostatná knihovna, ne nástroj, který by AI agent mohl hned použít jako součást svého toolsetu.
Spolehlivost, škála a údržba
Chci oddělit dvě věci, které se často hází do jednoho pytle: surový throughput a celkovou úspěšnost na reálných webech. Colly umí na statických, HTTP-friendly stránkách letět velmi rychle — to je součást jeho návrhu. Ale „rychle“ automaticky neznamená „bude fungovat i za tři měsíce“, až web nasadí redesign. Každý selektor, který jste napsali, je najednou potenciálně zastaralý, a nikdo vás neupozorní dřív, než datová pipeline začne tiše vracet null hodnoty.
Agentický přístup Thunderbit znamená, že selektory nemusíte udržovat sami — ale rád bych se ohradil proti jakémukoli tvrzení, včetně marketingu Thunderbit samotného, které by naznačovalo univerzální spolehlivost na každém webu, hlavně u stránek s agresivní anti-bot ochranou nebo obsahem za přihlášením, ke kterému nejste oprávněni. Když hodnotíte kterýkoli z těchto nástrojů, skutečná otázka zní: „kdo to opraví, když se to rozbije, a jak dlouho to bude trvat“ — ne jen „jak rychle to běží první den“.
Cena, licence a celkové náklady
Colly je open-source pod Apache 2.0 — samotná knihovna je zdarma. Ale celkové náklady vlastnictví zahrnují hodiny vývojáře na napsání a ladění crawleru, provozní náklady na běh, proxy náklady, pokud potřebujete rotaci IP, a průběžný čas pokaždé, když se cílový web změní a rozbije vám selektory. Pro tým, který už Go perfektně ovládá, to může být ve větším měřítku opravdu levné. Pro tým bez této dovednosti v týmu se „zdarma“ rychle změní na „draze nepřímo“.
Thunderbit funguje na kredity — aktuální ceník si raději ověřte na stránce s cenami, protože tarify a kreditové limity se mění a já vám nechci poslat zastaralé číslo. Smyslem je, že platíte za méně ruční údržby na podporovaných stránkách, ne za nulovou údržbu všude.
Pokud chcete poctivý mentální rámec, udělejte si vlastní hrubou tabulku: čas na nastavení, náklady na infrastrukturu/proxy, čas na průběžné opravy a cena předplatného. Která strana vyjde lépe pro reálné dovednosti a zátěž vašeho týmu — to je vaše odpověď, ne obecné „open source je levnější“.
Pro koho je Thunderbit vhodný?
Pokud jste obchodní uživatel, člověk z ops nebo member growth týmu a potřebujete strukturovaná data hned teď bez psaní kódu, rozšíření do prohlížeče od Thunderbit je jasná volba. Pokud jste vývojář, který chce extrakci jako stavební blok — přes API, CLI nebo uvnitř workflow AI agenta přes MCP — Thunderbit vám sedne taky, jen jinými dveřmi než tím point-and-click přístupem.
Pro koho je Colly vhodný?
Pokud jste Go vývojář (nebo je váš tým primárně Go-first) a potřebujete vlastní crawler s vysokou propustností, kde máte pod kontrolou každý request, každý retry i každou rotaci proxy — Colly je přesně na tenhle úkol. Je to také správná volba, pokud chcete mít kód plně ve své správě bez závislosti na předplatném a máte kapacitu ho udržovat.
Mohou týmy používat oba nástroje?
Upřímně, ano, a nepovažuju to za vyhýbavou odpověď. Je úplně běžné, že inženýrský tým provozuje odolný, škálovatelný Colly crawler pro klíčovou datovou pipeline, zatímco jiné týmy — sales, ops, marketing — používají Thunderbit pro ad hoc extrakci, kvůli které se nevyplatí psát a udržovat skript. Nebudu si tu vymýšlet nějakou falešnou „oficiální integraci“ mezi oběma — o žádné, o které bych věděl, nevím — ale architektonicky nic nebrání tomu, aby oba nástroje žily v jedné organizaci a řešily různé problémy.
Závěr
Vyberte podle toho, kdo tu práci dělá a co je cílem optimalizace. Pokud máte Go dovednosti, potřebujete vlastní logiku a chcete si údržbu držet pod kontrolou výměnou za plnou flexibilitu a nulové subscription náklady, Colly je správný nástroj. Pokud chcete data rychle, nechcete psát ani udržovat kód a nevadí vám vyměnit část nízkoúrovňové kontroly za spravované řešení — včetně možnosti zapojit extrakci přes API nebo AI agenta — Thunderbit je lepší volba. Ani jeden není „lepší“ obecně; jsou stavěné pro jiné lidi a jiné problémy.
Často kladené otázky
Je Colly zdarma? Ano — Colly je open-source pod licencí Apache 2.0, takže samotná knihovna nic nestojí. Skutečné náklady jsou čas vývojáře, hosting, případné proxy a průběžná údržba ve chvíli, kdy se cílové weby změní.
Umí Colly renderovat JavaScript? Nativně ne. Colly je primárně HTTP/HTML framework, takže weby silně závislé na JavaScriptu obvykle vyžadují nalezení podkladového JSON API, které stránka volá, nebo propojení Colly s dalším nástrojem pro browser automation.
Podporuje Thunderbit API a MCP přístup pro vývojáře? Ano. Thunderbit nabízí Open API pro programovou extrakci a MCP Server, který zpřístupňuje extrakci jako volatelný nástroj v kompatibilních AI agentních workflow, jako jsou Claude, Cursor nebo Windsurf.
Který nástroj se rozběhne rychleji? Thunderbit — záměrně. Flow One Click Extract v rozšíření do prohlížeče vám dá výsledek v řádu sekund až minut bez kódu. Colly vyžaduje napsání a otestování Go kódu, než uvidíte první výsledek.
Který nástroj dává větší kontrolu nad samotným crawlingem? Colly, jednoznačně. Přes gorutiny řídíte concurrency, rate limiting, cache, rotaci proxy i storage backendy přímo v kódu — takovou míru ladění spravovaný produkt jako Thunderbit záměrně neotevírá.




